阅读时间:约 45 分钟 前置知识:了解基本的服务可用性概念、有分布式系统运维经验 学完能回答:如何为关键服务设定 SLO?错误预算怎么用?On-Call 轮值怎么设计?复盘怎么做才不变成"甩锅大会"?
一、为什么 SRE 应急响应是架构师的必修课
2021 年 10 月,Facebook 全球宕机 6 小时。根因是一条 BGP 路由配置变更,但真正让它演变成灾难的,是故障响应链条的断裂——DNS 不可用导致内部工具全部失效,工程师甚至刷不开机房门禁卡。这不是技术问题,这是应急响应体系的系统性失效。
每一年,Google SRE 团队都会发布故障统计:平均每个复杂服务每年经历 2-3 次 P0/P1 级事故。没有完美的系统,只有对故障做好了准备的组织。
作为 Java 技术专家或架构师,你需要的不只是写代码的能力。当凌晨 3 点告警响起,你需要在 30 秒内判断:这是噪音还是事故?要不要升级?先止损还是先定位根因?这些决策,靠的是对 SRE 应急响应体系的深刻理解。
二、SLI、SLO、SLA:三个字母,一套因果
2.1 概念辨析
SLI(Service Level Indicator,服务等级指标) 是衡量服务质量的量化指标。它是客观的、可度量的数字。
| 指标类型 | 示例 SLI | 测量方式 |
|---|---|---|
| 可用性 | 请求成功率 | 成功请求数 / 总请求数 |
| 延迟 | P99 响应时间 | 1 分钟内所有请求的 P99 |
| 吞吐量 | 每秒请求数 | 滑动窗口均值 |
| 数据持久性 | 数据写入成功率 | 成功写入 / 总写入 |
| 正确性 | 端到端校验通过率 | 采样校验 |
选择 SLI 的核心原则:SLI 必须直接反映用户体验。 CPU 使用率高不是好的 SLI——用户不关心你的 CPU;用户关心的是"页面加载超过 3 秒了吗?"
SLO(Service Level Objective,服务等级目标) 是 SLI 的目标值,定义了服务"足够好"的边界。例如:
- "99.9% 的请求在 30 天内成功"(可用性 SLO)
- "P99 延迟 < 200ms,在 28 天滚动窗口内"(延迟 SLO)
SLO 不是越高越好。 设定 99.99% 可用性 SLO 意味着全年允许 52 分钟不可用时间。如果你的用户能容忍 99.9%(全年 8.76 小时),多出来的 8 小时 24 分钟就是你的"操作空间"——这就是错误预算的来源。
SLA(Service Level Agreement,服务等级协议) 是服务提供方对客户的法律承诺。违反了 SLA 通常意味着赔偿或退款。SLA 通常比 SLO 更宽松(留有安全边际):
SLA(对外承诺) < SLO(内部目标) < 实际可达性 例如:99.5% < 99.9% < 99.95%
2.2 三者的层次关系
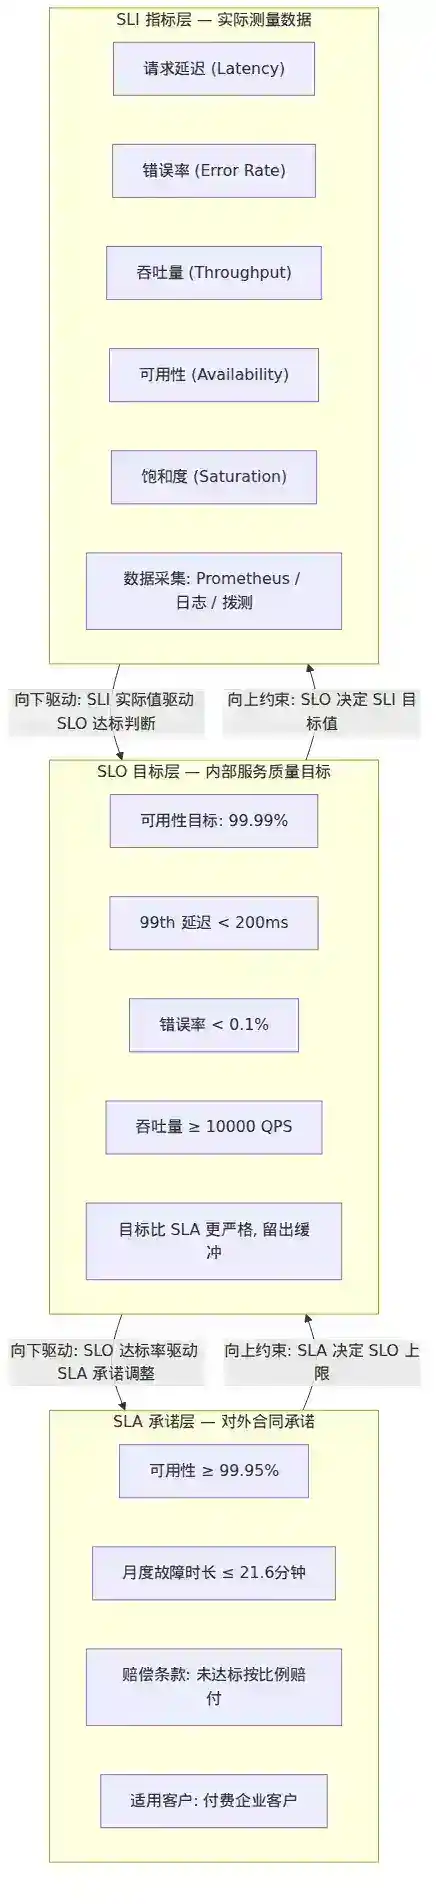
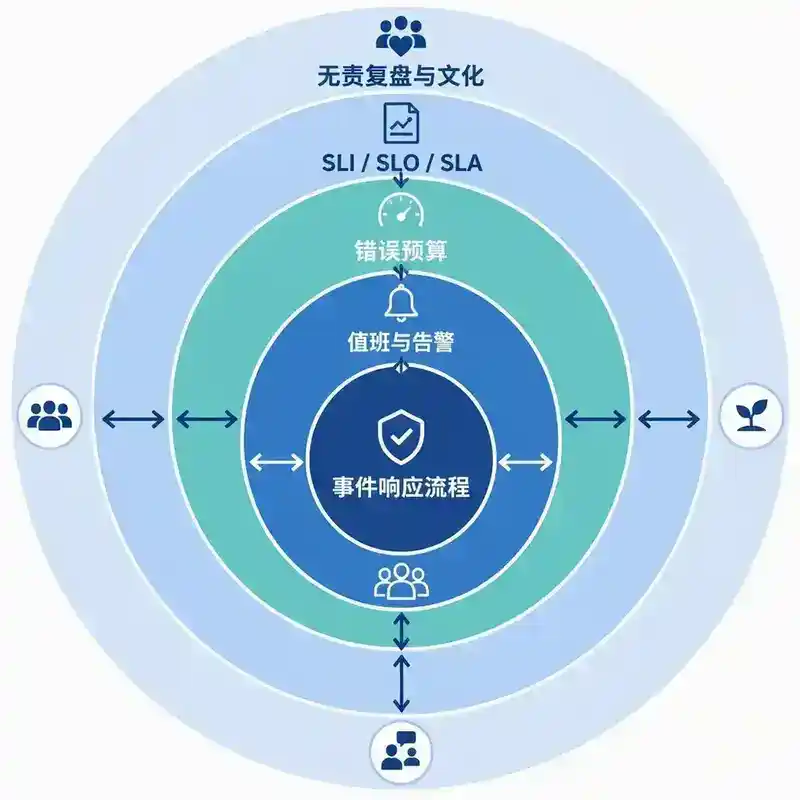
SLO 是连接技术指标与业务承诺的桥梁。它向上支撑 SLA 的达成,向下指导工程团队的日常决策:
- SLO 达标 → 团队可以继续做功能开发,消耗错误预算做风险变更
- SLO 接近不达标 → 减速功能开发,优先稳定性工作
- SLO 已经突破 → 冻结发布,全员投入稳定性修复
2.3 怎么设定一个好的 SLO
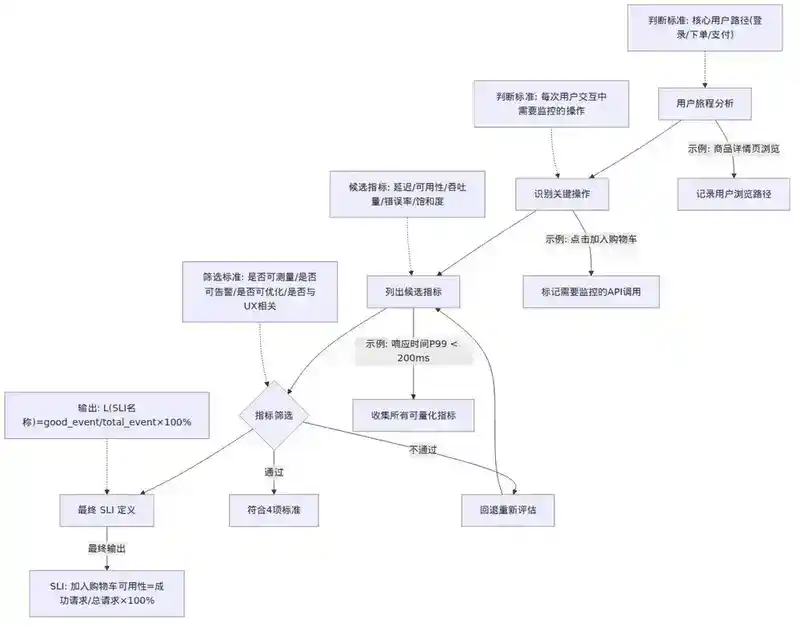
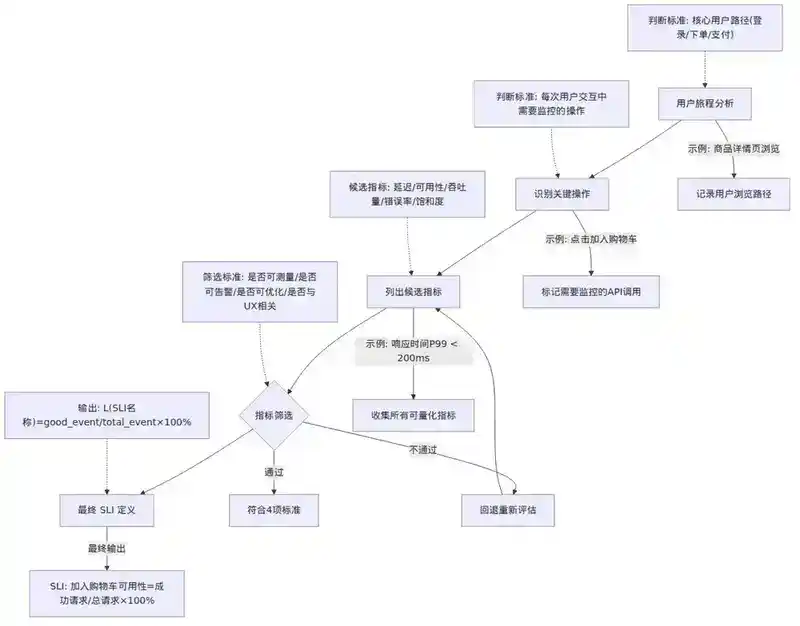
第一步:从用户旅程出发。 不要从"系统有哪些指标"开始,而是从"用户完成一个核心操作需要什么"开始。例如电商下单流程:
- 用户打开商品详情页 → 可用性 + 延迟
- 用户点击"加入购物车" → 可用性
- 用户提交订单 → 可用性 + 正确性(金额不能错)
第二步:选取关键 SLI。 一个服务通常只需要 3-5 个 SLI。太多 SLI = 太多的告警噪音 = 没人看。
第三步:设定合理阈值。 参考以下方法:
- 历史数据法:看过去 3 个月该指标的实际表现,SLO 设为比历史 95% 分位稍严格
- 用户感知法:从用户能感知到的阈值倒推。例如研究显示:页面加载超过 3 秒,用户流失率增加 32%
- 竞品对标法:同行业顶级服务的 SLO 作为参考
第四步:定义测量窗口。 推荐使用 28 天(4 周)滚动窗口。太短容易受短期波动影响,太长则反馈太慢。
三、错误预算:把"稳定性"变成可量化的决策工具
3.1 错误预算是什么
错误预算 = 1 - SLO 达标率,是服务在给定时间窗口内"允许犯错"的额度。
例如:SLO 为 99.9% 可用性,28 天窗口内总请求 1 亿次,则错误预算 = 0.1% × 1 亿 = 10 万次失败请求。
3.2 错误预算的三重用途
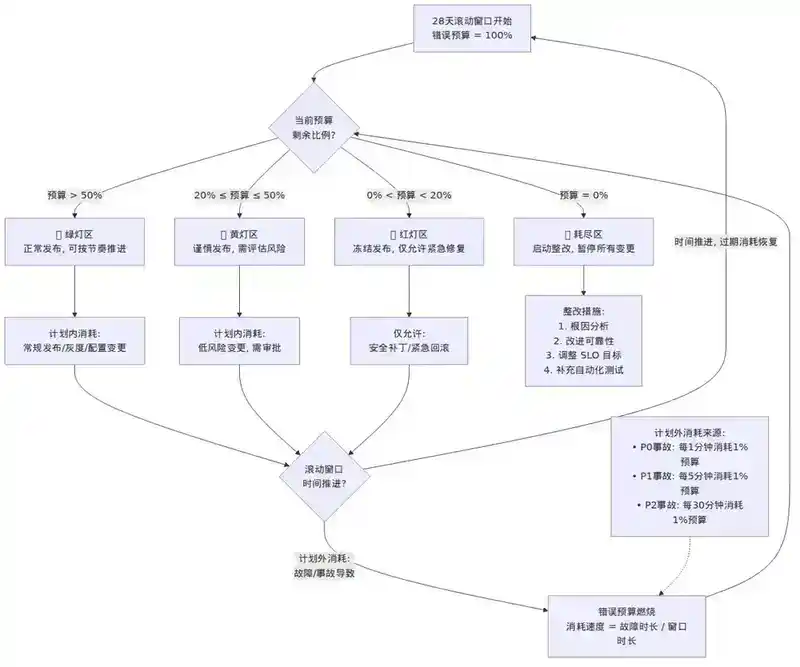
第一重:发布决策的"交通灯"。
| 错误预算消耗 | 决策 |
|---|---|
| 剩余 > 50% | 🟢 绿灯:正常发布,允许风险变更 |
| 剩余 20-50% | 🟡 黄灯:减速发布,新功能需评审 |
| 剩余 < 20% | 🔴 红灯:冻结所有非紧急变更 |
| 已耗尽/负数 | ⛔ 停止一切变更,全团队投入稳定性修复 |
第二重:优先级谈判的"硬通货"。
产品经理说"这个功能下周必须上线",你可以说"错误预算还剩 15%,SLO 规定剩余不到 20% 时冻结变更。要不我们先修稳定性问题,等预算恢复?"
这比"我觉得系统不够稳定"有力得多——你不是在说"我觉得",而是在说"我们约定的规则说"。
第三重:组织学习的"反馈环"。
错误预算消耗过快 → 说明近期变更质量有问题 → 需要加强 code review 或测试覆盖。错误预算长期剩余接近 100% → 说明 SLO 设得太松,可以收紧。
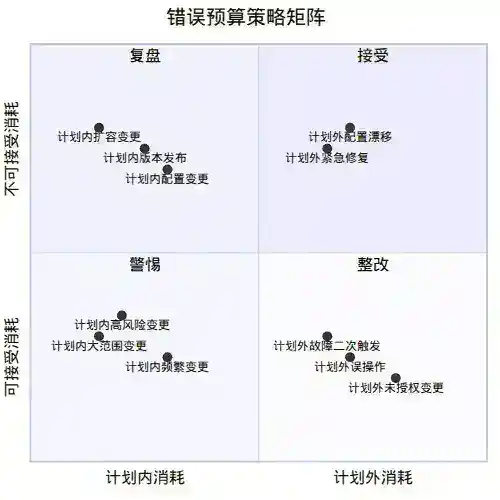
3.3 错误预算策略
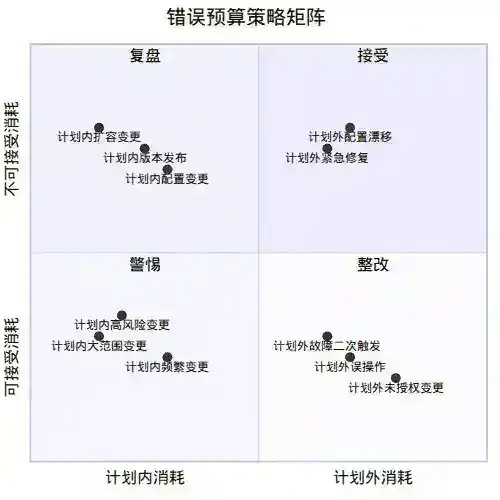
不是所有错误预算消耗都一视同仁。一个有效的策略是区分:
- 计划内消耗:灰度发布、A/B 测试、混沌工程实验。这些是"为了进步"的消耗,可接受。
- 计划外消耗:生产事故、代码缺陷。这些是"需要修复"的消耗,应触发复盘。
四、On-Call 机制:让凌晨 3 点的告警有人接
4.1 On-Call 的核心原则
原则一:没有人应该 7×24 待命。 轮值是最基本的尊重。典型的排班方式:
- 按周轮值:每人负责一周,交接清晰,心理负担可控
- 追随太阳:跨时区团队,亚洲→欧洲→美洲接力,没人需要熬夜
- 主备双岗:主值班负责响应,备值班在主值班 10 分钟无响应时接管
原则二:减少不必要的唤醒。 如果 On-Call 工程师每周被叫醒 3 次以上,要么告警太多,要么系统太脆弱。每个告警都应该满足:
- 可操作(Actionable):收到告警后,工程师知道该做什么。如果告警的唯一响应是"观察一下",那它不该是告警。
- 紧急(Urgent):需要立即人工介入。如果可以在工作时间处理,发邮件就够了。
- 代表用户痛感(User-facing):与用户实际体验直接相关。
原则三:On-Call 不应是"英雄主义"。 如果一个服务的 On-Call 只有一个人能接,这是单点故障。每个服务至少需要 2 人(理想 3-4 人)具备 On-Call 能力。
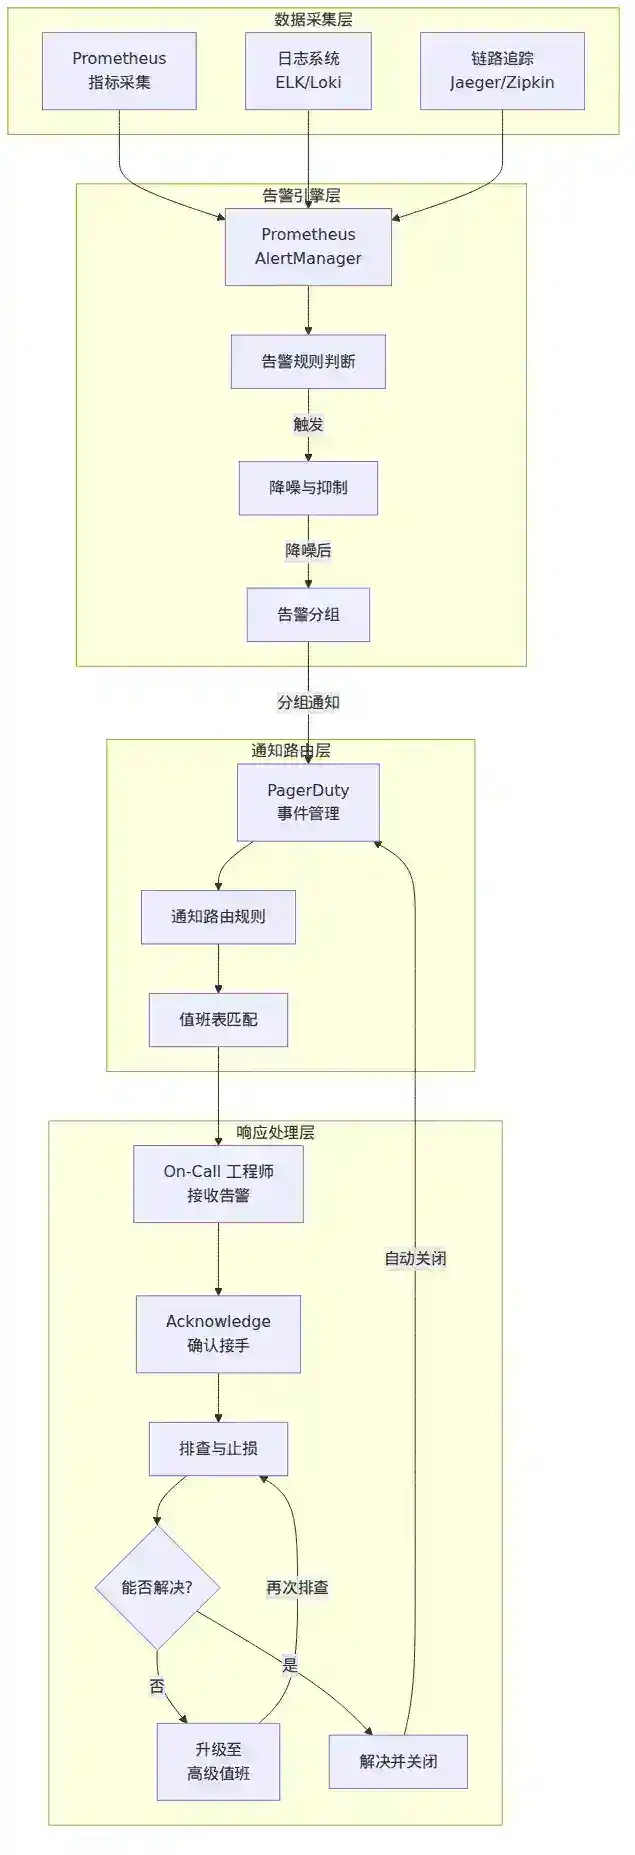
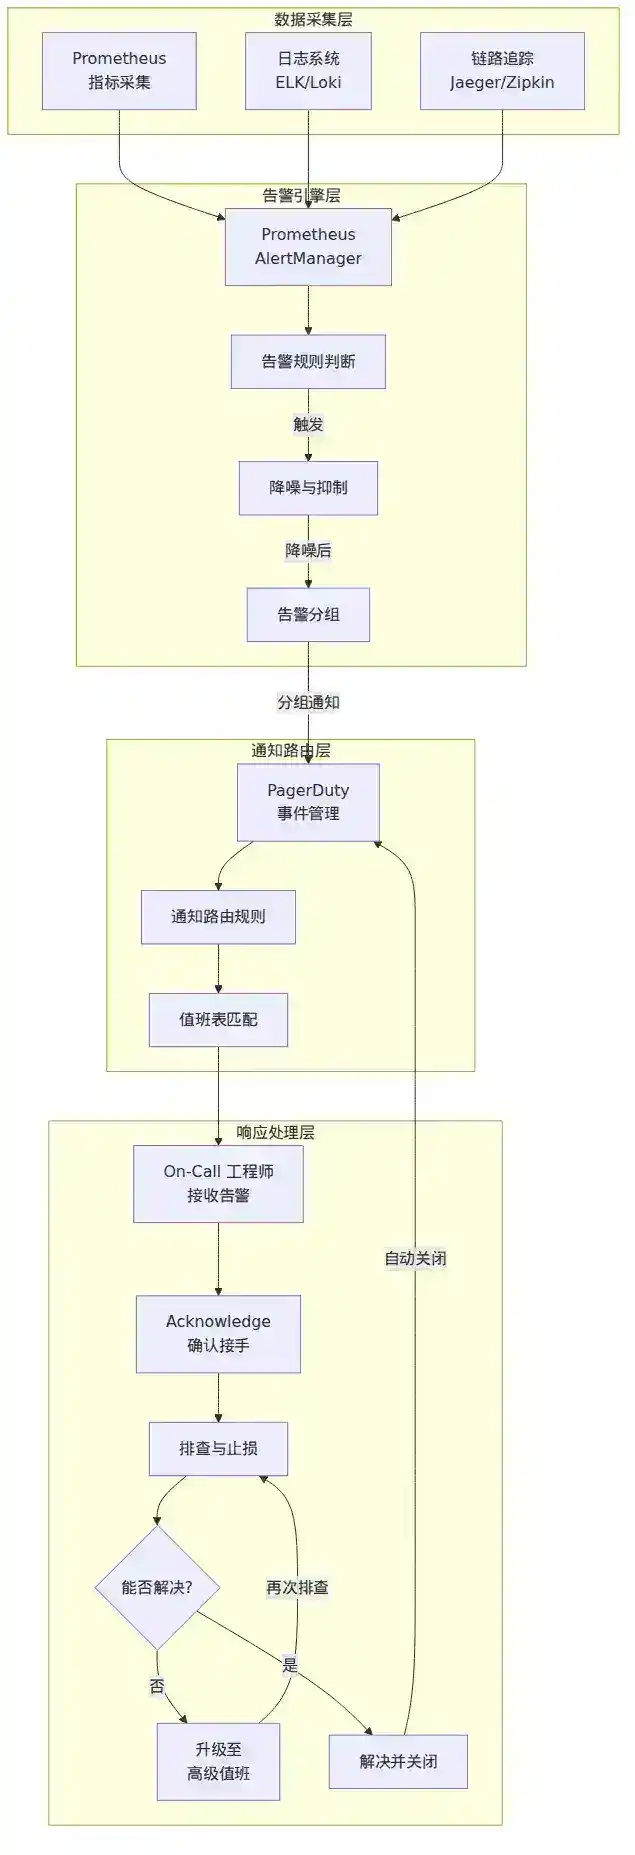
4.2 告警升级链
当一个告警在规定时间内无人确认(Acknowledge),应自动升级:
Level 1: 主值班工程师 → 5 分钟无 Ack Level 2: 备值班工程师 → 10 分钟无 Ack Level 3: 团队 Tech Lead → 15 分钟无 Ack Level 4: 值班经理/EM → 20 分钟无 Ack Level 5: 部门负责人 → 30 分钟无 Ack
每一级升级都应附带上下文(发生了什么、已尝试什么、需要什么决策),而不是让上级重新理解整个事件。
4.3 On-Call 健康度检查
定期检查 On-Call 的健康状况:
| 指标 | 健康阈值 | 危险信号 |
|---|---|---|
| 人均每周告警数 | < 2 次 | > 5 次 |
| 非工作时间告警占比 | < 30% | > 50% |
| 告警误报率 | < 10% | > 30% |
| 告警平均恢复时间 | < 30 分钟 | > 2 小时 |
| On-Call 人员倦怠度 | 自我评估良好 | 有人要求调离 |
五、故障应急响应:从"发现"到"恢复"的 60 分钟
5.1 故障分级
大多数公司采用 P0-P4 五级分类:
| 级别 | 定义 | 响应时间 | 示例 |
|---|---|---|---|
| P0 | 全站不可用,用户数据丢失风险 | 立即(< 1 分钟) | 核心支付服务全部失败 |
| P1 | 核心功能严重受损,大部分用户受影响 | < 5 分钟 | 商品详情页 50% 报错 |
| P2 | 部分功能受影响,有降级方案 | < 30 分钟 | 推荐服务不可用,兜底生效 |
| P3 | 轻微影响,用户可感知但不阻塞 | < 4 小时 | 管理后台某个页面加载慢 |
| P4 | 潜在问题,用户无感知 | 下一个工作日 | 日志中有偶发异常 |
5.2 应急响应角色
Google 的 IMAG(Incident Management at Google)模型定义了清晰的应急角色:
- Incident Commander(IC,事故指挥官):唯一决策者。负责协调、分配任务、对外沟通。IC 不写代码——ta 的职责是"看清全局"。
- Operations Lead(OL,运维负责人):执行 IC 的指令,指挥技术人员进行排查和修复操作。所有技术操作变更需经 OL 批准。
- Communications Lead(CL,沟通负责人):负责对外沟通——更新状态页、通知受影响团队、起草事故通知。
- Subject Matter Experts(SME):各领域的专家,负责具体排查和修复。
5.3 应急响应 SOP
[0-5 分钟] 发现与确认 → 确认告警是否为真实事故 → 判断故障级别(P0/P1/P2/P3/P4) → 宣布事故,指定 IC → 创建事故沟通频道(专用群聊/视频会议)
[5-15 分钟] 止损 → 优先:回滚最近变更、切流量、降级非核心功能 → 原则:先止损,后定位根因 → 记录所有操作的时间线
[15-45 分钟] 定位与修复 → 多维度排查:最近变更、监控曲线、依赖服务状态 → 尝试修复方案 → 持续评估:修复是否有效?是否需要升级?
[45-60 分钟] 恢复与验证 → 确认服务恢复正常 → 观察 15 分钟确保不再复发 → 宣布事故结束
5.4 黄金法则
- 先止损,后定位。 用户不关心根因,用户关心服务什么时候恢复。即使你还没搞懂为什么,回滚总是对的。
- 记录一切。 每个操作、每个观察、每个决策,记录时间戳。这不只是为了复盘,更是为了在交接时让接手的人知道"发生了什么"。
- 单一决策者。 多人指挥 = 无人负责。IC 的决定即使不是最优,也比没有决定好。
- 不要怕升级。 升级不是承认失败,而是负责任的表现。很多重大事故的恶化,都是因为当事人"觉得还能救回来"而迟迟不升级。
六、无责复盘:从"谁搞砸了"到"系统怎么让你搞砸了"
6.1 为什么传统复盘会失败
你经历过这样的复盘会吗?
"这次事故是因为张三在周五下午 5:59 执行了一条 SQL 没有加 WHERE 条件。张三,你有什么要说的?"
这种复盘的结果是:张三学会了下次不承认,团队学会了隐藏问题,而系统漏洞(为什么一条 SQL 就能删掉全表?为什么没有备份?为什么权限没限制?)一个都没解决。
无责复盘(Blameless Postmortem)的核心假设是:事故不是"坏人"造成的,而是"好人在有缺陷的系统中做出了合理但错误的选择"。
6.2 无责复盘的结构
一份好的无责复盘包含以下要素:
1. 事故摘要
- 什么时间、什么服务、什么影响
- 一句话总结根因
2. 时间线(Timeline)
- 精确到分钟的关键事件序列
- 从"第一个异常信号"到"完全恢复"
3. 根因分析(5 Whys 或因果图)
- 不是"谁",而是"为什么"
- 用 5 Whys 追问到系统性原因
4. 促成因素(Contributing Factors)
- 哪些系统设计、流程、工具问题让事故"更容易发生"、"更难发现"、"更难恢复"
5. 影响评估
- 用户影响:多少用户受影响、持续多久
- 业务影响:GMV 损失、工单量、客户投诉数
6. 行动项(Action Items)
- 预防性:防止同类事故再次发生
- 检测性:让同类事故更早被发现
- 响应性:让同类事故更快被恢复
- 每个 Action Item 必须指定负责人和截止时间
7. 经验教训
- 这次事故教会了我们什么?
- 如果重来一次,哪里可以做不同?
6.3 无责复盘的语言
| ❌ 不要这样说 | ✅ 这样说 |
|---|---|
| "张三犯了一个错误" | "系统没有提供足够的保护,使得一个操作失误导致了严重后果" |
| "运维忘了重启服务" | "重启流程没有被自动化,依赖人工记忆" |
| "测试没有覆盖这个场景" | "测试覆盖策略中缺少对此类边界条件的检测" |
| "为什么不早点升级?" | "升级触发条件不够明确,需要改为自动化升级" |
6.4 复盘后的闭环
复盘不是结束,而是开始。Google SRE 的做法是:
- 每个 Action Item 进入团队的 Bug/Feature 跟踪系统
- 每周 Review Action Items 的进展
- 每季度 Review 所有复盘,看是否有重复模式
- 对重复出现的问题,升级为系统性改进项目

七、实战案例:一个支付服务故障的完整应急响应
下面通过一个虚构但真实的案例,串联全部知识点。
场景
时间:周三凌晨 2:17 服务:某电商平台核心支付服务 背景:当天下午上线了新版本,引入了对第三方支付网关的异步回调优化
应急响应全流程
02:17 - 监控告警:支付成功率从 99.7% 骤降至 72%。On-Call 工程师李华收到 PagerDuty 电话告警,1 分钟内确认告警。
02:18 - 李华打开监控大盘,确认:支付服务 Pod 全部存活,但 5xx 错误率飙升。初步判断为真实事故,故障级别 P1(核心功能受损,无降级方案)。
02:20 - 李华宣布事故,在团队群聊中发送:"[P1] 支付成功率降至 72%,我正在排查,请保持频道畅通。" 同时开始录音记录操作过程。
02:22 - 遵循"先止损"原则,李华检查最近变更记录,发现 16:00 的发布。执行回滚。
02:28 - 回滚完成。支付成功率恢复到 99.5%。李华决定观察 15 分钟。
02:43 - 持续稳定 15 分钟。李华宣布事故结束,通知团队。总影响时间:26 分钟,影响约 8500 笔支付失败。
次日复盘发现
- 根因:新版本中对支付回调的线程池从固定大小改为动态扩展,在并发高峰时线程池无限扩展导致 OOM
- 促成因素:线程池参数变更未经过压测;代码 review 未覆盖线程池配置;灰度发布只覆盖了 5% 流量,不足以触发 OOM 阈值
- 行动项:
- 线程池配置变更纳入高危变更清单,需额外审批(3 天内)
- 增加 JVM 堆内存使用率告警,阈值 85%(1 天内)
- 灰度发布增加"内存趋势"检查项(2 周内)
- 补充支付回调的压测场景(1 个 sprint 内)
错误预算消耗:26 分钟不可用 ÷ 28 天窗口 = 约 0.06% 消耗。SLO 为 99.9%,错误预算剩余 60%,仍处于绿灯区。
八、常见陷阱与避坑指南
| 陷阱 | 症状 | 正确做法 |
|---|---|---|
| SLO 虚设 | 设了 SLO 但从没人看,告警阈值与 SLO 无关 | 告警策略必须基于 SLO 消耗速率,引入 burn rate alert |
| 错误预算当摆设 | 错误预算超了照样发布,没人喊停 | 将错误预算写入发布流程,自动化拦截 |
| On-Call 倦怠 | 没人愿意接 On-Call,告警被忽略 | 降低告警噪音,增加轮值人数,给予 On-Call 补偿 |
| 复盘变批斗 | 会上都在解释"不是我",没人提系统改进 | 坚持无责原则,复盘关注"系统怎么让人犯错" |
| 只有复盘没有闭环 | 每次复盘都提 Action Items,但从不跟踪 | Action Items 进 JIRA/系统,SRE 定期 Review 完成率 |
| 告警疲劳 | 告警太多,工程师开始忽略真正重要的告警 | 每个告警必须满足"可操作+紧急"标准,否则降级为工单 |
九、工具生态建议
| 环节 | 推荐工具 | 关键能力 |
|---|---|---|
| SLI 监控 | Prometheus + Grafana、Datadog | 自定义指标、多窗口查询、SLO 仪表盘 |
| 告警管理 | Alertmanager、PagerDuty、OpsGenie | 分组、抑制、静默、升级链、排班 |
| 事故协同 | FireHydrant、incident.io | 角色分配、时间线记录、自动化 Runbook |
| 复盘文档 | 钉钉文档、Confluence、Notion | 模板化、可搜索、可追溯 |
| 错误预算 | 基于 Prometheus 的计算、Datadog SLO | 实时消耗速率、燃尽图、自动拦截 |
十、总结
SRE 故障应急响应不是一套"出了事才用"的流程,而是一套贯穿日常工程决策的方法论:
- SLI/SLO 帮你定义"什么叫好",让稳定性从模糊的"感觉"变成可量化的数字
- 错误预算 把稳定性与开发速度的冲突,从"谁嗓门大"变成"数据说了算"
- On-Call 机制 确保有人在正确的时间响应正确的信号
- 无责复盘 让每次事故都变成组织的学习机会,而不是惩罚工具
记住 Google SRE 团队的核心理念:"Hope is not a strategy." 不要指望系统不出问题,要为"系统一定会出问题"做好准备。
本文是"Java 技术专家与架构师面试:250 个高频考点总览"系列的第 224 篇。下一篇预告:225|认证与授权:Authentication/Authorization、RBAC、ABAC 和最小权限。
面试官视角:追问与回答
以下问题不基于本文内容,而是从一个面试官的角度,考察你对 SRE 应急响应体系的深度理解和实战经验。
Q1:你说要给一个服务设定 SLO,假如这个服务是公司内部的订单查询服务,每天 100 万次调用,主要面向客服团队。你会怎么设定 SLO?设定什么样的 SLO?
参考答案:首先分析用户场景。客服团队使用订单查询服务的典型场景是:客户打电话来问订单状态,客服需要在 30 秒内给出答复。所以合理的延迟 SLO 应该是 P99 < 500ms(给客服系统 + 人工响应留时间)。可用性 SLO 可以设为 99.9%(内部工具,不需要 99.99%)。吞吐量方面,注意客服团队的工作时间(9:00-21:00)是峰值。另外,这个服务的"正确性"可能比"可用性"更重要——如果返回了错误的订单状态,对客户体验的影响比"查不到"更大。所以我会增加一个正确性 SLI:订单状态正确率 > 99.99%。
Q2:你们的错误预算烧完了,产品经理坚持要上线一个促销活动功能,说老板已经批了。你怎么处理?
参考答案:首先,错误预算烧完意味着我们的 SLO 已经被突破,继续发布风险变更会让服务变得更不稳定,最终伤害的还是用户。我会这样做:第一,用数据说话——展示错误预算的燃尽图和当前的服务稳定性趋势;第二,提供替代方案——能不能先做低风险的变更?能不能等 3 天错误预算窗口滚动后部分恢复?第三,如果确实必须上线,要求产品经理和老板共同签署"风险接受确认",明确说明他们理解此时发布可能导致服务不可用的风险,并承担后果。同时做好回滚预案。关键是把"能不能发"的决策权交还给规则——不是 SRE 不让你发,是我们共同约定的 SLO 和错误预算策略在起作用。
Q3:你们团队有 6 个人,On-Call 轮值方案怎么设计?如果有人在 On-Call 期间收到告警但 10 分钟没响应,怎么办?
参考答案:6 人团队可以设计为:主备双岗,每人每周轮值作为主值班,同时下一周的人是备值班。这样每人每 6 周轮一次主值班,两次 On-Call 之间有 5 周恢复期。对于告警升级:主值班 5 分钟无 Ack → 自动升级到备值班;备值班 5 分钟无 Ack → 升级到 Tech Lead;Tech Lead 5 分钟无 Ack → 升级到 EM。整个升级链可配置在 PagerDuty/Alertmanager 中。另外,要建立"On-Call 健康度"指标——如果某人的 Ack 率持续低于 80%,需要和 ta 一对一沟通,了解是倦怠、工具问题还是个人情况。
Q4:你说复盘要无责,但如果事故确实是因为某人明显违规操作(比如跳过了 code review 直接上线、在生产环境上手动执行了未测试的 SQL),你怎么做复盘?
参考答案:这是一个很好的问题,触及了无责复盘的边界。即使是"明显违规操作",无责复盘的思路仍然是问"为什么系统允许这种情况发生"。比如:为什么一个人可以跳过 code review 直接上线?为什么生产数据库的权限没有限制?为什么危险操作没有二次确认机制?复盘要区分"个人责任"和"系统责任"——如果是个人蓄意破坏,那是 HR 纪律问题;如果是好心办了坏事,系统应该设计成让"好心"不会导致"坏事"。但这不意味着没有后果——如果存在明显的流程违规,应该在复盘之外(一对一)进行反馈和 coaching。复盘的公开报告中仍然聚焦系统改进。
Q5:你如何衡量一个 SRE 应急响应体系的成熟度?
参考答案:可以从几个维度评估:
- MTTD(Mean Time to Detect):从故障发生到被检测到的平均时间。成熟体系 < 1 分钟(自动检测),不成熟体系可能靠用户投诉才发现。
- MTTR(Mean Time to Resolve):从检测到恢复的平均时间。成熟体系 P1 事故 < 30 分钟。
- 告警信噪比:真正需要人工响应的告警占比。成熟体系 > 70%,不成熟体系 < 30%。
- On-Call 健康度:人均每周告警数、非工作时间告警占比、On-Call 人员满意度。
- 复盘闭环率:Action Items 在约定时间内完成的比例。成熟体系 > 90%。
- 错误预算管理:是否按照错误预算状态自动化控制发布节奏。
- 混沌工程成熟度:是否定期进行故障演练,验证应急响应能力。
本文是"Java 技术专家与架构师面试:250 个高频考点总览"系列的第 224 篇。下一篇预告:225|认证与授权:Authentication/Authorization、RBAC、ABAC 和最小权限。