一、引言:内存持续增长的"温水煮青蛙"效应
与 OOM(OutOfMemoryError)崩溃不同,内存持续增长更像"温水煮青蛙"。应用不会立刻崩溃,而是内存曲线缓慢爬升,GC 频率逐渐增加,最终在某一天突然不可用。这类问题之所以棘手,是因为:
- 时间跨度长:可能从几个小时到几天才暴露
- 触发条件模糊:往往与特定流量模式、定时任务、缓存过期策略耦合
- 监控盲区:堆内存有 GC 日志和 Heap Dump 可查,但堆外、本地内存长期处于"灰色地带"
本文从 JVM 内存模型的全景视角出发,逐一剖析堆内、堆外、缓存、线程、本地内存等各维度的增长根因,并给出可落地的排查工具链和实战案例。
二、JVM 内存全景图:你看到的只是冰山一角
在深入排查之前,必须建立完整的内存视图。JVM 进程占用的内存远不止 -Xmx 指定的堆大小。
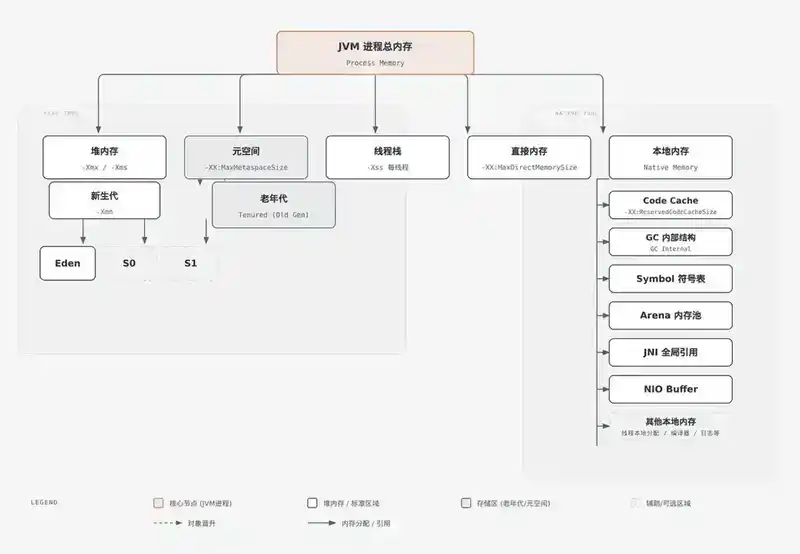
经验公式:JVM 进程总内存 ≈ -Xmx + -XX:MaxMetaspaceSize + 线程数 × (-Xss) + -XX:MaxDirectMemorySize + Code Cache + GC 内部结构 + JNI 分配 + ...
一个典型的 4 核 8G 应用:-Xmx4g -Xss1m,500 个线程的线程栈就占 500MB,加上 Metaspace 256MB、Direct Memory 256MB、Code Cache 240MB,总内存轻松超过 5.5GB。如果容器只分配了 6GB,剩余空间非常紧张。
三、堆内内存增长排查:GC 日志不会说谎
堆内内存增长是最常见的场景,排查手段相对成熟。
3.1 第一步:确认是堆内还是堆外
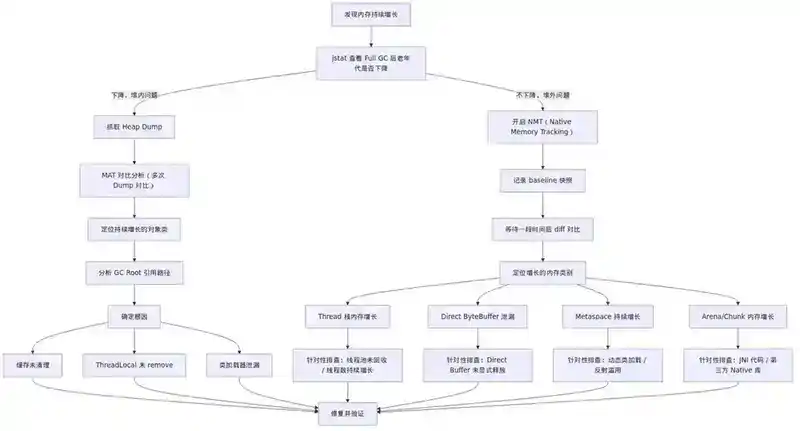
在动手分析之前,先确认增长的"主战场":
# 查看堆内存使用趋势
jstat -gcutil <pid> 1000  # 每秒输出一次 GC 统计

# 关键指标:
# OU(Old Gen usage)持续上升,FGC 后仍不下降 → 堆内泄漏
# FGC 后 OU 显著下降,但很快又涨回来 → 可能是缓存/业务正常增长
# 堆内存曲线平稳,但进程 RSS 持续上涨 → 堆外/本地内存泄漏
判断标准:如果 Full GC 后老年代使用率能回到一个稳定的基线,说明堆内对象是可回收的,问题在堆外;如果 Full GC 后老年代使用率持续升高,说明堆内存在泄漏。
3.2 堆内泄漏的三大根因
根因一:被遗忘的引用
// 经典错误:HashMap 作为缓存但从不清理
public class OrderService {
    // 静态 Map,类加载后永不释放
    private static final Map<String, Order> ORDER_CACHE = new HashMap<>();

    public Order getOrder(String id) {
        return ORDER_CACHE.computeIfAbsent(id, this::loadFromDB);
    }
}
这个 ORDER_CACHE 会随着访问的订单越来越多而无限增长,直到 OOM。HashMap 的 key 和 value 都是强引用,只要 Map 本身不被 GC,所有条目都永远存活。
根因二:类加载器泄漏
这是最难排查的堆内泄漏类型之一。当自定义 ClassLoader 加载的类无法被卸载时,该 ClassLoader 及其加载的所有类、所有静态字段引用的对象,全部成为"僵尸对象"。
// 典型场景:动态代理/热部署框架
// 每次重新加载服务,都创建新的 ClassLoader
// 但旧 ClassLoader 因为某个线程的 contextClassLoader 引用而无法被 GC
排查方法:在 MAT 中搜索 ClassLoader → 查看 Retained Heap → 找到最大的 ClassLoader 实例 → 追溯 GC Root 路径。
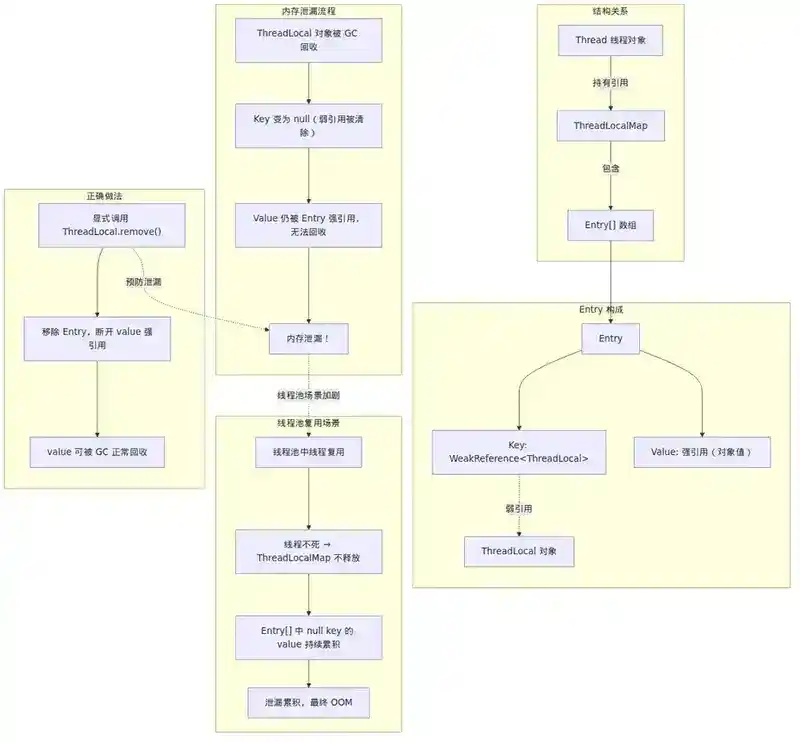
根因三:ThreadLocal 未清理
// 线程池中使用 ThreadLocal 必须显式 remove()
public class UserContext {
    private static final ThreadLocal<User> CURRENT_USER = new ThreadLocal<>();

    public static void setUser(User user) {
        CURRENT_USER.set(user);
    }
    // 忘记调用 remove(),线程复用后 ThreadLocal 值永远存在
}
当线程池中的线程被复用时,ThreadLocalMap 中的 Entry 不会被清理。对于 Tomcat 等 Web 容器,每个请求线程如果不清理 ThreadLocal,就会导致用户对象随着请求累积而不断增长。
3.3 Heap Dump 对比分析
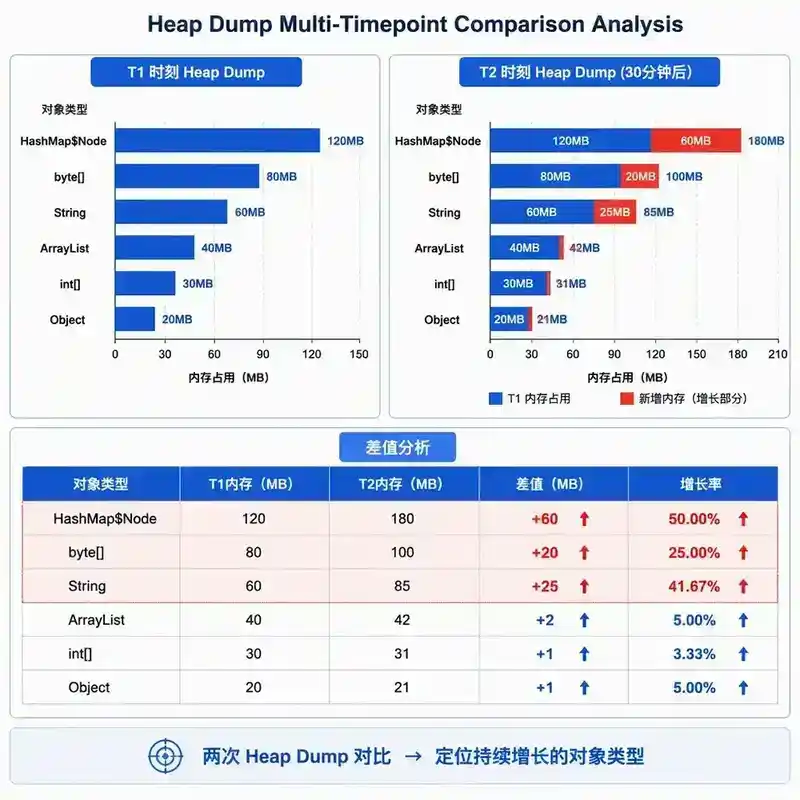
单次 Heap Dump 只能看到"当前状态",无法判断"增长趋势"。对于持续增长问题,需要至少两次 Heap Dump:
# 间隔 30 分钟分别抓取 Heap Dump
jmap -dump:live,format=b,file=heap1.hprof <pid>
# 等待 30 分钟
jmap -dump:live,format=b,file=heap2.hprof <pid>
在 MAT 中分别打开两次 dump,对比 "Histogram" 视图:
- 按
Retained Heap排序 - 找出两次 dump 之间 Retained Heap 增长最大的类
- 对该类做 "Merge Shortest Paths to GC Roots" 分析
关键技巧:关注 byte[ ]、char[ ]、String、HashMap$Node、Object[ ] 这些"容器类"的增长。如果 byte[ ] 占据了大量 Retained Heap,通常是缓存了大量数据;如果 HashMap$Node 暴涨,可能是某个 Map 在不断膨胀。
四、缓存:最大的"隐形杀手"
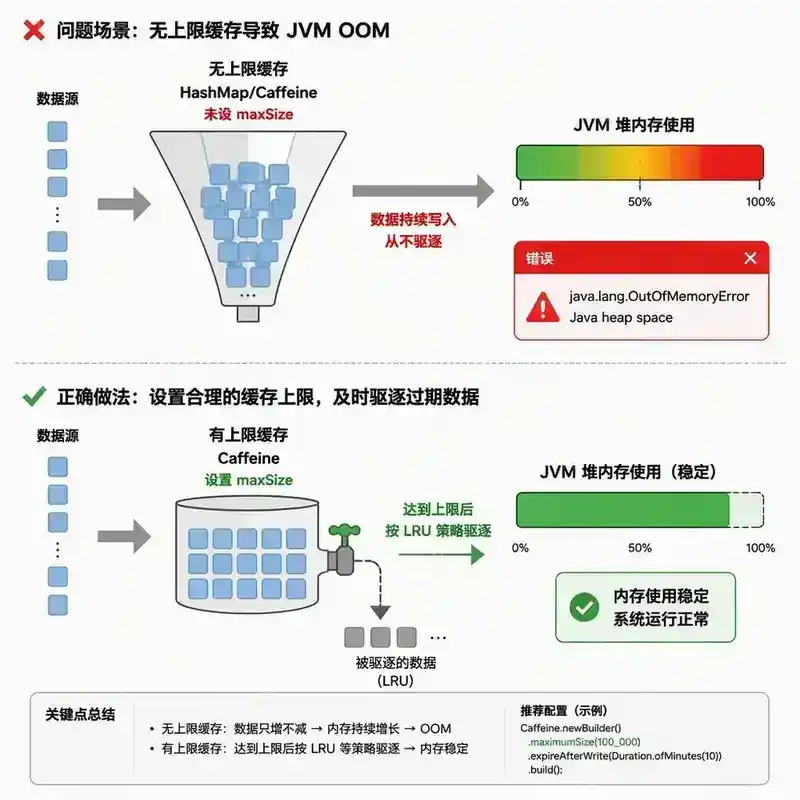
缓存是内存持续增长的"头号嫌犯"。在排查内存问题时,先检查所有缓存配置,往往能事半功倍。
4.1 本地缓存的常见陷阱
Guava Cache / Caffeine 配置不当
// 危险配置:没有最大大小限制
Cache<String, Object> cache = Caffeine.newBuilder()
    .expireAfterWrite(10, TimeUnit.MINUTES)  // 只有时间过期
    .build();
// 如果 10 分钟内写入 1000 万条 → 内存爆炸

// 正确配置:大小限制 + 时间过期双重保障
Cache<String, Object> cache = Caffeine.newBuilder()
    .maximumSize(10_000)                     // 硬性条目上限
    .expireAfterAccess(5, TimeUnit.MINUTES)  // 访问过期
    .expireAfterWrite(30, TimeUnit.MINUTES)  // 写入过期
    .recordStats()
    .build();
Caffeine 的 maximumSize 和 maximumWeight 是强制的:超过限制后会自动驱逐。但 expireAfterWrite 不是强制的——它只在访问时惰性检查。如果某个 key 写入后从未被访问,它会在内存中一直存在直到触发 maximumSize 驱逐。
WeakHashMap 的陷阱
// WeakHashMap:key 是弱引用,但 value 是强引用!
WeakHashMap<Key, BigObject> map = new WeakHashMap<>();
Key k = new Key("id");
map.put(k, new BigObject());  // 1MB 的对象
k = null;                     // key 失去引用
System.gc();                  // key 被回收
// 但 BigObject 仍然在 WeakHashMap 的内部 Entry 中!
// 需要等到下次对 map 的操作(get/put/size)才会清理 stale entry
WeakHashMap 的过期条目清理是被动触发的,只在 get、put、size 等操作时顺便清理。如果 Map 长期没有操作,内存不会被释放。
4.2 缓存排查工具
# 通过 JMX 查看 Guava/Caffeine 缓存统计
# 关注:size、hitRate、evictionCount
# 如果 size 持续增长而 evictionCount 为 0 → 缓存无上限或上限过大

# Arthas 查看缓存实例
vmtool --action getInstances --className com.github.benmanes.caffeine.cache.BoundedLocalCache --limit 10
4.3 Redis 客户端缓存注意
虽然 Redis 本身是外部存储,但 Jedis/Lettuce 客户端也有内存占用:
- 连接池中的连接对象
- 序列化/反序列化缓冲区
- 集群拓扑信息缓存
对于大 Value 场景,单次反序列化可能产生大量临时对象,导致 Young GC 压力增大。
五、线程栈内存与线程泄漏
线程栈内存经常被忽视,但在高并发应用中,它可能成为本地内存的"大户"。
5.1 线程栈默认大小
| JDK 版本 | 平台 | 默认 -Xss |
|---|---|---|
| JDK 8 | Linux x64 | 1024 KB |
| JDK 11+ | Linux x64 | 1024 KB |
| JDK 8 | macOS x64 | 1024 KB |
计算公式:线程栈总内存 = 线程数 × 线程栈大小
如果有 1000 个线程,每个线程栈 1MB,仅线程栈就占用 1GB 内存,且这部分内存不在堆内,由操作系统直接分配。
5.2 线程泄漏的常见场景
// 场景一:每次请求创建新线程(极端错误)
@GetMapping("/api")
public String handle() {
    new Thread(() -> {
        // 处理业务
    }).start();  // 线程执行完就死了,但高并发下瞬时创建大量线程
    return "ok";
}

// 场景二:线程池无限增长
ExecutorService executor = Executors.newCachedThreadPool();
// CachedThreadPool 的最大线程数是 Integer.MAX_VALUE!
// 当任务提交速度 > 处理速度时,线程数无限增长

// 场景三:线程池拒绝策略不当
ThreadPoolExecutor pool = new ThreadPoolExecutor(
    10, 20, 60L, TimeUnit.SECONDS,
    new LinkedBlockingQueue<>()  // 无界队列!
);
// 核心线程忙时,任务进入无界队列,队列无限增长导致堆内存 OOM
5.3 线程泄漏排查
# 查看当前线程数
jstack <pid> | grep "^Thread" | wc -l

# 或者
jcmd <pid> Thread.print | grep "^Thread" | wc -l

# 查看线程状态分布
jstack <pid> | grep "java.lang.Thread.State" | sort | uniq -c

# 通过 NMT 查看线程栈内存
jcmd <pid> VM.native_memory summary
# 关注 Thread 部分的 committed 值
关键判断:如果线程数随时间线性增长,且线程状态多为 WAITING 或 TIMED_WAITING,说明线程池在无限制创建线程但任务处理不过来。
六、堆外内存(Direct Memory):Netty 的"双刃剑"
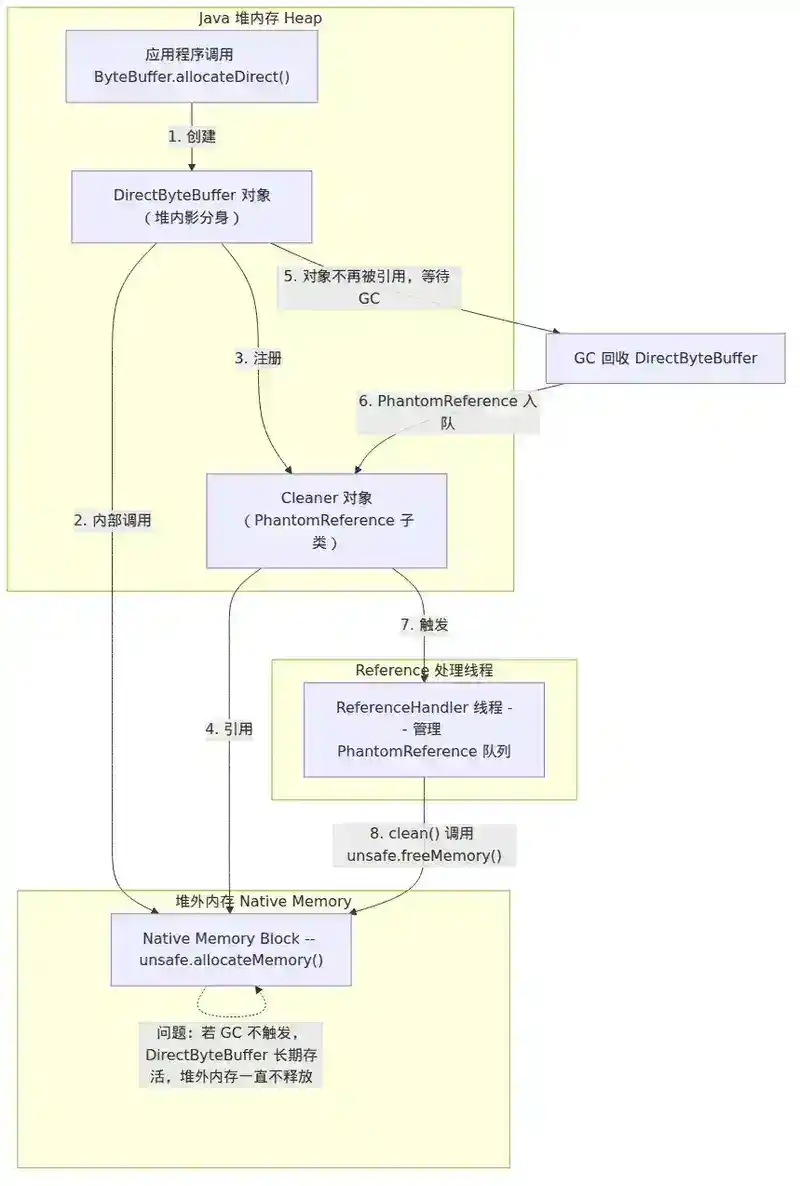
堆外内存(Direct Memory)通过 ByteBuffer.allocateDirect() 分配,不受 JVM 堆大小限制,GC 不直接管理,但受 -XX:MaxDirectMemorySize 限制。
6.1 Direct Memory 的回收机制
Direct Memory 的回收依赖 Cleaner 机制:DirectByteBuffer 对象在堆内有一个"影分身",当堆内的 DirectByteBuffer 被 GC 回收时,其 Cleaner 会触发 unsafe.freeMemory() 释放堆外内存。
问题所在:如果堆内存足够大,Young GC 很少触发,堆内的 DirectByteBuffer 对象一直存活在 Old Gen,堆外内存就一直不被释放。这就是为什么 Direct Memory 泄漏往往伴随着"堆内存正常,但进程 RSS 持续上涨"的现象。
# 查看 Direct Memory 使用情况
jcmd <pid> VM.native_memory summary
# 或使用 JMX:
# java.nio:type=BufferPool,name=direct
6.2 Netty 内存池与泄漏检测
Netty 使用自己的内存池(PooledByteBufAllocator)管理堆外内存,以提高性能。但使用不当容易泄漏:
// 危险:ByteBuf 未释放
public void handle(ChannelHandlerContext ctx, Object msg) {
    ByteBuf buf = (ByteBuf) msg;
    // 处理业务...

    byte[ ] data = new byte[buf.readableBytes()];

    buf.readBytes(data);
    // 忘记调用 ReferenceCountUtil.release(buf) 或 buf.release()
    // 引用计数永远不会归零,内存永远不会释放
}

// 正确做法
public void handle(ChannelHandlerContext ctx, Object msg) {
    ByteBuf buf = (ByteBuf) msg;
    try {

        byte[ ] data = new byte[buf.readableBytes()];

        buf.readBytes(data);
        // 处理业务...
    } finally {
        ReferenceCountUtil.release(buf);
    }
}
Netty 提供了内存泄漏检测级别:
# 开启高级泄漏检测(开发/测试环境)

- Dio.netty.leakDetection.level=PARANOID

# 级别:DISABLED < SIMPLE < ADVANCED < PARANOID
# PARANOID 会采样所有 ByteBuf,开销较大
6.3 堆外内存泄漏排查工具
# 使用 jcmd 查看 Direct ByteBuffer 相关统计
jcmd <pid> GC.run              # 先触发一次 Full GC
jcmd <pid> VM.native_memory summary.diff  # 对比 GC 前后的差异

# 使用 pmap 查看进程内存映射
pmap -x <pid> | sort -k3 -nr | head -20

# 使用 gperftools(Google Performance Tools)
# 适用于排查本地内存分配热点
LD_PRELOAD=/usr/lib/libtcmalloc.so HEAPPROFILE=/tmp/heap.prof java -jar app.jar
七、元空间(Metaspace):被忽视的增长源
元空间(Metaspace)存储类的元数据,位于堆外本地内存。JDK 8+ 默认不限制大小,但容器内存有限时,元空间的持续增长可能导致进程被 OOM Killer 杀死。
7.1 元空间增长的常见原因
动态类生成:
// Groovy 脚本引擎反复创建类
GroovyShell shell = new GroovyShell();
for (int i = 0; i < 100000; i++) {
    Script script = shell.parse("def foo() { return " + i + " }");
    script.run();  // 每次 parse 生成一个新类
}
// 100000 个类被加载到 Metaspace,无法卸载
Lambda 表达式:每个 Lambda 表达式在运行时生成一个匿名类。如果 Lambda 在循环中动态创建(如 Stream.map(x -> ...) 不是问题,但动态生成 Lambda 的工厂模式可能有问题)。
CGLIB / Javassist 动态代理:Spring AOP、MyBatis Mapper 等大量使用动态代理,每次代理创建一个新类。
Reflections 库扫描:org.reflections 库在扫描 classpath 时可能加载大量类。
7.2 元空间排查
# 查看元空间使用
jstat -gc <pid> 1000
# 关注 MU(Metaspace Used)和 MC(Metaspace Capacity)

# 查看类加载统计
jcmd <pid> GC.class_stats | head -100

# 设置元空间上限,让问题尽早暴露

- XX:MaxMetaspaceSize=256m

- XX:MetaspaceSize=128m

# 开启类加载/卸载日志

- XX:+TraceClassLoading

- XX:+TraceClassUnloading
八、本地内存(Native Memory):最隐蔽的泄漏源
本地内存泄漏是最难排查的,因为它在 JVM 的"管辖范围"之外。
8.1 常见本地内存泄漏源
JNI 调用:如果 JNI 代码在本地分配了内存但没有释放,Java 侧完全无法感知。
// JNI 错误示例
JNIEXPORT void JNICALL Java_Example_process(JNIEnv *env, jclass cls, jbyteArray data) {
    jsize len = (*env)->GetArrayLength(env, data);
    char *buf = (char *)malloc(len);  // 本地分配
    (*env)->GetByteArrayRegion(env, data, 0, len, (jbyte *)buf);
    // 处理...
    // 忘记 free(buf); → 本地内存泄漏
}
ZIP 压缩/解压:java.util.zip.Inflater 和 Deflater 内部使用本地内存。如果不调用 end() 方法,本地内存不会被释放。
// 错误:Inflater 未释放本地内存

public byte[ ] decompress(byte[ ] data) throws Exception {

    Inflater inflater = new Inflater();
    inflater.setInput(data);

    byte[ ] result = new byte[1024];

    inflater.inflate(result);
    inflater.end();  // 必须调用!否则本地内存泄漏
    return result;
}
JIT 编译的 Code Cache:-XX:ReservedCodeCacheSize 默认 240MB。当 Code Cache 满了,JIT 会停止编译,性能下降但不会直接报错。
8.2 本地内存排查工具
# NMT 是排查本地内存的首选工具
# 启动时开启 NMT

- XX:NativeMemoryTracking=summary  # 或 detail

# 查看 NMT 摘要
jcmd <pid> VM.native_memory summary

# 建立基线,运行一段时间后对比
jcmd <pid> VM.native_memory baseline
jcmd <pid> VM.native_memory summary.diff
九、NMT(Native Memory Tracking)实战:从数据到结论
NMT 是 JDK 内置的本地内存追踪工具,但很多工程师不会用或看不懂输出。
9.1 NMT 输出解读
$ jcmd 12345 VM.native_memory summary

Native Memory Tracking:

Total: reserved=5580267KB, committed=3123456KB

-       Java Heap (reserved=4194304KB, committed=2097152KB)
                (mmap: reserved=4194304KB, committed=2097152KB)

-           Thread (reserved=258048KB, committed=258048KB)
                (thread #252)
                (stack: reserved=256000KB, committed=256000KB)

-          Metaspace (reserved=131072KB, committed=126400KB)

-              Arena (reserved=1024KB, committed=24KB)

-       Direct Buffer (reserved=65536KB, committed=65536KB)
关键解读:
reserved:JVM 向操作系统"预订"的地址空间,不一定实际占用物理内存committed:实际分配的物理内存(或 swap),这是真正消耗的内存Thread部分:252 个线程 × 约 1MB 栈 = 258MB,符合预期Direct Buffer:如果 committed 接近-XX:MaxDirectMemorySize,说明堆外 Buffer 使用量大
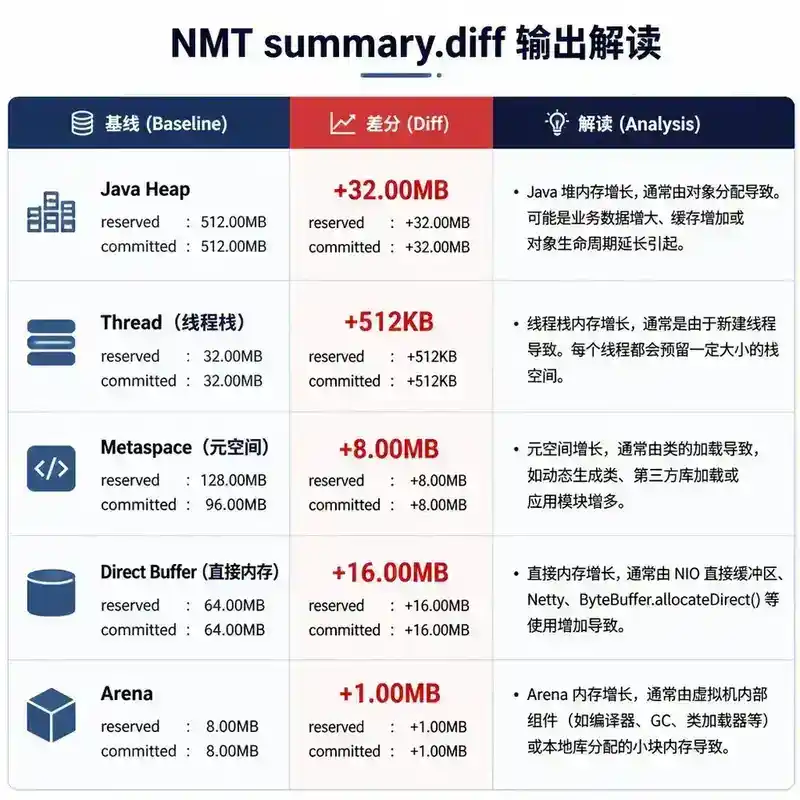
9.2 diff 模式:定位增长源
# 建立基线
jcmd <pid> VM.native_memory baseline

# 等待 30 分钟(内存持续增长期间)

# 对比差异
jcmd <pid> VM.native_memory summary.diff

# 输出示例:
# + Direct Buffer (reserved=+32768KB, committed=+32768KB)
# + Arena (reserved=+512KB, committed=+256KB)

# 如果 Direct Buffer 增长了 32MB,而 Metaspace 和 Heap 变化不大
# → 堆外内存泄漏,重点排查 Netty/DirectByteBuffer
十、对比分析:多时间点 Heap Dump 的差值定位
这是内存持续增长排查的"杀手锏"技术。
10.1 操作步骤
- 在增长过程中每隔 N 分钟抓取一次 Heap Dump(至少 3 次)
- 使用 MAT 打开每次 dump,在 Histogram 中按
Retained Heap排序 - 导出每个类的 instance count 和 total size
- 计算相邻两次 dump 的差值,找出持续增长的类
# 使用 MAT 命令行导出 Histogram CSV
# 路径:MAT 安装目录/ParseHeapDump.sh
./ParseHeapDump.sh heap1.hprof org.eclipse.mat.api:suspects
./ParseHeapDump.sh heap1.hprof org.eclipse.mat.api:top_components
10.2 增长模式分析
| 增长模式 | 特征 | 可能原因 |
|---|---|---|
HashMap$Node 持续增长 |
某个 Map 的条目数在不断增加 | 缓存无上限 |
| byte[ ] 持续增长 | 大量字节数组无法释放 | 大对象缓存、Netty 缓冲区 |
| String 持续增长 | 字符串对象不断创建 | 字符串拼接、日志收集 |
| 自定义类实例持续增长 | 某种业务对象不断累积 | 内存泄漏、未关闭的资源 |
| 类加载器数量持续增长 | ClassLoader 实例数增加 | 动态类加载、热部署重复 |
10.3 从可疑类到 GC Root 路径
MAT 中选中可疑类 → List objects → with outgoing references → 选中一个实例 → Path to GC Roots → exclude weak/soft/phantom references。
这条路径会告诉你为什么这个对象不能被 GC。如果路径最终指向一个静态字段或线程局部变量,那就是泄漏点。
十一、实战案例:一个真实的内存持续增长排查全过程
背景
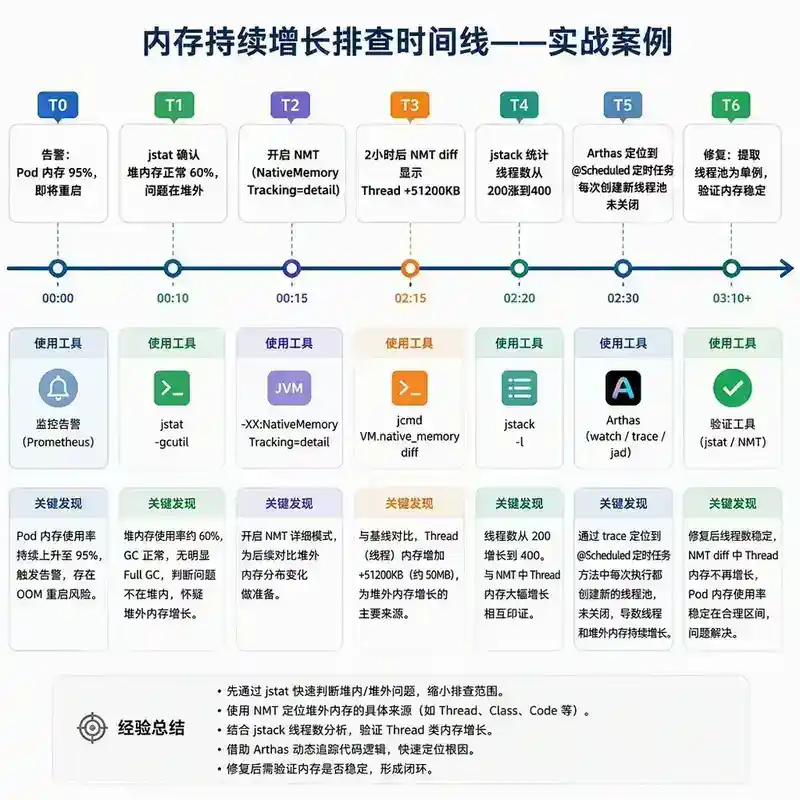
某电商订单服务,分配 8GB 容器内存,JVM 参数 -Xmx4g -Xms4g。上线后每 3 天内存使用率达到 95%,触发容器重启。监控显示堆内存使用率在 60% 左右,但进程 RSS 超过 7.5GB。
排查过程
Step 1:确认增长不在堆内
jstat -gcutil <pid> 1000
# OU 稳定在 60%,FGC 后能回到 40%
# 结论:堆内不是问题,问题在堆外
Step 2:开启 NMT 定位
# 重启应用,添加 NMT 参数

- XX:NativeMemoryTracking=detail

# 运行 1 小时后对比
jcmd <pid> VM.native_memory baseline
# 等待 2 小时
jcmd <pid> VM.native_memory summary.diff

# 结果:
# + Thread (reserved=+51200KB, committed=+51200KB)  ← 线程数增长了 50 个!
# + Direct Buffer (reserved=+8192KB, committed=+8192KB)
Step 3:追查线程增长
# 每隔 10 分钟统计线程数
watch -n 600 "jstack <pid> | grep '^Thread' | wc -l"
# 线程数从 200 增长到 300、400...

# 查看线程名模式
jstack <pid> | grep "^Thread" | awk -F'"' '{print $2}' | sort | uniq -c | sort -rn
# 发现大量 "pool-XX-thread-YY" 线程
Step 4:定位线程池泄漏代码
# 使用 Arthas 查看线程池
thread --all | grep pool

# 找到了:某个定时任务每次执行时创建新的 ScheduledThreadPoolExecutor
# 但从未调用 shutdown()
根因
@Scheduled(fixedDelay = 60000)
public void syncData() {
    // BUG:每次执行创建新线程池,从不关闭
    ScheduledExecutorService executor = Executors.newScheduledThreadPool(4);
    for (DataBatch batch : getBatches()) {
        executor.schedule(() -> processBatch(batch), 10, TimeUnit.SECONDS);
    }
    // 忘记 executor.shutdown()
}
修复
将线程池提取为单例,或者使用 @Scheduled 配合 @Async 共享线程池。
总结
这个案例的排查路径:堆内存正常 → 进程 RSS 上涨 → 开启 NMT → 发现 Thread 部分增长 → 线程数统计 → 定位线程池泄漏。
十二、总结与排查清单
排查工具箱
| 工具 | 用途 | 命令示例 |
|---|---|---|
| jstat | 堆内存、GC 实时监控 | jstat -gcutil &lt;pid&gt; 1000 |
| jmap | Heap Dump 抓取 | jmap -dump:live,format=b,file=heap.hprof &lt;pid&gt; |
| jstack | 线程栈抓取 | jstack &lt;pid&gt; &gt; thread.dump |
| jcmd NMT | 本地内存追踪 | jcmd &lt;pid&gt; VM.native&#95;memory summary.diff |
| MAT | Heap Dump 分析 | 支配树、Histogram、GC Root 路径 |
| Arthas | 在线诊断 | dashboard, thread, vmtool |
| pmap | 进程内存映射 | pmap -x &lt;pid&gt; |
| gperftools | 本地内存分配热点 | LD&#95;PRELOAD=libtcmalloc.so |
排查清单
- ☐ 确认问题类型:堆内还是堆外?(jstat 看 GC 后 OU 是否下降)
- ☐ 堆内 → 抓 Heap Dump → MAT 分析 → 两次对比找增长类 → GC Root 路径
- ☐ 缓存 → 检查所有 Guava/Caffeine 缓存的 maxSize 配置
- ☐ ThreadLocal → 检查线程池中是否有未 remove 的 ThreadLocal
- ☐ 线程 → 统计线程数趋势,检查线程池创建和关闭
- ☐ 堆外 → 开启 NMT → baseline → diff → 定位增长类别
- ☐ Direct Memory → 检查 Netty/ByteBuf 的 release 调用
- ☐ Metaspace → 检查动态类加载、Groovy、CGLIB 代理
- ☐ 本地内存 → 检查 JNI、Inflater/Deflater、ZIP 压缩
- ☐ Code Cache → 检查
-XX:ReservedCodeCacheSize是否合理
核心原则:先分堆内/堆外,再逐层排查。80% 的内存持续增长问题来自 20% 的常见原因:缓存无上限、ThreadLocal 未清理、线程池泄漏、DirectByteBuffer 未释放。
十三、面试问答
Q1:一个 Java 应用给 8GB 容器内存,JVM 参数**-Xmx6g -Xms6g**,为什么 Pod 还是被 OOM Kill 了?JVM 占用内存包括哪些部分?
A1:-Xmx6g 只限制了堆内存大小,但 JVM 进程占用的总内存远不止这些。还包括:
- Metaspace:存储类元数据,默认不限制,如果大量动态生成类,可能占用几百 MB
- 线程栈:每个线程默认 1MB 栈,如果有 500 个线程就是 500MB
- Direct Memory:
ByteBuffer.allocateDirect()分配的堆外内存,默认等于-Xmx - Code Cache:JIT 编译后的代码缓存,默认 240MB
- GC 内部结构:标记、压缩过程中的临时数据结构
- JNI 本地内存:JNI 调用中 malloc 的内存
粗略估算:6GB(堆)+ 256MB(Metaspace)+ 500MB(线程栈)+ 256MB(Direct Memory)+ 240MB(Code Cache)+ 其他 ≈ 7.5GB,留给操作系统的 buffer 不到 500MB,内存压力大时容易被 OOM Kill。
Q2:如何判断一个内存持续增长问题是堆内泄漏还是堆外泄漏?
A2:三步判断法:
- 触发 Full GC(
jcmd <pid> GC.run),观察老年代使用率是否回落到低位 - 如果 Full GC 后老年代使用率能回到稳定基线 → 堆内对象可回收,问题在堆外
- 如果 Full GC 后老年代仍居高不下 → 堆内存在泄漏,抓 Heap Dump 分析
对于堆外判断,开启 NMT(-XX:NativeMemoryTracking=detail),建立 baseline 后运行一段时间,用 summary.diff 对比,看哪个分类(Thread/Direct Buffer/Metaspace/Arena)的 committed 值在持续增长。
Q3:ThreadLocal 为什么会导致内存泄漏?JDK 是如何解决这个问题的?
A3:ThreadLocal 的内部实现是每个线程维护一个 ThreadLocalMap,Map 的 Entry 使用 WeakReference 包装 ThreadLocal 作为 key。当 ThreadLocal 对象失去强引用被 GC 回收后,Entry 的 key 变为 null,但 value 仍然是强引用。如果线程长期存活(如线程池中的线程),这些 key 为 null 的 Entry 永远不会被清理,value 对应的对象就泄漏了。
JDK 的改进:ThreadLocal.get()、set()、remove() 方法在操作时会顺便清理 key 为 null 的过期 Entry。但最可靠的方案还是显式调用**remove()**,尤其是在线程池场景中。
Q4:Netty 的 ByteBuf 内存泄漏如何排查?如果泄漏检测日志显示"LEAK:",但堆栈信息不完整怎么办?
A4:Netty 的内存泄漏检测依赖于采样和引用队列。当 ByteBuf 的引用计数未归零且 GC 触发了 Cleaner 时,泄漏检测器会记录"LEAK:"日志。堆栈信息不完整的原因通常是:
- 泄漏检测级别不够高(SIMPLE 模式不记录堆栈)
- 创建 ByteBuf 的调用栈在采样范围之外
解决方案:
- 设置
-Dio.netty.leakDetection.level=PARANOID,对所有 ByteBuf 采样 - 设置
-Dio.netty.leakDetection.targetRecords=N增加记录的堆栈帧数 - 使用
io.netty.util.ResourceLeakDetector的setLevel()方法在运行时动态调整
Q5:Caffeine Cache 配置了**expireAfterWrite(10, TimeUnit.MINUTES)**但没有配置**maximumSize**,有什么风险?
A5:expireAfterWrite 只是标记条目在写入 10 分钟后"过期",但 Caffeine 的过期处理是惰性的——只在访问时检查并清理。如果缓存中的条目写入后从未被再次访问,它们会一直占用内存,直到 JVM 堆满触发 OOM。
此外,expireAfterWrite 不影响缓存的大小控制。在流量峰值时,10 分钟内可能写入数百万条记录,远超预期。正确的做法是组合使用 maximumSize() 和 expireAfterWrite(),前者是硬性限制(强制驱逐),后者是软性优化(减少不必要的数据保留)。
Q6:元空间(Metaspace)和永久代(PermGen)有什么区别?为什么 JDK 8 要做这个替换?
A6:主要区别:
- 存储位置:PermGen 在堆内,Metaspace 在本地内存(堆外)
- 大小限制:PermGen 通过
-XX:MaxPermSize限制,默认很小(约 82MB);Metaspace 默认不限制,受限于系统可用内存 - GC 行为:PermGen 在 Full GC 时回收;Metaspace 在类加载器被回收时释放,GC 不直接管理
- 字符串常量池:JDK 7 开始字符串常量池移到堆中,不在 PermGen/Metaspace 中
JDK 8 替换的原因:PermGen 大小难以预估,固定大小容易导致 OOM: PermGen space;Metaspace 利用本地内存,更灵活,减少了 PermGen OOM 的风险。但同时也带来了新问题:如果不设置 -XX:MaxMetaspaceSize,动态类加载泄漏可能导致本地内存耗尽。