阅读时间:约 40-50 分钟 | 难度:中高级 | 分类:可观测性
一、问题起源:为什么需要分布式链路追踪
2010 年前后,Google 发表了 Dapper 论文,正式将"分布式链路追踪"这个概念推向业界。在此之前的监控体系主要依赖两种手段:
黑盒监控:在网卡层面抓包分析延迟,或者靠外部探头发起 HTTP 请求测响应时间。这种方式能看到"慢了",但不知道"哪里慢了"——就像你知道快递从北京到上海花了 3 天,但不知道是卡在分拣中心还是中转站。
白盒监控:每个服务独立打日志、暴露 Metrics。这是进步,但在微服务架构下产生了新问题:一个用户请求可能经过 10+ 个服务,每个服务独立记录自己的日志,这些日志散落在不同机器上,彼此之间没有关联 ID。当线上出问题时,你面对的是 10 个服务的日志文件,却无法把它们串成一条完整的调用链。
设想这样一个场景:用户反馈"下单接口超时"。你的系统架构是 API Gateway → 订单服务 → 库存服务 → 支付服务 → 物流服务。每个服务都正常运行,Metrics 面板显示 P99 延迟都在 50ms 以内。但用户的请求确实超时了——因为慢的不是某个服务,而是某条特定调用链上的累积延迟。
这就是分布式链路追踪要解决的核心问题:在分布式系统中,将一个请求涉及的所有服务调用串联起来,还原完整的调用路径和每个环节的耗时。
二、核心概念:Trace 与 Span
2.1 Trace:一条完整的调用链
Trace 代表一次完整的请求在分布式系统中的全生命周期。从用户点击"下单"按钮,到最终返回结果,这中间所有服务间的调用都属于同一个 Trace。
Trace 由全局唯一的 traceId 标识。这个 ID 在请求入口处生成,然后随调用链一路传递,无论经过多少个服务,traceId 始终不变。
2.2 Span:调用链上的一个片段
Span 是 Trace 的基本组成单元,代表一次独立的操作或调用。一个 Trace 由多个 Span 组成,Span 之间通过父子关系形成调用树。
每个 Span 包含以下关键信息:
| 字段 | 说明 | 示例 |
|---|---|---|
traceId |
所属 Trace 的全局唯一标识 | a1b2c3d4e5f6... |
spanId |
当前 Span 的唯一标识 | x1y2z3... |
parentSpanId |
父 Span 的标识(根 Span 无此字段) | x1y2z3... |
operationName |
操作名称,描述这个 Span 在做什么 | GET /api/order/create |
startTime |
操作开始时间戳 | 1715760000000000 |
duration |
操作耗时(微秒) | 52300 |
status |
操作状态(OK / Error) | OK |
tags |
键值对形式的标签,用于搜索和过滤 | http.status_code=200 |
logs |
时间点事件(带时间戳的日志) | "开始查询数据库" |
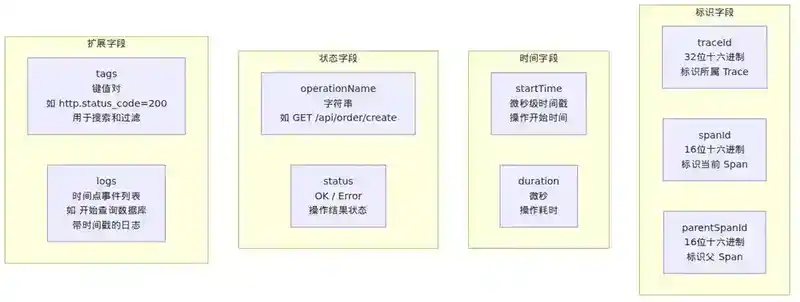
2.3 Span 之间的关系
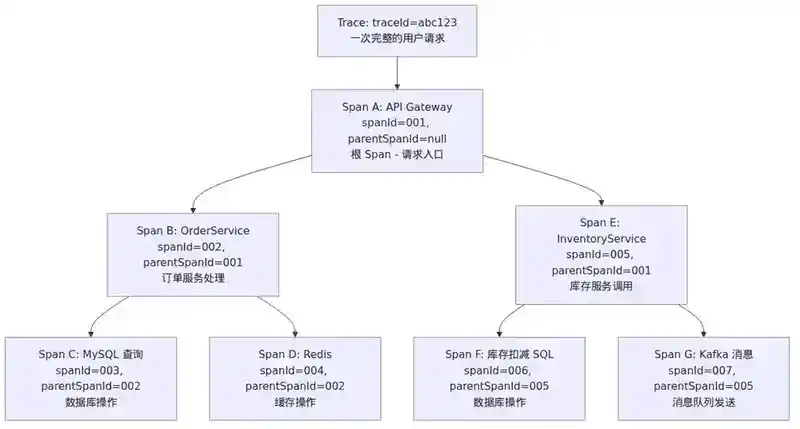
一个典型的微服务调用链的 Span 关系如下:
Trace: traceId=abc123
│
├── Span A (spanId=001, parentSpanId=null)  ← 根 Span,API Gateway 接收请求
│   ├── Span B (spanId=002, parentSpanId=001)  ← 订单服务处理
│   │   ├── Span C (spanId=003, parentSpanId=002)  ← 查询 MySQL
│   │   └── Span D (spanId=004, parentSpanId=002)  ← 调用 Redis
│   └── Span E (spanId=005, parentSpanId=001)  ← 调用库存服务(RPC)
│       ├── Span F (spanId=006, parentSpanId=005)  ← 库存扣减 SQL
│       └── Span G (spanId=007, parentSpanId=005)  ← 发送 Kafka 消息
从这个结构可以直观看出:Span A 是入口,它调用了订单服务(Span B)和库存服务(Span E)。Span B 内部又调用了 MySQL(Span C)和 Redis(Span D)。每个 Span 的 duration 加起来,就是整个请求的端到端延迟。
2.4 关键设计决策:Span 的粒度
Span 的粒度是一个需要权衡的设计决策:
- 太粗:一个 Span 覆盖整个 Service 方法,看不出内部瓶颈在哪
- 太细:每个 if-else 分支都创建一个 Span,产生海量数据,性能开销不可忽视
工程上的最佳实践是按逻辑边界划分子 Span:
- RPC 调用:每次跨服务调用,框架自动创建 Span
- 数据库操作:每次 SQL 执行
- 缓存操作:每次 Redis 命令
- 消息队列:每次消息发送/消费
- 关键业务逻辑:仅对耗时可能较大的业务方法手动埋点
三、上下文传播:让 traceId 穿越服务边界
3.1 核心问题
上下文传播(Context Propagation)是分布式链路追踪中最关键的技术环节。它的任务是:当请求从一个服务发往另一个服务时,如何将 traceId、spanId 等追踪信息携带过去。
没有上下文传播,每个服务会生成自己的 traceId,调用链就断裂了。
3.2 W3C TraceContext 标准
W3C 在 2020 年发布了 TraceContext 推荐标准,定义了统一的传播格式。它的核心是两个 HTTP Header:
traceparent: 00-0af7651916cd43dd8448eb211c80319c-b7ad6b7169203331-01
解析这个 Header:
| 部分 | 值 | 含义 |
|---|---|---|
version |
00 |
版本号 |
trace-id |
0af7651916cd43dd8448eb211c80319c |
32 位十六进制 traceId |
parent-id |
b7ad6b7169203331 |
16 位十六进制 spanId(父 Span) |
trace-flags |
01 |
采样标志(01=采样,00=不采样) |
第二个 Header 是 tracestate,用于传递厂商特定的键值对:
tracestate: vendor1=opaqueValue1,vendor2=opaqueValue2
3.3 传播过程详解
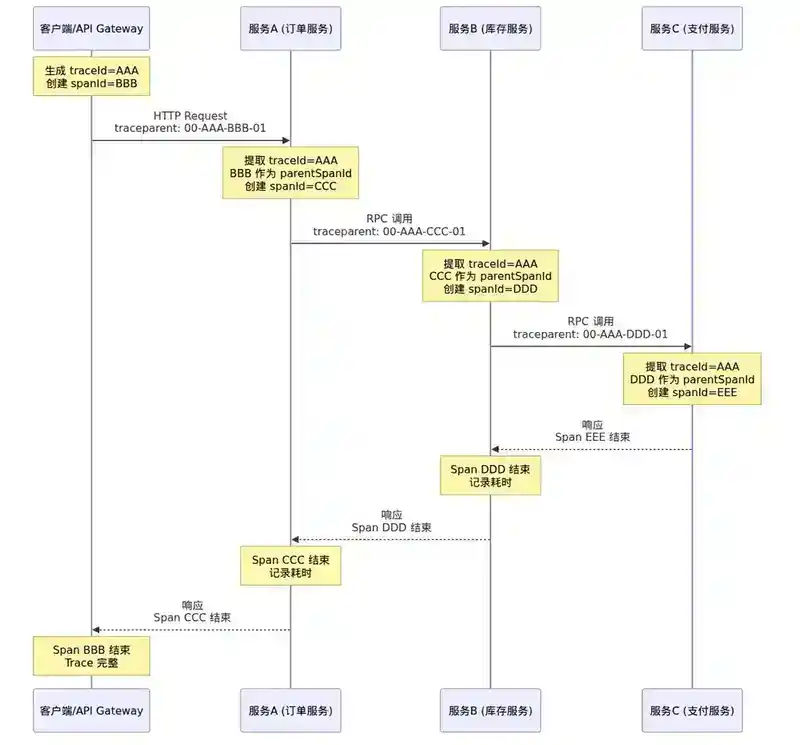
以一个包含三个服务的调用链为例:
步骤 1:客户端(或 API Gateway)发起请求
  生成 traceId=AAA, spanId=BBB
  HTTP Header: traceparent: 00-AAA-BBB-01

步骤 2:服务 A 收到请求
  提取 traceId=AAA, 将 BBB 作为 parentSpanId
  创建自己的 spanId=CCC
  调用服务 B 时,发送 Header: traceparent: 00-AAA-CCC-01

步骤 3:服务 B 收到请求
  提取 traceId=AAA, 将 CCC 作为 parentSpanId
  创建自己的 spanId=DDD
  返回响应给服务 A

步骤 4:服务 A 收到服务 B 的响应
  结束 Span CCC,记录耗时
  返回响应给客户端
关键点:traceId 在整个调用链中不变,但每个 Span 的 parentSpanId 在每次跨服务调用时都会更新为当前 Span 的 spanId。
3.4 传播方式:显式 vs 隐式
显式传播:将 traceId/spanId 直接放在协议头中,如 HTTP Header、gRPC Metadata。这是主流方式,因为协议本身承载了追踪信息,不依赖外部存储。
隐式传播:利用进程内的事件总线或线程本地存储传递上下文,不修改协议。这种方式对业务代码更透明,但跨进程传播时需要额外的协调机制。
3.5 Baggage:传递业务上下文
除了追踪信息,有时还需要在调用链上传递业务上下文(如租户 ID、用户 ID、AB 实验标识)。W3C 定义了 Baggage Header:
baggage: userId=alice,tenantId=cn-east-1,experiment=variantB
重要警告:Baggage 会随每个请求传输,数据量过大会显著增加网络开销。建议只传递关键的、轻量的上下文信息,避免将 Baggage 当成"分布式 HashMap"使用。
四、采样策略:平衡完整性与成本
4.1 为什么需要采样
在一个高吞吐的分布式系统中,每秒可能有数万甚至数十万次请求。如果对每个请求都进行全量追踪,会产生巨大的数据量:
- 一个请求平均产生 10 个 Span,每个 Span 约 1KB
- 10 万 QPS → 每秒 100 万个 Span → 每秒 1GB 数据
- 一天就是 86TB,存储成本惊人
采样的目标是在可接受的精度损失下,将追踪数据量控制在合理范围内。
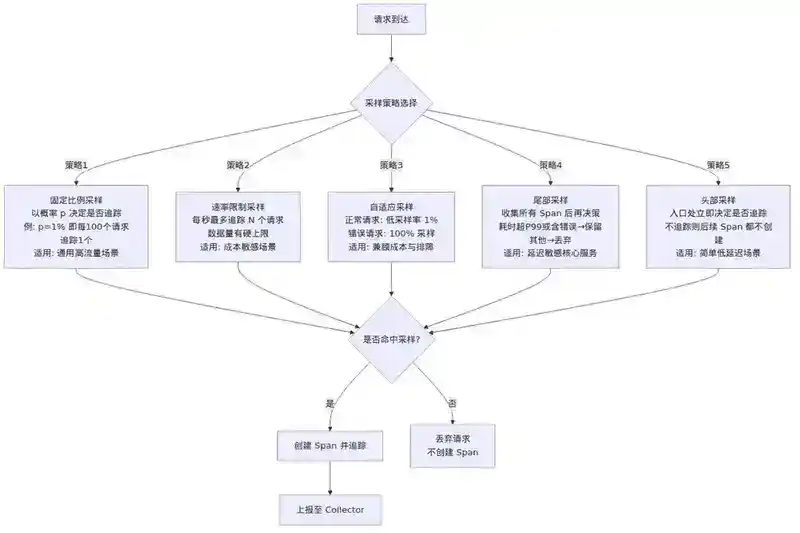
4.2 五种采样策略
1. 固定比例采样(Probabilistic Sampling)
最简单的策略:以固定概率 p 决定是否追踪一个请求。例如 p=1% 意味着每 100 个请求中追踪 1 个。
优点:实现简单,数据量可控
缺点:低流量服务可能采样不足,导致某些问题完全看不到
2. 速率限制采样(Rate Limiting Sampling)
设定每秒最多追踪 N 个请求。当系统 QPS 波动时,采样率自动调整。
优点:数据量有硬上限,不会因流量突增而撑爆存储
缺点:高流量时采样率可能极低,遗漏重要信息
3. 自适应采样(Adaptive Sampling)
根据请求的特征动态调整采样率。常见策略:正常请求采样 1%,错误请求采样 100%。
优点:保证异常请求不被遗漏,同时控制正常请求的数据量
缺点:需要在请求完成时才能判断是否异常,对尾部采样有要求
4. 尾部采样(Tail-based Sampling)
这是最强大也最复杂的策略。请求在所有 Span 收集完成后,根据完整调用链的特征决定是否保留。例如:
- 总耗时超过 P99 → 保留
- 调用链中包含错误 Span → 保留
- 调用了某个关键服务 → 保留
- 其他情况 → 丢弃
优点:基于完整信息做决策,保留最有价值的 Trace
缺点:需要在收集器端缓存所有 Span 直到决策完成,内存和延迟开销较大
5. 头部采样(Head-based Sampling)
在请求入口处(第一个 Span 创建时)就决定是否追踪。如果决定不追踪,后续所有 Span 都不创建。
优点:简单,无额外缓存开销
缺点:决策信息不完整,可能漏掉问题请求
4.3 采样策略选择建议
| 场景 | 推荐策略 |
|---|---|
| 开发/测试环境 | 全量采样(100%),方便调试 |
| 低流量生产环境 | 全量采样或高比例采样 |
| 高流量生产环境 | 头部采样(1%-10%)+ 错误强制采样 |
| 对延迟敏感的核心服务 | 尾部采样,确保慢请求被捕获 |
| 成本敏感 | 速率限制采样,严格控制数据量 |
五、性能开销:量化分析
5.1 开销来源
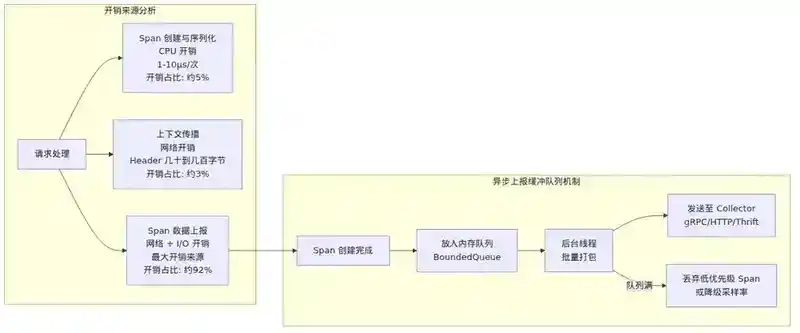
分布式链路追踪的开销主要来自三个方面:
1. Span 创建与序列化(CPU 开销)
每次创建 Span 涉及:生成唯一 ID(通常是随机数或雪花算法)、记录时间戳、序列化 Span 数据。现代实现中,这部分的单次耗时通常在微秒级(1-10μs)。对于大多数业务系统,这个开销可以忽略不计。
2. 上下文传播(网络开销)
每次 RPC 调用需要在请求头中携带 traceparent 和 tracestate。这些 Header 通常只有几十到几百字节,对于 HTTP/1.1 或 gRPC 请求来说,增加的带宽消耗微乎其微。
3. Span 数据上报(网络 + I/O 开销)
这是最大的开销来源。Span 数据需要从应用进程发送到 Collector 或直接写入后端存储。上报方式有两种:
- 同步上报:在当前请求线程中直接发送 Span 数据。这会显著增加请求延迟,不推荐。
- 异步上报:将 Span 数据放入内存队列,由后台线程批量发送。这是标准做法,对请求延迟几乎无影响,但会增加少量内存和 CPU 开销。
5.2 量化数据
以下是业界公开的基准测试数据(以 Jaeger Java Agent 为例):
| 指标 | 无追踪 | 1% 采样 | 100% 采样 |
|---|---|---|---|
| 平均延迟 | 12ms | 12.1ms | 12.8ms |
| P99 延迟 | 45ms | 45.5ms | 48ms |
| CPU 使用率 | 35% | 35.5% | 38% |
| 内存使用 | 512MB | 520MB | 560MB |
| 网络带宽 | 0 | 0.5MB/s | 50MB/s |
结论:在 1% 采样率下,追踪开销几乎可以忽略(< 1%)。在 100% 采样率下,CPU 开销增加约 3-8%,延迟增加约 5-7%。对于大多数业务系统,1%-10% 的采样率是一个合理的平衡点。
5.3 优化手段
Span 数据瘦身:避免在 Span 的 tags 中记录大对象(如完整的请求/响应体)。只记录关键信息:HTTP 状态码、方法名、耗时、错误信息。
批量上报:将多个 Span 打包成一个批次发送,减少网络往返次数。Jaeger Agent 默认每 1 秒或每 100 个 Span 发送一次。
本地过滤:在 Agent 侧过滤掉健康检查、静态资源请求等低价值 Span,减少上报量。
使用 UDP 而非 TCP:Jaeger Agent 默认使用 UDP 接收 Span 数据(Thrift Compact 协议),避免 TCP 握手和连接管理开销。但 UDP 有丢包风险,需要在"可靠性"和"性能"之间权衡。
六、主流实现与 OpenTelemetry 生态
6.1 Jaeger
由 Uber 开源,CNCF 毕业项目。Jaeger 的架构包括:
- Jaeger Client:嵌入应用进程,负责创建 Span 并发送给 Agent
- Jaeger Agent:部署在每个节点上的守护进程,接收 Client 的 Span 并转发给 Collector
- Jaeger Collector:接收 Agent 数据,验证、处理后写入存储
- Jaeger Query:提供 UI 和 API 查询 Trace
- 存储后端:支持 Cassandra、Elasticsearch、Badger(本地存储)
6.2 Zipkin
由 Twitter 开源,是最早的分布式追踪系统之一。Zipkin 的架构相对简单:Reporter 直接将 Span 数据发送到 Collector(通过 HTTP 或 Kafka),Collector 写入存储(MySQL、ES、Cassandra),Query 服务提供 UI。
6.3 SkyWalking
由 Apache 基金会维护,中国团队主导。SkyWalking 的特点是自动埋点能力极强,支持 Java、.NET、Node.js、Go 等多种语言,对主流框架(Spring、Dubbo、gRPC 等)开箱即用。SkyWalking 使用自研的存储引擎,也支持 ES、MySQL 等。
6.4 OpenTelemetry:统一标准
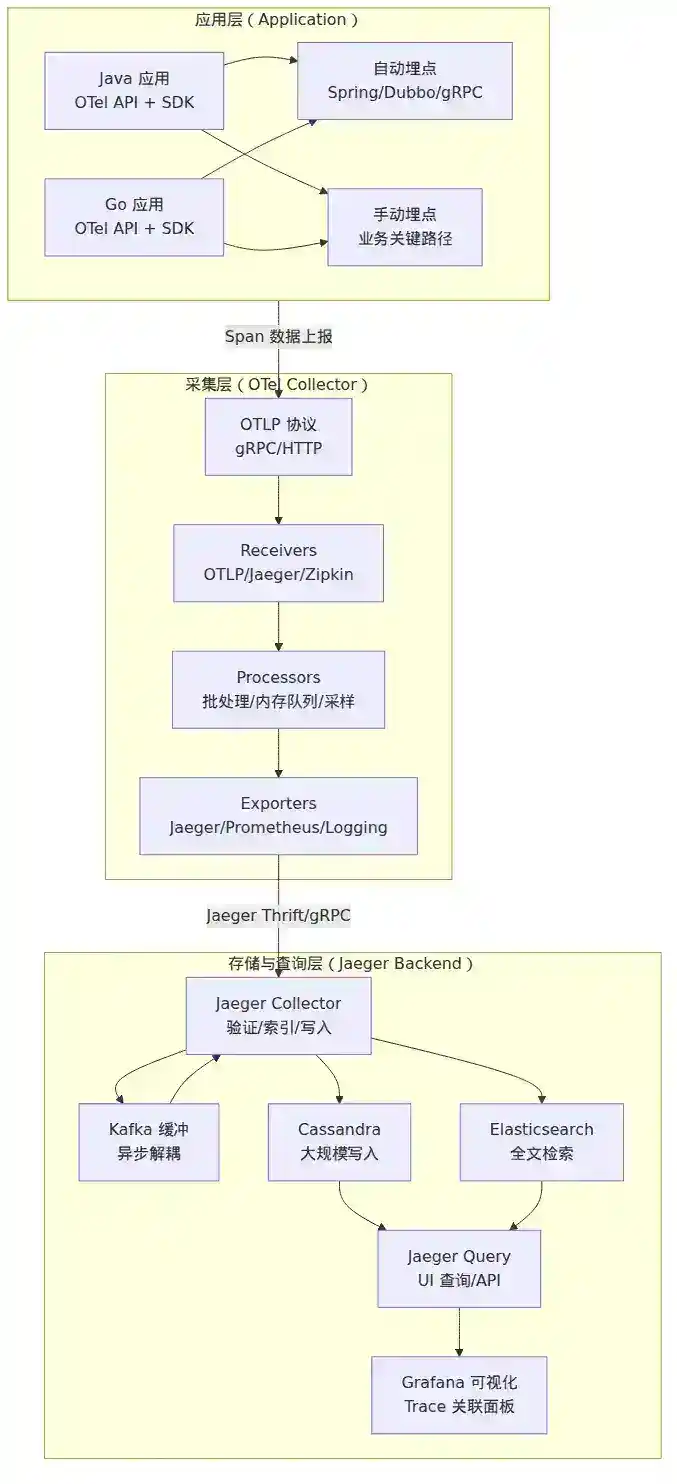
OpenTelemetry(简称 OTel)是 CNCF 的第二个孵化项目,目标是将 Trace、Metrics、Logs 的采集和导出统一到一个标准下。它定义了:
- API:应用代码中使用的接口,用于创建 Span、记录 Metrics
- SDK:API 的实现,包含采样、导出、资源管理等
- Collector:独立部署的数据处理服务,支持接收、处理、导出多种协议的数据
- OTLP 协议:OpenTelemetry Protocol,统一的数据传输协议
OpenTelemetry 本身不提供存储和 UI,而是将数据导出到 Jaeger、Zipkin、Prometheus 等后端。这让它成为"可观测性的 USB-C 接口"——一次埋点,到处使用。
七、实战:链路追踪排障流程
假设你收到一条告警:"订单服务 P99 延迟从 200ms 飙升至 2s"。按以下步骤排查:
步骤 1:定位异常 Trace
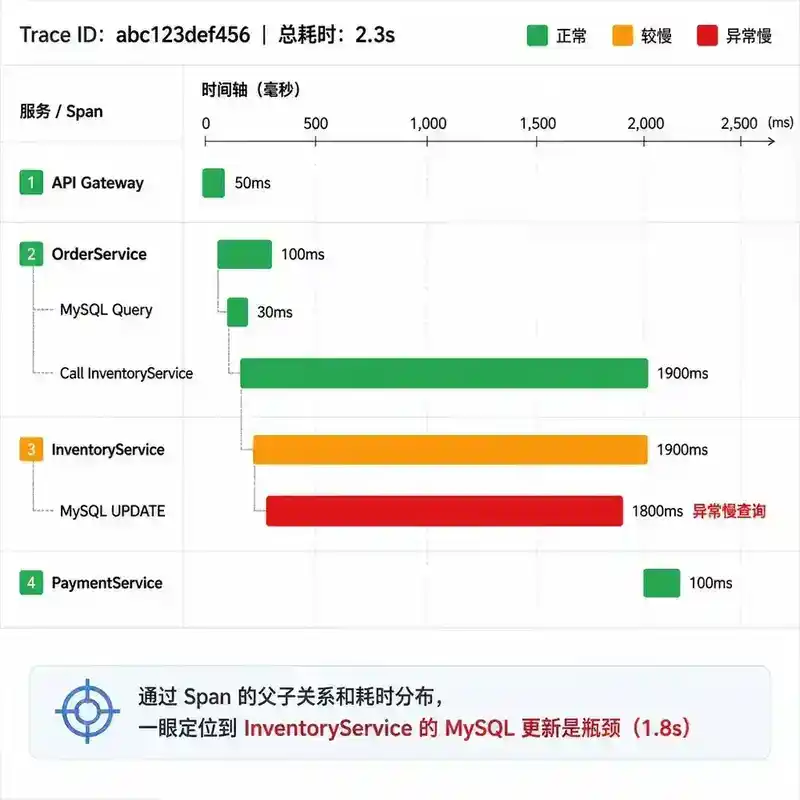
在 Jaeger UI 中搜索 order-service,按耗时降序排列,找到最近 15 分钟内耗时最长的 Trace。你会看到一条 Trace 包含 8 个 Span,总耗时 2.3s。
步骤 2:分析 Span 耗时分布
展开 Trace 的甘特图(Waterfall View),发现:
Gateway:  50ms
OrderService: 100ms
  ├── MySQL查询: 30ms
  └── 调用 InventoryService: 1900ms  ← 异常!
      └── MySQL更新: 1800ms  ← 根因!
PaymentService: 100ms
一目了然:InventoryService 的 MySQL 更新操作耗时 1.8s,是瓶颈所在。
步骤 3:关联日志
Jaeger 中每个 Span 都关联了服务名和时间戳。直接跳到 InventoryService 对应时间段的日志,搜索 UPDATE inventory SET stock = stock - 1,发现大量慢查询日志,explain 显示全表扫描——索引失效。
步骤 4:修复验证
重建索引后,同样的 Trace 耗时恢复到 200ms。
如果没有链路追踪,你需要逐个检查 4 个服务的日志和 Metrics,可能需要 30 分钟甚至更久。有了链路追踪,2 分钟就能定位到具体服务和 SQL。
八、架构设计要点
8.1 Collector 的高可用
Collector 是链路追踪系统的核心组件,如果它挂了,所有 Span 数据都会丢失。解决方案:
- 多实例部署:Collector 无状态,可以水平扩展
- 前置 Kafka 缓冲:Span 数据先写入 Kafka,Collector 从 Kafka 消费。即使 Collector 短暂宕机,Kafka 中的数据也不会丢失
- 客户端重试:SDK 内置重试机制,Collector 恢复后自动重传
8.2 存储选型
| 存储 | 适用场景 | 优缺点 |
|---|---|---|
| Elasticsearch | 通用场景 | 查询快,运维成本高,成本中等 |
| Cassandra | 超大规模 | 写入性能好,查询功能有限,运维成本高 |
| S3/对象存储 | 冷数据归档 | 成本极低,查询慢,适合合规留存 |
| ClickHouse | 分析场景 | 压缩比高,聚合查询快,运维成本中等 |
8.3 数据保留策略
- 热数据(最近 7 天):保留在 ES 中,用于实时排障
- 温数据(7-30 天):保留在 ClickHouse,用于趋势分析
- 冷数据(30 天以上):归档到 S3,按需恢复
九、总结
分布式链路追踪是微服务可观测性的核心支柱之一。理解它的关键在于掌握三个核心概念和两个权衡:
三个核心概念:
- Trace 和 Span:Trace 是全局调用链,Span 是调用链上的每个片段
- 上下文传播:通过 W3C TraceContext 标准在服务间传递 traceId
- 采样:在完整性和成本之间取得平衡
两个权衡:
- Span 粒度 vs 性能开销:太粗看不清,太细开销大,按逻辑边界划分最优
- 采样率 vs 故障覆盖率:采样率越低成本越低,但漏掉问题的概率越高
随着 OpenTelemetry 成为行业标准,链路追踪的接入成本正在快速降低。对于任何使用微服务架构的团队,分布式链路追踪不再是"锦上添花",而是排障必备的基础设施。
面试官视角:高频提问
(以下问题不计入 40 分钟阅读时间,建议在理解正文后尝试回答)
问题 1:Trace 上下文传播的"断链"问题
面试官问:你说你们的系统用了 Jaeger 做链路追踪,但有一天你发现某个 Trace 在服务 C 之后就没有 Span 了。可能的原因有哪些?你会怎么排查?
考察点:对上下文传播机制的深入理解,以及实际排障能力。
参考答案: 可能的原因按概率从高到低排列:
- 服务 C 的 HTTP 客户端没有透传 traceparent Header:最常见的原因。如果服务 C 使用自定义 HTTP 客户端或老旧的 HTTP 库,调用服务 D 时没有把请求头中的
traceparent和tracestate带过去,traceId 就断了。解决方案:检查 HTTP 客户端配置,确保 Header 透传;或者使用 OpenTelemetry 的自动埋点(auto-instrumentation),框架会帮你处理好。 - 跨协议调用导致上下文丢失:如果服务 C 通过 HTTP 接收请求(Header 中有 traceparent),但通过 Kafka 发送消息给服务 D,Kafka 消息的 Header 机制不同,需要显式地将 traceparent 注入到 Kafka Record Header 中。许多 Tracing 库对 Kafka 的集成需要手动配置。
- 异步线程切换:服务 C 使用线程池异步处理请求,但没有将 Span 上下文传递到工作线程。在 Java 中,ThreadLocal 默认不会跨线程传递,需要使用
Context.wrap()或Context.taskWrapping()来包装 Runnable。 - 采样决策不一致:服务 C 决定不采样(trace-flags=00),但服务 D 配置了强制采样。这会导致只有部分 Span 被记录,看起来像"断了"。这本质上是采样策略配置不一致的问题。
- 服务 D 的 Tracing SDK 初始化失败:SDK 没配好、Exporter 连不上 Collector、或者版本不兼容,导致 Span 创建成功但上报失败。
排查顺序:先看服务 D 的日志有没有 Tracing SDK 相关错误 → 用 tcpdump/Wireshark 抓包看 HTTP Header 中是否携带 traceparent → 检查服务 C 的 HTTP 客户端代码或框架配置 → 检查异步场景的 Context 传递。
问题 2:采样策略的选择困境
面试官问:你们的系统 QPS 在 5 万左右,日常采样率设置为 1%。但最近一次线上故障,恰好没有一个被采样的 Trace 覆盖到故障请求。你会怎么改进采样策略?
考察点:对采样策略的理解深度,以及能否根据业务场景设计合理的采样方案。
参考答案: 这是一个典型的"采样盲区"问题。1% 的固定比例采样在高 QPS 下确实可能出现"故障请求恰好没被采样"的情况,尤其在故障请求本身占比很低时(比如 0.01% 的错误率)。
改进方案,从简单到复杂:
- 错误强制采样(最低成本):在 SDK 层配置"如果 Span 的 status 是 ERROR,则强制保留,不受采样率限制"。这是最直接的改进,确保任何异常请求都能被追踪到。几乎所有 Tracing SDK 都支持这个配置。
- 延迟阈值采样(中等成本):配置"如果请求总耗时超过 P99 阈值(比如 500ms),则强制保留"。这需要一个"尾部采样"的 Collector 来支持——因为请求耗时在请求完成时才知道,而头部采样在请求开始时就已经决策了。实现方式:SDK 始终创建 Span 并缓存(不立即丢弃),请求完成时根据耗时决定是否上报。
- 自适应采样(较高成本):根据系统实时状态动态调整采样率。例如:错误率突增时自动将采样率提升到 100%,持续 5 分钟。这需要 Collector 支持实时决策下发。
- 分层采样(推荐):结合头部采样和尾部采样。头部采样先过一遍(1% 概率保留),尾部采样对剩下的做二次判断(错误/慢请求保留)。这样既控制了数据量,又不会漏掉问题请求。
在这四层改进中,第一步和第二步就是你需要的:错误强制采样 + 延迟阈值采样。投入不大,效果立竿见影。
问题 3:高吞吐场景下的性能开销处理
面试官问:你们有一个核心服务,单机 QPS 达到 2 万,P99 延迟要求不超过 10ms。如果引入分布式链路追踪,你担心性能开销会突破延迟预算。你怎么量化评估,以及有哪些优化手段?
考察点:对性能开销的量化分析能力和工程权衡能力。
参考答案: 首先需要量化,不能凭感觉。按照以下步骤:
第一步:灰度验证 在 1-2 台机器上开启 Tracing(从 1% 采样率开始),对比开启前后的 P99 延迟、CPU 使用率、内存使用率。如果 1% 采样率下延迟增加不超过 0.5%,可以逐步提升采样率到 5%、10%,找到性能和覆盖率的平衡点。
第二步:低延迟优化手段 针对 10ms P99 这个严苛的延迟要求,需要做以下优化:
- 异步上报,内存队列:绝对不能用同步上报。使用无锁队列(如 LMAX Disruptor 或 JCTools 的 MpscArrayQueue),Span 数据写入队列后立即返回,后台线程批量发送。队列满了就丢弃(drop),绝不阻塞业务线程。
- 使用 UDP 协议上报:Jaeger Agent 默认支持 UDP(Thrift Compact 格式)。UDP 无连接,发送即忘,不阻塞。代价是可能有少量丢包,但在 1% 采样率下,丢几个 Span 影响不大。
- Span 数据极致瘦身:只记录
operationName、duration、status、http.status_code、error五个字段。不要记录请求体、响应体、完整的 SQL 语句。一个 Span 应该控制在 200 字节以内。 - 使用 gRPC + Protobuf:如果必须用可靠传输,gRPC 比 HTTP+JSON 更快。OpenTelemetry 的 OTLP 协议就是基于 gRPC+Protobuf 的。
- 本地采样决策,避免远程调用:采样决策在 SDK 层完成,不要去问 Collector。每次远程调用至少增加 1-2ms 延迟。
- 关闭低价值 Span:健康检查、Metrics 采集、配置拉取等内部调用不要创建 Span。
第三步:预期结果 经过以上优化,在 1% 采样率下,追踪引入的额外延迟通常在 50-200μs(微秒级),远低于 10ms 的延迟预算。你可以放心引入。
关键认知:不要因为担心性能开销就放弃链路追踪。现代 Tracing SDK 经过大量优化,在合理采样率下,开销远低于你的直觉估计。没有链路追踪导致的排障时间损失,通常远大于追踪本身带来的性能开销。
问题 4:Trace 与 Log、Metrics 的关联
面试官问:你们同时有日志系统(ELK)、指标系统(Prometheus)和链路追踪系统(Jaeger)。三套系统各自独立,查询时需要在三个界面之间切换,非常低效。你如何设计让三者联动起来?
考察点:对可观测性三支柱联动方案的设计能力。
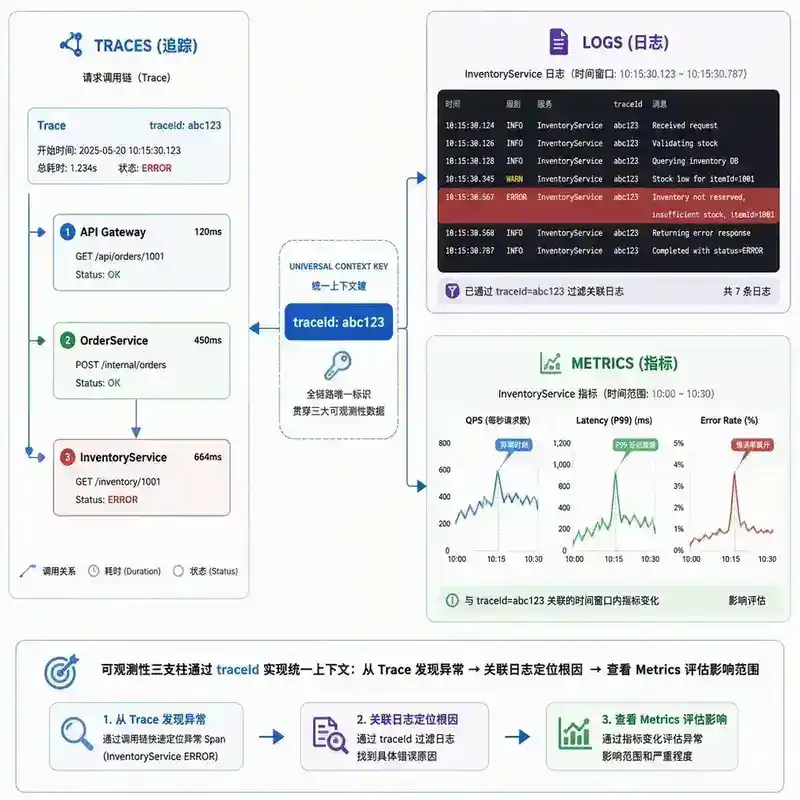
参考答案: 核心思路是以 traceId 为纽带,串联三套系统。
技术方案:
- 日志中注入 traceId 和 spanId:在日志框架(Logback/Log4j2)的 MDC(Mapped Diagnostic Context)中自动注入
traceId和spanId。这样每条日志都带有追踪上下文。在 ELK 中查询traceId=abc123就能看到该请求的所有日志。 - Jaeger → ELK 跳转:在 Jaeger UI 的 Span 详情页中,生成一个跳转链接,指向 ELK 中按
traceId和时间范围过滤的查询。URL 格式类似:https://kibana.example.com/app/discover#/?_g=(time:(from:'2024-01-01T00:00:00',to:'2024-01-01T01:00:00'))&_a=(query:(language:kuery,query:'traceId:abc123'))。 - Metrics 中嵌入 Exemplar:Prometheus 支持 Exemplar 机制,可以在 Metrics 数据点中附加 traceId。例如:
histogram_quantile(0.99, rate(http_request_duration_seconds_bucket[5m]))的 P99 值后面,可以附加一个具体的 traceId,点击后跳转到 Jaeger 查看该 Trace。 - Grafana 统一面板:在 Grafana 中创建一个统一的可观测性面板,左侧是服务依赖拓扑图,中间是 Metrics 面板,右侧是 Trace 列表。点击任意节点,自动关联日志和 Trace。
实施优先级:第一步(日志注入 traceId)投入最小、收益最大,建议最先做。第二步(Jaeger → ELK 跳转)只需配置 URL 模板,也不难。第三步(Exemplar)需要 Prometheus 和 SDK 的配合,稍微复杂一些。第四步是锦上添花。
问题 5:开源方案的选型决策
面试官问:你们团队要从零搭建分布式链路追踪系统,现在有 Jaeger、Zipkin、SkyWalking、以及基于 OpenTelemetry 自建四种方案。你会怎么选?请给出你的决策逻辑。
考察点:技术选型能力,以及对各方案优劣的深入了解。
参考答案: 选型取决于团队的技术栈和业务特点,但有一个答案是几乎对所有团队都成立的:基于 OpenTelemetry + Jaeger 的组合。
决策逻辑:
- OpenTelemetry 是标准,不是选项:无论你选什么后端,埋点部分都应该用 OpenTelemetry。理由很简单——它是 CNCF 的行业标准,未来任何 Tracing 后端都会支持 OTLP 协议。用 OTel 埋点,相当于买了一份"后端可替换"的保险。今天用 Jaeger,明天想换 Grafana Tempo 或商业产品(如 Datadog),只需要改 Exporter 配置,不需要改一行代码。
- Jaeger 作为默认后端:Jaeger 是 CNCF 毕业项目,社区活跃,文档完善,Kubernetes 部署简单(有官方 Helm Chart 和 Operator)。对比 Zipkin 架构更现代,对比 SkyWalking 侵入性更小(SkyWalking 的 Java Agent 虽然强大,但有时会与业务代码的字节码增强冲突)。
- 什么时候选 SkyWalking:如果你的团队主要使用 Java 且需要"开箱即用"的极致体验,SkyWalking 的自动埋点覆盖度确实最强。Spring Boot、Dubbo、MyBatis 等框架无需任何代码改动就能追踪。但代价是:SkyWalking 的协议是自研的,与 OpenTelemetry 生态的互通需要额外配置。
- 什么时候自建:只有当你的业务规模大到现有方案无法满足时(比如日增 100TB 以上的 Trace 数据),才考虑自建存储和查询层。绝大多数团队不需要。
一句话总结:OpenTelemetry 埋点 + Jaeger 后端 + Elasticsearch 存储,这是 2024 年最主流、最稳妥的选择。
问题 6:分布式追踪中的"时钟偏移"问题
面试官问:你在分析一个 Trace 时发现,服务 A 的 Span 显示 10:00:00.100 调用了服务 B,但服务 B 的 Span 显示它在 10:00:00.050 就开始处理了——比调用发起时间还早了 50ms。你怎么解释这个现象?如何解决?
考察点:对分布式系统中时钟问题的理解,以及实际处理能力。
参考答案: 这是典型的分布式时钟偏移问题。不同服务器上的时钟不是完全同步的,即使有 NTP 同步,通常也会有几毫秒到几十毫秒的偏差。当服务器 A 的时钟慢了 50ms,就会出现"子 Span 开始时间早于父 Span 的调用时间"的诡异现象。
解决方案:
- NTP 时间同步(基础):所有服务器必须配置 NTP,并确保时钟偏差在毫秒级。但对于高频交易或对时间精度要求极高的场景,NTP 不够。
- 基于 Span 的相对时间(推荐):在 Jaeger/OpenTelemetry 中,Span 的时间戳应该由发起调用的那一方来记录。即:服务 A 在调用服务 B 之前,记录一个
client send时间戳;服务 B 收到请求后,记录server receive时间戳。这两个时间戳来自同一台机器(服务 A 的时钟),不存在偏移问题。即使服务 B 的时钟偏移了,服务 A 记录的client send和server receive的时间差,仍然能准确反映网络延迟。 - 分布式时钟服务:Google Spanner 使用 TrueTime API(基于原子钟和 GPS),将时钟不确定性控制在一个很小的范围内(通常 < 7ms)。但这对大多数企业不现实。
生产实践:绝大多数情况下,只要配置了 NTP 且偏差在几十毫秒以内,对链路追踪的排障分析不会产生实质性影响。你关注的是"哪个 Span 花了 2 秒",而不是"Span A 比 Span B 早了 3ms"。