阅读时间:约 45 分钟 | 难度:中高级 | 适用方向:Java 技术专家、架构师、SRE
一、问题定义:一个让人困惑的告警
凌晨三点,运维群弹出一条告警:
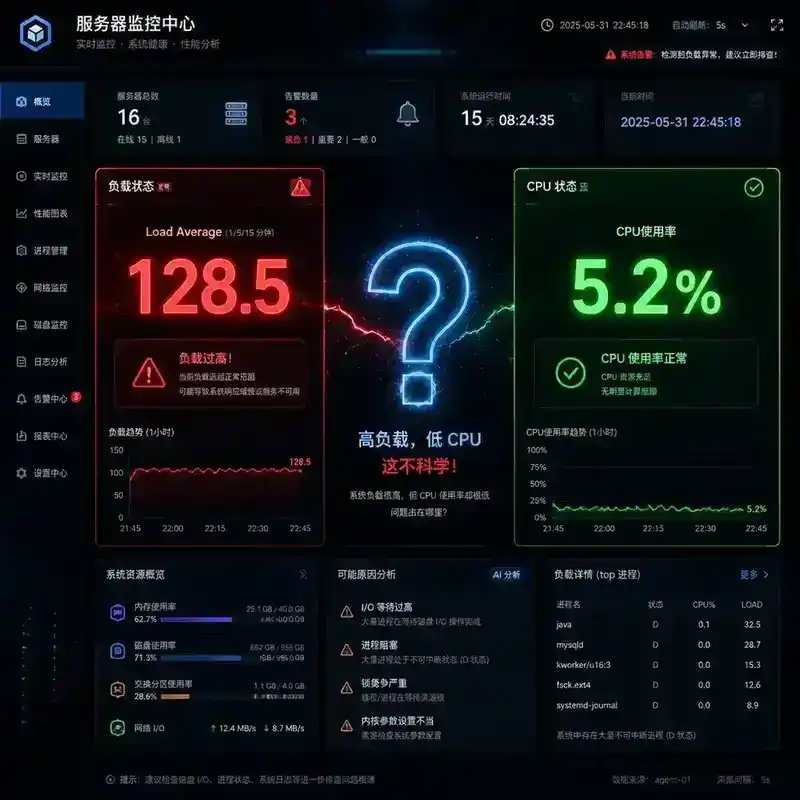
[CRITICAL] 生产服务器 10.0.1.42 Load Average: 128.5 (threshold: 24)
你登录上去一看,top 命令显示:
top - 03:12:45 up 180 days,  2:15,  3 users,  load average: 128.50, 95.30, 72.10
Tasks: 823 total,   2 running, 821 sleeping,   0 stopped,   0 zombie
%Cpu(s):  5.2 us,  1.1 sy,  0.0 ni, 92.8 id,  0.8 wa,  0.0 hi,  0.1 si,  0.0 st
CPU 空闲 92.8%,Load 却高达 128.5。 这种"高 Load 低 CPU"的矛盾场景,是线上故障排查中最典型也最容易被误判的一类问题。
核心矛盾:Load Average 衡量的是系统负载压力(包括正在使用 CPU 和等待资源的进程),而 CPU 使用率只反映 CPU 在用户态/内核态的实际工作时间。当大量进程处于"想运行但跑不起来"的状态时,Load 飙升但 CPU 却闲得发慌。
二、Load Average 的底层原理
2.1 Load Average 到底是什么
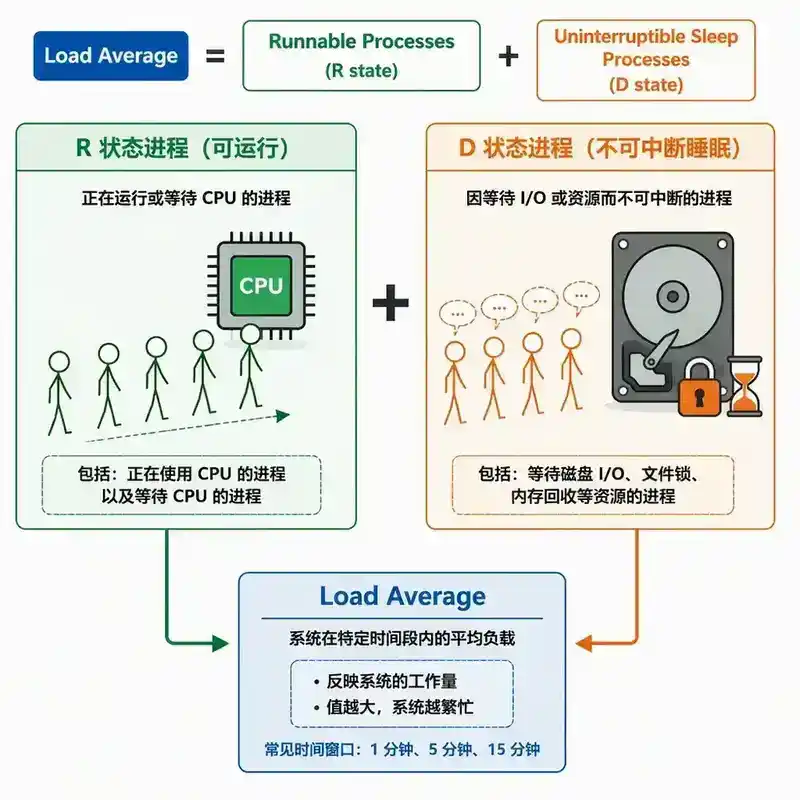
Load Average 不是 CPU 使用率,也不是进程数。Linux 内核中,它定义为:
处于可运行状态(TASK_RUNNING)和不可中断睡眠状态(TASK_UNINTERRUPTIBLE)的进程数的指数移动平均值。
源码位置:kernel/sched/loadavg.c
// 内核中 Load Average 的计算核心
long calc_load_fold_active(struct rq *this_rq, long adjust)
{
    long nr_active, delta = 0;

    nr_active = this_rq->nr_running - adjust;
    nr_active += (long)this_rq->nr_uninterruptible;

    if (nr_active != this_rq->calc_load_active) {
        delta = nr_active - this_rq->calc_load_active;
        this_rq->calc_load_active = nr_active;
    }
    return delta;
}
关键点:
nr_running:正在 CPU 上运行 + 在运行队列中等待 CPU 的进程数nr_uninterruptible:处于 D 状态(不可中断睡眠)的进程数,通常是等待 I/O 完成
2.2 三个数字的含义
load average: 1.50, 2.30, 2.10
               ↑     ↑     ↑
             1分钟  5分钟  15分钟
这三个值使用指数移动平均(EMA)计算,衰减因子约为:
- 1 分钟:exp(-1/60) ≈ 0.92
- 5 分钟:exp(-1/300) ≈ 0.97
- 15 分钟:exp(-1/900) ≈ 0.99
解读法则:
- Load = CPU 核数:系统刚好满负荷
- Load > CPU 核数 × 1.0:有进程在排队等待
- Load > CPU 核数 × N:严重过载,N 越大越严重
但这里有一个关键漏洞:这个法则只适用于所有 Load 都来自 CPU 密集型进程的情况。 当 Load 主要来自 D 状态进程时,CPU 使用率可以很低。
2.3 CPU 使用率 vs Load Average
| 维度 | CPU 使用率 | Load Average |
|---|---|---|
| 衡量什么 | CPU 工作时间占比 | 系统负载压力 |
| 包含等待 I/O 吗 | 不包含 | 包含(D 状态) |
| 包含等待 CPU 吗 | 不包含 | 包含(R 状态) |
| 高值一定有问题吗 | 不一定(计算密集型正常) | 不一定(需结合 CPU 使用率判断) |
高 Load 低 CPU 的本质原因只有两个:
- 大量进程在 D 状态(不可中断睡眠)——等待磁盘 I/O、网络 I/O、锁等
- 大量进程在 R 状态但被调度器频繁切换——锁竞争导致运行队列堆积
三、根因一:I/O 等待(D 状态进程堆积)
3.1 什么是 D 状态
Linux 进程状态中,D(Disk Sleep / Uninterruptible Sleep)状态是最特殊的:
// include/linux/sched.h
#define TASK_RUNNING            0x0000
#define TASK_INTERRUPTIBLE      0x0001  // S 状态,可被信号唤醒
#define TASK_UNINTERRUPTIBLE    0x0002  // D 状态,不可被信号中断
#define TASK_STOPPED            0x0004
#define TASK_ZOMBIE             0x0008
#define TASK_DEAD               0x0010
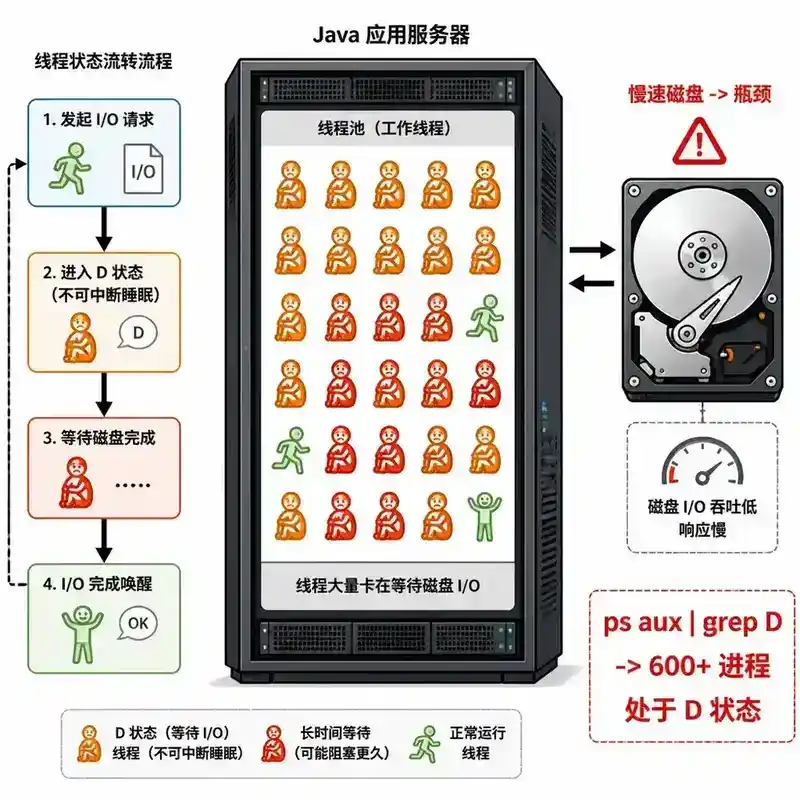
D 状态的设计目的:当进程在内核态执行某些关键操作(如磁盘 I/O)时,如果被信号中断,可能导致文件系统不一致或数据丢失。因此,内核将进程置为 D 状态,使其在 I/O 完成之前不响应任何信号(包括 SIGKILL)。
为什么 D 状态会导致 Load 高:因为 Load Average 的计算公式中包含了 nr_uninterruptible,D 状态进程直接贡献 Load 值。
3.2 磁盘 I/O 阻塞的典型场景
场景一:慢磁盘 + 大量随机读写
应用服务器上的日志写入线程堆积:
- 200 个线程同时写日志到机械硬盘
- 每次 write 系统调用进入 D 状态等待磁盘完成
- 机械硬盘 IOPS 只有 ~150,200 个线程大部分时间都在 D 状态
- Load 飙升到 200+,CPU 空闲 95%
场景二:NFS/SMB 挂载的远程文件系统卡顿
Java 应用读取 NFS 挂载的配置文件:
- NFS 服务端网络抖动或过载
- 所有读取线程进入 D 状态,等待 NFS 响应
- 线程池满,新请求被拒绝
- Load 飙升,CPU 几乎为 0
场景三:内存不足导致的大量 Swap I/O
物理内存耗尽,系统开始大量 Swap:
- 进程访问被换出的页面,触发 page fault
- 内核需要从 Swap 分区读回数据
- 进程进入 D 状态等待磁盘 I/O
- 恶性循环:内存不足 → Swap → 磁盘 I/O → D 状态堆积 → Load 飙升
3.3 I/O 等待的诊断工具链
第一步:确认 D 状态进程
# 查看 D 状态进程
ps aux | awk '$8 ~ /D/ {print}'

# 更精确的方式
ps -eo pid,stat,wchan:32,comm | grep '^.* D'

# 统计各状态进程数
ps -eo stat | sort | uniq -c | sort -rn
第二步:查看进程卡在哪个内核函数
# /proc/<pid>/wchan 显示进程当前阻塞的内核函数
cat /proc/$(pgrep -f your_app)/wchan

# 批量查看所有 D 状态进程的阻塞点
for pid in $(ps -eo pid,stat | awk '$2~/D/{print $1}'); do
    echo -n "$pid: "
    cat /proc/$pid/wchan 2>/dev/null
done

# 常见阻塞函数含义:
# - blkdev_issue_flush    → 等待磁盘刷写
# - wait_on_page_writeback → 等待页回写完成
# - io_schedule           → 通用 I/O 等待
# - rpc_wait_bit_killable  → NFS 等待
# - jbd2_log_wait_commit   → ext4 日志提交等待
第三步:使用 iostat 查看磁盘 I/O 压力
# -x 显示扩展统计,-d 设备级,1 每秒刷新
iostat -xdz 1

# 关键指标解读:
# await   - 平均每次 I/O 等待时间(ms),>20ms 需关注
# svctm   - 平均每次 I/O 服务时间(ms)
# %util   - 磁盘繁忙度,>80% 存在瓶颈
# r_await/w_await - 读/写平均等待时间
# aqu-sz  - 平均队列长度
第四步:使用 iotop 定位具体进程的 I/O
# 按 I/O 使用率排序
iotop -oP

# 只显示有 I/O 活动的进程
iotop -o
第五步:使用 perf 或 bpftrace 深入分析
# 查看 block I/O 延迟分布
bpftrace -e 'kprobe:blk_mq_make_request { @start[arg0] = nsecs; }
             kretprobe:blk_mq_make_request /@start[arg0]/ {
                 @lat_us = hist((nsecs - @start[arg0]) / 1000);
                 delete(@start[arg0]); }'

# 查看哪些进程在等待 I/O
perf record -e block:block_rq_issue -a -g sleep 10
perf report
四、根因二:锁竞争导致的运行队列堆积
4.1 锁竞争为什么会导致高 Load 低 CPU
当多个线程竞争同一把锁时:
- 线程 A 持有锁,在 CPU 上执行临界区代码
- 线程 B/C/D/E... 尝试获取锁,失败后进入等待队列
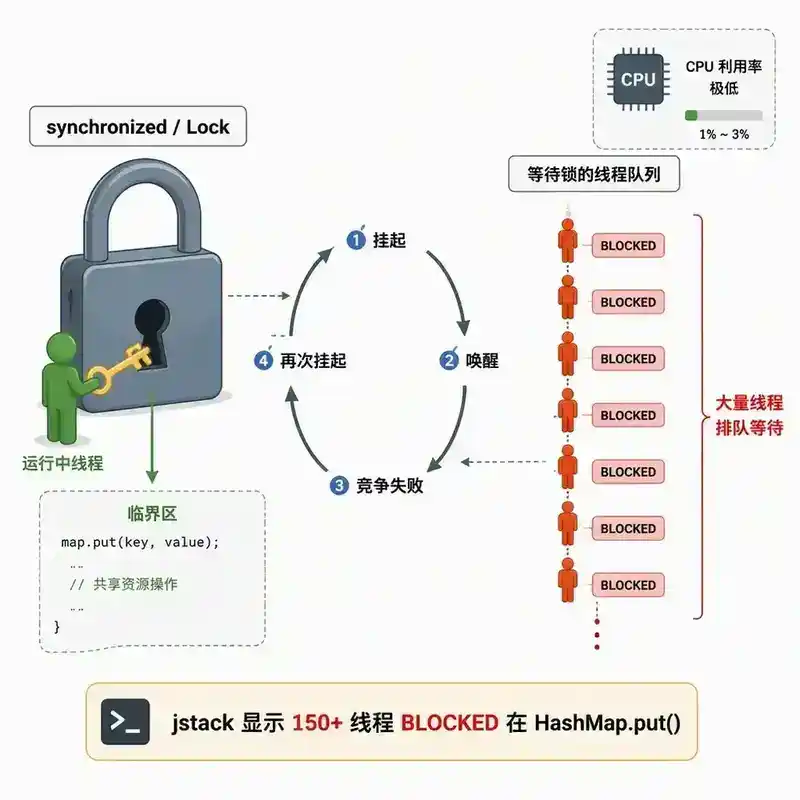
- 在 Java 的 synchronized 中,这些线程被挂起(BLOCKED 状态),进入等待队列
- 在 JVM 层面是 BLOCKED,但在 OS 层面,这些线程被
futex系统调用挂起,处于 S 状态(可中断睡眠)
等等,S 状态不是不计入 Load Average 吗?那为什么锁竞争会导致 Load 高?
关键洞察:锁竞争有三种路径导致 Load 高:
路径一:自旋锁(spinlock) 线程获取锁失败后不立即挂起,而是自旋等待一段时间(自适应自旋)。自旋期间线程处于 R 状态,占用 CPU 且直接贡献 Load。如果自旋时间过长,大量线程在 R 状态空转,Load 飙升但实际有效 CPU 工作很少。
路径二:频繁的锁竞争导致上下文切换风暴
线程获取锁失败 → futex 挂起 → 锁释放时唤醒 → 竞争失败再次挂起 → ...
这种"挂起-唤醒-挂起"的循环产生大量上下文切换,每次切换都需要内核调度器介入,调度器开销(sy CPU)上升,但整体 CPU 使用率可能不高——因为大部分时间花在了调度决策上而非实际计算。
路径三:管程(Monitor)的等待队列堆积 在 Java 中,synchronized 的管程模型有一个 Entry List(等待获取锁的线程队列)。大量线程堆积在 Entry List 中,虽然它们处于 BLOCKED 状态(OS 层面是 S 状态),但加上持有锁正在执行的线程和自旋等待的线程,运行队列(nr_running)会显著增加。
4.2 锁竞争诊断工具
第一步:查看线程状态分布
# 使用 Arthas 查看 Java 线程状态
thread --state BLOCKED

# 或者用 jstack 导出线程栈
jstack <pid> > thread_dump.txt
# 然后统计 BLOCKED 线程
grep "BLOCKED" thread_dump.txt | wc -l
grep "WAITING" thread_dump.txt | wc -l
第二步:找到锁竞争的根因
# Arthas 查看最忙的锁
thread -b

# 输出示例:
# "pool-1-thread-187" Id=587 BLOCKED on java.util.HashMap@0x6e2c6341
# owned by "pool-1-thread-23" Id=123
# → 定位到 pool-1-thread-23 持有 HashMap 锁,187 个线程在等待

# 用 jstack 找到持有锁的线程栈
# 搜索 "locked <0x...>" 关键字
第三步:使用 profiler 分析锁竞争
# async-profiler 锁竞争分析
profiler.sh -e lock -d 60 -f lock_profile.html <pid>

# 输出火焰图,显示:
# - 哪些锁竞争最激烈
# - 每个锁的等待时间分布
# - 持有锁的代码路径
4.3 常见锁竞争场景
| 场景 | 原因 | 典型表现 |
|---|---|---|
| HashMap 并发使用 | 非线程安全的 HashMap 在多线程环境下被共享 | random BLOCKED 线程,持锁时间短但竞争激烈 |
| 数据库连接池耗尽 | 所有连接被占用,新请求等待连接归还 | 大量线程 BLOCKED 在 getConnection() |
| 日志写入同步锁 | 日志框架的同步写入锁 | 高并发下大量线程等待日志锁 |
| 缓存重建 | 缓存失效后多个线程同时重建 | 缓存穿透场景下的锁竞争 |
| 线程池队列满 | 有界队列满时提交任务阻塞 | 调用方线程 BLOCKED 在 submit() |
五、根因三:不可中断睡眠(D 状态)的更多场景
除了磁盘 I/O,D 状态还有其他重要来源:
5.1 内核信号量(semaphore)等待
// 内核中使用 down() 获取信号量,失败时进入 D 状态
void down(struct semaphore *sem)
{
    unsigned long flags;
    raw_spin_lock_irqsave(&sem->lock, flags);
    if (likely(sem->count > 0))
        sem->count--;
    else
        __down(sem);  // 进入 TASK_UNINTERRUPTIBLE 等待
    raw_spin_unlock_irqrestore(&sem->lock, flags);
}
当内核模块(如文件系统驱动、设备驱动)使用信号量同步时,等待的进程进入 D 状态。
5.2 内存分配中的 direct reclaim
当系统内存紧张时,进程在 malloc 或 mmap 调用中可能触发 direct reclaim:
// mm/page_alloc.c
__alloc_pages_slowpath() {
    // 尝试直接回收内存
    // 此过程中进程处于 D 状态
    // 如果回收涉及回写脏页,还要等待磁盘 I/O
}
这会导致即使没有显式的磁盘 I/O,进程也可能进入 D 状态。
5.3 内核锁竞争
内核中的 mutex_lock、spin_lock 等操作在某些情况下也会导致 D 状态:
# 查看内核栈
cat /proc/<pid>/stack

# 示例输出:
# [<0>] __mutex_lock_slowpath+0x...
# [<0>] mutex_lock+0x...
# [<0>] ext4_file_write_iter+0x...
# → 进程在等 ext4 文件系统的内核互斥锁
六、根因四:队列堆积——运行队列的放大效应
6.1 运行队列(Run Queue)的回旋效应
Linux 的 CFS 调度器为每个 CPU 维护一个运行队列。当队列中有大量进程时:
- 调度延迟放大:每个进程分到的时间片更少,上下文切换频率增加
- 缓存失效:频繁切换导致 CPU 缓存(L1/L2/L3)命中率下降
- TLB 抖动:进程切换导致 TLB(Translation Lookaside Buffer)频繁刷新
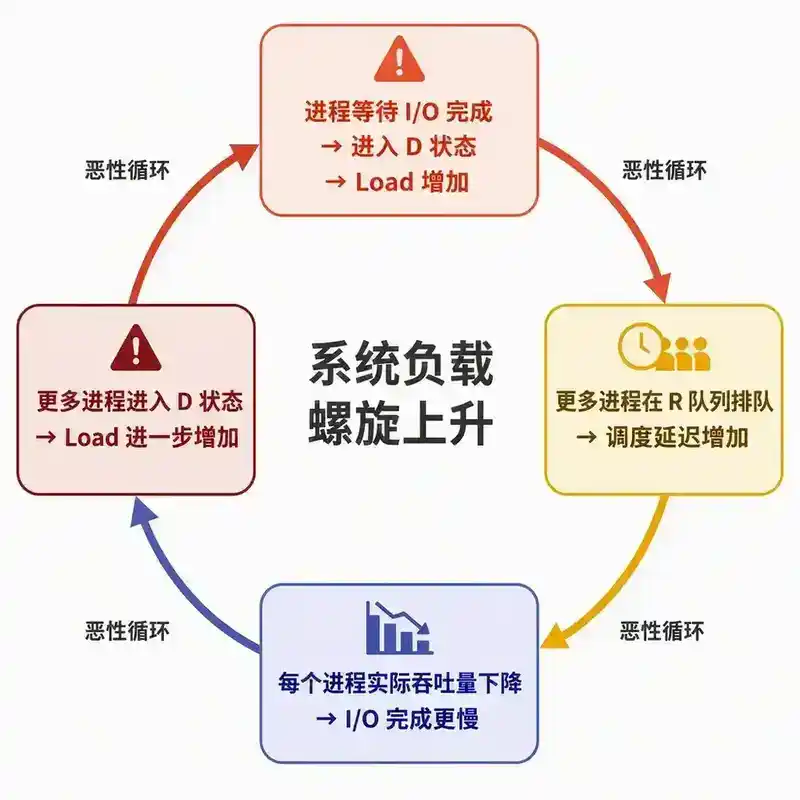
这三者叠加形成恶性循环:
进程等待 I/O 完成 → 进入 D 状态 → Load 增加
→ 更多进程在 R 队列中排队 → 调度延迟增加
→ 每个进程实际吞吐量下降 → I/O 完成更慢
→ 更多进程进入 D 状态 → Load 进一步增加
6.2 线程池的放大效应
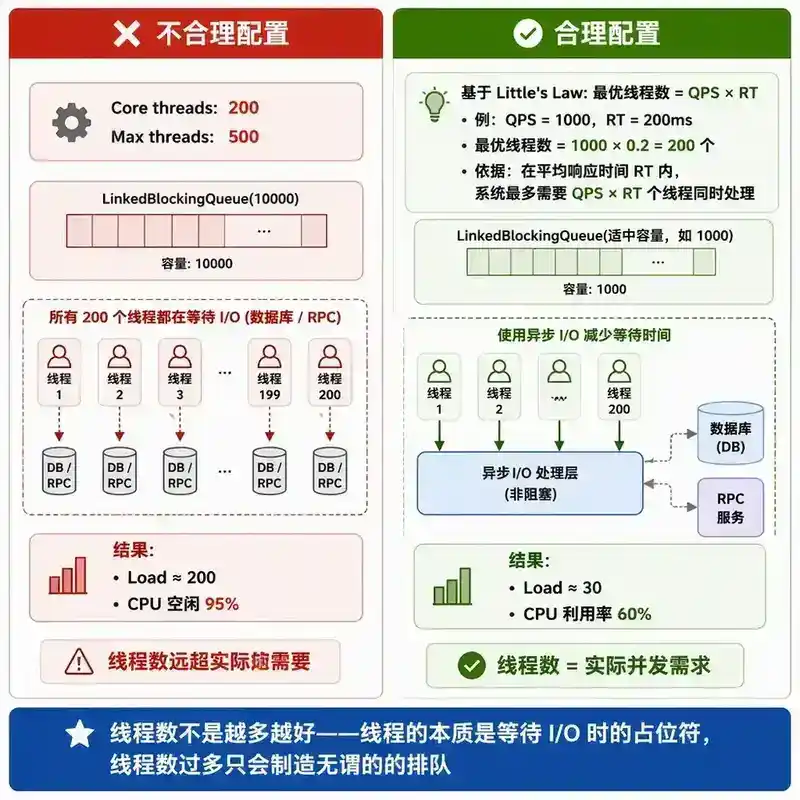
Java 应用中常见的线程池配置问题:
// 典型的问题配置
ThreadPoolExecutor pool = new ThreadPoolExecutor(
    200, 500,                           // 核心线程 200,最大 500
    60L, TimeUnit.SECONDS,
    new LinkedBlockingQueue<>(10000)    // 无界队列变体
);
当所有线程都在等待 I/O(数据库查询、RPC 调用)时:
- 200 个核心线程全部处于 D 状态或等待状态
- 每个线程贡献 1 到 Load
- 200 个线程 × 1 = Load 200
- 但 CPU 几乎空闲——因为线程根本不在计算
关键公式:
Load ≈ 正在运行的线程数 + 等待 I/O 的线程数

对于 I/O 密集型应用:
  Load ≈ 线程池活跃线程数 × I/O 等待时间占比

例如:
  - 线程池 200 线程
  - 每个请求 I/O 等待占 95%(数据库 50ms,计算 2.5ms)
  - 则 Load ≈ 200 × 0.95 = 190
  - 但 CPU 使用率仅 ≈ 200 × 0.05 / 48核 ≈ 20%
七、系统化排查方法论
7.1 故障现场快速定位(30 秒)
# 1. 确认问题
uptime                    # 看 Load Average
top -bn1 | head -5        # 看 CPU 使用率

# 2. 确认 D 状态进程
ps aux | awk '$8 ~ /D/' | wc -l

# 3. 确认 R 状态进程数
vmstat 1 3                # 看 r 列(运行队列长度)

# 4. 确认 I/O 压力
iostat -x 1 3             # 看 %util 和 await

# 5. 确认上下文切换
vmstat 1 3                # 看 cs 列(每秒上下文切换)
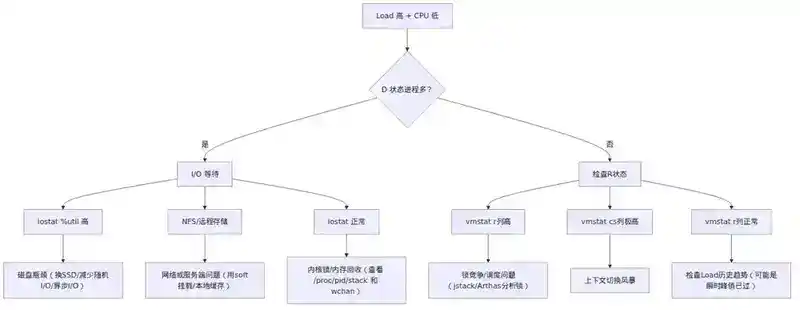
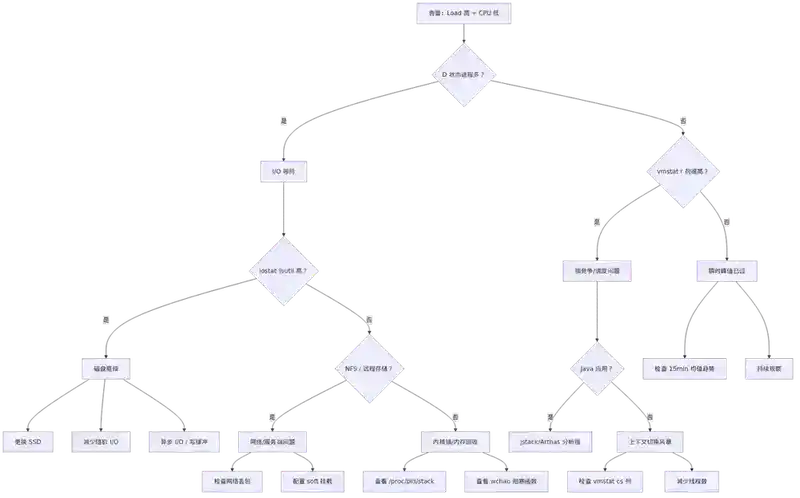
7.2 决策树
Load 高 + CPU 低
├── D 状态进程多?
│   ├── 是 → I/O 等待
│   │   ├── iostat %util 高 → 磁盘瓶颈
│   │   │   ├── 更换 SSD / 增加磁盘
│   │   │   ├── 减少随机 I/O / 批量写入
│   │   │   └── 使用异步 I/O / 写缓冲
│   │   ├── NFS / 远程存储 → 网络/服务端问题
│   │   └── iostat 正常 → 可能是内核锁/内存回收
│   │       └── 查看 /proc/<pid>/stack 和 wchan
│   └── 否 → 检查 R 状态
│       ├── vmstat r 列很高 → 锁竞争/调度问题
│       │   ├── Java 应用 → jstack/Arthas 分析锁
│       │   ├── vmstat cs 列极高 → 上下文切换风暴
│       │   └── 线程数过多 → 检查线程池配置
│       └── vmstat r 列正常 → 检查 Load 历史趋势
│           └── 可能是瞬时峰值已过,但 15min 均值未下降
7.3 完整排查命令速查表
| 命令 | 用途 | 关键指标 |
|---|---|---|
uptime |
查看 Load Average | 1/5/15 min 值 |
top -bn1 |
总体概览 | us/sy/wa/id, Load |
vmstat 1 |
系统级统计 | r(运行队列), b(D状态), cs(上下文切换), wa(等待IO) |
iostat -xdz 1 |
磁盘 I/O | %util, await, r_await/w_await |
iotop -oP |
进程级 I/O | DISK READ/WRITE, IO% |
ps aux |
进程状态 | STAT 列中 D 标记 |
pidstat -d 1 |
进程 I/O 详情 | kB_rd/s, kB_wr/s |
pidstat -w 1 |
上下文切换 | cswch/s, nvcswch/s |
sar -u 1 |
CPU 历史 | %iowait |
sar -b 1 |
I/O 历史 | tps, rtps, bread/s |
/proc/&lt;pid&gt;/wchan |
阻塞函数 | 内核函数名 |
/proc/&lt;pid&gt;/stack |
内核调用栈 | 完整内核栈 |
perf top |
系统级热点 | 函数级 CPU 占用 |
八、生产实战案例
案例一:NFS 卡顿导致全站 502
背景:某电商平台核心应用,突然大面积 502 错误。
故障现象:
Load Average: 350+
CPU: idle 97%
Tomcat 线程池: 800/800,全部 BUSY
排查过程:
ps aux | grep D→ 600+ 进程处于 D 状态cat /proc/<pid>/wchan→ 全部显示rpc_wait_bit_killablemount | grep nfs→ 发现/data/config挂载自 NFS 服务器- 检查 NFS 服务器 → 网络交换机端口故障,丢包率 40%
根因:应用启动时读取 NFS 上的配置文件,NFS 卡顿导致所有请求线程阻塞在 D 状态,Tomcat 线程池耗尽。
解决:紧急将配置文件复制到本地磁盘,修改挂载为 soft 模式(带超时),并建立配置本地缓存机制。
教训:生产环境关键路径不要依赖远程文件系统,或至少使用 soft,timeo=10,retrans=2 参数防止无限等待。
案例二:HashMap 并发导致 Load 过山车
背景:某数据处理服务,Load 周期性飙升到 200+,CPU 20%。
排查过程:
jstack导出线程栈 → 150+ 线程 BLOCKED 在HashMap.put()- Arthas
thread -b→ 定位到某缓存管理类使用了HashMap而非ConcurrentHashMap - 该缓存被 200 个 Worker 线程并发读写
根因:HashMap 在并发 put 时,不仅线程不安全,扩容时甚至可能形成环形链表导致死循环。此处虽然未死循环,但大量线程在 synchronized 块外等待同一把锁。
解决:替换为 ConcurrentHashMap,Load 从 200+ 降至 5 以下。
案例三:日志同步写入拖垮整个服务
背景:某支付网关,QPS 2 万时 Load 200+,CPU 仅 30%。
排查过程:
perf top→pthread_cond_wait和futex占 40% 的 CPU 采样jstack→ 发现大量线程在logback的Appender.doAppend()上 BLOCKED- 检查
logback.xml→ 使用了SynchronousAppender(同步写入)
根因:每个请求打印 5-8 条日志,2 万 QPS = 10-16 万条日志写入/秒。同步写入磁盘导致每条日志都在等 I/O,线程阻塞堆积。
解决:改为 AsyncAppender(异步日志),队列大小 1024,丢弃策略为丢弃 TRACE/DEBUG 级别日志。Load 降至 30 以下。
九、预防与治理策略
9.1 线程池治理
// 反模式:线程数 = 无脑设置
// 这种配置在 I/O 密集场景下是灾难

// 推荐:基于 Little 定律计算
// 最优线程数 = QPS × 平均响应时间(秒)
// 例如:QPS=1000, RT=200ms → 最优线程数 = 1000 × 0.2 = 200

// 再加上缓冲:
// 实际线程数 = 最优线程数 × (1 + 缓冲系数)
// 缓冲系数通常取 0.2-0.5
9.2 I/O 异步化
同步 I/O:线程发起 I/O → 阻塞等待 → I/O 完成 → 线程继续
           ↑ 线程在等待期间不能做任何事 ↑

异步 I/O:线程发起 I/O → 立即返回 → 线程处理其他任务
           I/O 完成后回调通知线程
           ↑ 1 个线程可以处理多个 I/O 请求 ↑
9.3 监控告警规则
# 推荐告警规则
Load/CPU核数 > 3 且 CPU idle > 70% 持续 5 分钟
→ 告警级别:P2(高 Load 低 CPU,典型 I/O 阻塞或锁竞争)

Load/CPU核数 > 5 且 CPU idle > 50% 持续 2 分钟
→ 告警级别:P1

# 辅助指标
- D 状态进程数 > 10
- iowait > 30%
- 上下文切换 > 100000/s
十、面试官视角追问
以下问题模拟面试中围绕本主题的纵深追问,涵盖原理、实践和系统设计层面。
Q1:Load Average 为什么包含 D 状态进程?设计上有什么考量?如果去掉 D 状态会怎样?
Q2:一个 Java 进程的线程在**BufferedReader.readLine()**上等待 Socket 数据,这个线程处于什么状态(JVM 层面和 OS 层面)?它会计入 Load Average 吗?
Q3:你的服务有 200 个线程,每个请求平均数据库查询耗时 50ms,业务逻辑耗时 5ms,30 个 CPU 核心。预估 Load Average 大约是多少?如果 Load 远超这个预估值,你的排查思路是什么?
Q4:**iostat**显示**%util**100%,但**await**只有 2ms,这种情况是不是磁盘瓶颈?为什么?
Q5:**vmstat**的**b**列和**r**列分别代表什么?如果**b**列很高但**r**列正常,说明什么问题?反过来呢?
Q6:在 Kubernetes 环境中,Pod 的 Load Average 是如何计算的?和物理机/虚拟机有什么不同?这会导致什么误判?
Q7:设计一个限流熔断机制,当检测到 Load 高但 CPU 低时自动触发降级。你会选择哪些信号作为触发条件?降级策略如何设计才能保证核心链路可用?
Q8:**top**命令中**wa**(iowait)的含义是什么?多核 CPU 中**wa**的计算方式有何特殊之处?为什么有时候磁盘已经很忙但**wa**显示很低?
参考答案要点
A1:D 状态进程虽然不消耗 CPU,但它们占用了系统资源(内存、文件描述符等),且通常表示子系统(磁盘、网络)存在瓶颈。Load Average 的设计目标是反映"系统有多忙",包括等待资源的压力。如果去掉 D 状态,一个磁盘卡死的系统 Load 可能显示为 0,掩盖了真实的系统压力。
A2:JVM 层面是 RUNNABLE(注意,Java 的 RUNNABLE 包含了 OS 层面的 RUNNING + READY + 阻塞 I/O 的线程)。OS 层面是 S 状态(TASK_INTERRUPTIBLE),因为 Socket I/O 是可中断的等待。不计入 Load Average,因为 Load Average 只计入 R 和 D 状态。这也是为什么纯网络 I/O 密集型应用(如 API 网关)Load 通常不会太高。
A3:根据 Little 定律,并发线程数 ≈ QPS × 平均响应时间。假设 QPS = 2000,则:2000 × 0.055s = 110 个并发线程。在 30 核机器上,Load ≈ 110/30 = 3.7。如果远高于此值,排查方向:① 线程池是否过大(线程数 > 实际需要);② 是否有线程在 D 状态(磁盘 I/O 慢);③ 是否有锁竞争导致线程频繁挂起唤醒。
A4:不一定。%util 是磁盘繁忙时间占比,但即使每次 I/O 很快(2ms),如果并发 I/O 请求多,磁盘可能一直有请求在处理,%util 也会显示 100%。真正的瓶颈判断应结合 await(平均等待时间)和 aqu-sz(平均队列长度)。如果 await 低但 aqu-sz 高,说明磁盘吞吐量够但并发请求多,可能需要增加磁盘数量分散 I/O。
A5:b 列是处于 D 状态的进程数,r 列是处于 R 状态的进程数(包括正在运行和等待 CPU 的)。b 高 r 正常 → I/O 瓶颈,磁盘或网络 I/O 慢。r 高 b 正常 → CPU 瓶颈或锁竞争,进程在排队等 CPU 或自旋等锁。b 和 r 都高 → 系统全面过载。
A6:Kubernetes Pod 中的 Load Average 读取的是宿主机 /proc/loadavg,这是宿主机级别的 Load Average,不是 Pod 级别的。如果宿主机上运行了 100 个 Pod,一个 Pod 的 Load Average 反映的是整个宿主机的负载。这会导致误判——Pod 自身负载很低但 Load 显示很高。解决方案:使用 cAdvisor 或 Prometheus 的容器级指标,或使用 cgroup 的压力指标。
A7:触发信号:① Load/CPU核数 > 3 且 CPU idle > 60%;② D 状态进程数 > 阈值;③ 接口 RT P99 超过 SLA 的 2 倍。降级策略采用分级:一级降级(关闭非核心日志写入、关闭推荐接口);二级降级(返回缓存数据替代实时查询、关闭数据同步任务);三级降级(返回静态兜底页面)。关键在于降级开关要能秒级生效,且降级后 Load 应能观测到明显下降。
A8:wa 是 CPU 等待 I/O 完成的时间占比。但多核 CPU 中,wa 的计算是:如果至少有一个 CPU 在等待 I/O,则这段时间计入 wa。这意味着即使只有 1 个核在等 I/O(其他 31 个核空闲),wa 也可能显示很高的值。反过来,如果所有 CPU 都很忙,即使磁盘 I/O 很多,wa 也可能显示为 0——因为 CPU 有其他事情可做,不会"闲着等 I/O"。正确的解读需要结合 iostat 的 %util 和 await 一起看。
延伸阅读
- Linux 内核源码
kernel/sched/loadavg.c:Load Average 计算实现 - Brendan Gregg《Systems Performance》:第 6 章 CPU、第 9 章 Disk I/O
man proc:/proc/loadavg、/proc/<pid>/stat、/proc/<pid>/wchan- Java 并发编程实战:第 11 章 性能与可伸缩性