阅读时间:约 40-50 分钟 关键词:可观测性、Metrics、Logs、Traces、OpenTelemetry、Prometheus、ELK、分布式追踪、统一上下文 难度:中级偏上,适合有 2 年以上后端开发经验的工程师
一、引言:你的系统真的"可观测"吗?
凌晨三点,告警响了——用户登录接口 P99 延迟飙到了 3 秒。你打开监控大盘,CPU 正常、内存正常、QPS 也没涨。你打开日志,几十台机器每秒几万行,grep 了半天没找到异常。你不甘心,又去翻链路追踪,发现调用链上某个下游服务耗时 2.8 秒——但那个服务的负责人说"我这边监控一切正常"。
这个场景暴露了一个核心问题:你的 Metrics、Logs、Traces 各自为政,彼此割裂。
你看到的指标告诉你"有问题",但定位不到根因。日志里有线索,但淹没在海量数据里。链路追踪能定位到慢节点,但缺少那个节点的上下文。
这就是可观测性三支柱的真正价值所在——不是三个独立工具,而是一个有机整体。当它们可以相互关联、统一上下文时,你才能在几分钟内从"发现异常"走到"定位根因"。
本文将从原理到实践,深入拆解 Metrics、Logs、Traces 各自的工作机制,并重点讲解如何将它们串联成一个统一的排障体系。
二、从监控到可观测性:一个范式转换
2.1 监控 ≠ 可观测性
这两个词经常被混用,但它们的哲学基础完全不同。
监控(Monitoring) 的假设是:我知道系统可能出什么问题。所以我预设各种指标阈值——CPU > 80% 告警、内存 > 90% 告警、错误率 > 1% 告警。监控回答的是一个已知集合的问题:我的系统还"健康"吗?
可观测性(Observability) 的假设是:我不知道系统会出什么问题,但我需要能够回答任何关于系统状态的问题。这个定义来自控制论——一个系统是可观测的,当且仅当你可以通过其外部输出来推断其内部状态。
分布式系统的复杂度已经超出了人类预设规则的能力范围。一个慢查询可能因为 GC 停顿、网络抖动、热点 Key、数据库锁竞争、甚至是一个不起眼的配置变更——你不可能为每一种可能性都预设监控。
关键区别:
| 维度 | 监控 | 可观测性 |
|---|---|---|
| 问题域 | 已知的已知 | 未知的未知 |
| 数据驱动 | 预设指标 | 高基数、高维度原始数据 |
| 排障模式 | 查大盘 → 猜原因 → 验证 | 从信号关联中推演 |
| 典型工具 | Zabbix、Nagios | Prometheus + Grafana + Jaeger + Loki |
2.2 可观测性的三根支柱
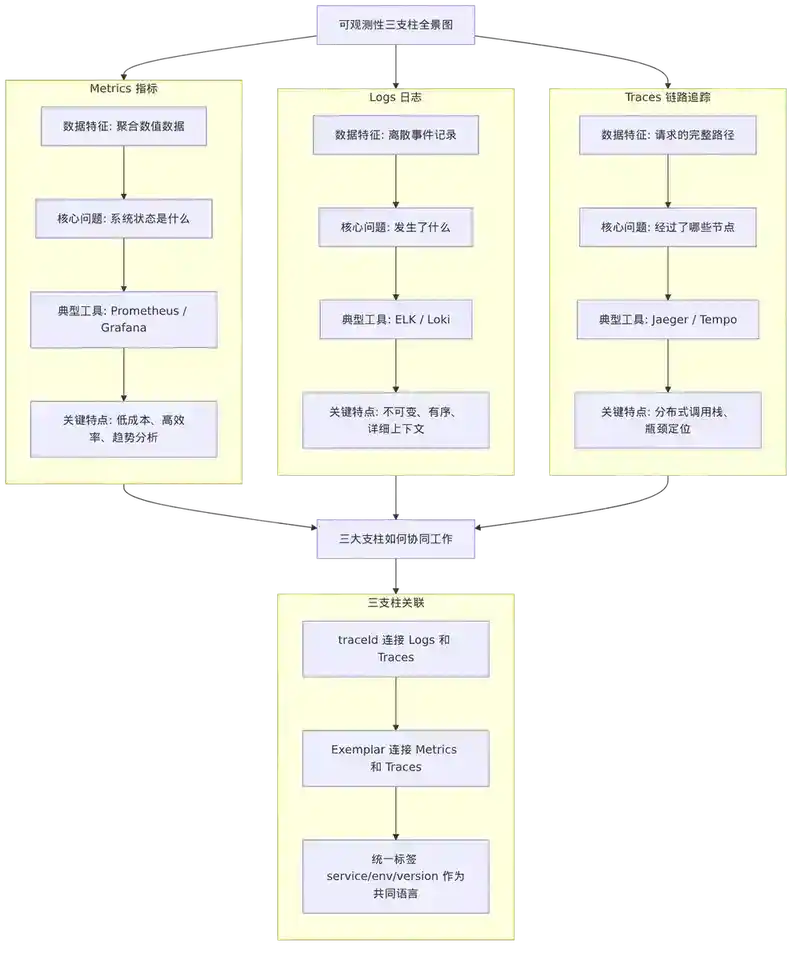
可观测性建立在三种基础信号之上,业界通常称为"三支柱":
- Metrics(指标):聚合后的数值数据,回答"系统现在是什么状态?"
- Logs(日志):离散的事件记录,回答"在某个时刻发生了什么?"
- Traces(链路追踪):请求在分布式系统中的完整路径,回答"一次请求经过了哪些节点?"
三者各有侧重,但孤立使用价值有限。真正让可观测性发挥威力的是三者之间的关联——当你能从一条告警指标跳转到相关日志,再从日志关联到链路追踪的完整调用链,你才真正拥有了"可观测"的能力。
三、Metrics:系统的量化脉搏
3.1 什么是 Metrics?
Metrics 是经过聚合的、带时间戳的数值测量。与日志不同,Metrics 不记录每个事件,而是对事件进行统计聚合——计数、求和、分位数、直方图等。
Metrics 的核心优势是低成本、高效率:
- 存储空间小(一个时序数据点几十字节)
- 查询速度快(时序数据库针对时间范围扫描优化)
- 适合长期趋势分析和告警
3.2 Metrics 的数据模型
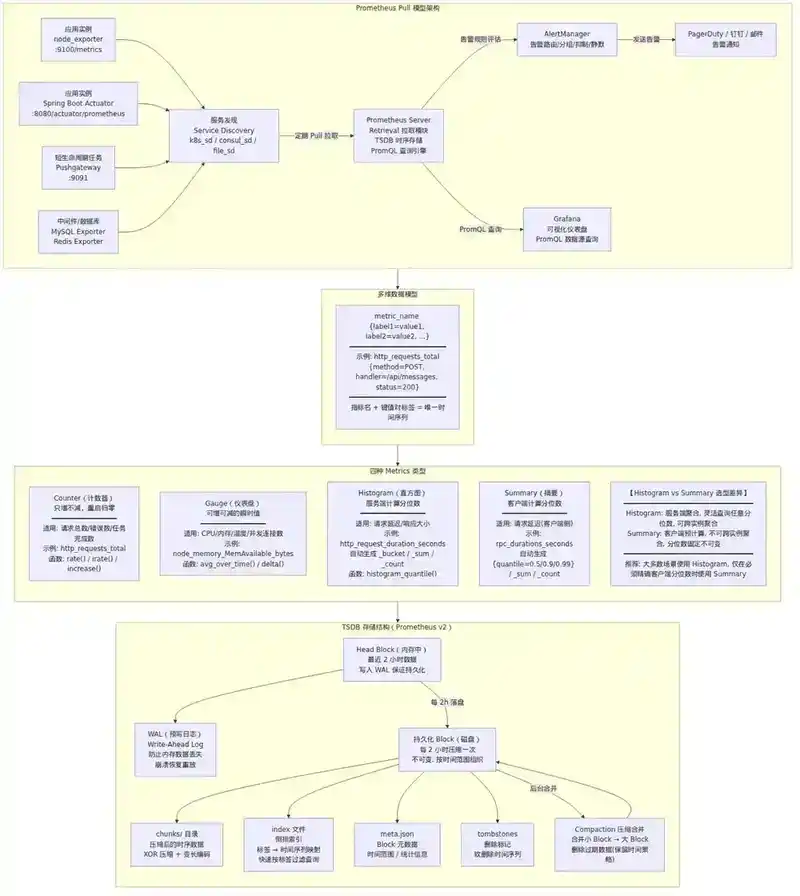
现代 Metrics 体系(以 Prometheus 为代表)采用多维数据模型:
<metric_name>{<label1>=<value1>, <label2>=<value2>} <value> @ <timestamp>
实例:
http_requests_total{method="GET", endpoint="/api/users", status="200"} 1042 @ 1694160000
这里的关键设计是标签(Labels)——它们为指标增加了维度,使得你可以从不同角度聚合和分析数据。但不是所有数据都适合作为标签:
- 标签值基数不能太高:user_id、request_id 不适合作为标签,否则会导致时间序列爆炸
- 标签应该是有限的枚举值:method、status、endpoint 等
3.3 四种核心 Metrics 类型
| 类型 | 用途 | 示例 | 特点 |
|---|---|---|---|
| Counter | 只增不减的计数 | 请求总数、错误总数 | 重启后从 0 开始,需用 rate() 计算速率 |
| Gauge | 可增可减的瞬时值 | CPU 使用率、内存占用、队列长度 | 直接反映当前状态 |
| Histogram | 观测值分布 | 请求延迟分布 | 将数据分桶,可计算分位数,但桶边界需预先定义 |
| Summary | 客户端分位数 | P50/P99 延迟 | 在客户端计算分位数,不能聚合多个实例 |
Histogram vs Summary 的选型:
Histogram 在服务端聚合时更灵活——你可以将多个实例的 Histogram 合并后再计算整体分位数。Summary 的分位数在客户端计算,合并多个 Summary 的分位数在数学上是不准确的。因此在微服务架构中,Histogram 是更推荐的选择。
3.4 Prometheus 核心原理
Prometheus 已成为云原生时代 Metrics 的事实标准。它的核心设计:
Pull 模型:Prometheus Server 主动从目标拉取数据(通过 HTTP /metrics 端点),而非被推送。这带来了几个优势:
- 不需要考虑消息队列的可靠性
- 服务发现集成简单
- 健康检查天然内置(拉取失败即告警)
时序存储引擎:Prometheus 自研的 TSDB 针对 Metrics 场景做了深度优化:
- 每 2 小时一个 Block,包含 chunks 目录(压缩的时间序列数据)和 index(倒排索引)
- 使用 WAL(Write-Ahead Log)保证数据可靠性
- 内存中维护当前 Block 的 head chunk,定期刷盘
PromQL:Prometheus 的查询语言,支持:
- 瞬时向量选择器:
http_requests_total{status="500"} - 范围向量选择器:
rate(http_requests_total[5m]) - 聚合操作:
sum by(instance) (rate(...)) - 函数:
histogram_quantile(0.99, rate(...))
3.5 RED 与 USE 方法论
选择监控什么指标,比配置监控本身更重要。两个经典方法论:
RED 方法(面向服务):
- Rate:每秒请求数
- Errors:失败请求数
- Duration:请求延迟分布
USE 方法(面向资源):
- Utilization:资源利用率
- Saturation:资源饱和度(排队长度)
- Errors:错误数
实际上,RED 和 USE 互补使用:RED 从服务视角发现问题,USE 从资源视角定位瓶颈。
四、Logs:时间的忠实记录者
4.1 日志的本质
日志是不可变、带时间戳的离散事件记录。一条日志回答"在某个时刻,某个实体发生了什么"。
日志的核心特征:
- 不可变性:日志一旦产生就不应被修改(类似会计中的"划线更正"而非"涂改")
- 有序性:日志按时间顺序排列,这是排障时追溯因果关系的基础
- 离散性:每条日志是一个独立事件,日志之间没有强制的结构关系
4.2 结构化日志:从文本到数据
传统日志的问题在于它是非结构化的:
2024-09-01 10:23:45 ERROR [UserService] Failed to login user 12345: connection timeout
运维人员靠 grep + 正则表达式来提取信息,这在分布式系统中完全不可行。
结构化日志将日志视为结构化数据(通常是 JSON 格式):
{
  "timestamp": "2024-09-01T10:23:45.123Z",
  "level": "ERROR",
  "service": "user-service",
  "instance": "user-service-pod-7f3a",
  "traceId": "a1b2c3d4e5f6",
  "spanId": "a1b2c3d4",
  "message": "Failed to login user",
  "userId": "12345",
  "error": "connection timeout",
  "duration_ms": 3001,
  "dbHost": "mysql-primary-1"
}
关键字段的含义:
traceId/spanId:关联到分布式链路追踪(三支柱关联的核心)level:日志级别,支持按严重程度过滤service/instance:在分布式系统中定位日志来源- 业务字段:
userId、orderId等,按业务维度搜索
4.3 日志处理流水线
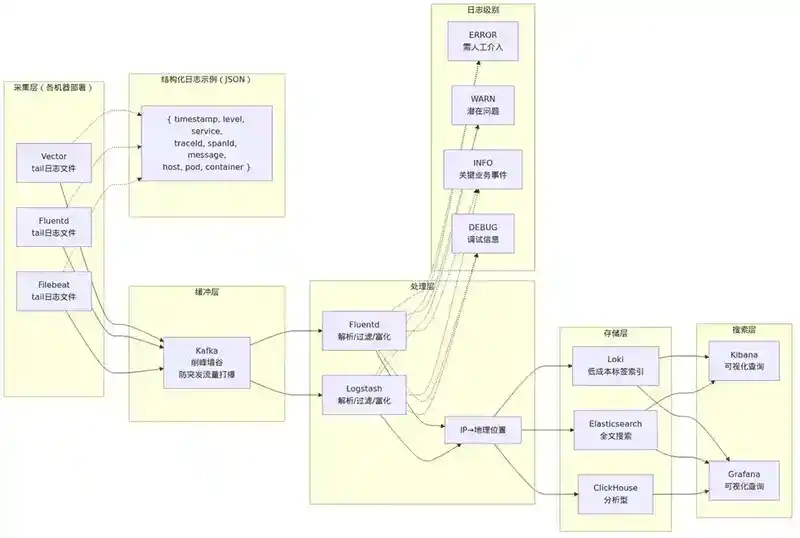
现代日志系统通常采用以下架构:
采集 → 缓冲 → 处理 → 存储 → 搜索
- 采集层:Filebeat / Fluentd / Vector 等 Agent 部署在每台机器上,tail 日志文件并推送
- 缓冲层:Kafka 等消息队列,削峰填谷,防止日志平台被突发流量打爆
- 处理层:Logstash / Fluentd 进行解析、过滤、富化(如从 IP 解析出地理位置)
- 存储层:Elasticsearch(全文搜索)、Loki(轻量级,按标签索引)、ClickHouse(分析型)
- 搜索层:Kibana / Grafana,提供可视化查询界面
4.4 日志规范
日志不应该是开发者的"心理活动记录"。好的日志规范:
级别定义:
- ERROR:需要人工介入处理的问题(支付失败、数据库连接断开)
- WARN:潜在问题但不影响当前请求(降级、重试成功、接近限流阈值)
- INFO:关键业务事件(用户注册、订单创建、配置变更)
- DEBUG:开发调试信息,生产环境默认关闭
内容原则:
- 每条日志应包含 traceId,能关联到调用链
- 敏感信息(密码、Token、身份证号)必须脱敏
- 日志量要可控——避免在循环中打印日志
- 关键决策点必须记录:为什么拒绝了这个请求?为什么走了降级逻辑?
五、Traces:还原请求的完整旅程
5.1 分布式追踪的核心理念
在单体应用中,一次请求的所有处理都在一个进程内,你可以通过调用栈来理解程序行为。但在微服务架构中,一次请求可能经过十几个服务,每个服务又有多个实例——你需要一个机制来还原这个"分布式调用栈"。
分布式追踪就是为此而生。它记录一次请求在分布式系统中的完整路径,包括经过了哪些服务、每个服务耗时多少、哪里是瓶颈。
5.2 核心概念:Trace、Span 与 Context
- Trace:一次完整的请求链路,由多个 Span 组成,用一个全局唯一的 traceId 标识
- Span:Trace 中的一个操作单元,代表一次具体的服务调用或内部操作。每个 Span 包含:
- 操作名称、开始/结束时间、标签(Tags)、日志事件(Logs)
- 父子关系:通过
parentSpanId建立 Span 之间的层级关系
- SpanContext:在服务间传递的上下文信息,包含:
- traceId:全局唯一,标识整个请求链路
- spanId:当前 Span 的唯一标识
- 采样标志:决定是否记录此 Trace
5.3 上下文传播:Trace 如何跨越服务边界
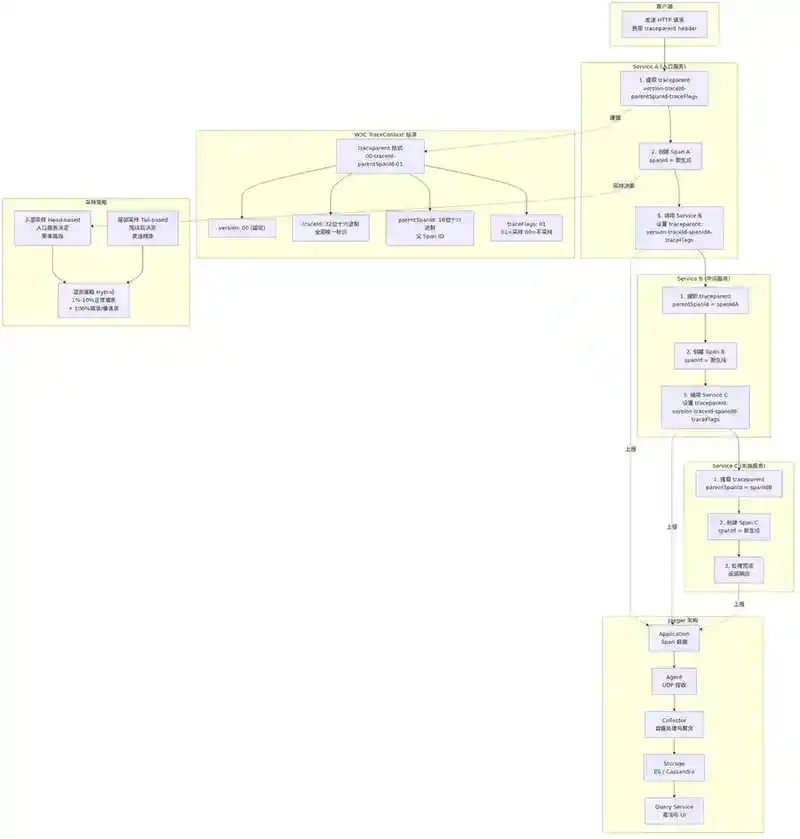
这是分布式追踪最核心的技术挑战。当一个 HTTP 请求从服务 A 发往服务 B 时,如何让 B 知道它是 A 的某个 Span 的子 Span?
答案是通过请求头传播 SpanContext:
// 服务 A 发出的 HTTP 请求头
traceparent: 00-a1b2c3d4e5f6a1b2c3d4e5f6a1b2c3d4-a1b2c3d4e5f6a1b2-01
tracestate: vendor1=opaqueValue1
W3C TraceContext 标准定义了 traceparent 头的格式:
version-traceId-parentSpanId-traceFlags
traceId:16 字节,全局唯一parentSpanId:8 字节,父 Span IDtraceFlags:采样标志(01 表示记录)
关键实现细节:每个服务在收到请求时,从 traceparent 头提取 traceId 和 parentSpanId,然后创建自己的 Span(生成新的 spanId),再在调用下游时将自己的 spanId 作为新的 parentSpanId 传递。
5.4 采样策略
如果记录所有请求的 Trace,存储和网络开销会非常大。因此需要采样:
头部采样(Head-based Sampling):在请求入口处决定是否采样。简单但"一刀切"——所有服务和所有请求类型同等对待。
尾部采样(Tail-based Sampling):在请求完成后决定是否保留。可以根据请求的最终状态(是否出错、延迟是否异常)来决定。更智能但需要缓冲所有 Span 直到请求完成。
实际建议:生产环境中,通常采用混合策略——头部采样保留 1%-10% 的正常请求,尾部采样保留所有错误和慢请求。
5.5 Jaeger 架构
Jaeger 是 CNCF 毕业的分布式追踪系统,架构设计清晰:
- Agent:部署在每个节点上,通过 UDP 接收 Span 数据(最小化对应用的性能影响)
- Collector:从 Agent 接收数据,验证、转换后写入存储
- Query:提供 UI 和 API 查询
- Storage:支持 Elasticsearch、Cassandra 等后端
六、三支柱的关联:从割裂到统一
6.1 为什么需要关联?
孤立的三个支柱各自有价值,但价值有限。真正的问题场景是:
告警说 P99 延迟升高 → 哪个服务?哪个接口? → 看 Metrics 大盘,发现
payment-service的延迟升高
→ 看这个服务的日志,有大量 timeout 错误
→ 但日志中的错误慢查询是哪个请求触发的?
→ 从日志中提取 traceId,去 Tracing 中查看完整调用链
→ 发现是数据库的某个查询突然变慢,而这个查询与一个新上线的功能有关
这个排障路径需要 Metrics → Logs → Traces 的无缝跳转。
6.2 关联的技术手段
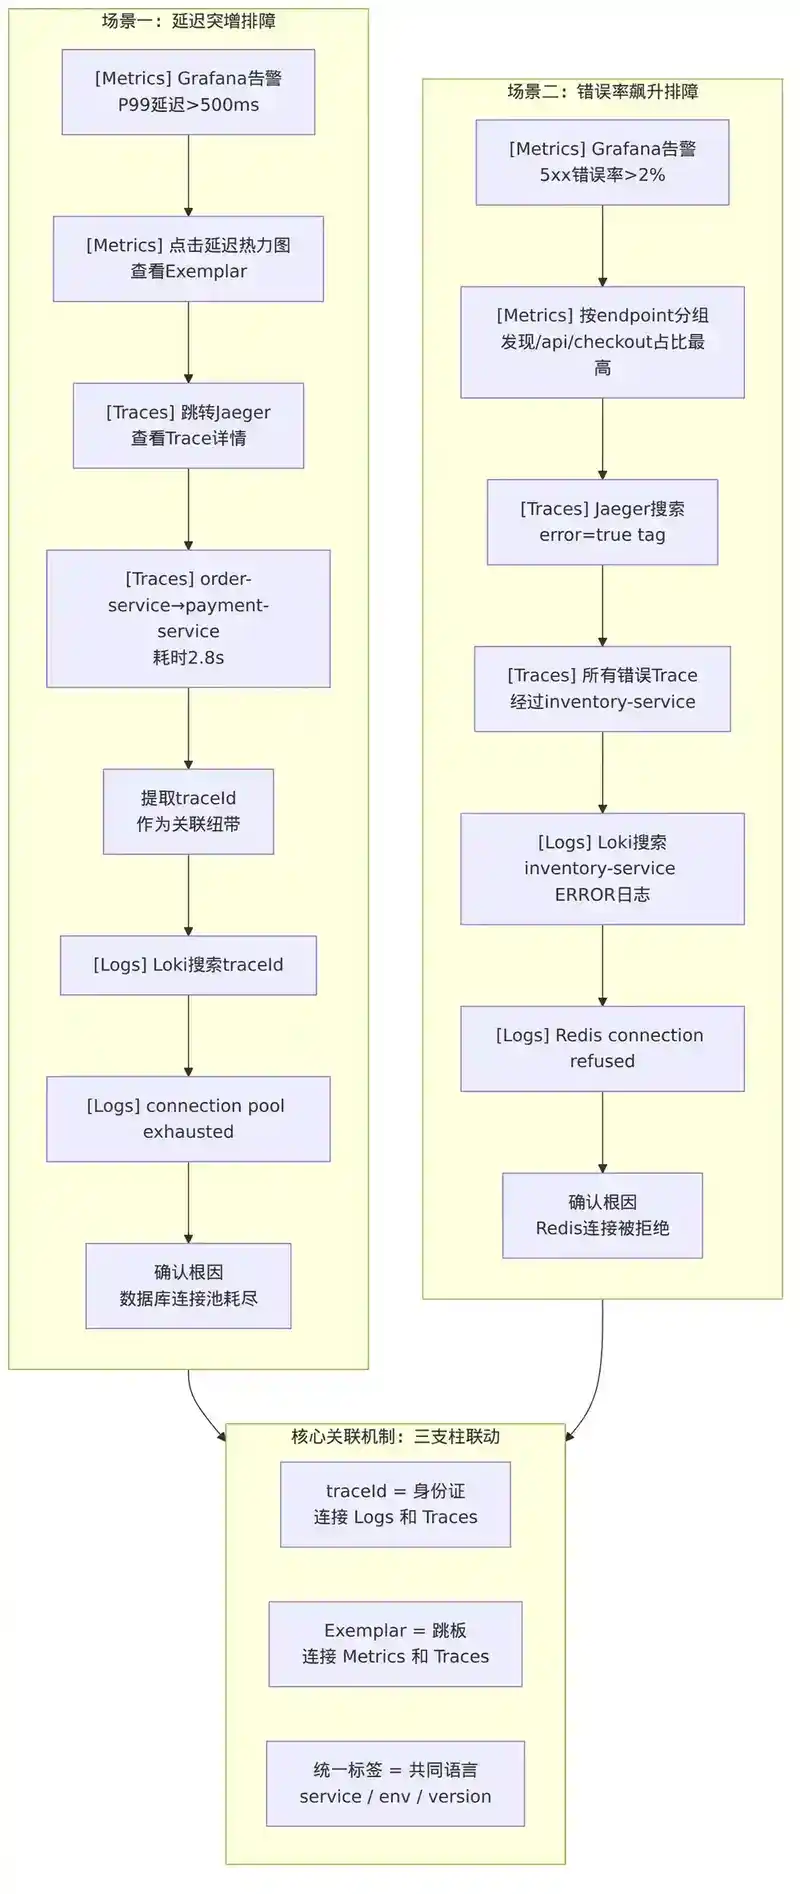
Exemplar(示例):Prometheus 支持在 Histogram 中附加 Exemplar——即一个分桶中的具体请求的 traceId。这样你在 Grafana 的延迟热力图上点击,就能直接跳转到 Jaeger 中对应的 Trace。
# 这是 Prometheus 的 OpenMetrics 格式
http_request_duration_seconds_bucket{le="0.1"} 230
http_request_duration_seconds_bucket{le="0.1"} 230 # {traceId="a1b2c3"} 0.047
TraceId in Logs:每条结构化日志携带 traceId,Elasticsearch / Loki 中可以通过 traceId 搜索到该请求的所有日志。
Span Tags as Metrics:将 Span 中的 Tags 导出为 Metrics(如 request_duration Histogram),使 Tracing 数据也能被监控告警。
6.3 实际排障工作流
场景一:延迟突增
- Metrics:Grafana 告警 → P99 延迟突破 500ms → 点击延迟热力图 → 查看 Exemplar → 跳转到 Jaeger
- Traces:Jaeger 显示
order-service→payment-service调用耗时 2.8s → 提取 traceId - Logs:在 Loki 中搜索 traceId → 看到
payment-service日志中connection pool exhausted→ 根因确认:数据库连接池耗尽
场景二:错误率飙升
- Metrics:5xx 错误率从 0.01% 跳到 2% → 按 endpoint 分组,发现
/api/checkout占比最高 - Traces:搜索包含
error=truetag 的 Trace → 发现所有错误 Trace 都经过inventory-service的某个方法 - Logs:搜索该方法的 ERROR 日志 → 发现
Redis connection refused→ 根因确认:Redis 连接被拒绝
6.4 统一上下文:不只是技术问题
三支柱的统一不仅是工具层面的集成,更是组织层面的协作。当 Metrics 是 SRE 团队维护、Logs 是开发团队关注、Traces 是架构组负责时,三个系统难以真正打通。
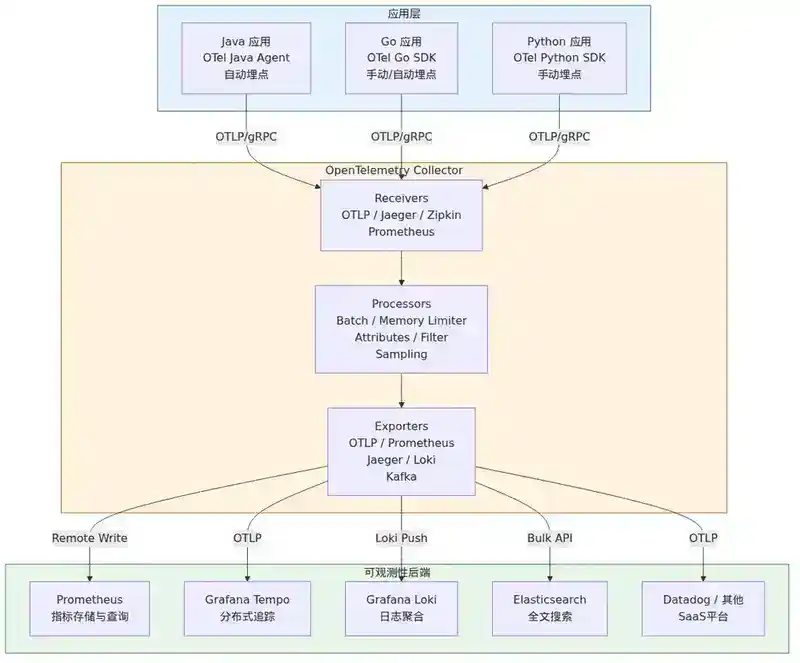
统一上下文的核心:
- traceId 是"身份证":贯穿日志和追踪,是连接两者的桥梁
- Exemplar 是"钩子":从聚合指标跳转到具体请求
- 统一的元数据标签:service、env、region、version 等标签在三支柱中保持一致
七、OpenTelemetry:统一可观测性标准
7.1 为什么需要统一标准?
在 OpenTelemetry 之前,可观测性生态是碎片化的:Prometheus 有自己的 SDK,Jaeger 有自己的 SDK,ELK 有自己的采集方式。开发者需要同时集成多个 SDK 才能采集完整的可观测性数据。
OpenTelemetry(OTel) 是 CNCF 的第二个最活跃项目(仅次于 Kubernetes),它提供了统一的可观测性数据采集标准。
7.2 核心架构
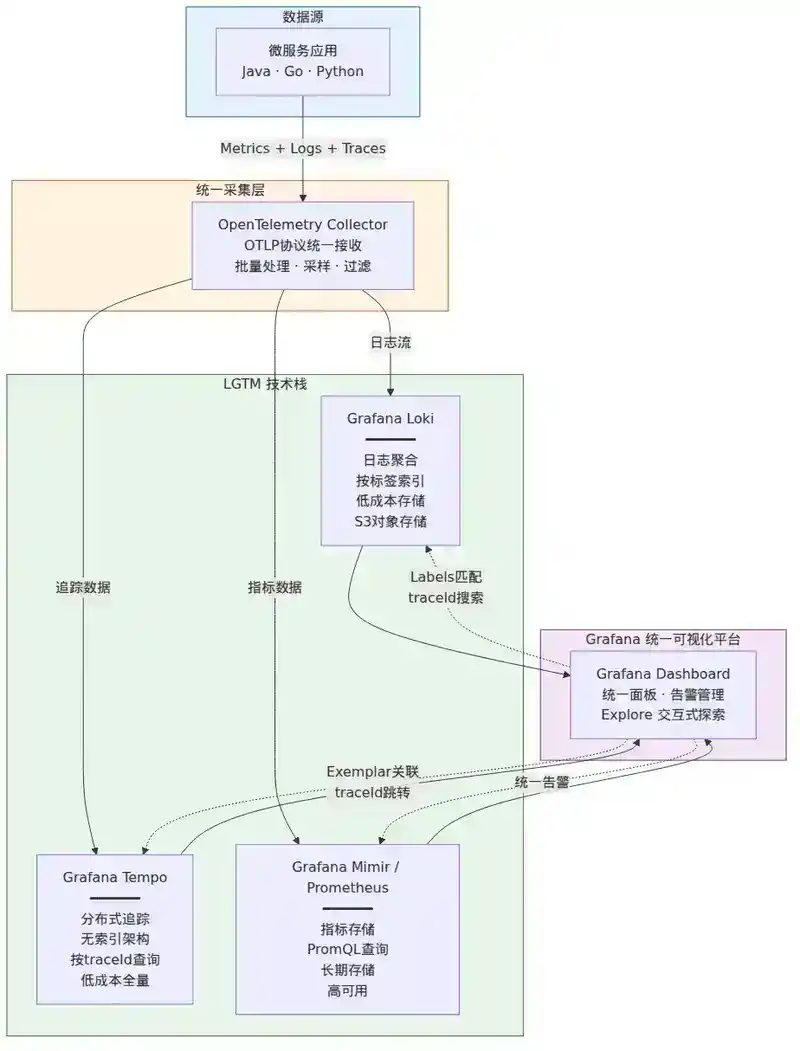
OpenTelemetry 的核心组件:
- API:定义数据模型和接口,应用代码只依赖 API
- SDK:API 的实现,负责采样、处理、导出
- Collector:独立部署的代理,接收、处理、导出数据(支持多种协议)
- Exporters:将数据导出到后端(Prometheus、Jaeger、Elasticsearch 等)
关键设计理念:分离数据采集和数据存储。开发者只需要集成 OTel SDK,具体数据发到哪里(Prometheus?Datadog?)通过配置决定,无需改代码。
7.3 数据模型
OTel 定义了三种核心信号(Signals):
- Metrics:支持 Sum、Gauge、Histogram 等类型,兼容 Prometheus 数据模型
- Logs:统一日志数据模型,支持与 Trace 的关联
- Traces:Span 和 Trace 的数据模型,支持 W3C TraceContext 传播
关键创新 —— Resource:OTel 引入了 Resource 概念,描述生成数据的实体(服务名、实例 ID、K8s Pod 信息等)。所有信号共享同一个 Resource,确保不同信号之间的元数据一致。
7.4 Java 集成
// 1. 引入依赖(无需关心具体后端)
// io.opentelemetry:opentelemetry-api
// io.opentelemetry:opentelemetry-sdk
// io.opentelemetry:opentelemetry-exporter-otlp

// 2. 自动埋点(Java Agent 方式,零代码侵入)
// java -javaagent:opentelemetry-javaagent.jar -jar myapp.jar

// 3. 手动埋点(需要更细粒度的控制)
Tracer tracer = GlobalOpenTelemetry.getTracer("my-service");
Span span = tracer.spanBuilder("processOrder").startSpan();
try (Scope scope = span.makeCurrent()) {
    span.setAttribute("order.id", orderId);
    span.setAttribute("order.amount", amount);
    // 业务逻辑
    processOrder(order);
    span.setStatus(StatusCode.OK);
} catch (Exception e) {
    span.setStatus(StatusCode.ERROR, "Order processing failed");
    span.recordException(e);
    throw e;
} finally {
    span.end();
}
八、生产实践:可观测性平台建设
8.1 技术选型
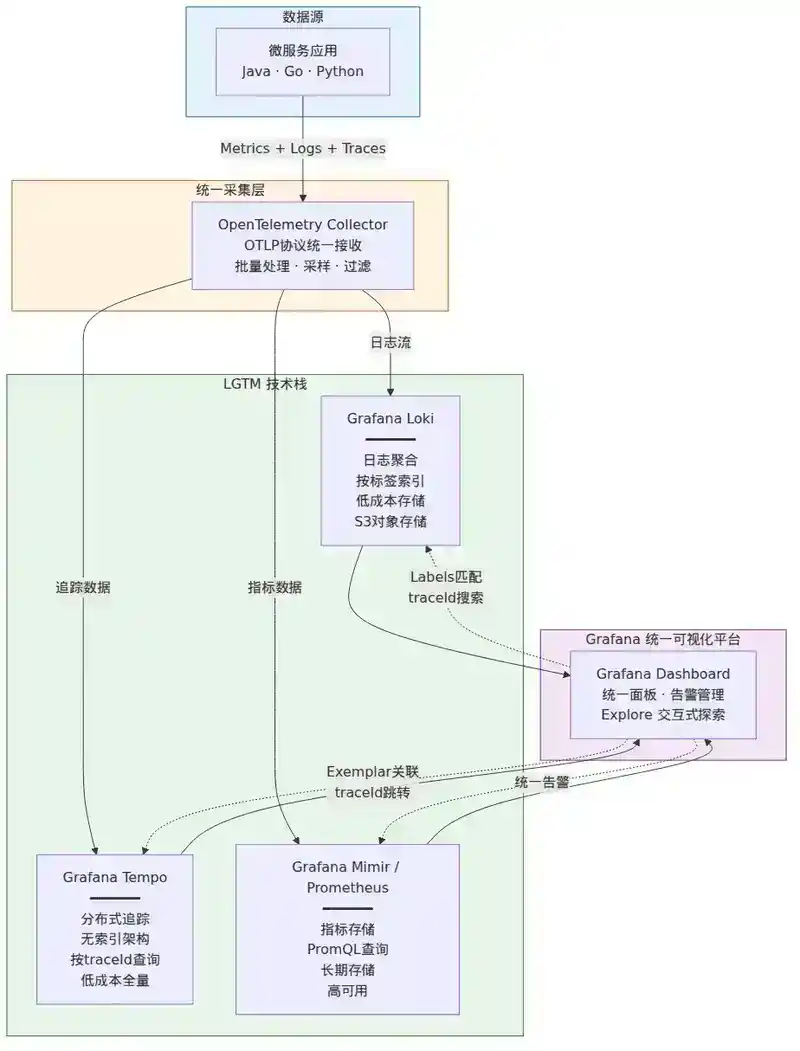
一个典型的开源可观测性栈(LGTM 栈):
| 组件 | 工具 | 用途 |
|---|---|---|
| Metrics | Prometheus + Grafana | 指标采集、存储、可视化、告警 |
| Logs | Grafana Loki | 日志聚合、按标签索引、搜索 |
| Traces | Grafana Tempo | 分布式追踪存储和查询 |
| 采集 | OpenTelemetry Collector | 统一采集、处理、导出 |
| 告警 | Grafana Alerting | 统一告警管理器 |
为什么选 Loki 而非 EFK(Elasticsearch + Fluentd + Kibana)?
- Loki 不对日志内容建立全文索引,只对标签(如 service、env)建索引,成本远低于 Elasticsearch
- Loki 与 Grafana 深度集成,在同一个界面中查看 Metrics、Logs、Traces
- Loki 使用与 Prometheus 相同的标签模型,运维心智负担低
8.2 数据治理
可观测性数据会快速增长,没有治理就是灾难:
存储成本控制:
- Metrics:Prometheus 默认保留 15 天,长期存储通过 Thanos/Cortex 降采样
- Logs:设置日志保留策略(如 7 天热数据、30 天温数据),ERROR 级别保留更久
- Traces:采样率控制,正常请求采样 1%,错误/慢请求全量保留
数据质量:
- 强制结构化日志:通过日志框架配置,禁止
System.out.println - 统一标签规范:所有服务使用相同的标签命名(service、env、version),避免
service_namevsserviceName的混乱 - traceId 全覆盖:所有 HTTP/RPC 调用必须携带 traceId
8.3 告警体系设计
告警是 Metrics 最重要的消费场景。好的告警体系:
症状告警 vs 原因告警:
- 症状告警:用户感知到的(P99 延迟 > 1s、错误率 > 1%)——应该告警
- 原因告警:系统内部指标(CPU > 80%、连接池使用率 > 90%)——应该告警但需要更谨慎
告警规则设计原则:
- 基于 SLO 设置阈值:如 P99 延迟 > 500ms 持续 5 分钟
- 使用
for子句避免瞬态告警:for: 5m表示条件持续 5 分钟才触发 - 告警分级:P0(立即处理)、P1(1 小时)、P2(工作日处理)
- 告警收敛:同一告警在 2 小时内不重复发送
九、常见误区和陷阱
误区一:把 Metrics 当 Logs 用
有些团队为了做"精细化监控",在 Metrics 标签中加了 userId、requestId——这会导致时间序列爆炸。每条唯一的标签组合都是一个独立的时序,高基数标签会快速耗尽 Prometheus 的内存。
正确做法:Metrics 用有限基数的标签(method、status、endpoint),具体请求的细节去 Logs 和 Traces 中查。
误区二:日志级别滥用
log.error("User not found: {}", userId) —— 用户不存在是一个正常的业务场景,不应该打 ERROR 日志。ERROR 意味着需要人工介入。
正确做法:业务异常用 WARN,系统异常用 ERROR。严格区分"业务失败"和"系统故障"。
误区三:全量采集 Trace
"采集所有 Trace 数据,这样任何问题都能回溯"——这在流量大的系统中完全不现实。每个请求的 Trace 可能包含几十个 Span,每个 Span 包含 Tags 和 Events,全量采集的存储成本可能超过业务数据本身。
正确做法:头部采样 1%-10%,尾部采样保留错误和慢请求。
误区四:过度依赖单一支柱
"我们上了 Prometheus,监控很全面了"——但 Prometheus 不能告诉你一个请求的完整调用链。"我们上了 ELK,日志全量搜索"——但日志搜索不能展示延迟的聚合趋势。"我们上了 Jaeger,链路追踪全覆盖"——但 Tracing 不能告诉你系统整体的 QPS 和错误率。
正确做法:三支柱互补使用,并通过 traceId 和 Exemplar 相互关联。
十、总结
可观测性不是"装一套 Prometheus + ELK + Jaeger"就完事了。它的核心是让开发者能够回答关于系统内部状态的任何问题,而不需要事先预测这些问题。
三个支柱的角色:
- Metrics:告诉你"系统出了什么问题"——聚合趋势和异常检测
- Logs:告诉你"为什么出问题"——详细的上下文和业务事件
- Traces:告诉你"问题出在哪里"——分布式系统中的瓶颈定位
三支柱关联的核心:traceId 是贯穿全链路的"身份证",Exemplar 是 Metrics 到 Traces 的"跳板",统一的标签规范是跨支柱搜索的"共同语言"。
技术选型建议:拥抱 OpenTelemetry 标准,使用 LGTM 栈(Loki + Grafana + Tempo + Mimir/Prometheus)作为可观测性底座,在三支柱的关联中构建真正的排障能力。
面试官视角:提问与回答
以下问题从面试官视角出发,考察候选人对可观测性的理解深度,而非简单复述概念。
Q1:Prometheus 的 Histogram 和 Summary 都能计算分位数,什么场景下必须用 Histogram?
考察点:对聚合特性的理解。
参考回答:当你需要聚合多个实例的数据时,必须用 Histogram。因为 Histogram 记录的是各分桶的计数,多个实例的 Histogram 可以合并(将同一分桶的计数相加),然后从合并后的分布计算分位数。Summary 的分位数在客户端计算(如 P99 = 150ms),两个实例的 P99 不能直接合并成整体的 P99——这在数学上是不准确的。在微服务架构中,一个服务有多个实例,我们需要聚合后的整体 P99,因此 Histogram 是更合适的选择。
Q2:如果一条日志里没有 traceId,你怎么把它和 Trace 关联起来?
考察点:对"统一上下文"实现原理的深入理解,以及应对非理想场景的变通能力。
参考回答:如果日志中缺少 traceId,可以通过以下方式补救:
- 时间窗口关联:根据日志的时间戳,查找同一时间段内的 Trace 数据,通过
service+endpoint+error message等维度交叉匹配。 - 请求内容关联:如果日志中有
userId、orderId等业务 ID,可以在 Trace Tags 中搜索这些 ID,找到对应的 Trace。 - 从源头修复:这本质上是个数据质量问题,应该推动团队在日志框架中自动注入 traceId(如 Logback 的 MDC 机制 + OpenTelemetry 自动埋点)。一次修复,永久受益。
这题的加分回答是:你不能只依赖工具,还需要理解数据关联的底层逻辑。
Q3:为什么 OpenTelemetry 要引入 Collector 组件?直接把数据发给后端不好吗?
考察点:对架构设计权衡的理解。
参考回答:Collector 的价值在于解耦:
- 协议统一:不同后端(Prometheus、Jaeger、Datadog)有不同的数据格式和协议。Collector 在中间做协议转换,应用只需对接 OTLP 协议。
- 处理能力:Collector 可以做采样、过滤、脱敏、批处理、重试等操作,这些逻辑放在应用侧会增加复杂度和资源消耗。
- 运维灵活性:更换后端不需要改应用代码或重启服务,只需改 Collector 配置。
- 降低客户端开销:Collector 本地部署,应用通过 gRPC 低延迟推送数据,由 Collector 负责与远程后端的网络交互。
这本质上是一个代理模式——将"数据生产"和"数据消费"解耦,各自独立演进。
Q4:在微服务架构中,一个请求经过 10 个服务,每个服务 3 个实例,Trace 数据如何确保不丢失?
考察点:对分布式追踪数据完整性的理解。
参考回答:
- 上下文传播不会丢失:traceId 和 spanId 通过 HTTP Header(
traceparent)或 RPC Metadata 在服务间传播,只要框架正确集成了 OpenTelemetry,就不会丢失。 - Span 数据上报可能丢失:应用通过 UDP(Jaeger Agent)或 gRPC(OTLP)上报 Span 数据到 Collector。UDP 天然不可靠,gRPC 虽然有重试,但在应用崩溃时也可能丢失。解决方案:
- 在应用侧使用内存缓冲队列,避免网络抖动导致的瞬时丢失
- 在 Collector 前部署 Kafka 缓冲层,解耦采集和存储
- 关键 Span 标记为"必须采样"(
sampled=true),确保不被丢弃
- 部分丢失是可接受的:可观测性的目标是"足够好"而非"完美"。采样本身就是一种有意的数据丢弃,只要能覆盖异常和慢请求的 Trace,就已经能满足排障需求。
Q5:如果让你设计一个公司级的可观测性平台,你如何说服不同团队统一使用 OpenTelemetry?
考察点:技术推广和架构治理能力。
参考回答:这不是纯技术问题,而是组织协调问题。我的策略是:
- 先解决痛点:找一两个有强烈排障需求的团队做试点,证明"Metrics + Logs + Traces 关联"能大幅缩短排障时间(从小时级降到分钟级)。
- 降低迁移成本:OpenTelemetry 的 Java Agent 自动埋点几乎零代码侵入,只需要在启动参数中加一行
-javaagent。对于已有自定义埋点的团队,提供迁移指南和兼容方案。 - 统一标准但不强制工具:规定所有服务必须输出 OTel 格式的数据,但具体后端(Prometheus/Jaeger/Datadog)各团队可以自己选——只要数据格式统一,未来在平台层做聚合就有基础。
- 平台化封装:提供统一的 SDK starter 和 K8s Sidecar 注入方案,让接入变成"改一行配置"而非"引入一堆依赖"。
本文为"Java 技术专家与架构师面试:250 个高频考点"系列第 221 篇,下一篇将介绍分布式链路追踪的深入实现原理。