阅读时间:约 45 分钟 | 难度:高级 | 适用方向:Java 架构师 / 技术专家 / SRE
一、为什么需要全链路压测
线上故障中,有一类问题最让人头疼:功能测试全部通过,上线后却挂了。原因通常是测试环境与生产环境在数据量、并发量、网络拓扑、第三方依赖等方面存在巨大差异。你永远无法在 4 核 8G 的 Staging 环境里,模拟出 500 万用户在双十一零点同时抢购的场景。
全链路压测(Full-Link Stress Testing)要解决的就是这个"环境失真"问题——直接在线上生产环境上制造可控的压测流量,模拟真实用户行为,从入口到存储全链路贯通。
但要在生产环境上做压测,必须解决四个核心问题:
- 流量识别:如何区分压测流量和真实用户流量?
- 数据隔离:压测产生的数据如何不污染真实业务数据?
- 资源隔离:压测流量如何不影响真实用户的体验?
- 容量评估:如何从压测结果中得出准确的容量结论?
下面我们逐一拆解。
二、流量染色:给每一条请求打上"压测"标签
(此处插入图片:fig1 - 流量染色原理示意图)
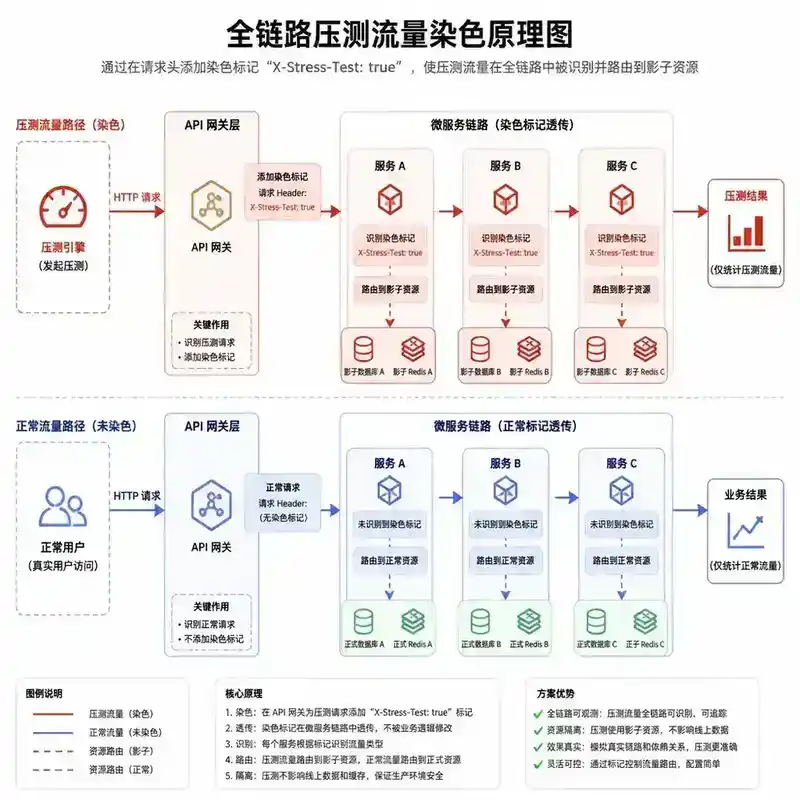
2.1 什么是流量染色
流量染色(Traffic Dyeing)是指在请求的入口处,给压测流量打上一个全局唯一的标记,使得后续的每一个下游服务都能识别出"这是一条压测请求"。这个标记必须在整个调用链中透传,不能丢失。
2.2 染色方案
方案一:HTTP Header 透传
最常见的做法是在 HTTP 请求头中添加一个特殊字段:
X-Stress-Test: true
X-Stress-Test-Id: 550e8400-e29b-41d4-a716-446655440000
在微服务架构中,这个 Header 需要被框架层面的拦截器或过滤器自动提取,并写入链路追踪上下文(如 OpenTelemetry 的 Span Attributes、SkyWalking 的 Trace Context、或者公司自研的 RPC 框架的 Attachments 中)。
Java 实现示例(网关层):
@Component
public class StressTestFilter implements GlobalFilter {
    private static final String STRESS_HEADER = "X-Stress-Test";

    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        ServerHttpRequest request = exchange.getRequest();
        boolean isStress = "true".equals(request.getHeaders().getFirst(STRESS_HEADER));
        if (isStress) {
            // 写入 Reactor Context,后续 Feign/Dubbo 调用自动透传
            return chain.filter(exchange)
                .contextWrite(ctx -> ctx.put(StressTestContext.KEY, true));
        }
        return chain.filter(exchange);
    }
}
方案二:RPC 框架层透传
对于 Dubbo 或 gRPC 这样的 RPC 框架,通过框架的隐式传参机制(Dubbo 的 RpcContext 或 Attachments)来透传压测标记:
// 服务消费方:设置压测标记
RpcContext.getContext().setAttachment("stress-test", "true");

// 服务提供方:读取压测标记
String isStress = RpcContext.getContext().getAttachment("stress-test");
if ("true".equals(isStress)) {
    // 走影子表、影子缓存等压测路径
}
方案三:消息队列染色
对于通过 MQ(Kafka / RocketMQ)传递的异步消息,染色标记需要写入消息的 Properties/Header 中:
// RocketMQ 生产者
Message msg = new Message("order-topic", body);
msg.putUserProperty("stress-test", "true");
producer.send(msg);

// RocketMQ 消费者
String isStress = msg.getUserProperty("stress-test");
方案四:链路追踪框架集成
在 OpenTelemetry / SkyWalking / Jaeger 等链路追踪框架中,通过 Baggage 机制传递染色标记:
// OpenTelemetry Baggage 透传
Baggage.current().toBuilder()
    .put("stress.test", "true")
    .build()
    .makeCurrent();
2.3 染色的关键设计原则
- 全局唯一性:同一个压测任务的标记应该在所有服务中保持一致
- 不可丢失性:任何中间件、网关、代理层都不能丢弃这个标记
- 最小侵入性:对业务代码的影响尽可能小,最好通过框架/AOP 统一处理
- 可追溯性:染色标记需要与链路追踪 ID 关联,方便事后排查
三、影子库表:压测数据不碰生产数据
(此处插入图片:fig2 - 影子库表架构示意图)
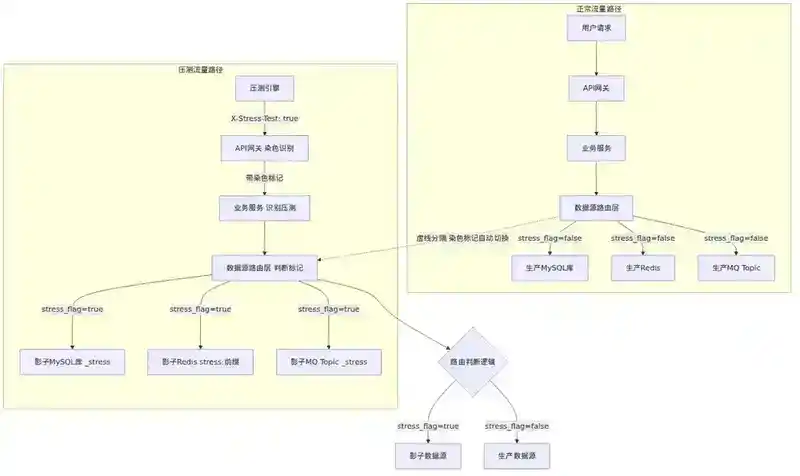
3.1 问题定义
压测流量到达数据库时,如果直接读写生产库的生产表,会产生两个严重问题:
- 数据污染:压测产生的订单、用户、日志等数据混入真实数据
- 性能干扰:压测的读写操作消耗数据库连接池和 IO,影响真实用户
影子库表(Shadow Table)方案的核心思想是:为集群中的每一个服务,在压测时将其数据源透明地切换到影子数据源,读写操作完全隔离。
3.2 实现方案
方案一:同库影子表
在同一个数据库中,为每张表创建一个影子表(表名加 _stress 后缀):
-- 生产表
CREATE TABLE orders (
    id BIGINT PRIMARY KEY,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status VARCHAR(20)
);

-- 影子表(结构完全一致)
CREATE TABLE orders_stress (
    id BIGINT PRIMARY KEY,
    user_id BIGINT,
    amount DECIMAL(10,2),
    status VARCHAR(20)
);
优点:部署简单,不需要额外的数据库实例 缺点:共享同一数据库资源,无法完全隔离 IO 和 CPU;维护成本高,每增加一张表就要建一张影子表
方案二:独立影子库
为每个数据库实例创建独立的影子库(库名加 _stress 后缀):
生产库:order_db          →  影子库:order_db_stress
生产库:user_db           →  影子库:user_db_stress
优点:资源完全隔离,压测不会影响生产库性能 缺点:需要额外的数据库实例,成本较高
方案三:基于中间件的动态路由(推荐)
通过数据库中间件(如 ShardingSphere-Proxy)实现压测流量的动态路由:
# ShardingSphere 影子库配置
rules:
  - !SHADOW
    column: stress_flag
    dataSources:
      shadowDataSource:
        sourceDataSourceName: ds_production
        shadowDataSourceName: ds_shadow
    tables:
      orders:
        dataSourceNames:
          - shadowDataSource
ShardingSphere 影子库的核心原理:通过判断 SQL 中的 stress_flag 字段(或通过 Hint 机制注入),自动将 SQL 路由到影子数据源。业务代码无需任何修改。
// 业务代码完全无感知
// 压测线程通过 HintManager 注入影子标记
HintManager hintManager = HintManager.getInstance();
hintManager.setShadow(true);
// 此后的所有 SQL 自动路由到影子库
orderMapper.insert(order);
hintManager.close();
方案四:MyBatis 插件层拦截
如果不使用 ShardingSphere,也可以通过 MyBatis 插件在 SQL 执行前动态修改表名:
@Intercepts({
    @Signature(type = Executor.class, method = "update", args = {MappedStatement.class, Object.class}),
    @Signature(type = Executor.class, method = "query", args = {MappedStatement.class, Object.class, RowBounds.class, ResultHandler.class})
})
public class ShadowTableInterceptor implements Interceptor {
    @Override
    public Object intercept(Invocation invocation) throws Throwable {
        if (StressTestContext.isStress()) {
            MappedStatement ms = (MappedStatement) invocation.getArgs()[0];
            // 动态替换表名:orders → orders_stress
            // 注意:这里需要处理 BoundSql 中的 SQL 改写
            modifyTableName(ms);
        }
        return invocation.proceed();
    }
}
3.3 影子 Redis / ES / MQ
不仅仅是数据库,整个链路中所有有状态存储都需要"影子化":
| 组件 | 影子方案 | 实现方式 |
|---|---|---|
| Redis | 影子 Key 前缀 | stress:cache:user:123 vs cache:user:123 |
| Elasticsearch | 影子索引 | order&#95;index&#95;stress vs order&#95;index |
| RocketMQ | 影子 Topic | order-topic-stress vs order-topic |
| MongoDB | 影子 Collection | orders&#95;stress vs orders |
3.4 影子库的数据一致性
影子库中的表结构需要和生产库保持一致。推荐方案:
- DDL 同步:生产库执行 DDL 时,通过 CI/CD 流水线自动同步到影子库
- 定期校验:每天凌晨对比生产库和影子库的表结构,发现不一致即时告警
- 影子表自动创建:在压测框架中,首次访问某张影子表时,如果不存在则自动从生产表复制结构
四、隔离机制:压测流量不能影响真实用户
(此处插入图片:fig3 - 隔离机制分层架构图)
4.1 隔离的三个层次
| 层次 | 目标 | 典型方案 |
|---|---|---|
| 数据隔离 | 压测数据不污染生产数据 | 影子库表、影子缓存、影子 MQ |
| 资源隔离 | 压测不占满生产资源 | 线程池隔离、限流、集群隔离 |
| 逻辑隔离 | 压测不触发真实副作用 | 挡板/Mock、不发真实短信/推送 |
4.2 线程池隔离
在服务内部,压测请求和正常请求使用不同的线程池,防止压测流量占满所有线程导致正常请求被阻塞:
@Service
public class OrderService {
    private final ExecutorService normalExecutor = new ThreadPoolExecutor(
        50, 100, 60L, TimeUnit.SECONDS, new LinkedBlockingQueue<>(1000));
    private final ExecutorService stressExecutor = new ThreadPoolExecutor(
        10, 20, 60L, TimeUnit.SECONDS, new LinkedBlockingQueue<>(100));

    public CompletableFuture<Order> processOrder(OrderRequest req) {
        ExecutorService executor = req.isStress() ? stressExecutor : normalExecutor;
        return CompletableFuture.supplyAsync(() -> doProcess(req), executor);
    }
}
4.3 集群级隔离
对于核心服务,可以部署独立的压测集群,通过服务发现(如 Nacos)的元数据来区分:
# 压测集群的服务实例打上标签
spring:
  cloud:
    nacos:
      discovery:
        metadata:
          stress: "true"
消费方通过负载均衡策略选择对应集群:
// 压测流量 → 压测集群;正常流量 → 正常集群
if (StressTestContext.isStress()) {
    // 只路由到 metadata.stress=true 的实例
    return stressLoadBalancer.choose(serviceId);
}
4.4 逻辑隔离:挡板与 Mock
压测中不能触发真实的副作用,比如:
- 发送短信验证码 → 改为调用 Mock 服务
- 调用支付接口 → 改为调用挡板
- 发送推送通知 → 直接丢弃
@Service
public class SmsService {
    private final SmsProvider realProvider;
    private final SmsProvider mockProvider;

    public void send(String phone, String content) {
        SmsProvider provider = StressTestContext.isStress() ? mockProvider : realProvider;
        provider.send(phone, content);
    }
}
4.5 限流与熔断
对压测流量设置独立的限流规则,防止压测流量过大导致服务雪崩:
// Sentinel 限流规则
// 正常流量:QPS 10000
// 压测流量:QPS 1000
FlowRule stressRule = new FlowRule("order-service-stress")
    .setGrade(RuleConstant.FLOW_GRADE_QPS)
    .setCount(1000);
五、防污染策略:压测结束后的"清场"工作
(此处插入图片:fig4 - 防污染策略全景图)
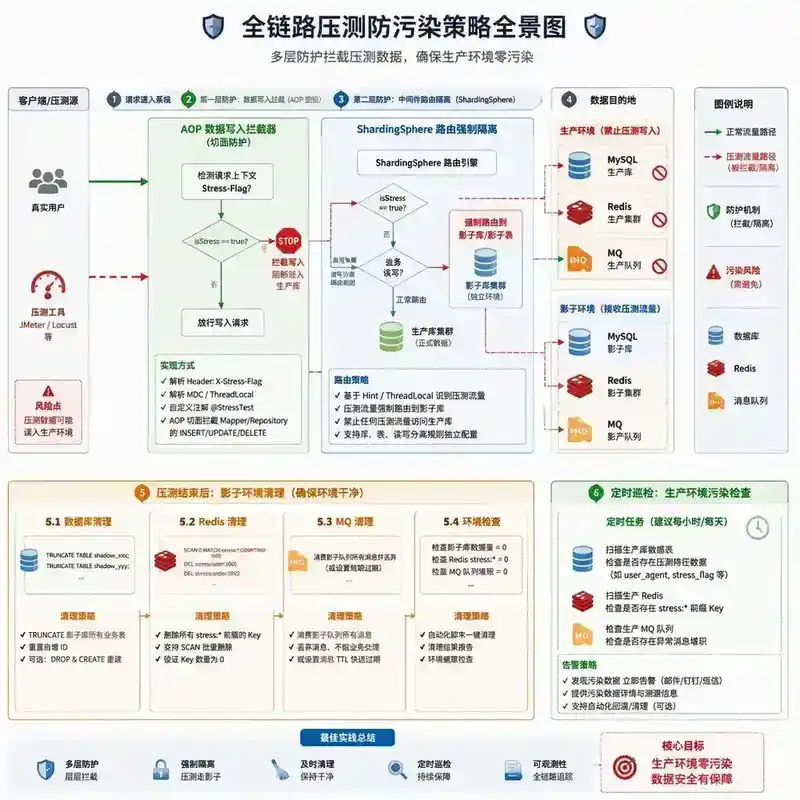
5.1 数据污染的常见场景
| 场景 | 污染后果 | 严重程度 |
|---|---|---|
| 压测订单写入生产表 | 财务数据错误、库存计算错误 | 🔴 致命 |
| 压测用户写入生产表 | 用户数据混乱、推荐算法失真 | 🔴 致命 |
| 压测日志写入生产 ES | 监控告警失真、统计报表错误 | 🟡 严重 |
| 压测缓存写入生产 Redis | 用户看到压测数据、缓存击穿 | 🟡 严重 |
| 压测文件写入 OSS | 存储成本增加、文件管理混乱 | 🟢 一般 |
5.2 防污染的技术手段
手段一:数据写入层拦截
在 DAO 层或 ORM 层统一拦截,压测流量禁止写入生产表:
@Aspect
@Component
public class StressDataGuard {
    @Around("@annotation(org.springframework.transaction.annotation.Transactional)")
    public Object guard(ProceedingJoinPoint pjp) throws Throwable {
        if (StressTestContext.isStress()) {
            // 检查当前数据源是否为影子数据源
            DataSource currentDs = DataSourceContextHolder.get();
            if (!currentDs.isShadow()) {
                throw new StressTestException("压测流量不允许写入生产数据源");
            }
        }
        return pjp.proceed();
    }
}
手段二:中间件层路由兜底
在 ShardingSphere 等中间件层面,配置默认路由规则:只要压测标记存在,SQL 必须路由到影子库,路由到生产库直接报错,这是最安全的兜底策略。
手段三:压测后数据清理
压测结束后,需要清理影子环境中的数据:
- 影子库清理:TRUNCATE 所有影子表,或直接 DROP 影子库重建
- 影子缓存清理:按前缀批量删除 Redis Key
- 影子 MQ 清理:消费并丢弃影子 Topic 中的剩余消息
- 日志清理:过滤掉压测标记的日志条目
// 压测结束后自动清理影子数据
@Component
public class StressDataCleanup {
    @PreDestroy  // 或通过压测平台的回调触发
    public void cleanup() {
        // 1. 清理影子表
        shadowJdbcTemplate.execute("TRUNCATE TABLE orders_stress");
        // 2. 清理影子缓存
        Set<String> keys = redisTemplate.keys("stress:*");
        if (!keys.isEmpty()) redisTemplate.delete(keys);
        // 3. 重置流量标记
        StressTestContext.clear();
    }
}
手段四:定时巡检
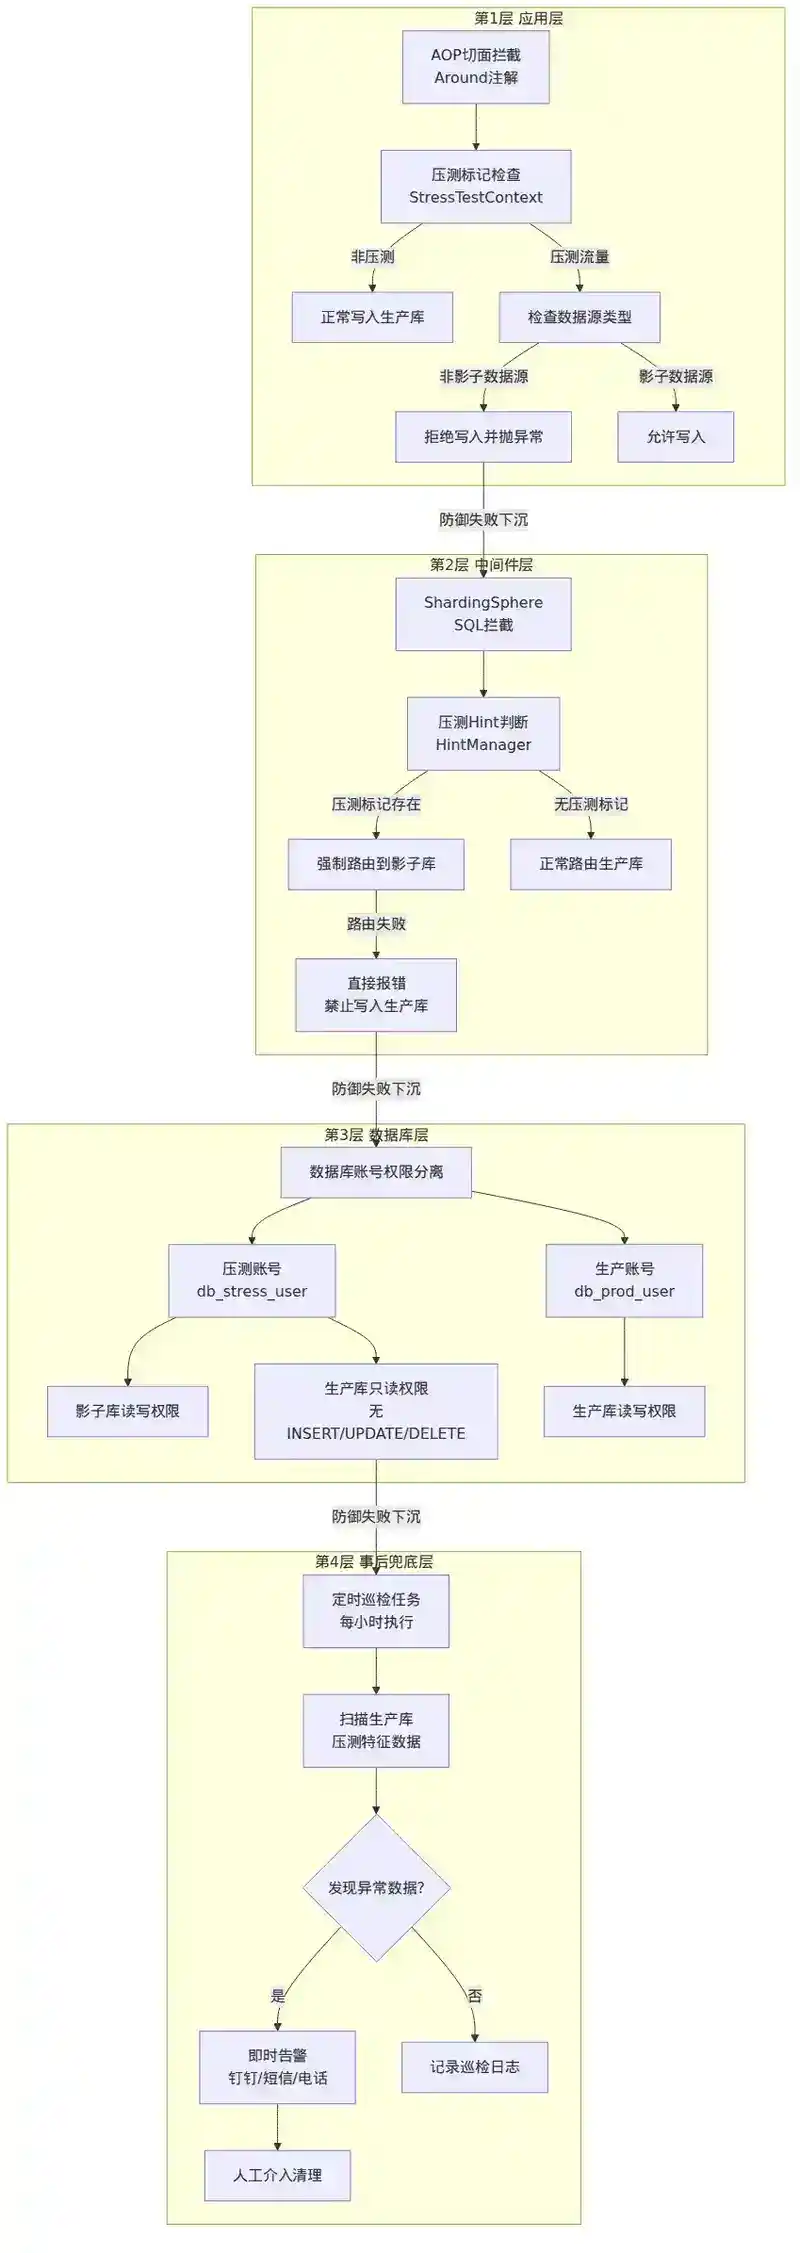
设置定时任务,每小时扫描生产库中是否存在疑似压测数据(例如所有 user_id 都以 stress_ 开头、订单金额为固定值等特征),发现异常即时告警。
六、容量评估:从压测数据到容量规划
(此处插入图片:fig5 - 容量评估流程图)
6.1 容量评估的核心指标
| 指标 | 含义 | 计算方式 |
|---|---|---|
| QPS 峰值 | 系统能承受的最大每秒请求数 | 逐步加压直到错误率 > 1% |
| RT 响应时间 | 各分位数的响应时间 | P50 / P90 / P99 / P999 |
| 资源利用率 | CPU / 内存 / 网络 / 磁盘 | 压测期间的监控数据 |
| 瓶颈点 | 最先达到容量上限的组件 | 逐层分析资源曲线 |
| 弹性系数 | 扩缩容的线性度 | 扩容 N 台后 QPS 实际增长倍数 |
6.2 容量评估方法
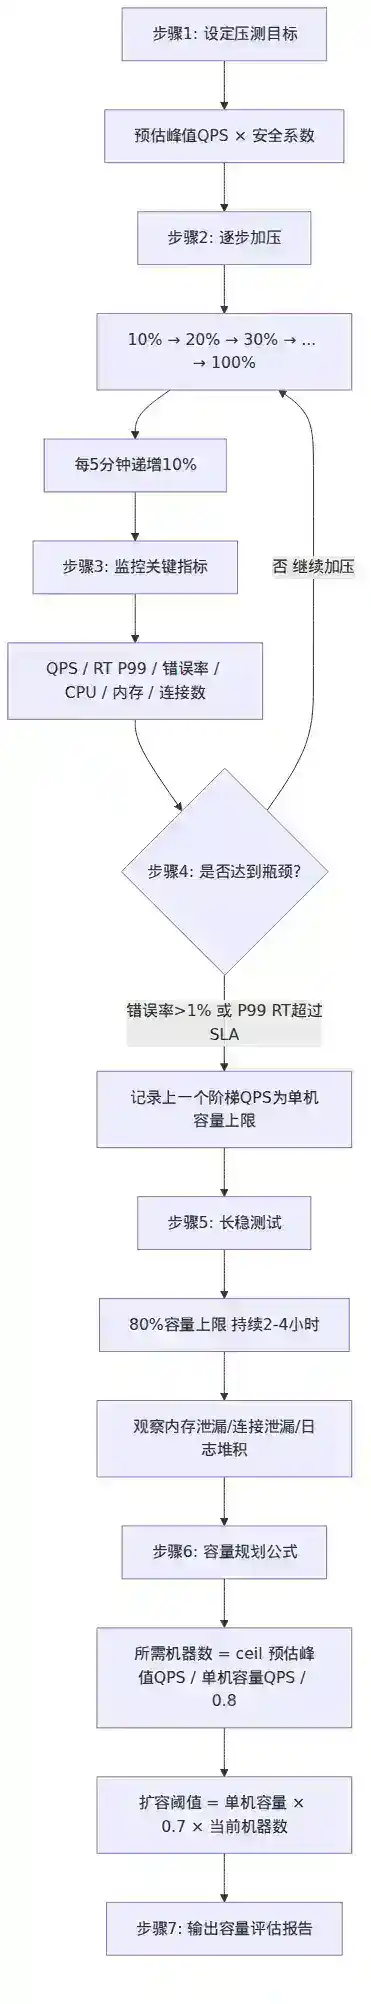
方法一:逐步加压法
- 从 10% 目标流量开始,每 5 分钟增加 10%
- 监控各项指标,记录每个阶梯的 QPS、RT、错误率
- 当错误率超过 1% 或 RT 的 P99 超过 SLA 阈值时,上一个阶梯的 QPS 即为容量上限
方法二:摸高测试
直接以预估峰值的 2-3 倍流量冲击系统,观察系统行为:
- 如果系统通过限流/熔断优雅降级 → 容量充足
- 如果系统直接崩溃 → 需要扩容或优化
方法三:长稳测试
以 80% 容量上限的流量,持续运行 2-4 小时,观察:
- 是否存在内存泄漏(GC 频率逐渐升高)
- 是否存在连接泄漏(连接池逐渐耗尽)
- 是否存在日志堆积、磁盘写满等问题
6.3 容量规划公式
基于压测结果,可以得出如下规划公式:
所需机器数 = ceil(预估峰值 QPS / 单机容量 QPS / 0.8)
其中 0.8 是安全水位系数,避免机器跑满。
扩容阈值 = 单机容量 * 0.7 * 当前机器数
当集群实时 QPS 超过扩容阈值时,触发自动扩容。
6.4 服务容量模型
不是所有服务都有相同的容量特征,需要分类建模:
| 服务类型 | 瓶颈特征 | 扩容策略 |
|---|---|---|
| 计算密集型 | CPU 先满 | 增加实例数 / 升级 CPU |
| IO 密集型 | 数据库连接池先满 | 增加实例数 / 优化 SQL |
| 内存密集型 | 堆内存先满 | 增加内存 / 优化缓存策略 |
| 网络密集型 | 带宽先满 | 升级网络 / 数据压缩 |
七、全链路压测平台架构设计
(此处插入图片:fig6 - 全链路压测平台架构图)
7.1 整体架构
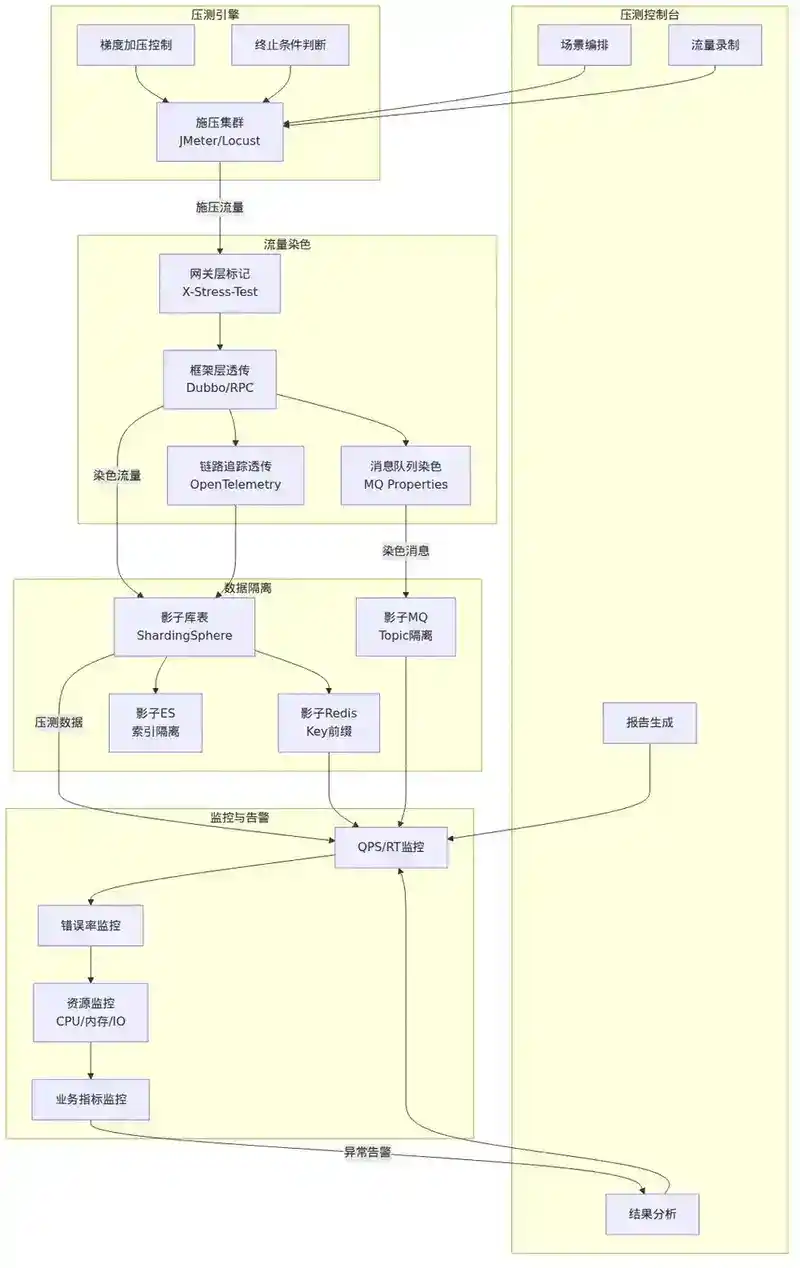
一个完整的全链路压测平台通常包含以下模块:
┌─────────────────────────────────────────────────┐
│                  压测控制台                        │
│  (场景编排 / 流量录制 / 结果分析 / 报告生成)         │
└─────────────────────────────────────────────────┘
                        │
        ┌───────────────┼───────────────┐
        ▼               ▼               ▼
┌───────────┐   ┌───────────┐   ┌───────────┐
│ 压测引擎   │   │ 流量染色   │   │ 数据隔离   │
│ (施压集群) │   │ (网关/框架) │   │ (影子库表) │
└───────────┘   └───────────┘   └───────────┘
        │               │               │
        └───────────────┼───────────────┘
                        ▼
┌─────────────────────────────────────────────────┐
│              监控 & 告警                          │
│  (QPS / RT / 错误率 / 资源 / 业务指标)            │
└─────────────────────────────────────────────────┘
7.2 流量录制与回放
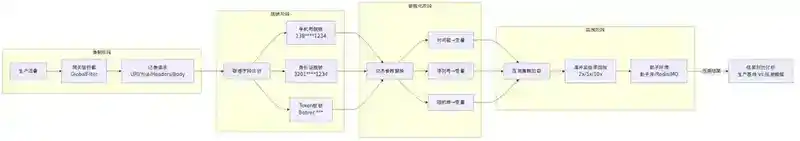
除了手动构造压测流量,更高效的方式是录制生产流量并在压测时回放:
- 录制:在网关层或 AOP 层录制真实的请求和响应
- 脱敏:对请求中的敏感字段(手机号、身份证、Token)进行脱敏
- 参数化:将请求中的动态参数(时间戳、序列号)替换为变量
- 回放:在压测集群中以更高并发倍率回放录制流量
// 流量录制示例(网关层拦截器)
@Component
public class TrafficRecorder implements GlobalFilter {
    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        if (recordingEnabled) {
            ServerHttpRequest request = exchange.getRequest();
            TrafficRecord record = new TrafficRecord();
            record.setUri(request.getURI().toString());
            record.setMethod(request.getMethodValue());
            record.setHeaders(desensitize(request.getHeaders()));
            record.setBody(readBody(request));
            recordQueue.offer(record);
        }
        return chain.filter(exchange);
    }
}
7.3 压测场景编排
一个完整的压测场景通常包含:
- 业务场景:模拟用户浏览商品 → 加入购物车 → 下单 → 支付
- 流量模型:各接口的 QPS 配比(如搜索 30%、下单 20%、支付 10%)
- 施压曲线:从低到高的流量爬坡曲线
- 终止条件:错误率 > 5% 或 P99 RT > 2s 时自动停止
八、实战踩坑与最佳实践
8.1 踩坑记录
坑一:染色标记丢失
在半同步半异步的调用链中(如 HTTP → MQ → HTTP),染色标记在 MQ 消费端丢失,导致影子库切换失败,压测数据写入生产库。
解法:在每个异步边界点(MQ 发送、定时任务触发、回调接口)都显式检查和恢复染色标记。
坑二:影子表结构不一致
生产库加了一个字段,但影子表忘记同步,导致压测 SQL 报错。
解法:通过 CI/CD 流水线强制 DDL 同步;压测前自动校验表结构差异。
坑三:第三方回调无法染色
外部支付回调、短信回执等第三方接口,无法携带你的染色标记。
解法:对第三方回调接口,直接拒绝压测流量(白名单模式),或者通过回调参数中的业务标识反查染色标记。
坑四:压测结束后清理不彻底
影子 Redis 的 Key 没设 TTL,压测结束后 Key 越积越多,占满内存。
解法:所有影子 Key 强制设置 TTL;压测结束后执行全量清理脚本。
8.2 最佳实践清单
- 染色标记标准化:全公司统一染色标记的格式和透传方式
- 影子环境即用即建:压测开始前自动创建影子库表,压测结束后自动销毁
- 压测窗口期:选择业务低峰期(如凌晨 2-5 点)进行压测
- 熔断兜底:压测流量和正常流量共享熔断器,但阈值独立
- 灰度加压:不要一次压满,从 5% → 10% → 20% 逐步递增
- 监控先行:确保所有核心指标都已接入监控大盘,再开始压测
- 回滚预案:准备一键切换回正常模式的开关,出现问题即时回滚
九、面试提问
以下问题从面试官视角出发,考察对全链路压测的深度理解和实战经验。
Q1:在全链路压测中,染色标记在跨线程池(如**CompletableFuture.supplyAsync**)传递时会丢失,你如何解决?RPC 框架中的隐式传参和链路追踪的 Baggage 机制各有什么优劣?
Q2:如果公司有 500+ 张数据库表,你如何设计影子表方案?逐表建影子表显然不现实,你有哪些自动化或按需生成的策略?
Q3:你如何保证压测流量永远不会写入生产库?请设计一个多层防御体系,从应用层、中间件层、数据库层各提供至少一种保障手段。
Q4:压测流量和真实流量共享同一个 Redis 集群时,你如何确保压测的**KEYS ***或大 Key 操作不会拖垮 Redis,影响真实用户?
Q5:在一次全链路压测中,你发现某个下游服务的 P99 RT 从 50ms 飙升到 5000ms,但 CPU 和内存使用率都正常。你会如何排查这个瓶颈?
Q6:全链路压测是否应该常态化?比如每天凌晨自动跑一次。常态化压测需要解决哪些额外的问题?
Q7:假设你的系统使用了分布式事务(Seata AT 模式),压测流量在影子库中产生的 Undo Log 会影响什么?你如何处理?