阅读时间:约 45 分钟 | 难度:中高级 | 适用方向:后端开发、SRE、架构师
一、为什么告警体系需要"设计"
一个经典的失败场景:凌晨 3 点,数据库主库发生切换,你的手机在 30 秒内收到 200 条告警消息——"CPU 超过 90%"、"连接数超阈值"、"慢查询告警"、"主从延迟告警"、"应用 500 错误率飙升"、"接口超时"……你被消息轰炸得根本看不清发生了什么,只能把手机关静音。
这不是运维的失败,这是告警体系设计的失败。
好的告警体系像一个经验丰富的医生:不是把体检报告里的所有异常指标都告诉你,而是结合症状给出诊断方向。坏的告警体系则像一个焦虑的实习生,每次看到仪表盘上有个红灯就大喊大叫。
本篇文章从工程实践出发,系统性地拆解告警体系设计的六个核心维度:症状告警与根因告警的区分、降噪策略、收敛机制、分级模型、升级流程,以及如何将这些维度组合成一个可落地、可演进的告警体系。
二、告警的本质:信号与噪声的博弈
2.1 告警不是什么
在讨论告警设计之前,先明确告警不是什么:
- 告警不是监控。监控是持续采集和存储指标/日志/追踪数据的过程,告警是监控的输出。监控数据可以不用来告警(比如用于趋势分析),但告警一定依赖监控数据。
- 告警不是日志。日志是"发生了什么"的记录,告警是"你需要关注什么"的决策。
- 告警不是通知。通知是告警的送达渠道(短信/电话/钉钉/邮件),告警本身是触发通知的条件判断。
2.2 告警的核心矛盾
告警设计的核心矛盾可以用一句话概括:
漏报(Miss)和误报(False Positive)不可兼得,但两者都会杀死告警体系的可信度。
| 问题 | 定义 | 后果 |
|---|---|---|
| 漏报 | 真实故障未触发告警 | 线上故障发现延迟,用户先于你发现 |
| 误报 | 没有故障却触发告警 | 告警疲劳,值班人员不再信任告警 |
Google SRE 团队在《Site Reliability Engineering》中提出了一个关键洞察:告警疲劳(Alert Fatigue)比漏报更危险,因为漏报可以通过事后复盘改进,而告警疲劳一旦形成,团队会习惯性地忽略所有告警——包括那些真正重要的。
三、症状告警 vs 根因告警
这是告警体系设计中最重要的一对概念,也是大多数团队告警混乱的根源。
3.1 定义
症状告警(Symptom-based Alerting) 关注的是"用户正在经历什么痛苦"——即从用户视角或服务边界观察到的异常。
根因告警(Cause-based Alerting) 关注的是"系统哪里出了问题"——即底层资源的异常状态。
3.2 一个例子讲清楚
假设你的订单服务出现故障,用户无法下单。以下是可能同时发生的告警:
| 告警类型 | 告警内容 | 例子 |
|---|---|---|
| 症状告警 | 订单服务 P99 延迟 > 2s | ✅ 需要关注 |
| 症状告警 | 订单服务错误率 > 1% | ✅ 需要关注 |
| 根因告警 | 订单数据库 CPU > 90% | ⚠️ 可能相关 |
| 根因告警 | 订单数据库连接数满 | ⚠️ 可能相关 |
| 根因告警 | Redis 内存使用率 > 80% | ❓ 不一定相关 |
| 根因告警 | 某台机器磁盘使用率 > 85% | ❌ 大概率无关 |
症状告警可以直接告诉你"用户正在受影响",根因告警只能告诉你"某个组件状态异常"。 状态异常不等于用户受影响——那台磁盘使用率 85% 的机器可能根本不是订单服务在用的。
3.3 Google SRE 的黄金法则
Google SRE 团队在多年的实践中总结了一个核心原则:
告警应该基于症状,而不是根因。当你基于症状告警时,你收到的是"用户正在受影响"的信号;当你基于根因告警时,你收到的是"某个组件状态异常"的通知——而状态异常可能根本不影响用户。
但这并不意味着根因告警毫无价值。根因告警的合理用途是:
- 作为症状告警的补充信息,帮助快速定位问题
- 作为趋势预警,在问题影响用户之前提前发现(比如磁盘使用率在 24 小时内从 60% 涨到 80%,虽然还没影响用户,但值得关注)
- 作为自动化动作的触发条件(比如 CPU 超过阈值自动扩容,不需要人工介入)
3.4 实践建议
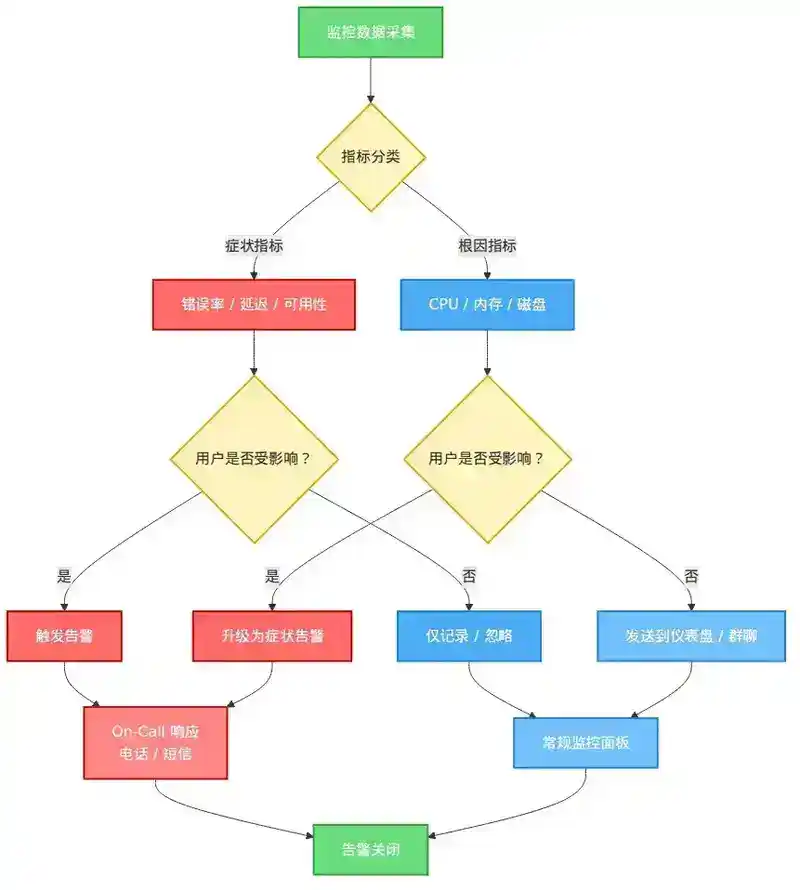
一个好的告警体系应该以"症状告警"为主要告警通道(需要 On-Call 响应),以"根因告警"为辅助信息通道(不需要立即响应,但可用于排查)。
具体来说:
- 需要叫醒人的告警:必须基于症状(用户可见的错误率、延迟、可用性)
- 不需要叫醒人的告警:可以基于根因(磁盘使用率趋势、连接数增长),这些应该发到群聊或仪表盘,而不是短信/电话
四、告警降噪(Noise Reduction)
告警降噪是告警体系中最容易被低估的环节。它的目标不是"不发告警",而是"不发无价值的告警"。
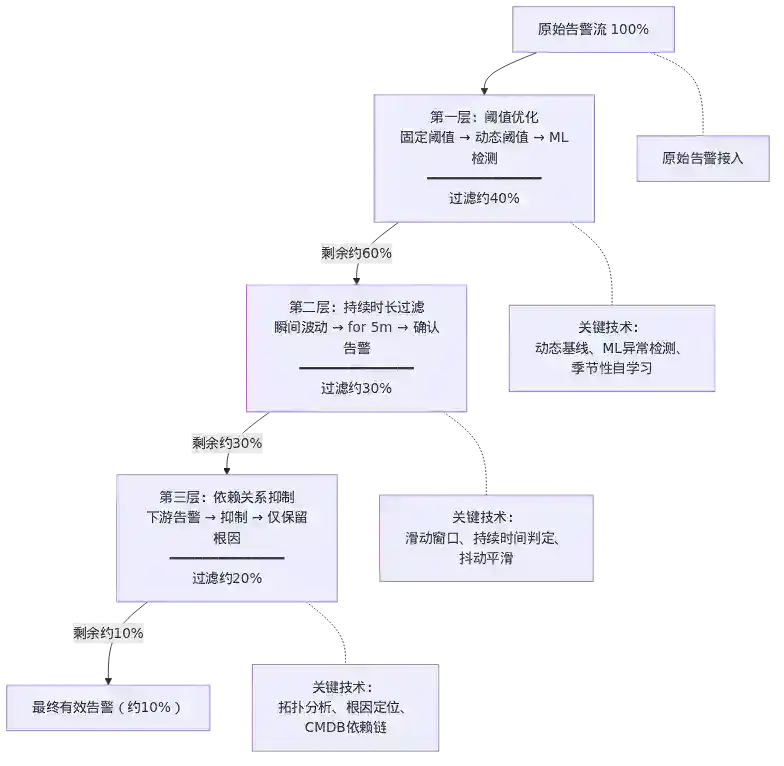
4.1 降噪的三个层次
第一层:阈值优化
最常见的降噪方式是调整阈值。但阈值优化有一个陷阱——阈值是静态的,而流量是动态的。
| 阈值策略 | 优点 | 缺点 |
|---|---|---|
| 固定阈值 | 简单直观,容易理解 | 无法适应流量变化 |
| 同比/环比阈值 | 自适应流量变化 | 节假日/大促等特殊场景仍会误报 |
| 动态基线(统计分析) | 自动学习正常模式 | 冷启动慢,需要足够历史数据 |
| 机器学习异常检测 | 能发现未知模式 | 可解释性差,调参复杂 |
实践建议:从固定阈值开始,逐步过渡到基于统计的动态阈值。对于有明显周期性的指标(如 QPS),使用同比/环比策略;对于无明显周期性的指标(如错误率),使用固定阈值 + 持续时长作为附加条件。
第二层:持续时长(Duration)
一个指标瞬间超过阈值不代表真的有问题。持续时长是降噪的最有效手段之一。
# 不好的告警规则
- alert: HighCPU
  expr: cpu_usage > 90
  # 只要一瞬间超过 90% 就告警

# 好的告警规则
- alert: HighCPU
  expr: cpu_usage > 90
  for: 5m  # 持续超过 5 分钟才告警
for 的取值经验:
- 严重故障(如错误率飙升):
for: 1m-2m,快速响应 - 资源问题(如 CPU 高):
for: 5m-10m,等待短暂波动过去 - 容量预警(如磁盘使用率):
for: 30m-1h,这类问题不需要秒级响应
第三层:依赖关系抑制
这是最容易被忽视的降噪手段,但也是最有效的。
当一个核心组件(如数据库)故障时,依赖它的所有服务都会触发告警。如果每个服务都独立告警,值班人员会收到数十条告警消息,而实际上只有一条是有用的——"数据库故障"。
依赖关系抑制的核心思想是:如果 A 故障会导致 B 也故障,那么当 A 和 B 同时告警时,只保留 A 的告警,抑制 B 的告警。
4.2 降噪的度量
降噪做得好不好,可以用一个指标来衡量:
信噪比(SNR)= 有效告警数 / 总告警数
- Google SRE 的目标:信噪比 > 50%
- 一般团队的现实:信噪比往往不到 10%
- 如果你的信噪比低于 20%,你的告警体系已经接近失效——因为 80% 以上的告警都是噪音,值班人员会形成"告警 = 噪音"的心理模型
五、告警收敛(Alert Convergence / Aggregation)
收敛和降噪经常被混为一谈,但它们解决的是不同层面的问题。
- 降噪:减少单个告警的误报("这条告警该不该发?")
- 收敛:将多条相关的告警合并为一条或少量告警("这 50 条告警能不能合并成 1 条?")
5.1 收敛的四种策略
策略一:时间窗口聚合
将一段时间内的同类告警合并为一条摘要告警。
【告警收敛】过去 5 分钟内共发生 12 次 "order-service 接口超时" 告警
- 首次发生:03:14:22
- 最近发生:03:18:45
- 峰值错误率:3.2%
- 当前错误率:2.8%
策略二:拓扑收敛
基于服务拓扑关系,将下游告警收敛到上游根因。
数据库主库故障
├── [已收敛] 订单服务数据库连接超时
├── [已收敛] 支付服务数据库连接超时
├── [已收敛] 库存服务数据库连接超时
└── [已收敛] 用户服务查询超时
策略三:标签维度收敛
当同一个告警规则因为不同标签值(如不同实例、不同接口)触发多条告警时,将它们合并。
# 原始告警:每个 Pod 单独一条
- pod-1: CPU > 90%
- pod-2: CPU > 90%
- pod-3: CPU > 90%
- pod-4: CPU > 90%

# 收敛后:合并为一条
- order-service 集群 CPU 整体偏高(4/4 个 Pod 超过 90%)
策略四:场景化收敛
基于已知的故障场景模式进行收敛。例如,当检测到"数据库主库切换"事件时,自动将同一时间段内的"主从延迟"、"连接池耗尽"、"慢查询"等告警收敛到主库切换事件下。
5.2 收敛的工程实现
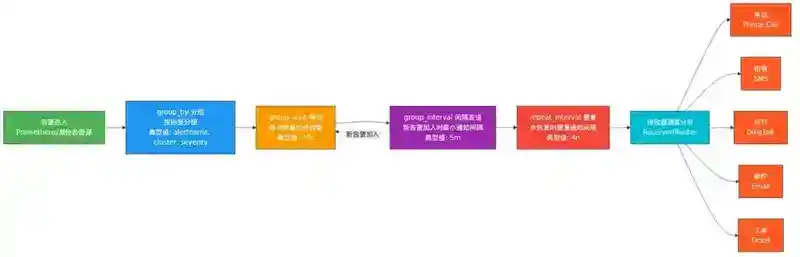
收敛功能通常由一个独立的告警管理组件(如 Alertmanager)负责。其核心流程:
告警源 → 分组(group_by)→ 等待(group_wait)→ 间隔(group_interval)→ 重复(repeat_interval)→ 通知
各组件的职责:
| 参数 | 含义 | 典型值 |
|---|---|---|
group_by |
按哪些标签分组 | ['alertname', 'cluster', 'severity'] |
group_wait |
收到第一条告警后等待多久,以便收集同组告警 | 30s |
group_interval |
同一组告警有新成员加入时,再次通知的最小间隔 | 5m |
repeat_interval |
同一组告警未恢复时,重复通知的间隔 | 4h |
六、告警分级(Severity Classification)
告警分级决定了"这条告警需要多快响应"以及"应该通知谁"。
6.1 经典四级模型
| 级别 | 名称 | 定义 | 响应要求 | 通知方式 |
|---|---|---|---|---|
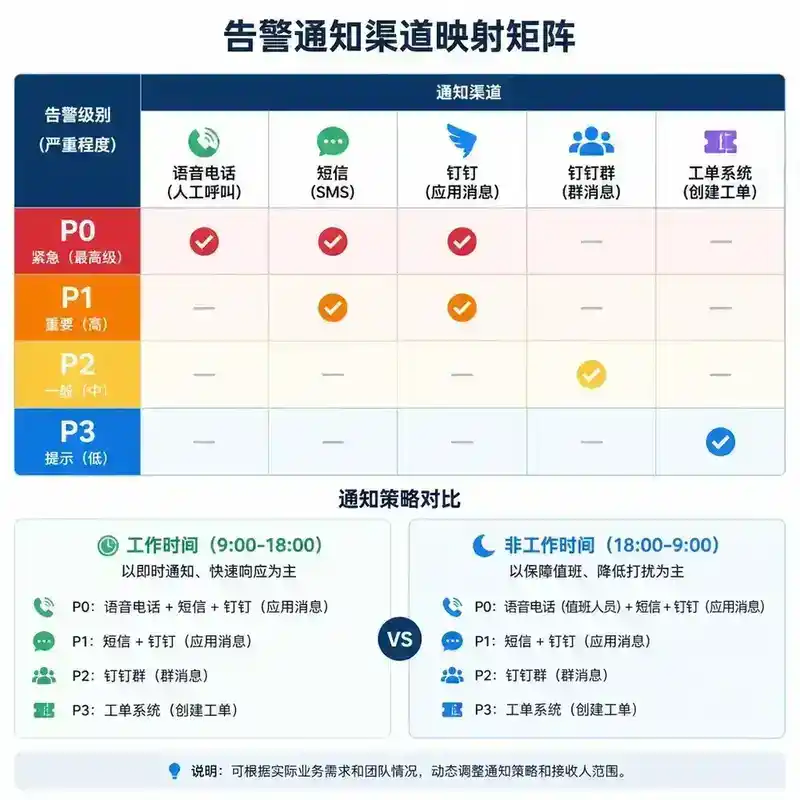
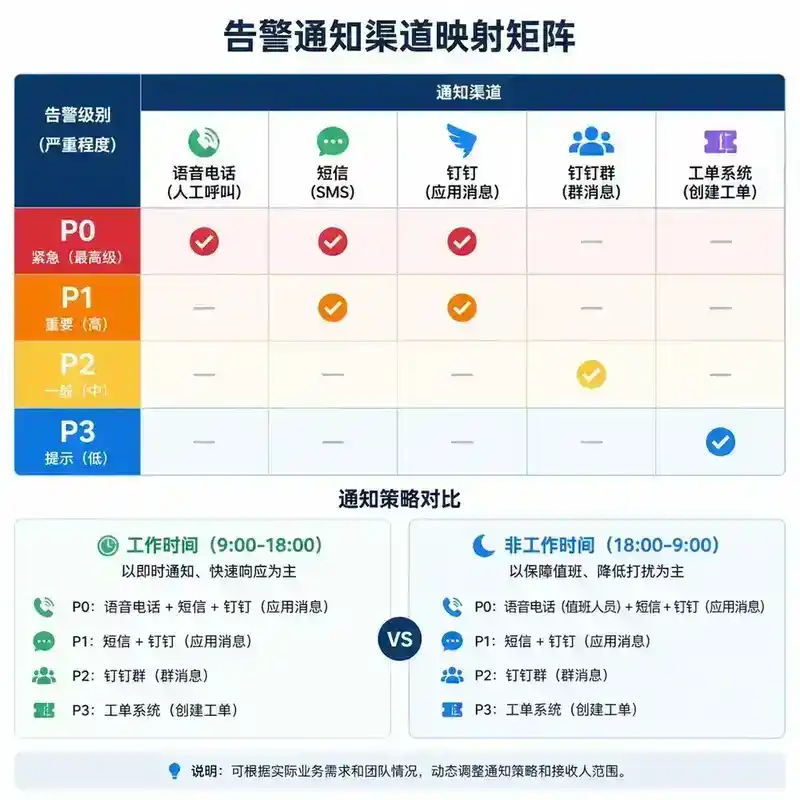
| P0 | 紧急/Critical | 核心业务不可用,用户大规模受影响 | 5 分钟内响应,立即拉群处理 | 电话 + 短信 + 钉钉 |
| P1 | 严重/Warning | 核心业务部分受损,或非核心业务不可用 | 15 分钟内响应 | 短信 + 钉钉 |
| P2 | 一般/Info | 出现异常但不影响业务可用性 | 1 小时内关注 | 钉钉群消息 |
| P3 | 提醒/Notice | 趋势预警、容量提醒 | 工作时间处理 | 钉钉群消息 / 工单 |
6.2 分级的关键原则
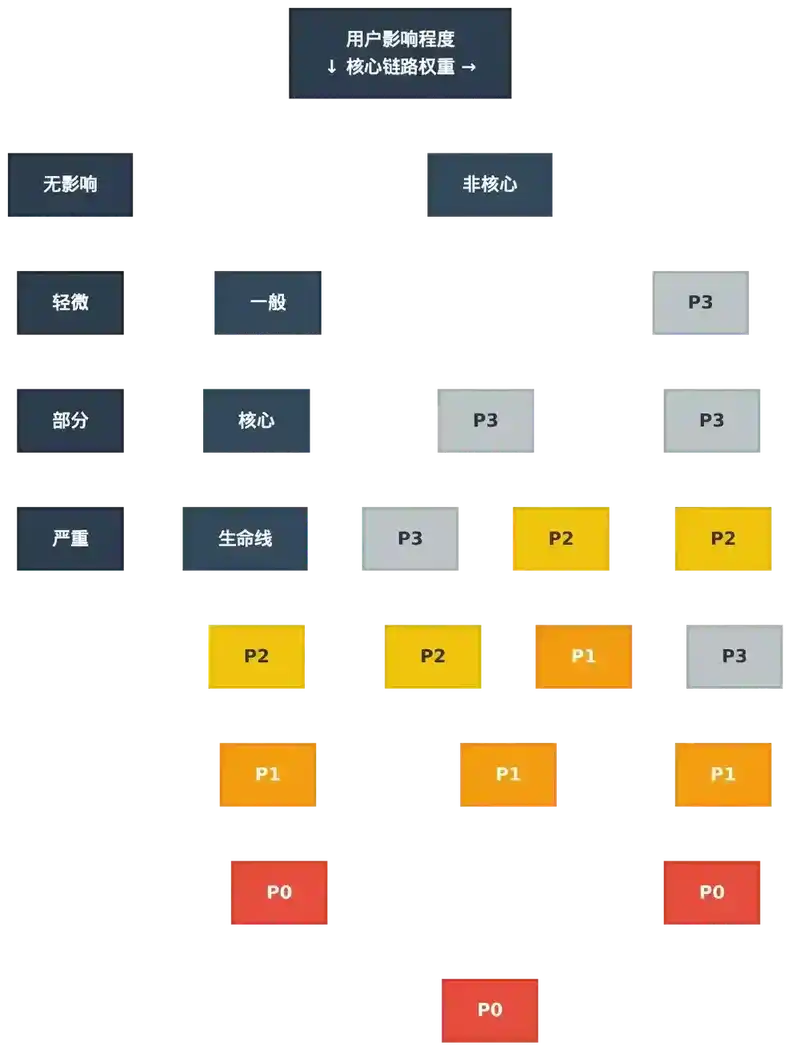
原则一:以用户影响为第一判定标准
一个告警的级别不应该取决于"是什么指标异常",而应该取决于"对用户的影响有多大"。
- Redis 内存使用率 90% → 如果当前 QPS 正常、错误率正常 → P2
- Redis 内存使用率 90% → 如果当前错误率 5% → P0
- Redis 内存使用率 90% → 如果当前错误率 0% 但无剩余内存 → P1(即将影响用户)
原则二:核心链路优先
A 服务错误率 5% 和 B 服务错误率 5%,级别可能完全不同。如果 A 是下单核心链路,B 是后台管理页面,A 应该是 P0,B 可以是 P2。
原则三:分级要有差异化动作
不同级别的告警必须有不同的处理流程,否则分级就是形式主义。
- P0/P1:必须有 On-Call 值班人员,必须有升级机制,必须有事后复盘
- P2:可以进入 backlog,不需要立即打断工作
- P3:可以自动创建工单,不需要人工实时关注
6.3 分级的反模式
反模式一:所有告警都是 P0
如果所有告警都是 P0,那就没有 P0。这会导致真正的 P0 被淹没,值班人员对所有告警都一视同仁地"慢慢看"。
反模式二:级别只升不降
初始设置的 P0 告警规则,随着系统演进可能已经不再重要。需要定期(每季度)review 告警规则,将不再关键的告警降级或删除。
反模式三:只有技术指标,没有业务指标
技术指标(CPU、内存、QPS)的异常不一定等于业务受损。业务指标(下单成功率、支付成功率、用户活跃度)的告警才是最接近用户真实体感的。 一个健康的告警体系中,P0 级别的告警至少有一半应该基于业务指标。
七、告警升级(Escalation)
告警升级解决的是"告警发出后,没人响应怎么办"的问题。
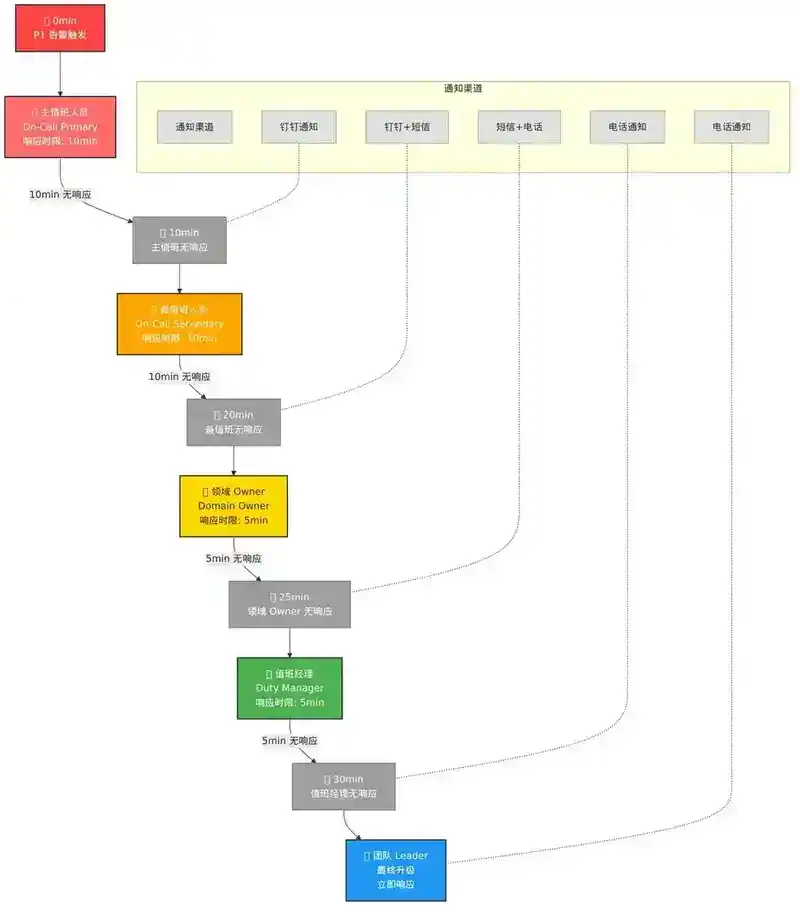
7.1 升级的三种模式
模式一:时间驱动升级
最经典的升级模式:告警在指定时间内未被确认/处理,自动升级到更高级别的响应人。
03:00  P1 告警触发 → 通知主值班人员
03:10  主值班人员无响应 → 升级到备值班人员
03:20  备值班人员无响应 → 升级到团队 Leader
03:30  团队 Leader 无响应 → 升级到部门总监
模式二:条件驱动升级
当告警的严重程度发生变化时触发升级。例如:
- 初始:P2 告警(错误率 1%)→ 钉钉群通知
- 恶化:P1 告警(错误率 5%)→ 短信通知值班人员
- 进一步恶化:P0 告警(错误率 20%)→ 电话通知 + 拉群
模式三:人工触发升级
值班人员判断现有告警需要更高级别的资源或人员介入时,可以手动升级。这种模式要求告警平台提供一键升级的能力。
7.2 升级策略设计要点
1. 升级链必须明确
每个告警规则都应该有明确的升级链:谁是一线响应人,谁是二线,谁是最终决策者。不要在告警发生时才想"该找谁"。
2. 升级要有"去重"机制
同一告警不应该被重复升级。如果一条 P1 告警已经在升级流程中,但告警管理系统又收到了同一条告警的新触发,不应该再次走升级流程,而应该更新告警状态。
3. 升级要支持"抑制"
如果值班人员已经确认在处理,但还需要时间,应该能手动抑制升级——"我知道这个问题,正在处理,不需要升级到 Leader"。
4. 升级要有"静默期"
凌晨 2 点到早上 7 点,P2 级别的告警不应该升级到电话通知。升级策略需要结合时间窗口,避免在非工作时间过度打扰。
7.3 升级与值班体系的关系
升级机制不能脱离值班体系存在。一个完整的升级体系需要:
| 角色 | 职责 | 响应时间 |
|---|---|---|
| 主 On-Call | 第一时间响应告警 | P0: 5min, P1: 15min |
| 备 On-Call | 主值班无法响应时的替补 | P0: 10min, P1: 20min |
| 领域 Owner | 特定领域的专家,协助排查 | 按需介入 |
| 值班经理 | 协调资源,决策是否回滚/降级 | P0 时 15min 内介入 |
| 团队 Leader | 兜底,确保故障被妥善处理 | 升级后 15min 内介入 |
八、告警规则设计方法论
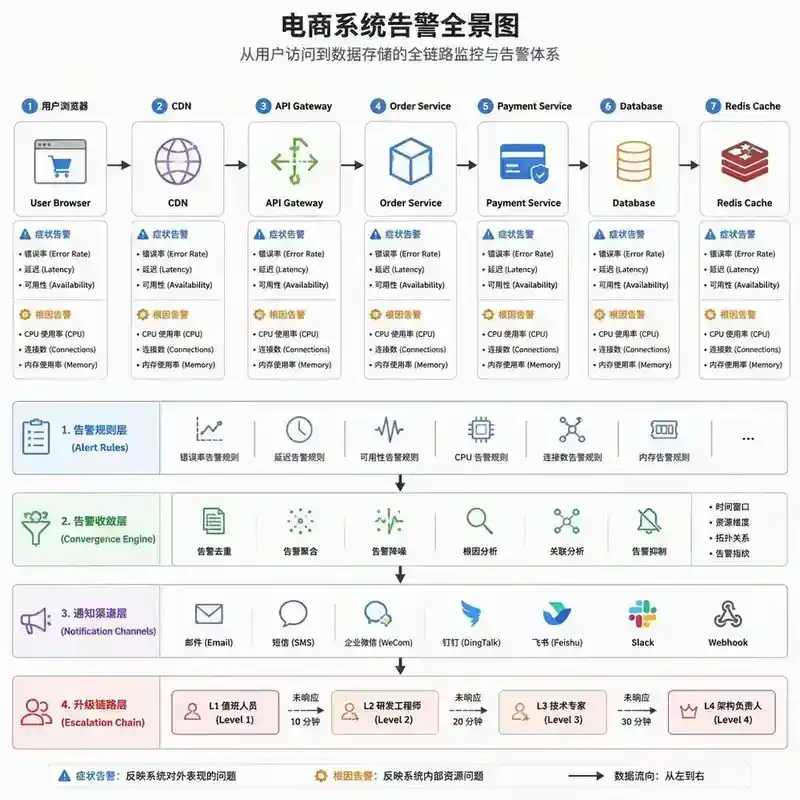
前面讲了告警体系的各个维度,这一节把它们串起来,给出一个可操作的告警规则设计方法论。
8.1 告警规则设计四步法
第一步:确定告警对象
从"用户旅程"出发,确定关键路径上的每个环节。例如一个电商下单流程:
用户浏览 → 加购物车 → 提交订单 → 支付 → 支付回调 → 扣库存 → 发货
每个环节都应该有对应的症状告警。
第二步:选择告警指标
对于每个环节,选择最能反映"用户是否受影响"的指标:
| 环节 | 症状指标 | 根因指标(辅助) |
|---|---|---|
| 用户浏览 | 页面加载成功率、加载时间 | CDN 命中率、源站响应时间 |
| 提交订单 | 订单创建成功率、P99 延迟 | 数据库连接数、Redis 命中率 |
| 支付 | 支付成功率、支付耗时 | 支付网关响应时间、回调成功率 |
第三步:设定阈值和持续时间
# 好的告警规则模板
- alert: OrderCreateFailureRateHigh
  expr: rate(order_create_failures[5m]) / rate(order_create_total[5m]) > 0.01
  for: 2m
  labels:
    severity: P1
    team: order-team
  annotations:
    summary: "订单创建失败率超过 1%"
    description: "订单创建失败率 {{ $value | humanizePercentage }},当前 QPS {{ $qps }}"
    runbook_url: "https://wiki.example.com/runbooks/order-create-failure"
第四步:配置收敛和升级策略
# 收敛配置
route:
  group_by: ['alertname', 'severity']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h

# 升级配置
  routes:
    - match:
        severity: P0
      receiver: 'oncall-phone'
      continue: true
    - match:
        severity: P1
      receiver: 'oncall-sms'
8.2 告警规则的生命周期管理
告警规则不是"写好就完事"。每条规则都应该有生命周期:
- 创建:基于故障场景或 SLO 要求创建
- 验证:在预发布环境验证告警规则的有效性
- 观察:生产环境运行 1-2 周,收集误报/漏报数据
- 优化:根据观察数据调整阈值、持续时间、级别
- 定期 Review:每季度 review 所有告警规则,清理不再需要的规则
- 退役:删除长期未触发或已不再适用的规则
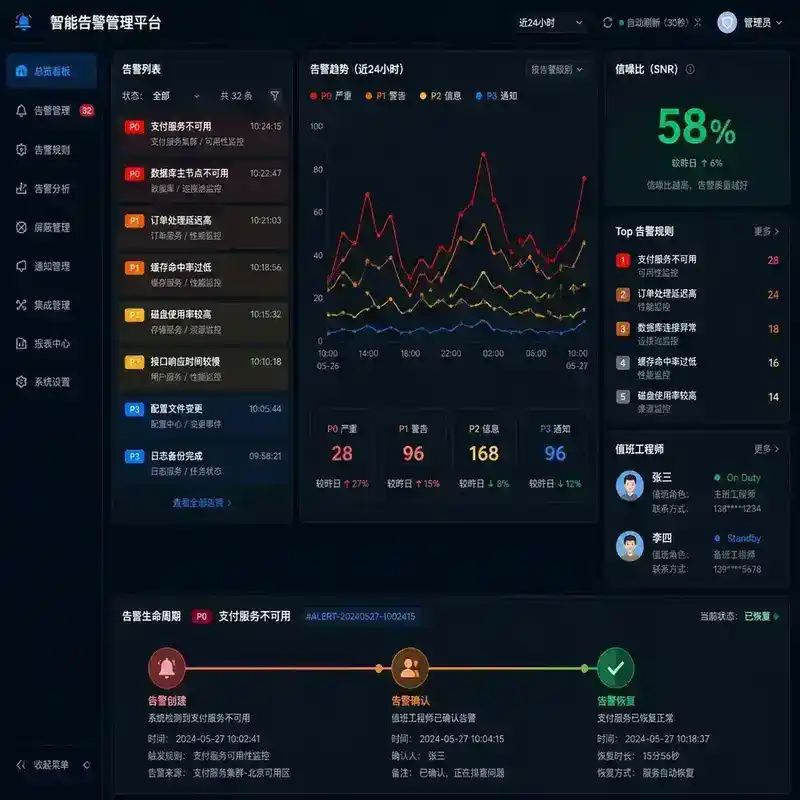
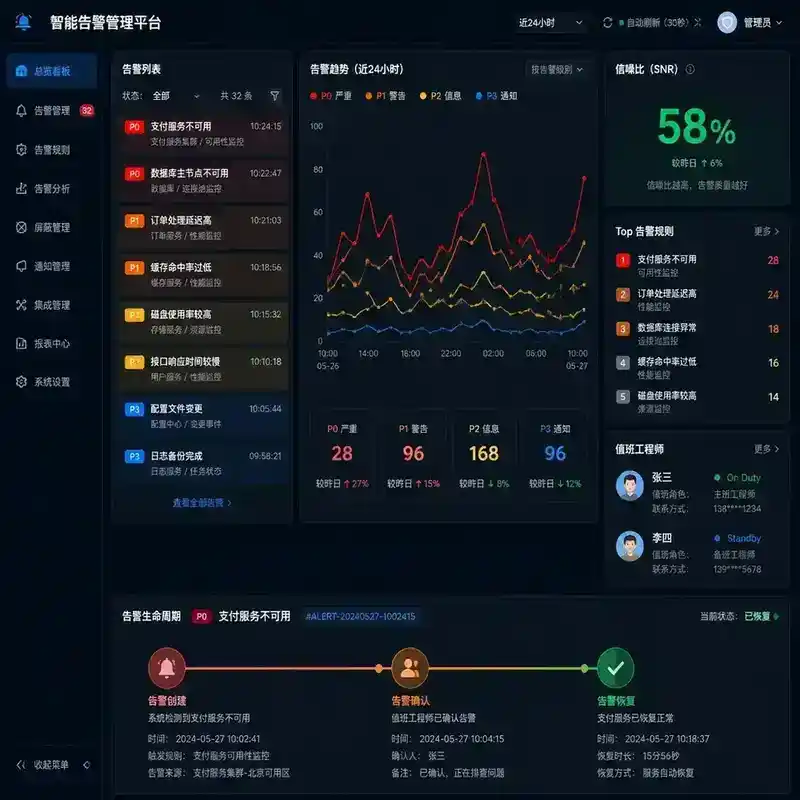
8.3 告警质量的衡量指标
| 指标 | 计算方式 | 目标 |
|---|---|---|
| 告警信噪比 | 有效告警 / 总告警 | > 50% |
| 告警响应时间 | 告警触发到确认的时间 | P0 < 5min, P1 < 15min |
| MTTR(平均修复时间) | 告警触发到故障恢复的时间 | 持续降低 |
| 告警疲劳度 | 每周无效告警数 / 值班人数 | < 10 条/人/周 |
| 告警覆盖率 | 有告警覆盖的故障 / 总故障 | > 90% |
九、从单服务到全链路:告警体系的演进路线
9.1 阶段一:裸奔期(团队 < 5 人)
- 告警方式:人工巡检 + 用户反馈
- 告警工具:无或云厂商自带的基础告警
- 核心目标:建立基本的存活监控(服务是否还活着)
- 推荐做法:健康检查 + 简单的错误率告警
9.2 阶段二:基础期(团队 5-20 人)
- 告警方式:Prometheus + Alertmanager 或云厂商监控
- 告警规则:基于阈值,覆盖核心指标
- 核心目标:覆盖所有核心服务的症状告警
- 推荐做法:引入告警分级(P0/P1/P2),建立 On-Call 值班制度
9.3 阶段三:成熟期(团队 20-50 人)
- 告警方式:统一告警管理平台 + 多渠道通知
- 告警规则:引入动态阈值、依赖关系抑制、告警收敛
- 核心目标:告警信噪比 > 50%,告警覆盖率 > 90%
- 推荐做法:建立告警规则生命周期管理,定期 review 和清理
9.4 阶段四:智能化期(团队 50+ 人)
- 告警方式:AIOps 智能告警 + 自动化故障处理
- 告警规则:机器学习异常检测 + 根因分析 + 自动修复
- 核心目标:告警→自动诊断→自动修复的闭环
- 推荐做法:告警与自动化运维深度集成,常见故障自动处理
9.5 演进的核心原则
无论处于哪个阶段,以下原则始终不变:
- 症状优先于根因:告警的第一优先级永远是"用户是否受影响"
- 少即是多:100 条无人看的告警不如 10 条被认真对待的告警
- 持续优化:告警规则不是一次性配置,而是需要持续迭代的
- 以人为本:告警体系的设计要围绕值班人员的体验,而不是告警系统的炫酷功能
十、常见设计陷阱与避坑指南
陷阱一:告警过多,试图"万无一失"
症状:团队有 500+ 条告警规则,每天收到 200+ 条告警消息。
根因:试图用告警覆盖所有可能的异常场景,把监控仪表盘上的每个指标都设置了告警。
解决方案:回到"用户是否受影响"这个标准,只保留症状告警。Google SRE 建议每个团队的核心告警规则不超过 10-15 条(P0+P1 级别)。
陷阱二:告警阈值过紧,频繁误报
症状:告警经常在"触发→恢复→触发→恢复"的震荡中。
根因:阈值设置过于严格,没有考虑正常的指标波动。
解决方案:
- 增加
for持续时间 - 使用百分比变化而非绝对值("CPU 比 5 分钟前增长了 50%"而非"CPU > 90%")
- 引入"恢复阈值"(触发阈值 90%,恢复阈值 80%,避免震荡)
陷阱三:告警通知渠道单一
症状:所有告警都通过同一种渠道(如短信)发送,P0 和 P3 没有区别。
根因:告警分级没有与通知渠道关联。
解决方案:
- P0:电话 + 短信 + 钉钉(多渠道同时触达)
- P1:短信 + 钉钉
- P2:钉钉群消息
- P3:工单系统
陷阱四:告警没有 Runbook
症状:告警消息只有"CPU > 90%",没有上下文、没有操作指引。
根因:告警规则缺少 annotations 中的 runbook_url 和上下文信息。
解决方案:每条告警规则都应该附带:
- 告警含义(一句话说清楚)
- 影响范围(影响哪些用户/业务)
- 操作指引(Runbook 链接)
- 当前关键指标(QPS、错误率、连接数等)
陷阱五:告警规则永不清理
症状:告警规则列表越积越多,很多规则已经不再适用但没人敢删。
根因:缺乏告警规则的生命周期管理。
解决方案:每季度执行一次告警规则清理:
- 30 天内未触发的规则 → 评估是否还需要
- 频繁触发但从未被确认的规则 → 评估是否误报
- 对应的服务/组件已下线的规则 → 直接删除
十一、总结
告警体系设计不是一个纯技术问题,它涉及技术(监控、规则引擎、通知渠道)、流程(值班、升级、复盘)和人性(告警疲劳、信任、响应行为)三个维度。
核心要点回顾:
| 维度 | 核心原则 | 一句话总结 |
|---|---|---|
| 症状告警 vs 根因告警 | 症状优先,根因辅助 | 告警要回答"用户是否受影响",而非"某个组件状态如何" |
| 降噪 | 多层过滤,持续优化 | 减少误报比增加告警更重要 |
| 收敛 | 分组聚合,拓扑关联 | 把 50 条相关告警变成 1 条有用信息 |
| 分级 | 用户影响为纲 | P0 是"用户正在受苦",P3 是"有空看看" |
| 升级 | 时间驱动 + 条件驱动 | 告警没人响应,就让它找到能响应的人 |
最后,记住告警体系设计的终极目标:
不是"不漏掉任何一条告警",而是"每条告警都值得被认真对待"。
十二、面试官视角提问
以下问题从面试官视角出发,考察候选人对告警体系设计的深度理解和实战经验。回答时请结合自己的项目经历,不要只是背诵概念。
Q1:你搭建的告警体系中,P0/P1 级别的告警规则大概有多少条?你是如何控制告警规则数量的?如果业务方要求你给某个不太重要的指标加 P0 告警,你会怎么沟通?
Q2:假设你负责一个日均 PV 过亿的电商系统,凌晨 3 点数据库主库宕机。请描述你的告警体系会如何响应:会触发哪些告警?先收到哪条?哪些告警会被收敛?值班人员会收到什么样的通知?如果 10 分钟内没人确认,会发生什么?
Q3:Prometheus Alertmanager 的**group_by**、**group_wait**、**group_interval**、**repeat_interval**四个参数分别是什么含义?如果**group_interval**设置为 1 小时,而**repeat_interval**设置为 30 分钟,会发生什么?
Q4:你的团队现在有 200 条告警规则,但信噪比只有 15%。你计划如何逐步优化到 50% 以上?请给出具体的步骤和优先级排序。
Q5:在一个微服务架构中,服务 A 调用服务 B,服务 B 调用服务 C。如果服务 C 故障,A 和 B 都会触发告警。请设计一个告警收敛方案,确保值班人员只收到一条关于"服务 C 故障"的有效告警,而不是三条。你如何实现服务间的依赖关系发现和告警抑制?
Q6:告警升级机制中,如何避免"升级风暴"——即一个故障导致多个告警同时升级,最终把整个管理层都叫醒?请设计一个升级风暴防护机制。
Q7:你如何衡量一个告警体系的质量?除了信噪比之外,还有哪些指标?如果一个告警体系"看起来很好"(信噪比高、响应快),但线上故障还是经常由用户先发现,可能的原因是什么?
Q8:请设计一个告警规则的生命周期管理系统。从规则创建、验证、上线、观察到退役,每个阶段应该有哪些检查和审批?如何防止"规则腐化"——越来越多的无效规则堆积在系统中?
十二、面试官视角提问与回答
以下问题从面试官视角出发,考察候选人对告警体系设计的深度理解和实战经验。回答时请结合自己的项目经历,不要只是背诵概念。
Q1:你搭建的告警体系中,P0/P1 级别的告警规则大概有多少条?你是如何控制告警规则数量的?如果业务方要求你给某个不太重要的指标加 P0 告警,你会怎么沟通?
A1:在我负责的告警体系中,P0 级别保持在 5-8 条,P1 级别约 15-20 条,总量控制在 30 条以内。这个数量是 Google SRE 实践验证过的——超过这个数,值班人员无法在告警触发时快速判断优先级。
控制数量的核心方法有三条:第一,只对用户可见的症状设 P0/P1,比如下单成功率、支付成功率、核心接口 P99 延迟,而非 CPU 或内存。第二,每周 review 告警触发记录,把连续两周未触发或触发后无人处理的规则降级或删除。第三,新规则必须有退役计划,创建时就约定观察期和退出条件。
当业务方要求给不重要的指标加 P0 时,我不会直接拒绝,而是用数据说话:拿出最近一个月该指标的波动曲线,证明它和用户影响的关联度很低;同时展示当前 P0 告警的信噪比,说明每增加一条 P0 就是对值班人员注意力的稀释。如果业务方确实担心,可以折中——先设为 P2,观察一个月,如果确实有预警价值再升级。这样做既尊重了业务方的诉求,又维护了告警体系的健康度。
Q2:假设你负责一个日均 PV 过亿的电商系统,凌晨 3 点数据库主库宕机。请描述你的告警体系会如何响应:会触发哪些告警?先收到哪条?哪些告警会被收敛?值班人员会收到什么样的通知?如果 10 分钟内没人确认,会发生什么?
A2:这是考察告警体系全链路协同的经典场景。整个响应流程如下:
告警触发阶段(0-30秒):首先触发的是数据库连接池耗尽告警(根因告警),几乎同时,下单服务、支付服务、库存服务、用户服务四个上游服务各自触发"数据库连接超时"告警。紧接着,下单成功率跌破阈值触发 P0 症状告警,支付成功率下降触发 P0 症状告警。
收敛阶段(30秒-1分钟):Alertmanager 的 group_wait=30s 窗口内,上述所有告警被收集完成。group_by 保证同级别告警归为一组。拓扑收敛模块检测到数据库故障是四个服务告警的共同根因,将四条上游服务告警标记为"已收敛",仅保留"数据库主库连接失败"作为根因告警。最终值班人员收到的是:一条 P0 收敛通知,内容为"数据库主库不可用,已收敛 4 条上游服务告警,影响下单/支付/库存/用户查询",附带关键指标快照。
通知阶段(1分钟):P0 级别通过电话+短信+钉钉三渠道同时推送,消息包含 Runbook 链接、当前影响面评估、值班 DBA 联系信息。
升级阶段(10分钟无人确认):主 On-Call 超时 → 自动升级到备 On-Call(电话+短信)→ 20分钟升级到团队 Leader → 25分钟升级到值班经理 → 30分钟升级到部门总监。同时,升级风暴防护机制检测到这是同一故障场景下的关联告警,不会为每条被收敛的告警单独发起升级。
Q3:Prometheus Alertmanager 的 group_by、group_wait、group_interval、repeat_interval 四个参数分别是什么含义?如果 group_interval 设置为 1 小时,而 repeat_interval 设置为 30 分钟,会发生什么?
A3:四个参数的含义:
- group_by:分组键,决定哪些告警归入同一组。例如 group_by: ['alertname', 'severity'] 表示同名且同级别的告警归为一组,合并发送。
- group_wait:首次收到该组告警后等待多久再发送。目的是等待该组内更多告警到达,一次发送而非逐条发送。典型值 30s。
- group_interval:同一组告警已发送后,有新告警加入该组时,再次通知的最小间隔。典型值 5m。如果设置为 5 分钟,意味着同一组的新告警最多每 5 分钟通知一次。
- repeat_interval:同一组告警持续未恢复时,重复发送通知的间隔。典型值 4h。用于提醒值班人员"这条告警还没恢复"。
关于陷阱问题:如果 group_interval=1h 而 repeat_interval=30m,会产生一个矛盾场景——每 30 分钟重复发送未恢复的告警,但同一组有新告警加入时却要等 1 小时才通知。这意味着新告警的时效性被严重延迟。正确的配置应该是 group_interval < repeat_interval,通常 group_interval=5m,repeat_interval=4h。如果反过来设置,实际上是配置错误,会导致新告警被延迟通知,而对持续未恢复的告警反而频繁打扰。
Q4:你的团队现在有 200 条告警规则,但信噪比只有 15%。你计划如何逐步优化到 50% 以上?请给出具体的步骤和优先级排序。
A4:优化策略分四个阶段,按投入产出比排序:
第一阶段:快速止血(1-2周)。统计每条告警规则过去 30 天的触发次数和确认率。触发次数 Top 20 但确认率为 0 的规则,直接静默或删除——这些是纯噪音。同时,对所有规则加上 for 持续时间,P0 加 for: 2m,P1 加 for: 5m,消除瞬时波动告警。这一步通常能提升信噪比 10-15 个百分点。
第二阶段:结构优化(2-4周)。将告警规则分为症状告警和根因告警两类。根因告警(CPU、内存、磁盘、连接数)全部降为 P2/P3,不进入 On-Call 通道,仅发到群聊或仪表盘。只保留症状告警(错误率、延迟、可用性)在 P0/P1。同时,引入依赖关系抑制,当数据库告警触发时,自动抑制所有依赖它的服务告警。这一步通常能提升 10-15 个百分点。
第三阶段:阈值调优(4-6周)。对每个 P0/P1 规则,分析过去 30 天的指标曲线,找到合理的阈值和 for 组合。对于有周期性的指标(如 QPS),从固定阈值切换到同比/环比阈值。引入"恢复阈值"(触发 90%,恢复 80%)避免告警震荡。这一步通常能提升 5-10 个百分点。
第四阶段:持续运营(长期)。建立告警规则生命周期管理,每季度 review 所有规则。引入告警质量仪表盘,展示每条规则的信噪比、响应时间、误报率。设置规则自动退役——连续 30 天未触发且非核心规则,自动降级为 P3。最终目标是信噪比维持在 50% 以上。
Q5:在一个微服务架构中,服务 A 调用服务 B,服务 B 调用服务 C。如果服务 C 故障,A 和 B 都会触发告警。请设计一个告警收敛方案,确保值班人员只收到一条关于"服务 C 故障"的有效告警,而不是三条。你如何实现服务间的依赖关系发现和告警抑制?
A5:核心思路是依赖拓扑发现 + 告警抑制规则。
依赖关系发现有三种方式:
- 静态配置(最简单):维护一个 YAML 配置文件,定义服务间的依赖关系。适合依赖关系不频繁变化的场景。
- 链路追踪推导(推荐):从分布式追踪系统(如 Jaeger、Zipkin)的服务调用拓扑中自动提取依赖关系。定时任务每小时拉取一次拓扑图,更新依赖关系矩阵。
- 服务网格 Sidecar 上报(最精确):如果使用了 Service Mesh(如 Istio),Envoy Sidecar 天然知道上下游调用关系,可以直接从控制面获取。
告警抑制实现(以 Alertmanager 为例):
# 抑制规则:当服务 C 触发 P0 告警时,抑制服务 A 和 B 的同类型告警
inhibit_rules:
  - source_match:
      alertname: 'ServiceCDown'
      severity: 'P0'
    target_match_re:
      alertname: 'ServiceADown|ServiceBDown'
    equal: ['severity']
工作流程:当服务 C 故障触发 P0 告警后,Alertmanager 的抑制引擎检测到该告警,自动将服务 A 和 B 的告警标记为 SUPPRESSED,不发送通知。值班人员收到的通知中,annotation 会注明"已抑制上游服务 A、B 的告警"。如果服务 C 恢复而服务 A 仍然异常,抑制解除,服务 A 的告警正常发送。
进阶做法:在告警通知中附带拓扑影响面——"服务 C 故障,影响路径:C → B → A,间接影响 12 个下游服务,预计影响用户数约 50 万"。这能帮助值班人员快速评估故障严重程度。
Q6:告警升级机制中,如何避免"升级风暴"——即一个故障导致多个告警同时升级,最终把整个管理层都叫醒?请设计一个升级风暴防护机制。
A6:升级风暴的根本原因是多条告警各自独立走升级流程,缺乏"全局视角"。防护机制需要从三个层面设计:
第一层:收敛层防护。在告警进入升级流程之前,先经过收敛。使用 group_by 将同一故障场景下的多条告警归为一组,只有组级别的告警才进入升级流程。例如,数据库故障导致 4 条上游告警,收敛后只生成一条"数据库故障-影响面摘要"告警,仅这一条走升级流程。
第二层:升级去重层。维护一个全局的"升级窗口"状态表。当一条告警进入升级流程后,在 N 分钟窗口内(如 15 分钟),所有与被升级告警属于同一故障场景的告警,自动绑定到同一升级链,不发起新的升级。实现方式:告警管理平台在升级时向一个集中式状态存储(如 Redis)写入 key escalation:active:{incident_id},后续告警升级前先检查该 key 是否存在,存在则追加入已有升级链而非新建。
第三层:升级熔断层。设置硬性限制:
- 同一升级链最多升级到团队 Leader 级别,不允许所有告警都升级到总监
- 同一升级链在 30 分钟内最多升级 3 次
- 同一时间段内(如凌晨 2-7 点)最多允许 2 条独立的升级链同时存在,超过的排队等待
- 全局升级频率限制:10 分钟内最多发起 5 次电话通知,超过的降级为短信
通知层面的防护:升级通知中聚合上下文,例如"凌晨 3:15 数据库故障升级通知:主 On-Call 超时,已升级至备 On-Call。当前故障影响下单/支付/库存 3 条核心链路,预计影响 50 万用户。已收敛 4 条关联告警。"一条消息囊括所有关键信息,避免管理层收到多条碎片化消息。
Q7:你如何衡量一个告警体系的质量?除了信噪比之外,还有哪些指标?如果一个告警体系"看起来很好"(信噪比高、响应快),但线上故障还是经常由用户先发现,可能的原因是什么?
A7:告警体系质量需要多维度衡量,我通常使用以下指标体系:
核心指标:
- 信噪比(SNR):有效告警/总告警,目标 > 50%
- MTTD(Mean Time To Detect):故障发生到告警触发的时间,反映告警规则的灵敏度
- MTTA(Mean Time To Acknowledge):告警触发到值班人员确认的时间,P0 < 5min
- MTTR(Mean Time To Resolve):告警触发到故障恢复的时间,反映整体响应效率
- 告警覆盖率:有告警覆盖的故障/总故障数,目标 > 95%
辅助指标:
- 告警疲劳度:每人每周收到的无效告警数,目标 < 10
- 告警规则活跃率:过去 30 天至少触发过一次的规则占比,目标 > 60%(低于此值说明大量僵尸规则)
- 升级率:告警进入升级流程的比例,目标 < 5%(过高说明一线响应能力不足)
- NPS 类指标:每月对值班人员做告警体验调查,"你是否信任当前告警体系?"(1-5 分),目标平均分 > 4
关于"看起来很好但用户先发现故障"的矛盾,可能原因有:
- 告警覆盖的是"已知故障模式",漏掉了"未知故障模式"。信噪比高可能是因为只告警了最容易检测的问题,而真正难检测的异常(如数据正确性问题、慢退化、局部降级)没有被覆盖。典型案例:下单成功率 99.5%,未触发阈值,但实际上某个省份的用户全部下单失败——总量指标掩盖了局部问题。
- 告警指标和用户体感之间存在 Gap。高信噪比可能来自大量"技术指标告警"被降噪,但真正反映用户体感的业务指标告警不足。例如,你没有监控"用户完成下单的平均耗时",只监控了"服务端 P99 延迟"——服务端延迟正常,但前端渲染慢导致用户流失。
- SLO 设置不合理。告警阈值基于 SLO 设定,但 SLO 本身可能过于宽松。例如错误率阈值设为 1%,但用户对 0.5% 的失败率已经感知强烈。
- 告警盲区。基础设施告警(服务/数据库)完善,但前端、CDN、第三方依赖(支付网关、短信服务)的告警覆盖不足。用户可能因为 CDN 回源失败或第三方支付超时而无法使用,但你的告警体系完全看不到。
Q8:请设计一个告警规则的生命周期管理系统。从规则创建、验证、上线、观察到退役,每个阶段应该有哪些检查和审批?如何防止"规则腐化"——越来越多的无效规则堆积在系统中?
A8:告警规则生命周期管理系统设计如下:
阶段一:创建(Creation)
触发条件:新服务上线、故障复盘 Action Item、SLO 变更、业务方需求。
必填信息:
- 告警名称、级别(P0-P3)
- 告警指标和 PromQL/DSL 表达式
- 阈值和 for 持续时间
- 所属服务和团队
- 告警含义(一句话描述)
- 影响范围(影响哪些用户/业务)
- Runbook 链接(必填,否则不允许创建 P0/P1 规则)
- 预期触发频率(如"预计每月触发 1-2 次")
- 退役条件(如"关联服务下线时自动退役")
审批流程:P0 规则需要团队 Leader + SRE 负责人双审批;P1 规则需要团队 Leader 审批;P2/P3 可自助创建。
阶段二:验证(Validation)
在预发布/灰度环境验证规则有效性:
- 规则语法正确,能正常触发
- 阈值和 for 组合合理,不会震荡
- 通知渠道正确,包含完整的上下文信息
- 模拟故障注入验证(可选但推荐):通过 Chaos Engineering 工具注入故障,确认告警能在预期时间内触发
阶段三:上线(Rollout)
- 规则上线后进入 "观察模式"(前 2 周),P0/P1 规则先以 P2 级别发送,验证无误后自动升级为声明级别
- 自动记录规则的首次上线时间、创建人、审批人
阶段四:观察与优化(Observe & Optimize)
持续监控每条规则的运行质量:
- 每周自动生成"告警规则健康报告":触发次数、确认率、平均响应时间、误报率
- 连续 2 周误报率 > 50% 的规则 → 自动降级并通知规则 Owner
- 每条规则设置 TTL(Time To Live),默认 6 个月,到期后需 Owner 手动续期,否则自动降级为 P3
阶段五:退役(Retirement)
自动退役条件:
- 连续 30 天未触发 → 标记为"待评估"
- 连续 90 天未触发 → 自动降级为 P3,通知 Owner
- 连续 180 天未触发 → 自动删除(先归档到规则仓库,可恢复)
- 关联服务/组件已下线 → 立即删除
人工退役:任何人在规则健康报告中标记"此规则已无价值",经 Owner 确认后退役。
防止规则腐化的长效机制
- 季度告警规则大扫除:每季度初,SRE 团队组织一次规则清理会议,逐条 review 所有 P0/P1 规则,评估是否仍然需要、阈值是否合理
- 规则 Owner 责任制:每条规则有明确的 Owner(个人,不是团队),Owner 离职/转岗时自动触发规则交接流程
- 告警规则预算制:每个团队有 P0/P1 规则配额(如 P0 ≤ 8 条,P1 ≤ 20 条),超出配额需特殊审批
- 规则创建关联工单:每条规则关联一个工单,工单关闭时自动评估规则是否仍需保留
- 自动化巡检:每周自动扫描所有规则,生成"僵尸规则"列表(30 天未触发)和"噪音规则"列表(触发但 0 确认),推送到团队群聊
阅读建议:以上 8 个问题的回答结合了 Google SRE 最佳实践和国内互联网公司的实际落地经验。建议读者在理解回答的基础上,结合自己团队的实际场景(团队规模、业务特点、技术栈)进行适配,而非照搬。好的告警体系不是设计出来的,是持续运营出来的。