阅读时间:约 45 分钟 难度:中级~高级 适用人群:Java 后端工程师、SRE、性能工程师
引言
凌晨三点,告警响起——线上服务 CPU 使用率从 15% 飙到 95%,RT 飙升,504 超时刷屏。你打开监控面板,确认不是误报,接下来该做什么?
CPU 飙高是线上故障中最常见的一类,也是最考验排查功底的。与其说它是一个技术问题,不如说它是一个"信息收敛"问题:系统运行时产生的信号很多,但你能在有限时间内抓住关键信号、形成证据链、定位到根因吗?
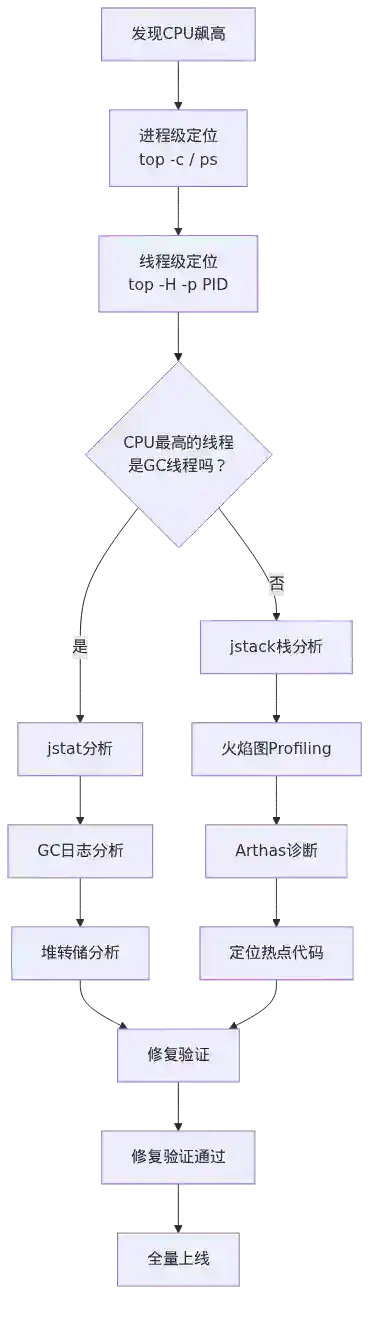
本文将从进程级定位 → 线程级定位 → 栈分析 → 热点代码 → GC 关联五个层次,串起一条完整的 CPU 飙高排查链路。每个层次都有对应的工具和命令,形成肌肉记忆后,你可以在 5 分钟内完成从"发现异常"到"定位代码行"的全过程。
一、第一层:进程级定位 —— 找到"谁"在吃 CPU
1.1 经典三板斧:top / ps / vmstat
排查的第一步永远是缩小范围。一台机器上可能跑着几十个 Java 进程,你需要先确定是哪个进程在消耗 CPU。
# 按 CPU 使用率排序,实时刷新
top -c

# 一次性快照,适合脚本采集
ps aux --sort=-%cpu | head -20

# 查看系统整体负载趋势
vmstat 1 5
**top**输出关键字段解读:
| 字段 | 含义 | 排查关注点 |
|---|---|---|
%CPU |
进程 CPU 使用率(多核可超 100%) | >100% 说明多线程并发消耗 |
%MEM |
物理内存占用比例 | 配合 CPU 判断是否内存泄漏导致 GC |
TIME+ |
累计 CPU 时间 | 短时间异常高说明突发计算 |
load average |
1/5/15 分钟平均负载 | 负载 > CPU 核数说明有等待 |
一个关键判断:如果 CPU 使用率高但 load average 不高,说明是纯计算密集型;如果 CPU 使用率高且 load average 远超核数,大概率有大量线程在等待(可能是锁竞争、IO 等待的间接表现)。
1.2 容器环境特别注意
在 Docker/K8s 环境中,top 看到的是宿主机的全局 CPU,可能被误导。请使用:
# 查看容器级别的 CPU 配额和使用情况
docker stats <container_id>

# 进入容器后查看 cgroup 限制
cat /sys/fs/cgroup/cpu/cpu.cfs_quota_us
cat /sys/fs/cgroup/cpu/cpu.cfs_period_us

# cgroup v2
cat /sys/fs/cgroup/cpu.max
如果容器被限流(throttling),nr_throttled 计数会持续增长。这意味着即使 CPU 使用率看起来不高,实际已经触达配额天花板,请求延迟会周期性抖动。
二、第二层:线程级定位 —— 找到"哪个线程"在吃 CPU
2.1 top -H:线程视角
找到高 CPU 进程后,下一步是定位到具体线程:
# -H 显示线程视图,-p 指定进程 PID
top -H -p <pid>

# 或者用 ps
ps -T -p <pid> --sort=-%cpu | head -20
你会看到类似这样的输出:
  PID USER      PR  NI    VIRT    RES    SHR S %CPU %MEM     TIME+ COMMAND
12345 admin     20   0 8765432 2.1g  18432 R 45.0  2.6  12:34.56 java
12346 admin     20   0 8765432 2.1g  18432 R 42.3  2.6  11:22.33 java
12347 admin     20   0 8765432 2.1g  18432 S  0.3  2.6   0:00.12 java
注意 %CPU 最高的两个线程(12345 和 12346),它们就是我们要深入追踪的对象。
2.2 关键操作:线程 ID 转十六进制
Java 的线程栈(jstack)中使用的是十六进制的线程 ID(nid),而 Linux 系统使用的是十进制。这个转换是排查中最容易出错的环节:
# 将十进制线程 ID 转为十六进制
printf "%x\n" 12345
# 输出:3039

# 一步到位:找到 CPU 最高的 Java 线程并转十六进制
top -H -b -n 1 -p <pid> | grep java | sort -k9 -r | head -5 | \
  awk '{printf "%s (0x%x)\n", $1, $1}'
阿里的 Arthas 工具提供了更便捷的方式:
thread -n 3直接列出 CPU 使用率最高的 3 个线程及其当前执行的代码,省去了手动转换和 jstack 查找的步骤。但理解底层原理的排查链路仍然重要——Arthas 可能无法在极端高负载下正常 attach。
!
三、第三层:栈分析 —— 线程到底在执行什么代码
3.1 jstack 核心用法
# 获取线程栈快照(建议连续采集 3-5 次,间隔 2 秒)
jstack -l <pid> > jstack_1.log
sleep 2
jstack -l <pid> > jstack_2.log
sleep 2
jstack -l <pid> > jstack_3.log

# 或者使用 jcmd(更现代的方式)
jcmd <pid> Thread.print > threads.log
为什么需要多次采集? 单次 jstack 只是一个瞬间快照,线程可能在短暂的等待和运行之间切换。多次采集后比对,如果某个线程始终在同一个方法调用栈上,基本可以确定这就是热点。
3.2 线程栈结构解读
一段典型的 jstack 输出:
"http-nio-8080-exec-15" #47 daemon prio=5 os_prio=0 tid=0x00007f8a1c001000 nid=0x3039 runnable [0x00007f8a0c8f8000]
   java.lang.Thread.State: RUNNABLE
        at com.example.service.ReportService.generateReport(ReportService.java:156)
        at com.example.service.ReportService.exportPDF(ReportService.java:132)
        at com.example.controller.ReportController.download(ReportController.java:45)
        at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
        ...

   Locked ownable synchronizers:
        - <0x00000006c2e1a3a0> (a java.util.concurrent.locks.ReentrantLock$NonfairSync)
关键字段解析:
| 字段 | 含义 |
|---|---|
nid=0x3039 |
原生线程 ID(十六进制),对应 top -H 中的 12345 |
runnable |
线程状态(注意:JVM 的 RUNNABLE 包含 waiting for CPU 和 真正运行中) |
ReportService.java:156 |
最关键的定位信息——当前正在执行的代码行 |
Locked ownable synchronizers |
持有的锁,排查死锁的关键 |
3.3 线程状态与 CPU 飙高的关联
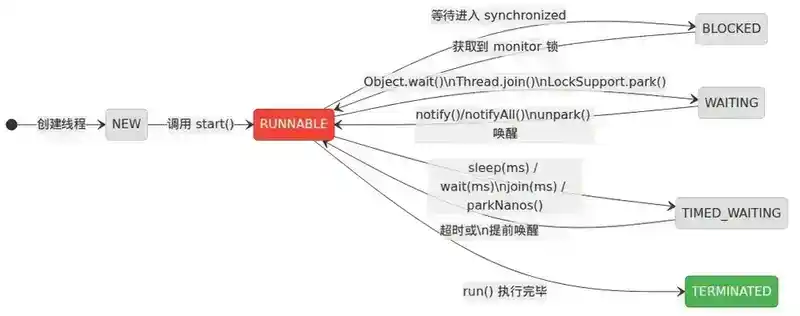
Java 线程有 6 种状态,并非所有状态都与 CPU 飙高相关:
| 状态 | 含义 | 与 CPU 飙高的关系 |
|---|---|---|
| RUNNABLE | 可运行(含真正运行中 + 等待 CPU 调度) | ✅ 直接相关,这就是消耗 CPU 的线程 |
| BLOCKED | 等待获取 monitor 锁 | 不直接消耗 CPU,但大量线程 BLOCKED 说明锁竞争严重 |
| WAITING | 无限期等待(Object.wait/join) | 不消耗 CPU |
| TIMED_WAITING | 限时等待(sleep/wait(timeout)) | 不消耗 CPU |
| NEW / TERMINATED | 新建/终止 | 不消耗 CPU |
核心结论:排查 CPU 飙高时,只关注 RUNNABLE 状态的线程。在 jstack 中搜索 RUNNABLE,然后比对多次快照,找到反复出现的栈帧。
!
3.4 常见 CPU 飙高场景的线程栈特征
场景 A:死循环 / 无限计算
特征:某个线程始终在同一个方法中,多次 jstack 栈帧不变。
"pool-3-thread-1" #32 prio=5 nid=0x3f2a runnable
   at com.example.service.CalcService.heavyLoop(CalcService.java:88)
   at com.example.service.CalcService.process(CalcService.java:72)
场景 B:正则表达式灾难性回溯
特征:栈帧停在 java.util.regex.Pattern 的相关方法中,CPU 持续高但线程看似在"运行中"。
"http-nio-8080-exec-23" #55 nid=0x4b1c runnable
   at java.util.regex.Pattern$BmpCharProperty.match(Pattern.java:3797)
   at java.util.regex.Pattern$Branch.match(Pattern.java:4604)
   at java.util.regex.Matcher.match(Matcher.java:1270)
这类问题通常由恶意构造的输入 + 复杂正则表达式触发,正则引擎回溯深度可达指数级。
场景 C:JSON 序列化/反序列化大对象
特征:栈帧在 Jackson/Gson/Fastjson 的序列化方法中。
"http-nio-8080-exec-42" #74 nid=0x5a33 runnable
   at com.fasterxml.jackson.databind.ser.BeanPropertyWriter.serializeAsField(...)
   at com.fasterxml.jackson.databind.ser.BeanSerializer.serialize(...)
场景 D:HashMap 退化
特征:不停执行 HashMap.put() 或 HashMap.get(),但在链表中遍历。多次 jstack 总是停在 HashMap 的桶遍历中。
"http-nio-8080-exec-8" #40 nid=0x4178 runnable
   at java.util.HashMap.getNode(HashMap.java:571)
   at java.util.HashMap.get(HashMap.java:556)
这种情况通常是因为 HashMap 的 key 的 hashCode() 设计不当,导致大量元素落在一个桶中,get 操作退化为 O(n)。
四、第四层:热点代码定位 —— Profiler 与火焰图
4.1 jstack 的局限性
jstack 是"抽样"而非"统计"。你只能看到线程在某一个瞬间的栈帧,但无法知道在 10 分钟内,某个方法累计消耗了多少 CPU 时间。这就需要 Profiler 工具。
4.2 Async Profiler:Linux perf_event 的 Java 封装
async-profiler 是目前 Java 生态中首选的 CPU Profiler,它利用 Linux 的 perf_event 进行采样,同时支持 perf 的调用栈展开和 JVM 的 JFR(Java Flight Recorder)。
# 采样 30 秒,生成火焰图
profiler.sh -d 30 -f /tmp/flamegraph.html <pid>

# 只采样 CPU 事件
profiler.sh -e cpu -d 30 -f /tmp/cpu.html <pid>

# 同时采样 CPU 和 内存分配
profiler.sh -e cpu,alloc -d 30 -f /tmp/profile.html <pid>

# 生成 JFR 格式,可在 JDK Mission Control 中分析
profiler.sh -d 60 -o jfr -f /tmp/recording.jfr <pid>
Async Profiler 的核心优势:
- 极低的开销:基于 perf_event 内核接口,采样而非插桩,对生产环境影响极小(通常 < 2%)
- 同时获取内核栈和 Java 栈:可以看到 JVM 到底在系统调用层面做了什么
- 不依赖 JVM 协作:不需要
-XX:+PreserveFramePointer等特殊参数,使用 perf 的 DWARF 栈展开
4.3 火焰图解读
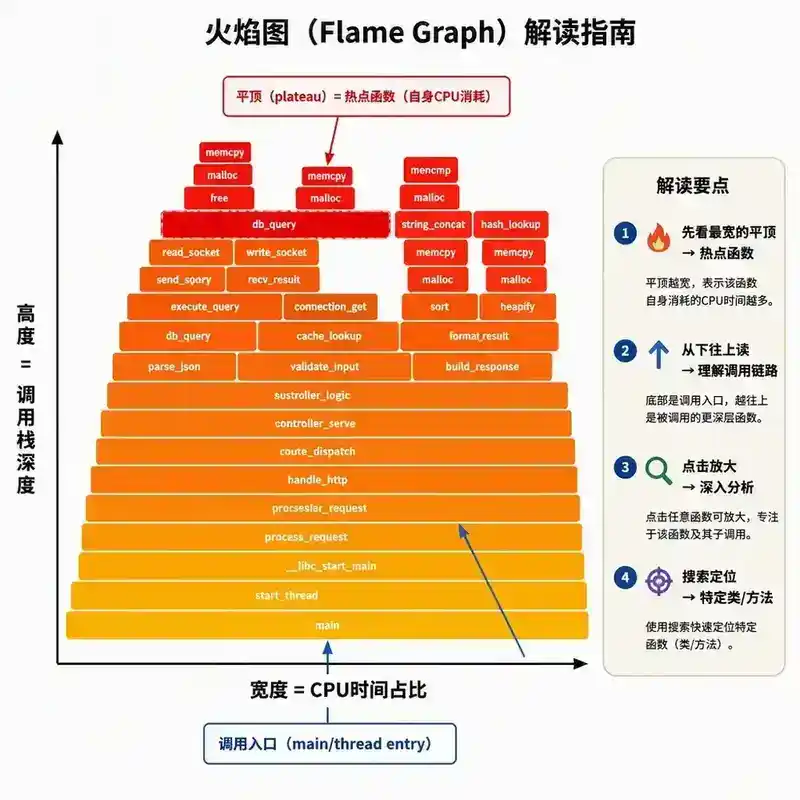
火焰图(Flame Graph)是 Brendan Gregg 发明的可视化方法,它把多次采样的调用栈叠在一起:
- X 轴宽度:代表该函数在采样中出现的比例(即 CPU 时间占比)
- Y 轴高度:代表调用栈深度
- 颜色:通常随机分配,无特殊含义
- 平顶:代表该函数自身在 CPU 上运行(而非等待子调用返回)
读图技巧:
- 先看最宽的"平顶"——这就是 CPU 消耗最大的热点函数
- 从下往上读,理解调用链路
- 点击某一帧可以放大,深入分析
- 用"搜索"功能定位特定类或方法
!
4.4 Arthas:在线诊断利器
当无法安装 profiler 或需要实时交互式诊断时,Arthas 是首选:
# 启动 Arthas
java -jar arthas-boot.jar

# 查看 CPU 最高的 N 个线程(实时刷新)
thread -n 5

# 查看特定线程的栈(thread-id 来自 thread 命令的输出)
thread <thread-id>

# 监控方法调用耗时和调用次数
monitor -c 5 com.example.service.ReportService generateReport

# 观察方法入参和返回值(谨慎使用,有性能开销)
watch com.example.service.ReportService generateReport '{params, returnObj, throwExp}' -x 3

# 方法调用链路追踪
trace com.example.service.ReportService generateReport

# 反编译类,确认线上代码版本
jad com.example.service.ReportService
**thread -n**的核心价值:它内部做的事情就是 top -H + 线程 ID 转十六进制 + jstack 查找的自动化,但 Arthas 通过 JVMTI 的 GetThreadCpuTime() 可以精确获取每个线程的 CPU 时间,比 jstack 的"快照"更准确。
4.5 线程 CPU 时间的真相
这里有一个容易混淆的概念:
- 线程 CPU 时间(Thread Cpu Time):该线程实际占用 CPU 执行的时间,JVM 通过
java.lang.management.ThreadMXBean.getThreadCpuTime()获取 - 线程状态:线程在 JVM 层面的状态(RUNNABLE/BLOCKED 等)
一个线程处于 RUNNABLE 状态,不代表它正在消耗 CPU。它可能只是在等待操作系统调度,或者在等待 IO 完成(从 JVM 视角看 IO 也是 RUNNABLE)。所以真正精确的 CPU 排查,必须依赖 CPU 时间的累积值,而非状态快照。
Arthas 的 thread -n 就是基于 CPU 时间排序,这比单纯看 jstack 中的 RUNNABLE 线程更准确。
五、第五层:GC 与 CPU 的关联
5.1 GC 为何让 CPU 飙高
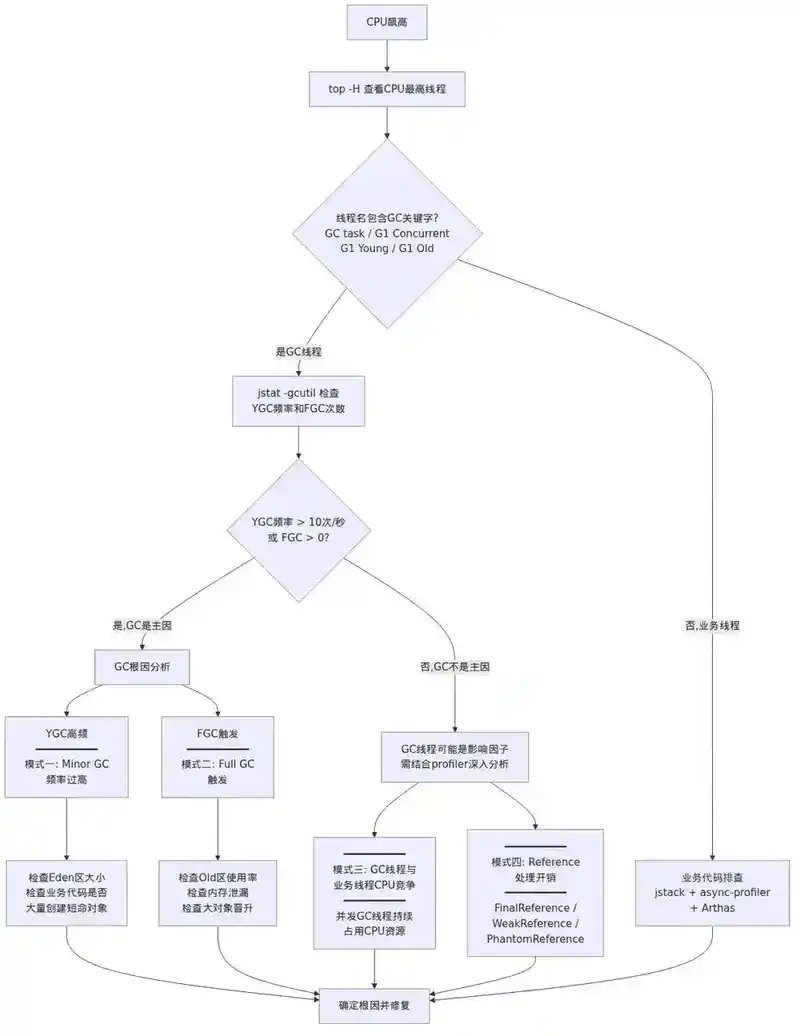
很多 CPU 飙高的问题,根因不在业务代码,而在 GC。以下是 GC 导致 CPU 高的几种典型模式:
模式一:Minor GC 频率过高
- 现象:CPU 被 GC 线程消耗,YGC 每秒数十次甚至上百次
- 根因:Young 区太小,或者业务代码瞬间产生大量短命对象
- 典型场景:批量处理、JSON 解析、大对象频繁分配
模式二:Full GC 触发
- 现象:Old 区满了,触发 Full GC,GC 线程长时间占用 CPU
- 根因:内存泄漏、大对象进入 Old 区、晋升阈值设置不当
- 副作用:CMS 并发标记阶段与业务线程抢占 CPU 时间片
模式三:GC 线程与业务线程竞争
- 现象:在 G1/ZGC 的并发标记阶段,GC 线程与业务线程竞争 CPU 资源
- 根因:容器 CPU 配额不足,或并发 GC 线程数设置过高
模式四:Reference 处理
- 现象:大量 SoftReference/WeakReference 需要处理,ReferenceHandler 线程占用 CPU
- 根因:使用弱引用做缓存,但回收频率过高
5.2 GC 活动检测方法
# 实时查看 GC 统计
jstat -gcutil <pid> 1000 10

# 输出示例:
#  S0     S1     E      O      M     CCS    YGC     YGCT    FGC    FGCT     GCT
#  0.00  45.32  78.12  23.45  95.21  93.55   1234   56.789    12    5.678   62.467
关键指标解读:
| 指标 | 含义 | 异常阈值 |
|---|---|---|
YGC / YGCT |
Young GC 次数和总耗时 | YGC 频率 > 10次/秒需关注 |
FGC / FGCT |
Full GC 次数和总耗时 | FGC > 0 立即排查,每次 FGCT > 1s 严重 |
GCT |
总 GC 耗时 | > 总运行时间的 5% 说明 GC 压力大 |
E |
Eden 区使用率 | 频繁到达 100% 说明 Young 区太小 |
O |
Old 区使用率 | 持续增长不回落 = 内存泄漏 |
5.3 GC 日志确认
# 如果启动参数中开启了 GC 日志
# -Xlog:gc*:file=/tmp/gc.log:time,level,tags

# 查看最近的 GC 事件
grep "Full GC" /tmp/gc.log | tail -20

# 统计 GC 暂停时间
jstat -gcutil <pid> 1000 | awk 'NR>1 {sum+=$10; count++} END {print "Avg FGC Time:", sum/count "s"}'
5.4 判断 GC 是否是 CPU 飙高的根因
一个简单的判断方法:
# 查看 GC 相关的线程在 jstack 中是否频繁出现
jstack <pid> | grep -E "GC task|G1 (Concurrent|Young|Mixed)|Concurrent Mark|VM Thread"

# 用 top -H 观察,GC 线程的 COMMAND 通常显示为类似:
# "GC task thread#0 (ParallelGC)" 或 "G1 Concurrent Refinement Thread#0"
如果 top -H 中 CPU 最高的几个线程是 GC 线程,那问题显然在 GC 上。否则,GC 可能只是"受害者"——业务代码产生大量对象导致 GC 频繁,但根因还是业务代码。
!
六、实战案例
案例一:HashMap 退化导致 CPU 100%
背景:某电商订单服务,大促期间 CPU 从 30% 飙到 100%,RT 从 50ms 升到 5s。
排查过程:
top -H -p <pid>发现 CPU 最高线程 ID 为 28541(十六进制 0x6f7d)jstack <pid> | grep -A 20 "0x6f7d"发现栈帧停在java.util.HashMap.getNode()- 多次 jstack 确认线程始终卡在 HashMap 查找
- Arthas
watch发现 HashMap 中某些桶的链表长度超过 2000 - 排查代码发现
Order对象的hashCode()方法只基于orderType字段计算,而大促期间 90% 订单都是同一类型
根因:hashCode() 设计缺陷导致 HashMap 退化为链表,get 操作 O(n)。
修复:重写 hashCode() 方法,均匀分布哈希值;同时改用 ConcurrentHashMap 的 computeIfAbsent 原子操作。
案例二:正则表达式回溯导致 CPU 假死
背景:某内容审核服务,偶尔出现 CPU 飙高且长时间不恢复,kill 后重启恢复正常。
排查过程:
- jstack 发现所有工作线程都停在
java.util.regex.Pattern的 match 方法中 - 从栈帧往上追溯,发现正则表达式为
^(a+)+$,输入是一个包含 30 个 'a' 后面跟一个 'b' 的长字符串 - 这是典型的灾难性回溯(Catastrophic Backtracking)——正则引擎尝试所有可能的匹配组合,复杂度呈指数增长
根因:正则表达式中的嵌套量词 (a+)+ 在匹配失败时会穷举所有分组组合。
修复:重写正则为 ^a+$,并在使用前用有限状态机验证;同时对所有正则匹配加上超时机制。
案例三:大对象频繁分配导致 GC 占满 CPU
背景:某推荐系统,每次请求后 CPU 飙高,持续 5-10 秒后恢复。
排查过程:
top -H发现 CPU 最高的是 "GC task thread" 相关线程jstat -gcutil 1000发现 YGC 每秒 30+ 次,Eden 区 1 秒内就打满- Async Profiler 采样发现 80% 的 CPU 时间花在 TLAB 分配和 GC 线程上
- Arthas
trace发现在推荐算法中,每次请求会创建一个大 ArrayList(初始容量 10000),然后填充大量临时对象
根因:推荐算法中创建了大量中间对象,Eden 区瞬间填满,触发高频 Minor GC。
修复:使用对象池复用 ArrayList;改用流式处理减少中间对象;适当调大 Young 区(-Xmn)。
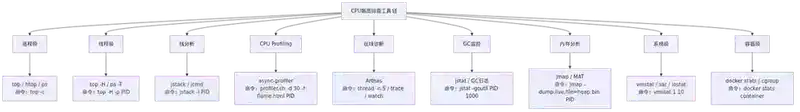
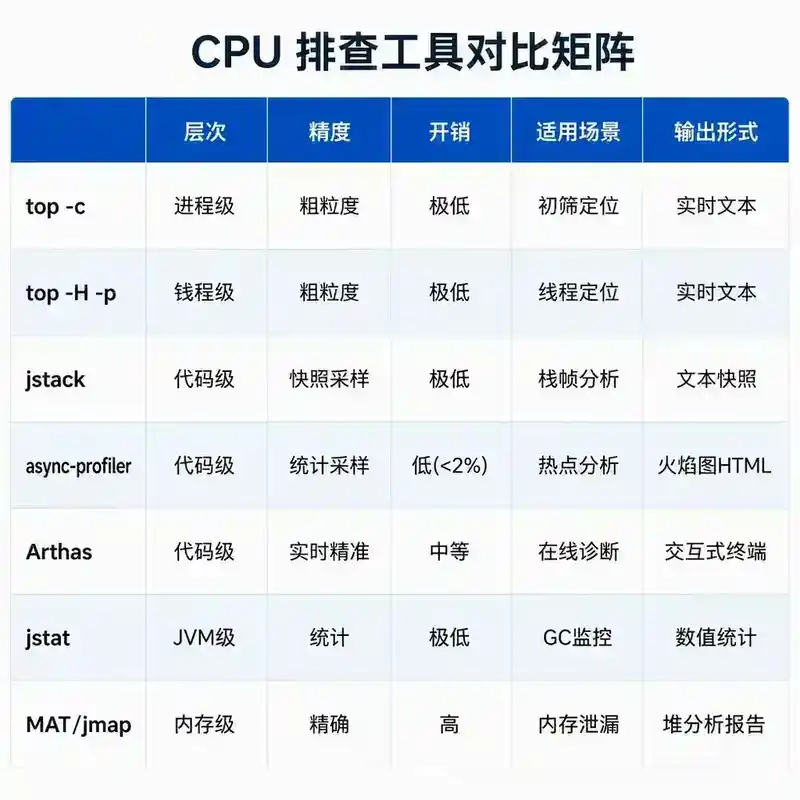
七、排查工具链总结
| 层次 | 工具 | 用途 | 典型命令 |
|---|---|---|---|
| 进程级 | top / htop / ps | 定位高 CPU 进程 | top -c |
| 线程级 | top -H / ps -T | 定位高 CPU 线程 | top -H -p &amp;lt;pid&amp;gt; |
| 栈分析 | jstack / jcmd | 获取线程栈快照 | jstack -l &amp;lt;pid&amp;gt; |
| CPU Profiling | async-profiler | 生成火焰图,统计 CPU 时间 | profiler.sh -d 30 -f flame.html &amp;lt;pid&amp;gt; |
| 在线诊断 | Arthas | 交互式排查,实时监控 | thread -n 5, trace, watch |
| GC 监控 | jstat / GC 日志 | GC 统计和日志分析 | jstat -gcutil &amp;lt;pid&amp;gt; 1000 |
| 内存分析 | jmap / MAT | 堆转储和对象分析 | jmap -dump:live,file=heap.bin &amp;lt;pid&amp;gt; |
| 系统级 | vmstat / sar / iostat | 系统资源全景 | vmstat 1 10 |
| 容器级 | docker stats / cgroup | 容器资源限制和使用 | docker stats &amp;lt;container&amp;gt; |
!
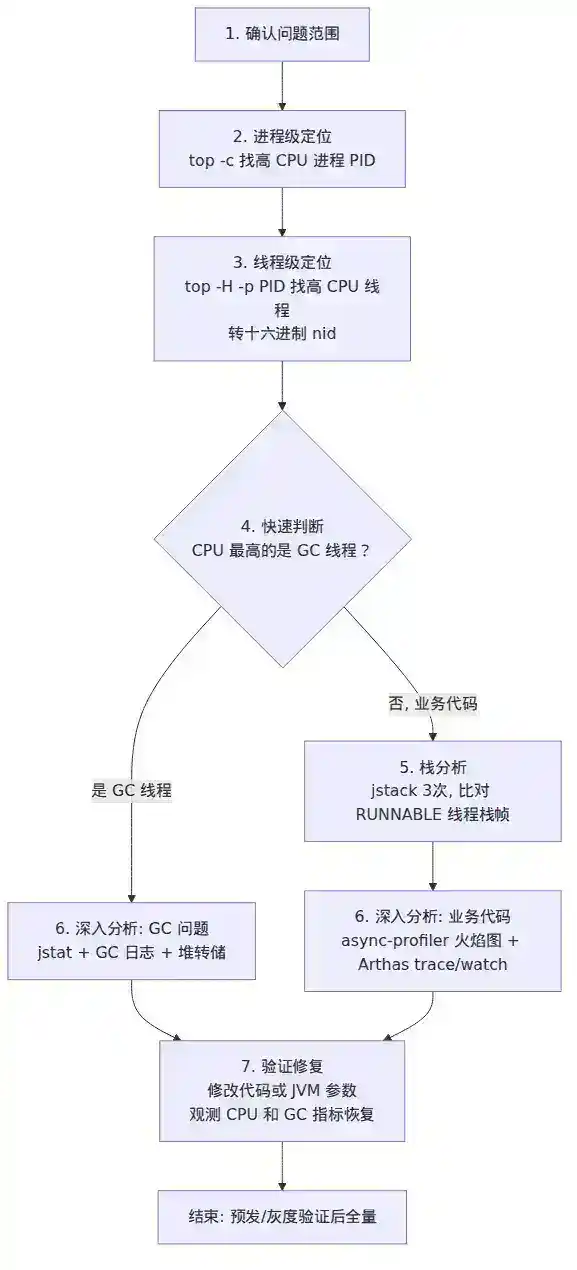
八、排查 SOP(标准操作流程)
将上述所有内容浓缩为一套标准操作流程,面对 CPU 飙高时按以下顺序执行:
1. 确认问题范围
   → 哪个机器?哪个进程?持续多久?是否有业务影响?

2. 进程级定位
   → top -c 找到 CPU 最高的 Java 进程 PID

3. 线程级定位
   → top -H -p <PID> 找到 CPU 最高的线程,转十六进制

4. 快速判断:GC 还是业务代码?
   → top -H 中 CPU 最高的是 GC 线程?→ 跳至步骤 6
   → 否则 → 继续步骤 5

5. 栈分析
   → jstack 3 次,比对 RUNNABLE 线程的栈帧
   → 分析热点代码

6. 深入分析
   → GC 问题:jstat + GC 日志 + 堆转储
   → 业务代码:async-profiler 火焰图 + Arthas trace/watch

7. 验证修复
   → 修改代码或 JVM 参数后,观测 CPU 和 GC 指标恢复
   → 在预发/灰度环境验证后再全量
!
九、总结
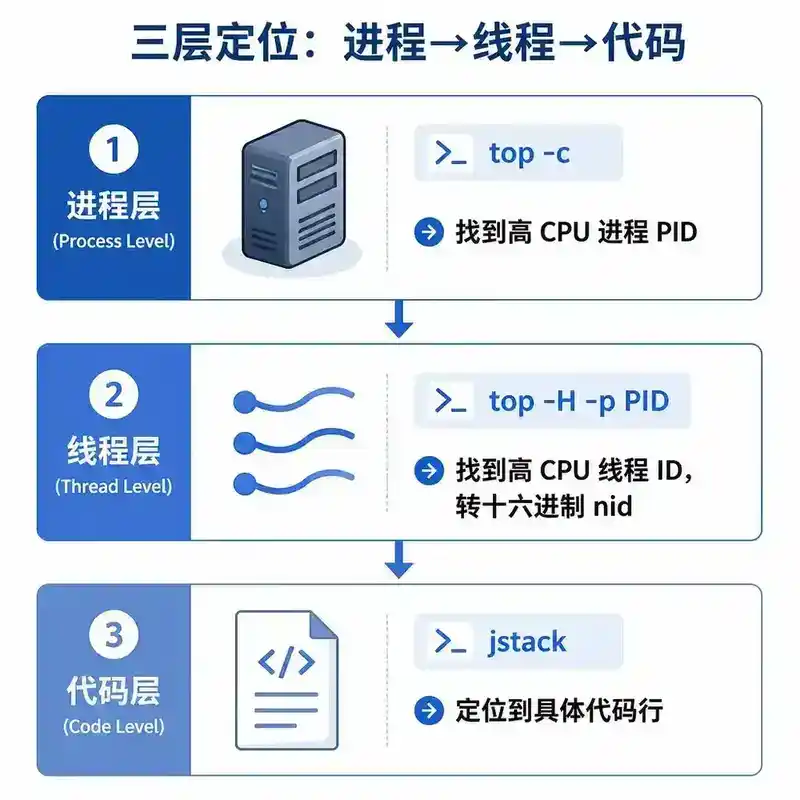
CPU 飙高排查本质上是一个逐层收敛的过程:
- 进程级:范围从"整台机器"收敛到"一个进程"
- 线程级:范围从"一个进程"收敛到"几个线程"
- 栈分析:范围从"几个线程"收敛到"某几行代码"
- 热点分析:从"快照"升级到"统计",找到真正的 CPU 热点
- GC 关联:判断根因在 GC 还是业务代码,避免头痛医头
核心技巧只有三个:缩小范围(逐层定位)、多次采样(避免单点误判)、交叉验证(多个工具相互印证)。
!
!
面试官视角提问
Q1:你发现线上 CPU 100%,jstack 后发现所有线程都在 RUNNABLE 状态且停在**java.util.HashMap.get()**,但多次 jstack 中线程 ID 不同。这说明什么问题?下一步你打算怎么排查?
点击查看解析
线程 ID 不同说明这不是某个特定线程的问题,而是所有线程均匀地受 CPU 飙高影响。这种情况下,HashMap 的 get 操作可能不是根因,而是"受害者"——真正的根因可能是 GC 导致 STW,STW 恢复后所有线程同时恢复执行,你抓到的 jstack 快照正好是它们刚恢复后在 HashMap 中查找的第一个操作。
下一步应该:
- 用
jstat -gcutil检查 GC 频率和暂停时间 - 用 async-profiler 采样 CPU,看 CPU 时间到底花在 HashMap 还是 GC 上
- 如果确认是 HashMap,再用 Arthas watch 观察 HashMap 的桶深度
Q2:async-profiler 和 jstack 在 CPU 分析上有什么本质区别?为什么只看 jstack 可能得出错误结论?
点击查看解析
本质区别在于采样方式和统计维度:
- jstack:时间点快照,只能看到线程在某个瞬间的栈帧。它无法告诉你这个线程在过去 10 分钟内累计在哪段代码上花了最多 CPU 时间。你看到的 RUNNABLE 线程可能只是刚好在等待 CPU 调度,而不是真正在消耗 CPU。
- async-profiler:基于 perf_event 的周期性采样(默认采样频率可配置),统计的是CPU 时间累计占比。它告诉你的是"过去 30 秒内,CPU 30% 的时间在方法 A,20% 在方法 B"。
只看 jstack 的经典误判:某线程在 jstack 中显示 RUNNABLE 且停在 Thread.sleep() 下面的代码,但实际上它刚从 sleep 中醒来,还没开始真正消耗 CPU。而 async-profiler 的火焰图中,这个方法的宽度会很窄。
Q3:线上服务 CPU 飙高,但 jstack 只看到几十个线程,top -H 也只显示几十个线程,CPU 使用率却显示 800%(8 核机器)。这合理吗?怎么解释?
点击查看解析
完全合理。CPU 使用率 800% 的含义是8 个核都被占满(每个核 100%),而不是 800 个线程。如果只有 8 个线程,每个都在做纯计算,就可以把 8 个核打满。
关键判断:
- 如果有 8 个线程 RUNNABLE + CPU 800% → 8 个线程各占 1 核做纯计算
- 如果有 200 个线程 RUNNABLE + CPU 800% → 大量线程在等待 CPU 调度,实际的 CPU 消耗可能集中在少数线程上
- 如果有 200 个线程 RUNNABLE + CPU 200% → 大量线程处于 RUNNABLE 但等待调度状态,实际只有 2 个核在工作
排查时应该关注 top -H 中 %CPU 列最高的那几个线程,而非被 RUNNABLE 线程的数量吓到。
Q4:你如何判断 CPU 飙高是 GC 导致的还是业务代码导致的?不用任何 profiler 工具,只用 jstack 和 jstat 能做到吗?
点击查看解析
可以。分三步:
第一步(jstat):jstat -gcutil <pid> 1000 5。如果 YGC 频率 > 10 次/秒,或 FGC 次数在增长,GC 大概率是主因。
第二步(top -H):观察 CPU 最高的线程名称。如果是 "GC task thread"、"G1 Concurrent"、"G1 Young" 等,直接确认是 GC。
第三步(jstack 交叉验证):如果 jstack 中大量线程是 RUNNABLE 且在做业务逻辑,但 CPU 最高的线程是 GC 线程,说明 GC 占用了 CPU 资源但业务线程也在跑——此时 GC 是主因。如果 CPU 最高的线程全部是业务线程,且 jstat 显示 GC 正常(YGCT/FGCT 占比低),则根因在业务代码。
边界情况:业务代码产生大量对象 → Eden 区频繁打满 → YGC 高频 → GC 线程消耗 CPU → 看起来是 GC 问题,但根因在业务代码。这种情况下,需要结合 jstat 的 Eden 区使用率变化速度和 async-profiler 的内存分配采样来区分。
Q5:如果服务在容器中运行,CPU 配额被限制为 2 核,但你的 JVM 使用了默认的 GC 线程数(Parallel GC 默认 = CPU 核数,即宿主机的 8 核),会有什么问题?
点击查看解析
这是一个典型的容器环境 JVM 参数适配问题。如果 JVM 没有正确感知 cgroup 限制:
- GC 线程数过多:JVM 认为有 8 个核,启动 8 个 GC 线程。但容器只有 2 核配额,8 个 GC 线程争抢 2 个核,上下文切换开销巨大,GC 效率反而更低。
- CPU 限流(throttling):GC 线程 + 业务线程的总 CPU 需求远超 2 核配额,触发 cgroup 的 CPU 限流,进程被周期性暂停,RT 出现锯齿状抖动。
- Runtime.getRuntime().availableProcessors() 返回 8:这会影响所有基于此值的参数默认值,包括 ForkJoinPool 的并行度、线程池大小等。
解决方案:
- Java 8u191+ / Java 11+:
-XX:+UseContainerSupport(默认开启),JVM 会自动感知 cgroup 限制 - 或者显式指定:
-XX:ActiveProcessorCount=2 - 或者调整 GC 线程数:
-XX:ParallelGCThreads=2 -XX:ConcGCThreads=1
本文是「Java 技术专家与架构师面试:250 个高频考点总览」系列第 217 篇。