阅读时间:约 45 分钟 适用人群:Java 高级工程师、技术专家、架构师 前置知识:性能指标体系(214)、JVM 原理、并发编程基础
一、问题定义:为什么压测不是"跑一下 JMeter"?
很多工程师对压测的理解停留在"写个脚本、跑一下、看 QPS 多少"。但真正的压测是一门系统工程——它回答的是:"系统在各种负载下能不能扛住?扛不住的时候,瓶颈在哪里?"
压测出问题的案例比比皆是:
- 模型失真:线上 90% 是读请求,压测脚本全是写,结果测出来的瓶颈跟线上完全不搭边
- 数据失真:压测用了 100 条数据跑 10000 QPS,缓存命中率 100%,上线后数据库直接被打穿
- 预热缺失:JVM 还没完成 JIT 编译就开始计量,结果比实际偏高 30%
- 拐点误判:把 QPS 还在涨但 RT 已经开始劣化的点当成"还能扛",上线后雪崩
这些问题都指向同一个结论:压测的方法论,比压测工具更重要。 工具只是执行器,方法论决定你能不能用正确的姿势问出正确的问题。
二、核心原理:压测的本质是什么?
压测的本质是在受控条件下,对系统施加可量化的负载,观察系统的行为变化,建立负载与性能之间的映射关系。它不是一个简单的"发请求数结果"的过程,而是一个假设-验证-分析的循环:
- 假设:系统在 X QPS 下,P99 延迟不超过 Y ms
- 施加负载:用精确控制的流量模型向系统施加 X QPS
- 观察:记录实际的 P99 延迟、错误率、资源利用率
- 分析:如果 P99 > Y,定位瓶颈;如果 P99 < Y,继续加压找拐点
- 迭代:调整假设,重复上述过程
这个循环与科学实验方法完全一致,所以压测本质上是一种系统性能实验。
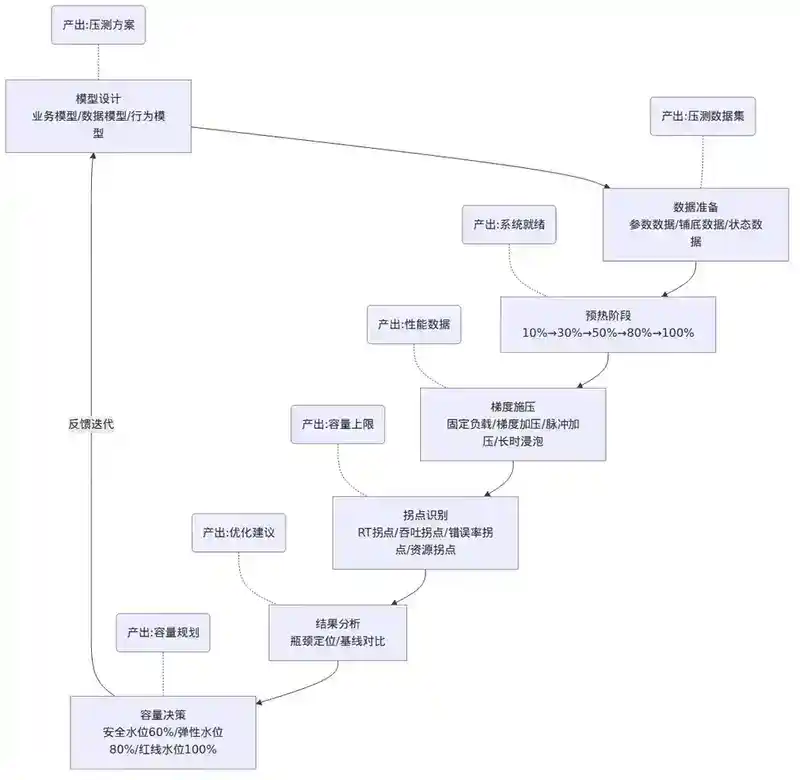
图1:压测方法论全景流程图——从模型设计到容量决策的完整闭环
三、压测模型设计:输入决定输出
3.1 流量模型的三层结构
一个好的压测模型必须回答三个问题:
| 层次 | 问题 | 错误做法 | 正确做法 |
|---|---|---|---|
| 业务模型 | 压什么接口?比例如何? | 所有接口平均分配 | 基于线上真实流量比例(如:查询 70%、下单 15%、支付 10%、退款 5%) |
| 数据模型 | 压什么数据?热点怎么处理? | 全部用同一组参数 | 模拟真实数据分布(参数化、热点 Key、冷热分离) |
| 行为模型 | 用户怎么操作?有依赖关系吗? | 只压单个接口 | 模拟真实业务流程(登录→浏览→加购→下单→支付) |
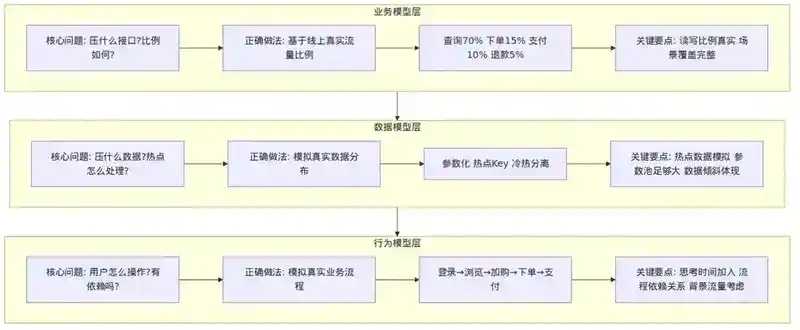
图2:压测流量模型三层结构——业务模型、数据模型、行为模型
3.2 流量模型的来源
- 线上流量回放(最准确):从网关或 Nginx 日志中抽取真实请求,按比例回放。GoReplay、Tcpcopy 等工具可以实现
- 业务方提供(次准确):让产品/运营给出各接口的预期调用比例
- 经验估算(参考):基于历史数据、业务特性估算,仅适用于新系统
3.3 模型设计的关键原则
原则一:读写比例要真实。 缓存命中率是压测结果的胜负手。读多写少的场景如果压测写成读少写多,数据库负载会被严重高估。
原则二:热点数据要模拟。 线上 20% 的数据承载 80% 的流量。如果压测数据均匀分布,热点效应被抹平,测出来的结果比实际乐观。
原则三:思考时间要加入。 真实用户不会无间隔地连续发请求。"思考时间"(Think Time)的平均值和分布直接影响并发数计算。
原则四:背景流量要考虑。 压测单一接口时,线上其他接口仍在消耗资源。如果压测环境没有背景流量,测出来的容量会偏高。
四、数据准备:压测的"弹药"
4.1 数据准备的三个维度
- 参数数据:请求参数从哪里来?需要参数化到什么程度?
- 静态参数:固定值,如固定 userId
- 动态参数:从数据池中随机/顺序取,如不同 userId
- 构造参数:根据规则生成,如不同订单号、不同金额
- 铺底数据:数据库里有多少数据?
- 线上有 5000 万订单,压测环境只有 1000 条,索引选择性完全不同
- 铺底量 = 线上数据量 × 等比缩放系数(至少保持索引层级结构一致)
- 状态数据:需要哪些前置状态?
- 登录态(Token、Session)
- 库存状态(下单前库存必须充足)
- 账户余额(支付前余额必须足够)
4.2 数据准备方式对比
| 方式 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 脱敏生产数据 | 铺底数据 | 最接近真实分布 | 数据量大、脱敏成本高、有安全风险 |
| 脚本构造 | 参数数据 | 灵活可控 | 难以模拟真实分布 |
| 影子库 | 全链路压测 | 与线上隔离、真实分布 | 需要中间件支持流量染色 |
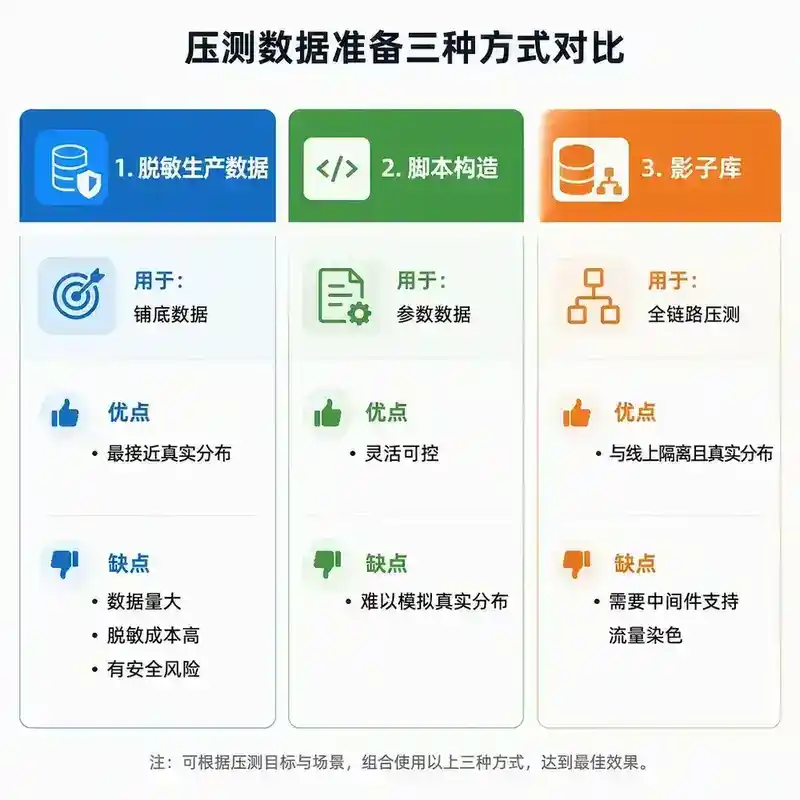
图3:压测数据准备三种方式对比——脱敏生产数据、脚本构造、影子库
4.3 数据准备常见陷阱
- 参数池太小:100 个 userId 循环使用,缓存 100% 命中,数据库压力为零
- 数据倾斜未模拟:线上 1% 商户承担 80% 交易量,压测未体现这种倾斜
- 时间敏感性数据:券过期、活动时间、Token 过期等,压测时需要动态刷新
五、预热阶段:给系统一个"热身"的机会
5.1 为什么需要预热?
Java 系统尤其需要预热,原因有三:
- JIT 编译:JVM 默认使用混合模式(-Xmixed),热点代码在运行一段时间后才被 C2 编译器优化为机器码。预热期间代码在解释执行或 C1 编译阶段,性能偏低
- 类加载:首次访问某些类时会触发类加载,包含验证、准备、解析等步骤
- 连接池与缓存:数据库连接池、Redis 连接池、HTTP 连接池在启动时尚未建立连接;本地缓存为空
5.2 预热策略
- 梯度加压:从 10% → 30% → 50% → 80% → 100% 目标 QPS,每阶段持续 3-5 分钟
- 观察指标:预热期间关注 RT 是否逐渐下降并趋于稳定;CPU 使用率是否稳定
- 预热判定:当 RT 和 CPU 在连续 2 分钟内波动不超过 ±5%,认为预热完成
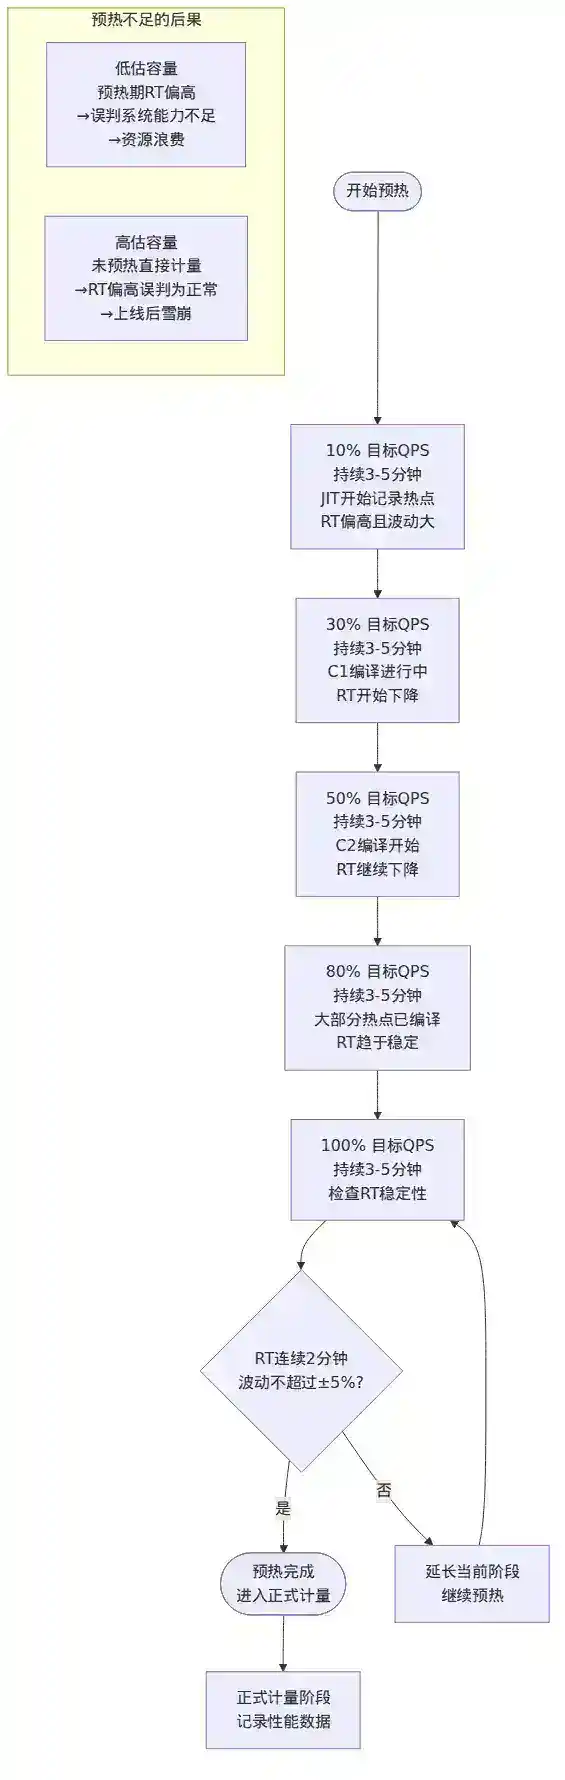
图4:预热阶段梯度加压流程——10%→100%目标QPS,每阶段JIT编译状态与RT变化趋势
5.3 预热不足的典型表现
- 前 10 分钟 QPS 偏低、RT 偏高,半小时后 QPS 上升 20%-30%
- 如果直接按预热期数据下结论,会低估系统容量,导致上线后资源浪费
- 反之,如果没有预热就把性能数据当稳态数据,会高估系统容量,导致上线后雪崩
六、稳态施压:找到系统的真实能力
6.1 什么是稳态?
稳态不是"RT 不波动"——真实系统 RT 永远在波动。稳态是指在固定负载下,吞吐量、响应时间、资源利用率、错误率四个核心指标都在一个可接受的范围内波动,没有趋势性变化。
判断稳态的条件:
- RT 的 P50/P99 在 ±10% 内波动,没有持续上升趋势
- 错误率不变(或为零)
- CPU/内存/磁盘 IO 等资源利用率稳定
- GC 频率和停顿时间稳定
6.2 施压策略
| 策略 | 做法 | 适用场景 |
|---|---|---|
| 固定负载 | 持续施加固定 QPS,观察系统行为 | 验收测试、容量确认 |
| 梯度加压 | 逐步增加 QPS,每梯度稳定后记录 | 容量探测、找性能拐点 |
| 脉冲加压 | 短时间内施加极高负载,然后恢复正常 | 弹性测试、削峰能力验证 |
| 长时浸泡 | 以中等负载持续运行数小时 | 内存泄漏、连接泄漏、GC 稳定性 |
6.3 施压时长
- 常规压测:每个梯度至少 10-15 分钟
- 长时浸泡:至少 2-4 小时
- 关键原因:GC 周期可能长达几分钟,短时间施压可能错过 Full GC 导致的问题;内存泄漏需要时间累积
七、拐点分析:系统的"临界点"在哪里?
7.1 什么是拐点?
拐点是系统性能特征发生质变的点。最常见的拐点出现在利用率与响应时间的关系曲线上。
根据排队论(M/M/1 模型),响应时间与利用率的关系为:
$R = \frac{S}{1 - \rho}$
其中 $R$ 是响应时间,$S$ 是服务时间,$\rho$ 是利用率。
当 $\rho$ 从 50% 升到 80% 时,$R$ 只增加 2.5 倍;但从 80% 升到 95% 时,$R$ 增加 4 倍。这个非线性关系决定了拐点通常在利用率 70%-85% 之间。
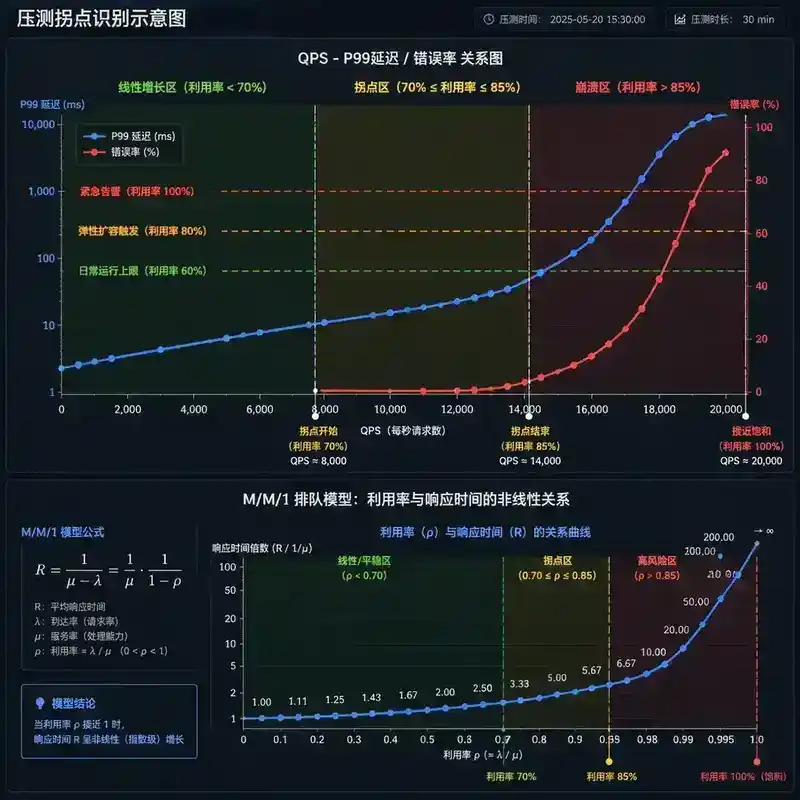
图5:压测拐点识别——QPS-RT双轴曲线,线性增长区、拐点区、崩溃区,副图为M/M/1排队模型
7.2 拐点识别方法
- RT 拐点:QPS 继续增加但 RT 的 P99 开始指数级增长
- 吞吐拐点:继续加压但 QPS 不再增长(甚至下降)——说明系统达到饱和
- 错误率拐点:错误率从 0 开始出现并持续增长(超时、拒绝连接、连接池耗尽)
- 资源拐点:某个资源(CPU/内存/连接数/线程数)达到瓶颈
拐点出现顺序通常是:RT 劣化 → 吞吐饱和 → 错误率上升 → 系统崩溃
7.3 拐点决策
- 安全水位:拐点 QPS 的 60%-70% 作为日常运行容量上限
- 弹性水位:拐点 QPS 的 80%-90% 配合弹性扩容使用
- 红线水位:拐点 QPS 本身,触发告警和紧急扩容
八、结果分析:从数据到洞察
8.1 压测报告的核心指标
| 维度 | 指标 | 说明 |
|---|---|---|
| 吞吐 | QPS/TPS | 每秒处理请求数/事务数 |
| 延迟 | Avg / P50 / P95 / P99 / P999 | 响应时间分布 |
| 错误 | 错误率、错误类型分布 | 区分业务错误和系统错误 |
| 资源 | CPU / 内存 / 磁盘 IO / 网络 | 各资源利用率 |
| 饱和 | 线程池队列长度、连接池等待数 | 资源饱和程度 |
| GC | GC 频率、停顿时间、回收量 | JVM 内存行为 |
8.2 瓶颈定位方法
当压测结果不理想时,按以下顺序排查:
- 先看错误:有错误先看错误日志,错误类型直接指向问题
- 再看资源:哪个资源利用率接近 100%?
- CPU 高 → 热点代码、GC 频繁
- 内存高 → 内存泄漏、缓存过大
- IO 高 → 磁盘瓶颈、日志过多
- 网络高 → 带宽瓶颈
- 再看饱和:线程池队列满?连接池耗尽?
- 最后看代码:Arthas profiler、火焰图定位热点方法
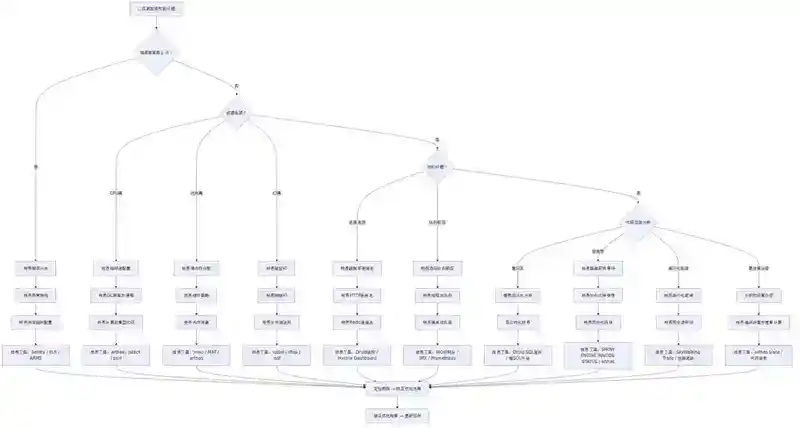
图6:压测瓶颈定位决策树——错误→资源→饱和→代码四层排查流程
8.3 压测报告常见误区
- 只看平均值:平均值掩盖了长尾延迟,P99 才是用户体验的关键
- 忽略错误率:QPS 高但错误率 5%,等于没测
- 不对比基线:没有历史基线对比,不知道这次是变好还是变差
- 不给出建议:报告只给数据不给结论,等于白做
九、生产实践:压测的工程化落地
9.1 压测环境选择
| 环境 | 适用场景 | 注意事项 |
|---|---|---|
| 独立压测环境 | 单服务容量探测 | 资源配置需与线上一致,否则结论无意义 |
| 线上环境(低峰) | 验证真实容量 | 必须在低峰期、有熔断兜底、数据隔离 |
| 全链路压测环境 | 端到端容量评估 | 需要流量染色、影子库表、中间件改造 |
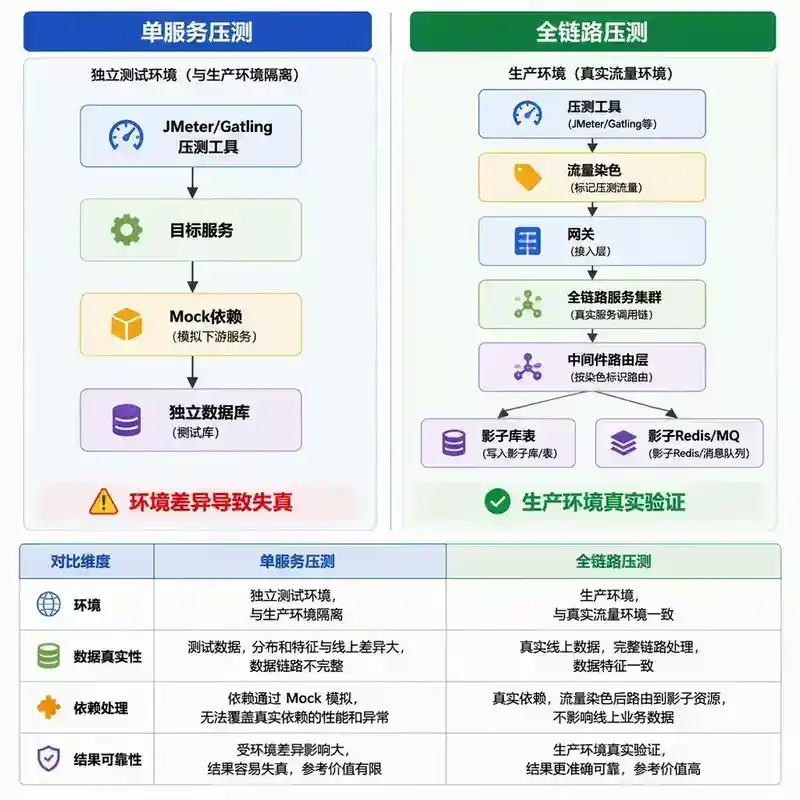
图7:全链路压测与单服务压测架构对比——左侧单服务压测,右侧全链路压测
9.2 压测安全规范
- 必须有熔断机制:错误率超过阈值自动停止压测
- 必须有回滚方案:压测导致问题时能快速恢复
- 必须通知相关方:DBA、运维、相关业务方提前知晓
- 必须数据隔离:压测数据不能污染线上业务数据
9.3 压测频率
- 大促前:全链路压测,找到系统容量瓶颈
- 架构变更后:核心链路压测,验证变更没有引入性能退化
- 定期:每月一次核心链路巡检压测
- 上线前:关键接口冒烟压测
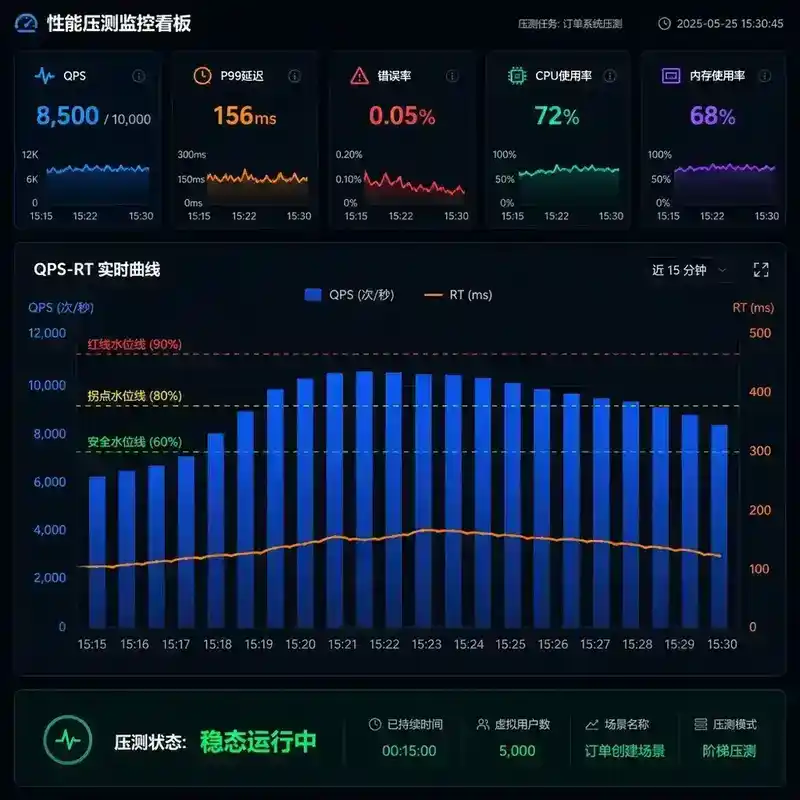
图8:压测决策仪表盘——核心指标实时展示,安全水位线、拐点水位线、红线水位线
十、常见陷阱与故障案例
陷阱 1:压测工具成为瓶颈
现象:QPS 上不去,压测发起端 CPU 100% 原因:单台压测机能力有限,或 JMeter 的 GUI 模式消耗大量资源 解决:分布式压测(多台压测机)、使用非 GUI 模式、选用高性能压测工具(如 wrk、vegeta)
陷阱 2:连接数耗尽
现象:压测到一半突然大量超时 原因:压测端或服务端连接数达到上限,TIME_WAIT 堆积 解决:调整系统参数(net.ipv4.tcp_tw_reuse、net.ipv4.ip_local_port_range)、使用长连接
陷阱 3:缓存"假象"
现象:压测结果很好,上线后数据库被打穿 原因:压测数据量小,缓存命中率 100%;上线后真实数据量大,缓存命中率骤降 解决:铺底数据量要足够大,模拟真实缓存命中率
案例:某电商大促压测翻车
某电商平台在大促前压测,核心交易链路 QPS 达到 5000,P99 延迟 200ms,一切正常。大促当天流量到达 3000 QPS 时,系统开始大面积超时。
复盘发现两个问题:
- 预热不充分:压测在启动后 30 分钟才开始计量,JIT 已充分优化;大促当天流量瞬间涌入,JIT 编译尚未完成
- 数据量差异:压测环境数据库 100 万订单,线上 2 亿订单,索引 B+Tree 层数多一层,单次查询多一次磁盘 IO
十一、面试追问与参考答案
以下问题从面试官视角设计,重点考察对压测方法论的深度理解,而非简单记忆。
Q1:压测时发现 QPS 还在增长,但 P99 延迟已经涨了 3 倍,你会继续加压吗?为什么?
参考答案:不应该继续加压。QPS 增长但 P99 暴涨,说明系统已经进入拐点区域。根据排队论,利用率已经超过 80%,响应时间呈指数增长。此时继续加压不会得到有意义的容量数据,反而可能触发雪崩。正确的做法是:记录当前 QPS 作为拐点,分析 P99 劣化的根因(是哪个资源成为瓶颈),然后按拐点 QPS 的 60%-70% 设定安全水位。
Q2:压测环境和线上环境的硬件配置相同,但压测数据只有 10 万条,线上有 5000 万条。你觉得压测结果能代表线上真实容量吗?为什么?
参考答案:不能。数据量差异直接影响三个层面:① 索引效率——5000 万数据的 B+Tree 可能比 10 万数据多 2-3 层,每次索引查找多 2-3 次磁盘 IO;② 缓存命中率——10 万数据可能全部缓存,5000 万数据缓存命中率可能只有 80%;③ 数据库连接池竞争——真实数据量下查询耗时更长,连接占用时间更长,连接池更容易耗尽。正确的做法是等比缩放铺底数据,或用影子库直接使用生产数据。
Q3:你们公司的压测是在独立环境做还是线上做?各有什么利弊?
参考答案:独立环境的优势是安全、不影响线上,劣势是环境差异导致结论不准;线上的优势是结果最真实,劣势是风险高。最佳实践是分层压测:日常在独立环境做单服务容量探测和回归压测,大促前在线上低峰期做全链路压测验证真实容量。线上压测必须做到:流量染色、数据隔离(影子库/影子表)、熔断兜底、低峰期执行。
Q4:如何判断 JVM 预热已经完成?有哪些量化指标?
参考答案:三个量化指标:① RT 稳定——连续 5 分钟内 P99 延迟波动不超过 ±5%;② 编译线程活动——通过 jstat -compiler 查看编译任务数,当编译任务数降到接近 0 时说明热点代码已编译完成;③ CodeCache 使用率——CodeCache 使用率趋于稳定,不再快速增长。实践中通常以 RT 稳定为主要判断依据,辅以编译活动指标。
Q5:给你一个从未压测过的系统,你如何设计第一次压测方案?
参考答案:按以下步骤:① 先了解业务——搞清楚核心接口、流量比例、读写比例;② 确定目标——是想知道"最大容量"还是"当前水位是否安全";③ 设计流量模型——基于业务方提供的数据或线上日志分析;④ 准备数据——铺底数据量尽可能接近线上;⑤ 梯度加压——从低 QPS 开始,每梯度 10 分钟,观察 RT/错误率/资源利用率;⑥ 找到拐点后停止——不要盲目追求极限 QPS;⑦ 输出报告——给出安全水位、拐点、瓶颈分析和优化建议。
十二、延伸阅读
-
《Systems Performance: Enterprise and the Cloud》— Brendan Gregg,第 6-7 章
-
《高性能 MySQL》第 3 版,第 3 章(基准测试)
-
Little's Law 在性能工程中的应用:$L = \lambda \times W$
-
JMH(Java Microbenchmark Harness)——JVM 微基准测试的正确姿势
-
阿里云 PTS(Performance Testing Service)文档