一、为什么 GC 日志比监控面板更重要
监控面板告诉你"GC 花了多少时间",但 GC 日志告诉你"GC 为什么花了这么多时间"。当你看到 Full GC 告警时,监控面板只能告诉你暂停了 2 秒,而 GC 日志能告诉你暂停是因为晋升失败(Promotion Failed)、并发模式失败(Concurrent Mode Failure)、还是单纯的堆空间不足——每种原因的修复方案完全不同。
本文以 JDK 9+ 统一日志框架(-Xlog:gc*)为主线,覆盖 G1 和 CMS 两种最常用的收集器。目标是让你能逐行解读 GC 日志,从日志中提取停顿时间、吞吐量、晋升速率和分配速率四个核心指标,并建立"日志异常 -> 根因判断 -> 参数调优"的完整链路。
二、统一日志框架:从 -XX:+PrintGCDetails 到 -Xlog:gc*
2.1 新旧对比
JDK 8 及之前使用 -XX:+PrintGCDetails -XX:+PrintGCDateStamps。JDK 9+ 统一为 -Xlog 框架:
# 基础 GC 日志(等同于老式的 PrintGCDetails)

- Xlog:gc*=info:file=gc.log:time,level,tags:filecount=10,filesize=100M


# 各部分含义:
# gc*           -> 所有 GC 相关的 tag
# =info         -> 日志级别为 info 及以上
# :file=gc.log  -> 输出到文件
# :time,level,tags -> 装饰器:时间、级别、标签
# :filecount=10,filesize=100M -> 滚动:10 个文件,每个最大 100M
2.2 常用日志级别
- Xlog:gc*=debug   # 最详细(包含每次 GC 的详细操作)


- Xlog:gc*=info    # 推荐:包含关键信息,不冗余


- Xlog:gc+heap=info  # 只看堆变化


- Xlog:gc+age=trace  # 只看年龄分布(调优晋升阈值时用)
2.3 生产环境推荐配置
- Xlog:gc*=info:file=/data/logs/gc-%t.log:time,level,tags:filecount=20,filesize=50M
这个配置在 99% 的场景下够用,日志大小可控,信息完整。
三、G1 GC 日志逐行解读
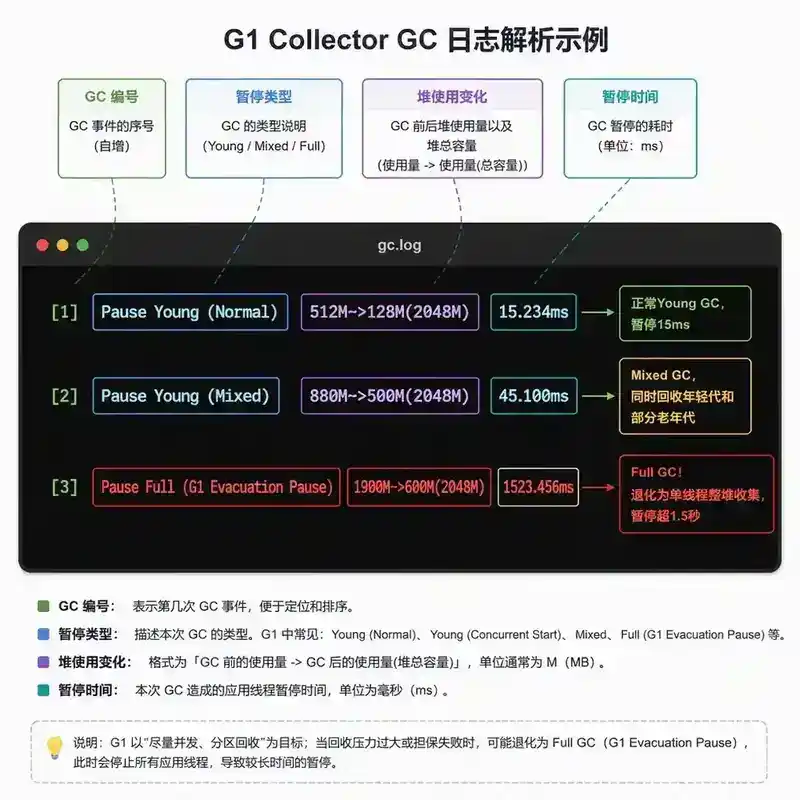
3.1 年轻代收集(Young GC)
[12.345s][info][gc] GC(42) Pause Young (Normal) (G1 Evacuation Pause) 512M->128M(2048M) 15.234ms
[12.346s][info][gc,cpu] GC(42) User=0.02s Sys=0.00s Real=0.02s
逐字段解读:
| 字段 | 含义 |
|---|---|
| 12.345s | JVM 启动后的时间 |
| GC(42) | 第 42 次 GC |
| Pause Young (Normal) | 年轻代收集,Normal 类型 |
| 512M->128M(2048M) | 堆使用量:GC 前 512M -> GC 后 128M(总容量 2048M) |
| 15.234ms | 暂停时间(STW) |
| User=0.02s | CPU 用户态时间 |
| Real=0.02s | 实际挂钟时间 |
3.2 并发标记周期
[45.678s][info][gc] GC(58) Pause Young (Concurrent Start) (G1 Humongous Allocation) 800M->300M(2048M) 25.100ms
[46.000s][info][gc] GC(58) Concurrent Cycle
[46.100s][info][gc,marking] GC(58) Concurrent Mark From Roots
[46.500s][info][gc,marking] GC(58) Concurrent Mark From Roots 400.123ms
[46.800s][info][gc,marking] GC(58) Concurrent Preclean
[47.000s][info][gc,marking] GC(58) Concurrent Preclean 200.456ms
[47.100s][info][gc] GC(58) Pause Remark 100M->90M(2048M) 5.234ms
[47.200s][info][gc] GC(58) Pause Cleanup 90M->80M(2048M) 3.100ms
[47.300s][info][gc] GC(58) Concurrent Cleanup
[47.800s][info][gc] GC(58) Concurrent Cleanup 500.789ms
[47.900s][info][gc] GC(58) Concurrent Cycle 1900.123ms
关键点:Concurrent Start 的触发原因是 G1 Humongous Allocation,说明有大对象分配触发了并发标记周期。如果频繁看到这个 trigger,需要检查代码中是否有大量大对象分配。
[图4:G1 并发标记周期时序图——展示各阶段时间线,标注STW阶段和非STW阶段]
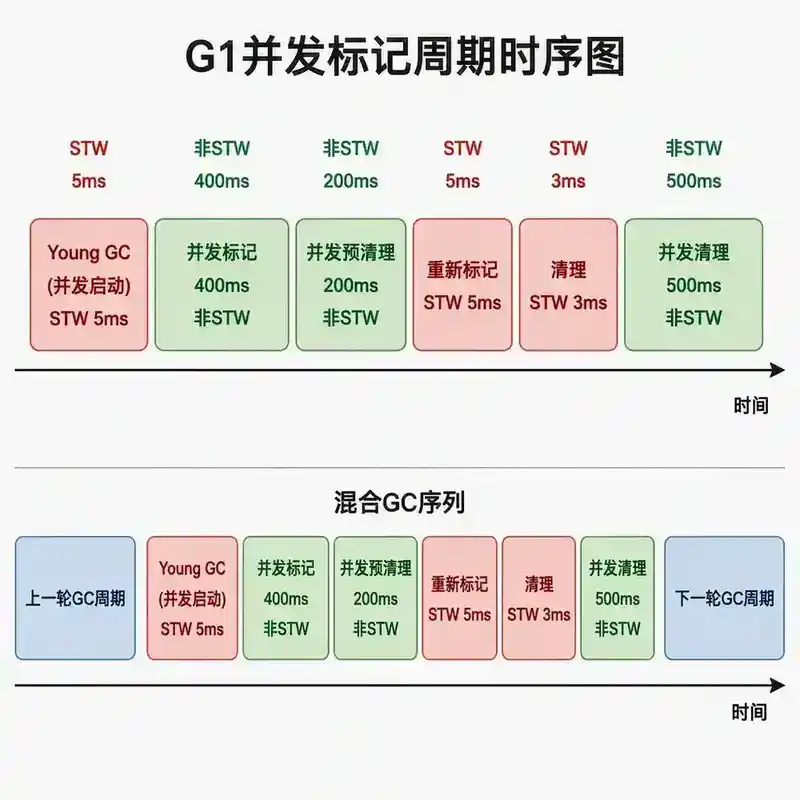
3.3 Mixed GC
[89.012s][info][gc] GC(75) Pause Young (Prepare Mixed) (G1 Evacuation Pause) 900M->400M(2048M) 35.100ms
[90.000s][info][gc] GC(76) Pause Young (Mixed) (G1 Evacuation Pause) 880M->500M(2048M) 45.234ms
[91.000s][info][gc] GC(77) Pause Young (Mixed) (G1 Evacuation Pause) 860M->550M(2048M) 42.100ms
Mixed GC 同时回收年轻代和部分老年代 Region。注意暂停时间从 35ms 到 45ms——接近 G1 的 MaxGCPauseMillis 目标(默认 200ms)。
3.4 Full GC(退化回退)
[120.000s][info][gc] GC(89) Pause Full (G1 Evacuation Pause) 1900M->600M(2048M) 1523.456ms
这是 G1 用户最不想看到的一行——Pause Full 意味着 G1 的增量回收失败,退化为单线程整堆收集。暂停时间从通常的几十毫秒跳到 1.5 秒,是业务感知的典型故障点。
[图1:G1 GC日志标注解读图——Young GC/Mixed GC/Full GC三行对比,彩色标注关键字段,红色高亮Full GC]
四、CMS GC 日志逐行解读
4.1 CMS 的六个阶段
# 初始标记(STW,短)
[GC (CMS Initial Mark) [1 CMS-initial-mark: 500M(1000M)] 600M(2000M), 0.0123456 secs]

# 并发标记(不 STW)
[CMS-concurrent-mark-start]
[CMS-concurrent-mark: 1.234/1.234 secs]

# 并发预清理(不 STW)
[CMS-concurrent-preclean-start]
[CMS-concurrent-preclean: 0.123/0.123 secs]

# 重新标记(STW,比初始标记长)
[GC (CMS Final Remark) [YG occupancy: 100M (500M)] 550M(2000M), 0.0456789 secs]

# 并发清理(不 STW)
[CMS-concurrent-sweep-start]
[CMS-concurrent-sweep: 2.345/2.345 secs]

# 并发重置(不 STW)
[CMS-concurrent-reset-start]
[CMS-concurrent-reset: 0.012/0.012 secs]
[图5:CMS GC 六个阶段流程图——标注各阶段是否STW和典型耗时]
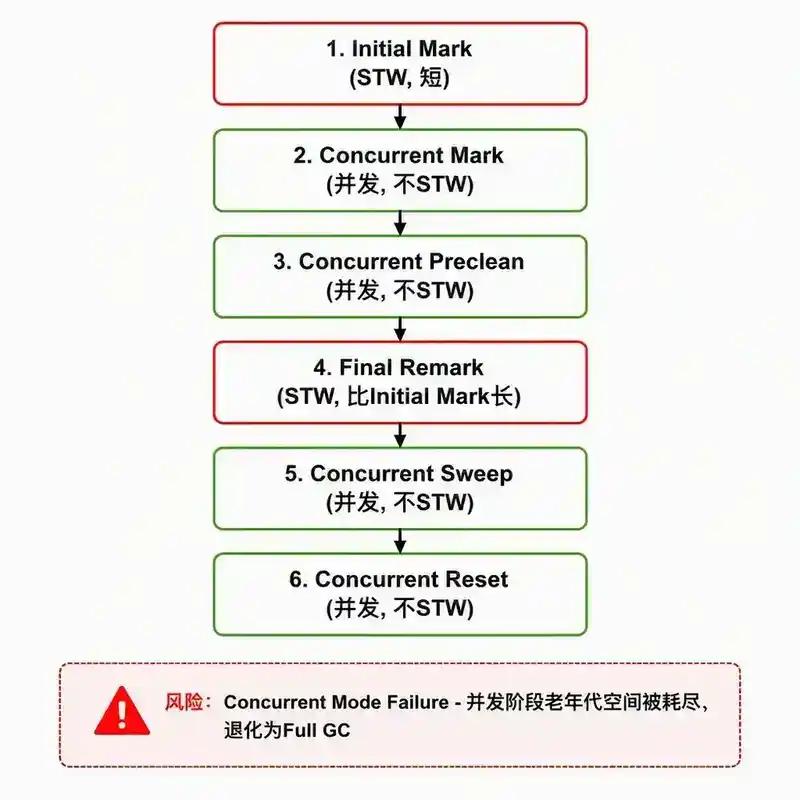
4.2 CMS 的致命问题:Concurrent Mode Failure
[CMS-concurrent-mark: 1.500/5.000 secs]
[GC (Allocation Failure) ...]
[Full GC (Allocation Failure) 1800M->600M(2000M), 3.4567890 secs]
如果在并发标记/清理过程中,老年代空间被新晋升的对象耗尽,CMS 会退化为单线程 Full GC。关键信号:并发标记的时间(1.5s)远小于预期完成时间(5.0s),说明被提前中断了——因为老年代空间不足。
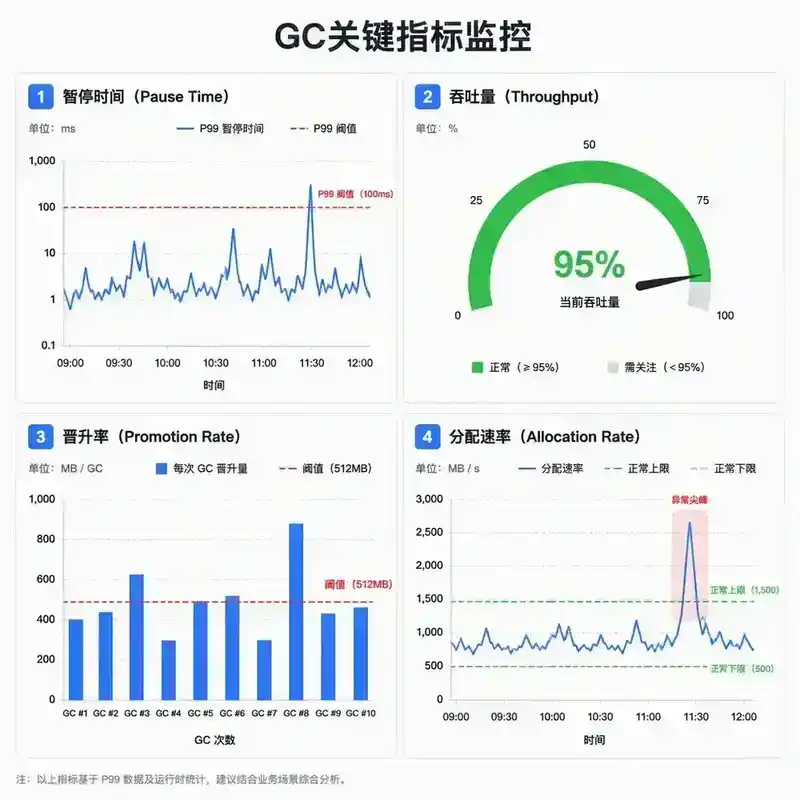
五、四个核心指标:从日志中提取
5.1 停顿时间(Pause Time)
# 提取所有 GC 暂停时间
grep "Pause" gc.log | awk '{print $NF}' | sed 's/ms//'

# 计算 P99 暂停时间
grep "Pause" gc.log | awk '{print $NF}' | sed 's/ms//' | sort -n | awk '{all[NR]=$1} END{print all[int(NR*0.99)]}'
关注点:最大暂停时间、P99 暂停时间、暂停时间超过 MaxGCPauseMillis 的次数。
5.2 吞吐量(Throughput)
吞吐量 = (运行时间 - GC总耗时) / 运行时间。从 GC 日志中提取 GC 总耗时:
grep "Pause" gc.log | awk '{sum+=$NF} END{print sum "ms"}'
如果 GC 总耗时超过运行时间的 5%,说明 GC 压力过大,需要调优。
5.3 晋升速率(Promotion Rate)
晋升速率 = 每次 Minor GC 后老年代使用量的增量。在 GC 日志中开启 gc+age=trace 可以看每个年龄段的晋升量:
- Xlog:gc+age=trace:file=gc-age.log
日志中会出现 Desired survivor size 和 age 1: 5123456 bytes 等信息,直接反映各年龄段的晋升量。
5.4 分配速率(Allocation Rate)
分配速率 = 两次 GC 之间的对象分配量 / 间隔时间。在 G1 日志中,两次 Young GC 之间堆使用量的增加就是这段时间的分配量。
jstat -gc <pid> 1000 | awk '{print "Alloc rate:", ($3-$8)/1024, "MB/s"}'
如果分配速率突然飙升,说明有接口在大量创建对象,需要排查代码。
[图2:GC关键指标仪表盘——停顿时间/吞吐量/晋升速率/分配速率四个面板]
六、GC 日志分析实战:三个典型场景
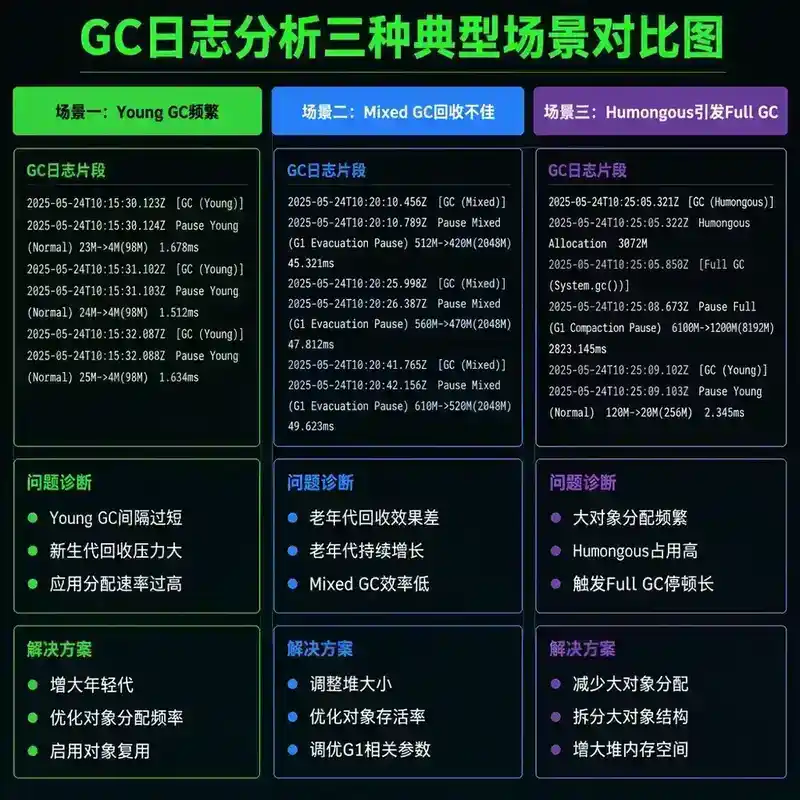
6.1 场景一:Young GC 频繁但停顿时间短
日志特征:GC(100) Pause Young 15ms, GC(101) Pause Young 12ms(间隔仅 2 秒)。诊断:Young GC 间隔太短,说明分配速率高或 Eden 太小。解决:增大年轻代(-Xmn 或 -XX:NewRatio),或检查代码中是否有不必要的对象分配。
6.2 场景二:Mixed GC 后老年代回收不明显
日志特征:Mixed GC 每次只回收 50M。诊断:老年代中大部分对象是长期存活的,或者 G1 的 G1MixedGCLiveThresholdPercent(默认 85%)设置过高。解决:适当降低阈值(如 65%),或增加 G1MixedGCCountTarget。
6.3 场景三:Full GC 前有大量 Humongous Allocation
日志特征:大量 Humongous Allocation 触发后出现 Pause Full。诊断:大对象导致碎片化,找不到连续 Region。解决:从代码层面减少大对象分配;或增大 G1 Region 大小(-XX:G1HeapRegionSize)。
[图3:GC日志分析三种场景对比图——每列含日志片段、诊断结论、解决方案]
七、GC 日志工具链
7.1 在线分析工具
- GCEasy(https://gceasy.io):上传 GC 日志,自动生成可视化报告,包含停顿时间分布、吞吐量、GC 原因分析、调优建议。
- GCViewer:本地 GUI 工具,可以打开 GC 日志文件,查看 GC 事件的时序图和统计信息。
7.2 命令行分析
# 统计 GC 暂停次数和总时间
grep "Pause" gc.log | wc -l
grep "Pause" gc.log | awk '{sum+=$NF} END{print "Total pause:", sum, "ms"}'

# 统计 Full GC 次数
grep "Pause Full" gc.log | wc -l

# 查看每次 GC 的堆使用变化
grep "Pause" gc.log | grep -oP '\d+M->\d+M\(\d+M\)'

# 查看 GC 触发原因
grep "Pause" gc.log | grep -oP '\(G1 [^)]+\)' | sort | uniq -c | sort -rn
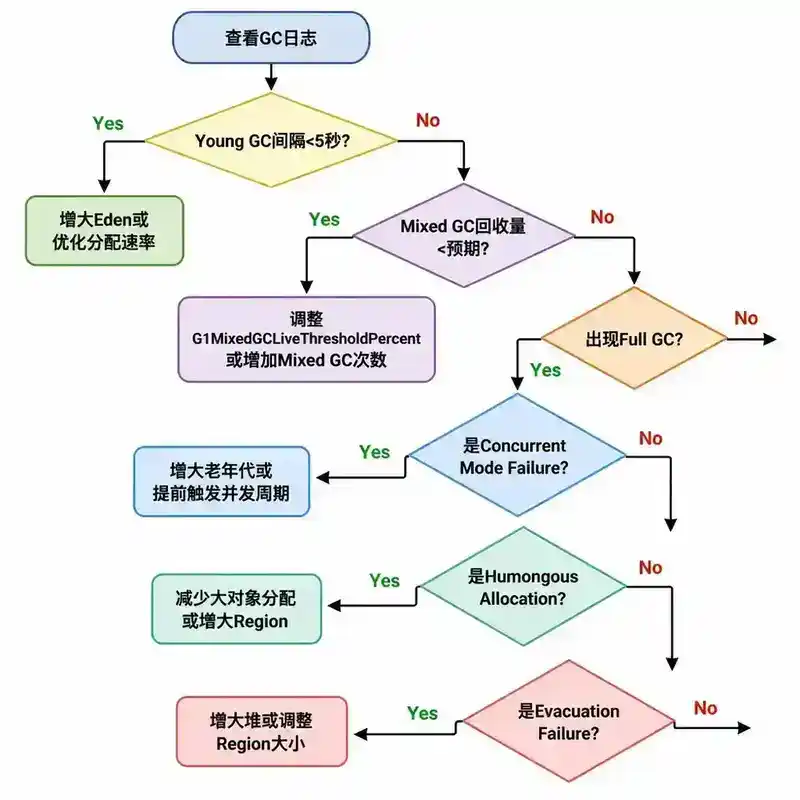
[图6:GC日志分析决策树——从查看GC日志出发,判断Young GC问题还是Mixed/Full GC问题,分支到不同诊断路径]
八、面试常见误区
- "GC 日志只看出 Full GC" —— 不对。Young GC 的频率和暂停时间同样重要,Mixed GC 的回收效率直接影响老年代使用率。
- "吞吐量 99% 就是好的" —— 不完全。吞吐量高但 P99 暂停时间超过 SLA 阈值,对用户体验仍然有影响。
- "GC 日志里看到 Promotion Failed 就是参数配错了" —— 可能是代码问题。Promotion Failed 可能是 Survivor 太小,也可能是某次请求产生了大量长生命周期对象。
- "G1 的日志里从来没看到 Full GC,所以不需要关心" —— 不对。如果 Mixed GC 的回收效率持续下降,Full GC 只是时间问题。
九、总结
GC 日志分析的核心链路:
- 开启日志:-Xlog:gc*=info:file=gc.log(生产环境标配)
- 提取四个指标:停顿时间、吞吐量、晋升速率、分配速率
- 分析异常模式:Young GC 频繁?Mixed GC 回收不佳?Full GC 退化?
- 定位根因:从 GC 触发原因追溯到具体的问题类型
- 针对性修复:代码优化 -> 参数调优 -> 容量扩容
记住:GC 日志不是用来"看"的,是用来"问"的。每一行日志都在回答一个问题:这次 GC 为什么发生?花了多少时间?回收了多少?下一步该做什么?
延伸阅读
- Oracle 官方文档:JVM Unified Logging Framework
- GCEasy 在线分析:https://gceasy.io
- 本系列相关篇目:060(G1 收集器)、062(Minor/Major/Full GC)、066(JVM 常用诊断工具)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 GC 日志分析的实战经验和深度理解。
Q1:你在 G1 GC 日志中看到每次 Young GC 后堆从 2G 降到 800M,但老年代从 600M 涨到 650M。这正常吗?如果不正常,你会怎么排查?
每次 Young GC 后老年代增长 50M 是晋升的正常表现,但需要判断这个速率是否合理。我会:1)看 Young GC 的间隔时间——如果间隔 30 秒,晋升速率约 1.6MB/s,对大多数应用来说正常;如果间隔 2 秒,晋升速率 25MB/s,说明有大量对象过早晋升。2)开启 gc+age=trace 日志,看各年龄段的晋升量,判断是哪个年龄的对象在大量晋升。3)如果年龄 1-2 的对象就大量晋升,说明 Survivor 区太小,动态年龄判定过早触发。4)如果年龄 6-8 的对象晋升,说明对象生命周期确实长,是正常的。关键不是有没有晋升,而是晋升速率是否与业务特征匹配。
Q2:你在 GCEasy 上看到 GC 吞吐量 98%,但 P99 暂停时间 500ms。你的老板说"GC 没问题",你的用户说"偶尔卡一下"。谁是对的?怎么解决?
两个都对,但用户说了算。吞吐量 98% 代表 GC 总耗时占 2%,看似正常,但 P99 暂停 500ms 意味着每 100 次 GC 中有 1 次暂停超过 500ms——这 1% 的"长暂停"对用户体验的影响远超 99% 的"短暂停"。这是典型的"平均指标掩盖了长尾问题"。解决方案:1)在 G1 中调低 MaxGCPauseMillis(如从 200ms 降到 100ms),让 G1 更激进地控制单次暂停时间。2)检查是否有 Mixed GC 或 Full GC 导致了长暂停。3)如果长暂停来自 Humongous Allocation,从代码层面减少大对象分配。4)如果长暂停来自 Mixed GC 回收老年代时的一次性大回收,增加 G1MixedGCCountTarget 分散到多次 Mixed GC。
Q3:你在 GC 日志中看到 "To-space Overflow",这和 Promotion Failed 有什么不同?排查方向有什么差异?
To-space Overflow 发生在 G1 中,表示 Evacuation 时目标 Region 空间不足,对象无法复制过去。Promotion Failed 发生在 CMS/Parallel 中,表示 Survivor 空间不足且老年代也无法容纳晋升对象。差异:To-space Overflow 是 G1 特有的,通常意味着堆碎片化严重(找不到空闲 Region)或并发标记周期未完成导致空闲 Region 不足。排查方向:1)检查 G1ReservePercent(默认 10%),这部分预留空间是否被耗尽。2)检查并发标记周期是否能及时完成——如果标记周期太长,回收的 Region 来不及释放。3)检查是否有大量 Humongous Object 导致碎片化。Promotion Failed 的排查方向完全不同:主要看 Survivor 大小和晋升速率。
Q4:CMS 的 GC 日志中,你看到 Concurrent Mode Failure 后紧跟着一次 Full GC,暂停了 5 秒。但 CMS 的初衷是低延迟,为什么还会出现 5 秒的暂停?怎么避免?
CMS 的"低延迟"只适用于正常路径——并发标记和并发清理确实不 STW。但 Concurrent Mode Failure 是 CMS 的"退化路径":当并发清理速度跟不上晋升速度时,CMS 放弃并发收集,退化为 Serial Old 的单线程整堆收集,这就是那 5 秒暂停的来源。避免方案:1)让 CMS 更早地触发并发收集——调低 CMSInitiatingOccupancyFraction(默认 92%,降到 70-75%),给并发收集留出更多时间。2)增大老年代,让晋升速率相对变慢。3)如果始终无法避免,说明 CMS 的并发模型不适合你的晋升速率,考虑迁移到 G1。
Q5:你有一个服务,GC 日志中分配速率稳定在 200MB/s,晋升速率 5MB/s,Young GC 每 10 秒一次,Mixed GC 正常。但每周日晚上 8 点,分配速率突然飙到 2GB/s,持续 10 分钟,期间出现 3 次 Full GC。你怀疑是定时任务导致的,但开发说"没有定时任务"。你怎么在 GC 日志中找线索?
GC 日志本身不会告诉你"哪个业务操作导致的",但可以给你时间维度的精确线索。1)先看 GC 日志中分配速率飙升的精确时间(精确到秒),和业务监控(QPS、接口响应时间)交叉比对。2)在分配速率飙升前的最后一次 GC 日志中,看 GC 触发原因——如果是 G1 Humongous Allocation,说明有大量大对象分配,结合时间点看是否有报表导出、数据同步、缓存预热等操作。3)在 Arthas 中用 monitor 命令监控所有 Service 方法的调用频率,找出在对应时间段调用量突增的方法。4)如果确实没有 Java 层面的定时任务,检查是否有外部触发器——比如消息队列的积压消息在某个时间点被批量消费、定时健康检查触发了全量数据加载等。GC 日志是"果",业务日志是"因",两者结合才能定位根因。