一、内存泄漏不等于内存溢出
很多工程师把"内存泄漏"和"OutOfMemoryError"当作同义词,其实它们是因果关系:内存泄漏是导致 OOM 最常见的原因,但 OOM 也可能是单纯的容量不足。 内存泄漏的本质是"不再需要的对象,因为被 GC Roots 引用而无法回收"——GC 不是不想收,而是"不敢收",因为引用链上确实还有活着的引用。
本文的重点不是讲"什么是内存泄漏",而是讲怎么找到它。从获取堆转储到分析支配树,从追踪引用链到使用 MAT/JProfiler 定位代码,每一步都给出可操作的命令、截图级别的步骤描述和实战案例。
关键概念速览:
- 堆转储(Heap Dump):某一时刻 JVM 堆中所有对象的完整快照,包含对象实例、字段值、引用关系。
- 支配树(Dominator Tree):以"谁支配谁"的方式组织对象引用关系,核心指标是 Retained Heap——如果回收某个对象,能释放多少内存。
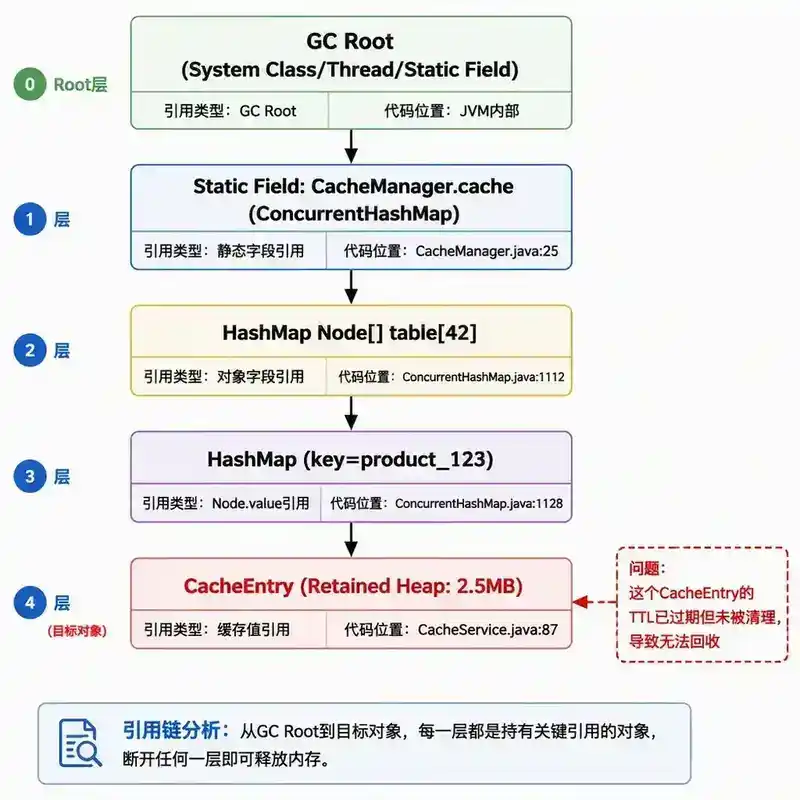
- 引用链(Path to GC Roots):从 GC Root 到目标对象的完整引用路径,直接告诉你"谁不让这个对象回收"。
- Shallow Heap vs Retained Heap:Shallow Heap 是对象本身占用的内存,Retained Heap 是回收该对象后能释放的总内存(包括它支配的所有子对象)。
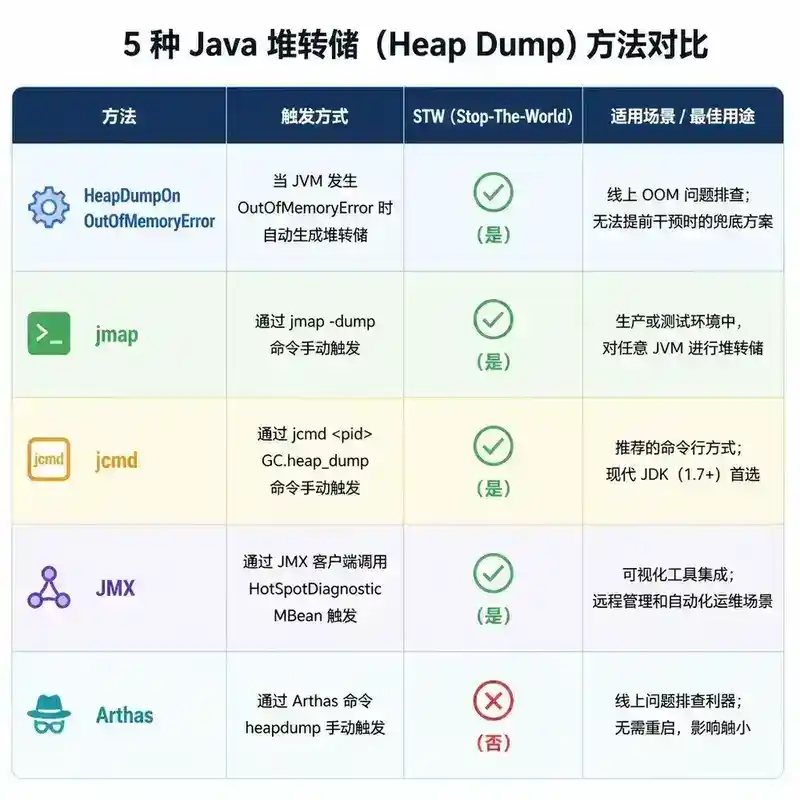
二、获取堆转储的五种方式
2.1 自动 OOM dump(推荐)
在 JVM 启动参数中加入以下选项:
-XX:+HeapDumpOnOutOfMemoryError-XX:HeapDumpPath=/data/dumps/java_heapdump.hprof
OOM 发生时自动生成 dump,无需人工干预。这是生产环境必须配置的参数,成本极低(只是 OOM 那一刻的 I/O 开销),但排查价值极高。
2.2 jmap 手动导出
# 导出存活对象(先触发一次 Full GC)
jmap -dump:live,format=b,file=heap.hprof <pid>

# 导出全部对象(不触发 GC,保留现场)
jmap -dump:format=b,file=heap.hprof <pid>
注意:-dump:live 会触发 Full GC,在排查问题时可能破坏现场(比如把本应泄漏的对象也回收了)。建议先用不带 live 的方式导出,保留完整的现场信息。
2.3 jcmd 导出(JDK 8+)
jcmd <pid> GC.heap_dump /path/to/dump.hprof
与 jmap -dump 效果相同,但 jcmd 是 JDK 推荐的统一诊断命令。
2.4 JMX 触发
import com.sun.management.HotSpotDiagnostic;
HotSpotDiagnostic mxBean = ManagementFactory.getPlatformMXBean(HotSpotDiagnostic.class);
mxBean.dumpHeap("/path/to/dump.hprof", true);
适合在自定义监控系统中集成,当堆使用率超过阈值时自动触发 dump。
2.5 Arthas 导出
heapdump /tmp/dump.hprof
适合在无法直接执行 jmap/jcmd 的容器环境中快速导出。
2.6 dump 文件大小的注意事项
dump 文件的大小约等于堆的当前使用量(存活对象大小)。一个 8GB 堆且使用率 70% 的进程,dump 文件约 5-6GB。导出前确认磁盘空间充足,导出过程会暂停应用(STW),时间取决于堆大小和磁盘速度。
[图6:堆转储获取方式对比图——五种方式的对比表,标注适用场景、优缺点、是否STW]
三、支配树:从"谁引用谁"到"谁支配谁"
3.1 为什么要用支配树
一个对象的引用关系极其复杂——一个 HashMap 可能被 100 个对象引用,但只要你清除了其中 99 个引用,只要还有 1 个引用存在,这个 HashMap 就不会被回收。普通的引用图无法告诉你"应该断开哪个引用才能让最多的对象被回收"。
支配树解决了这个问题。在支配树中,如果从 GC Root 到对象 B 的所有路径都经过对象 A,那么 A 支配 B。简单说:A 是 B 的"必经之路",回收 A 就能连锁回收 B 和 B 支配的所有子对象。
3.2 Retained Heap 的计算逻辑
[图1:支配树与 Retained Heap 示意图——左侧对象引用关系图,右侧支配树,每个节点标注 Shallow Heap 和 Retained Heap]
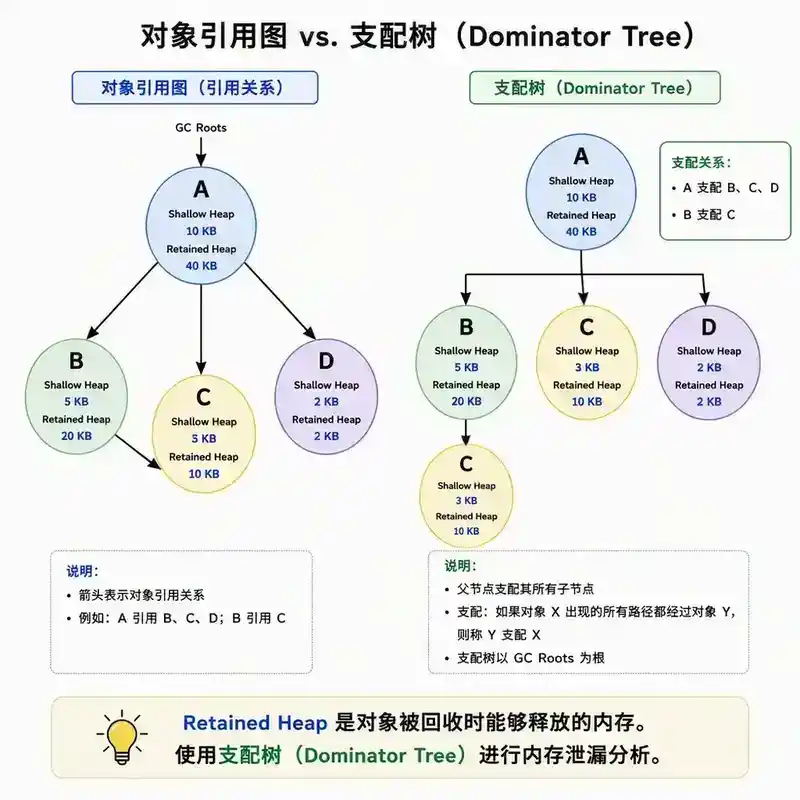
Retained Heap 是内存泄漏分析中最重要的指标。在 MAT 中按 Retained Heap 排序,最大的几个对象通常就是泄漏的根——回收它们能释放最多的内存。
3.3 常见陷阱
"Retained Heap 最大的对象就是泄漏对象"——不一定。比如一个巨大的缓存本身就是业务需要的,Retained Heap 大是正常的。关键是看这个对象是否"应该被回收但没有被回收"。判断方法:结合业务逻辑,这个对象代表的业务实体是否已经过期或被删除。
四、MAT 实战:从 dump 到定位代码
4.1 环境准备
MAT 是 Eclipse 旗下的开源堆分析工具,独立运行。下载地址:https://eclipse.dev/mat/
启动时调整 MAT 自身的 JVM 参数:修改 MemoryAnalyzer.ini,设置 -Xmx8g(至少是 dump 文件大小的 1.5 倍)。
如果 dump 文件太大(比如 10GB+),可以考虑:
- 用 jmap 导出时只导出存活对象(
-dump:live),减少文件大小。 - 在服务器上运行 MAT 的命令行模式(
ParseHeapDump.sh)生成分析报告,不启动 GUI。 - 使用 JProfiler 的远程分析模式,直接在服务器上分析。
4.2 分析流程
[图2:MAT 分析流程图——打开dump→Leak Suspects→Dominator Tree→Class Histogram→Merge Shortest Paths to GC Roots→定位代码]
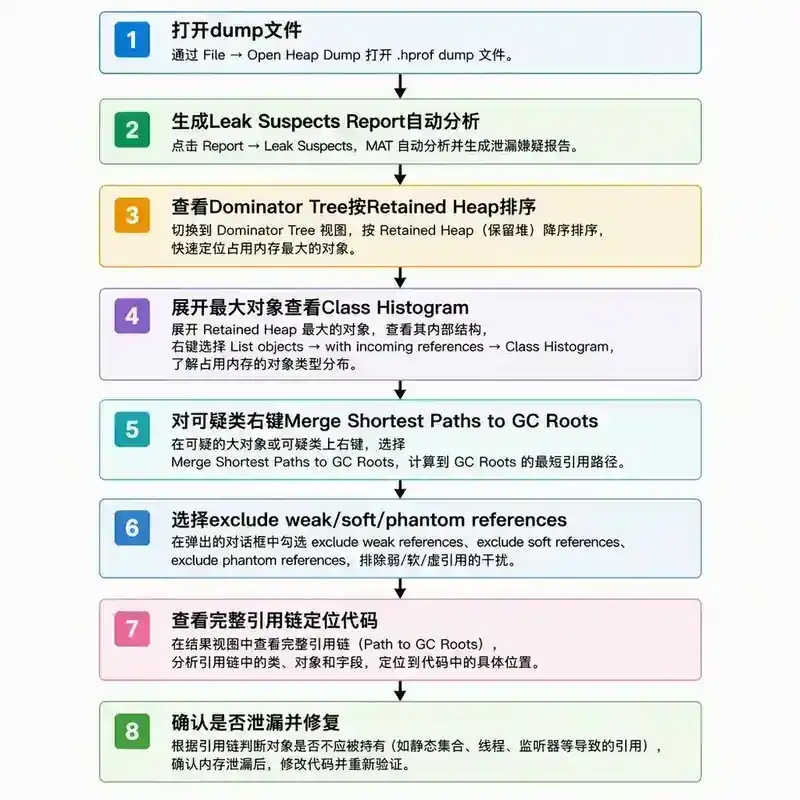
Step 1:打开 dump 文件,生成 Leak Suspects Report
MAT 打开 dump 后会自动生成"Leak Suspects"报告,列出最可能的内存泄漏嫌疑对象。这个报告是自动化的初步分析,可以快速定位到最大的几个嫌疑对象。
Step 2:查看 Dominator Tree(支配树)
点击工具栏的 Dominator Tree 图标,对象按 Retained Heap 从大到小排列。展开最大的几个节点,观察它们的类型和内容。
Step 3:查看 Class Histogram(类直方图)
如果某个类的实例数量异常多(比如预期只有 100 个,实际有 10 万个),即使每个实例的 Retained Heap 不大,也可能存在泄漏。常见的泄漏类:HashMap$Node、LinkedHashMap$Entry、byte[ ]、String。
Step 4:追踪引用链
对可疑对象右键 → "Merge Shortest Paths to GC Roots" → 选择 "exclude weak/soft/phantom references"。MAT 会显示从 GC Root 到该对象的完整引用链,直接指出"谁持有了这个对象"。
[图5:Path to GC Roots 引用链示意图——从GC Root逐层向下到目标对象,每层标注引用类型和代码位置]
Step 5:定位代码
引用链的最后一环通常就是泄漏的代码位置。比如如果 PoolEntry 对应的连接早已超时但未被清理,就是典型的连接池泄漏。
4.3 三个典型的泄漏案例
案例 1:ThreadLocal 泄漏
MAT 中大量 ThreadLocal$ThreadLocalMap$Entry 占用高 Retained Heap,追踪引用链发现是线程池中的线程持有 ThreadLocal 值,但业务代码中从不在 finally 中调用 remove()。
案例 2:静态集合泄漏
Class Histogram 中 HashMap$Node 实例数持续增长,Dominator Tree 中发现某个 static HashMap 是所有节点的支配者,这个 Map 的 size 远大于业务预期。
案例 3:类加载器泄漏
MAT 中 ClassLoader 的 Retained Heap 很大,展开后发现每个 ClassLoader 持有了大量类。追踪引用链:某个第三方库的缓存持有了 ClassLoader 的引用,导致已部署的 Web 应用类加载器无法被回收。
五、JProfiler:更直观的在线分析
5.1 MAT vs JProfiler 的定位
MAT 是离线分析工具——拿到 dump 文件后,在任意机器上分析。JProfiler 是在线分析工具——通过 Agent 连接到运行中的 JVM,实时观察内存分配和 GC 行为。
| 场景 | 推荐工具 |
|---|---|
| 线上 OOM 后离线分析 dump | MAT |
| 开发/测试环境实时观察内存增长 | JProfiler |
| 定位某个接口的内存分配热点 | JProfiler |
| 分析超大 dump 文件(10GB+) | MAT 命令行模式 |
| 生产环境实时监控(低开销) | Arthas / jstat |
5.2 JProfiler 的核心功能
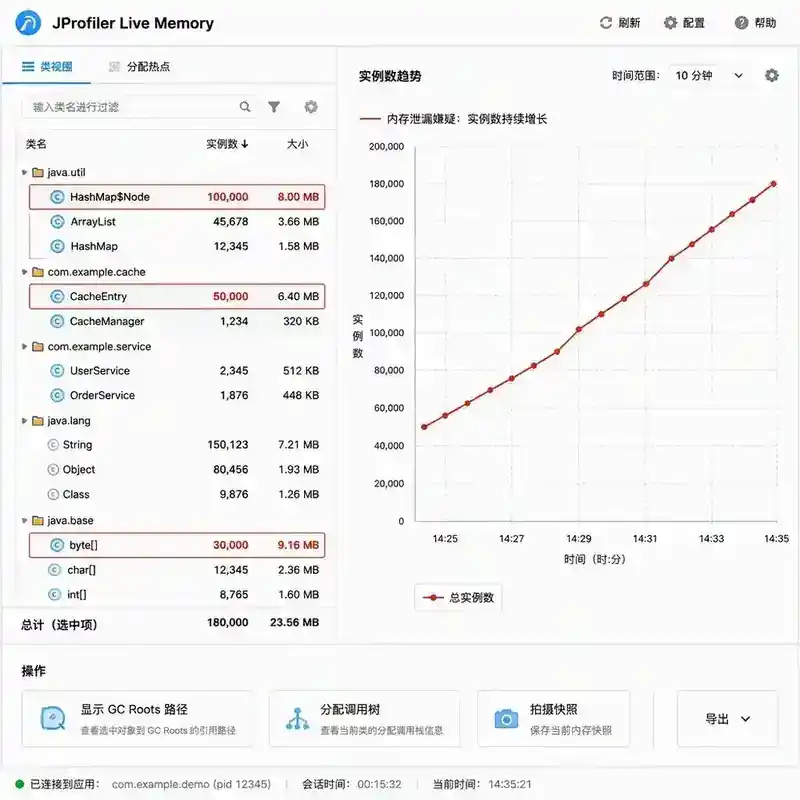
Live Memory(实时内存):查看当前堆中所有对象的实例数和占用大小,按包名、类名分组,实时刷新。可以看到哪些类在持续增长——这些就是泄漏嫌疑。
Allocation Call Tree(分配调用树):记录每个方法分配了多少对象和多少内存。结合"分配热点"视图,可以快速定位"哪个方法创建了最多的对象"。
Heap Walker(堆遍历器):类似 MAT 的 Dominator Tree,但可以实时更新。支持按 Retained Size 排序,追踪引用链。
[图3:JProfiler Live Memory 界面示意图——左侧类列表按实例数,右侧实例数量增长曲线图,底部标注内存泄漏嫌疑]
5.3 JProfiler 的典型使用流程
- 启动目标应用时加上 JProfiler Agent:
-agentpath:/path/to/jprofiler/bin/linux-x64/libjprofilerti.so - 在 JProfiler GUI 中连接到目标 JVM。
- 打开 Live Memory 视图,观察哪些类的实例数在持续增长。
- 对可疑类,右键 → "Show Paths to GC Roots" → 追踪引用链。
- 结合 Allocation Call Tree,确认是在哪个方法中分配了这些对象。
六、Arthas:线上轻量级排查
对于生产环境,MAT 和 JProfiler 都有明显局限:MAT 需要 dump 文件(可能几 GB,导出时间长),JProfiler 需要 Agent(对性能有影响)。Arthas 提供了更轻量级的选项:
# 查看堆中对象占用
vmtool --action getInstances --className java.lang.String --limit 10

# 导出在线 dump
heapdump --live /tmp/dump.hprof

# 查看类加载器
classloader -l

# 监控方法执行和对象分配
monitor -c 5 com.example.MyService processRequest
Arthas 的优势是不需要重启、不需要修改 JVM 参数,直接 attach 到运行中的进程,适合紧急排查。
七、支配树分析实战:一个完整的排查流程
[图4:内存泄漏排查完整流程图——监控发现→导出dump→MAT分析→支配树排序→追踪引用链→定位代码→修复验证→观察恢复]
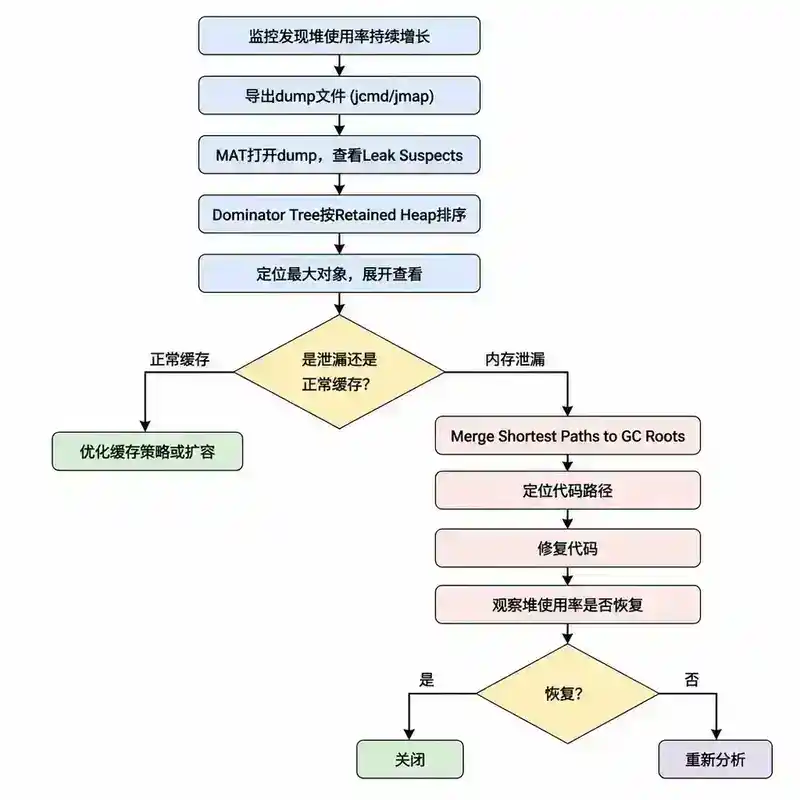
假设你收到告警:某个服务堆使用率从 30% 持续增长到 85%,Full GC 回收量越来越小。以下是完整排查步骤:
Step 1:确认趋势
jstat -gcutil <pid> 1000 10
# 观察 OU(Old utilization)是否持续增长
如果 OU 在 Full GC 后仍然很高且持续增长,大概率是内存泄漏。
Step 2:导出 dump
jcmd <pid> GC.heap_dump /tmp/heap_dump.hprof
Step 3:MAT 打开 dump
打开 Leak Suspects 报告,看到最大嫌疑对象是 com.example.product.CacheManager,Retained Heap 占 3.2GB。
Step 4:追踪引用链
展开 CacheManager → 内部有一个 ConcurrentHashMap → 包含 500 万个 CacheEntry,但业务逻辑中,这些缓存条目应该在 TTL 过期后自动清理。查看引用链确认:CacheManager 是 static 字段,持有 map 引用,map 中的 Entry 永远不会被清理。
Step 5:定位代码
public class CacheManager {
    private static final ConcurrentHashMap<String, CacheEntry> cache = new ConcurrentHashMap<>();

    public static void put(String key, CacheEntry entry) {
        cache.put(key, entry); // 永不过期,永不清理
    }
}
Step 6:修复
加上过期清理逻辑(如 ScheduledExecutorService 定期清理、Guava Cache 替换、或使用 WeakHashMap)。
八、支配树 vs 简单引用排序:一个容易被忽略的差异
很多工程师在 MAT 中直接看"Objects by Retained Heap"而不是 Dominator Tree,这两个视图的计算结果不同。
- Objects by Retained Heap:计算每个对象的 Retained Heap 时,如果两个对象共同支配了第三个对象,它们会重复计算第三个对象的 Retained Heap。所以这个视图的总和可能超过堆的实际大小。
- Dominator Tree:每个对象只被一个支配者支配,Retained Heap 不重复计算。总和精确等于堆大小。
结论:分析内存泄漏时,优先使用 Dominator Tree,它的 Retained Heap 更准确。
九、常见误区和面试陷阱
- "MAT 的 Leak Suspects 报告直接告诉我泄漏在哪" —— 不总是。Leak Suspects 是自动聚类分析,只能指出"嫌疑",不能替代人工判断。它可能把正常的业务缓存标记为泄漏嫌疑。
- "Class Histogram 里哪个类实例数最多,一定是这个类导致的泄漏" —— 不一定,byte 数组和 String 往往是"受害者"而非"肇事者"——其他对象持有它们的数据,泄漏的是持有它们的对象。
- "Retained Heap 最大的对象就是泄漏" —— 业务正常的大缓存 Retained Heap 也很大。判断标准是"这个对象是否应该被回收"而非"它有多大"。
- "用 jmap -dump:live 导出 dump 更小,更好" ——
-dump:live会触发 Full GC,可能把本应泄漏的对象(被软引用/弱引用关联)也回收了,导致 dump 现场失真。排查泄漏时建议用不带live的导出。
十、总结
内存泄漏排查的核心思路是一个闭环:
- 监控发现:堆使用率持续增长 + Full GC 回收量低。
- 获取 dump:
-XX:+HeapDumpOnOutOfMemoryError自动获取,或 jcmd/jmap 手动导出。 - 支配树排序:MAT 中按 Retained Heap 排序,找到最大嫌疑对象。
- 追踪引用链:Merge Shortest Paths to GC Roots,转化为"谁不让这个对象回收"。
- 定位代码:引用链的末端就是持有引用的代码位置。
- 修复验证:修代码、重启、观察堆使用率是否回落。
记住:MAT 告诉你"泄漏了什么",引用链告诉你"为什么会泄漏",你的业务知识告诉你"这个对象是否应该被回收"。 三者缺一不可。
延伸阅读
- Eclipse MAT 官方文档:Dominator Tree 和 Path to GC Roots
- JProfiler 官方文档:Heap Walker 和 Allocation Call Tree
- Arthas 官方文档:vmtool、heapdump 命令
- 本系列相关篇目:064(常见 OOM 类型)、066(JVM 常用诊断工具)、067(GC 日志分析)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对内存泄漏分析的实战经验和深度理解。
Q1:你在 MAT 的 Dominator Tree 里看到一个 HashMap 的 Retained Heap 占了 3GB,但你打开后发现在这个 HashMap 里存的是业务必须的缓存数据。你怎么判断这是"正常的缓存"还是"内存泄漏"?
关键不是看它有多大,而是看它是否应该被回收。具体判断标准:第一,看这个缓存的 TTL 机制是否正常工作——如果缓存条目的 TTL 已过期但仍然存在,那就是泄漏。第二,看缓存的增长率——如果缓存大小随业务数据量线性增长且没有上限,即使现在正常,未来也会变成 OOM,这是设计缺陷。第三,看 GC 行为——如果 Full GC 能正常回收这个 HashMap 中的过期条目,说明不是泄漏;如果 Full GC 后 HashMap 的大小几乎不变,说明条目被强引用持有无法回收。
Q2:你拿到一个 8GB 的 dump 文件,本地 MAT 打不开(内存不够)。你有哪几种替代方案?
方案一:在服务器上用 MAT 的命令行模式生成分析报告,不需要 GUI,用 ParseHeapDump.sh 生成 HTML 报告和索引文件,拷贝到本地查看。方案二:用 jhat(JDK 自带工具)做初步分析。方案三:用 jmap -dump:live 重新导出只含存活对象的 dump,文件会小很多(但可能丢失现场)。方案四:用 JProfiler 的远程连接模式,在服务器上直接分析,不需要完整下载 dump。方案五:只分析关键对象——用 jmap -histo:live 先看类直方图,定位可疑类后再用 Arthas 的 vmtool 针对性查看引用链。
Q3:你在 MAT 中看到某个对象的 "Path to GC Roots" 经过了 java.lang.ref.Finalizer,这意味着什么?这个对象还能被回收吗?
这意味着这个对象重写了 finalize() 方法,且已经被 GC 判定为不可达,但还没有执行 finalize 方法。对象被放入 Finalizer 队列中,等待 Finalizer 线程执行其 finalize() 方法。如果 Finalizer 线程处理不过来(队列积压),这些对象会长期占用内存无法回收。更危险的是,如果 finalize() 方法中把对象重新赋值给一个静态字段(对象复活),这个对象就永远不会被回收了。排查方向:看 Finalizer 线程是否存活,队列是否积压,以及代码中是否有不必要的 finalize() 重写。
Q4:你在排查一个内存泄漏,发现可疑对象被一个 java.lang.Thread 的栈帧引用。这说明什么?怎么进一步定位?
这说明泄漏对象被某个线程的局部变量持有——这个线程可能正在执行中(局部变量在作用域内),或者线程虽然执行完了但线程池复用了线程,局部变量表没有被清理。进一步定位:在 MAT 中查看该线程的线程栈,找到引用该对象的具体方法调用栈帧,直接定位到代码行。如果线程栈显示该线程在 wait() 或 park() 状态,说明线程在等待某个条件,持有的局部变量可能一直无法释放。这时需要检查线程的逻辑——是否在等待一个永远不会到来的信号。
Q5:你有一个微服务,堆设置 4GB,Docker 容器内存限制 6GB。监控显示进程 RSS 持续增长到 5.8GB,但堆使用率只有 60%。dump 文件分析也没发现泄漏。你觉得问题出在哪?怎么排查?
堆使用率只有 60% 但 RSS 接近容器限制,说明问题在堆外内存。排查方向:第一,用 Native Memory Tracking(-XX:NativeMemoryTracking=detail)查看各区域内存占用,用 jcmd GC.heap_dump 输出详情。第二,检查直接内存(Direct ByteBuffer)使用量——用 NMT 的 Internal 和 Direct 区域的 committed 值。第三,检查线程数乘以 -Xss 的总栈空间。第四,检查 Metaspace 使用量。第五,检查 JNI 和第三方本地库的内存分配(如 Netty 的堆外池、RocksDB 的 Block Cache 等)。常见原因是 Netty 的 ByteBuf 未释放、JNI 代码中的内存泄漏、或线程数量超预期。用 pmap -x 查看进程的内存映射,可以帮助定位是哪块内存区域在不断增长。