一、ZGC 和 Shenandoah 的设计目标:亚毫秒级停顿
在 G1 已经将 GC 停顿控制在几十毫秒级别(默认目标 200ms)之后,垃圾收集器的发展方向转向了一个更激进的目标:将停顿时间压缩到亚毫秒级(< 1ms),并且停顿时间不随堆大小增长。ZGC(Z Garbage Collector)和 Shenandoah 就是为实现这一目标而生的。
ZGC 最初由 Oracle 开发,在 JDK 11 中首次实验性引入,JDK 15 正式发布。Shenandoah 由 Red Hat 开发,在 JDK 12 中首次引入。两者都实现了并发整理(Concurrent Compaction)——即 GC 在移动对象的同时,用户线程仍在运行,不需要 STW 来更新引用。这是 GC 技术的一次重大突破。
但在实现"并发整理"的具体技术路径上,ZGC 和 Shenandoah 走了不同的路线:ZGC 使用了染色指针(Colored Pointers),而 Shenandoah 使用了转发指针(Brooks Forwarding Pointer)。这个技术选择深刻影响了它们的设计取舍和性能特征。
二、ZGC:染色指针技术
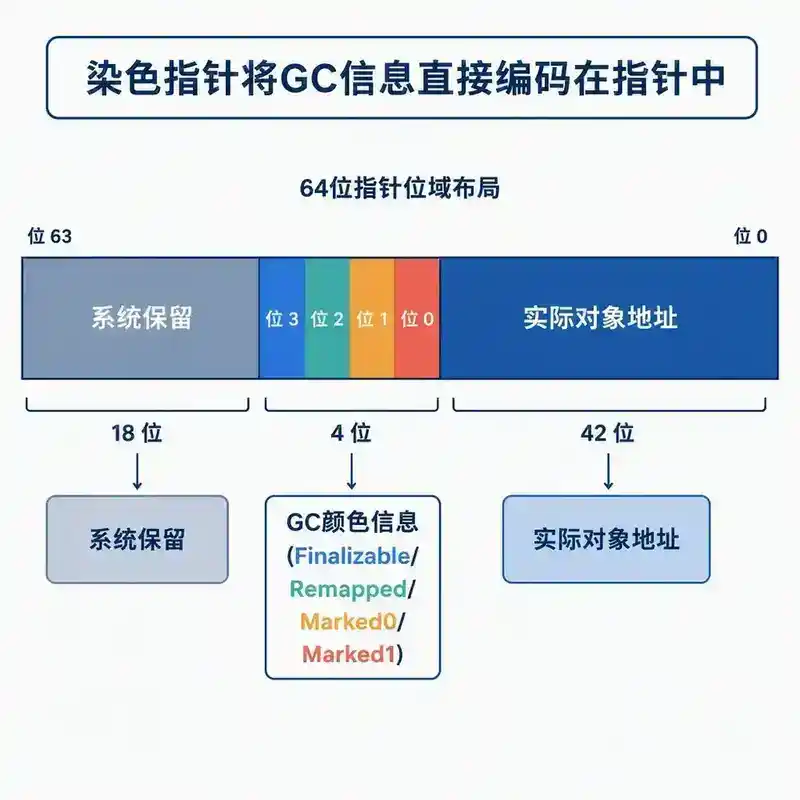
ZGC 的核心创新是染色指针——将 GC 信息直接编码在 64 位指针的某些位中,而不是像传统 GC 那样将 GC 信息存储在对象头(Mark Word)中。在 64 位 Linux 系统上,虚拟地址空间的高 16 位未被使用,ZGC 利用其中的 4 位来存储指针的"颜色"信息:
- Finalizable 位:标记该对象是否覆盖了
finalize()方法(仅用于兼容,JDK 18+ 不再使用) - Remapped 位:标记该指针是否已经指向对象的新地址(用于并发整理)
- Marked 位:标记该对象是否在并发标记阶段被标记为存活(Marked0 和 Marked1 交替使用)
染色指针的核心优势是:GC 信息直接存储在指针中,不需要额外的对象头开销,也不需要读写屏障来更新对象头。当 GC 移动对象时,它只需要更新指针中的 Remapped 位,而不是修改对象头。这使得 ZGC 的 GC 停顿时间极短(通常 < 1ms),且不随堆大小增长。
但染色指针也有代价:它限制了 ZGC 支持的堆大小。因为只有 46 位可用于地址空间(64 位中高 18 位系统保留,低 4 位被染色占用,实际可用约 42-46 位),ZGC 支持的堆大小上限约为 4TB(在 Linux/x64 上)。这在实际使用中已经足够,但不如 G1 理论上可以支持无限大的堆(受限于操作系统)。
三、ZGC 的 GC 周期
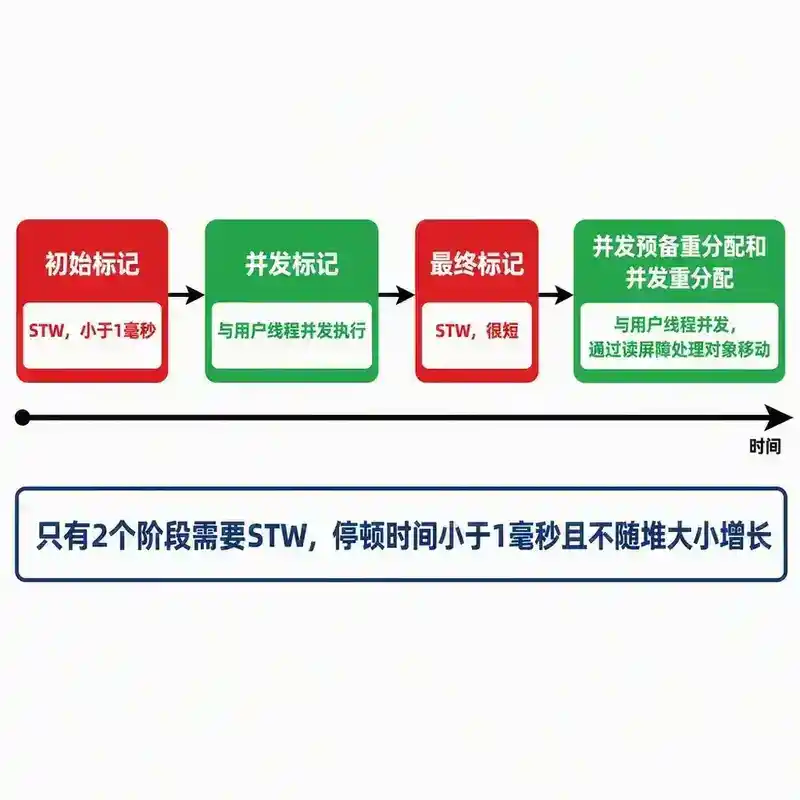
ZGC 的 GC 周期分为多个阶段,其中只有 Initial Mark 和 Remark 需要 STW,其余阶段全部与用户线程并发:
- 初始标记(Initial Mark,STW):标记 GC Roots 直接关联的对象,停顿时间固定(通常 < 1ms),不随堆大小增长。
- 并发标记(Concurrent Mark):遍历对象图,标记所有可达对象。与用户线程并发执行。
- 最终标记(Remark,STW):处理并发标记阶段的残留记录,停顿时间很短。
- 并发预备重分配(Concurrent Prepare for Relocate):确定需要重分配哪些 Region,准备重分配操作。
- 并发重分配(Concurrent Relocate):将存活对象从选中的 Region 复制到新的 Region。在这个过程中,用户线程可以继续访问对象——当用户线程访问一个正在被移动的对象时,ZGC 通过读屏障(Load Barrier)自动将引用更新为新地址。这是 ZGC 实现"并发整理"的关键。
- 并发重映射(Concurrent Remap):更新所有指向已移动对象的指针。这一步在下次 GC 的并发标记阶段一并完成,不需要单独执行。
四、Shenandoah:转发指针(Brooks Pointer)技术
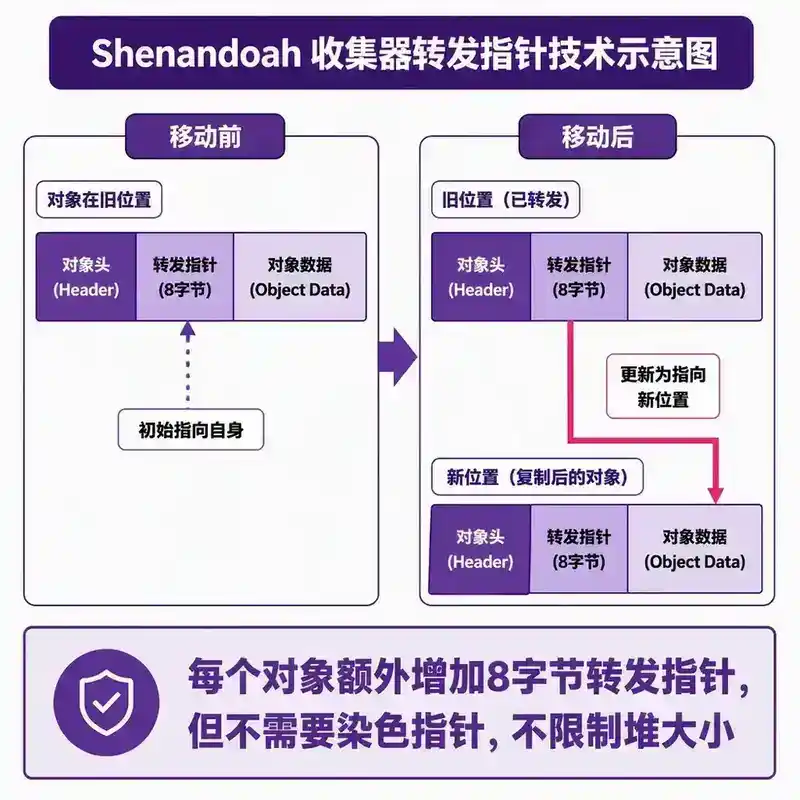
Shenandoah 使用了与 ZGC 不同的技术路径——转发指针(Brooks Forwarding Pointer)。Shenandoah 在每个对象头的前面增加一个额外的指针字段(转发指针),初始指向对象自身。当 GC 需要移动对象时,将对象复制到新位置,然后将原位置的转发指针更新为新地址。用户线程访问对象时,通过转发指针找到对象的实际位置。
转发指针的优点是:不需要染色指针,不限制堆大小,Shenandoah 可以支持任意大小的堆。缺点是:每个对象额外增加 8 字节的转发指针,内存开销较大;且访问对象需要经过一次额外的指针跳转(先读转发指针,再访问实际对象),有一定的性能开销。
五、Shenandoah 的 GC 周期
Shenandoah 的 GC 周期分为以下阶段:
- 初始标记(Initial Mark,STW):标记 GC Roots,停顿很短。
- 并发标记(Concurrent Mark):遍历对象图,标记所有可达对象。
- 最终标记(Final Mark,STW):处理并发标记阶段的残留,扫描 GC Roots 引用的变化。
- 并发清理(Concurrent Cleanup):清理被标记为垃圾的 Region。
- 并发疏散(Concurrent Evacuation):将存活对象从选中的 Region 复制到新的 Region。在这个过程中,用户线程可以继续访问对象——通过读屏障(Brooks 转发指针)和写屏障(比较并交换 CAS)来处理并发修改。
- 初始更新引用(Init Update Refs,STW):准备更新引用阶段。
- 并发更新引用(Concurrent Update Refs):将所有指向旧地址的引用更新为新地址。
- 最终更新引用(Final Update Refs,STW):处理残留的引用更新。
六、ZGC vs Shenandoah:核心对比
| 维度 | ZGC | Shenandoah |
|---|---|---|
| 关键机制 | 染色指针(Colored Pointers) | 转发指针(Brooks Forwarding Pointer) |
| 并发整理 | 读屏障(Load Barrier) | 读屏障 + 写屏障 |
| 堆大小限制 | 受限于地址空间(约 4TB) | 无限制 |
| 对象内存开销 | 无额外开销 | 每个对象 +8 字节(转发指针) |
| STW 阶段数 | 2 个(Initial Mark + Remark) | 4 个(Initial/Final Mark + Init Ref/Final Ref) |
| 最大停顿 | < 1ms(通常) | < 10ms(通常) |
| 吞吐量影响 | 中等(读屏障开销) | 较高(读屏障 + 写屏障开销) |
| JDK 状态 | JDK 15 正式发布 | JDK 12 引入 |
七、低延迟 GC 的取舍与选择建议
ZGC 和 Shenandoah 将 GC 停顿压缩到了极致,但这是有代价的:
- 吞吐量下降:读屏障/写屏障的开销导致 GC 占用更多 CPU 时间,吞吐量通常比 G1 低 5-15%。
- 内存开销:Shenandoah 的转发指针增加每个对象的内存占用;ZGC 的染色指针限制了堆大小上限。
- 适用场景限制:ZGC 和 Shenandoah 适合对延迟极度敏感的在线服务(如金融交易、实时推荐、游戏服务器),不适合批处理和计算密集型应用。
选择建议:
- 如果追求极致低延迟且堆 < 4TB:选择 ZGC(STW 更少,性能更优)。
- 如果堆大小不固定或超过 4TB:选择 Shenandoah(无堆大小限制)。
- 如果追求吞吐量和低延迟的平衡:选择 G1(JDK 默认,成熟稳定)。
- 如果追求高吞吐量:选择 Parallel。
八、面试追问链
从"ZGC 和 Shenandoah 与 G1 的本质区别是什么"这个基础问题出发,逐层追问:ZGC 的染色指针是什么如何在指针中存储 GC 信息染色指针的优缺点是什么、ZGC 的 GC 周期有哪些阶段为什么只有 2 个阶段需要 STW、Shenandoah 的转发指针是什么和 ZGC 的染色指针有什么区别、ZGC 和 Shenandoah 如何实现并发整理读屏障和写屏障各自的作用是什么、ZGC 和 Shenandoah 的堆大小限制分别是什么为什么、ZGC 和 Shenandoah 的吞吐量为什么比 G1 低、什么场景下应该选择 ZGC 什么场景下选择 Shenandoah 什么场景下选择 G1。
延伸阅读
- JEP 333(ZGC)、JEP 377(ZGC 正式发布)、JEP 189(Shenandoah),理解两者的演进历程
- 《深入理解 Java 虚拟机》(周志明)第 3.5.6 节,介绍了 ZGC 和 Shenandoah
- 「04 JVM 原理与调优」系列下一篇(062)将深入 JVM 常用诊断工具的使用
九、面试官视角问答
以下问题不是对文档内容的简单复述,而是模拟面试官会怎样追问、怎样刁难。建议先自己想清楚再看答案。
Q1:染色指针把 GC 信息编码进指针的高位,那对象一旦被移动、指针的地址位变了,所有指向它的指针不是都要重新“染色”吗?ZGC 是怎么避免一次性全部更新的?
不需要一次性全部更新。ZGC 的关键设计是指针的更新是惰性的、发生在访问时:Remapped 位标记的是“这个指针是否已经指向最新地址”,而不是要求某个时刻所有指针都同步。当用户线程通过一个还指向旧地址、Remapped 位未置位的指针访问对象时,读屏障会拦截这次访问,发现地址过期,就地完成一次“自愈”(self-healing):从转发表查到新地址,同时把这个指针原地重写为新地址、并置位 Remapped。所以指针的“修复”是分散在成千上万次访问中逐步完成的,而不是 STW 阶段去扫一遍堆。这也是为什么 ZGC 的并发重映射可以合并到下一轮 GC 的并发标记里一起做——没有严格的“必须马上更新完”的时间压力。
Q2:读屏障要在几乎每次对象引用读取时插入检查逻辑,这在解释执行和 JIT 编译代码里分别是怎么做到几乎不可感知的开销的?
在解释执行层面开销确实存在,但 ZGC 的目标场景主要是 JIT 之后的热点代码。JIT(C2)编译时,读屏障被设计成一段极短的机器码:先做一次位测试(and 指令检查地址的高位是否命中 bad-mask),绝大多数情况下测试通过,直接使用原指针,这个快路径可以被内联到几条指令,且现代 CPU 分支预测对这种“几乎总是不进入”的分支预测得很好。只有在对象确实处于“未重映射”状态时才会进入慢路径调用运行时函数。另外 ZGC 会随着 GC 阶段推进整体切换一个全局的 bad-mask 常量,这样绝大多数对象在多数时间里读屏障测试都是走空指令般的路径,均摊开销通常在 5%-15% 吞吐量之间,这也是它标注为“中等吞吐量影响”的原因。
Q3:Shenandoah 用写屏障+CAS 来处理并发疏散阶段的引用更新,如果两个线程同时写同一个字段、且对象正在被移动,会不会出现更新丢失或者写到旧对象上的情况?
不会,因为 Shenandoah 用的是“to-space invariant”(新生代不变式的推广):一旦某个对象进入疏散阶段,任何线程对它字段的写入都必须先通过写屏障把目标地址转换成新位置的地址,再执行写操作;如果对象还没复制完成,写屏障会先协助完成复制(相当于抢先做一次 evacuate),确保写永远只发生在新副本上。多线程竞态复制同一个对象时用 CAS 保证只有一个线程真正执行复制,其余线程发现 CAS 失败后直接使用已经复制成功的新地址。这样旧对象自复制完成后就成为死对象,不会再有写入落到它身上,从根本上避免了“写丢失”或“写到旧地址”的问题。
Q4:如果让你现在选型,一个堆 96GB、P99 延迟要求小于 5ms 的在线服务,你会怎么在 G1、ZGC、Shenandoah 之间做取舍?只看结论是不够的,说说你的判断依据。
不会只看“堆多大”或“延迟多敏感”这种表面参数,而是要看三个更细的维度:一是延迟目标和收集器理论停顿的余量——G1 的默认目标是 200ms,即使调 MaxGCPauseMillis 到 50ms 也很难稳定,而 5ms 的 P99 已经进入 ZGC/Shenandoah 的射程但退出了 G1 的能力边界,所以 G1 基本可以排除;二是团队对新收集器的运维经验和 JDK 版本——ZGC 在 JDK 15+ 才正式可用且早期版本堆上限、NUMA 支持有取舍,Shenandoah 是 Red Hat 系 JDK 更成熟一些,如果团队在用 OpenJDK 官方发行版且版本较新,两者都能用;三是对吞吐量下降的容忍度和是否有多余 CPU 预算——读屏障/写屏障都会占用额外 CPU,96GB 堆规模下这个开销是实打实的,需要先用生产流量做基准测试量化,而不是直接拍板。结论上,96GB 不算特别大,两者都能跑,我会优先压测 ZGC(停顿更短、STW 更少),Shenandoah 作为备选,同时明确告诉业务方吞吐量会有 5%-15% 的下降,需要提前扩容或压测验证容量水位。
Q5:染色指针方案理论上有堆大小上限,如果业务量增长到未来某天堆真的要突破这个上限,除了换 Shenandoah,ZGC 本身有没有办法缓解?
有。JDK 21 引入的 Generational ZGC(分代 ZGC)已经不再是简单地"扩位"来提高上限,而是从根本上改变了策略:把堆分成年轻代和老年代分别回收,绝大多数垃圾在年轻代就被高频次、低成本地清理掉,大幅降低了对"整堆一次性染色"能力的依赖,间接缓解了地址空间不足的压力,同时因为回收更聚焦于短命对象,实际吞吐量也比传统单代 ZGC 有明显提升。所以这不是靠单纯扩大染色位数解决的,而是通过改变整体回收策略来适配更大规模的堆和更真实的对象生命周期分布。