一、OOM 不是一种错误,是一个家族
大多数 Java 工程师对 OOM(OutOfMemoryError)的第一反应是"堆内存不够了,调大 -Xmx"。但在 JVM 规范中,OOM 有六种不同的子类型,每种对应不同的内存区域、不同的根因和不同的排查手段。用"调大堆"这一招应对所有 OOM,就像用创可贴处理所有伤口——对某些有效,对另一些只会延误真正的治疗。
本文按"生产环境出现频率从高到低"的顺序,逐一拆解四种最常见的 OOM:
- Java heap space:堆内存耗尽,最常见但也最容易被误判。
- Metaspace:元空间耗尽,动态代理和热部署的典型陷阱。
- Direct buffer memory:直接内存耗尽,NIO 和 Netty 用户的必经之路。
- Unable to create new native thread:线程耗尽,看起来像内存问题,实际上是操作系统资源限制。
每种 OOM 都会覆盖:触发条件 → 日志特征 → 排查步骤 → 根因定位 → 修复方案 → 预防措施。
二、Java heap space:最熟悉的陌生人
2.1 触发条件
当 JVM 尝试在堆上分配对象,但即使经过一次 Full GC 后仍然没有足够连续空间时,抛出 java.lang.OutOfMemoryError: Java heap space。
关键是"即使经过 Full GC"——这意味着 JVM 已经尽了最大努力回收,仍然不够。这和"堆使用率 90%"是两回事:使用率 90% 可能只是对象多,GC 后能回收到 30%;而 Java heap space OOM 意味着 GC 后几乎没回收到什么。
2.2 两大类根因
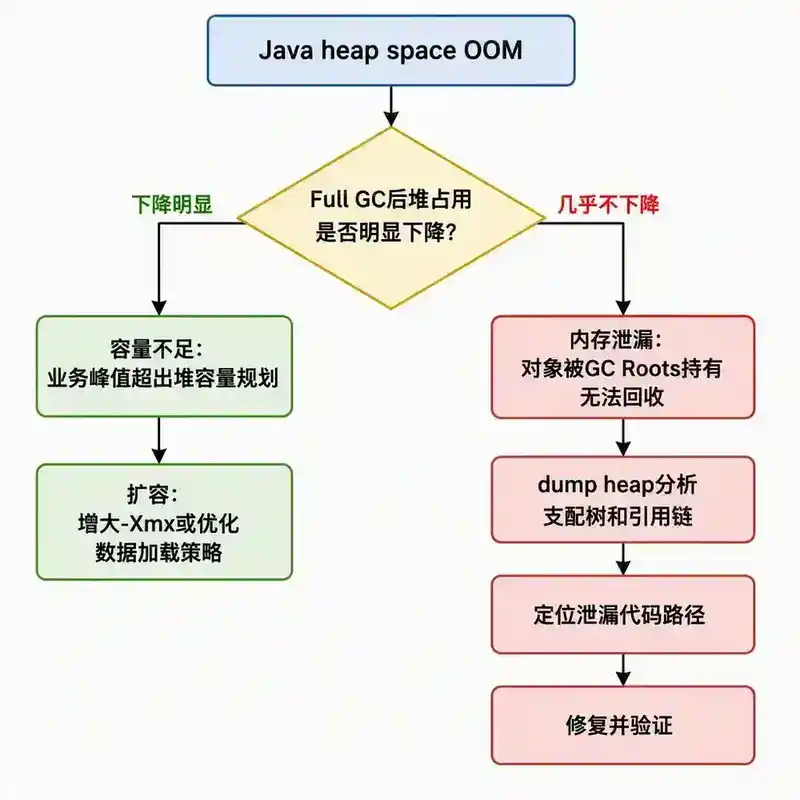
类别一:内存泄漏(Memory Leak)
对象不再被业务逻辑需要,但仍然被 GC Roots 引用,无法回收。典型场景:
- 静态集合(static HashMap/ArrayList)不断往里塞数据,从不清理。
- 线程局部变量(ThreadLocal)在线程池场景下未及时 remove,导致值对象随线程长期存活。
- 监听器/回调未注销,被观察者持有引用。
- 第三方库内部缓存无限增长(如某些 ORM 的查询缓存)。
类别二:容量不足(Capacity Shortage)
对象确实都是"活"的,业务需求就是需要这么多内存,但堆配得太小。典型场景:
- 促销活动流量翻倍,内存对象数量翻倍。
- 数据量增长(用户表从 100 万到 1000 万),一次加载到内存的缓存数据也增长。
- 批处理任务一次性加载了比预期大得多的数据集。
[图1:Java heap space OOM 排查决策流程图——Full GC后堆占用是否明显下降,分支到容量不足或内存泄漏]
2.3 排查步骤
Step 1:确认是泄漏还是容量不足
最简单的方法:看 GC 日志。如果 Full GC 前后堆占用差异很大(比如 2G → 500M),说明 GC 是有效的,只是容量不够;如果 Full GC 前后几乎没变化(比如 2G → 1.95G),说明大量对象无法被回收,大概率是泄漏。
Step 2:获取堆转储(Heap Dump)
在启动参数中加上 -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/path/to/dump,OOM 发生时自动生成 dump 文件。如果来不及加参数,可以用 jmap -dump:live,format=b,file=heap.bin <pid> 手动导出。
Step 3:分析支配树(Dominator Tree)
用 MAT(Memory Analyzer Tool)或 JProfiler 打开 dump 文件,查看支配树。支配树会告诉你:如果某个对象被回收,能让多少其他对象也被回收。按"Retained Heap"排序,最大的几个对象通常就是泄漏的根。
Step 4:追踪引用链
从可疑对象出发,找到"Path to GC Roots"——是什么最终引用链让这个对象无法被回收。通常最终会定位到一个 static 字段、ThreadLocal 值、或线程栈帧中的局部变量。
2.4 常见陷阱
- "OOM 后 dump 文件太大打不开":用
-XX:HeapDumpPath指定有足够空间的分区,或者在 OOM 前用jcmd <pid> GC.heap_dump主动导出。 - "dump 里 char[] 和 String 最多,以为是 String 泄漏":char[] 通常是"受害者"而非"肇事者"——它们被其他对象引用,真正泄漏的是持有它们的那个大对象。
- "调大 -Xmx 就解决了":如果是泄漏,调大堆只是延缓 OOM 到来的时间,而且每次 Full GC 的暂停时间会更长。
三、Metaspace:类元数据的"隐形杀手"
3.1 触发条件
java.lang.OutOfMemoryError: Metaspace 在 JDK 8+ 中出现,表示元空间(存储类元数据)已满。对应 JDK 7 及之前的 PermGen space。
3.2 为什么会发生
Metaspace 默认不设上限(使用本地内存,受操作系统限制),但可以通过 -XX:MaxMetaspaceSize 限制。生产环境通常建议设置一个合理上限,避免类加载失控耗尽本地内存。
Metaspace OOM 的典型场景:
- 动态代理滥用:Spring AOP、CGLIB、Javassist 等框架在运行时动态生成类。如果代理逻辑有 bug 导致无限生成新类,Metaspace 会迅速耗尽。
- 热部署/HotSwap:如 JRebel、Spring DevTools 等工具反复加载新版本的类,旧版本类未被卸载。
- Groovy 脚本引擎:每次执行脚本都编译生成新类,不限制缓存。
- Lambda 表达式:每个 lambda 会在运行时生成一个匿名类(虽然 JDK 通过 invokedynamic 优化了这一点,但某些场景下仍可能产生大量类)。
- OSGi/模块化容器:类加载器泄漏,导致已经无用的类加载器和其加载的类无法被卸载。
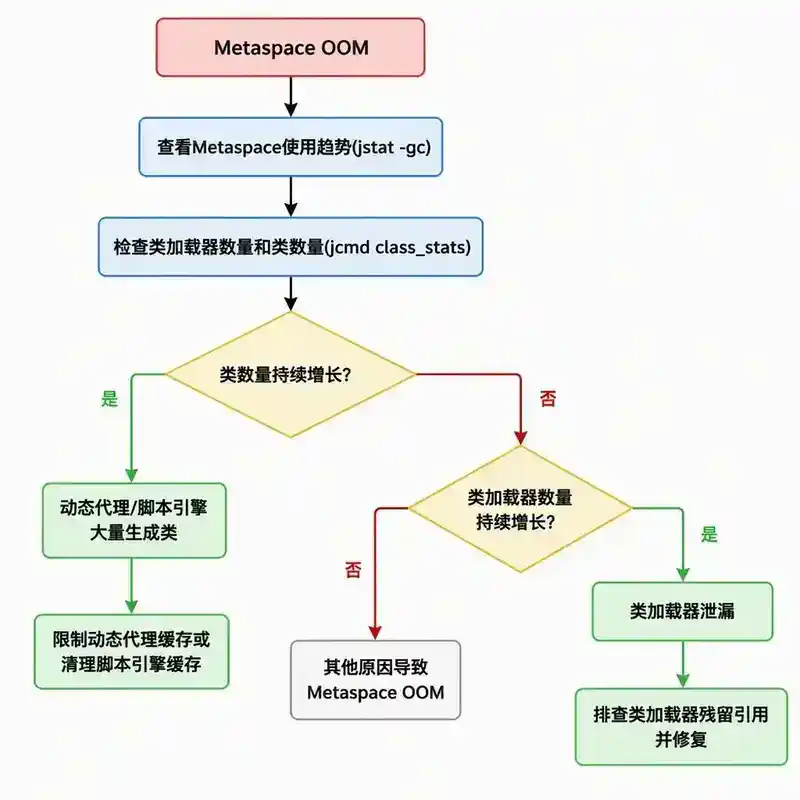
[图2:Metaspace OOM 排查流程图——Metaspace使用趋势→检查类加载器和类数量→动态代理泛滥或类加载器泄漏]
3.3 排查步骤
Step 1:确认 Metaspace 使用趋势
jstat -gc <pid> 1000 # 每秒输出一次,关注 MU (Metaspace utilization) 列
如果 MU 持续增长且不回落,说明类在不断加载但不卸载。
Step 2:查看类加载统计
jcmd <pid> GC.class_stats # 输出每个类加载器加载的类数量和占用大小
或者在 Arthas 中执行 classloader -l 查看所有类加载器及其加载的类数量。
Step 3:定位动态生成的类
如果发现大量类名类似 com.sun.proxy.$Proxy123、MyClass$$EnhancerByCGLIB$$xxx、TestGroovy_script123 的类,说明是动态代理或脚本引擎在大量生成类。
Step 4:检查类加载器回收
在 GC 日志中开启类卸载统计:-Xlog:class+unload=info(JDK 9+),确认类是否被正常卸载。如果类加载器已经被回收但类未被卸载,可能是类加载器泄漏。
3.4 解决方案
- 设置
-XX:MaxMetaspaceSize=256m(或根据实际需求),防止 Metaspace 无限制增长。 - 限制动态代理的缓存大小(如 CGLIB 的
Enhancer可以设置是否缓存)。 - 对于 Groovy 脚本引擎,设置
GroovyClassLoader的缓存上限或定期清理。 - 排查类加载器泄漏:确保不再需要的类加载器没有残留引用。
四、Direct buffer memory:堆外内存的黑洞
4.1 触发条件
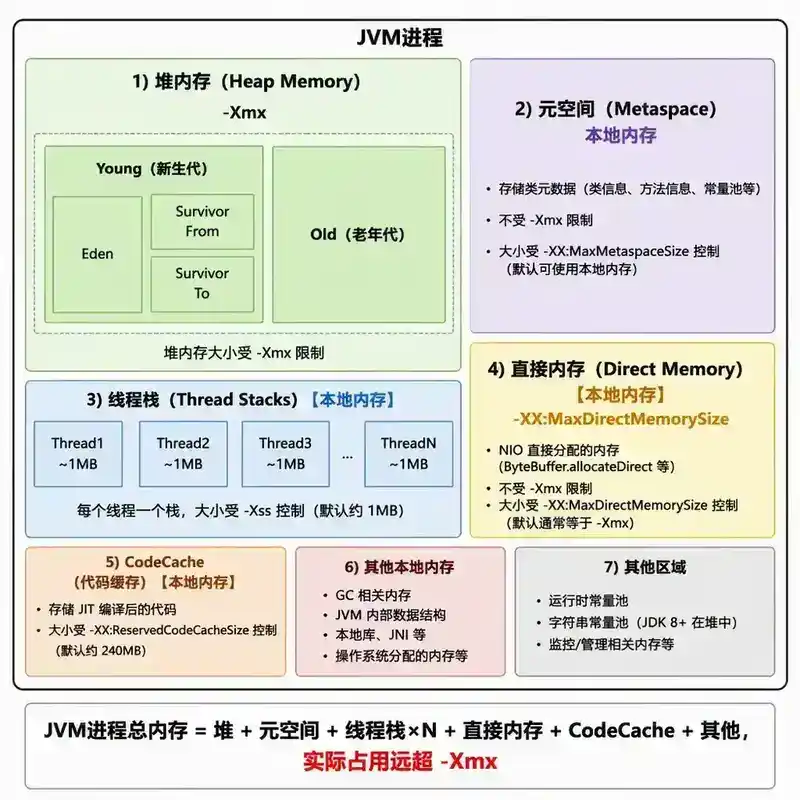
java.lang.OutOfMemoryError: Direct buffer memory 发生在直接内存(Direct Memory)分配失败时。直接内存不在堆内,不受 -Xmx 限制,而是受 -XX:MaxDirectMemorySize 控制(默认等于 -Xmx)。
4.2 直接内存的使用场景
- NIO ByteBuffer.allocateDirect():用于高效的 I/O 操作,减少一次从堆内到堆外的数据拷贝。
- Netty 的 PooledByteBufAllocator:Netty 默认使用直接内存进行网络数据的读写。
- Unsafe.allocateMemory():JDK 内部和一些高性能框架(如 Spark、Flink)使用 Unsafe 直接操作堆外内存。
- JNI 调用:本地代码(C/C++)通过 JNI 分配的内存。
4.3 为什么容易出问题
[图3:直接内存与堆内存的关系示意图——JVM进程内存全景,标注堆、元空间、线程栈、直接内存等区域,说明进程总内存远超-Xmx]
直接内存的回收依赖 Cleaner 机制(PhantomReference + 虚引用队列),当 DirectByteBuffer 对象被 GC 回收时,其关联的 Cleaner 会触发 unsafe.freeMemory() 释放堆外内存。但这里有一个致命的时间差:
- Java 对象可能已经"死了"(不再被引用),但 GC 还没发生。
- 即使 GC 发生了,如果 GC 只回收了 DirectByteBuffer 对象,但堆内存还很充裕,JVM 可能不会主动触发 GC——这就导致直接内存一直被占用,直到堆也快满了才触发 GC,而此时直接内存可能早就 OOM 了。
4.4 排查步骤
Step 1:确认直接内存使用量
# 使用 JMX 监控
jcmd <pid> VM.native_memory summary
# 关注 "Direct" 行的 committed 值
Step 2:检查 -XX:MaxDirectMemorySize
默认等于 -Xmx,如果堆设置很大但直接内存使用量也很大,需要显式调大。同时注意:如果显式设置了 -XX:MaxDirectMemorySize,它就独立于 -Xmx 了。
Step 3:检查 Netty 的引用计数泄漏
Netty 的 ByteBuf 使用引用计数——如果代码中忘记调用 release(),会导致 ByteBuf 无法被回收。使用 Netty 的 ResourceLeakDetector 可以检测泄漏。
Step 4:分析堆外内存趋势
如果堆正常但进程 RSS 持续增长,很可能是堆外内存泄漏。用 pmap -x <pid> 查看进程的内存映射,定位哪些区域在不断增长。
4.5 解决方案
- 显式设置
-XX:MaxDirectMemorySize,避免默认等于 -Xmx 导致直接内存过小。 - 检查 Netty 的 ByteBuf 使用是否正确 release。开启
-Dio.netty.leakDetection.level=PARANOID进行泄漏检测。 - 对于频繁分配 DirectByteBuffer 的场景,考虑复用或使用对象池。
- 如果使用 JDK 8 且直接内存使用量大,考虑升级到 JDK 11+,其直接内存回收机制有所改进。
五、Unable to create new native thread:压垮骆驼的最后一根稻草
5.1 触发条件
java.lang.OutOfMemoryError: unable to create new native thread 发生在 JVM 无法创建新的操作系统线程时。这个错误信息里虽然有 "OutOfMemoryError",但它和内存没有直接关系——它本质上是操作系统级别的资源限制,而非 JVM 堆内存不足。
5.2 线程数的限制来源
每个线程都会消耗操作系统资源,主要有两个限制:
限制一:进程的最大线程数
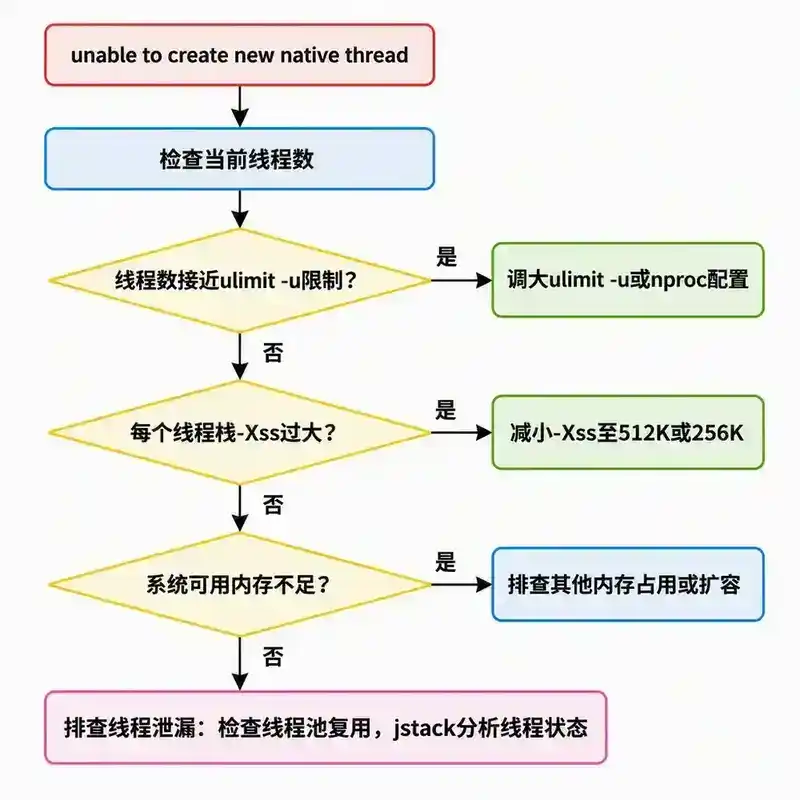
Linux 通过 ulimit -u(或 /etc/security/limits.conf 中的 nproc)限制每个用户的最大进程数。由于 Linux 中线程是轻量级进程(LWP),这个限制也适用于线程。
限制二:虚拟内存不足
每个线程的栈空间默认 1MB(-Xss 控制),在 32 位系统上,用户空间只有约 3GB,线程数上限约为 3000;在 64 位系统上,虽然虚拟地址空间很大,但操作系统可能对 vm.max_map_count 有限制(一个线程需要创建多个内存映射区域)。
[图4:线程创建失败排查流程图——检查线程数→ulimit限制→Xss大小→系统可用内存→分支解决方案]
5.3 排查步骤
Step 1:确认当前线程数
ps -eLf | grep java | wc -l   # 查看 Java 进程的线程数
# 或者
jstack <pid> | grep "^Thread" | wc -l
Step 2:检查系统限制
ulimit -u    # 查看用户最大进程数
cat /proc/sys/kernel/threads-max   # 系统级最大线程数
cat /proc/<pid>/limits | grep "Max processes"  # 进程级别的限制
Step 3:检查线程栈大小
-Xss 参数(默认约 1MB,不同 JDK 版本和平台可能不同)。如果业务不需要深递归调用栈,可以将线程栈缩小到 512KB 甚至 256KB,每个线程节省 0.5-0.75MB,对高线程数场景非常有效。
Step 4:排查线程泄漏
查看线程栈,看是否有大量线程处于相同状态(如大量 WAITING 的线程在等待同一个锁),判断是线程池配置问题还是代码 bug:
jstack <pid> | grep "java.lang.Thread.State" | sort | uniq -c | sort -nr
5.4 解决方案
- 代码层面:检查线程池是否正确复用线程,是否有每次请求都创建新线程的代码。排查线程泄漏——线程池中任务执行完毕后线程是否正常回收。
- 参数层面:减小
-Xss(如 512K 或 256K);如果确实需要大量线程,考虑使用虚拟线程(JDK 21+)。 - 系统层面:调大
ulimit -u;检查/proc/sys/kernel/threads-max和/proc/sys/vm/max_map_count是否足够。
六、其他 OOM 类型速览
6.1 GC overhead limit exceeded
java.lang.OutOfMemoryError: GC overhead limit exceeded 意味着 JVM 花费了超过 98% 的时间在 GC 上,但每次 GC 只能回收不到 2% 的堆空间。这通常发生在堆空间极度不足、GC 频繁但几乎无回收的"濒死"状态。
排查思路同 Java heap space,但需要更紧迫地处理——这通常意味着堆已经严重不足,或存在严重的内存泄漏。
6.2 Requested array size exceeds VM limit
当尝试分配一个超过 JVM 限制的数组时抛出(比如接近 Integer.MAX_VALUE 大小的数组)。这通常是代码 bug 导致计算的数组大小错误,而非真正的内存不足。
七、OOM 排查速查表
[图5:OOM排查速查表——四种OOM类型的日志特征、监控指标、排查命令、根因、修复方向对照表]
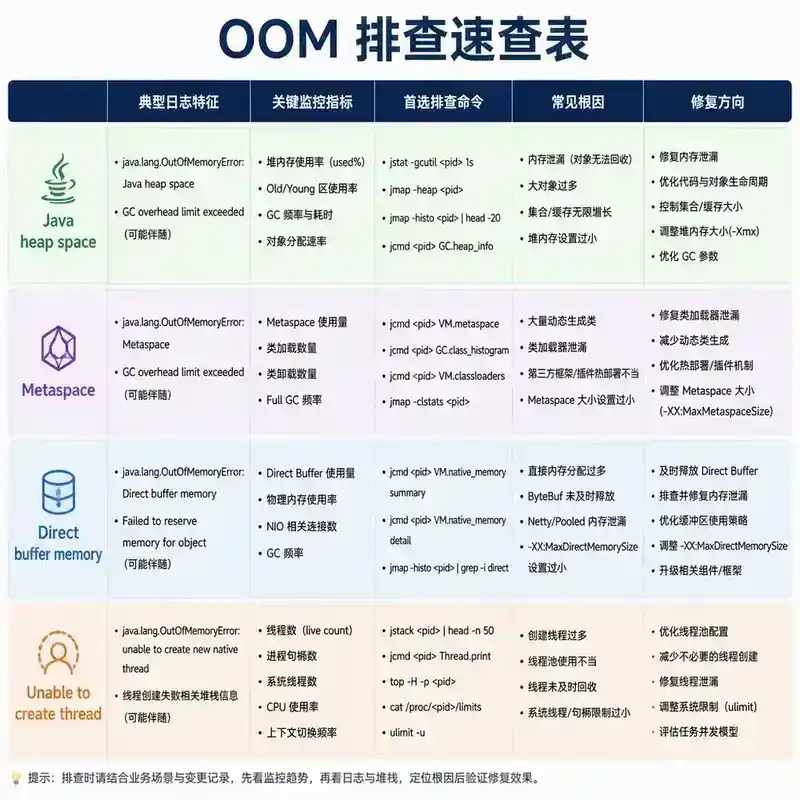
| OOM 类型 | 关键监控指标 | 首选排查命令 | 常见根因 | 修复方向 |
|---|---|---|---|---|
| Java heap space | 堆使用率、Full GC 频率/回收量 | jmap dump + MAT 分析 | 内存泄漏 / 容量不足 | 修代码 / 扩容 |
| Metaspace | MU (Metaspace utilization) | jstat -gc / jcmd class_stats | 动态代理泛滥 / 类加载器泄漏 | 限制 MaxMetaspaceSize / 修代码 |
| Direct buffer memory | 进程 RSS - 堆大小 | NMT summary / pmap | DirectByteBuffer 未释放 / Netty 泄漏 | 显式设 MaxDirectMemorySize / 修代码 |
| Unable to create thread | 线程数、-Xss | ulimit -u / jstack | 线程泄漏 / 线程池过大 / Xss 过大 | 调小 Xss / 修代码 / 调 ulimit |
八、面试常见误区纠正
- "OOM 就是堆满了" —— 错误。OOM 有六种类型,只有 Java heap space 是堆问题,Metaspace、Direct buffer、线程耗尽、GC overhead 都有各自的独立原因。
- "遇到 OOM 就调大 -Xmx" —— 对 Direct buffer memory 和线程耗尽无效,对 Metaspace 无效(除非堆大小间接影响了 Metaspace 的 GC 触发),对内存泄漏有害(更大的堆意味着更长的 Full GC 暂停)。
- "直接内存的 -XX:MaxDirectMemorySize 默认等于 -Xmx,所以不用管" —— 危险。如果你的堆设置了 8G,但直接内存实际需要 4G,而默认也等于 8G 看似够用,但如果堆实际使用都快满了,GC 触发时机可能不及时,直接内存可能已经 OOM 了。
- "线程耗尽?调大内存就好了" —— 不对。线程耗尽和内存没有直接关系,它受 ulimit -u 和 -Xss 和操作系统虚拟内存限制,调大 -Xmx 可能反而加剧问题(因为每个线程能分配到的虚拟地址空间更小了)。
九、总结
[图6:四种OOM类型全景对比图——JVM进程内存布局中标注每种OOM的发生位置,底部简述触发条件和解决方案]
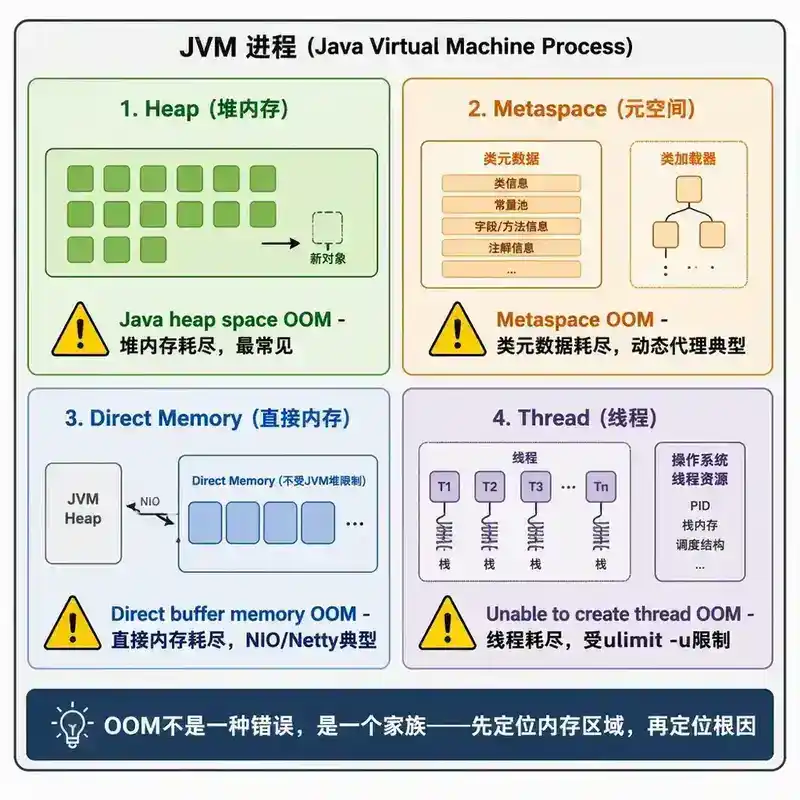
OOM 排查的核心原则是先定位内存区域,再定位根因:
- 先看 OOM 的具体类型——是堆、元空间、直接内存还是线程?
- 再判断是泄漏还是容量不足——通过监控趋势(持续增长→泄漏;随业务峰值波动→容量不足)。
- 最后针对性修复——泄漏修代码,容量调整参数。
本文覆盖的四种 OOM 类型,建议按以下顺序建立监控:
- 第一优先级:Java heap space(最频繁,影响最大)
- 第二优先级:Metaspace(一旦发生,应用直接不可用)
- 第三优先级:Direct buffer memory(Netty/NIO 应用必监控)
- 第四优先级:线程数(高并发服务必监控)
记住:OOM 不是终点,而是排查的起点。 错误信息本身已经告诉了你内存区域,下一步就是沿着这个线索追下去。
延伸阅读
- 《深入理解 Java 虚拟机》(周志明)第 2 章和第 4 章
- Oracle 官方文档:Understand the OutOfMemoryError Exception
- MAT(Memory Analyzer Tool)官方教程:Dominator Tree 和 Path to GC Roots
- 本系列相关篇目:062(Minor/Major/Full GC)、065(内存泄漏分析的堆转储和支配树)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 OOM 排查的实战经验和深度理解。
Q1:线上服务突然 OOM 重启,日志里只有**Java heap space**,没有 dump 文件(没加 HeapDumpOnOutOfMemoryError)。现在服务已经重启恢复了,你该怎么排查?
这是典型的"事后排查"场景,没有 dump 文件但仍有线索。我会按以下顺序:
- 先看 GC 日志:OOM 前几分钟的 GC 频率和回收量。如果 Full GC 越来越频繁且回收量越来越小,大概率是内存泄漏;如果 GC 频率正常但突然 OOM,可能是某次请求分配了超大对象。
- 查看 OOM 前后的请求日志:是否有异常的大批量查询、大文件上传、报表导出等操作,这些操作可能瞬间分配大量对象。
- 查看 JVM 的
-Xmx设置和容器内存限制:是否容器内存限制接近 -Xmx,导致堆外内存挤占了堆空间。 - 如果以上都找不到线索,加上
-XX:+HeapDumpOnOutOfMemoryError和-XX:HeapDumpPath后观察,等待下次发生。
Q2:你用 jstat 看到 Metaspace 的 MU 一直在涨,但还没有 OOM。你怎么判断是不是正常的类加载,还是类加载器泄漏?
关键看两个指标:类加载总数和类卸载总数。jstat -gc 的 CCSC(压缩类空间容量)和 CCSU(已使用)直接反映类元数据占用。如果 CCSU 持续增长而 YGC 和 FGC 的次数正常但类卸载从未发生,说明类只加载不卸载,大概率是泄漏。
另外,jstat -class(或 jcmd <pid> GC.class_stats)可以看 Loaded 和 Unloaded 的差值。正常应用启动后类加载会趋于稳定——如果 Loaded - Unloaded 持续增长,就值得警惕。最后,用 Arthas 的 classloader 命令查看是否有大量同类型类加载器实例(比如 1000 个 GroovyClassLoader),这是最直接的证据。
Q3:直接内存 OOM 和堆内存 OOM 的日志很像,都报 OutOfMemoryError。你如何在不看完整日志的情况下,一眼区分是哪种 OOM?
看错误消息的具体文字。Java heap space 是 java.lang.OutOfMemoryError: Java heap space,Direct buffer memory 是 java.lang.OutOfMemoryError: Direct buffer memory——消息本身就已经区分了。但如果日志被截断或只记录了 OutOfMemoryError,可以通过以下间接判断:
- 堆 OOM 通常伴随频繁 Full GC 日志,直接内存 OOM 的 GC 日志可能完全正常(因为堆并不满)。
- 用
jcmd <pid> VM.native_memory summary看 Native Memory Tracking 中 Direct 区域的 committed 值,和-XX:MaxDirectMemorySize对比。 - 如果进程 RSS 远大于 -Xmx + Metaspace + 线程数 × Xss,差额大概率是直接内存或其他堆外内存。
Q4:一个服务有 2000 个线程,你把它迁移到 JDK 21 的虚拟线程后,是不是就不会再遇到 unable to create new native thread 了?
不完全是。虚拟线程极大降低了线程创建的内存开销(虚拟线程不绑定 1:1 到 OS 线程),但虚拟线程最终还是要运行在少量的平台线程(Carrier Thread)上。平台线程数通常等于 CPU 核心数,远小于 2000。所以迁移到虚拟线程后,os 线程数从 2000 降到几十个,unable to create new native thread 问题基本消失了。
但还有两个边界情况:一是如果代码中使用了 synchronized 块,虚拟线程在遇到 synchronized 时会 pin 住平台线程,高并发下可能导致平台线程池耗尽,效果退化为平台线程;二是如果代码中调用了 JNI 或使用了 ForkJoinPool 之外的自定义线程池,虚拟线程的优势可能被削弱。所以迁移到虚拟线程前,需要先排查代码中的 synchronized 用法和 JNI 调用。
Q5:你的应用同时出现了 Java heap space OOM 和 Direct buffer memory OOM,你觉得它们之间有关联吗?怎样关联起来的?
有很强的关联性。直接内存的回收依赖 GC 触发 Cleaner 机制——当 DirectByteBuffer 对象在堆上被 GC 回收时,才会释放其关联的直接内存。如果堆配置很大(比如 8G)但实际使用只有 3G,JVM 可能很久不触发 GC,导致大量"已死"的 DirectByteBuffer 对象堆积在堆上,其关联的直接内存也没被释放。最终直接内存先于堆内存 OOM。
这就是"堆内存看似充足,但直接内存已经 OOM"的经典场景。解决方案:要么显式调小 -XX:MaxDirectMemorySize 让直接内存 OOM 更早触发(至少能留下明确的现场),要么在代码中主动调用 System.gc() 触发 GC 来回收 DirectByteBuffer(但这不是好方案),要么升级到 JDK 11+ 改进直接内存回收机制,要么从代码层面使用 Netty 的对象池复用 ByteBuf 避免频繁分配释放。