一、GC 收集器的演进之路
上一篇我们讨论了 GC 的基础算法(标记-清除、标记-复制、标记-整理、分代收集),但算法只是理论,真正执行 GC 的是垃圾收集器(Garbage Collector)。不同的收集器采用不同的算法组合和实现策略,在吞吐量、停顿时间和内存占用之间做出不同的权衡。
HotSpot JVM 提供了多种垃圾收集器,按照演进历程可以分为三个阶段:经典收集器(Serial、Parallel、CMS)→ 现代收集器(G1、Shenandoah)→ 下一代收集器(ZGC)。本篇聚焦于三种经典收集器,它们虽然"年事已高",但在面试中仍然高频出现,而且理解它们是理解现代 GC 的基础。
二、Serial 收集器:最古老、最简单、最"单线程"
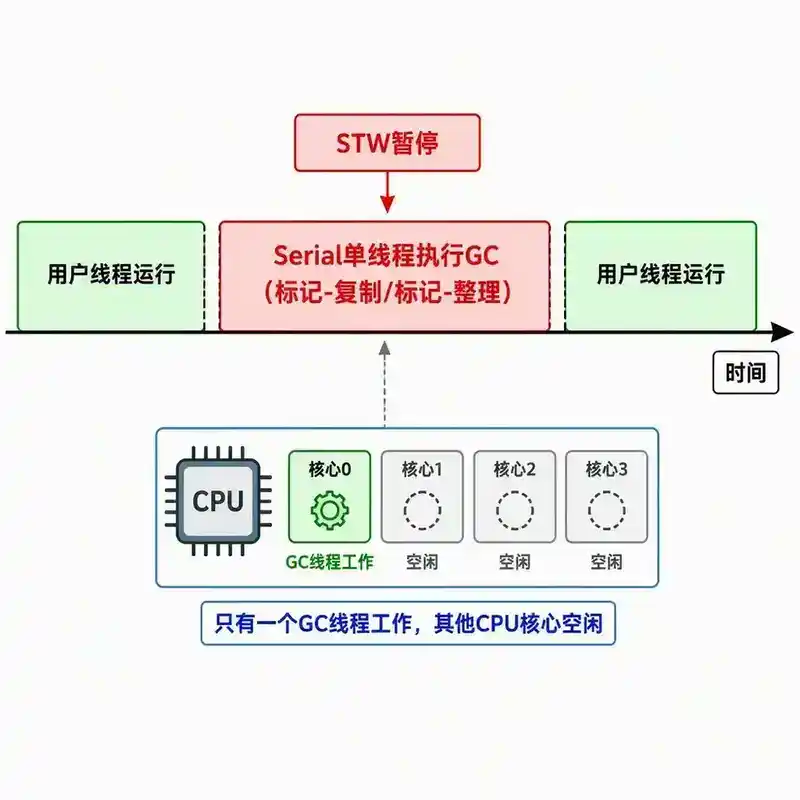
Serial 收集器是 HotSpot 最基础、历史最悠久的收集器,它在 JDK 1.3.1 之前是 JVM 新生代收集的唯一选择。Serial 的含义是"串行"——它是一条单线程运行的收集器,且在 GC 工作时必须暂停所有用户线程(Stop-The-World),直到 GC 完成。
新生代(Serial):使用标记-复制算法,单线程执行。
老年代(Serial Old):使用标记-整理算法,单线程执行。
工作过程:用户线程运行 → 触发 GC → 所有用户线程暂停 → 单线程执行 GC → GC 完成 → 恢复用户线程。
优点:
- 简单高效,没有线程交互的开销,单线程 GC 的 CPU 时间最小。
- 对于内存较小的应用(如几十 MB 到一二百 MB),停顿时间可以控制在几十到一百多毫秒内,完全可以接受。
- 是唯一一个在客户端模式下可用的新生代收集器(JDK 8 及之前)。
缺点:
- 多核 CPU 场景下无法利用多核优势,其他 CPU 核心在 STW 期间完全空闲。
- 堆内存越大,STW 时间越长,不适合大内存应用。
适用场景:桌面应用、小型嵌入式系统、客户端模式下的 Java 应用。在容器化部署中,如果单容器内存很小(如 128MB),Serial 收集器反而可能是最优选择,因为它的简单性避免了多线程协调的开销。
三、Parallel 收集器:吞吐量优先的"多线程 Serial"
Parallel 收集器(也叫 Parallel Scavenge)是 Serial 收集器的多线程版本,目标不是缩短单次 GC 的停顿时间,而是最大化吞吐量(Throughput)——即用户代码运行时间占总时间的比例。
新生代(Parallel Scavenge):使用标记-复制算法,多线程并行执行。
老年代(Parallel Old):使用标记-整理算法,多线程并行执行。
核心参数:
-XX:MaxGCPauseMillis:目标最大停顿时间(毫秒),GC 会尽量满足这个目标,但可能以牺牲吞吐量和新生代大小为代价。-XX:GCTimeRatio:吞吐量目标,值为1/(1+N),默认N=99,即 GC 时间不超过总时间的 1%。-XX:ParallelGCThreads:GC 线程数,默认等于 CPU 核心数。
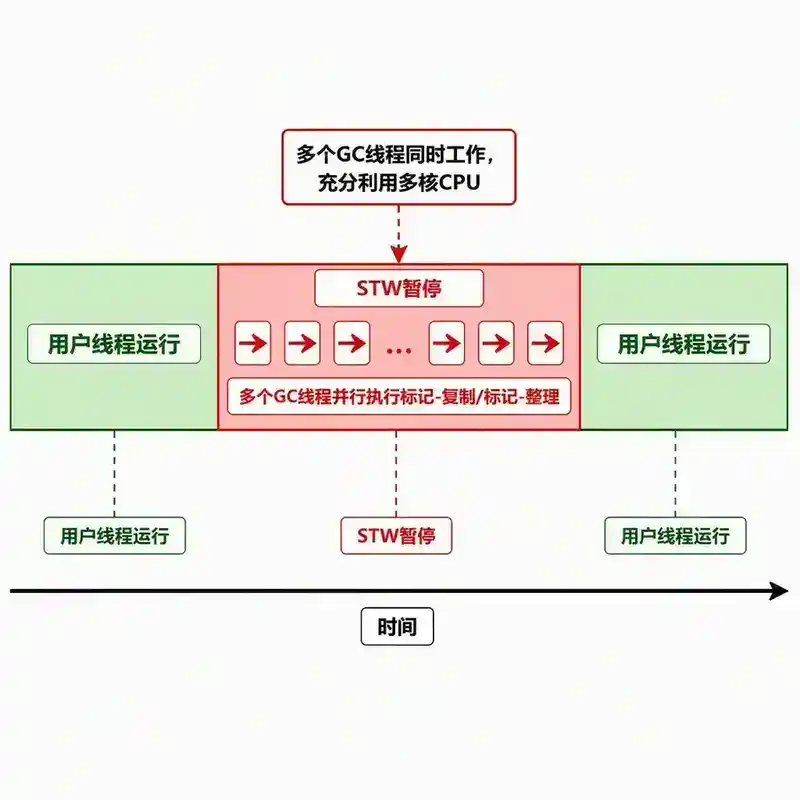
与 Serial 的关键区别:Parallel 收集器在 GC 时使用多个线程并行工作,所有用户线程仍然被暂停(STW),但 GC 本身是多线程执行的,因此 GC 的停顿时间比 Serial 短得多,尤其在大内存/多核场景下。
适用场景:后台计算型应用(批处理、科学计算、数据 ETL 等),这些场景不需要低延迟,但追求高吞吐量——即"让程序尽可能快地处理完所有任务,偶尔的停顿可以接受,但总体 CPU 利用率要高"。JDK 8 及之前是服务端模式的默认收集器。
四、CMS 收集器:低延迟优先的"并发"收集器
CMS(Concurrent Mark Sweep)收集器是 HotSpot 第一款真正意义上的并发收集器——它允许 GC 线程与用户线程同时工作(在某些阶段),目标是最小化停顿时间。CMS 是"低延迟优先"收集器的里程碑,虽然已被 G1 取代,但它的设计思想深刻影响了后续所有低延迟 GC。
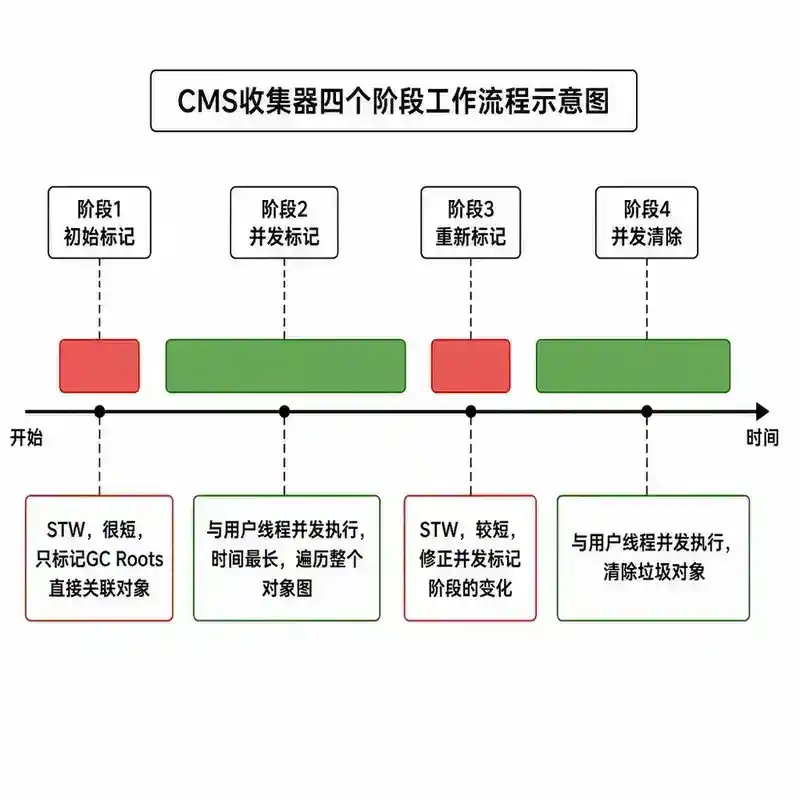
工作过程:四个阶段
1. 初始标记(Initial Mark,STW):标记 GC Roots 能直接关联到的对象。这个阶段需要 STW,但只标记 GC Roots 直接关联的对象,速度很快。
2. 并发标记(Concurrent Mark):从 GC Roots 出发,遍历整个对象图,标记所有可达对象。这个阶段与用户线程并发执行,不暂停应用。但由于用户线程可能修改引用关系,可能产生漏标,需要后续阶段修正。
3. 重新标记(Remark,STW):修正并发标记阶段因用户线程运行导致的标记变化。这个阶段需要 STW,但只处理并发标记阶段变化的部分,比初始标记略长但远短于并发标记。
4. 并发清除(Concurrent Sweep):清除所有未被标记的对象。这个阶段与用户线程并发执行,不暂停应用。由于使用的是标记-清除算法,不会移动存活对象,也就不需要 STW 来更新引用。
CMS 的三大缺陷
缺陷一:对 CPU 资源敏感。CMS 的并发阶段会占用一部分 CPU 核心(默认使用 (CPU核心数+3)/4 个线程),减少用户线程可用的 CPU 资源。在 CPU 核心数较少的环境下(如 2 核),CMS 的并发开销会明显拖慢用户程序。
缺陷二:无法处理"浮动垃圾"。并发清除阶段,用户线程仍在运行,可能产生新的垃圾("浮动垃圾"),这些垃圾无法在本次 GC 中被清除,只能等待下一次 GC。因此 CMS 不能等到老年代完全满了才触发 GC,需要预留一部分空间给并发阶段的用户线程分配对象。默认在老年代使用率达到 92%(-XX:CMSInitiatingOccupancyFraction)时触发 GC。如果预留空间不足,就会发生并发模式失败(Concurrent Mode Failure),此时 CMS 会回退到 Serial Old 收集器进行单线程的标记-整理,导致一次长时间的 STW。
缺陷三:内存碎片。CMS 使用标记-清除算法,不移动对象,长时间运行后会产生内存碎片。当碎片严重到无法分配大对象时,同样会触发 Full GC(回退到 Serial Old 做整理)。CMS 提供了 -XX:+UseCMSCompactAtFullCollection 参数(默认开启),在 Full GC 时进行碎片整理,但整理过程需要 STW。
适用场景
CMS 适合对响应时间要求高的交互式应用,如 Web 服务器、API 网关、在线交易系统等。这些场景下,偶尔一次的长时间停顿比持续的高 CPU 占用更不可接受。
五、三种收集器对比总结
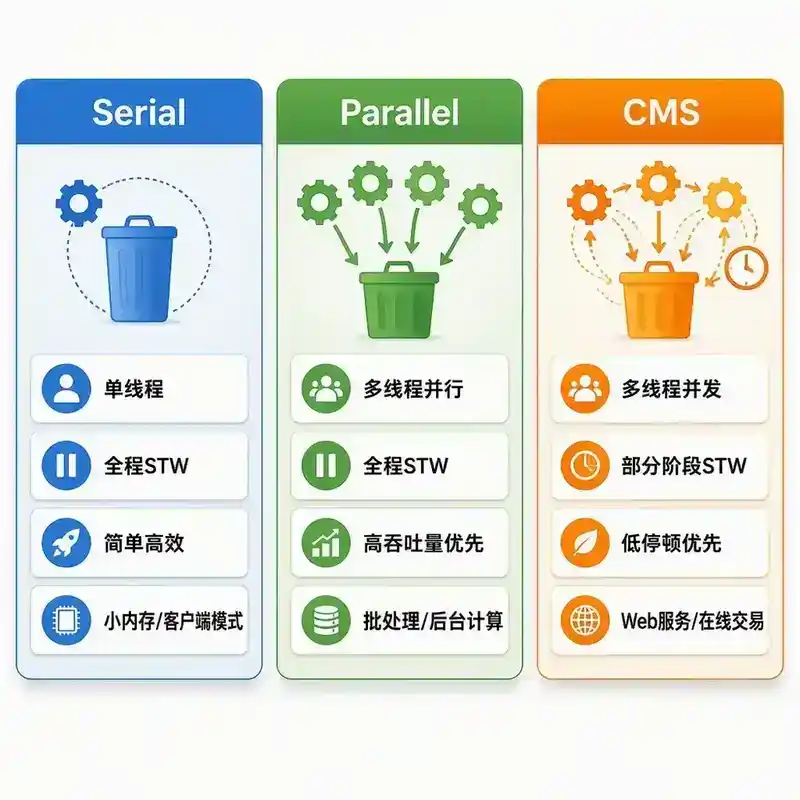
| 收集器 | 算法(新生代/老年代) | 线程模型 | 目标 | 最大特点 |
|---|---|---|---|---|
| Serial | 复制 / 标记-整理 | 单线程,全程 STW | 简单高效 | 小内存场景最优 |
| Parallel | 复制 / 标记-整理 | 多线程并行,全程 STW | 高吞吐量 | GC 期间多线程并行 |
| CMS | 复制 / 标记-清除 | 多线程,部分并发 | 低停顿 | 并发标记和并发清除 |
六、从 Serial 到 CMS 到 G1:GC 收集器演进的逻辑
理解这三种经典收集器,就能理解 GC 技术演进的底层逻辑:
- Serial:追求"简单",用单线程换来零协调开销,但 STW 随堆大小线性增长。
- Parallel:追求"高吞吐",用多线程并行缩短 STW,但 STW 仍然存在,停顿时间仍然不可控。
- CMS:追求"低延迟",用并发执行减少 STW 阶段,但并发带来了 CPU 占用、浮动垃圾和内存碎片等新问题。
- G1(后续章节):吸收 CMS 的经验教训,用分区域(Region)+ 可预测停顿模型,在低延迟和高吞吐之间找到更好的平衡。
这个演进路径的核心驱动力是:用户对"停顿时间可控"的需求越来越强烈。从 Serial 的"能停多久就停多久",到 Parallel 的"停得尽量短",到 CMS 的"尽可能不停",再到 G1 的"停多久可控"——每一次迭代都在向"可预测的低延迟"更近一步。
七、面试追问链
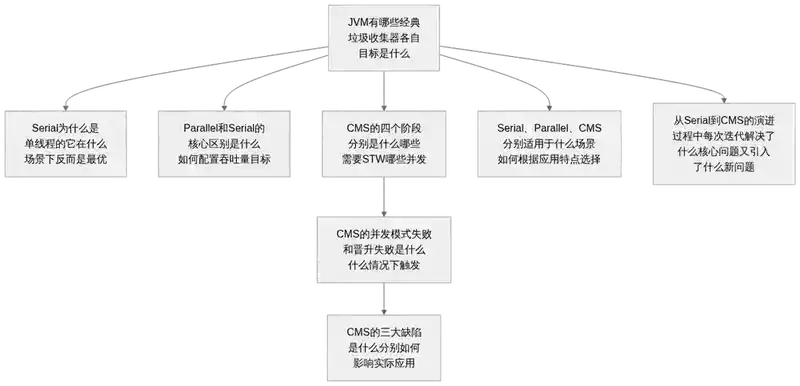
从"JVM 有哪些经典的垃圾收集器各自的目标是什么"这个基础问题出发,逐层追问:Serial 收集器为什么是单线程的它在什么场景下反而是最优选择、Parallel 收集器和 Serial 收集器的核心区别是什么如何配置吞吐量目标、CMS 收集器的四个阶段分别是什么哪些需要 STW 哪些并发执行、CMS 的并发模式失败和晋升失败分别是什么什么情况下触发、CMS 的三大缺陷是什么分别如何影响实际应用、Serial、Parallel、CMS 分别适用于什么场景如何根据应用特点选择、从 Serial 到 CMS 的演进过程中每次迭代解决了什么核心问题又引入了什么新问题。
延伸阅读
- 《深入理解 Java 虚拟机》(周志明)第 3.5 节,详细介绍了经典 GC 收集器
- HotSpot GC 调优指南(Oracle 官方文档),了解各收集器的参数配置
- 「04 JVM 原理与调优」系列下一篇(060)将深入 G1 收集器:Region 布局、Mixed GC 与可预测停顿
问答(不计入阅读时长)
Q1:Serial 在单核 CPU 和多核 CPU 上的表现有什么不同?为什么在某些容器化场景中 Serial 反而是最优选择?
A:在单核 CPU 上,Serial 是最优选择——它的单线程模型没有线程切换开销,GC 期间 CPU 利用率 100% 用于 GC 工作。在多核 CPU 上,Serial 只使用一个核心,其他核心在 STW 期间完全空闲,造成 CPU 资源浪费。但在容器化场景中,如果容器分配的内存很小(如 128MB-256MB)且 CPU 核数也很少(如 1-2 核),Serial 反而可能是最优选择:因为小内存意味着 GC 停顿很短(几十毫秒),而 Parallel 或 CMS 的多线程调度开销在这种场景下可能比 GC 本身还大。此外,Serial 的简单性使得它的内存占用和 CPU 消耗最小,对于资源受限的容器环境非常友好。JDK 的默认 GC 选择策略中,如果 JVM 检测到系统只有 1 个 CPU 核心或内存小于 1792MB,就会自动选择 Serial 收集器。
Q2:Parallel 收集器的吞吐量目标参数**-XX:GCTimeRatio**和**-XX:MaxGCPauseMillis**是如何相互作用的?如果两者冲突,哪个优先级更高?
A:-XX:GCTimeRatio=N 表示 GC 时间占总时间的比例为 1/(1+N),默认 N=99(即 GC 时间不超过 1%)。-XX:MaxGCPauseMillis 指定最大 GC 停顿时间。这两个参数本质上是冲突的:要缩短停顿时间,就需要更频繁地触发 GC(分配更少的堆空间),这会导致总 GC 次数增加,降低吞吐量;要提高吞吐量,就需要更大的堆空间和更少的 GC 次数,但每次 GC 的停顿时间会更长。Parallel 收集器以吞吐量为优先目标,如果两个参数冲突,GC 会优先满足吞吐量目标,仅在吞吐量目标可达成的前提下才尝试减少停顿时间。实际的调节策略是:JVM 会根据这两个参数动态调整新生代和老年代的大小,在吞吐量目标和停顿时间目标之间寻找平衡。
Q3:CMS 的并发标记阶段与用户线程"并发"执行,但实际上它们真的在"同时"跑吗?两者如何共享 CPU 资源?
A:CMS 的并发标记阶段与用户线程在逻辑上是"并发"的,但在物理上它们共享 CPU 核心。CMS 默认使用 (CPU核心数+3)/4 个线程进行并发标记,比如 8 核 CPU 上,CMS 使用约 2-3 个核心做 GC,剩下 5-6 个核心留给用户线程。如果 CPU 核心数较少(如 2 核),CMS 使用约 1 个核心,用户线程只剩 1 个核心,性能下降明显。这就是 CMS 对 CPU 资源敏感的根本原因。另外,"并发"并不意味着没有停顿——CMS 在初始标记和重新标记阶段仍然需要 STW,只是这两个阶段的时间远短于 Parallel 的全量 STW。"并发"只意味着 GC 线程和用户线程可以同时运行,而不是同时运行且互不干扰。
Q4:CMS 的"并发模式失败"(Concurrent Mode Failure)是什么?它和"晋升失败"(Promotion Failed)有什么区别?
A:并发模式失败发生在:CMS 并发收集老年代期间,用户线程仍在运行并分配新对象到老年代,如果老年代空间在 CMS 完成之前就被填满了,CMS 将无法继续,此时 JVM 会回退到 Serial Old 收集器进行单线程的标记-整理,导致一次长时间的 STW。晋升失败发生在:Minor GC 时,Survivor 区无法容纳所有存活对象,需要将部分对象晋升到老年代,但老年代也没有足够空间——这通常发生在老年代碎片化严重或老年代已满的情况下。两者都会触发 Full GC,但触发机制不同:并发模式失败是 CMS 并发收集过程中的空间不足,晋升失败是 Minor GC 时的晋升操作失败。区分两者的方法:GC 日志中会明确标注 Concurrent Mode Failure 或 Promotion Failed。
Q5:CMS 使用标记-清除算法导致内存碎片,为什么它不直接使用标记-整理算法?如果使用标记-整理,CMS 会面临什么问题?
A:CMS 选择标记-清除而不是标记-整理,是因为标记-整理的"整理"阶段需要移动存活对象并更新所有引用,这个操作必须全程 STW——如果 CMS 使用标记-整理,它的"并发清除"阶段就无法实现了,CMS 的低停顿优势也就不复存在。CMS 的设计目标就是"尽可能减少 STW 时间",因此它宁愿接受标记-清除带来的碎片问题,也不愿意放弃并发清除。CMS 通过 -XX:+UseCMSCompactAtFullCollection 在发生 Full GC 时进行碎片整理作为补偿,但这个整理是 STW 的。G1 通过 Region 级别的标记-复制巧妙解决了这个问题——在 Region 级别做复制,避免了全局整理的开销,同时保持了无碎片的内存布局。
Q6:从 Serial 到 Parallel 到 CMS 的演进中,每次迭代"新引入了什么问题"?这些新问题又是如何被下一代收集器解决的?
A:Serial 到 Parallel:引入了多线程协调开销——多个 GC 线程需要同步工作,线程间的竞争和通信增加了 CPU 开销。但 Parallel 的吞吐量提升远超这个开销,所以整体收益是正的。Parallel 到 CMS:引入了三个新问题——CPU 资源敏感(并发阶段占用 CPU)、浮动垃圾(并发清除期间用户线程产生的新垃圾无法清除)、内存碎片(标记-清除不整理内存)。CMS 到 G1:G1 用 Region 级标记-复制解决了碎片问题,用可预测停顿模型解决了不可控的 STW 时间,用 Mixed GC 解决了浮动垃圾。G1 到 ZGC:ZGC 用染色指针和数据平面隔离进一步将 STW 压缩到亚毫秒级。这个演进路径清晰展示了 GC 设计的核心 trade-off:每次改进一个维度,往往会在其他维度上引入新的挑战。
Q7:在 JDK 14 中 CMS 被正式标记为废弃(Deprecated),JDK 15 中默认移除了 CMS 的实现。为什么 CMS 被弃用?它的替代者 G1 相比 CMS 有哪些本质优势?
A:CMS 被弃用的根本原因是维护成本高且存在无法修复的架构性缺陷:碎片问题需要回退到 Serial Old 做整理,这在架构上无法根治;并发模式失败的风险随着堆大小增长而加剧;CMS 的代码复杂度高,修复 bug 的难度大。G1 相比 CMS 的本质优势:(1)Region 级标记-复制彻底消除了碎片问题;(2)可预测的停顿模型(-XX:MaxGCPauseMillis),CMS 的停顿不可预测;(3)Mixed GC 可以在年轻代 GC 的同时回收部分老年代,避免 CMS 那种"老年代快满了才回收"的被动模式;(4)G1 的并发标记使用 SATB(Snapshot-At-The-Beginning)算法,比 CMS 的增量更新(Incremental Update)更高效且更少漏标。G1 已经成为 JDK 9+ 的默认收集器,CMS 的退出是 GC 技术自然演进的必然结果。
Q8:如果让你为以下三个场景分别选择 GC 收集器,你会怎么选?(1)4 核 8G 内存的 Web 服务器;(2)32 核 128G 内存的批处理系统;(3)2 核 512MB 内存的容器化微服务。请说明理由。
A:(1)Web 服务器:选择 G1(JDK 9+ 默认)。Web 服务器需要低延迟响应,G1 的可预测停顿模型和 Region 级回收非常适合。如果 JDK 版本较低必须用经典收集器,选择 CMS(但注意 CMS 在 JDK 14+ 已移除)。4 核 CPU 足够 CMS 和用户线程共享。(2)批处理系统:选择 Parallel(Parallel Scavenge + Parallel Old)。批处理追求高吞吐量,不在乎单次停顿时间,Parallel 的多线程并行回收能够最大化 CPU 利用率,减少 GC 总时间。32 核 CPU 可以分配给 Parallel 足够的 GC 线程数。(3)容器化微服务:选择 Serial。512MB 内存下,GC 停顿通常在几十毫秒以内,完全可接受。Serial 的单线程模型避免了多线程协调开销,内存和 CPU 占用最小,对资源受限的容器环境最友好。如果容器内存较大(如 4GB+),则考虑使用 G1 并设置合理的 -XX:MaxGCPauseMillis。