一、垃圾回收算法的三个维度
上一篇我们讨论了 GC 如何判定对象是否存活(可达性分析),但知道"谁是垃圾"只是第一步,接下来要回答的问题是:如何回收这些垃圾? 这个问题的答案就是垃圾回收算法。
评价一个垃圾回收算法的优劣,通常从三个维度来衡量:
- 吞吐量(Throughput):用户代码运行时间占总时间的比例。高吞吐量意味着 GC 占用的 CPU 时间少,适合后台计算型应用。
- 停顿时间(Pause Time):GC 导致用户线程暂停的时间。低停顿时间对于交互式应用(如 Web 服务)至关重要。
- 内存碎片(Fragmentation):GC 后剩余内存的连续性。内存碎片过多会导致大对象无法分配,即使总体空闲内存充足。
没有任何一种算法能同时在这三个维度上做到最优——这是 GC 算法设计的核心 trade-off。理解每种算法的优劣,才能理解现代 GC 为什么要把多种算法组合使用。
二、标记-清除(Mark-Sweep):最基础、最直观
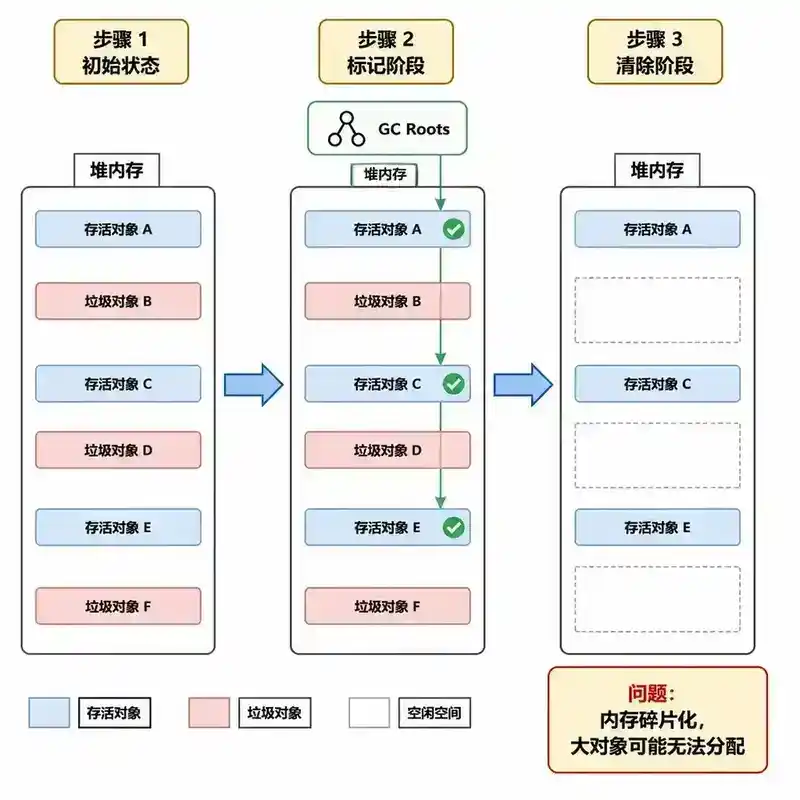
标记-清除算法是最基础的 GC 算法,分为两个阶段:
标记阶段(Mark):从 GC Roots 出发,遍历所有可达对象,将其标记为"存活"。
清除阶段(Sweep):线性遍历整个堆,将未被标记的对象回收(将它们的空间标记为空闲),然后将已标记对象的标记清除(为下一次 GC 做准备)。
优点:实现简单,不需要移动对象,回收过程不改变对象的地址。
缺点:
- 效率不稳定:标记和清除两个阶段的效率都随堆中对象数量增长而下降。
- 内存碎片:清除后会产生大量不连续的内存碎片,碎片过多时,即使总空闲内存足够,也可能无法分配一个大对象,从而提前触发下一次 GC。
三、标记-复制(Mark-Copy):新生代的主力算法
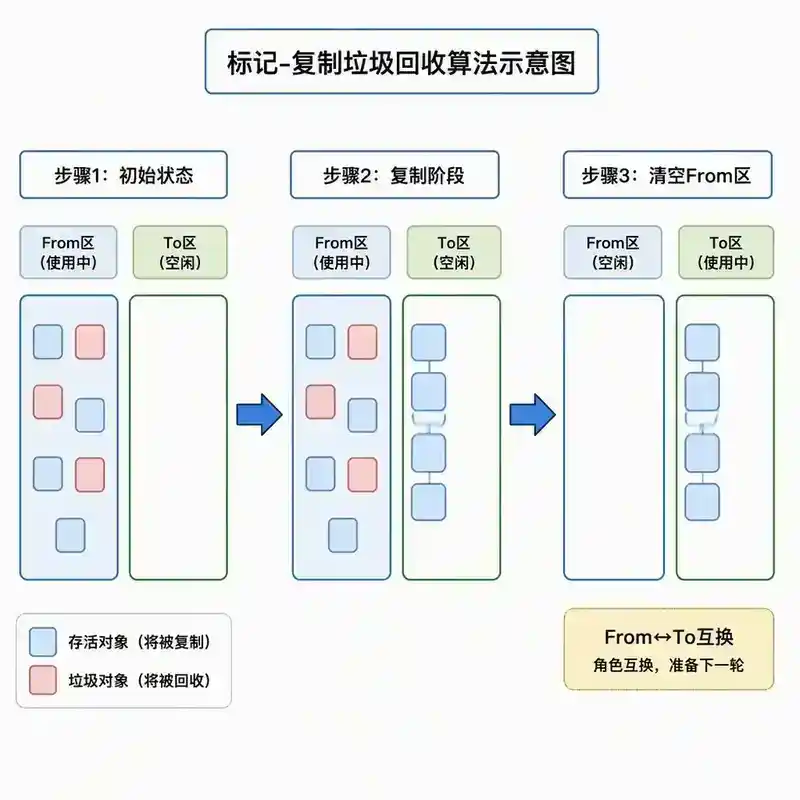
标记-复制算法将可用内存分为两块大小相等的区域(From 和 To),每次只使用其中一块。GC 时,将存活对象从 From 区复制到 To 区,然后直接清空整个 From 区。复制完成后,From 和 To 的角色互换。
优点:
- 无内存碎片:复制后存活对象紧密排列在 To 区,内存完全规整。
- 分配效率极高:只需移动指针(指针碰撞),不需要维护空闲列表。
- 实现简单:清理就是直接清空整个 From 区,不需要遍历。
缺点:
- 内存利用率低:只有一半的可用内存能被使用,另一半始终空闲。
- 复制开销大:如果存活对象很多,复制操作本身耗时较大。
- 不适合老年代:老年代中存活对象比例高,复制成本太大。
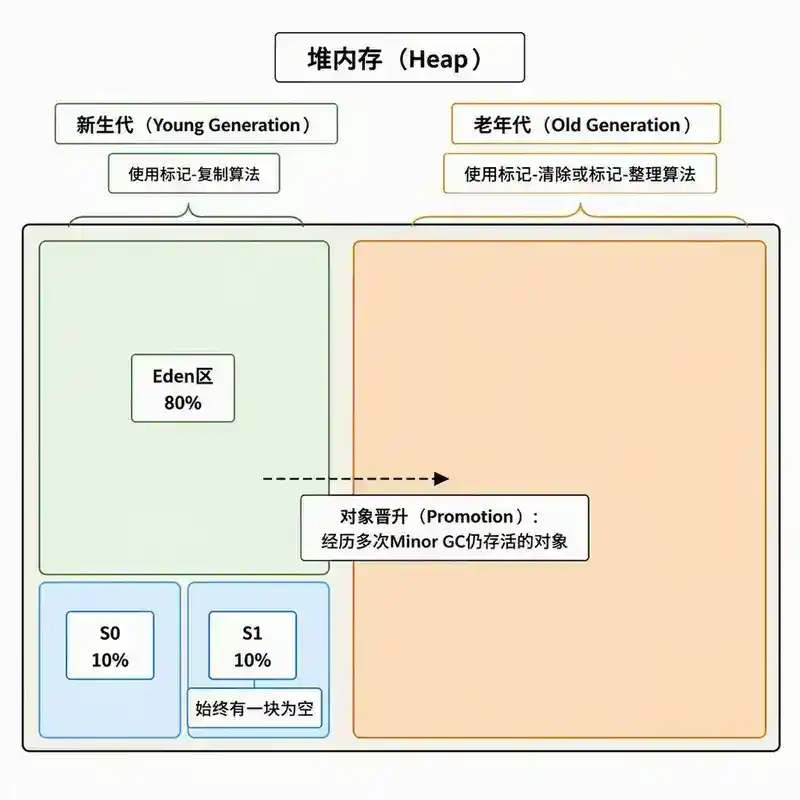
HotSpot 的优化版本:在新生代中,HotSpot 没有使用 1:1 的 From/To 划分,而是采用 Eden + 两块 Survivor(S0 和 S1)的布局,比例约为 8:1:1(Eden 占 80%,两块 Survivor 各占 10%)。这样内存利用率从 50% 提升到了 90%,只有 10%(一块 Survivor)始终空闲。
四、标记-整理(Mark-Compact):老年代的解决方案
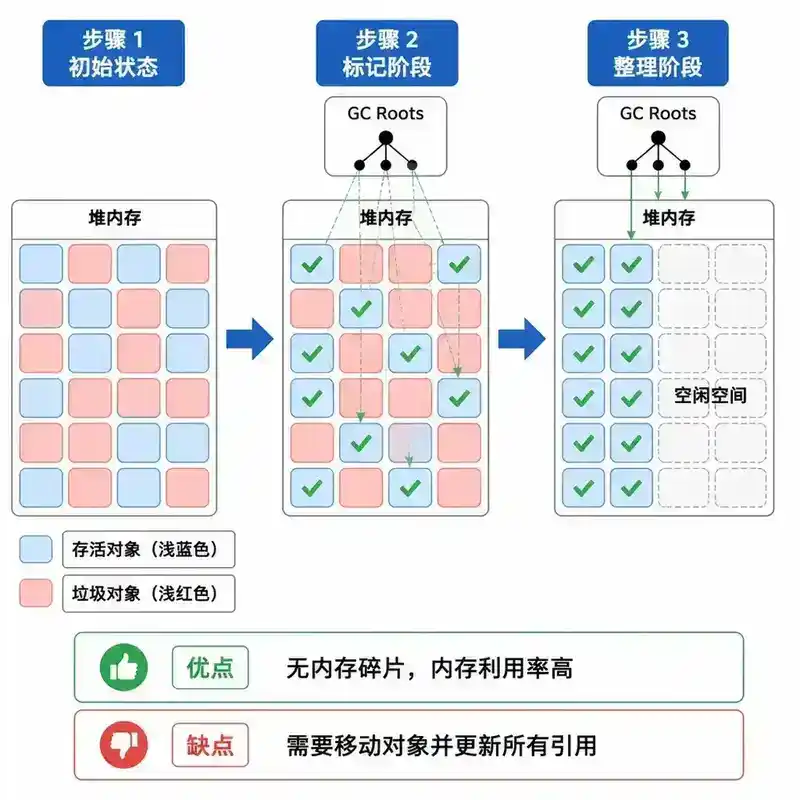
标记-整理算法结合了标记-清除和标记-复制的优点。它也分为标记和整理两个阶段:
标记阶段:与标记-清除完全一致,标记所有存活对象。
整理阶段:将所有存活对象向内存的一端移动,整理成连续的一片,然后直接清理边界之外的内存。
优点:
- 无内存碎片:整理后内存规整,可以用指针碰撞分配。
- 内存利用率高:不像复制算法那样浪费一半内存。
缺点:
- 对象移动开销大:移动对象时需要更新所有指向该对象的引用(栈上、堆上其他对象、OopMap 中的引用),这是一个"全堆更新"的操作。
- STW 时间长:标记-整理通常需要全程 STW,停顿时间比标记-清除长。
五、分代收集(Generational Collection):组合拳
分代收集不是一种独立的算法,而是将上述三种算法按内存区域组合使用的策略。它基于两个核心假设:
- 弱分代假说(Weak Generational Hypothesis):绝大多数对象都是"朝生夕死"的——它们很快变为垃圾。
- 强分代假说(Strong Generational Hypothesis):熬过越多次 GC 的对象,越不容易变成垃圾。
基于这两个假设,JVM 将堆内存划分为新生代(Young Generation)和老年代(Old Generation),针对不同区域使用不同的 GC 算法:
- 新生代(Young Generation):对象存活率低,每次 GC 大部分对象都是垃圾。使用标记-复制算法(Eden + S0/S1),每次只复制少量存活对象,效率很高。
- 老年代(Old Generation):对象存活率高,每次 GC 大部分对象存活。使用标记-清除或标记-整理算法(取决于具体的 GC 器),避免频繁复制的大量开销。
新生代 GC 称为 Minor GC(Young GC),触发频率高、速度快(通常在几十毫秒内)。老年代 GC 称为 Major GC / Full GC,触发频率低、速度慢(通常比 Minor GC 慢 10 倍以上),通常会伴随至少一次 Minor GC。
六、四种算法对比总结
| 算法 | 内存碎片 | 内存利用率 | 停顿时间 | 典型适用场景 |
|---|---|---|---|---|
| 标记-清除 | 严重 | 高 | 较短 | 老年代(CMS) |
| 标记-复制 | 无 | 低(50%) | 短 | 新生代 |
| 标记-整理 | 无 | 高 | 最长 | 老年代(Serial Old、Parallel Old) |
| 分代收集 | 组合使用 | 高 | 综合 | 所有现代 JVM |
七、面试追问链
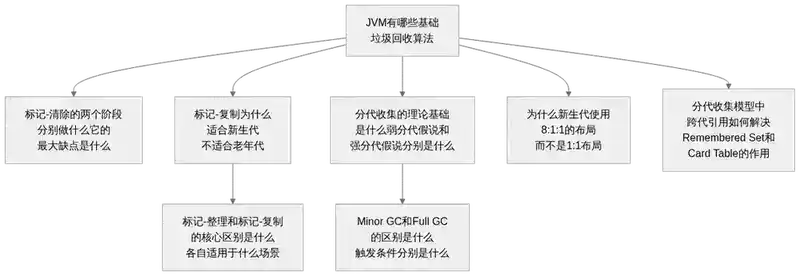
从"JVM 有哪些基础的垃圾回收算法"这个基础问题出发,逐层追问:标记-清除的两个阶段分别做什么它的最大缺点是什么、标记-复制为什么适合新生代不适合老年代、标记-整理和标记-复制的核心区别是什么各自适用于什么场景、分代收集的理论基础是什么弱分代假说和强分代假说分别是什么、Minor GC 和 Full GC 的区别是什么触发条件分别是什么、为什么新生代使用 8:1:1 的 Eden/S0/S1 布局而不是 1:1 的 From/To 布局、分代收集模型中跨代引用如何解决 Remembered Set 和 Card Table 的作用。
延伸阅读
- 《深入理解 Java 虚拟机》(周志明)第 3.3 节,详细介绍了垃圾回收算法
- HotSpot 源码
src/hotspot/share/gc/shared目录下的 GC 算法实现 - 「04 JVM 原理与调优」系列下一篇(059)将深入 HotSpot 经典 GC 器(Serial、Parallel、CMS、G1)
问答(不计入阅读时长)
Q1:标记-清除算法的"清除"阶段具体做了什么?为什么说它会产生内存碎片?内存碎片在什么情况下会变成真正的问题?
A:"清除"阶段线性遍历整个堆,找到所有未被标记的对象,将它们占用的内存空间标记为"空闲"(通常通过空闲列表 Free List 管理)。它不移动任何存活对象,所以存活对象之间的空隙(被回收的垃圾对象原本的位置)会保留下来,形成不连续的内存碎片。内存碎片在以下情况下变成问题:当需要分配一个较大的对象时,即使总空闲内存足够,但由于没有一块连续的空闲空间能容纳这个大对象,分配就会失败,从而提前触发 Full GC 甚至 OOM。CMS 作为使用标记-清除算法的老年代 GC,在碎片化严重时不得不回退到 Serial Old 的标记-整理来压缩内存,这就是 CMS 的"并发模式失败"(Concurrent Mode Failure)的一种表现形式。
Q2:标记-复制算法为什么新生代使用 8:1:1(Eden:S0:S1)的布局,而不是 1:1 的 From/To 布局?这两种布局各自的优势是什么?
A:1:1 布局(From/To 各占 50%)内存利用率只有 50%,浪费严重。HotSpot 观察到绝大多数新生代对象在第一次 Minor GC 时就会被回收(弱分代假说),因此只有极少数对象需要被复制到 Survivor 区。基于这个观察,HotSpot 将新生代划分为一个大的 Eden 区(80%)和两块小的 Survivor 区(各 10%),内存利用率从 50% 提升到 90%。极端情况下,如果 Survivor 区空间不够容纳所有存活对象,这些对象会通过"空间分配担保"(Allocation Guarantee)机制直接进入老年代,避免 Survivor 溢出。8:1:1 布局的代价是:如果某次 Minor GC 后存活对象特别多(超过了 Survivor 的 10%),就会触发过早晋升(Premature Promotion),增加老年代的压力。
Q3:标记-整理算法中,整理阶段需要更新所有指向被移动对象的引用。这个"更新所有引用"具体是怎么做的?为什么这个操作这么耗时?
A:当一个对象被移动后,所有指向该对象的引用(包括栈上的局部变量引用、堆中其他对象的字段引用、静态变量引用、JNI 引用等)都需要更新为新的地址。HotSpot 通过以下方式完成:整理阶段遍历整个堆,对于每个存活对象,读取其所有引用类型的字段,如果字段指向的对象发生了移动,就将字段值更新为新地址。栈上的引用通过 OopMap 精确定位并更新。这个操作之所以耗时,是因为它需要遍历整个堆中所有存活对象的所有引用字段,相当于"全堆扫描"。对于老年代这种存活对象多、对象大的区域,全堆更新引用的开销非常大,这也是为什么 Full GC 的停顿时间通常很长(几百毫秒到几秒)。
Q4:CMS 使用的是标记-清除算法,G1 使用的是标记-整理(局部),但为什么 CMS 的碎片问题比 G1 严重得多?
A:CMS 基于标记-清除算法,在整个老年代层面不做内存整理,长时间运行后碎片化严重。G1 虽然也使用标记-清除的思想,但它的整体策略是"标记-整理"的变体:G1 将堆划分为多个 Region,每次 GC 时选择回收价值最高的 Region(Garbage-First),在这些 Region 内部,G1 将存活对象复制到其他空闲 Region 中,然后清空整个 Region——这本质上是在 Region 级别做"标记-复制",避免了全局碎片问题。G1 的另一个优势是:它不会等到老年代满了才做 GC,而是通过"混合 GC"(Mixed GC)在年轻代 GC 的同时回收部分老年代 Region,持续保持老年代有足够的连续空闲空间。所以 G1 的碎片问题比 CMS 轻得多,这也是 G1 取代 CMS 成为默认 GC 的重要原因之一。
Q5:分代收集的"弱分代假说"和"强分代假说"在什么情况下会失效?如果失效了,JVM 会有什么表现?
A:弱分代假说(大多数对象朝生夕死)在以下场景可能失效:对象池(如连接池、线程池)中的对象生命周期很长,创建后不会被快速回收;缓存场景中,对象被创建后长期存活。强分代假说(活得越久越不容易死)在以下场景可能失效:某些对象在经历了多次 GC 后,因为业务逻辑变化而突然变成垃圾(如缓存过期、会话超时)。分代假说失效时,JVM 的表现是:新生代中存活对象比例异常高,导致 Survivor 区溢出,对象过早晋升到老年代;老年代中垃圾对象比例异常高,导致 Full GC 频繁但回收效果很差。这就是为什么 G1 和 ZGC 等现代 GC 逐渐弱化分代概念,而采用基于 Region 的分区回收策略——它们不依赖分代假说,对任何对象分布模式都能保持较好的回收效率。
Q6:Minor GC 和 Full GC 的触发条件分别是什么?为什么 Full GC 通常比 Minor GC 慢 10 倍以上?
A:Minor GC 的触发条件:Eden 区满,无法分配新对象。Full GC 的触发条件:老年代空间不足、元空间空间不足、System.gc() 调用(取决于 -XX:+DisableExplicitGC)、CMS 并发模式失败、晋升担保失败(Minor GC 时老年代剩余空间不足以容纳可能晋升的对象)。Full GC 比 Minor GC 慢 10 倍以上的原因:(1)Minor GC 只扫描新生代,对象少、存活率低,复制操作轻量;(2)Full GC 扫描整个堆(新生代+老年代+元空间),对象多、存活率高;(3)Full GC 通常需要做标记-整理,需要移动对象并更新所有引用,操作量巨大;(4)Full GC 的 STW 时间不可控,老年代越大停顿越长。
Q7:新生代中的对象晋升到老年代的条件是什么?除了年龄达到阈值,还有哪些情况会触发"提前晋升"?
A:对象晋升到老年代的条件有四个:(1)年龄达到 MaxTenuringThreshold(默认 15);(2)动态年龄判定:如果 Survivor 区中相同年龄的所有对象大小总和超过了 Survivor 空间的一半,那么年龄大于等于这个年龄的对象就可以直接晋升;(3)大对象直接分配在老年代:如果对象大小超过 -XX:PretenureSizeThreshold,直接在老年代分配,避免在新生代中复制;(4)Survivor 区空间不足:Minor GC 时,如果 Survivor 区无法容纳所有存活对象,多余的对象直接晋升到老年代。过早晋升(Premature Promotion)是需要警惕的现象:如果大量短命对象因为 Survivor 空间不足被提前晋升到老年代,它们很快会在老年代中变成垃圾,触发不必要的 Full GC,浪费 CPU 资源。
Q8:如果让你从零设计一个 GC,针对"低延迟"和"高吞吐"两个目标,你会分别选择什么算法组合?为什么?
A:低延迟目标(如 Web 服务、实时系统):选择标记-复制算法作为核心。因为标记-复制算法的 STW 时间只取决于存活对象数量,不取决于堆大小,可以通过控制存活对象数量来控制停顿时间。同时使用分代或分区策略,将回收工作分散到多次小停顿中,避免单次长时间 STW。参考设计:G1(Region 级标记-复制 + 并发标记)和 ZGC(染色指针 + 并发整理)。高吞吐目标(如批处理、科学计算):选择标记-整理算法用于老年代。因为标记-整理不浪费内存,内存利用率最高,虽然单次停顿时间长,但总 GC 次数少,CPU 开销低,适合"不在乎单次停顿但追求整体效率"的场景。参考设计:Parallel GC(Parallel Scavenge + Parallel Old)。核心权衡:低延迟需要更频繁的小 GC(复制算法),高吞吐需要更少但更彻底的大 GC(整理算法),两者不可兼得,这是 GC 设计中最根本的 trade-off。