一、G1 的设计哲学:可预测的停顿优于最高的吞吐量
G1(Garbage-First)收集器是 JDK 9 以来的默认垃圾收集器,它的设计目标是在低延迟和高吞吐之间找到平衡,但更偏向低延迟。G1 的核心设计哲学是:与其追求极致的吞吐量,不如追求可预测的停顿时间——用户可以通过 -XX:MaxGCPauseMillis 设置一个停顿时间目标(默认 200ms),G1 会尽量在这个时间限制内完成 GC。
G1 是如何做到这一点的?它放弃了传统的"新生代+老年代"的固定分代布局,转而采用了一种全新的基于 Region 的分区内存布局,使得 GC 可以"按需选择"回收哪些区域,而不是一次性回收整个新生代或老年代。
二、Region:G1 的基础内存单元
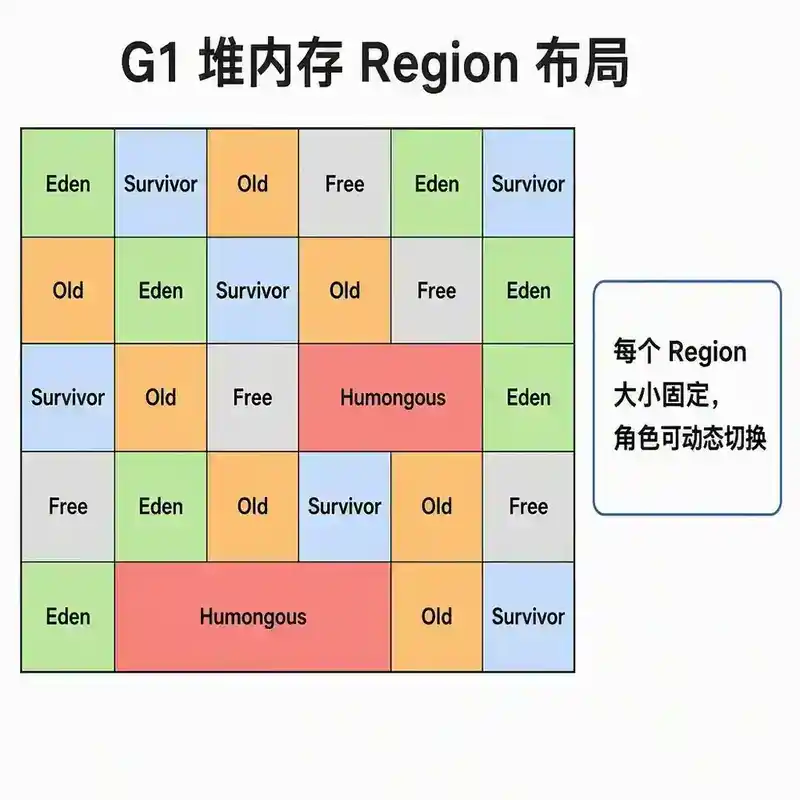
G1 将整个 Java 堆划分为多个大小相等的独立区域(Region),每个 Region 的大小通过 -XX:G1HeapRegionSize 指定,必须是 2 的幂次(1MB 到 32MB),默认将堆划分为约 2048 个 Region。
每个 Region 可以扮演不同的角色:
- Eden Region:新生代中的 Eden 区
- Survivor Region:新生代中的 Survivor 区
- Old Region:老年代
- Humongous Region:巨型对象区(用于存储大小超过单个 Region 50% 的对象)
Region 的角色不是固定的,可以在 GC 后动态切换。比如一次 GC 后,某个 Eden Region 被清空,它可以变成空闲 Region,下一次分配时可能被用作 Survivor 或 Old Region。
Humongous Region 的特殊处理:如果对象大小超过单个 Region 的 50%,G1 将其视为"巨型对象"。巨型对象直接分配在连续的 Humongous Region 中(不经过 Eden),不参与新生代 GC,而是直接参与 Mixed GC 或 Full GC。如果对象大小超过一个 Region,G1 会分配连续的多个 Humongous Region 来存储。Humongous Region 的回收效率较低,应尽量避免频繁创建和销毁大对象。
三、G1 的 GC 周期:Young GC → Mixed GC → Full GC
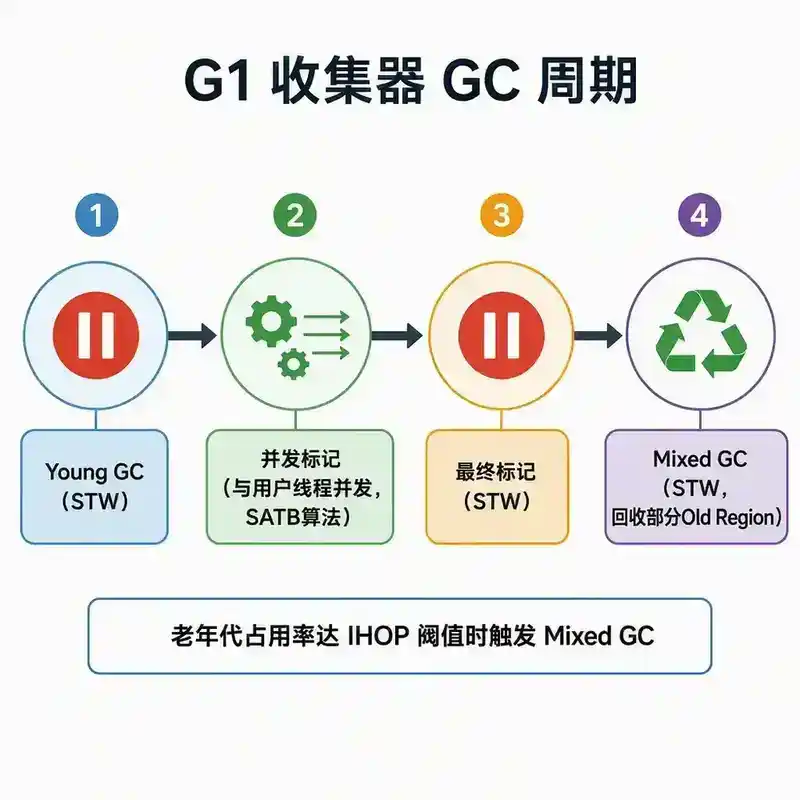
G1 的 GC 分为三个阶段:
Young GC(年轻代 GC)
当 Eden Region 被填满时触发。G1 的 Young GC 与 Parallel 的 Young GC 类似,但只回收选中的 Eden 和 Survivor Region,将存活对象复制到新的 Survivor Region 或晋升到 Old Region。Young GC 是 STW 的,但只涉及部分 Region,停顿时间可控。
Mixed GC(混合 GC)
当老年代占用率达到 -XX:InitiatingHeapOccupancyPercent(默认 45%)时触发。Mixed GC 不仅回收新生代 Region,还回收部分老年代 Region——G1 会选择回收价值最高的老年代 Region(垃圾最多的 Region),直到达到停顿时间目标。这就是 G1 名字"Garbage-First"的由来:优先回收垃圾最多的 Region。
Mixed GC 分为以下阶段:
- 初始标记(Initial Mark,STW):随 Young GC 一起进行,标记 GC Roots。
- 并发标记(Concurrent Marking):与用户线程并发,使用 SATB 算法标记老年代中的存活对象。
- 最终标记(Remark,STW):处理 SATB 缓冲区中的残留记录。
- 筛选回收(Cleanup,STW):根据停顿时间目标,选择回收价值最高的 Region 进行回收。
Full GC
当 Mixed GC 无法跟上内存分配速度,或者 Humongous Region 无法分配时,G1 会回退到 Serial Old 收集器进行单线程的 Full GC。Full GC 是 G1 的"最后防线",应尽量避免。
四、Remembered Set(RSet):G1 解决跨 Region 引用的关键
在分代 GC 中,跨代引用通过 Card Table 来解决。G1 将这个概念扩展到了 Region 级别:每个 Region 维护一个 Remembered Set(简称 RSet),记录了"哪些其他 Region 中的对象引用了当前 Region 中的对象"。
当 G1 回收某个 Region 时,只需要扫描该 Region 的 RSet 中记录的"外部引用",而不需要扫描整个堆。这大大减少了 GC Roots 枚举的工作量,是实现"只回收部分 Region"的前提条件。
RSet 的维护开销是 G1 的一个主要开销来源。每个引用赋值操作都需要通过写屏障(Write Barrier)来检查是否需要更新 RSet。写屏障的开销通常占 G1 总开销的 10-20%,但这是实现"可预测停顿"必须付出的代价。
五、SATB(Snapshot-At-The-Beginning):G1 的并发标记算法
G1 使用 SATB(Snapshot-At-The-Beginning)算法来进行并发标记。SATB 的核心思想是:在并发标记开始时,给堆的当前状态拍一个"快照",标记过程中只关注这个快照中的对象,快照之后新产生的垃圾(浮动垃圾)留到下一次 GC 处理。
SATB 通过两个机制来保证正确性:
- SATB 写屏障:在引用赋值操作之前,将旧引用值记录到 SATB 缓冲区中。这样,即使旧引用指向的对象在并发标记过程中变成了不可达,SATB 也能保证它被标记为存活(因为它在快照时刻是可达的)。
- SATB 缓冲区:每个线程有一个 SATB 缓冲区,写屏障将旧引用值写入缓冲区。当缓冲区满时,将缓冲区加入全局列表,然后分配新缓冲区。在最终标记阶段,处理所有缓冲区中的记录。
SATB 的优点是:漏标概率极低(因为所有旧引用都被记录),并发标记阶段用户线程不需要额外的同步。缺点是:可能产生"浮动垃圾"——快照之后新产生的垃圾无法在本次 GC 中被回收。
六、停顿预测模型:G1 的"智能调度"
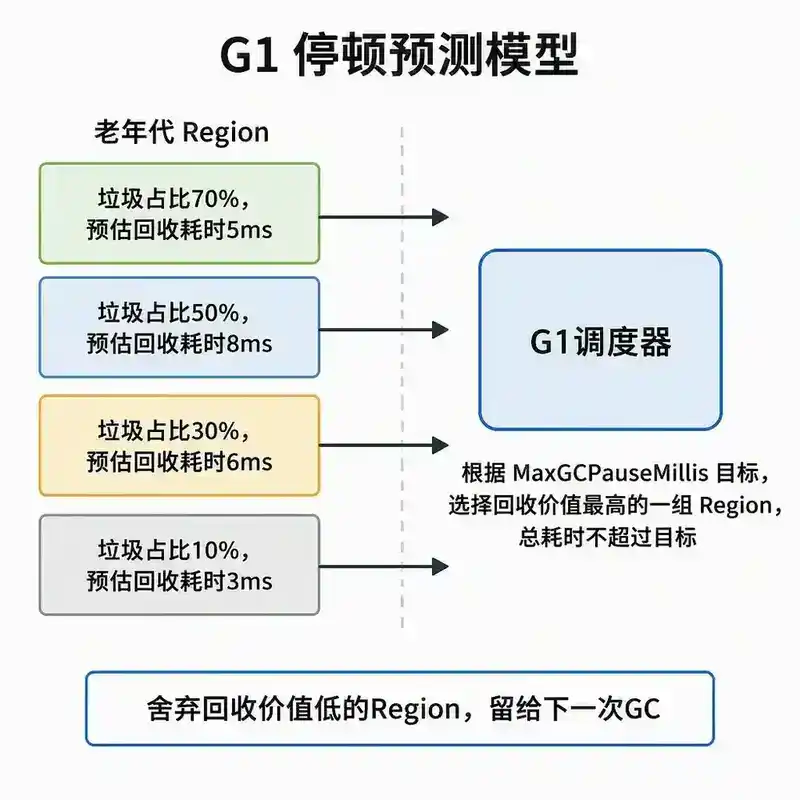
G1 最核心的特性之一是停顿预测模型(Pause Prediction Model)。G1 根据历史 GC 数据,估算每个 Region 的回收耗时(包括存活对象复制耗时和 RSet 扫描耗时),然后根据用户设定的停顿时间目标(-XX:MaxGCPauseMillis),选择一组"回收价值最高且总耗时不超过目标"的 Region 集合进行回收。
这个模型使得 G1 的停顿时间具有可预测性——虽然不能保证每次 GC 的停顿时间都在目标范围内,但长期来看,G1 会尽量满足用户的停顿时间目标。如果用户设定了过于激进的停顿时间目标(比如 10ms),G1 可能无法跟上内存分配速度,最终导致 Full GC。
七、G1 vs CMS:为什么 G1 是更好的选择
| 维度 | CMS | G1 |
|---|---|---|
| 内存布局 | 固定新生代+老年代 | 基于 Region 的灵活分区 |
| 碎片问题 | 严重(标记-清除) | 无(Region 级标记-复制) |
| 停顿可预测性 | 不可预测 | 可预测(停顿预测模型) |
| 并发标记算法 | 增量更新 | SATB |
| 老年代回收 | 一次性回收整个老年代 | 增量回收(Mixed GC) |
| 巨型对象 | 直接分配在老年代,回收困难 | 独立 Humongous Region,更快回收 |
| Full GC | 回退到 Serial Old | 回退到 Serial Old(但触发频率更低) |
八、面试追问链
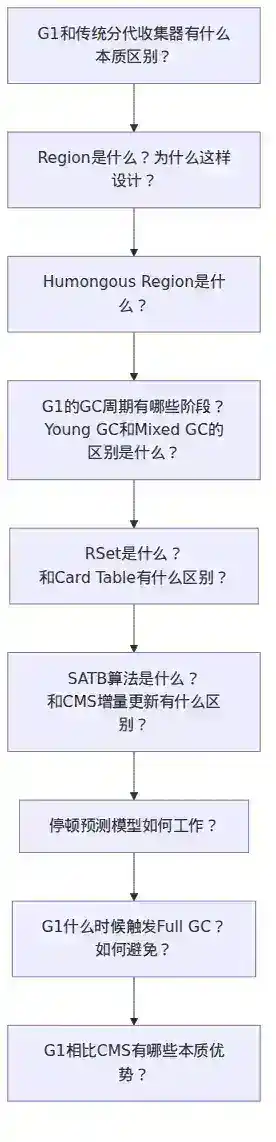
从"G1 收集器和传统分代收集器有什么本质区别"这个基础问题出发,逐层追问:G1 的 Region 是什么为什么这样设计 Region 大小如何确定、Humongous Region 是什么为什么大对象在 G1 中需要特殊处理、G1 的 GC 周期有哪些阶段 Young GC 和 Mixed GC 的区别是什么、RSet 是什么它和 Card Table 有什么区别为什么 G1 需要 RSet、SATB 算法是什么和 CMS 的增量更新算法有什么区别、G1 的停顿预测模型是如何工作的为什么能实现可预测停顿、G1 什么时候会触发 Full GC 如何避免、G1 相比 CMS 有哪些本质优势为什么 JDK 9 选择 G1 作为默认收集器。
延伸阅读
- JEP 248(G1 默认启用),JEP 304(G1 的改进),理解 G1 成为默认 GC 的技术背景
- 《深入理解 Java 虚拟机》(周志明)第 3.5.4 节,详细介绍了 G1 收集器
- HotSpot 源码
src/hotspot/share/gc/g1目录,深入了解 G1 的实现细节 - 「04 JVM 原理与调优」系列下一篇(061)将深入 ZGC 与 Shenandoah:低延迟 GC 的原理与对比
问答(不计入阅读时长)
Q1:G1 的 Region 大小如何确定?Region 太大或太小分别有什么影响?
A:Region 大小通过 -XX:G1HeapRegionSize 指定,默认将堆划分为约 2048 个 Region。Region 太大(如 32MB):每个 Region 粒度太粗,一次 GC 回收的 Region 数少,停顿预测模型的可调节空间变小,可能导致停顿时间上下波动大。Region 太小(如 1MB):每个 Region 粒度太细,但 RSet 的维护开销增加(每个 Region 都要维护自己的 RSet),写屏障的开销变大,GC 总时间可能增加。通常建议 Region 大小在 2MB-8MB 之间,让堆被划分为 1000-4000 个 Region。对于 4GB 堆,默认 Region 大小为 2MB;对于 32GB 堆,默认 Region 大小为 16MB。如果指定了 -XX:G1HeapRegionSize,JVM 会取不超过该值的最大 2 的幂次。
Q2:G1 的 Humongous Region 为什么需要特殊处理?大对象在 G1 中经历什么 GC 过程?
A:对象大小超过单个 Region 50% 时,G1 将其视为"巨型对象"(Humongous Object)。Humongous Region 特殊处理的原因:(1)大对象如果分配在 Eden 中,复制到 Survivor 的成本太高,所以直接分配在老年代 Region 中;(2)大对象可能跨越多个 Region,需要连续 Region 分配,如果内存碎片化严重,可能无法分配;(3)大对象回收只能通过 Mixed GC 的 Cleanup 阶段或 Full GC,不能通过 Young GC 回收。Humongous Region 的 GC 过程:Young GC 会跳过 Humongous Region;Mixed GC 的 Cleanup 阶段会回收被标记为垃圾的 Humongous Region;Full GC 会整理 Humongous Region。因此,频繁创建和销毁大对象可能导致 Humongous Region 碎片化,触发 Full GC。建议避免超过 Region 大小 50% 的大对象频繁分配。
Q3:G1 的 RSet(Remembered Set)和传统分代 GC 中的 Card Table 有什么区别?为什么 G1 需要 RSet 这个额外的数据结构?
A:Card Table 是全局的,记录"老年代中哪些卡(Card)被修改过",用于 Minor GC 时快速定位跨代引用。RSet 是每个 Region 独立的,记录"哪些其他 Region 引用了当前 Region"。Card Table 是"粗粒度"的(一个 Card 通常 512 字节),RSet 是"细粒度"的(记录到具体 Region)。G1 需要 RSet 的原因:G1 每次只回收部分 Region,而不是整个新生代或老年代。如果只有一个全局的 Card Table,回收一个 Region 时需要扫描整个 Card Table 来找到所有跨 Region 引用,效率太低。RSet 将"外部引用"信息按 Region 聚合,回收一个 Region 时只需要扫描该 Region 的 RSet,时间复杂度从 O(堆大小) 降到 O(Region 大小 + RSet 大小)。RSet 的维护开销很大,但这是 G1 实现"部分回收"的代价。
Q4:SATB(Snapshot-At-The-Beginning)算法为什么能减少漏标?它和 CMS 的增量更新(Incremental Update)算法在什么场景下有不同的表现?
A:SATB 通过写屏障在引用赋值之前记录旧引用值,保证"并发标记开始时快照中的所有可达对象都不会被漏标"。CMS 的增量更新通过写屏障在引用赋值之后记录新引用值,保证"并发标记过程中新增的引用关系不会被遗漏"。SATB 的优势:漏标概率极低,因为所有旧引用都被记录,不需要担心并发标记期间的引用变化。CMS 增量更新的问题:需要重新扫描被修改过的卡(Card),可能导致重复标记。SATB 的代价:可能产生更多"浮动垃圾"——因为所有在快照中可达的对象都被标记为存活,即使它们后来变成了垃圾,这比 CMS 的增量更新产生的浮动垃圾更多。但 G1 通过更频繁的 Mixed GC 来弥补这个缺陷,浮动垃圾不会积压太久。
Q5:G1 的停顿预测模型具体是如何工作的?它如何根据历史数据估算每个 Region 的回收耗时?
A:G1 的停顿预测模型基于衰减平均值(Decaying Average)和衰减方差(Decaying Variance)来估算每个 Region 的回收耗时。模型维护三个关键指标:每个 Region 的存活对象复制耗时(与存活对象数量成正比)、每个 Region 的 RSet 扫描耗时(与 RSet 大小成正比)、每个 Region 的垃圾占比。模型根据最近几次 GC 的实际耗时数据,使用衰减平均算法更新这些指标的估计值。在 Cleanup 阶段,G1 根据当前停顿时间目标(-XX:MaxGCPauseMillis),对所有候选 Region 按"回收价值/回收耗时"(即垃圾占比/预估耗时)降序排序,贪心地选择一组 Region,使得总预估耗时不超过目标。如果用户设置的停顿时间目标过于激进(如 10ms),G1 每次只能回收很少的 Region,可能导致老年代回收速度跟不上分配速度,最终触发 Full GC。
Q6:G1 什么时候会触发 Full GC?如何通过日志分析和参数调优来避免 Full GC?
A:G1 触发 Full GC 的场景:(1)Mixed GC 无法跟上内存分配速度,老年代占用率持续增长;(2)Humongous Region 分配失败,无法找到连续的 Region 空间;(3)元空间(Metaspace)不足触发 Full GC;(4)System.gc() 调用(取决于 -XX:+DisableExplicitGC)。避免 Full GC 的调优策略:(1)增加 -XX:ConcGCThreads 提高并发标记速度;(2)降低 -XX:InitiatingHeapOccupancyPercent(IHOP)提早触发 Mixed GC;(3)增大 -XX:G1HeapRegionSize 减少 Humongous Region 的数量;(4)适当增大 -XX:G1ReservePercent(默认 10%)保留更多空间应对突发分配。日志分析:GC 日志中 To-space exhausted 或 Full GC 是明确的信号,需要关注 Mixed GC 的频率和回收效率,以及 Humongous Region 的分配和回收情况。
Q7:G1 相比 CMS 有哪些本质优势?为什么 JDK 9 选择 G1 作为默认收集器而不是 CMS?
A:本质优势:(1)无内存碎片——G1 使用 Region 级标记-复制,CMS 使用标记-清除,碎片是 CMS 无法根治的架构性问题;(2)可预测停顿——G1 的停顿预测模型让停顿时间可控,CMS 的停顿时间不可预测;(3)增量回收——G1 的 Mixed GC 可以增量回收老年代,CMS 一次性回收整个老年代;(4)更好的并发标记——SATB 算法比 CMS 的增量更新算法更高效,漏标概率更低;(5)巨型对象支持——G1 有独立的 Humongous Region,CMS 大对象直接放老年代,回收困难。JDK 9 选择 G1 作为默认的原因:CMS 的维护成本高且存在架构性缺陷无法修复,而 G1 在低延迟和高吞吐之间找到了更好的平衡,同时社区有更强的意愿持续改进 G1。
Q8:如果 G1 的 Mixed GC 回收速度跟不上分配速度,G1 会怎么做?这个过程对应用的影响是什么?
A:当 Mixed GC 回收速度跟不上分配速度时,G1 会进入"退化"(Degeneration)模式:首先,G1 会尝试增加 Mixed GC 的频率(降低 IHOP 阈值,让 Mixed GC 更早触发)。如果仍然跟不上,G1 会放弃"部分回收"策略,转而进行一次"全量"的 Young GC + 清理(回收所有 Region),仍无法满足则回退到 Serial Old 进行单线程 Full GC,导致一次长时间的 STW(可能几秒到几十秒)。对应用的影响:在退化过程中,应用的响应时间会急剧恶化,P99/P999 延迟飙升到秒级甚至更高。这在生产环境中表现为"间歇性的长时间停顿",对在线服务的影响非常大。最佳实践是:通过监控 GC 日志提前发现 Mixed GC 效率下降的趋势,主动调整参数(如增大堆、调整 IHOP、优化应用的内存分配模式),避免 G1 进入退化模式。