一、Java 是"解释执行"还是"编译执行"?——都不是,是先解释后编译
很多人从教科书上学到"Java 是解释型语言",又有人纠正说"不对,Java 有 JIT 编译器,是编译执行"。两个说法都不完全准确。HotSpot JVM 采用的是混合模式:方法首次执行时由解释器逐条执行字节码,当方法被调用足够多次后,JIT 编译器将其编译为本地机器码,后续调用直接执行机器码。
这个设计的核心逻辑是"二八定律":20% 的热点代码消耗了 80% 的执行时间。与其在启动时编译所有代码,不如先解释执行,把编译资源投入在真正热点的方法上。
关键概念速览:
- 解释器(Interpreter):逐条执行字节码,启动快,执行慢。
- C1(Client Compiler):快速编译,编译时间短,适合启动敏感的场景。
- C2(Server Compiler):深度优化编译,编译时间长,但生成的机器码执行效率最高。
- 分层编译(Tiered Compilation):C1 + C2 协同工作,先 C1 快速编译,后 C2 深度优化。
- 热点探测(Hotspot Detection):通过计数器判断哪些代码需要编译。
- OSR(On-Stack Replacement):在方法执行到一半时切换到编译版本。
- 去优化(Deoptimization):放弃已编译的机器码,退回到解释执行。
- 逃逸分析(Escape Analysis):分析对象的作用域,决定是否可以栈上分配或标量替换。
二、分层编译:五层递进的编译策略
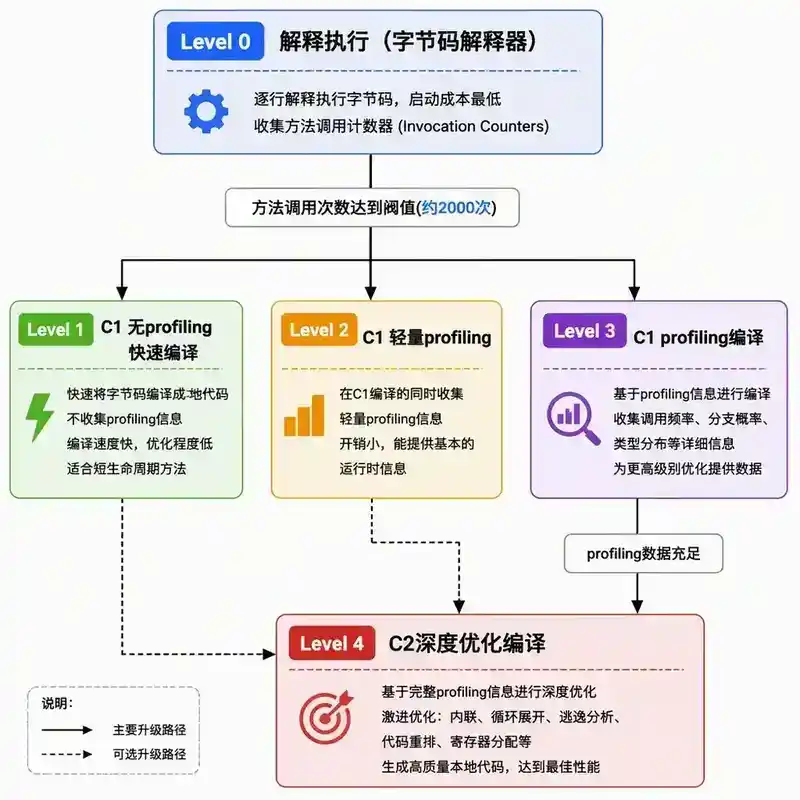
JDK 8+ 默认开启分层编译(-XX:+TieredCompilation),将代码执行分为五个层级:
| 层级 | 名称 | 描述 |
|---|---|---|
| Level 0 | 解释执行 | 字节码解释器执行,收集方法调用和回边计数 |
| Level 1 | C1 完全优化 | C1 编译,无 profiling 数据,快速编译 |
| Level 2 | C1 受限编译 | C1 编译,轻量 profiling,收集调用频率 |
| Level 3 | C1 完全 profiling | C1 编译,完整 profiling,收集分支概率、类型分布 |
| Level 4 | C2 编译 | C2 深度优化编译,利用 profiling 数据做激进优化 |
编译路径:启动 -> 解释执行(Level 0)-> 方法调用次数达到阈值 -> C1 编译(Level 3),继续收集 profiling 数据 -> C2 编译(Level 4),利用 profiling 数据做激进优化。
Profiling 数据是 C2 能否做激进优化的关键——它告诉 C2:哪个分支走得多、参数实际类型是什么、虚方法调用的实际接收者是谁。没有 profiling 数据,C2 只能做保守优化。分层编译的"先 C1 后 C2"策略,在启动速度和峰值性能之间达成了最佳平衡。
[图1:分层编译五层递进流程图——Level 0解释执行→Level 3 C1 profiling→Level 4 C2深度优化]
三、热点探测:JVM 如何决定"该编译了"
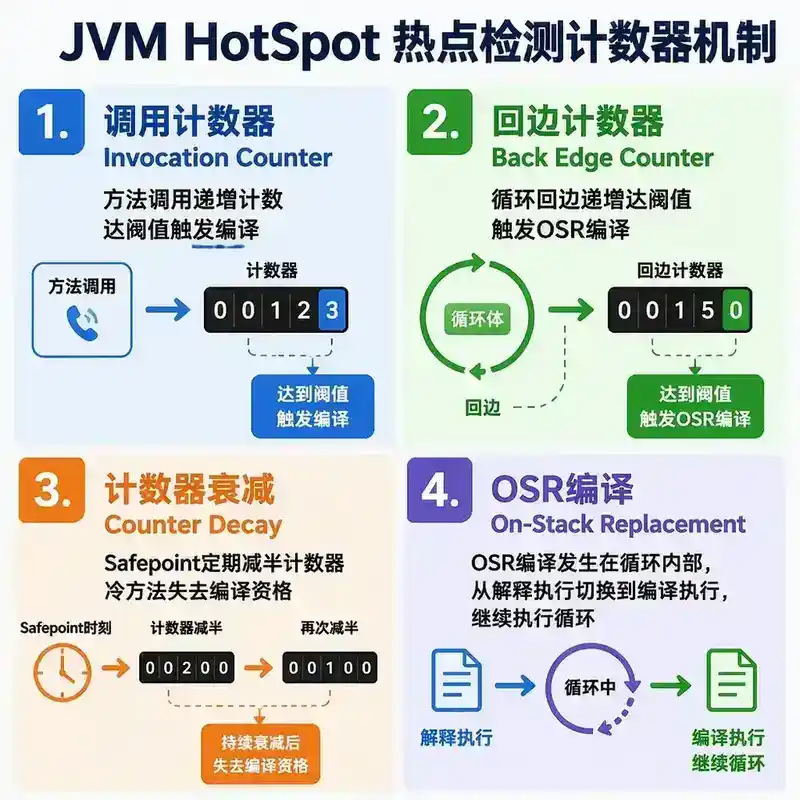
每个方法有一个调用计数器,方法每被调用一次,计数器加 1。当计数器达到阈值时,提交编译请求。除了方法调用,循环也是编译的重要目标——回边计数器记录方法内循环的执行次数,达到阈值时触发 OSR 编译。
JVM 定期将所有方法的计数器减半(计数器衰减),这样"只在启动时调用一次"的方法会逐渐失去编译资格,把编译资源留给真正的热点方法。
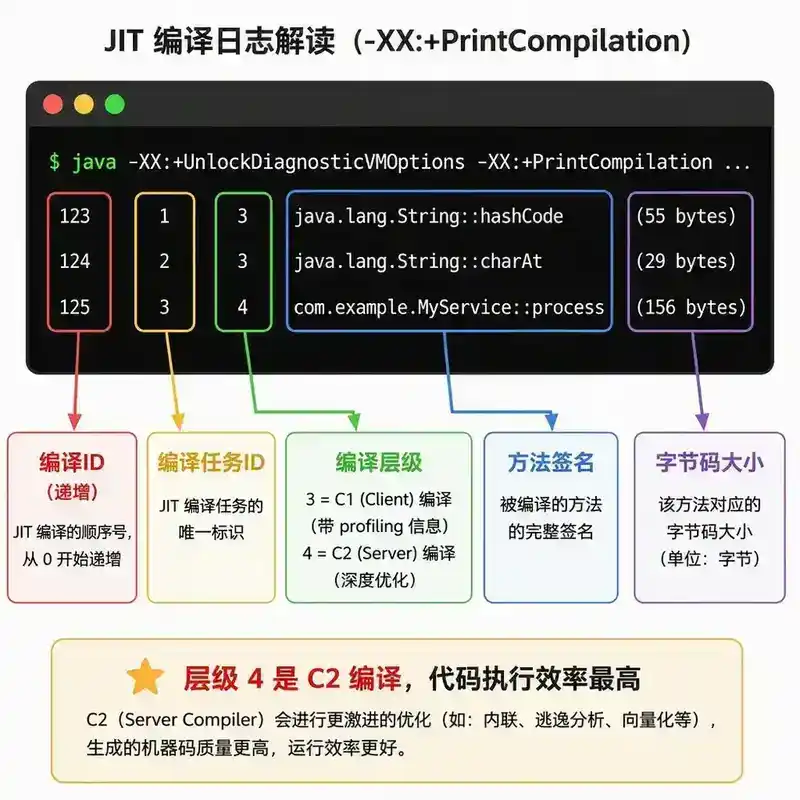
开启编译日志:-XX:+PrintCompilation。输出示例:
123  1  3  java.lang.String::hashCode (55 bytes)
124  2  3  java.lang.String::charAt (29 bytes)
125  3  4  com.example.MyService::process (156 bytes)
列含义:123=编译ID,1=任务ID,3/4=编译层级(3=C1 profiling, 4=C2),后跟方法签名和字节码大小。
[图2:JIT编译日志解读图——标注编译ID、层级、方法名、字节码大小]
[图5:热点探测计数器机制图——调用计数器和回边计数器的工作流程]
四、OSR(On-Stack Replacement):循环中途的编译
假设一个方法包含一个执行 100 万次的循环,但方法本身只被调用了一次。按正常流程,这个方法永远不会被编译。但循环体确实是一个热点——这就是 OSR 的用武之地。
当回边计数器达到阈值,JVM 在循环的"回边点"生成一个编译版本的入口。下次循环迭代时,执行从解释器"跳"到编译版本,后续循环迭代在编译版本中执行。但方法入口仍然是解释版本。
OSR 编译的代码通常不如正常编译的代码优化得好,因为入口在循环中间,C2 的很多优化(如方法内联)难以在 OSR 编译中应用。如果方法后续被多次调用,正常编译的版本会最终取代 OSR 版本。
五、去优化(Deoptimization):放弃编译,退回解释
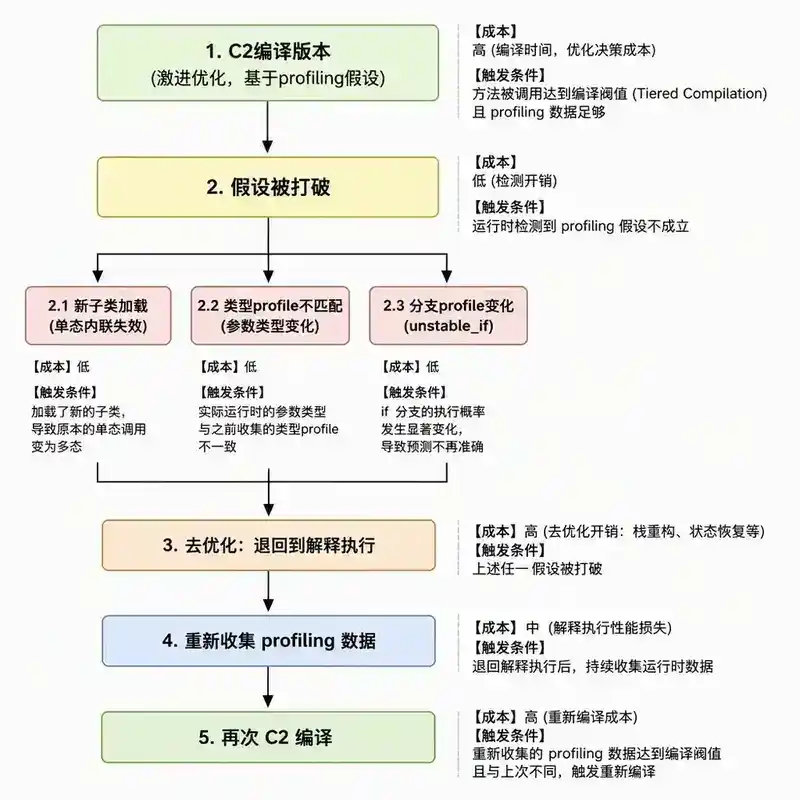
C2 的激进优化建立在"假设"之上。当这些假设被打破时,已编译的代码不再正确,必须放弃编译版本,退回到解释执行。常见原因:
- 类加载导致的新子类:C2 编译时假设某个虚方法只有一个实现(单态内联),运行时加载了新的子类。
- 类型 profile 不匹配:C2 假设某个参数总是 String 类型,运行时传入了一个 Integer。
- Unstable_if:C2 假设某个 if 分支总是走 true,运行时开始频繁走 false 分支。
去优化本身代价不高,但后续性能会下降(回到解释执行,需要重新 profiling 和编译)。如果形成"编译-去优化"循环,对性能影响很大。
[图3:去优化触发场景示意图——C2编译版本→假设被打破→退回解释执行→重新profiling→再次编译]
六、逃逸分析:让对象"不逃出"方法
逃逸分析判断一个对象的作用域是否局限在方法内部。如果对象不会"逃逸"到方法外部,C2 就可以做激进优化。
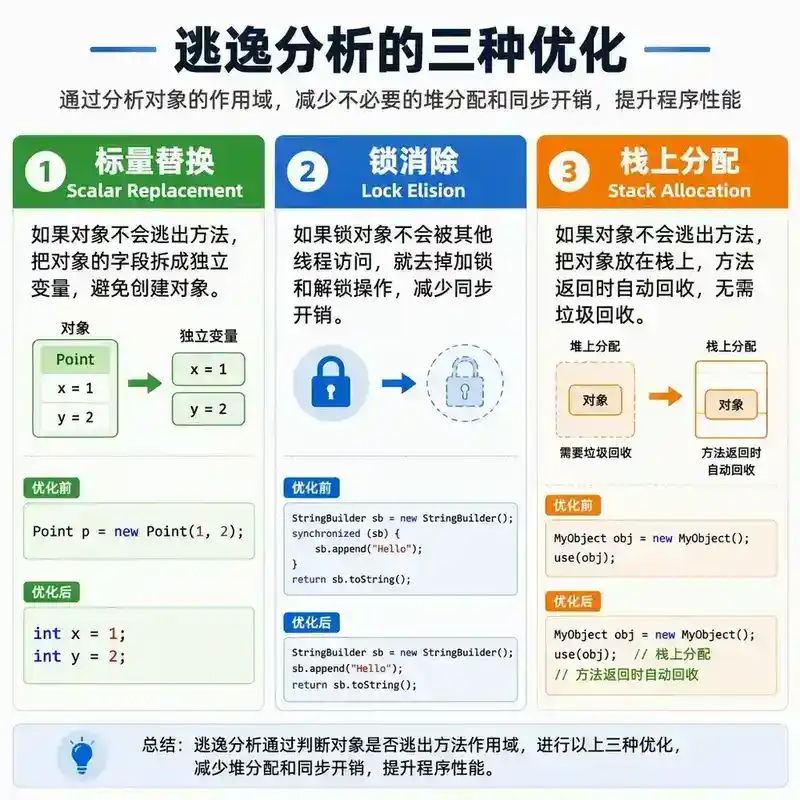
标量替换(Scalar Replacement):将对象的成员变量拆开为独立的局部变量,不再需要创建对象本身。例如 Point p = new Point(1,2) 被优化为 int x=1; int y=2,Point 对象完全被消除,不需要分配内存。
同步消除(Lock Elision):如果对象不会逃逸出当前线程,对该对象的 synchronized 操作可以安全地消除。例如局部 StringBuffer 的 append 锁可以消除。
栈上分配(Stack Allocation):对象直接在栈上分配,随栈帧弹出自动销毁,不需要 GC 参与。注意:HotSpot 目前没有真正实现栈上分配,而是通过标量替换达到类似效果。
逃逸分析相关参数:-XX:+DoEscapeAnalysis(默认开启)、-XX:+EliminateAllocations(标量替换)、-XX:+EliminateLocks(锁消除)。
[图4:逃逸分析三种优化示意图——标量替换/锁消除/栈上分配]
七、JIT 编译的常见陷阱
- 方法内联的大小阈值:C2 自动内联小型方法,-XX:MaxInlineSize(默认 35 字节)和 -XX:FreqInlineSize(默认 325 字节)控制内联阈值。热点方法因为太大而无法内联会显著影响性能。可通过 -XX:+PrintInlining 查看内联情况。
- CodeCache 满:JIT 编译的代码存储在 CodeCache 中(默认 240MB)。如果 CodeCache 满了,JVM 停止编译,所有代码回到解释执行,性能急剧下降。日志中会出现 "CodeCache is full. Compiler has been disabled." 警告。
- 编译阈值过高导致预热慢:如果 -XX:CompileThreshold 设置过高,热点方法需要更长时间才能被编译,应用需要更长的预热期才能达到峰值性能。
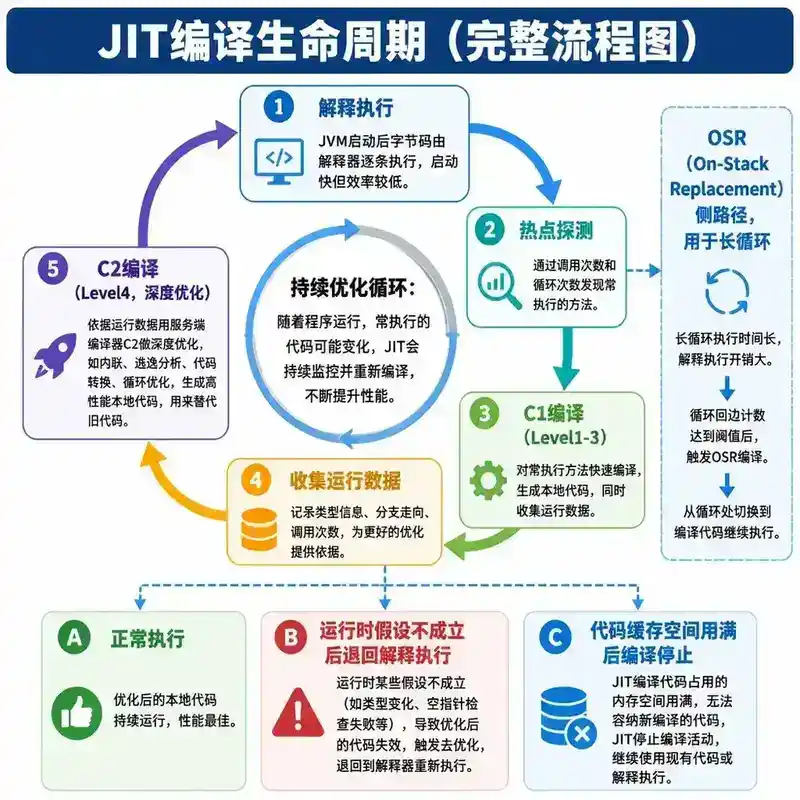
[图6:JIT编译全生命周期全景图——从解释执行→热点探测→C1→C2→去优化→重新编译的完整循环]
八、面试常见误区
- "Java 是解释执行的" —— 不准确。HotSpot 是混合模式,热点代码会被 JIT 编译为机器码,只有冷代码才解释执行。
- "JIT 编译后代码永远是最快的" —— 不一定。C2 的激进优化建立在 profiling 假设上,如果假设不成立,去优化后退回解释执行,反而更慢。
- "关闭逃逸分析省内存" —— 错误。逃逸分析可以减少对象分配,关闭后反而会分配更多对象,增加 GC 压力。
- "分层编译就是 C1 编译一次、C2 编译一次" —— 不准确。分层编译有五层,C1 内部还有无 profiling 和 profiling 的区分。
九、总结
JIT 编译的核心设计理念是"把编译资源投在最有价值的地方":
- 分层编译:先解释,再 C1 快速编译,最后 C2 深度优化。
- 热点探测:调用计数器 + 回边计数器 + 计数器衰减。
- OSR:循环中途的编译切换。
- 去优化:当编译假设被打破时,安全退回到解释执行。
- 逃逸分析:对象不逃逸 -> 标量替换 + 锁消除。
理解 JIT 编译不是为了"调参数",而是为了理解为什么 Java 应用需要预热、为什么"启动后先跑 10 分钟"性能会变好、以及为什么某些看似简单的代码改动会导致性能下降。
延伸阅读
- OpenJDK 源码:hotspot/src/share/vm/opto(C2 编译器)
- JITWatch:可视化分析 JIT 编译日志的工具
- 本系列相关篇目:069(JIT 优化技术:方法内联、标量替换、锁消除、公共子表达式消除)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 JIT 编译的深度理解和实战经验。
Q1:你在 -XX:+PrintCompilation 日志中看到一个方法先被编译为 Level 3,然后被编译为 Level 4,但过了一段时间又出现了同一个方法的 Level 3 编译。这正常吗?为什么?
这是一个典型的"去优化后重新编译"场景。同一个方法从 Level 3 -> Level 4 -> Level 3 的路径是:方法先被 C1 profiling 编译(Level 3)-> 收集足够 profiling 数据后 C2 深度优化(Level 4)-> C2 的某个优化假设被打破(如新子类加载、类型 profile 变化)-> 去优化退回到 Level 0 解释执行 -> 重新 profiling 后再次 C1 编译(Level 3)-> 最终可能再次到 Level 4。这种"编译-去优化"循环如果只发生一两次,是正常的(加载了新类),但如果频繁发生,说明 C2 的优化假设不稳定,需要排查是否有代码在不断生成新类或改变调用模式。
Q2:逃逸分析可以让对象在栈上分配、避免 GC。为什么不是所有对象都做逃逸分析?什么情况下逃逸分析会失效?
逃逸分析是 C2 编译阶段的分析,不是运行时分析。C2 只对热点方法做逃逸分析,冷方法不会触发。逃逸分析失效的常见情况:1)对象被返回给调用者(return this)——即使调用者也不使用这个对象,C2 也可能保守判定为逃逸。2)对象被赋值给非静态字段——即使这个字段只在方法内部使用,赋值给字段这个动作本身就被判定为逃逸。3)对象被传递给一个未内联的方法调用——C2 无法分析被调用方法内部的行为,保守判定为逃逸。4)对象被放入数组或集合——容器本身就是一种"逃逸路径"。所以逃逸分析对"纯粹在方法内部创建、使用、销毁"的对象效果最好,复杂控制流和间接引用会使其失效。这也是为什么 Point 这种简单对象能受益,而复杂业务对象通常不行。
Q3:CodeCache 满了,JVM 日志显示 "CodeCache is full. Compiler has been disabled."。你如何在不重启的情况下缓解这个问题?
不重启的情况下能做的有限,但有以下方案:1)如果 JVM 还没完全停止编译,可以尝试用 jcmd 的 Compiler.codecache 命令查看 CodeCache 使用情况,用 Compiler.clear 清理部分编译代码。2)如果是分层编译导致 CodeCache 中积压了大量 Level 1-3 的 C1 编译代码,可以用 -XX:-TieredCompilation 关闭分层编译(但需要重启,所以不适用)。3)根本修复需要重启并调整参数:增大 -XX:ReservedCodeCacheSize(如 512MB)、用 -XX:+UseCodeCacheFlushing 开启 CodeCache 自动清理(JDK 9+ 默认开启)、用 -XX:+PrintCodeCache 监控 CodeCache 使用趋势。CodeCache 满的问题本质上是"编译了太多方法",除了扩容,还可以减少编译——通过 -XX:CompileCommand=exclude 排除编译收益低的大型方法,或提高编译阈值减少编译数量。
Q4:你在 benchmark 测试中发现,同一个方法在单测中跑 10 万次,前 1000 次慢、后面变快,这是 JIT 预热的效果。但你把这段代码放到实际业务中,发现预热效果不明显、性能波动很大。为什么?
单测环境是"理想化"的 JIT 编译场景:代码路径固定、参数类型稳定、没有其他线程竞争 CodeCache 和编译线程。实际业务中:1)多线程竞争导致 JIT 编译线程被调度延迟,编译请求排队。2)参数类型不稳定——同一个方法可能被传入多种类型,C2 的单态内联假设频繁被打破,导致去优化。3)CodeCache 被其他热点方法抢占,你的方法编译代码被淘汰。4)GC 频繁导致 Safepoint 多,计数器衰减可能让热点方法失去编译资格。5)虚方法调用的实际接收者多样化,C2 的内联优化效果打折扣。解决方案:在预热阶段用 JMH 做针对性预热,或使用 -XX:CompileCommand=inline 显式指定内联策略,或升级到 JDK 17+ 利用更先进的 C2 优化。
Q5:你有一个 Spring Boot 微服务,启动耗时 60 秒,其中 40 秒在 JIT 编译上。产品经理要求启动时间缩短到 30 秒。你会怎么优化?
启动阶段的 JIT 编译优化可以从几个方向入手:1)减少编译数量:用 -XX:CICompilerCount 减少编译线程数(避免编译线程和业务线程抢占 CPU),但可能降低峰值性能。2)降低编译阈值:用 -XX:Tier3InvocationThreshold 和 -XX:Tier4InvocationThreshold 降低 C1/C2 的触发阈值,让热点方法更快被编译,减少在解释执行中的时间。3)用 AOT(Ahead-of-Time Compilation):JDK 9+ 的 jaotc 或 GraalVM Native Image 可以提前编译,大幅减少启动时的 JIT 编译量。4)分层编译优化:JDK 17+ 的 C2 启动优化(-XX:+UseDynamicNumberOfCompilerThreads)可以让编译线程数动态调整。5)如果业务允许,用 GraalVM Native Image 编译为原生二进制,启动时间可以降到秒级甚至毫秒级,但牺牲了 JIT 的运行时优化能力。6)排查是否有大量不必要的方法被编译——用 -XX:+PrintCompilation 分析编译日志,找出编译了哪些大型方法,看是否可以通过代码重构拆分为更小的、可内联的方法。