一、为什么需要关心对象内存布局
在 Java 中,我们每天都在写 new Object(),但很少有人真正想过:一个 Java 对象在内存中到底长什么样?它占用多少字节?这些字节各自代表什么含义?理解对象内存布局,不仅是为了应付面试,更直接影响着实际工程中的内存估算、GC 调优、缓存行优化、以及对 JVM 底层机制的深入理解。
举个例子:一个空的 java.lang.Object 对象占多少内存?在 64 位 HotSpot JVM 上,开启指针压缩时,答案是 16 字节。这 16 字节由什么组成?为什么是 16 而不是 12 或 24?这些问题背后,就是对象内存布局的核心知识。
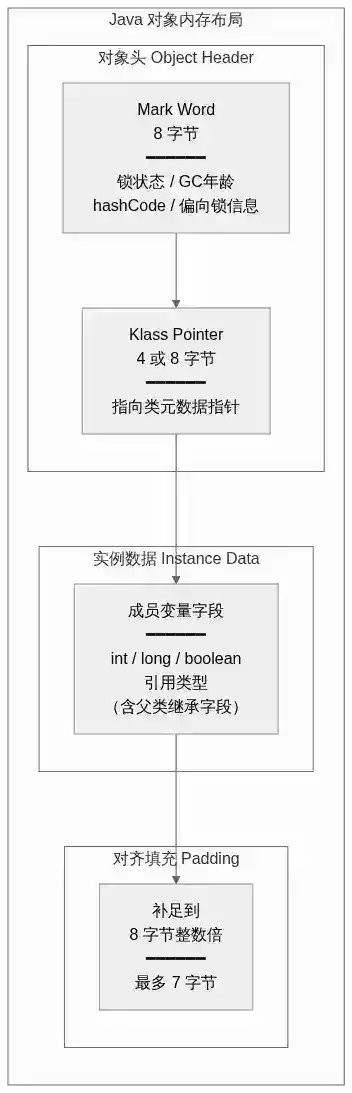
一个 Java 对象在 HotSpot JVM 的堆内存中,由三个部分组成:
- 对象头(Object Header):包含 Mark Word 和 Klass Pointer(类型指针),在数组对象中还有数组长度。
- 实例数据(Instance Data):对象的成员变量(字段),包括从父类继承的字段。
- 对齐填充(Padding):JVM 要求对象起始地址必须是 8 字节的整数倍,如果对象头 + 实例数据的总大小不是 8 的倍数,就需要填充到 8 的倍数。
理解这三个部分各自的结构和作用,是本节的核心目标。
二、对象头:Mark Word 与 Klass Pointer
对象头是理解 Java 对象内存布局的核心,也是面试中考察最深入的部分。它又可以细分为两个组成部分:
Mark Word(标记字)
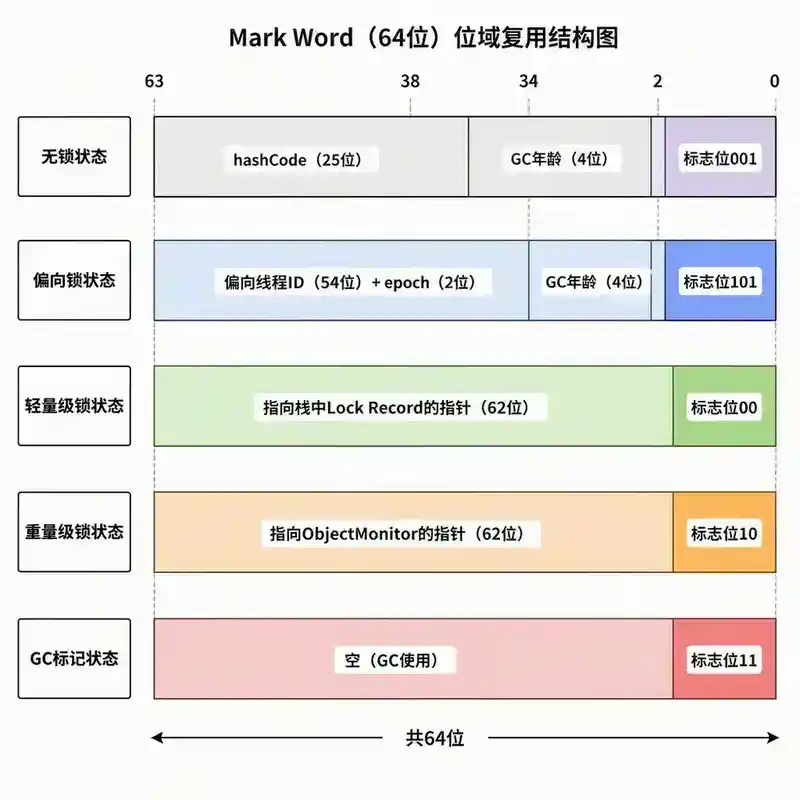
Mark Word 固定占用 8 字节(64 位 JVM)或 4 字节(32 位 JVM),是所有 Java 对象都有的"元数据头"。它不是一个静态的数据结构,而是一个动态复用的位域——根据对象当前的锁状态不同,Mark Word 中存储的内容也不同。这种设计在"存储空间极度有限"的前提下,把多套信息压缩到了同一块内存中,是 HotSpot 为节省内存所做的一个经典设计。
Mark Word 在不同锁状态下存储的内容如下:
| 锁状态 | 标志位 | 存储内容 |
|---|---|---|
| 无锁(Unlocked) | 001 | 对象的 hashCode(25 位)、GC 分代年龄(4 位)、偏向锁标志(0) |
| 偏向锁(Biased) | 101 | 偏向线程 ID(54 位)、偏向时间戳(epoch)、GC 分代年龄、偏向锁标志 |
| 轻量级锁(Lightweight Locked) | 00 | 指向当前线程栈中 Lock Record 的指针 |
| 重量级锁(Heavyweight Locked) | 10 | 指向操作系统 Monitor 对象(ObjectMonitor)的指针 |
| GC 标记(Marked for GC) | 11 | 空(GC 线程使用,不存储对象自身信息) |
可以看到,Mark Word 的 64 位空间被"多路复用"了:无锁时用它存储 hashCode 和 GC 年龄,偏向锁时用它存储偏向线程 ID,轻量级锁和重量级锁时用它存储锁记录指针。正是这种复用机制,使得每个对象只需要 8 字节的额外开销就能支持从无锁到重量级锁的完整锁升级路径,而不需要为每种锁状态单独分配一块存储空间。
GC 分代年龄只占 4 位,这意味着对象最多只能记录 15 次 GC 年龄(2^4 - 1 = 15)。这也是为什么 -XX:MaxTenuringThreshold 的最大值只能是 15——不是 JVM 不想设更大,而是 Mark Word 里只给 GC 年龄留了 4 个比特位,物理上限就是 15。
Klass Pointer(类型指针)
Klass Pointer 是对象头中紧接 Mark Word 之后的第二个字段,存储的是指向方法区(元空间)中该类元数据的指针。JVM 通过这个指针来确定一个对象属于哪个类——当你调用 obj.getClass() 或 instanceof 判断时,JVM 底层就是通过这个指针来定位到类的元数据。
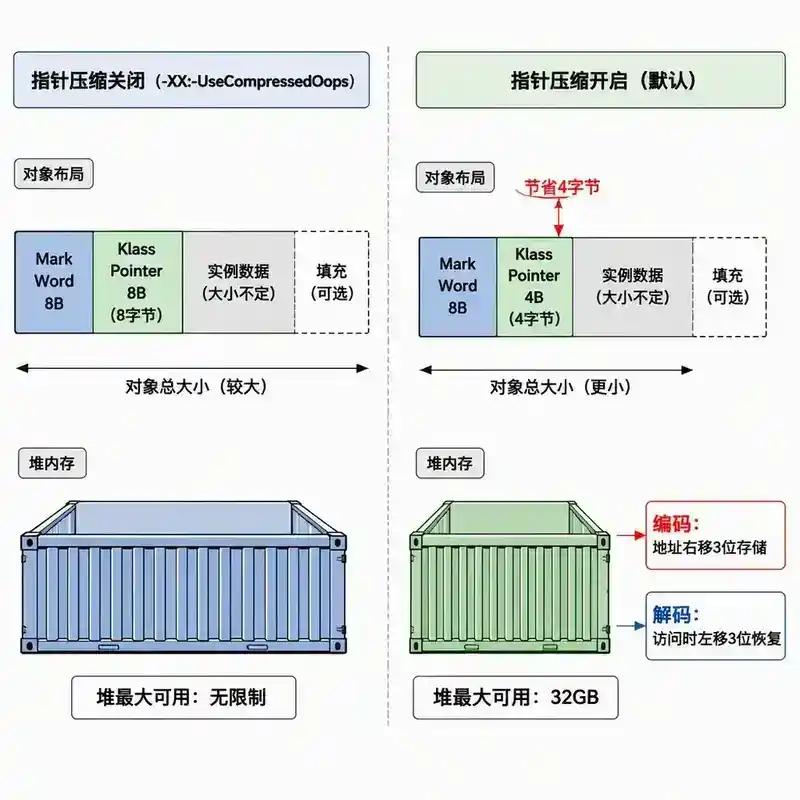
Klass Pointer 的大小取决于是否开启了指针压缩(Compressed OOPs):
- 开启指针压缩(默认,堆内存 < 32GB):4 字节
- 关闭指针压缩(
-XX:-UseCompressedOops):8 字节
所以,在默认配置下,一个普通 Java 对象的对象头总大小是:Mark Word(8 字节)+ Klass Pointer(4 字节)= 12 字节。注意:这里说的是"普通对象",如果是数组对象,对象头中还有一个额外的 4 字节字段存储数组长度,所以数组对象的对象头是 16 字节(Mark Word 8 + Klass Pointer 4 + 数组长度 4)。
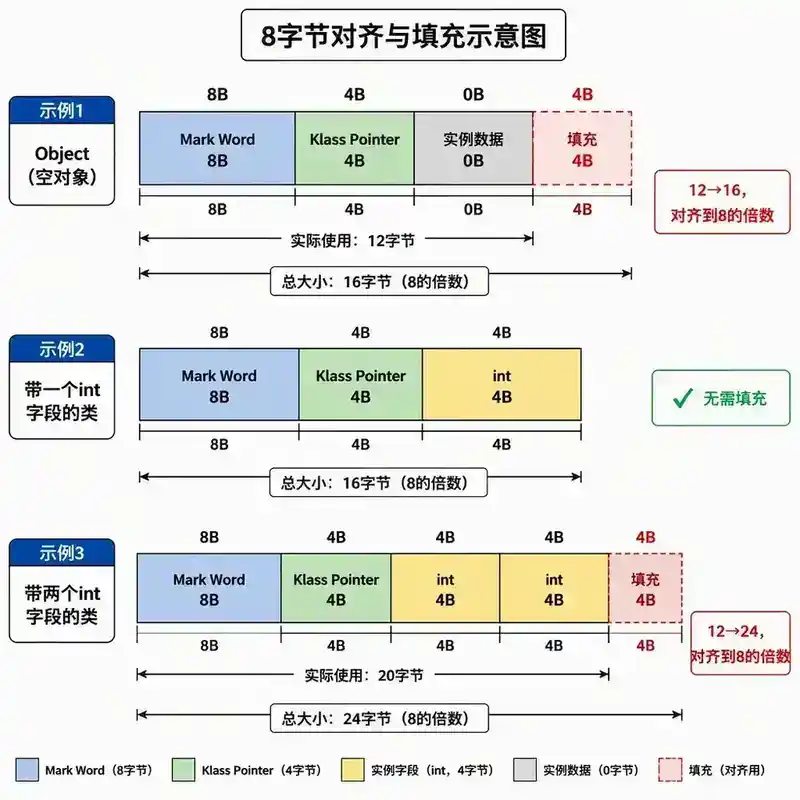
一个常见的面试问题是:"一个空的 Object 对象占多少内存?" 答案:Mark Word 8 字节 + Klass Pointer 4 字节 + 实例数据 0 字节(Object 没有字段)= 12 字节,但需要对齐到 8 字节的整数倍,所以填充 4 字节,最终占 16 字节。
三、实例数据:字段的存储顺序与重排序
实例数据是对象中存储成员变量(字段)的部分。父类继承的字段和自己的字段都在这里,存储顺序遵循以下规则:
- 相同宽度的字段放在一起:
long/double(8 字节)→int/float(4 字节)→short/char(2 字节)→byte/boolean(1 字节)→ 引用类型(4 或 8 字节,取决于是否开启指针压缩)。 - 父类字段在子类字段之前:这样做是为了保证父类的内存布局一致,子类指针可以直接转换为父类指针而无需偏移调整。
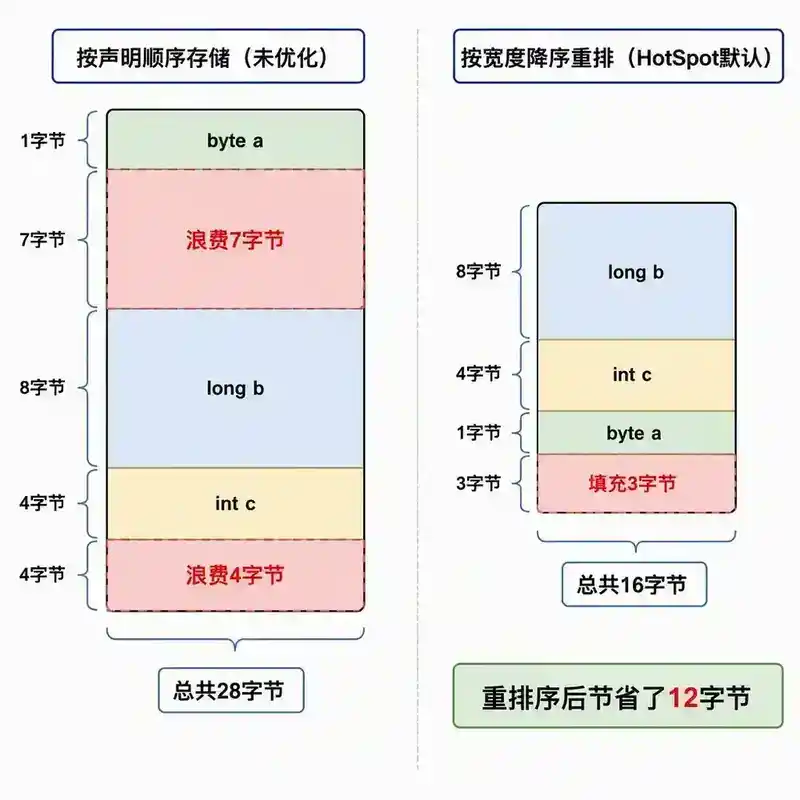
- JVM 可能对字段进行重排序:HotSpot 默认会按照字段宽度降序排列,以减少对齐填充带来的空间浪费。例如,如果把
byte a; long b; int c;按声明顺序存储,会产生大量填充字节;重排序后long; int; byte;只需一个填充字节,整体更紧凑。可以通过-XX:FieldsAllocationStyle控制分配策略。
这个重排序带来的一个实际影响是:不要依赖 Java 对象字段在内存中的物理顺序来推断任何行为——即使是同一个类的两个实例,JVM 也不保证它们的字段在内存中的排列顺序完全相同(虽然通常是一致地按宽度降序排列)。
四、对齐填充:8 字节对齐的"代价"
HotSpot 要求所有对象的起始地址必须是 8 字节的整数倍(即 8 字节对齐)。这个要求有两个目的:
- 性能优化:CPU 访问内存时,对齐的数据通常可以一次读取完成,而非对齐的数据可能需要多次读取和拼接。
- 配合 Mark Word 中的位域使用:由于对象地址是 8 的倍数,地址的低 3 位始终为 0。HotSpot 利用这一点,在 Mark Word 的最低 3 位中存储锁状态标志位——这样不需要额外空间就能区分不同的锁状态。
对齐填充就是用来满足"8 字节对齐"这个硬性要求的手段。如果对象头 + 实例数据的总大小不是 8 的倍数,JVM 会在末尾填充若干字节,直到达到 8 的倍数。
例如,一个 Object 对象:对象头 12 字节 + 实例数据 0 字节 = 12 字节,12 不是 8 的倍数,填充 4 字节到 16 字节。这就是为什么空的 new Object() 占用 16 字节而不是 12 字节。
对齐填充看起来是"浪费",但实际上在多数情况下,HotSpot 的字段重排序已经很大程度上减少了填充的浪费——真正需要填充的场景并不多。而且,对齐填充所占用的空间通常很小(最多 7 字节),相对于它带来的性能收益和设计便利性,这个代价是可以接受的。
五、指针压缩:4 字节还是 8 字节?
在 64 位 JVM 上,如果一个指针(引用)占用 8 字节,那么相对于 32 位 JVM 上 4 字节的指针,同样堆内存下能存放的对象数量会减少,而且每个对象多占用的 4 字节指针在大量对象时会显著增加内存占用。指针压缩(Compressed OOPs, Ordinary Object Pointers)就是为了解决这个问题而引入的技术。
基本原理
指针压缩的核心思想是:利用 8 字节对齐后对象地址的低 3 位恒为 0 这一特性,在存储时右移 3 位(相当于除以 8),在访问时左移 3 位(相当于乘以 8),从而将 32 位的存储空间扩展到 35 位的寻址能力。
具体来说,一个 32 位的压缩指针可以表示的地址范围是 2^32 × 8 = 32GB。也就是说,开启指针压缩后,堆内存最大可以到 32GB,超过这个限制,指针压缩就会自动失效。
压缩的不是"指针"本身,而是"编码后的地址"
这里有一个常见的误解:很多人说"指针压缩就是把 8 字节的指针压缩成 4 字节"。但实际上,指针压缩并不是压缩指针本身——它是在存储和使用对象引用时,对地址进行编码和解码。编码阶段:encoded_address = real_address >> 3(利用低 3 位为 0,右移 3 位仍能无损恢复);解码阶段:real_address = encoded_address << 3。这样,32 位的编码就可以表示 35 位的真实地址,寻址范围从 4GB 扩展到 32GB。
哪些指针会被压缩?
- 对象引用(
-XX:+UseCompressedOops):实例数据中的引用字段、局部变量中的引用等。这是默认开启的。 - Klass Pointer(
-XX:+UseCompressedClassPointers):对象头中的 Klass Pointer。这也是默认开启的,且必须在UseCompressedOops开启的前提下才能生效。
开启指针压缩后,一个普通 Java 对象的对象头从 Mark Word 8 字节 + Klass Pointer 8 字节 = 16 字节,变为 Mark Word 8 字节 + Klass Pointer 4 字节 = 12 字节,每个对象节省了 4 字节。对于堆中有上百万个对象的应用来说,这节省的内存量是相当可观的。
六、实战:使用 JOL 查看对象内存布局
Java 官方提供了 JOL(Java Object Layout)工具,可以直观地查看对象的内存布局。要使用 JOL,在 Maven 中添加依赖:
<dependency>
    <groupId>org.openjdk.jol</groupId>
    <artifactId>jol-core</artifactId>
    <version>0.17</version>
</dependency>
然后运行以下代码,可以看到一个 Object 对象的完整内存布局:
import org.openjdk.jol.info.ClassLayout;

public class ObjectLayoutDemo {

    public static void main(String[ ] args) {

        System.out.println(ClassLayout.parseInstance(new Object()).toPrintable());
    }
}
输出结果大致如下(64 位 HotSpot,开启指针压缩):
java.lang.Object object internals:
OFF  SZ   TYPE DESCRIPTION               VALUE
  0   8        (object header: mark)     0x0000000000000001 (non-biasable; age: 0)
  8   4        (object header: class)    0x00000c00
 12   4        (object alignment gap)
Instance size: 16 bytes
Space losses: 0 bytes internal + 4 bytes external = 4 bytes total
解读:OFF 是偏移量(从对象起始地址算起),SZ 是字节数,TYPE 是类型。可以看到:偏移 0-7 是 Mark Word(8 字节),偏移 8-11 是 Klass Pointer(4 字节),偏移 12-15 是对齐填充(4 字节)。总共 16 字节。
JOL 不仅能看到 Object 的布局,还能看到任意自定义类、数组、甚至加锁后的 Mark Word 变化。在生产环境中排查内存占用问题时,JOL 是第一个应该拿出来的工具。
七、面试追问链
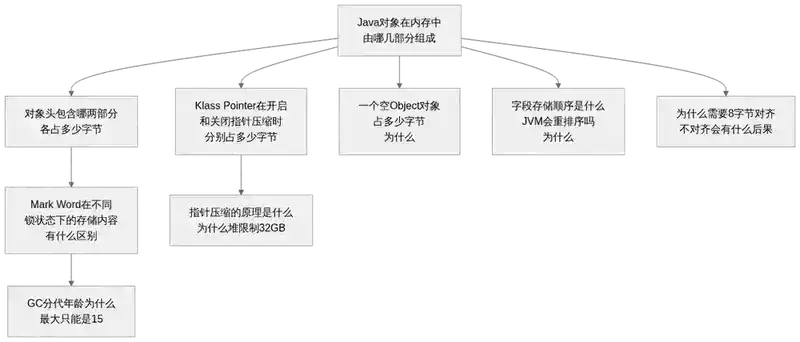
从"Java 对象在内存中由哪几部分组成"这个基础问题出发,逐层追问:对象头包含哪两部分各占多少字节、Mark Word 在不同锁状态下存储的内容有什么不同为什么能复用同一块空间、GC 分代年龄为什么最大只能是 15、Klass Pointer 在开启和关闭指针压缩时分别占多少字节、指针压缩的原理是什么为什么堆内存限制在 32GB、一个空 Object 对象占多少字节为什么、字段存储顺序是什么JVM 会对字段重排序吗、为什么需要 8 字节对齐若不对齐会有什么后果。这条链覆盖了面试官在"对象内存布局"这个话题上的核心考察点。
延伸阅读
- JEP 450(Compact Object Headers):OpenJDK 正在探索进一步压缩对象头到 8 字节的方案,值得关注
- 《Java 虚拟机规范》第 2.6 节 Frames 和第 4 章 class 文件格式,理解对象字段的底层描述
- 「04 JVM 原理与调优」系列下一篇(053)将深入「对象创建过程:类检查、内存分配、零值初始化、对象头设置与构造」
问答(不计入阅读时长)
Q1:一个空的**new Object()**在 64 位 HotSpot JVM(开启指针压缩)中占多少字节?为什么是这个数?
A:占 16 字节。组成:Mark Word 8 字节 + Klass Pointer 4 字节(开启指针压缩) + 实例数据 0 字节(Object 没有字段) = 12 字节。但 JVM 要求对象起始地址必须是 8 字节的整数倍,12 不是 8 的倍数,所以需要填充 4 字节到 16 字节。如果关闭指针压缩,Klass Pointer 变成 8 字节,对象头变成 16 字节,正好是 8 的倍数,不需要填充,同样是 16 字节——所以无论是否开启指针压缩,空的 new Object() 都是 16 字节,但内部组成不同。
Q2:Mark Word 中 GC 分代年龄只有 4 位,所以最大只能是 15。那么**-XX:MaxTenuringThreshold**能不能设成 16 或更大?
A:不能。-XX:MaxTenuringThreshold 的范围是 0-15,JVM 会检查这个值,如果设置超过 15 会直接忽略或报错。这不是 JVM 不想让你设更大,而是 Mark Word 里只给 GC 年龄留了 4 个比特位,物理上限就是 2^4 - 1 = 15。如果对象在 Survivor 区已经经历了 15 次 Minor GC 仍然存活,它就会被直接晋升到老年代,不管 MaxTenuringThreshold 设的是多少。另外,HotSpot 还有一个动态年龄判定机制:如果 Survivor 区中相同年龄的所有对象大小总和超过了 Survivor 空间的一半,那么年龄大于等于这个年龄的对象就可以直接晋升到老年代,不一定要等到 15 岁。
Q3:Mark Word 在不同锁状态下存储的内容不同,这是怎么实现的?JVM 如何知道当前 Mark Word 里存的是 hashCode 还是锁记录指针?
A:Mark Word 的 64 位空间被"多路复用"了——最低 3 位(在某些情况下是 2 位)是锁状态标志位,JVM 通过读取这几位来判断当前 Mark Word 里存的是什么内容。标志位 001 表示无锁状态,此时 Mark Word 中存储的是 hashCode 和 GC 年龄;标志位 101 表示偏向锁,存储的是偏向线程 ID;标志位 00 表示轻量级锁,存储的是指向栈中 Lock Record 的指针;标志位 10 表示重量级锁,存储的是指向 ObjectMonitor 的指针;标志位 11 表示 GC 标记。这种复用之所以可能,是因为不同锁状态是互斥的——一个对象不可能同时处于无锁和偏向锁状态,所以同一块存储空间在不同状态下可以存不同的内容。
Q4:对象头中的 Klass Pointer 在开启指针压缩时是 4 字节,那它指向的元空间地址范围受 32GB 限制吗?
A:不直接受 32GB 限制。Klass Pointer 的压缩机制(-XX:+UseCompressedClassPointers)和普通对象引用的压缩(-XX:+UseCompressedOops)是两套独立的机制,但 UseCompressedClassPointers 必须在 UseCompressedOops 开启的前提下才能生效。压缩后的 Klass Pointer 也是 32 位,编码方式同样是利用 8 字节对齐后低 3 位为 0 的特性,但 Klass Pointer 指向的是元空间(Metaspace),元空间本身在本地内存中,不在 Java 堆里。所以 Klass Pointer 的压缩地址范围限制的是元空间中"类元数据对象"的分布范围,而不是堆内存大小。在默认配置下,压缩的 Klass Pointer 可以覆盖的元空间范围也是约 32GB(2^32 × 8),但这和堆内存的 32GB 限制是独立的。
Q5:JVM 对字段重排序后,**Unsafe**或反射操作会不会受到影响?字段的物理位置变了,还能通过偏移量正确访问吗?
A:不会受到影响。字段重排序只是改变了字段在对象内存中的物理排列顺序,但 JVM 内部维护了每个字段的偏移量(offset)映射。无论字段被重排到哪个位置,Unsafe 和反射操作都是通过这个偏移量来访问字段的,而不是依赖字段的声明顺序。Unsafe.objectFieldOffset() 返回的是 JVM 分配的实际偏移量,这个偏移量已经考虑了字段重排序后的实际位置。所以即使字段在物理布局上被重排了,Unsafe 和反射仍然能正确读写。不过需要注意:字段重排序可能导致同一个类的两个实例在内存中的布局不同吗?理论上,同一类加载器加载的同一个类的所有实例,字段布局是一致的——重排序是在类加载/解析阶段确定的,一旦确定就不会改变。
Q6:为什么 JVM 要求对象 8 字节对齐?如果不对齐会有什么后果?
A:两个原因。一是性能:CPU 访问内存时,对齐的数据通常可以一次读取完成,非对齐的数据可能需要多次读取和拼接,这会显著降低内存访问效率。二是利用低 3 位存储锁状态:因为对象地址是 8 的倍数,地址的低 3 位始终为 000,HotSpot 利用这一点在 Mark Word 的最低 3 位存储锁状态标志位——如果不要求 8 字节对齐,低 3 位就不一定是 0,Mark Word 就没法复用这 3 位来存储锁状态了。如果不对齐,在 x86 架构上通常不会直接崩溃(x86 允许非对齐访问),但性能会下降;在 ARM 等架构上,非对齐访问可能直接导致硬件异常。
Q7:指针压缩的"编码地址右移 3 位"是怎么做的?为什么右移 3 位后还能无损恢复原始地址?
A:因为 8 字节对齐保证了对象地址的低 3 位始终为 0。假设一个对象的真实地址是 0x12345678,二进制最低 3 位是 000。编码时右移 3 位:0x12345678 >> 3 = 0x02468ACF,这个值只需要 32 位就能存储(因为原始地址的低 3 位是 0,右移后不会丢失任何有效信息)。解码时左移 3 位:0x02468ACF << 3 = 0x12345678,完整恢复原始地址。这就是为什么 32 位的压缩指针可以表示 35 位的寻址空间(2^32 × 8 = 2^35 = 32GB)——本质上是把 8 字节对齐多出来的 3 位地址空间"借"给了压缩指针的编码。
Q8:如果要估算一个包含 10 个**int**字段和 1 个**String**引用的对象占多少内存,需要考虑哪些因素?
A:需要考虑:Mark Word 8 字节 + Klass Pointer 4 字节(开启压缩)+ 10 个 int 字段 × 4 字节 = 40 字节 + 1 个 String 引用 4 字节(开启压缩)= 44 字节。加上对象头 12 字节,总共 56 字节。56 已经是 8 的倍数,不需要填充,最终 56 字节。但需要注意:(1) 如果关闭指针压缩,Klass Pointer 变成 8 字节,String 引用变成 8 字节,对象头 16 字节,总大小 16 + 40 + 8 = 64 字节,正好 8 对齐。(2) 父类继承的字段也要算进去。(3) String 字段本身只是一个引用,不包含 String 对象内部 char[ ] 数组的内存——那是另一个对象,需要单独计算。(4) 如果字段有 boolean、byte 等小类型,可能因为字段重排序而改变实际占用空间。面试官考察这个问题的核心是:你是否理解对象头的组成、指针压缩的影响、以及对齐填充的规则。