一、为什么会有虚拟线程:平台线程撞到的天花板
Java 从 1.0 开始,Thread 就直接对应一个操作系统线程——这类线程在 Project Loom 之后被称为平台线程(Platform Thread)。平台线程简单、直观,但有两个跟操作系统绑得很死的成本:
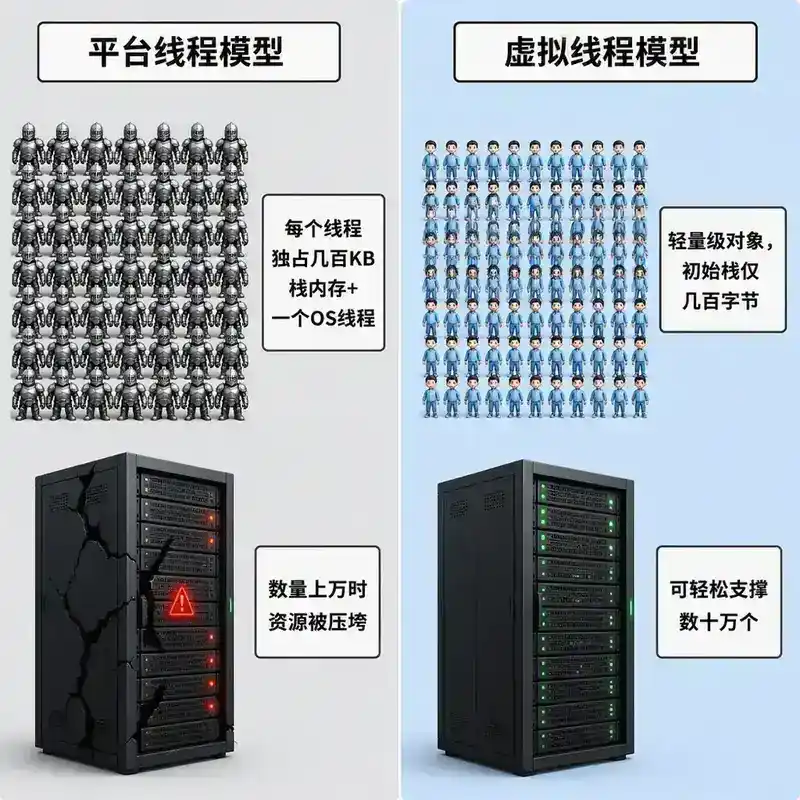
- 内存成本:每个平台线程默认会分配一块独立的栈内存(通常几百 KB 到 1MB),操作系统线程本身的内核数据结构也要占内存。开一万个平台线程,光栈内存就要吃掉几个 GB。
- 调度成本:平台线程由操作系统内核调度,线程切换需要陷入内核态,保存和恢复大量寄存器和上下文信息,代价并不便宜。当线程数远超 CPU 核心数时,频繁的上下文切换会显著拖累整体吞吐量。
这两个成本共同导致了经典的 C10K/C10M 问题:如果一个高并发服务采用"一个请求配一个线程"的模型,当并发连接数上到几万甚至几十万时,光是线程本身的资源开销就能把机器压垮,远远早于业务逻辑本身耗尽资源。过去业界应对这个问题的主流方案是异步非阻塞编程(Netty、Reactor、CompletableFuture 链式调用、协程式的 Kotlin coroutine),用少量线程通过事件循环处理海量并发——但代价是代码可读性大幅下降:一段本来"从上到下顺序执行"的逻辑,会被拆散成一堆回调、then、flatMap,调试和排查异常的体验都变差,这就是所谓"回调地狱"的根源之一。
虚拟线程(Virtual Thread,JDK 21 正式发布,Project Loom 的核心成果)想解决的正是这个矛盾:既要保留"同步顺序编写代码"的简单心智模型,又要能撑住数十万并发。它的做法不是让平台线程变得更轻,而是在 JVM 层面新增一层用户态调度的轻量级线程,把"业务逻辑用什么模型写"和"底层用什么资源真正执行"这两件事解耦开。
二、虚拟线程到底是什么:M:N 调度模型
虚拟线程不是"更快的线程",而是一种全新的抽象层。理解它,关键是搞清楚三个角色:
- 虚拟线程(Virtual Thread):你在代码里
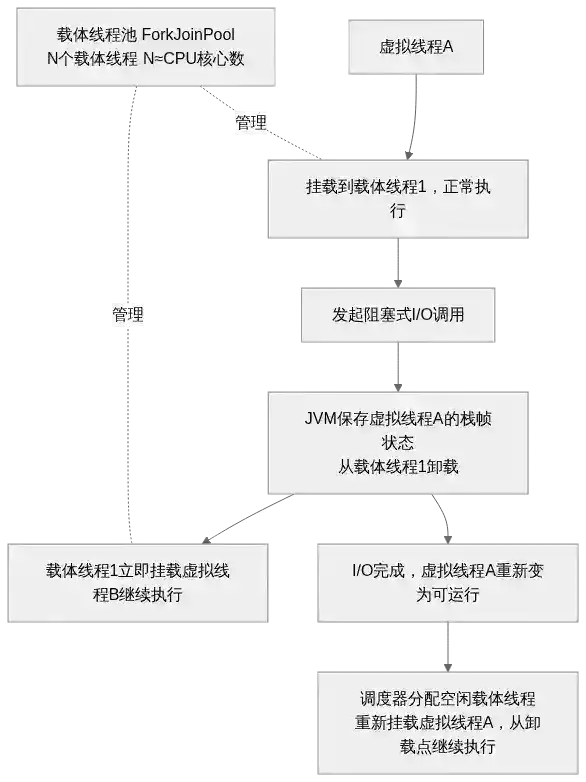
Thread.ofVirtual().start(...)创建出来的对象,它是一个存在于 JVM 堆上的普通 Java 对象,初始栈很小(可以按需增长),创建和销毁的成本极低。 - 载体线程(Carrier Thread):真正在操作系统层面执行代码的平台线程。虚拟线程本身不会执行任何 CPU 指令,它必须"挂载"到一个载体线程上才能真正跑起来。
- 调度器(Scheduler):默认是一个专门的
ForkJoinPool(工作窃取线程池),线程数默认等于 CPU 核心数。调度器负责决定"这个虚拟线程接下来挂到哪个载体线程上执行"。
这构成了一个经典的 M:N 线程模型:M 个虚拟线程(可以是几十万)映射到 N 个载体线程(通常等于 CPU 核心数,比如 8 或 16 个)上执行。这跟早期 Java(1.1 之前)的"绿色线程"(Green Thread)思路类似,但当年的绿色线程因为不能利用多核而被淘汰;虚拟线程能重新做起来,是因为现代 JVM 已经能让载体线程池充分利用多核,虚拟线程只是在这批载体线程之上做更细粒度的复用。
核心机制是"挂载"(mount)和"卸载"(unmount):当一个虚拟线程执行到会阻塞的操作(比如网络 I/O、Thread.sleep、java.util.concurrent 包里支持虚拟线程感知的阻塞方法)时,JVM 会把这个虚拟线程的执行状态(栈帧信息)保存下来,将它从载体线程上卸载,然后载体线程立刻可以去挂载、执行另一个处于可运行状态的虚拟线程。等到原来那个虚拟线程等待的 I/O 完成了,调度器会找一个空闲的载体线程,把它重新挂载上去继续执行——从代码的角度看,这整个过程完全透明,业务代码里就是一行普通的阻塞调用,没有任何回调或异步语法。
这也是虚拟线程真正的杀手级特性:它把"阻塞时让出资源"这件事从"程序员手写异步代码"下沉到了"JVM 自动管理",你写的还是最朴素的同步顺序代码,但获得了异步模型的资源利用效率。
三、pinning:虚拟线程"卸载不掉"的例外情况
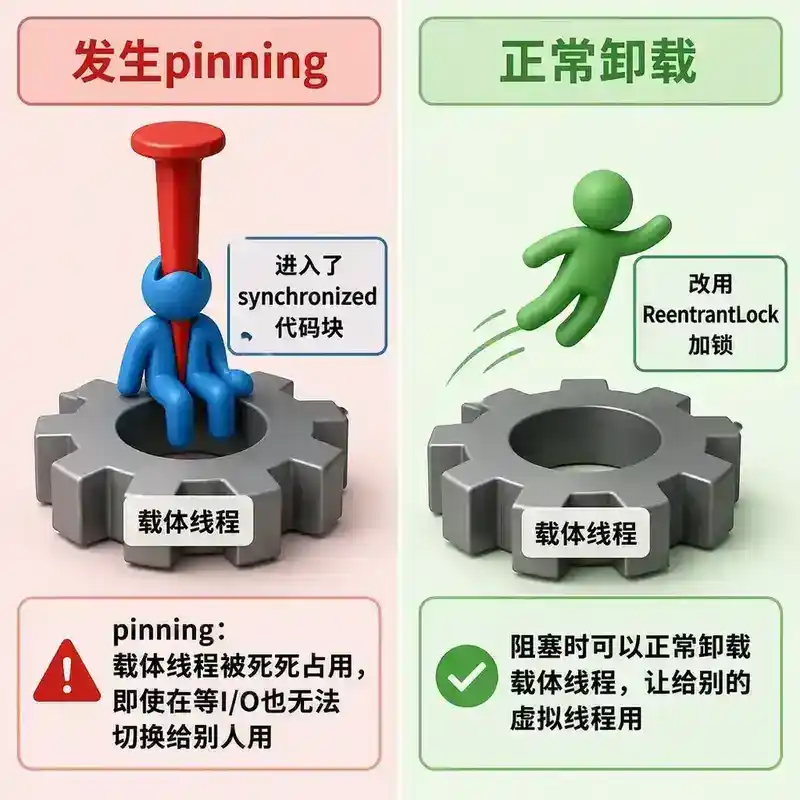
虚拟线程的优势建立在"遇到阻塞就能卸载载体线程"这个假设上,但有几种情况下,虚拟线程即使阻塞了,也无法从载体线程上卸载,这种现象叫pinning(钉住)。一旦发生 pinning,这个载体线程会被这一个虚拟线程死死占用,即使它本身在等待 I/O、什么正事都没干,其他虚拟线程也没法用这个载体线程——如果大量虚拟线程同时发生 pinning,载体线程池(默认只有 CPU 核心数那么多个)就会被占满,新来的虚拟线程即使已经就绪也排不上号,整体吞吐量会退化到接近平台线程模型。
已知会导致 pinning 的场景(JDK 21/22 阶段):
- 在
**synchronized**代码块或方法内执行阻塞操作:这是最常见的 pinning 来源。synchronized依赖的是操作系统级别的 Monitor 锁机制,跟虚拟线程的调度器是两套独立的机制,JVM 目前无法在synchronized块内部安全地做栈帧的保存和恢复,所以只能把虚拟线程钉在原来的载体线程上等着。替代方案:把synchronized替换成java.util.concurrent.locks.ReentrantLock,ReentrantLock是纯 Java 实现的锁,对虚拟线程是"卸载友好"的,阻塞时可以正常卸载载体线程。 - 调用 native 方法或外部函数接口(FFI)时阻塞:因为虚拟线程的调度机制是 JVM 层面实现的,一旦执行流进入了 native 代码(比如某些 JNI 调用、老旧的文件 I/O 实现),JVM 就失去了对这段执行的控制权,自然也没法在这期间做卸载。
如何发现 pinning:JDK 提供了诊断参数 -Djdk.tracePinnedThreads=full(或 short),开启后,当虚拟线程在阻塞时因为 pinning 无法卸载,会在标准输出打印一段栈追踪,明确指出是哪一行代码、因为什么原因(比如 synchronized 块)导致了 pinning,方便针对性地排查和替换。生产环境做虚拟线程迁移评估时,这个参数几乎是必开项——不开的话,pinning 会安静地发生,只在压测数据里表现为"吞吐量没有达到预期",很难直接定位原因。
四、适用场景:I/O 密集型任务的福音,CPU 密集型任务无感
虚拟线程带来的资源效率提升,本质上来自"阻塞时能腾出载体线程给别人用"这一点。所以它的收益高度依赖任务的性质:
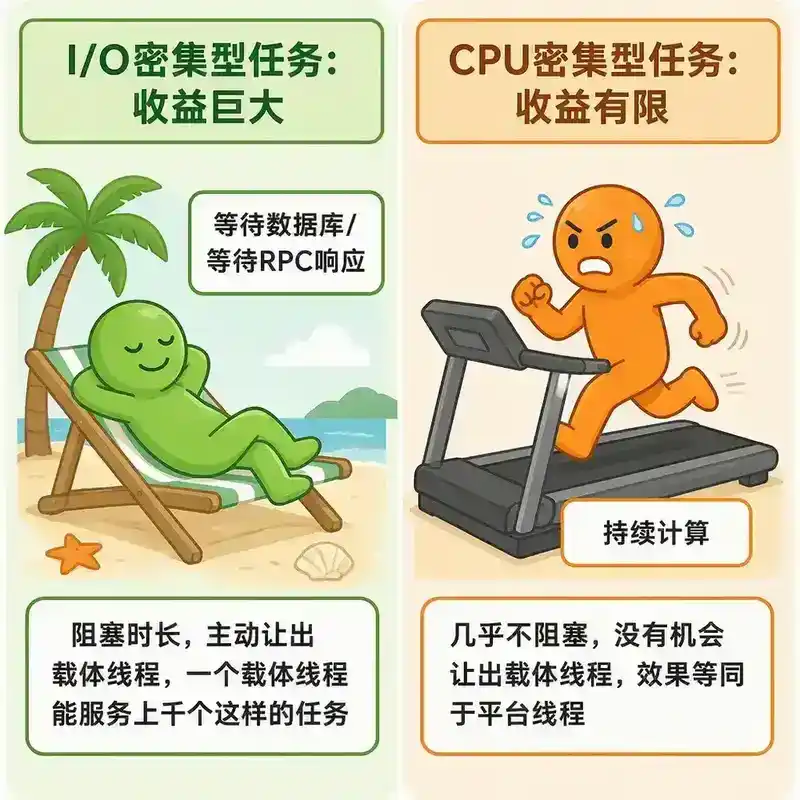
- I/O 密集型任务,收益巨大:典型场景是 Web 服务器处理 HTTP 请求——每个请求的处理逻辑里大部分时间花在等数据库返回、等下游 RPC 响应、等磁盘读写上,真正占用 CPU 计算的时间很短。这种场景下,用虚拟线程给每个请求分配一个"专属线程",代码逻辑简单直观,同时因为大部分虚拟线程时刻都在阻塞等待、被卸载让出载体线程,少量载体线程就能支撑起海量并发请求。这正是虚拟线程被设计出来要解决的核心场景。
- CPU 密集型任务,几乎没有收益甚至有额外开销:如果任务本身就是持续占用 CPU 做计算(比如复杂的数值运算、图像处理、加密解密),几乎不会主动让出执行权,虚拟线程也就没有"卸载"的机会。这种场景下,无论是用虚拟线程还是平台线程,能同时执行的任务数都受限于 CPU 核心数,虚拟线程反而因为多了一层调度和栈帧管理,可能带来轻微的额外开销。对于纯 CPU 密集型任务,
ForkJoinPool+ 平台线程仍然是更合适的选择。
另外几个需要谨慎评估的场景:
- 需要维护线程本地状态、依赖线程数量有限的设计:比如某些连接池、缓冲区池的实现,假设"线程数量有限且相对固定",用
ThreadLocal给每个线程绑定一个专属的昂贵对象(数据库连接、编解码器缓冲区)来避免重复创建。如果直接套用虚拟线程(数量可能是几十万),每个虚拟线程都触发一次ThreadLocal的初始化,会造成大量重复创建、内存暴涨——这类场景应该使用 JDK 21 引入的ScopedValue,或者把资源池化的粒度从"绑定线程"改成"绑定载体线程数量级的池"。 - 本来就用固定大小线程池限流的场景:如果一段代码用线程池的固定大小来控制"同时最多多少个任务在跑"(比如限制同时对某个下游服务的并发请求数),直接把线程池换成虚拟线程会让这个隐式的限流失效——因为虚拟线程可以创建几十万个,不会有线程池排队等待的效果。这种场景需要用显式的限流机制(比如
Semaphore)来代替"线程池大小"这个隐式限流手段。
五、虚拟线程 vs 平台线程:核心特性对照
| 维度 | 平台线程 | 虚拟线程 |
|---|---|---|
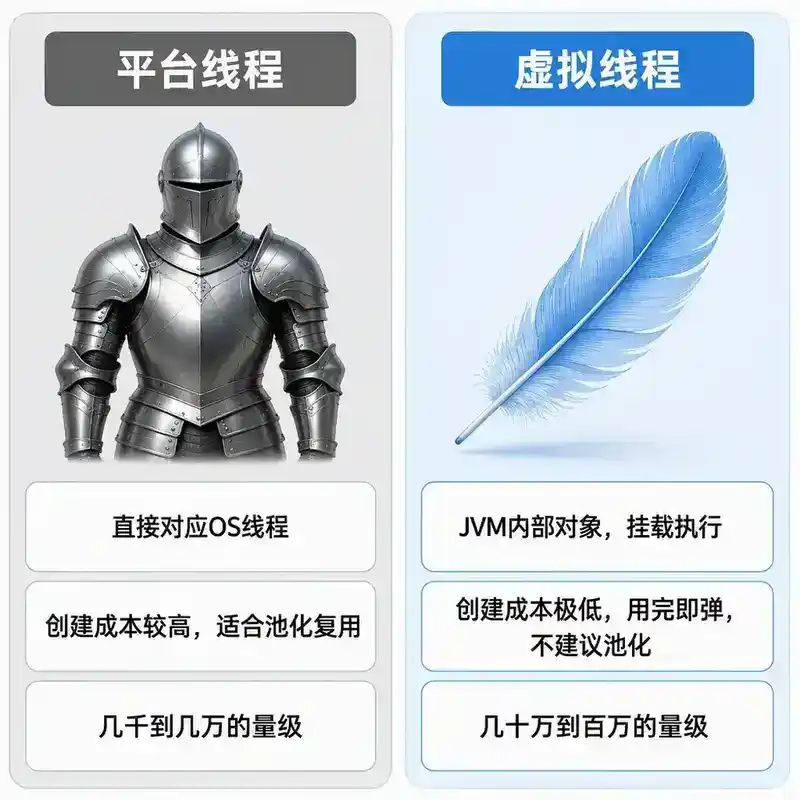
| 底层对应 | 直接对应一个操作系统线程 | JVM 内部对象,需挂载到载体线程才能执行 |
| 创建成本 | 较高(分配 OS 线程资源) | 极低(普通 Java 对象分配) |
| 初始栈大小 | 固定,通常几百 KB 到 1MB | 很小(几百字节级别),按需增长,存在堆上 |
| 可创建数量级 | 几千到几万(受内存和调度限制) | 几十万到百万级 |
| 调度方 | 操作系统内核 | JVM 的用户态调度器(默认 ForkJoinPool) |
| 阻塞时的行为 | 线程本身被挂起,占着 OS 资源不动 | 通常会从载体线程卸载,让出资源(除非发生 pinning) |
| 是否支持池化复用 | 支持(线程池),且很常见 | 官方明确不建议池化,用完即弹,创建成本本来就很低 |
| 典型适用场景 | CPU 密集型计算、需要精细控制线程数量的场景 | 高并发 I/O 密集型服务(Web 请求处理、RPC 调用链) |
这里有一个容易踩的坑:不要把虚拟线程放进传统的线程池里复用。传统线程池存在的意义是"避免频繁创建销毁线程的高成本",但虚拟线程本身创建成本就极低,池化复用反而会限制虚拟线程的数量(回到"固定大小线程池"的老问题),完全违背了虚拟线程"随需创建、用完即弹"的设计初衷。JDK 官方推荐的做法是用 Executors.newVirtualThreadPerTaskExecutor(),这个 Executor 会为每个提交的任务创建一个全新的虚拟线程,而不是从某个池子里复用已有线程。
六、常见误区与实践建议
结合前面的调度模型和 pinning 机制,几个在生产环境落地虚拟线程时需要特别注意的点:
- 排查代码里残留的
**synchronized**:如果一个已有系统要迁移到虚拟线程,第一步应该是全局搜索synchronized关键字,评估每一处是否可能在同步块内触发阻塞式 I/O。可以先开启-Djdk.tracePinnedThreads=full跑一轮真实流量或压测,用输出结果定位真正需要改造的位置,而不是盲目地把所有synchronized都替换掉(很多短临界区、纯内存操作的synchronized其实无所谓)。 - 重新评估基于线程池大小做限流的代码:任何"用固定大小线程池间接限制并发数"的地方,迁移到虚拟线程后都需要换成显式的并发控制手段(
Semaphore、令牌桶等),否则并发控制会直接失效。 **ThreadLocal**用量大的模块要单独评估:尤其是那种"在线程里缓存一个较重对象、假设线程数量有限"的写法,虚拟线程数量级完全不同,需要考虑改用ScopedValue或者把缓存对象的生命周期从"线程级"调整为"池级"或"请求级"。- 不要用虚拟线程做 CPU 密集型任务的并行加速:如果目标是加速纯计算任务,
ForkJoinPool配合平台线程仍然是正确工具,虚拟线程在这类场景下不会带来收益。 - 虚拟线程仍然是"线程",不要滥用数量:虽然虚拟线程可以创建几十万个,但每一个仍然占用一定的堆内存和调度开销,如果业务逻辑本身有明确的并发上限(比如下游服务的处理能力),仍然应该有相应的限流设计,而不是无限制地为每个请求创建虚拟线程。
七、面试追问链
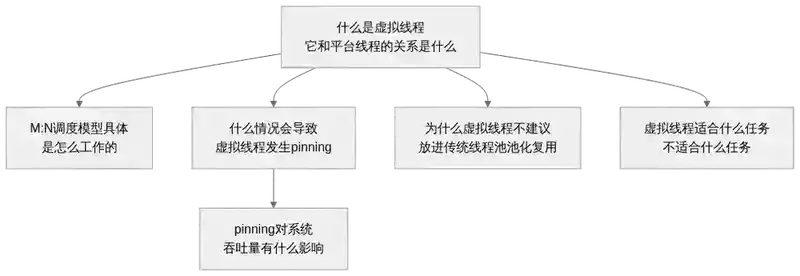
从"什么是虚拟线程,它和平台线程的关系是什么"这个基础问题出发,逐层追问:虚拟线程的 M:N 调度模型具体是怎么工作的、什么情况会导致虚拟线程发生 pinning、pinning 对系统吞吐量的影响机制是什么、为什么虚拟线程不建议放进传统线程池里池化复用、以及虚拟线程适合什么样的任务不适合什么样的任务,这条链基本覆盖了面试官在这个话题上的核心考察点。
延伸阅读
- JEP 444(Virtual Threads,JDK 21 正式特性)官方文档,理解虚拟线程的完整设计动机和 API 细节
ScopedValue(JEP 446):作为ThreadLocal在虚拟线程场景下的替代方案,理解其不可变、结构化作用域的设计差异- 「03 Java 并发编程」系列至此完结(031-050),下一篇将开启新的分类
问答(不计入阅读时长)
Q1:虚拟线程和平台线程是什么关系?虚拟线程执行时到底是不是"真的线程"在跑代码?
A:虚拟线程本身不会执行任何 CPU 指令,它只是 JVM 堆上的一个普通 Java 对象,记录着这个"逻辑执行流"的栈帧状态。真正在 CPU 上跑代码的永远是平台线程——只不过在虚拟线程的语境下,这些平台线程被称为"载体线程"(Carrier Thread)。可以理解为虚拟线程是"剧本",载体线程是"演员":同一时刻只有挂载在载体线程上的虚拟线程才在真正执行,没挂载的虚拟线程只是安静地保存着自己的状态等待被再次挂载。
Q2:M:N 调度模型具体是怎么工作的?为什么载体线程数量通常等于 CPU 核心数?
A:M 个虚拟线程(可以是几十万)由调度器(默认是一个 ForkJoinPool)动态分配到 N 个载体线程上执行,N 默认等于 CPU 核心数。载体线程数量设成 CPU 核心数是因为:一旦虚拟线程真正在执行计算(没有被卸载),它就跟平台线程一样占用一个 CPU 核心,更多的载体线程数并不能让计算跑得更快,只会增加操作系统层面的线程调度开销。调度器的核心工作就是不断地把"可运行但还没挂载"的虚拟线程分配给"空闲的载体线程",尽量让 N 个载体线程始终有活干。
Q3:什么情况会导致虚拟线程发生 pinning?为什么偏偏是**synchronized**会出问题,而普通的方法调用不会?
A:目前已知会导致 pinning 的场景主要有两类:一是在 synchronized 代码块或方法内执行阻塞操作;二是执行流进入 native 方法(比如某些 JNI 调用)时发生阻塞。根本原因在于"卸载"这个操作需要 JVM 能够完整地保存虚拟线程当前的栈帧状态,synchronized 依赖的 Monitor 锁是操作系统层面的机制,和虚拟线程调度器是两套独立体系,JVM 目前没法在这个锁的持有期间安全地做栈帧的保存/恢复,所以只能把虚拟线程原地钉住等锁释放。而普通方法调用完全在 JVM 的管控范围内,不涉及跨越到 JVM 无法插手的层面,所以可以正常保存和恢复。
Q4:pinning 对系统吞吐量具体会造成什么样的影响?会不会导致整个系统卡死?
A:不会直接导致系统卡死,但会明显拖累吞吐量。载体线程池的大小通常只有 CPU 核心数那么多个(比如 8 或 16 个),如果同一时刻有大量虚拟线程都因为 pinning 卡在各自的载体线程上等待 I/O,这些载体线程就没法被腾出来服务其他已经就绪的虚拟线程——本质上退化成了"载体线程数量个平台线程在处理请求",跟没用虚拟线程时的效果差不多,甚至因为多了一层虚拟线程管理的开销还会略差。系统不会死,但高并发场景下设计的吞吐量优势会大幅缩水,压测数据会明显低于预期。
Q5:为什么虚拟线程不建议放进传统线程池里池化复用?直接套用现成的线程池代码不是更省事吗?
A:传统线程池存在的核心价值是"避免频繁创建/销毁线程的高成本"——因为平台线程创建一个就要分配一份 OS 线程资源,成本不低。但虚拟线程本身创建成本极低(就是普通对象分配),完全不需要靠池化来摊薄成本。更关键的是,如果把虚拟线程塞进一个固定大小的线程池,就相当于人为地把"可以创建几十万个"限制回了"池子大小这么多个",直接抵消了虚拟线程最大的优势。正确做法是用 Executors.newVirtualThreadPerTaskExecutor(),让每个任务都拿到一个全新创建的虚拟线程,用完直接丢弃即可。
Q6:虚拟线程适合什么任务,不适合什么任务?能不能用虚拟线程给纯计算任务做并行加速?
A:虚拟线程最适合 I/O 密集型任务,比如 Web 服务器处理 HTTP 请求——大部分时间花在等数据库、等下游 RPC 上,真正占 CPU 的时间很短,这种"频繁阻塞又频繁恢复"的模式正好能发挥虚拟线程"阻塞就让出载体线程"的优势。但对纯 CPU 密集型任务(比如复杂数值计算),因为几乎不会主动阻塞让出执行权,虚拟线程没有任何优势可言,能同时跑的任务数一样受限于 CPU 核心数,这种场景下 ForkJoinPool 配合平台线程仍然是更合适的选择,不应该指望切换成虚拟线程就能获得并行加速。
Q7:如果一段代码原本用固定大小的线程池来限制"同时最多多少个任务在跑",直接换成虚拟线程会有什么问题?
A:会导致这个隐式的限流失效。很多代码习惯用线程池的大小间接控制并发上限(比如"最多同时对下游服务发起 20 个并发请求",靠一个大小为 20 的线程池排队实现),但虚拟线程创建成本很低、数量可以到几十万个,如果直接用虚拟线程替代,原来靠线程池排队实现的限流效果会完全消失,所有请求都会立刻创建虚拟线程发出去。迁移到虚拟线程后,这类场景必须换成显式的并发控制手段,比如用 Semaphore 明确限制同时执行的任务数量。
Q8:为什么说虚拟线程场景下**ThreadLocal**的使用需要重新评估?和**ScopedValue**有什么关系?
A:ThreadLocal 常见的一个用法是"给每个线程绑定一个较重的专属对象"(比如数据库连接、编解码缓冲区),来避免重复创建,这个设计隐含的假设是"线程数量有限且相对固定"。但虚拟线程的数量级可能是几十万个,如果照样用 ThreadLocal 给每个虚拟线程都初始化一份这种较重的对象,会造成大量重复创建和内存暴涨,完全违背了 ThreadLocal 原本"节省重复创建成本"的初衷。JDK 为此专门引入了 ScopedValue(JEP 446),它提供的是一种不可变、结构化作用域内共享数据的方式,语义上更适合虚拟线程这种"用完即弹"的场景,能替代很多原本靠 ThreadLocal 实现的用法。