一、锁解决的是"互斥",这几个工具解决的是"节奏"
前面几篇讲的 synchronized、ReentrantLock、AQS 解决的核心问题是"互斥"——同一时刻只让一个线程进入临界区,避免数据被并发修改破坏。但实际业务里,还有另一类完全不同的需求:多个线程之间需要按某种"节奏"协调,而不是争抢同一份资源。比如"主线程要等好几个子任务全部跑完才能继续往下走",或者"多个线程要先各自完成第一阶段的工作,等所有人都到齐了再一起进入第二阶段",或者"某个资源池只有固定数量的名额,超出名额的线程要排队等"。
java.util.concurrent 包里专门为这类"协调节奏"的场景准备了四个工具类:CountDownLatch、CyclicBarrier、Semaphore、Phaser。它们内部大多数都是基于前面讲过的 AQS(Semaphore 直接是,CountDownLatch 也是;CyclicBarrier 和 Phaser 则是基于 ReentrantLock/Condition 或者更底层的 CAS 实现),但暴露出来的语义完全不一样,选错了不会报错,但代码写起来会非常别扭,甚至埋下难以察觉的 bug。这篇要讲清楚这四个工具各自解决的问题、内部关键行为、以及最容易混淆的几个边界。
二、CountDownLatch:一次性的倒计时器
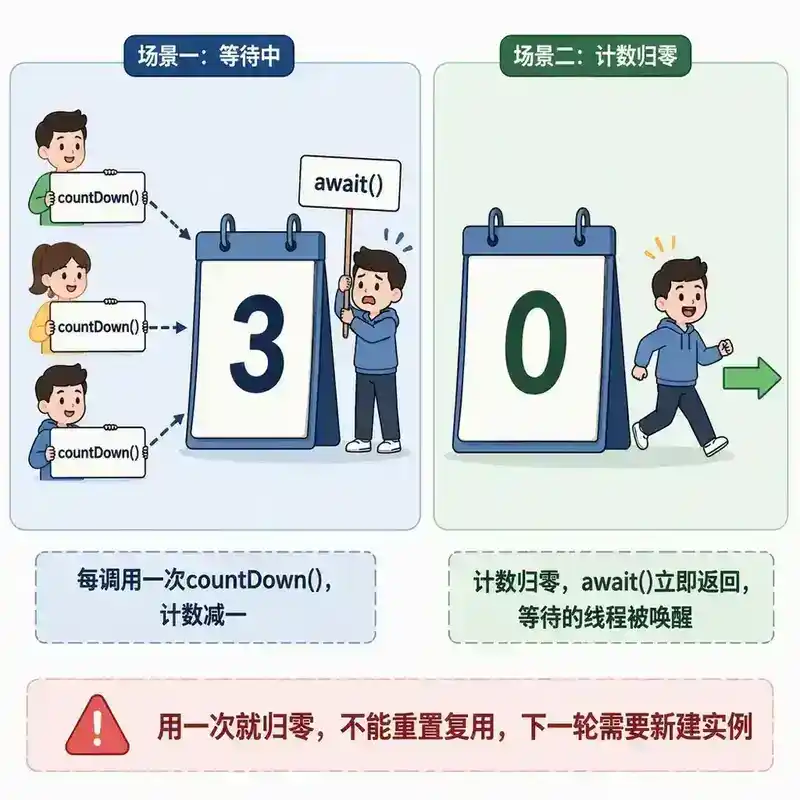
CountDownLatch 的语义非常直白:构造时传入一个初始计数值 count,countDown() 每调用一次计数值减一,await() 会阻塞调用线程,直到计数值减到 0 才放行。最经典的用法是"主线程等待多个并行子任务全部完成":
CountDownLatch latch = new CountDownLatch(3);
// 三个子任务各自执行完调用 latch.countDown()
latch.await(); // 主线程等待三个任务都完成
它的内部实现直接复用了 AQS:计数值就是 AQS 的 state 字段,countDown() 本质是 state 的 CAS 递减操作,await() 会检查 state 是否为 0,不为 0 就把当前线程放入 AQS 的等待队列挂起,state 归零时会唤醒所有等待的线程——这也是为什么 CountDownLatch 天然支持"多个线程同时 await,计数归零时全部被唤醒"这种一对多的通知模式。
最容易踩的坑是:**CountDownLatch**用一次就废,不能重置。计数值一旦归零,这个 CountDownLatch 对象就永久处于"放行"状态,后续任何 await() 调用都会立刻返回,countDown() 再调用也没有任何效果(state 已经是 0,不会变成负数)。如果业务场景需要"周期性地重复这套等待-放行"的逻辑(比如每一轮任务都要等所有子任务完成),必须每一轮都创建一个新的 CountDownLatch 实例,不能想着复用同一个对象。
三、CyclicBarrier:所有人互相等所有人,还能重复用
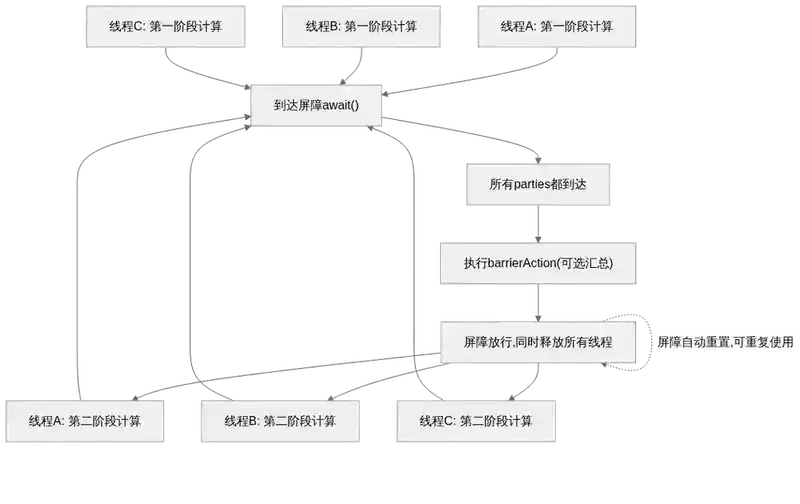
CyclicBarrier 解决的场景和 CountDownLatch 表面相似但本质不同:CountDownLatch 是"一个(或几个)线程等着别的线程干完活",而 CyclicBarrier 是"一组线程互相等待,所有人都到达某个集合点后再一起继续往下走"——没有谁是专门"等待方",参与的每个线程既是被等的人也是等的人。
构造 CyclicBarrier 时传入参与方数量 parties,每个线程完成自己这一阶段的工作后调用 await(),这个调用会阻塞,直到调用 await() 的线程数量达到 parties,所有线程才会同时被放行、一起进入下一阶段。可以额外传入一个 Runnable(barrier action),它会在最后一个线程到达屏障、即将放行所有线程之前被执行——通常用来做"这一阶段汇总数据"之类的收尾工作。
和 CountDownLatch 最大的实用差异是:**CyclicBarrier**天然支持重复使用(这也是"Cyclic"这个名字的来源)——一轮所有线程都通过屏障之后,内部计数会自动重置,可以直接开始下一轮的等待,不需要像 CountDownLatch 那样每轮重新创建对象。这让它特别适合"分阶段并行计算"的场景——比如多个线程各自处理一部分数据,每处理完一个阶段就要同步一次,再开始下一个阶段,反复循环多轮。
CyclicBarrier 还有一个 CountDownLatch 没有的行为:如果某个线程等待超时或者被中断,屏障会被判定为"损坏"(broken),所有正在等待的其他线程会收到**BrokenBarrierException**——因为屏障的语义是"所有人必须一起通过",一旦有人掉队,继续让剩下的人傻等下去没有意义,框架会主动把等待中的线程都唤醒并报错,而不是让它们无限期挂起。
四、Semaphore:管理一批"许可证",控制并发访问数量
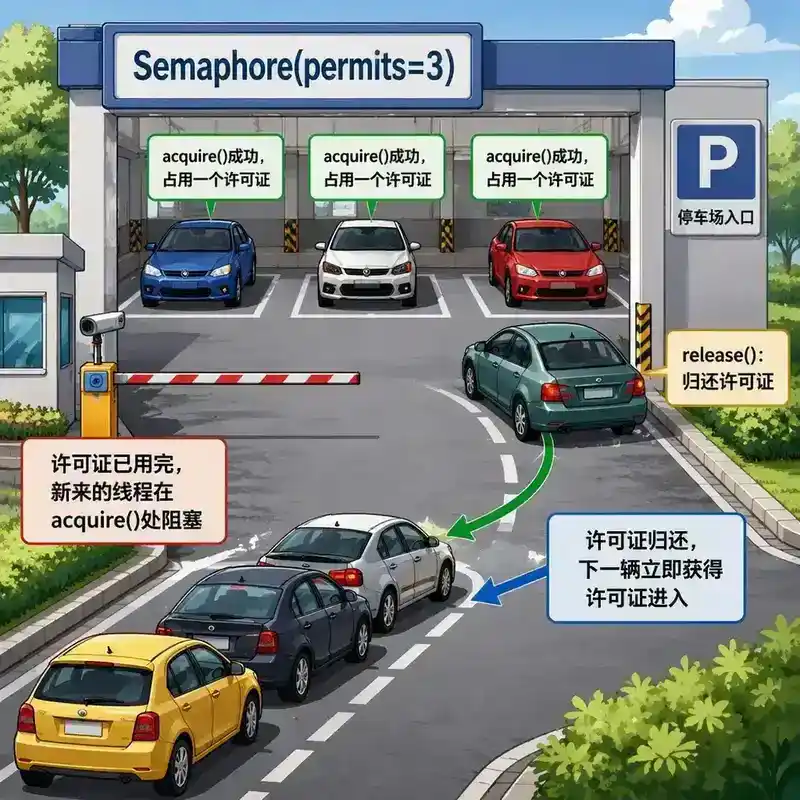
Semaphore(信号量)解决的是完全不同的问题:限制同时能访问某个资源的线程数量。构造时传入许可证数量 permits,线程调用 acquire() 会尝试拿走一个许可证(拿不到就阻塞等待),用完之后调用 release() 把许可证还回去。任何时刻,成功拿到许可证、还没释放的线程数量不会超过 permits。
典型场景是限流和资源池管理:比如一个数据库连接池只有固定数量的连接,或者一个下游接口约定了最大并发调用数,都可以用 Semaphore 来控制"同时最多有 N 个线程在使用这个资源"。它的内部同样是基于 AQS,permits 数量就是 state,acquire() 是 CAS 递减,release() 是 CAS 递增,递减到负数(也就是许可证不够)时线程会被放入等待队列挂起。
Semaphore 也支持公平模式和非公平模式(构造时传入 fair 参数),语义和 ReentrantLock 的公平/非公平完全一致:公平模式下等待的线程严格按照请求顺序拿到许可证,非公平模式下允许后来的线程"插队"抢到刚释放的许可证,吞吐量通常更高但可能导致某些线程长时间拿不到许可证。
有一个容易被忽略的细节:**Semaphore**的许可证数量本身没有和"谁持有"绑定——acquire() 和 release() 不要求必须是同一个线程调用,release() 甚至可以在没有对应 acquire() 的情况下被调用(会让 permits 数量增加,超出初始值也不会报错)。这既是灵活性,也是一个潜在的坑:如果代码逻辑写错了、release() 调用次数比 acquire() 多,Semaphore 允许的并发数会在不知不觉中"膨胀",而不会有任何异常提示。
五、Phaser:比 CyclicBarrier 更灵活的多阶段协调工具
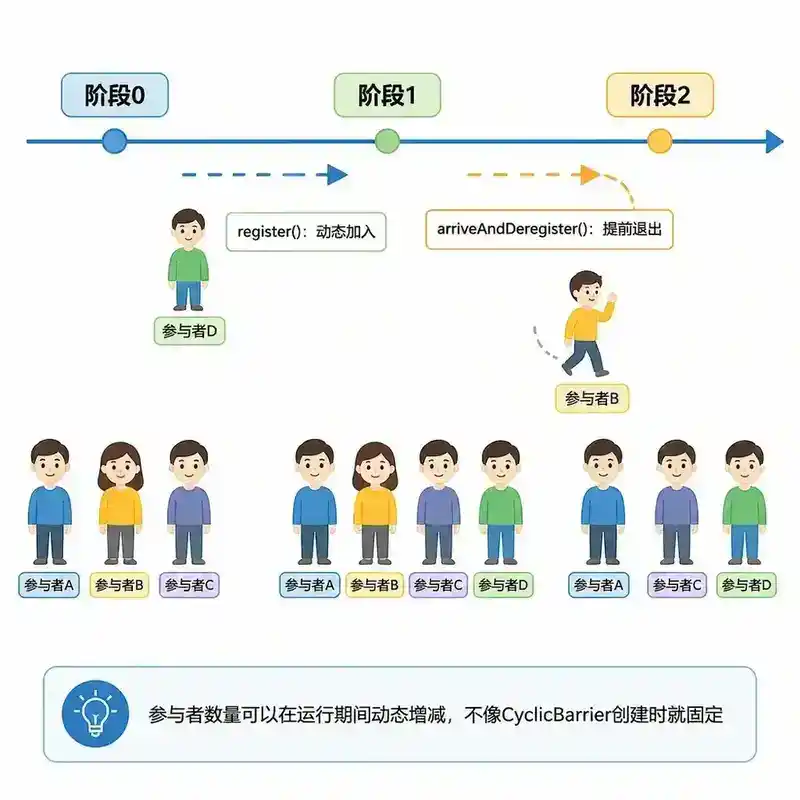
Phaser(Java 7 引入)可以看作是 CyclicBarrier 的一个更强大的升级版,用来解决 CyclicBarrier 的一个明显局限:**CyclicBarrier**的参与方数量**parties**在构造时就固定了,运行期间无法动态调整。但很多实际场景里,参与协调的线程数量是动态变化的——比如一批并行任务里有的任务提前结束不再参与后续阶段、或者运行期间需要动态加入新的参与者。
Phaser 支持通过 register()/bulkRegister() 动态增加参与者,通过 arriveAndDeregister() 让一个参与者完成当前阶段后直接退出、不再参与后续阶段的同步。它把"一轮同步"抽象成了"阶段"(phase)的概念——每完成一轮同步,内部的阶段号就会递增,arriveAndAwaitAdvance() 方法(等价于 CyclicBarrier 的 await())会阻塞到当前阶段的所有参与者都到达为止,然后自动进入下一阶段。
Phaser 还支持分层结构(一个 Phaser 可以有子 Phaser),用于减少大量参与者同时竞争同一个屏障对象带来的争用开销——这在参与者数量特别多的场景下能有效降低同步本身的性能损耗,是 CyclicBarrier 完全没有的能力。不过 Phaser 的 API 也明显比前三者更复杂,日常业务代码里用到它的频率远低于 CountDownLatch、Semaphore,通常只有在真正需要"动态参与者数量"或者"多阶段协调"且用 CyclicBarrier 会很别扭的场景,才值得引入。
六、四者怎么选:一张对照表看清适用场景
把这四个工具的核心差异放在一起对比,能更清楚地看出各自该用在什么地方:
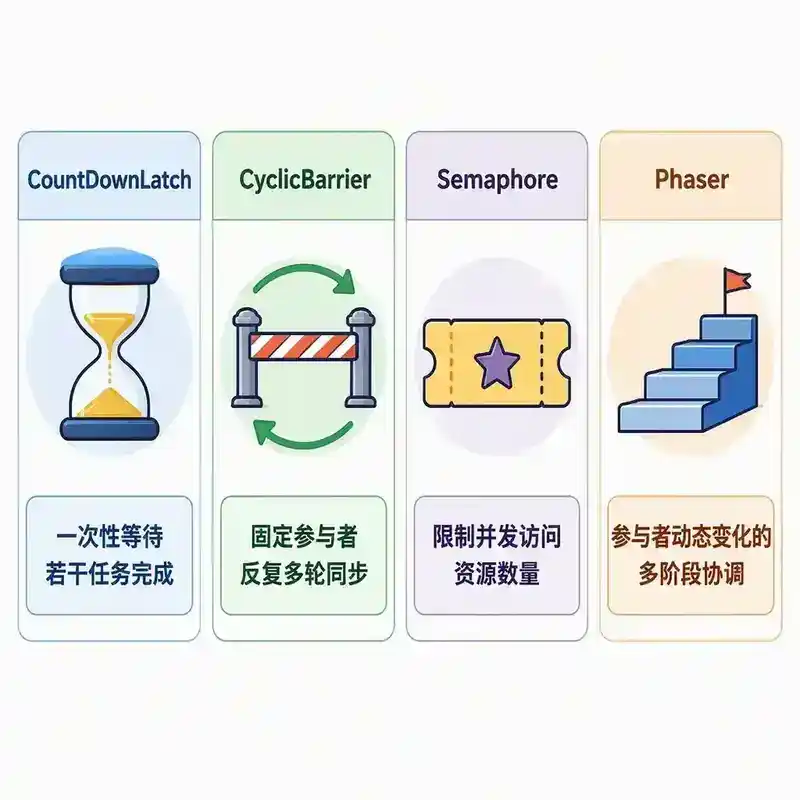
**CountDownLatch**:适合"一次性等待若干任务完成"的场景,语义是"减到 0 就放行",用完即弃,不能重复使用。**CyclicBarrier**:适合"一组线程需要反复分阶段互相同步"的场景,语义是"所有参与方都到达才一起放行",自动重置可重复用,还能在放行前执行一段汇总逻辑。**Semaphore**:适合"限制同时访问某资源的并发数量"的场景,语义是"许可证够不够",和CountDownLatch/CyclicBarrier的"等待所有人到齐"完全不是一类问题,更接近一个可以线程无关地获取和归还的计数器。**Phaser**:适合"参与者数量会动态变化、且需要多阶段协调"的场景,是CyclicBarrier的超集,但复杂度更高,只有在CyclicBarrier真的无法满足动态参与者需求时才需要引入。
一个实用的判断顺序是:先看是不是"限流/控制并发数"——是的话直接用 Semaphore;再看是不是"一次性等待若干任务完成,之后不需要重复这套逻辑"——是的话用 CountDownLatch;如果需要"反复多轮同步,且参与者数量固定",用 CyclicBarrier;只有当参与者数量会在运行期间变化时,才考虑 Phaser。
七、面试追问链
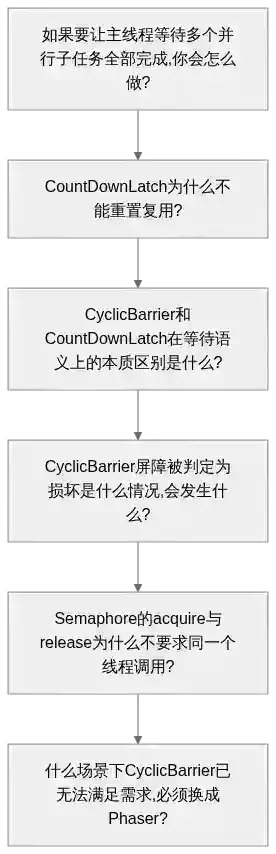
从"如果要让主线程等待多个并行子任务全部完成,你会怎么做"这个入门问题出发,逐层追问:CountDownLatch 为什么不能重置复用、CyclicBarrier 和 CountDownLatch 在等待语义上的本质区别是什么、CyclicBarrier 屏障被判定为"损坏"是什么情况以及会发生什么、Semaphore 的 acquire/release 为什么不要求同一个线程调用、以及什么场景下 CyclicBarrier 已经无法满足需求、必须换成 Phaser,这条链基本能覆盖面试官对并发协调工具类这个话题的核心考察点。
延伸阅读
java.util.concurrent.CountDownLatch与Semaphore内部Sync内部类继承AbstractQueuedSynchronizer的具体实现,能更直接地看到它们和ReentrantLock共享同一套底层调度框架CyclicBarrier内部基于ReentrantLock/Condition实现的nextGeneration()逻辑,理解"generation"概念是如何支撑起自动重置能力的- 下一篇预告:并发容器:ConcurrentHashMap 的分段锁演进、CopyOnWriteArrayList 的读写权衡与适用边界
问答(不计入阅读时长)
Q1:为什么**CountDownLatch**用一次就不能重置复用?内部是怎么实现的?
A:CountDownLatch 内部直接复用了 AQS,构造时传入的计数值就是 AQS 的 state 字段。countDown() 本质是对 state 做 CAS 递减,await() 检查 state 是否为 0。当 state 递减到 0 之后,它就永久停留在"已放行"状态——countDown() 再调用不会让它变成负数(CAS 递减在 0 时会直接跳过或失败),await() 也只会立刻返回。整个类没有提供任何"把 state 重新设回初始值"的方法,因为它的设计目标就是"一次性等待",不是可循环使用的同步工具,需要重复这套逻辑时必须每轮新建实例。
Q2:**CyclicBarrier**和**CountDownLatch**在等待语义上的本质区别是什么?
A:CountDownLatch 是"旁观者等待参与者"模式——await() 的线程和调用 countDown() 的线程可以完全不是同一批,甚至数量也不需要对应(比如一个主线程等三个子任务,只有主线程调用 await())。CyclicBarrier 是"参与者互相等待"模式——所有 parties 数量的线程都要调用 await(),既是被等的一方也是等待的一方,没有人能只旁观不参与。这也是为什么 CyclicBarrier 能自动重置重复使用:它的"一轮"有明确的起点和终点(所有参与者到达即完成一轮),而 CountDownLatch 的"完成"和"重新开始"之间没有这种对称性。
Q3:**CyclicBarrier**的屏障被判定为"损坏"(broken)具体是什么情况?会发生什么?
A:当正在等待屏障的某个线程被中断、或者等待超时(如果用了带超时的 await(timeout, unit)),又或者屏障的 barrierAction 执行时抛出异常,屏障就会被标记为损坏。一旦损坏,所有正在这个屏障上等待的其他线程会立刻被唤醒,并抛出 BrokenBarrierException;后续任何线程再调用这个屏障的 await(),也会立刻抛出同样的异常,直到调用 reset() 手动复位。这个设计的道理是:屏障的语义要求"所有人必须一起通过",一旦有参与者出了问题掉队,让剩下的人无限期挂起等一个永远不会到达的人是没有意义的,框架选择主动让所有人失败退出。
Q4:**Semaphore**的**acquire()**和**release()**为什么不要求必须是同一个线程调用?
A:因为 Semaphore 的核心抽象是"许可证数量"这个纯粹的计数,而不是"谁持有了锁"这种带身份的所有权关系(这一点和 ReentrantLock 完全不同,ReentrantLock 要求持有和释放必须是同一个线程,否则报错)。acquire() 只是把内部计数减一,release() 只是把计数加一,两者之间没有绑定任何线程标识的校验。这让 Semaphore 可以支持"线程 A 拿到许可证去处理任务,处理完之后由线程池里的另一个线程 B 负责调用 release() 归还"这种跨线程的资源管理模式,但也意味着如果代码逻辑写错、release() 调用次数多于 acquire(),允许的并发数会在没有任何异常提示的情况下悄悄"膨胀"。
Q5:**Semaphore**的公平模式和非公平模式有什么实际差异?该怎么选?
A:公平模式下,等待获取许可证的线程严格按照请求发起的顺序排队获得许可证,不会有后来的线程插队;非公平模式下,刚释放许可证的瞬间,任何线程(包括新来的、还没排队的)都可能抢先拿到,吞吐量通常更高,因为省去了严格排队检查和线程切换的部分开销,但可能导致某些排在队列前面的线程长时间抢不到许可证。和 ReentrantLock 的公平/非公平选择逻辑一致:多数追求吞吐量的场景默认用非公平模式(Semaphore 默认也是非公平),只有在业务上必须保证"先来先得"、不能有线程被长期饿死时,才需要显式传入 fair=true。
Q6:**Phaser**相比**CyclicBarrier**解决了什么局限?它的"阶段"概念具体是怎么运作的?
A:CyclicBarrier 最大的局限是参与方数量 parties 在构造时就固定死了,运行期间无法增减。Phaser 通过 register()/bulkRegister() 支持动态加入参与者,通过 arriveAndDeregister() 支持某个参与者提前退出、不再参与后续同步。它把每一轮同步抽象成一个"阶段"(phase),内部维护一个阶段号,每完成一轮同步(所有当前注册的参与者都调用了 arriveAndAwaitAdvance())阶段号就递增,效果上等价于 CyclicBarrier 的"一轮 await 全部放行",但参与者集合可以在每个阶段之间变化。
Q7:**Phaser**的分层结构(子**Phaser**)是用来解决什么问题的?
A:当参与者数量特别多时,所有线程都在同一个 Phaser 对象上竞争到达状态,会产生较高的锁争用或 CAS 竞争开销,成为性能瓶颈本身。Phaser 支持创建带父子关系的树形结构——多个子 Phaser 各自管理一部分参与者,子 Phaser 完成自己那部分的同步后再统一向父 Phaser 汇报一次。这样把一次全局同步拆成了多次局部同步 + 少量全局同步,能显著降低大规模参与者场景下的同步开销,这是 CyclicBarrier 完全不具备的能力。
Q8:实际业务代码里,该怎么在这四个工具之间做选型?
A:可以按一个简单的判断顺序来:如果目标是"限制同时访问某资源的并发数量",直接用 Semaphore,它和另外三个解决的根本不是同一类问题;如果是"一次性等待若干任务全部完成,之后不需要重复这套逻辑",用 CountDownLatch;如果需要"多个线程反复分阶段互相同步,且参与者数量固定不变",用 CyclicBarrier;只有当参与者数量会在运行期间动态变化、或者需要多阶段协调且 CyclicBarrier 用起来非常别扭时,才考虑引入复杂度更高的 Phaser。日常业务代码里 CountDownLatch 和 Semaphore 的使用频率远高于后两者,Phaser 更多出现在对同步性能和灵活性有较高要求的框架或中间件代码里。