一、为什么需要专门学一套"内存模型"
很多人第一次听到"Java 内存模型"(JMM,Java Memory Model)会下意识联想到堆、栈、方法区这些 JVM 运行时数据区——但这是两个完全不同的概念。运行时数据区讲的是"内存里有哪些区域、分别存什么",是一个物理/结构性的划分;而 JMM 讲的是一个更抽象的问题:在多线程并发读写共享变量时,一个线程对变量的修改,什么时候能保证被另一个线程看到、看到的顺序是否和代码书写顺序一致。这是一个规则性的约定,和内存物理结构无关。
这套规则之所以必须存在,根本原因是现代计算机为了性能,在多个层面都做了"偷懒"优化:CPU 有多级缓存,不会每次都直接读写主内存;编译器和处理器会在不改变单线程语义的前提下调整指令的执行顺序。这些优化在单线程环境下完全正确,但一旦引入多线程共享变量,就会暴露出两个经典问题:可见性问题和有序性问题,外加一个本身就存在的原子性问题。JMM 就是 Java 语言层面对这三个问题给出的统一解决方案和规则约定。
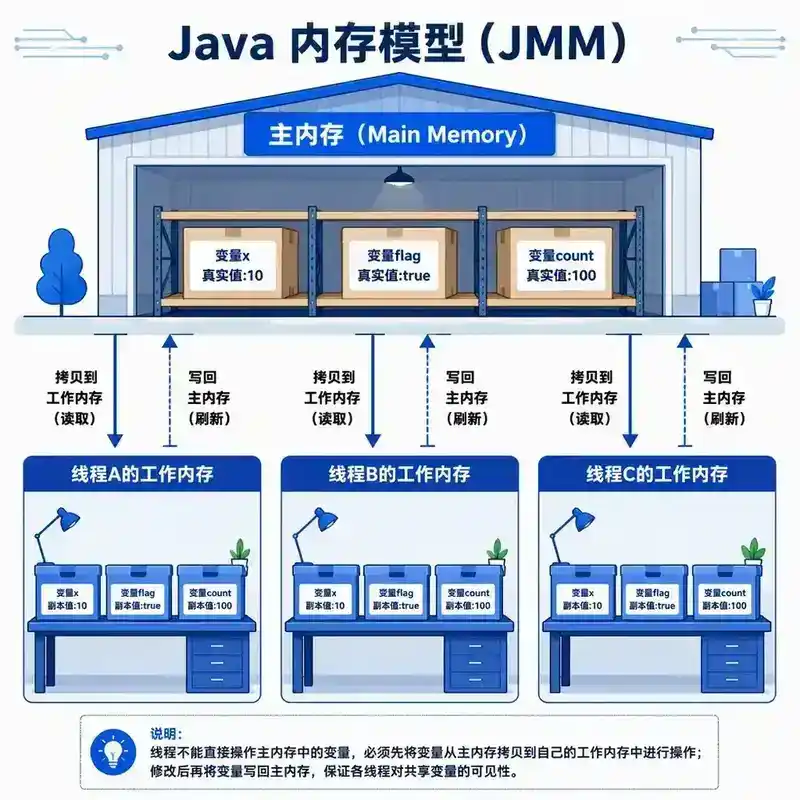
二、主内存与工作内存:一个抽象模型,不是物理硬件
JMM 定义了两个抽象概念:
- 主内存(Main Memory):存放所有共享变量的"标准答案",是所有线程共同可见的存储区域,概念上类似堆。
- 工作内存(Working Memory):每个线程私有,保存该线程用到的共享变量的副本。线程对变量的所有操作(读、写、计算)都是先在自己的工作内存里进行,然后再在某个时间点和主内存做同步,而不是每次都直接穿透到主内存。
需要强调的是,这只是 Java 内存模型层面的抽象,不直接对应某一块具体的物理硬件(比如不能简单地说"工作内存就是 CPU 缓存、主内存就是内存条")——它是为了统一描述各种硬件平台(不同的缓存架构、不同的编译器优化策略)上都成立的一套行为规范,让 Java 程序员不需要关心底层是 x86 还是 ARM,只需要理解这一套模型即可推理并发行为是否正确。
三、可见性问题:我改了,你为什么看不到
可见性问题指的是:一个线程对共享变量的修改,如果只停留在自己的工作内存里、还没有同步回主内存,其他线程读到的可能还是旧值。一个经典的代码场景:
class Flag {
    boolean running = true;
    void stop() { running = false; }
}
如果线程 A 调用 stop() 把 running 设为 false,这个修改可能只更新了线程 A 自己工作内存里的副本,没有及时刷回主内存;同时线程 B 一直在用一个 while (flag.running) { ... } 循环检查这个变量,但它读的是自己工作内存里缓存的旧副本——只要线程 B 的工作内存副本没有失效并重新从主内存加载,B 就可能永远读到 true,导致循环永远不退出,即所谓的"死循环 bug"。这类问题在生产环境里往往表现为"看起来卡死了,重启一下又好了",非常隐蔽。
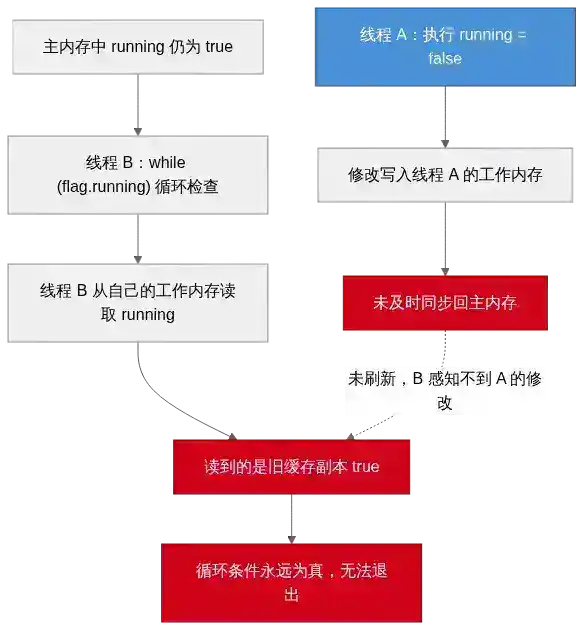
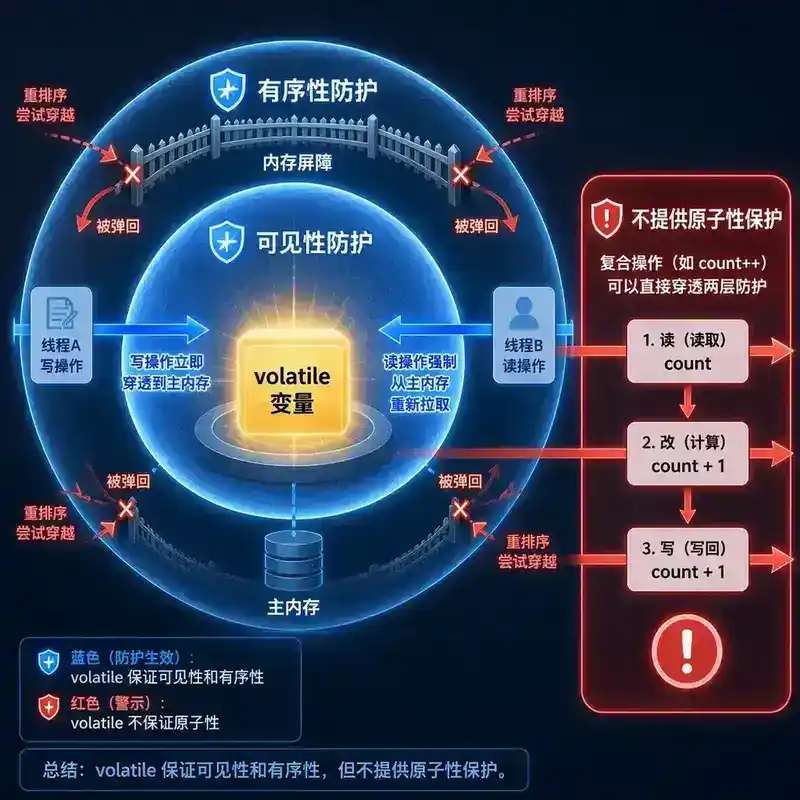
解决方案:给变量加上 volatile 关键字。volatile 保证对该变量的写操作会立即刷新到主内存,对该变量的读操作会强制从主内存重新加载(而不是使用工作内存里可能过期的副本),从而保证了可见性。除了 volatile,synchronized 和 Lock 在释放锁的时候,也会强制把工作内存的修改同步回主内存,同样能解决可见性问题——但代价是需要承担锁本身的开销。
四、有序性问题:代码写的顺序,不一定是执行的顺序
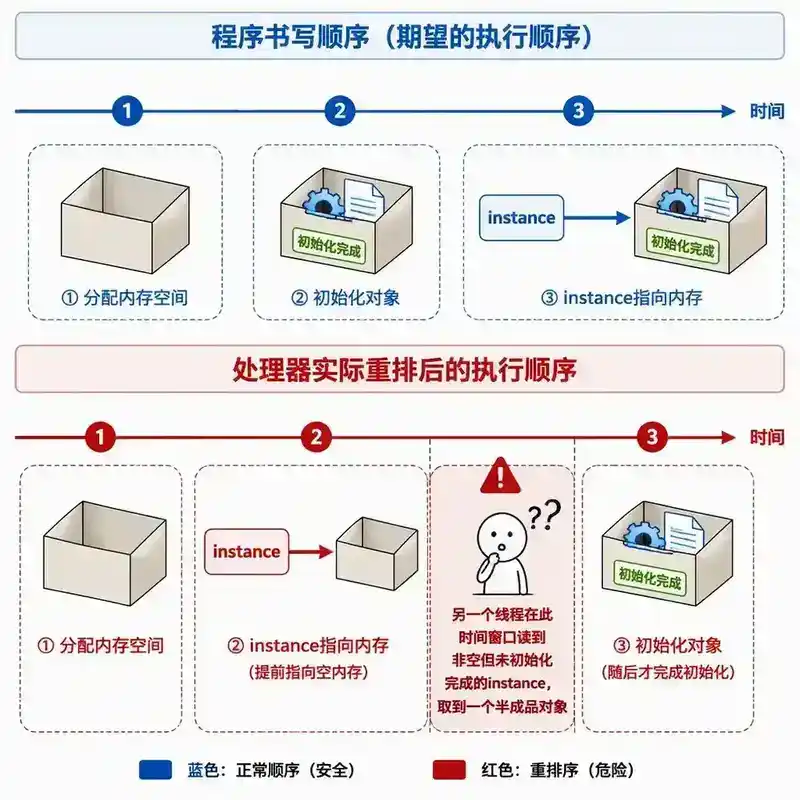
有序性问题指的是:为了提升性能,编译器和处理器会在不改变单线程程序最终结果的前提下,对指令进行重排序。这在单线程里是绝对安全的(因为无论怎么重排,单线程自己观察到的结果都不变),但在多线程场景下,一个线程看到的另一个线程的指令执行顺序,可能和代码书写的顺序不一致,从而引发诡异的 bug。
最经典的例子是双重检查锁(Double-Checked Locking)实现单例模式时踩的坑:
public class Singleton {
    private static Singleton instance;
    public static Singleton getInstance() {
        if (instance == null) {
            synchronized (Singleton.class) {
                if (instance == null) {
                    instance = new Singleton(); // 问题就在这一行
                }
            }
        }
        return instance;
    }
}
instance = new Singleton() 这一行看似是一个原子操作,实际上可以拆解成三个步骤:① 分配一块内存空间;② 在这块内存上调用构造函数初始化对象;③ 把 instance 指向这块内存地址。在没有**volatile**修饰的情况下,编译器/处理器可能对②和③重排序,先把地址赋值给 instance(此时对象还没初始化完成),再执行构造函数初始化。如果这时另一个线程恰好执行 if (instance == null) 判断,会发现 instance 已经不是 null(指向了一块未初始化完成的内存),直接返回这个"半成品"对象,使用时就会出现字段值不符合预期的诡异 bug。
解决方案:把 instance 声明为 volatile。volatile 除了保证可见性之外,还会通过插入内存屏障(Memory Barrier)禁止指令重排序,确保②一定在③之前完成,从根本上堵住这个漏洞。
五、原子性问题:一步操作,其实是好几步
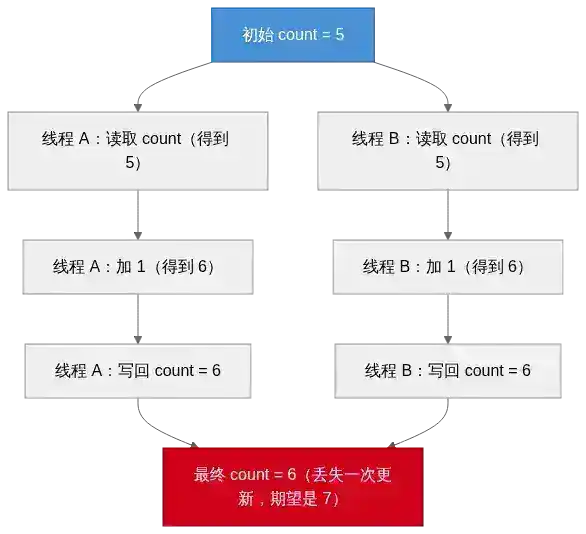
原子性指的是一个操作要么完整执行、要么完全不执行,中间不会被其他线程的操作插入干扰。Java 里最容易被误解的一个例子是自增操作:
count++;
这一行代码看起来是一步,但实际上会被编译成至少三个独立的字节码步骤:① 读取 count 当前值;② 把这个值加 1;③把结果写回 count。如果两个线程同时执行 count++,可能会发生这样的交错:线程 A 读到 count=5,还没写回,线程 B 也读到 count=5,两个线程各自加 1 后都写回 6——本该是两次自增、结果应该是 7,实际却因为"读-改-写"三步被交错执行,丢失了一次更新,最终结果错误地停留在 6。这种现象叫竞态条件(Race Condition)。
需要特别注意:Java 里对基本数据类型变量的单次读或单次写操作本身是原子的(比如 int a = 1; 这个赋值本身没问题),但复合操作(比如 count++、count += 1,本质是"读+改+写"三步组合)不是原子的。另外还有一个历史遗留细节:对于 long 和 double 这两种 64 位的类型,JMM 允许将其读写操作拆成两次 32 位操作来完成(除非用 volatile 修饰),理论上存在"读到一个值的高 32 位和另一个值的低 32 位拼接出来的诡异中间态"的可能性,这也是为什么长期以来的建议是给共享的 long/double 变量加上 volatile。
解决方案:用 synchronized、Lock 保证复合操作的互斥执行;或者对于简单的数值累加场景,使用 java.util.concurrent.atomic 包下的 AtomicInteger、AtomicLong 等类,它们基于 CPU 提供的 CAS(Compare-And-Swap)指令实现真正的原子操作,性能通常优于加锁。
六、volatile:一个关键字,两种保证
综合前面三节,可以清楚地总结 volatile 关键字提供的两项保证:
- 保证可见性:写操作立即刷回主内存,读操作强制从主内内存重新加载,不使用工作内存里的旧副本。
- 保证有序性(针对该变量相关的操作):通过插入内存屏障禁止特定类型的指令重排序,防止类似双重检查锁场景中的"提前发布未初始化完成对象"问题。
但要特别注意:**volatile**不保证原子性。volatile 修饰的变量在做 count++ 这种复合操作时,依然会出现前面讲的竞态条件问题,因为可见性和原子性是两个独立的属性,volatile 只解决前者。这是一个非常高频的面试陷阱——很多人以为加了 volatile 就"线程安全"了,但如果操作本身不是原子的,volatile 完全无法提供保护。
七、面试追问链
延伸阅读
- 《Java 并发编程的艺术》第 3 章,Java 内存模型详解
- JSR-133:Java Memory Model and Thread Specification
- 下一篇预告:happens-before 规则——程序次序、锁、volatile、线程启动与终止规则如何具体规定"谁的修改对谁可见"
问答(不计入阅读时长)
Q1:Java 内存模型(JMM)里说的"主内存"和"工作内存",是不是就是堆和线程栈?
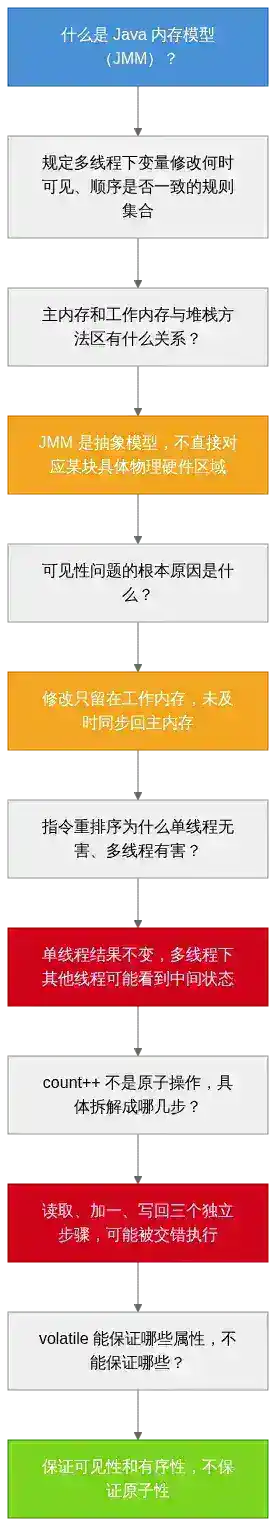
A:不是。JMM 定义的主内存和工作内存是一套抽象概念,用来描述多线程环境下变量的可见性和同步规则,不直接对应某一块具体的物理硬件区域或 JVM 运行时数据区。运行时数据区(堆、栈、方法区等)讲的是内存的物理/结构划分,而 JMM 讲的是"一个线程的修改什么时候能保证被另一个线程看到"这个规则性问题,两者是不同维度的概念,不能划等号。
Q2:一个线程把共享变量改了,为什么另一个线程读到的还是旧值?
A:因为这个修改可能只写入了修改线程自己的工作内存,还没有来得及同步回主内存;而读取的线程也是先看自己工作内存里缓存的副本,如果这个副本还没有被标记为失效、重新从主内存加载,它读到的就还是旧值。这就是可见性问题,最常见的解决方式是给共享变量加上 volatile,或者用 synchronized/Lock 保证修改在释放锁时强制刷回主内存。
Q3:为什么指令重排序在单线程程序里完全没问题,但在多线程程序里会出 bug?
A:因为编译器和处理器做重排序优化时,遵循的原则是"不改变单线程程序自身观察到的最终结果"——单线程只会按照它自己的视角顺序执行下去,感知不到中间步骤被调整过。但在多线程场景下,另一个线程可能正好在这个"重排后的中间时刻"去读取共享状态,看到的执行顺序和代码书写顺序不一致,从而观察到一个本不应该存在的中间状态(比如双重检查锁单例模式中读到一个未初始化完成的对象)。
Q4:为什么说**count++**不是原子操作,它到底做了什么?
A:count++ 看起来是一步,但底层会被拆解成"读取当前值"、"计算加一后的结果"、"把结果写回变量"三个独立步骤。如果两个线程同时对同一个 count 执行这个操作,可能会发生交错:两个线程都读到了修改前的旧值,各自加一后又都把同一个新值写回,结果两次自增只体现了一次效果,比期望的结果少了一次更新——这就是所谓的竞态条件(Race Condition)。
Q5:给变量加上**volatile**之后,是不是就可以说这个变量的操作"线程安全"了?
A:不能这样说,这是一个很常见的误区。volatile 只保证两件事:可见性(写操作立即刷回主内存、读操作强制从主内存重新加载)和有序性(禁止特定重排序)。但它不保证原子性。如果对 volatile 变量执行的是像 count++ 这样的复合操作(本质是读+改+写三步),即使加了 volatile,多线程并发执行仍然会出现竞态条件,结果依然可能是错的。要解决复合操作的原子性问题,需要用 synchronized、Lock,或者 AtomicInteger 这类基于 CAS 的原子类。
Q6:**long**和**double**这两种类型的变量,在多线程读写时有什么特殊之处?
A:long 和 double 都是 64 位类型,JMM 允许在没有 volatile 修饰的情况下,把它们的读写操作拆分成两次 32 位操作来完成。这意味着理论上存在一种边界情况:一个线程可能读到"一半是某次写入的高 32 位,一半是另一次写入的低 32 位"拼接出来的诡异中间值。这也是为什么长期以来的工程建议是,如果 long/double 变量会被多线程共享读写,最好加上 volatile 修饰,避免这种极端情况。
Q7:双重检查锁单例模式里,为什么一定要给**instance**变量加**volatile**,只加内层的**synchronized**还不够吗?
A:内层的 synchronized 只能保证同一时刻只有一个线程在执行创建对象的那段代码,防止重复创建实例,但它挡不住"对象创建过程内部"的指令重排序问题——instance = new Singleton() 可以被拆解成分配内存、初始化对象、指向内存三步,如果没有 volatile,"指向内存"这一步可能被提前到"初始化对象"之前执行。这时另一个线程在外层判断 if (instance == null) 时,可能拿到一个已经非空但内部字段还没初始化完成的"半成品"对象。只有给 instance 加上 volatile,才能同时禁止这种重排序,从根本上堵住这个漏洞。
Q8:如果一段代码只是简单地累加一个共享的计数器,应该用**synchronized**还是**AtomicInteger**?
A:对于单纯的数值累加这类场景,通常优先考虑 AtomicInteger/AtomicLong。它们底层基于 CPU 提供的 CAS(Compare-And-Swap)指令实现原子操作,不需要像 synchronized 那样让线程阻塞等待锁,在竞争不是特别激烈的场景下性能通常更好。synchronized 更适合需要保护一段包含多个操作、需要保证整体一致性的复合逻辑块,而不仅仅是一次简单的数值更新。