一、已经有 synchronized 了,为什么还需要 ReentrantLock
前一篇讲了 AQS 这套"造锁的框架",ReentrantLock 正是基于 AQS 独占模式实现的一把标准锁,可以理解成 AQS 骨架上长出来的第一个、也是最典型的血肉。它和 synchronized 解决的是同一个问题——互斥访问共享资源——但走的是"手动挡"路线:需要显式调用 lock() 加锁、unlock() 释放锁,配合 try/finally 保证锁一定会被释放。
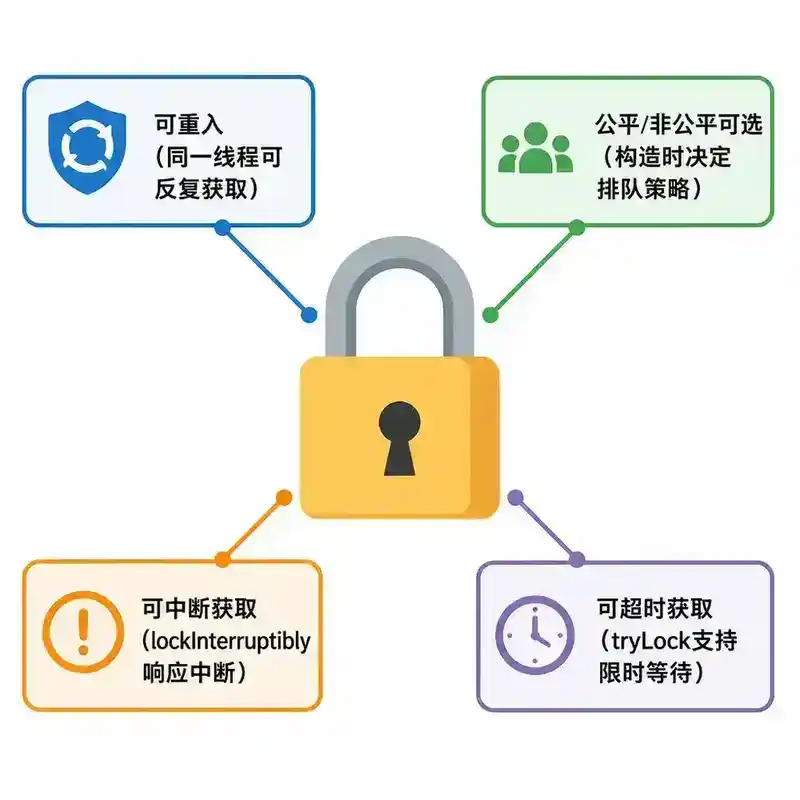
既然多了一步手动操作的麻烦,为什么还要用它?因为它在 synchronized 的基础上,额外提供了四项 JVM 内置锁给不了的能力:可重入(这个 synchronized 也有)、公平锁可选、响应中断的锁获取方式、支持超时的锁获取方式。这四项能力,加上可以配合 Condition 做精细的等待通知,构成了它存在的全部理由。
二、基本用法与可重入:state 计数器又出现了
ReentrantLock 的标准用法是:
lock.lock();
try {
    // 临界区代码
} finally {
    lock.unlock();
}
一定要把 unlock() 放进 finally,否则临界区代码抛出异常时锁永远不会被释放,其他线程会永远阻塞在获取锁这一步——这是手动加锁最容易踩的坑,也是 synchronized 由 JVM 自动管理加解锁的最大优势所在。
可重入的实现原理和上一篇讲的 AQS 的 state 直接挂钩:ReentrantLock 内部继承 AQS 的同步器,把 state 当作"当前持有线程的重入次数"来用。第一次 lock() 成功时 state 从 0 变成 1;同一个线程再次调用 lock(),tryAcquire() 里会判断"当前持有者是不是我自己",是的话直接把 state 加一,不需要重新走一遍排队竞争;对应地,unlock() 每次把 state 减一,只有减到 0 才真正释放锁、唤醒下一个排队线程。这和 synchronized 靠 Monitor 里的 Recursions 计数器实现可重入是同一个思路,只是换了一套底层机制来承载。
三、公平锁与非公平锁:排队还是插队
ReentrantLock 的构造方法可以传入一个布尔参数决定用公平锁还是非公平锁:new ReentrantLock(true) 是公平锁,默认(无参或传 false)是非公平锁。
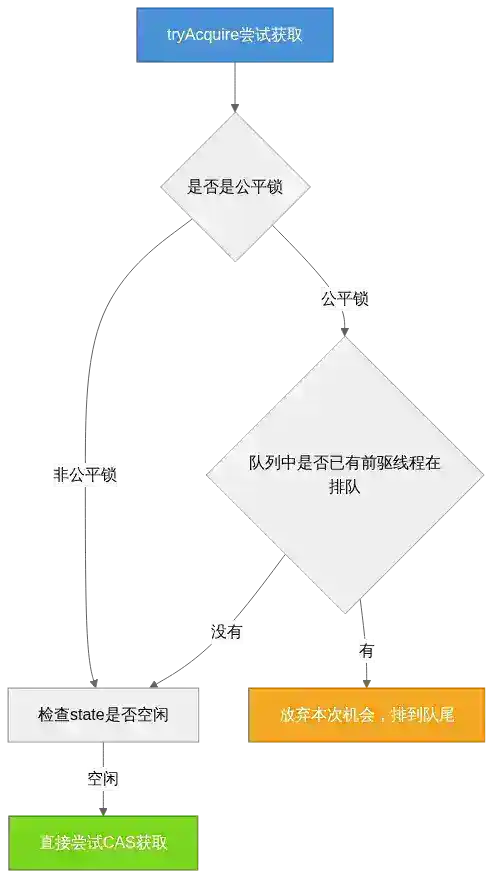
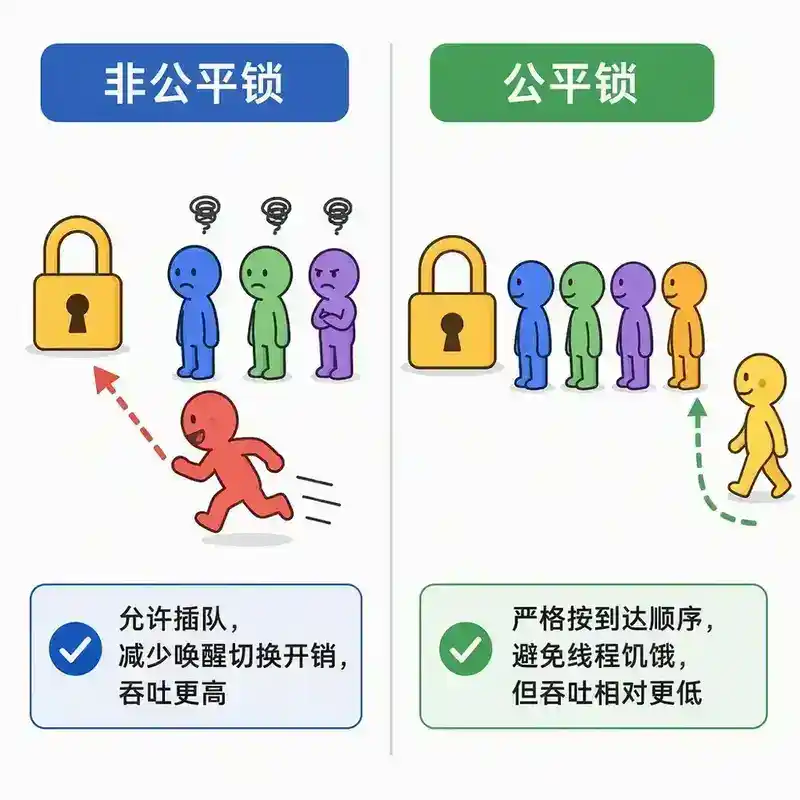
公平锁严格按照请求锁的先后顺序分配——谁先排队,谁先拿到锁,绝对不允许后来的线程插队。具体实现上,公平锁的 tryAcquire() 在尝试获取前会多一步判断:查询 AQS 等待队列里是否已经有别的线程在自己前面排队(hasQueuedPredecessors()),如果有,即使当前锁是空闲的,也主动放弃这次获取机会,乖乖去排到队尾。
非公平锁则不做这个判断:只要发现锁当前是空闲的,不管队列里有没有别的线程在等,新来的线程都可以直接尝试抢一把。这意味着一个刚被唤醒、还没来得及重新竞争的排队线程,完全可能被一个"插队"进来的新线程抢先拿到锁。
听起来公平锁更"讲道理",但实际中非公平锁是默认选项,而且在绝大多数场景下吞吐量更高。原因在于:非公平锁允许新线程"插队"直接拿锁,减少了"唤醒一个休眠线程、等它重新调度、再让它去竞争"这一整套开销——很多时候新来的线程恰好是正在运行中的线程,直接抢到锁比唤醒一个休眠很久的线程再切换过去快得多。公平锁的代价是:为了绝对公平,可能会频繁触发线程的挂起和唤醒,整体吞吐反而更低,只有在"必须严格避免某些线程长期抢不到锁(饥饿)"的场景下,才值得选择公平锁去换取这份公平性。
四、可中断锁获取:等待的时候也能被叫停
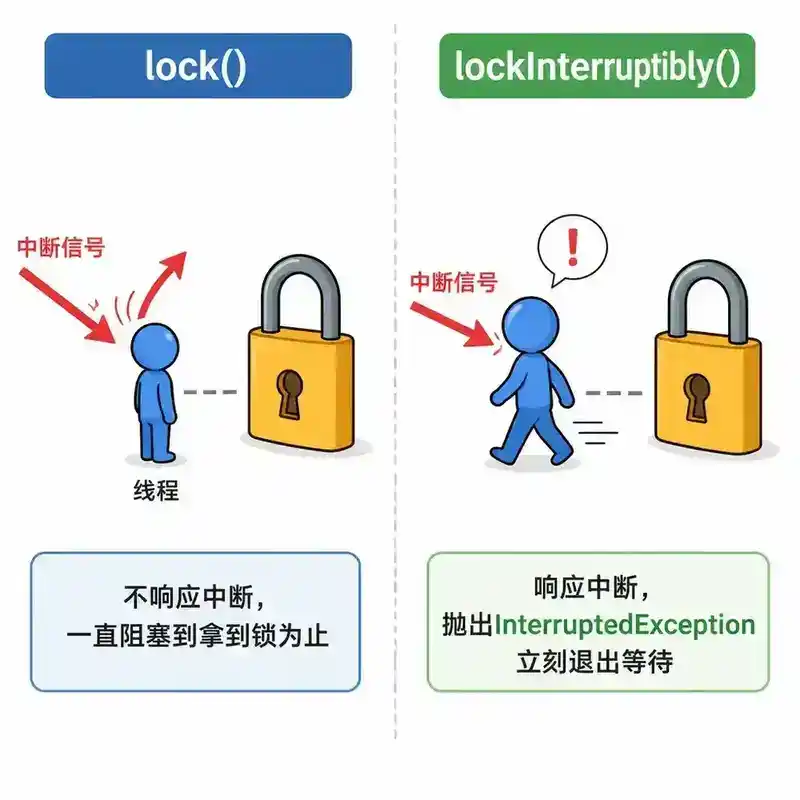
普通的 lock() 一旦调用,线程会一直阻塞直到真正拿到锁为止,中途不会响应中断——哪怕外部调用了这个线程的 interrupt(),它也会继续傻等下去,只是中断标志位会被记下来,等真正拿到锁之后才能感知到。
如果希望一个线程在等待锁的过程中,一旦被中断就能立刻放弃等待、及时退出,就需要用 lockInterruptibly()。它的行为是:正常情况下和 lock() 一样阻塞等待锁;但如果在等待期间线程被中断,会立刻抛出 InterruptedException,方法直接返回,不会真正拿到锁。这对于那些"等太久就该放弃、不该傻等"的场景(比如响应用户取消操作、超时熔断链路中的资源获取)非常有用。
需要注意:lockInterruptibly() 必须配合 try/catch 处理 InterruptedException,并且因为抛异常时线程还没拿到锁,不需要也不应该在对应的 catch 分支里调用 unlock()。
五、超时获取锁:不想无限等,也不想立刻放弃
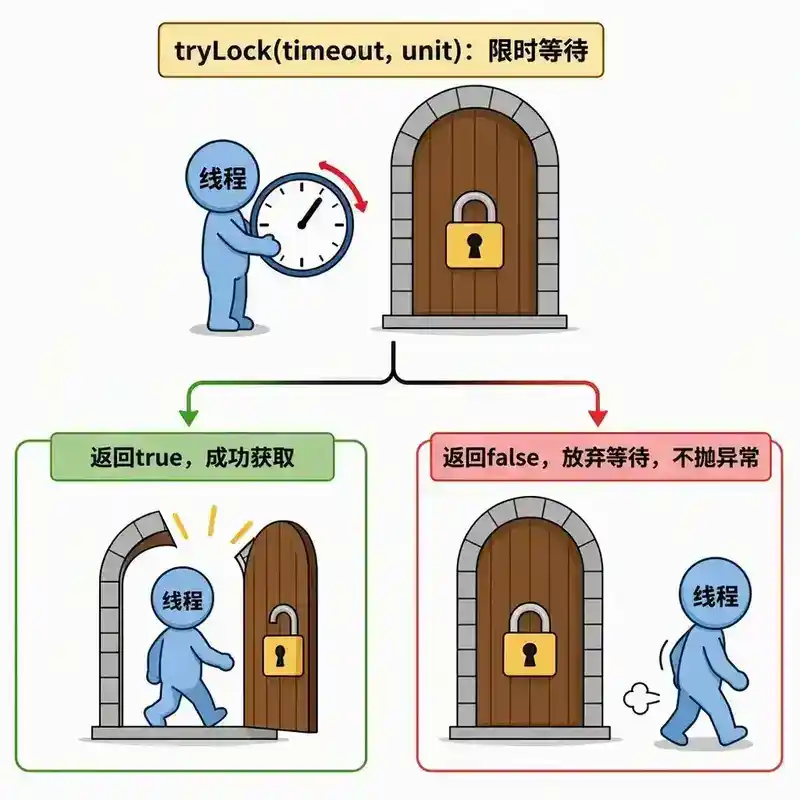
有时候既不想像 lock() 一样无限期等待,也不想像后面要提到的无参 tryLock() 一样连一次重试机会都不给,这时候可以用 tryLock(long timeout, TimeUnit unit)——在指定的时间窗口内尝试获取锁,拿到了返回 true,超过时限还没拿到就返回 false,不会抛异常也不会继续阻塞。
配合无参版本一起看会更清楚 tryLock 家族的层次:
tryLock():立即尝试一次,能拿到就返回 true,拿不到立刻返回 false,完全不阻塞。tryLock(timeout, unit):在给定时间窗口内阻塞等待,超时前拿到就返回 true,超时了返回 false。lock():无限期阻塞,直到拿到锁为止。lockInterruptibly():无限期阻塞,但响应中断。
这四种方式覆盖了"完全不等"、"等一会儿"、"一直等"、"一直等但可以被叫停"四种典型诉求,这正是 ReentrantLock 相比 synchronized 更灵活的地方——synchronized 只有"一直等"这一种模式,没有给开发者留下任何折中选择的空间。
六、配合 Condition:ReentrantLock 的另一个杀手级能力
上一篇讲 AQS 时提到,Condition 允许一把锁拆分出多个独立的等待队列。ReentrantLock 通过 newCondition() 就能创建这些 Condition 对象,这是 synchronized 完全没有对应能力的地方——synchronized 的 wait/notify 只有一个笼统的等待集合,没法区分"等待队列不满"和"等待队列不空"这两种完全不同的等待条件。经典的有界缓冲区(生产者/消费者模型)用 ReentrantLock 配合两个 Condition 分别管理,可以做到"生产者只唤醒等待队列不满的消费者,不会误唤醒等待队列不空的生产者",减少无意义的唤醒和重新阻塞。
七、面试追问链
从"为什么已经有 synchronized 还需要 ReentrantLock"出发,逐层追问:可重入具体靠什么字段实现、公平锁和非公平锁在获取逻辑上具体差在哪一步判断、为什么非公平锁是默认选项而不是更"讲道理"的公平锁、lock() 和 lockInterruptibly() 在响应中断上有什么本质区别、tryLock 的几种重载分别对应什么等待策略、以及 ReentrantLock 配合 Condition 相比 synchronized 的 wait/notify 强在哪里,这条链基本能覆盖面试官对 ReentrantLock 的核心考察点。

延伸阅读
java.util.concurrent.locks.ReentrantLock源码,重点看内部类FairSync和NonfairSync的tryAcquire()实现差异AbstractQueuedSynchronizer.hasQueuedPredecessors()的实现,理解公平锁判断排队顺序的具体逻辑- 下一篇预告:ReentrantReadWriteLock 与 StampedLock——读多写少场景和乐观读
问答(不计入阅读时长)
Q1:ReentrantLock 的可重入和 synchronized 的可重入,底层机制是一回事吗?
A:思路一样,载体不同。synchronized 靠 Monitor 里的 Recursions 计数器判断"当前持有者是不是我自己"来实现可重入;ReentrantLock 走的是 AQS 框架,把同一个 state 字段当作重入计数器用——第一次获取 state 从0变1,同一线程再次获取时 tryAcquire 判断出持有者是自己,直接把 state 加一,不用重新排队竞争。两者本质都是"给持锁线程留一个身份标记+一个计数器",只是分别挂在 Monitor 结构和 AQS 的 state 上。
Q2:如果忘记把 unlock() 放进 finally,具体会出什么问题?
A:如果临界区代码正常执行完毕没有抛异常,忘记 finally 通常不会立刻暴露问题,因为 unlock() 还是会在正常流程里被执行到。但一旦临界区代码抛出了未捕获的异常,程序会直接跳出方法,unlock() 根本不会被执行,这把锁就永远处于"被占用"状态,其他所有试图获取这把锁的线程都会永久阻塞下去,表现为线上服务突然大面积卡死、看起来像死锁但其实只是一把没释放的锁。这也是为什么"lock() 后立刻紧跟 try,unlock() 放进 finally"几乎是使用 ReentrantLock 时唯一正确的写法,没有例外。
Q3:非公平锁看起来对某些线程"不公平",实际生产中会不会真的有线程一直抢不到锁?
A:理论上存在这种风险,但在实际生产场景中极少真正发生严重饥饿。非公平锁的插队只是在锁刚好空闲的一瞬间给新来的线程一次机会,不代表排队的线程会被无限期地持续插队压制——只要新线程不是持续高频地精确卡在锁释放的那个时间点抢入,排队线程迟早会轮到。真正需要担心饥饿、必须换成公平锁的场景,通常是那种竞争极其激烈、持锁时间很短、请求频率极高的特殊场景,绝大多数业务代码不需要为了防饥饿而牺牲非公平锁带来的吞吐优势。
Q4:lockInterruptibly() 捕获到 InterruptedException 之后,还需要不需要调用 unlock()?
A:不需要,而且不应该调用。因为抛出 InterruptedException 就意味着这次调用没有真正拿到锁——线程是在等待过程中被中断退出的,根本不存在"持有了锁又要释放"的问题。如果在 catch 块里误调用 unlock(),反而会抛出 IllegalMonitorStateException(因为当前线程并不是这把锁的持有者),这是一个常见的误用陷阱,写 lockInterruptibly() 相关代码时要格外注意 catch 块里只处理中断响应逻辑,不要顺手加 unlock()。
Q5:tryLock() 无参版本和 tryLock(0, unit) 是一回事吗?
A:效果上非常接近,都是"立即尝试一次,拿不到就马上返回 false,不阻塞等待",但严格来说 tryLock(0, unit) 本质上走的还是限时等待的那套逻辑,只是把等待时间设成了 0,理论上仍然可能进入一次极短暂的排队检查流程;而无参 tryLock() 是直接调用非公平的抢锁路径,不会考虑任何排队逻辑,哪怕当前用的是公平锁实例,无参 tryLock() 依然会"不讲公平地插队尝试一次"。这是一个容易被忽略的细节:无参 tryLock() 在语义上天生就是非公平的,即使锁本身配置为公平锁。
Q6:既然 ReentrantLock 功能更强,是不是应该在所有场景下都优先选择它而不是 synchronized?
A:不是。功能更多不等于默认更优——如果一段代码只是最普通的互斥场景,不需要可中断、不需要超时、不需要公平锁、不需要多个 Condition,synchronized 的语法更简单,而且由 JVM 自动管理加解锁,不存在忘记 unlock() 的风险,出错空间更小。只有当业务确实需要 ReentrantLock 提供的某项额外能力时,才值得为它付出"必须手动管理加解锁"的复杂度代价。选型的判断标准是功能需求,不是"哪个更高级就用哪个"。
Q7:公平锁判断"队列中是否已有前驱线程在排队",这个判断本身会不会也有性能开销?
A:会有,但开销很小。hasQueuedPredecessors() 本质上只是检查 AQS 内部维护的 head、tail 指针以及队列头部节点的状态,是几次简单的字段读取和比较,不涉及遍历整个队列,时间复杂度是常数级的。相比公平锁为了保证严格顺序而额外增加的线程挂起唤醒次数,这个判断本身带来的开销微不足道——公平锁真正的性能代价主要来自于"更频繁地把线程真正挂起和唤醒",而不是这个前置判断逻辑。
Q8:ReentrantLock 配合多个 Condition,和用多把不同的 ReentrantLock 分别管理不同的等待场景,有什么本质区别?
A:本质区别在于"保护的是不是同一份共享状态"。同一把锁下的多个 Condition,共享的是这把锁保护的同一份数据(比如同一个缓冲区),只是把"等待的理由"拆开了,等待和唤醒之间可以安全地共享和检查同一份状态,不需要额外的跨锁同步。而如果换成多把独立的锁,每把锁保护的是各自独立的数据,线程在等待某个条件时无法安全地检查另一把锁保护的状态,除非再引入额外的同步机制协调这几把锁之间的关系——这样反而更复杂,也更容易引入锁顺序不一致导致的死锁风险。所以"一把锁+多个 Condition"是专门为"同一份共享状态、多种等待条件"这类场景设计的。