一、为什么普通线程池不够用,得单独讲 ForkJoinPool
前一篇讲到 CompletableFuture 的 xxxAsync 方法如果不显式传入线程池,会默默用上 ForkJoinPool.commonPool()。这句话里藏着一个容易被忽略的事实:ForkJoinPool 根本不是普通的 ThreadPoolExecutor,它是 Java 7 引入的、专门为"分治式并行计算"设计的另一套调度框架,Stream.parallel()、CompletableFuture 的默认异步方法背后用的都是它。
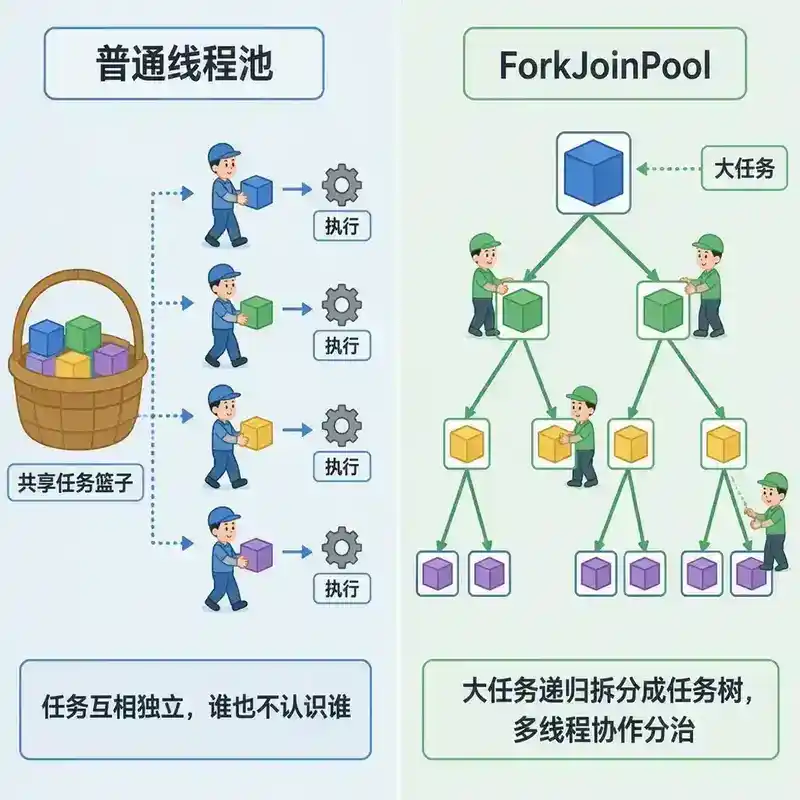
普通线程池(比如 ThreadPoolExecutor)解决的问题是"我有一堆互相独立的任务,扔给线程池并发执行"。它的调度模型很简单:一个共享队列,多个线程排队去队列里取任务。但 ForkJoinPool 要解决的是另一类问题:一个大任务本身可以递归拆成很多小任务,小任务之间还可能继续往下拆,拆到足够小之后再一层层把结果合并回去——比如"对一千万个数字排序"可以拆成"对左边五百万个排序"和"对右边五百万个排序",再合并,这种问题如果硬套普通线程池的"提交独立任务"模型,会很别扭:谁来负责拆分?子任务算完了怎么通知父任务?父任务要不要等着?
这篇要讲清楚的,就是 ForkJoinPool 为了解决这类问题引入的两个核心概念——分治任务拆分(fork/join)和工作窃取(work-stealing)算法——以及它默认共享池(commonPool)背后真正的风险来源和配置方式。
二、核心设计理念:分治(fork/join)+ 工作窃取(work-stealing)
ForkJoinPool 里跑的任务,通常是 RecursiveTask<V>(有返回值)或者 RecursiveAction(无返回值)的子类,核心逻辑都写在重写的 compute() 方法里,典型结构是:
if (任务规模 <= 阈值) {
    直接计算并返回结果;
} else {
    把任务拆成两个(或多个)子任务;
    fork() 异步提交子任务;
    递归调用自己的 compute() 或者 join() 等待子任务完成;
    合并子任务结果并返回;
}
这就是"分治"(divide and conquer)在代码里的直接体现:大任务不停**fork**出小任务,小任务算完之后再**join**合并回去,整个计算过程天然形成一棵任务树。
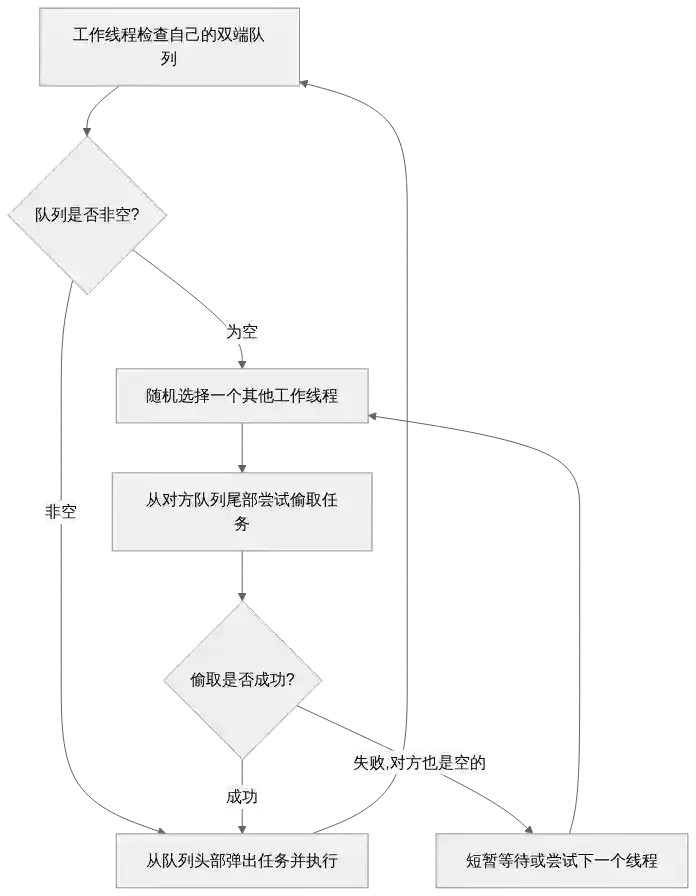
但光有分治逻辑还不够——如果简单粗暴地用一个共享队列去调度这棵任务树上产生的海量子任务,线程之间会因为频繁竞争这同一个队列的锁而互相拖累,任务拆得越细,这种竞争开销占比就越高。ForkJoinPool 解决这个问题的办法是工作窃取算法:每个工作线程维护自己的一个双端队列(deque),线程处理自己 fork 出的任务时,从队列头部取(后进先出,符合分治任务"最近拆出来的子任务往往关联性最强,优先处理有利于减少内存占用"这个特点);但如果某个线程自己的队列空了,它就会去随机挑一个别的线程的队列,从队列尾部"偷"一个任务过来执行(先进先出,尽量偷"最老"的任务,减少和该线程自己正在处理的任务发生冲突的概率)。
这个设计的效果是:只要整个任务树里还有没被处理的子任务,所有工作线程基本都能一直保持繁忙,而不会出现"一个线程干完活闲着,另一个线程队列里堆满了任务"的失衡状态——这正是 ForkJoinPool 相比"共享队列"模型在这类递归分治场景下吞吐量明显更高的根本原因。
三、工作窃取算法:谁的队列空了就去"偷"别人的
上一节提到的"偷"任务这件事,值得再拆开讲讲细节,因为这正是 ForkJoinPool 名字里"work-stealing"的字面含义:
- 每个工作线程内部都有自己的一个双端队列,只存放自己通过
fork()拆分出来的子任务。 - 线程正常工作的时候,从自己队列的头部弹出任务处理——因为最新
fork出来的子任务往往是当前正在深入处理的分支,从头部拿能保持局部性,减少任务树在内存里同时存活的宽度。 - 一旦自己的队列空了(说明手头这条分支已经处理完),线程不会闲着等待,而是随机选一个其他线程,从对方队列的尾部"偷"一个任务——尾部通常放着更早、更"顶层"的任务,偷这类任务通常意味着能拿到一个相对独立、不会和原线程正在处理的任务产生数据冲突的分支。
这套机制带来的直接好处是负载自动均衡:不需要任何中心调度者去主动决定"哪个线程该去帮哪个线程",纯粹靠"queue 空了就去偷"这个简单规则,就能让计算资源在整棵任务树的生命周期里都被充分利用。代价是实现上需要无锁或者低锁开销的双端队列数据结构(ForkJoinPool 内部用的是一种专门优化过的 work-stealing deque),并且偷任务的过程本身需要处理并发访问同一个队列两端的正确性问题——不过这些都是框架内部已经解决好的问题,使用者不需要关心。
四、拆分阈值:切太细和切太粗都会拖慢速度
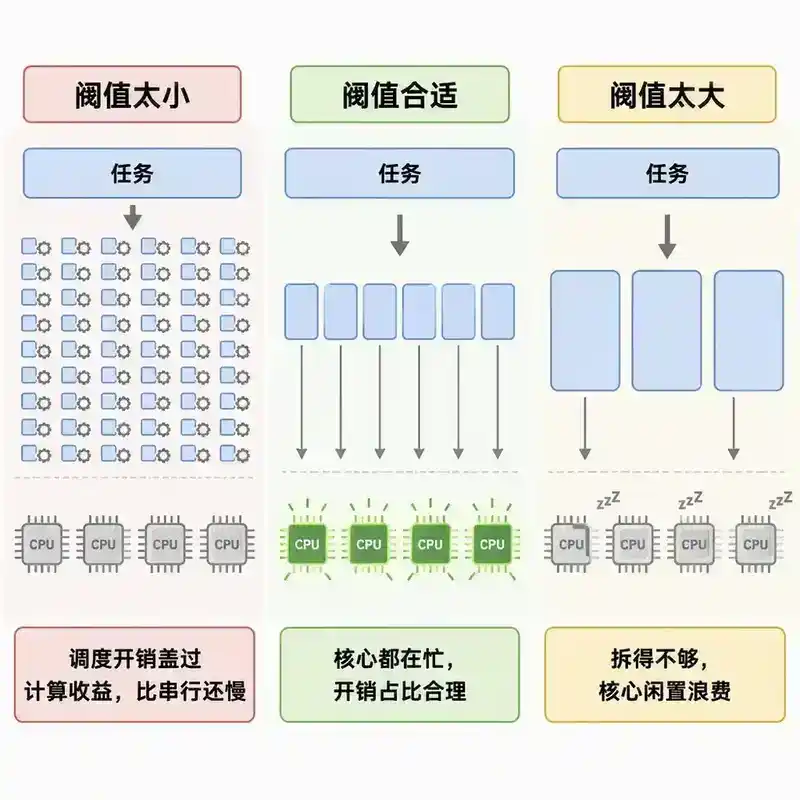
compute() 方法里那个"任务规模 <= 阈值就直接算,否则继续拆"的判断,阈值定多大是一个需要认真权衡的参数,而不是随便写个数字就行:
- 拆得太细:如果阈值设得很小,一个原本可以几毫秒算完的小任务也要经过一次
fork/join的调度开销(创建任务对象、放入队列、可能触发一次窃取、合并结果),当任务规模小到调度开销和实际计算耗时接近甚至超过时,fork/join带来的开销就会盖过并行带来的收益,整体反而比串行直接算还慢。 - 拆得太粗:如果阈值设得太大,任务树很快就不再往下拆分,最终产生的子任务数量可能还不到 CPU 核心数,会有核心一直闲置,完全没有利用上多核并行的能力。
实践中常见的经验法则是:让最终产生的子任务数量大致落在"CPU 核心数的几倍"这个量级(比如核心数的 4-8 倍),既保证每个核心都有活干、也保证任务切换和偷取的开销不会占主导。具体阈值往往需要结合数据规模、单次计算的实际耗时,通过压测去校准——这和上上篇讲线程池参数估算时提到的"没有放之四海而皆准的公式,理论值只是压测的起点"是同一个道理。
五、invoke、join 与普通 Future.get() 的关键区别
ForkJoinPool 提交任务的方式和普通线程池类似,也有 execute(纯异步,不关心结果)、submit(返回一个 Future)、invoke(同步等待并直接拿到结果)几种,但真正值得注意的是 join() 这个方法在 ForkJoinPool 内部执行环境下的特殊行为。
如果调用 join() 的线程本身就是一个 ForkJoinWorkerThread(也就是在另一个 fork/join 任务内部调用 join() 等待子任务),ForkJoinPool 不会让这个线程傻等——它会尝试让这个线程去处理任务队列里其他还没被执行的任务(可能是自己的、也可能是偷来的),一边"顺手打工"一边等待目标子任务完成,这种机制被称为"任务帮助"(work helping)。这和普通 Future.get() 那种纯粹阻塞、线程什么都不做直接被挂起等待的行为是本质不同的——ForkJoinPool 尽可能不让任何一个工作线程在等待期间彻底闲置。
但如果调用 join() 的线程不是ForkJoinWorkerThread(比如你在 main 线程里直接调用某个 ForkJoinTask 的 join()),就没有这套"顺手打工"的优化了,行为退化成普通的阻塞等待。这也是为什么通常建议通过 ForkJoinPool.invoke() 或者在池子内部提交顶层任务,而不是在池子外部的线程上直接调用任务对象的 join()。
六、commonPool 风险回顾:默认共享池到底危险在哪
上一篇提到过,CompletableFuture 的 xxxAsync 方法如果不传 Executor,会用到 ForkJoinPool.commonPool()。这里可以把风险讲得更完整:
- 并行度有限且全局共享:
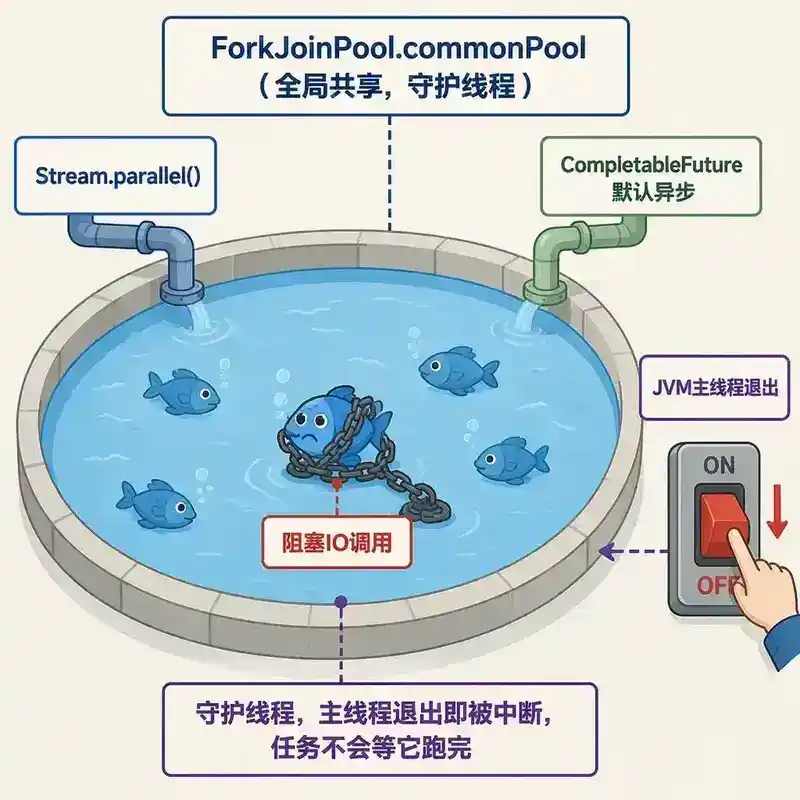
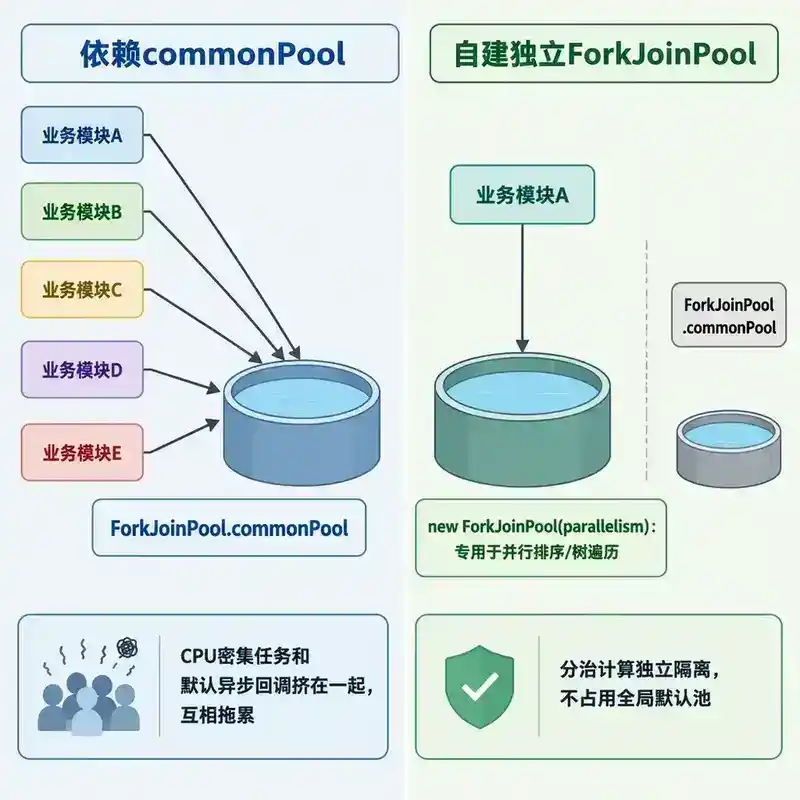
commonPool的默认并行度是Runtime.availableProcessors() - 1,这是整个 JVM 进程里唯一的一个默认池,Stream.parallel()、CompletableFuture的默认异步方法、任何直接用ForkJoinPool.commonPool()的代码,全部挤在这几个线程上竞争。 - 最怕的是阻塞式 I/O:
ForkJoinPool的工作窃取模型是为纯 CPU 密集型、快速返回的计算任务设计的,它的线程数量通常不多(核心数级别)。如果有人在commonPool上跑了一段同步阻塞的网络调用或者数据库查询,这个线程会被长时间占用而无法参与"窃取"其他任务,等效于变相减少了整个进程可用的并行度——而且这种占用是跨模块的,出问题的代码和被拖慢的代码可能毫无业务关联,只是刚好都依赖了默认的commonPool。 - 是 daemon 线程:
commonPool里的工作线程默认是守护线程(daemon thread),这意味着如果 JVM 主线程退出、且没有其他非 daemon 线程存活,进程会直接退出,commonPool里正在跑的任务会被直接中断而不会等它跑完——这和自己创建的普通线程池默认非 daemon 线程的行为是相反的,如果没意识到这一点,可能会遇到"任务突然消失、没有任何异常也没有日志"的诡异现象。 - 如何调整:可以通过 JVM 启动参数
-Djava.util.concurrent.ForkJoinPool.common.parallelism=N调整commonPool的默认并行度,但生产环境更推荐的做法不是去调这个全局参数,而是为真正需要用到**ForkJoinPool**分治能力的 CPU 密集型任务,创建独立的**new ForkJoinPool(parallelism)**实例,和commonPool彻底隔离,避免互相拖累。
七、什么时候该自己创建 ForkJoinPool,而不是依赖 commonPool
自己创建一个 ForkJoinPool 实例(new ForkJoinPool(parallelism))并不复杂,关键是判断清楚什么样的任务真正适合这套模型:
- 适合:任务本身可以自然递归拆分成规模更小的同类子问题,子问题之间基本没有共享状态、可以独立计算,最后再合并结果——典型的比如大数组的并行排序、大规模数值计算、树/图结构的并行遍历。
- 不适合:任务之间没有"递归拆分再合并"的关系,只是一堆互相独立、各干各的活的普通任务(比如处理一批 HTTP 请求)——这种场景用普通
ThreadPoolExecutor更合适,ForkJoinPool的工作窃取机制在这里发挥不出优势,甚至因为它的设计假设(短任务、快速返回、避免阻塞)反而更容易踩坑。
一句话总结这两者的本质区别:ThreadPoolExecutor 面对的是"一堆互相独立的任务,找线程执行",ForkJoinPool 面对的是"一个可以递归拆分的大任务,通过工作窃取让所有线程都有活干、协作着把整棵任务树跑完"——选错模型,代码能跑,但性能和资源利用效率会差一大截。
八、面试追问链
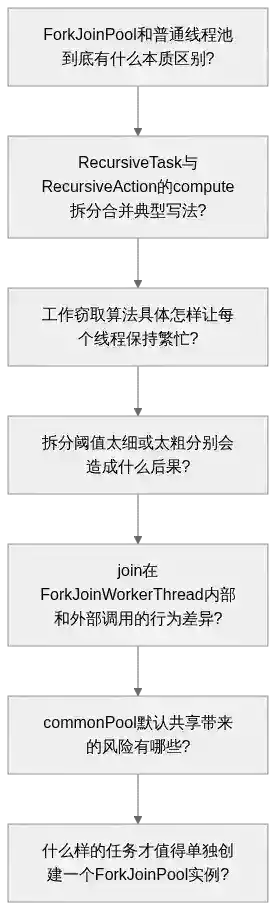
从"ForkJoinPool 和普通线程池到底有什么本质区别"这个核心问题出发,逐层追问:RecursiveTask 和 RecursiveAction 的 compute() 方法里"拆分-合并"的典型写法是什么、工作窃取算法具体是怎么让每个线程都保持繁忙的(队列头部处理自己的任务、队列尾部被别人偷)、拆分阈值定太细或太粗分别会造成什么后果、join() 在 ForkJoinWorkerThread 内部和外部调用的行为差异(任务帮助机制)、commonPool 默认共享带来的风险(阻塞 I/O 占用、daemon 线程、跨模块拖累)、以及什么样的任务真正值得单独创建一个 ForkJoinPool 实例,这条链基本能覆盖面试官对分治并行框架这个话题的核心考察点。
延伸阅读
ForkJoinPool内部WorkQueue的具体实现(java.util.concurrent.ForkJoinPool源码中的内部类),了解 work-stealing deque 是如何用 CAS 而非传统锁来实现无阻塞的双端访问的Stream.parallel()底层如何把数据源拆分成Spliterator并交给ForkJoinPool处理,以及为什么它默认也用commonPool- 下一篇预告:CompletionService 与 Executors 工具方法:批量异步任务的结果收集与常见线程池创建方式的取舍
问答(不计入阅读时长)
Q1:**ForkJoinPool**和普通**ThreadPoolExecutor**最本质的区别是什么?
A:普通线程池解决的是"一堆互相独立的任务,扔给线程池并发执行",调度模型是一个共享队列,多个线程排队取任务。ForkJoinPool 解决的是另一类问题:一个大任务可以递归拆分成很多互相关联的小任务,小任务算完后还要一层层合并结果——它面对的是一棵任务树,靠工作窃取算法让多个线程协作着把整棵树跑完,而不是简单地"谁闲了就去队列里拿一个独立任务"。
Q2:**RecursiveTask**的**compute()**方法典型写法是什么?
A:核心逻辑是"能不能直接算"的判断:如果任务规模小于等于某个阈值,直接计算并返回结果;否则把任务拆成两个(或多个)子任务,调用 fork() 异步提交子任务,再递归调用自己的 compute() 或者 join() 等待子任务完成,最后合并子任务的结果并返回。这个"规模够小就直接算,否则拆分再合并"的结构就是分治算法在代码里的直接体现。
Q3:工作窃取算法具体是怎么让线程都保持繁忙的?
A:每个工作线程维护自己的一个双端队列,只存放自己 fork 出来的子任务。线程正常工作时从队列头部弹出任务处理,因为最新拆出来的子任务局部性更好。一旦自己的队列空了,线程不会闲着,而是随机挑一个其他线程,从对方队列的尾部"偷"一个任务过来执行——偷尾部通常是相对独立、和原线程正在处理的任务冲突概率低的分支。这套"queue 空了就去偷"的简单规则不需要中心调度者,就能让计算资源在整棵任务树的生命周期里都被充分利用。
Q4:为什么工作线程从自己队列头部取任务,却从别人队列尾部偷任务,而不是两边都用同一个方向?
A:这是两个不同目标的权衡。从自己队列头部取(后进先出)是为了保持局部性——最近 fork 出来的子任务往往和当前正在处理的分支关联性最强,先处理它有利于减少任务树在内存里同时存活的宽度。从别人队列尾部偷(先进先出)则是为了尽量拿到"最老"、最独立的任务,减少和对方线程正在处理的任务发生数据冲突或者重复劳动的概率。两个方向配合起来,既保证了单线程内的处理效率,又保证了跨线程窃取时的低冲突。
Q5:拆分阈值该怎么定?设太小或太大分别有什么后果?
A:阈值太小,任务会拆得非常细,每个小任务的 fork/join 调度开销(创建任务对象、放入队列、可能触发一次窃取、合并结果)会盖过实际计算耗时,整体反而比串行直接算还慢。阈值太大,任务树拆分太粗,产生的子任务数量可能还不到 CPU 核心数,会有核心一直闲置,浪费多核并行能力。实践中常见经验法则是让最终子任务数量落在"CPU 核心数的几倍"这个量级,具体数值需要结合数据规模和单次计算耗时压测校准。
Q6:**join()**在**ForkJoinPool**内部调用和在外部线程调用有什么区别?
A:如果调用 join() 的线程本身就是 ForkJoinWorkerThread(也就是在另一个 fork/join 任务内部等待子任务),ForkJoinPool 会让这个线程"顺手打工"——尝试去处理任务队列里其他还没执行的任务,一边帮忙一边等待目标子任务完成,这被称为"任务帮助"(work helping)。但如果调用 join() 的线程不是 ForkJoinWorkerThread(比如在 main 线程里直接调用),就没有这套优化,行为退化成普通的纯阻塞等待,和 Future.get() 没有本质区别。
Q7:**ForkJoinPool.commonPool()**默认共享会带来哪些风险?
A:主要三点。第一,并行度有限且全局共享——默认并行度是 CPU 核数减一,Stream.parallel()、CompletableFuture 默认异步方法等全部挤在这几个线程上;第二,最怕阻塞式 I/O——如果有人在 commonPool 上跑了同步阻塞的网络调用或数据库查询,会占用本就不多的线程,变相拖慢整个进程里其他毫无业务关联、但恰好也依赖 commonPool 的模块;第三,commonPool 的工作线程是守护线程(daemon thread),JVM 主线程退出时正在跑的任务会被直接中断,不会等它跑完。
Q8:什么样的任务才真正值得单独创建一个**ForkJoinPool**实例,而不是依赖**commonPool**或者普通线程池?
A:关键是判断任务本身是不是"可以自然递归拆分成规模更小的同类子问题,子问题之间基本没有共享状态、能独立计算,最后再合并结果"——典型的比如大数组的并行排序、大规模数值计算、树或图结构的并行遍历。如果任务之间没有这种递归拆分再合并的关系,只是一堆互相独立、各干各的活的普通任务(比如处理一批 HTTP 请求),用普通 ThreadPoolExecutor 更合适;ForkJoinPool 的设计假设是短任务、快速返回、避免阻塞,硬套到不合适的场景反而容易踩坑。