一、execute 方法:一次任务提交要经过哪几层判断
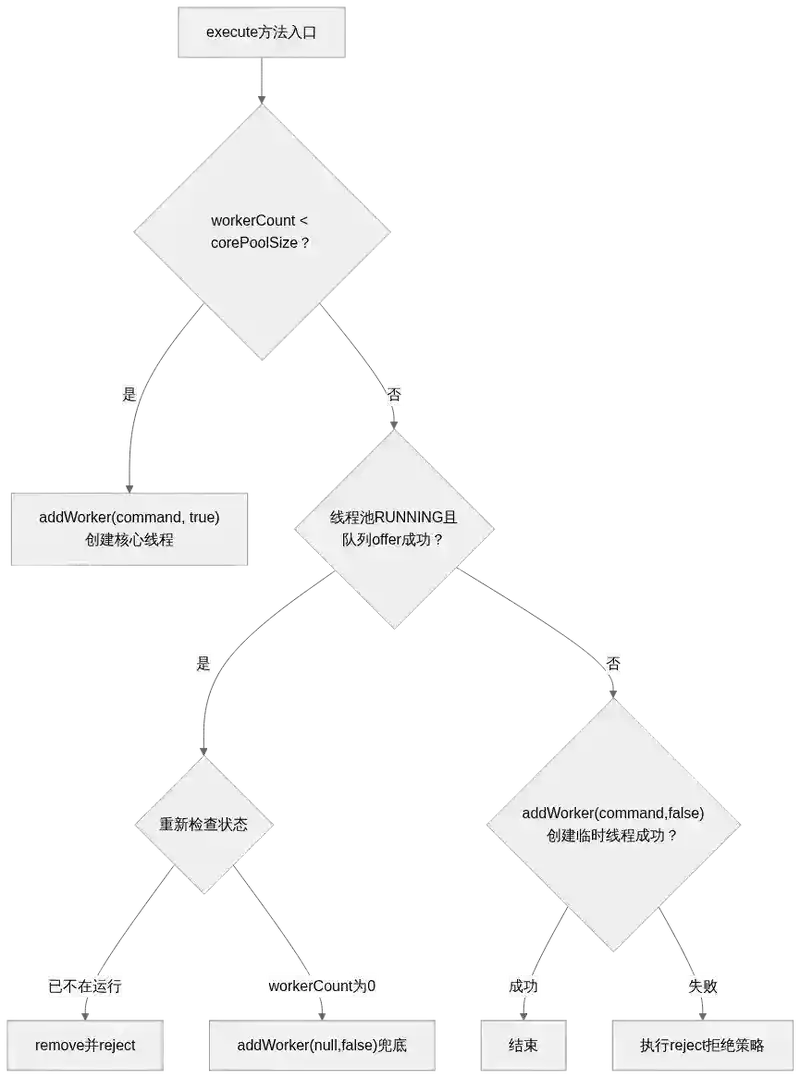
上一篇讲清楚了 corePoolSize、maximumPoolSize、workQueue、keepAliveTime 这几个参数各自控制什么,但这些参数并不是孤立生效的——它们真正的行为逻辑,全部体现在 ThreadPoolExecutor.execute(Runnable command) 这一个方法的判断顺序里。理解了 execute 的决策路径,前面那些参数才算真正"连起来"。
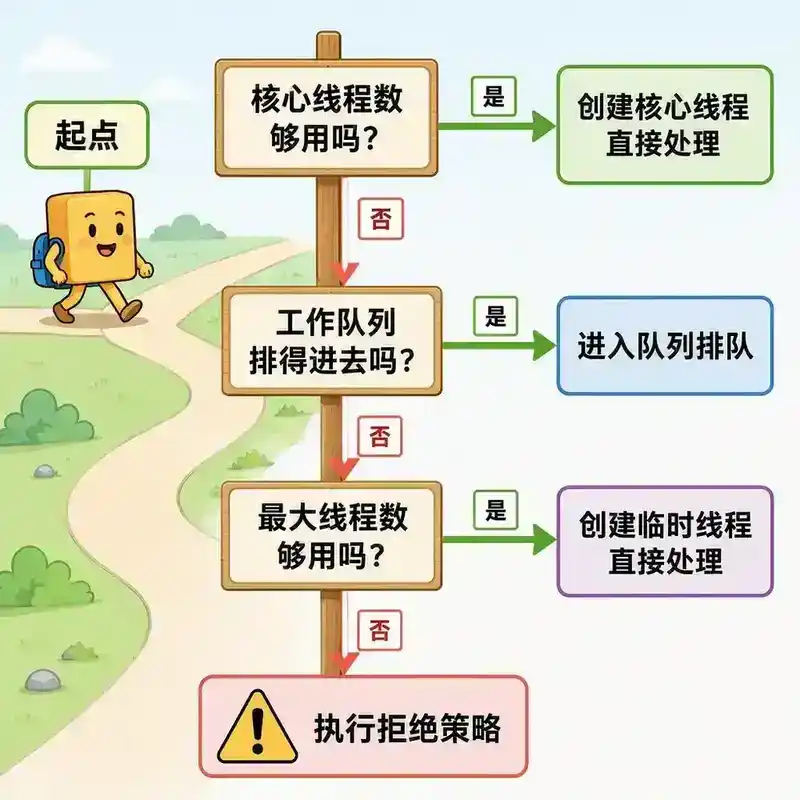
execute 的核心逻辑可以概括成三个连续的判断:
- 当前线程数是否还没达到核心线程数? 没达到,直接创建一个新的核心线程去执行这个任务,跳过排队。
- 核心线程已经补满,任务能不能放进工作队列? 如果线程池还在正常运行状态、且队列还没满,把任务放进队列排队,等待某个线程来取。
- 队列也放不进去了(满了,或者是不存储任务的
**SynchronousQueue**),当前线程数还没到最大线程数吗? 没到,创建一个超出核心线程数的"临时"线程直接处理这个任务;如果已经到了最大线程数,执行拒绝策略。
这三步判断有一个容易被忽略但非常关键的顺序特点:优先创建核心线程,其次才排队;队列排不下了,才轮到创建临时线程。也就是说,只要核心线程还没补满,线程池宁可多开一个核心线程,也不会先把任务丢进队列——这跟很多人直觉里"先排队,排不下再开线程"的想法是相反的。
二、ctl 变量:一个 int 如何同时表示线程池状态和线程数量
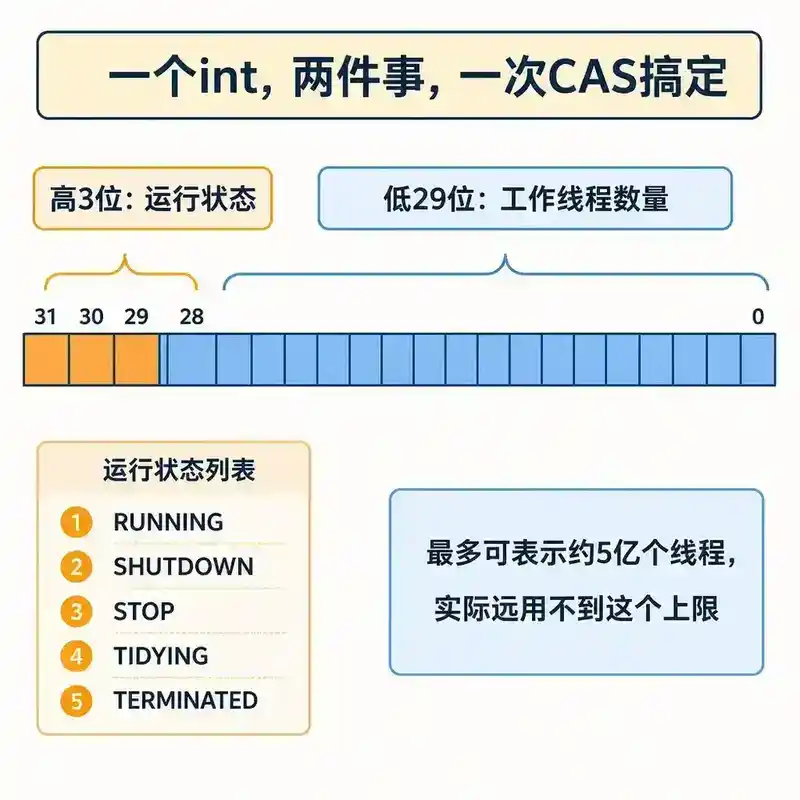
ThreadPoolExecutor 内部用一个名叫 ctl 的 AtomicInteger 同时打包了两类信息:线程池的运行状态(RUNNING、SHUTDOWN、STOP、TIDYING、TERMINATED 五种)和当前的工作线程数量。具体的打包方式是:一个 32 位的 int,高 3 位存运行状态,低 29 位存线程数量。这么设计的好处是:可以用一次原子的 CAS 操作,同时完成"检查状态是否允许、并且更新线程数量"这两件事,不需要用两个独立的变量再加锁去保证它们之间的一致性——如果状态和数量分开存,线程池在高并发下判断"当前是否还在运行、且线程数是否还没达到上限"时,就必须用锁把两次读取包起来,否则会出现读到状态时是 RUNNING、读到数量时线程池已经被关闭的中间态。
线程池的五种状态之间只能按固定方向单向迁移:RUNNING → SHUTDOWN(调用 shutdown(),不再接受新任务,但会处理完队列里剩下的任务)、RUNNING/SHUTDOWN → STOP(调用 shutdownNow(),不但不接受新任务,还会尝试中断正在执行的任务)、SHUTDOWN/STOP → TIDYING(所有任务都已经处理完、工作线程数归零)、TIDYING → TERMINATED(执行完 terminated() 钩子方法)。理解这条状态迁移链,能解释很多"为什么 shutdown() 之后还能看到任务继续执行、但 shutdownNow() 之后任务却被中断"这类现象背后的机制。
三、Worker:线程池里真正在跑的线程到底是什么
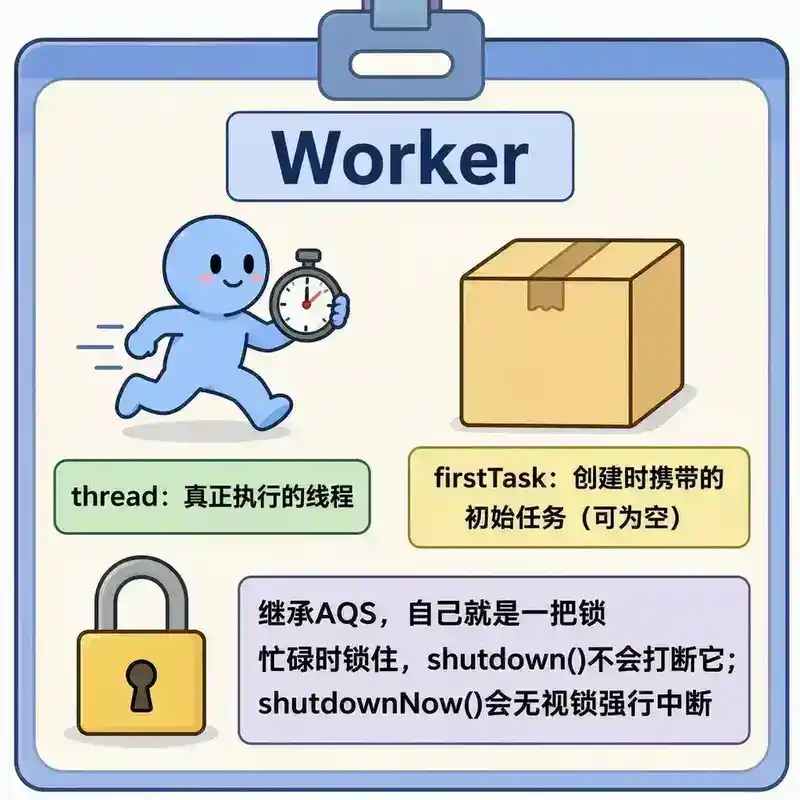
线程池并不是直接管理裸的 Thread 对象,而是把每一个工作线程包装成一个内部类 Worker。Worker 本身实现了 Runnable,同时继承了 AbstractQueuedSynchronizer(也就是上一个系列里讲过的 AQS)——它自己就是一把简化版的独占锁。每个 Worker 内部持有两个关键字段:一个真正的 Thread 对象(这个线程运行起来之后,执行的就是 Worker.run()),以及一个 firstTask(如果这个 Worker 是因为要立刻执行某个任务而被创建出来的,这个字段就存着那个任务,避免创建出来后还要绕一圈从队列里取)。
Worker 借用 AQS 实现"锁"的目的,跟 ReentrantLock 保护共享资源完全不同——它是为了实现一套精确的"能不能被中断"的状态机:Worker 在真正开始执行任务期间会把自己"锁住"(state 设为 1),线程池调用 shutdown() 时,只会去中断那些当前没有在执行任务、处于空闲等待状态的 Worker(能成功获取到它的锁,说明它没在忙),而正在执行任务的 Worker 因为锁被它自己持有,shutdown() 会跳过它,让它先把手头的任务做完。shutdownNow() 则不做这层区分,无论 Worker 是否在忙,全部尝试中断。
四、addWorker:真正创建一个新线程要经过哪些检查
execute 里提到的"创建核心线程"和"创建临时线程",底层调用的都是同一个方法:addWorker(Runnable firstTask, boolean core),第二个参数 core 就是用来区分"这次创建是要占用核心线程的名额,还是最大线程的名额"。这个方法内部大致分两个阶段:
第一阶段是检查是否还有名额:先检查线程池的运行状态是否允许创建新线程(比如已经进入 STOP 状态就不会再创建),然后用一个 CAS 循环把 ctl 里的工作线程数 +1——这里用 CAS 而不是加锁,是因为"能不能再加一个线程"这个判断本身不需要跟其他复杂逻辑绑在一起,用无锁的原子操作性能更好。
第二阶段才是真正创建线程对象:这一步需要加锁(mainLock),因为要把新建的 Worker 加入到线程池维护的 workers 这个集合里,这是一个共享的数据结构,必须加锁保护。加锁之后还会再检查一次线程池状态——因为从第一阶段的 CAS 成功到这里加锁成功之间,线程池的状态可能已经发生了变化(比如刚好有另一个线程调用了 shutdown()),这是一种典型的"检查后加锁、加锁后再检查一次"的双重检查模式,用来防止在没有锁保护的间隙里状态发生了改变。检查通过之后,把 Worker 加入集合、调用 Worker 内部线程的 start() 方法,这个新线程才真正开始运行。
如果中间任何一步检查失败(状态不允许、或者线程启动失败),addWorker 会把刚才 CAS 增加的线程计数回滚,并触发一次 tryTerminate()(检查线程池是否满足终止条件),保证整个过程即使失败也不会让内部计数出现"多算了一个线程"的不一致状态。
五、任务执行循环:getTask 与 runWorker
一个 Worker 线程启动之后,运行的是 runWorker 方法,它的核心是一个循环:只要能持续拿到任务,就一直执行下去。第一个任务如果是创建时携带的 firstTask,直接执行;执行完之后,进入循环反复调用 getTask() 去工作队列里取下一个任务,取到就继续执行,取不到(返回 null)就意味着这个线程该退出了,整个方法结束,线程真正终止。
getTask() 内部有一个判断,直接决定了这个线程是"该永远等下去"还是"该等一段时间就放弃":如果当前工作线程数已经超过了 corePoolSize(说明这是一个"临时"线程),或者显式开启了 allowCoreThreadTimeOut,取任务时用的是带超时的**poll(keepAliveTime, unit)**——超时还没等到任务,就返回 null,线程随之退出,这正是上一篇文章里 keepAliveTime 回收机制的具体实现位置。反之(核心线程、且没开启超时),取任务用的是无限等待的**take()**,不会因为等待太久而自己放弃。
每次真正执行任务前后,runWorker 会调用两个可以被子类覆盖的钩子方法:beforeExecute(thread, task) 和 afterExecute(task, throwable)——这是线程池留给使用者的扩展点,比如可以在这里做任务执行耗时的统计、日志埋点,而不需要修改任务本身的代码。
六、异常处理:任务执行时抛异常,这个线程会怎样
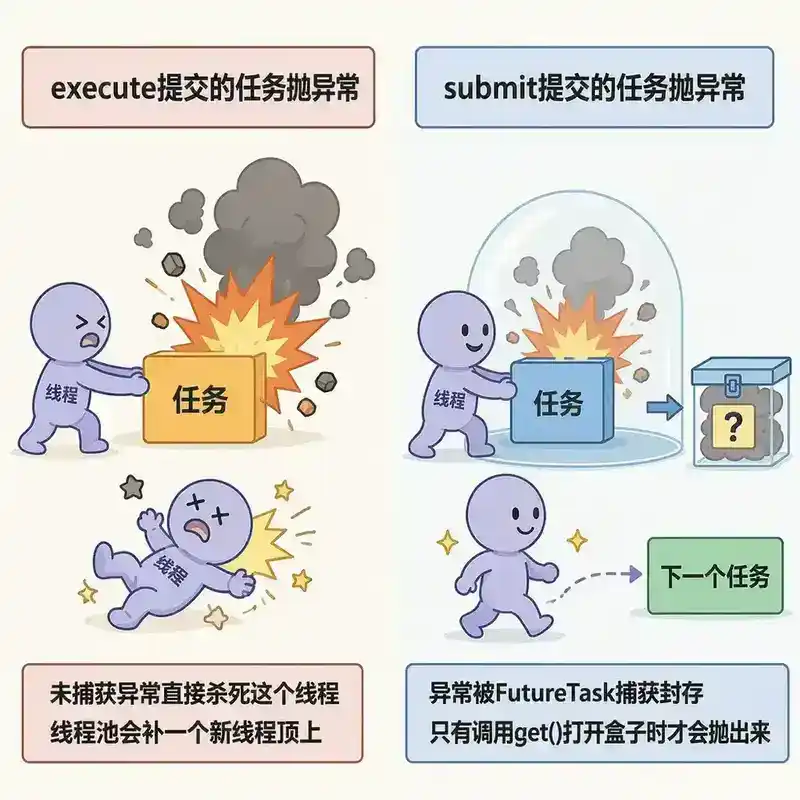
这是线程池实践中最容易被忽视、也最容易踩坑的一块。当一个 Runnable 任务在 runWorker 的执行循环里抛出一个未被内部捕获的运行时异常,这个异常会顺着调用栈往上传:先经过 afterExecute(task, thrown) 钩子(thrown 参数会带上这个异常,即使用户没有覆盖这个方法,默认实现也什么都不做,异常继续往上传),然后在 runWorker 的外层被重新抛出,导致这个线程的执行循环直接结束、线程真正死亡——不是"捕获了异常然后继续下一个任务",而是"这个线程因为这次异常,人生就此终结"。
线程死亡之后,processWorkerExit 方法会被触发,检测到这是一次"异常终止"(completedAbruptly=true)而不是正常的"取不到任务了主动退出",会额外做一次线程数补偿:创建一个新的 Worker 顶替上去,保证线程池的实际线程数不会因为一次任务异常而悄悄减少。从线程池整体数量上看,这个过程几乎是无感的;但如果没有配合日志或者监控,这次异常本身很可能完全没有留下任何痕迹,只有配置了 Thread.UncaughtExceptionHandler 或者线程池默认的异常处理链路才会把异常栈打到标准错误输出。
如果任务不是通过 execute() 而是通过 submit() 提交(对应的是 Callable,返回一个 Future),情况完全不同:submit() 内部会把任务包装成一个 FutureTask,任务真正执行的代码在 FutureTask.run() 里,其中有一层 try-catch 会把执行过程中抛出的异常捕获并存进**FutureTask**内部的一个字段,并不会让异常继续往外传——也就是说,通过**submit()**提交的任务,即使内部抛了异常,执行它的 Worker 线程完全不受影响,会正常地继续去取下一个任务。这个异常只有在调用 future.get() 时,才会以 ExecutionException 的形式被重新抛出来。这也是为什么很多团队会强调:如果用 execute() 提交任务,必须自己在任务内部做好异常捕获,否则异常会"静默"地杀死一个线程;如果用 submit(),则必须记得调用 get() 或者主动检查 Future 的状态,否则异常会被"藏起来",永远没人知道它发生过。
七、面试追问链
从 execute 的三步决策路径出发,逐层追问:execute 判断核心线程、队列、最大线程的先后顺序是什么、ctl 变量为什么要把状态和数量打包在一起、Worker 为什么要自己实现一把锁而不是用现成的 ReentrantLock、addWorker 里"检查后加锁、加锁后再检查"的双重检查模式解决了什么并发问题、getTask 里线程是"永远等待"还是"限时等待"由什么决定、任务执行抛出异常之后这个线程本身会怎样、以及 execute 和 submit 在异常处理上到底有什么本质区别,这条链基本能覆盖面试官对线程池执行机制的核心考察点。
延伸阅读
java.util.concurrent.ThreadPoolExecutor源码中的execute、addWorker、runWorker、getTask、processWorkerExit方法,建议对照本文逐行阅读一遍java.util.concurrent.FutureTask源码,理解submit()提交任务的异常为什么会被"封存"而不是直接抛出- 下一篇预告:线程池的关闭流程——shutdown 与 shutdownNow 的区别、中断的传递范围与优雅停机实践
问答(不计入阅读时长)
Q1:既然 execute 的判断顺序是"优先补满核心线程,其次才排队",那如果 corePoolSize 设置得很大(比如 200),是不是意味着一开始来 200 个任务,就会瞬间创建 200 个线程,而完全不会用到工作队列?
A:是的,这正是这个判断顺序带来的直接后果。只要 workerCount < corePoolSize 这个条件成立,execute 就会毫不犹豫地走 addWorker(command, true) 这条路径去创建新的核心线程,完全不会考虑"是不是应该先让任务排队"。所以如果 corePoolSize 设置得很大,短时间内涌入大量任务,确实会在很短时间内创建出大量线程,工作队列这时候几乎是空的,直到核心线程全部补满之后,后续的任务才会开始排队。这也提示了一个实践上的考量:corePoolSize 不应该被当作一个"能扛得住的最大并发数"来设置,而应该结合任务的性质(CPU 密集还是 IO 密集)算出一个真正合理的常驻线程数,如果只是为了"应对偶尔的突发流量",更合理的做法是保持较小的 corePoolSize,配合工作队列和 maximumPoolSize 来吸收突发压力,而不是一开始就把 corePoolSize 设得很大。
Q2:**ctl**变量的高 3 位存状态、低 29 位存数量,那这几个状态值(RUNNING、SHUTDOWN 等)具体的数值大小有讲究吗,为什么不是简单地用 0、1、2、3、4 表示?
A:有讲究,这几个状态在源码里被定义成负数和正数交替的形式(大致是 RUNNING = -1<<COUNT_BITS,SHUTDOWN = 0,STOP = 1<<COUNT_BITS,以此类推,数值上依次递增),这样设计是为了能直接用"数值比较"来判断状态的先后关系,而不需要写一堆 if-else 去匹配具体的状态枚举值。比如源码里判断"线程池是否已经不再处于 RUNNING 状态",只需要判断 ctl.get() >= SHUTDOWN 这一个数值比较,因为所有状态按照生命周期顺序被设计成数值递增的——RUNNING 是负数,比其余所有状态都小,只要数值大于等于 SHUTDOWN,就说明已经进入了后续某个阶段。用数值大小天然表达状态先后顺序,是一种很紧凑地把"状态机的偏序关系"编码进整数比较运算的技巧。
Q3:Worker 继承 AQS 实现锁,那它的**tryAcquire**具体是怎么实现的,跟**ReentrantLock**的实现思路一样吗?
A:思路上是类似的,但 Worker 的实现更简化,因为它不需要支持"可重入"这个特性。Worker 内部的 tryAcquire 直接用一次 CAS,把状态从 0 改成 1,成功就代表获取锁成功,并且不会去判断当前持有者是不是自己(ReentrantLock 需要判断重入的情况,Worker 完全不需要,因为 Worker 的锁只在自己内部的执行循环里使用,不存在"同一个线程多次请求同一把锁"的场景)。正因为不需要处理重入,Worker 里的加锁逻辑比 ReentrantLock 的实现要简单得多,本质上只是借用 AQS 现成的排队和状态管理框架,来表达"当前是否正在执行任务"这一个二元状态,而不是真的把它当作一把给业务代码用的通用锁。
Q4:addWorker 里"检查后加锁、加锁后再检查"这种双重检查模式,如果只做一次检查(比如只在加锁后检查一次),会出什么问题?
A:如果省掉第一次检查(也就是在没有锁保护的情况下直接尝试 CAS 增加线程计数),会导致在线程池已经处于不允许创建新线程的状态时,依然可能有线程数被意外地增加,之后即使加锁后发现状态不对要回滚,也已经产生了一段时间的计数不一致,可能被其他并发路径读取到错误的中间态。如果反过来省掉第二次检查(只在没加锁的时候检查一次,然后直接加锁创建),问题会更明显:从"检查状态允许创建"到"真正加锁执行创建"之间存在一个时间窗口,如果恰好在这个窗口内另一个线程调用了 shutdown(),那么锁内的创建操作会在"线程池已经不允许创建新线程"的状态下依然把新线程加进去,导致关闭流程无法正确地把所有工作线程清点干净,甚至造成线程泄漏。两次检查配合无锁的 CAS 和加锁后的最终确认,才能在保证性能(大部分时候不需要加锁)的同时不牺牲正确性。
Q5:getTask 里"如果 workerCount 超过 maximumPoolSize 也会走限时等待",这句话是什么意思?maximumPoolSize 不是运行时不能修改的吗?
A:maximumPoolSize 并不是不能修改的——ThreadPoolExecutor 提供了 setMaximumPoolSize(int) 方法,可以在线程池运行期间动态调小这个值。如果线程池当前的线程数是按照旧的(更大的)maximumPoolSize 创建出来的,之后又被调小了,就会出现"当前工作线程数超过了新的 maximumPoolSize"这种情况。getTask 里正是为了处理这种场景,才把"工作线程数是否超过当前的 maximumPoolSize"也作为触发限时等待(进而可能导致线程退出)的条件之一——这样即使 maximumPoolSize 被调小了,线程池也能通过这套"取任务超时就退出"的机制,逐步把多余的线程自然地淘汰掉,而不需要强行去中断某些正在运行的线程。
Q6:如果一个任务在 execute 提交后,执行过程中抛出了**Error**(比如**OutOfMemoryError**)而不是普通的**RuntimeException**,处理逻辑跟普通异常一样吗?
A:从"导致当前线程终止"这个结果上说是一样的——不管是 RuntimeException 还是 Error,只要是没有被任务内部代码捕获的 Throwable,都会顺着 runWorker 的调用栈往外传,导致这个工作线程死亡,触发 processWorkerExit 补一个新线程顶上。但实际后果可能差异很大:普通的业务异常通常只影响这一个任务本身的正确性;而像 OutOfMemoryError 这种 Error,往往意味着整个 JVM 已经处于资源枯竭的边缘状态,即使线程池"自动补线程"维持了表面上的线程数量,新创建的线程很可能马上又会因为同样的资源问题而失败,这种情况下线程池层面的自愈机制其实解决不了根本问题,需要在更上层(比如监控告警、限流降级)介入处理,而不能指望线程池的补偿逻辑能扛住系统性的资源枯竭。
Q7:既然 execute 提交的任务异常会"静默"杀死线程,日常写代码时,有没有办法在不改动每一个任务代码的前提下,统一给所有任务加上异常捕获?
A:有,最直接的方式是自定义线程池使用的 ThreadFactory,在创建线程时通过 Thread.setUncaughtExceptionHandler(handler) 给每个线程设置统一的未捕获异常处理器,这样即使任务内部没有做异常捕获,异常最终传到线程层面终止线程之前,会先经过这个统一的 handler,可以在这里做日志记录、监控上报,而不需要改动每一个具体任务的代码。另一种更彻底的方式是在线程池外面包一层,把提交给 execute 的每一个 Runnable 用一个统一的包装类再包一层,在包装类的 run() 方法里用 try-catch 兜底捕获所有异常并记录,这样从根源上避免异常继续往外传导致线程死亡。这两种方式经常被同时使用:包装类兜底捕获保证问题不会杀死线程,UncaughtExceptionHandler 作为最后一道防线,捕获那些万一漏网的异常。
Q8:文章里提到线程池状态只能单向迁移(RUNNING → SHUTDOWN → TIDYING → TERMINATED 这条链路),如果调用 shutdown() 之后又想让线程池恢复到 RUNNING 继续接受新任务,有没有办法做到?
A:没有办法,ThreadPoolExecutor 没有提供任何"撤销关闭"的机制,一旦调用了 shutdown() 或者 shutdownNow(),线程池就已经进入了不可逆的关闭流程,唯一能做的是等它自然走到 TERMINATED 状态(可以用 awaitTermination 等待),然后重新创建一个新的**ThreadPoolExecutor**实例。这是一个很多人容易想岔的地方——线程池不是一个可以反复开关的"阀门",而是一个有明确生命周期的资源对象,关闭即意味着终结。如果业务场景确实需要"临时暂停接受任务、之后又能恢复"这种效果,应该在应用层维护一个开关标志,在提交任务前先检查这个标志,而不是依赖对线程池本身状态的开关控制。