一、为什么需要 ThreadLocal
两个典型场景能说明 ThreadLocal 存在的意义:
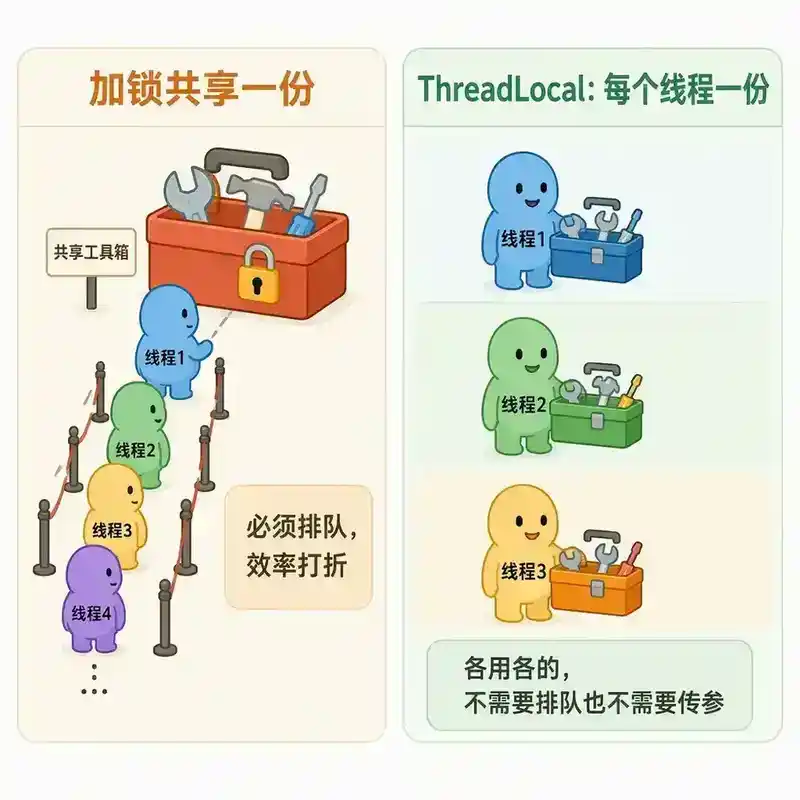
第一个场景是线程不安全的工具类。比如老版本的 SimpleDateFormat,它内部有可变的成员变量,多个线程共享同一个实例并发调用 format()/parse() 会出现数据错乱。解决办法之一是每个线程都拿到自己独立的一个实例,不同线程之间互不干扰——但如果每次用到都 new 一个新实例,创建成本又不划算;如果所有线程共享一个实例再加锁保护,又把原本可以并发的操作串行化了。
第二个场景是跨方法传递上下文。比如一次 HTTP 请求里,最外层的入口方法拿到了当前登录用户信息、traceId 等上下文数据,但这次请求内部会调用一长串方法、跨越好几层调用栈,最终某个很深层的方法也需要用到这些上下文数据。如果一层层地在方法参数里传递这些数据,会让每个方法签名都被这些"跟本身业务逻辑无关"的参数污染。
这两个场景本质上都指向同一个需求:让同一个线程内的不同代码位置,能够共享一份只属于这个线程自己的数据,而不需要显式传参,也不需要跟其他线程互相干扰。这正是 ThreadLocal 要解决的问题。
二、ThreadLocalMap:数据到底存在哪里
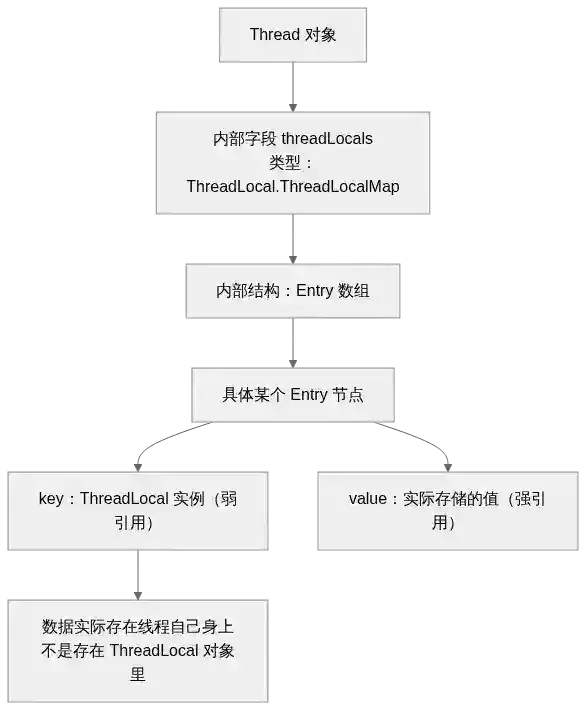
很多人对 ThreadLocal 有一个直觉上的误解:以为 ThreadLocal 对象内部维护了一张"线程 → 值"的映射表,每个线程去这个 ThreadLocal 对象里取属于自己的那一份。但真实的实现方向恰好是反过来的:数据并不存在 ThreadLocal 对象里,而是存在线程自己身上。
具体来说:Thread 类内部有一个字段叫 threadLocals,类型是 ThreadLocal.ThreadLocalMap——这是一个定制化的哈希表,专门为 ThreadLocal 场景设计。当你调用 threadLocal.set(value) 时,实际发生的事情是:找到当前线程的这个 threadLocals 字段(如果还没有就新建一个),然后往这个哈希表里塞入一条 Entry,key 是这个 ThreadLocal 实例本身,value 才是你传进去的值。调用 get() 则是反过来,找到当前线程的 threadLocals,用当前这个 ThreadLocal 实例作为 key 去查找对应的 value。
这也解释了为什么"ThreadLocal"这个名字容易让人误解——它本身更像是一把用来在当前线程的 Map 里定位数据的钥匙,而不是数据的存储容器本身。真正的存储容器是挂在每个 Thread 对象上的那个 ThreadLocalMap。
三、弱引用设计:为什么 key 要用弱引用
ThreadLocalMap 里的 Entry 继承自 WeakReference<ThreadLocal<?>>,也就是说 Entry 对 ThreadLocal 实例的引用是一个弱引用,而对 value 的引用是普通的强引用。这个设计是有意为之的:
如果 Entry 对 ThreadLocal 实例是强引用,那么只要这个线程的 threadLocals 里还挂着这条 Entry,这个 ThreadLocal 实例就永远不会被垃圾回收,即使业务代码里已经不再持有任何指向这个 ThreadLocal 实例的引用(比如它是一个方法内的局部变量,方法早就执行完了)。用弱引用可以让 ThreadLocal 实例在业务代码不再引用它之后,能够被垃圾回收器正常回收,避免"ThreadLocal 对象本身"发生泄漏。
四、真正的内存泄漏根源:value 才是强引用
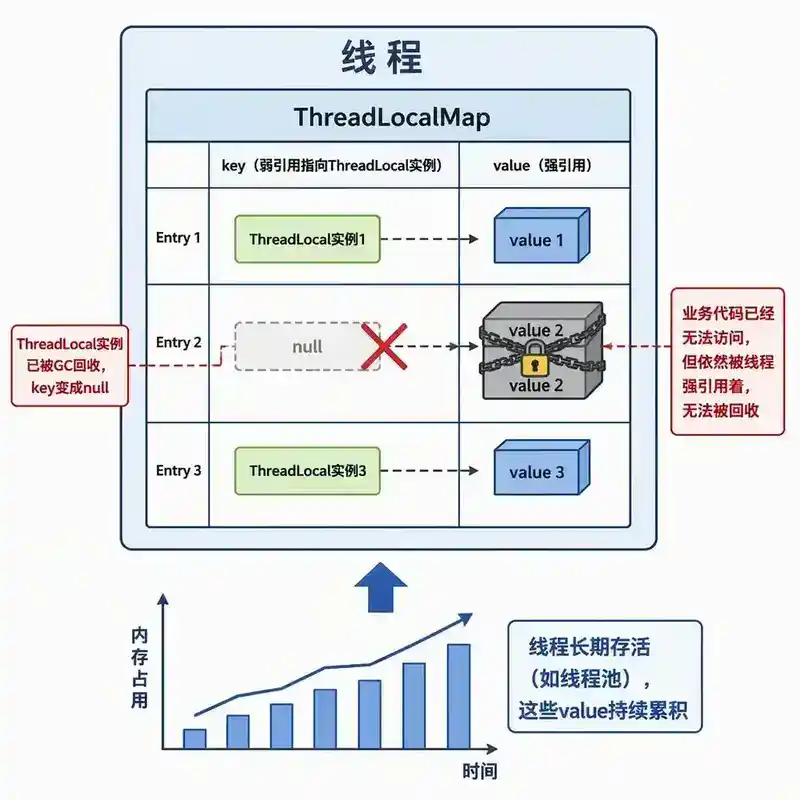
弱引用只解决了"ThreadLocal 实例"这一半的问题,但value 依然是被强引用着的。当 ThreadLocal 实例被回收之后,对应 Entry 里的 key 会变成 null,但这个 Entry 本身依然存在于线程的 ThreadLocalMap 里,而它持有的 value 依然是一个正常的强引用——只要这个线程还活着,这个 value 就永远不会被回收,哪怕已经没有任何代码能再通过正常途径访问到它(因为对应的 ThreadLocal key 已经变成了 null,业务代码没有办法再用它去 get)。
这才是"ThreadLocal 会导致内存泄漏"这句话背后真正的机制:不是 ThreadLocal 本身泄漏,而是 key 被回收后残留下来的、再也无法被正常代码访问、却依然被线程强引用着的 value。这个问题在线程池场景下会被放大到很严重的程度——线程池里的线程是长期存活、反复被复用执行不同任务的,如果每个任务都往 ThreadLocal 里塞了数据却没有清理,日积月累,这个线程的 ThreadLocalMap 里会堆积大量再也用不到、却占着内存不释放的 value,最终可能导致内存持续增长甚至 OOM。
五、如何真正避免内存泄漏
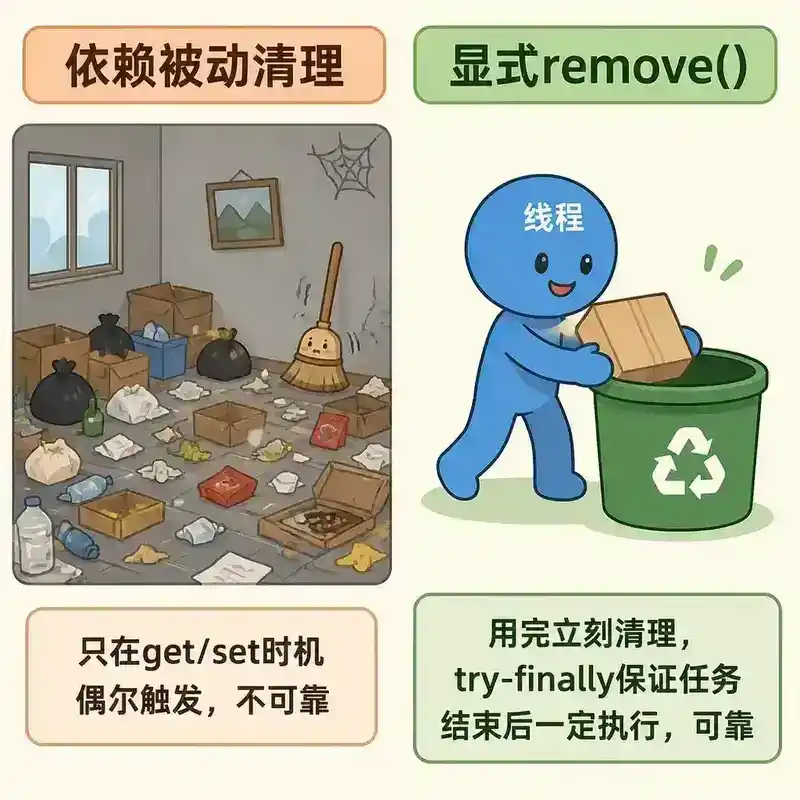
被动依赖弱引用是不够的,ThreadLocalMap 内部虽然在 get()、set()、扩容等操作过程中会附带做一些清理"key 已经为 null 的陈旧 Entry"的工作(比如 expungeStaleEntry 这类方法),但这些清理都是被动触发、时机不确定的兜底手段,不能替代主动清理。
真正可靠的做法是:用完 ThreadLocal 之后,显式调用**remove()**。这会直接把当前线程对应的那条 Entry 从 ThreadLocalMap 里彻底删掉,value 也就失去了这条强引用链,能够被正常回收。在线程池场景下,标准做法是把"设置 ThreadLocal"和"移除 ThreadLocal"分别放在任务开始和任务结束(通常用 try-finally 包裹),确保这个线程被交还给线程池、去执行下一个任务之前,上一个任务留下的 ThreadLocal 数据已经被清理干净。
六、InheritableThreadLocal 与线程池场景下的失效
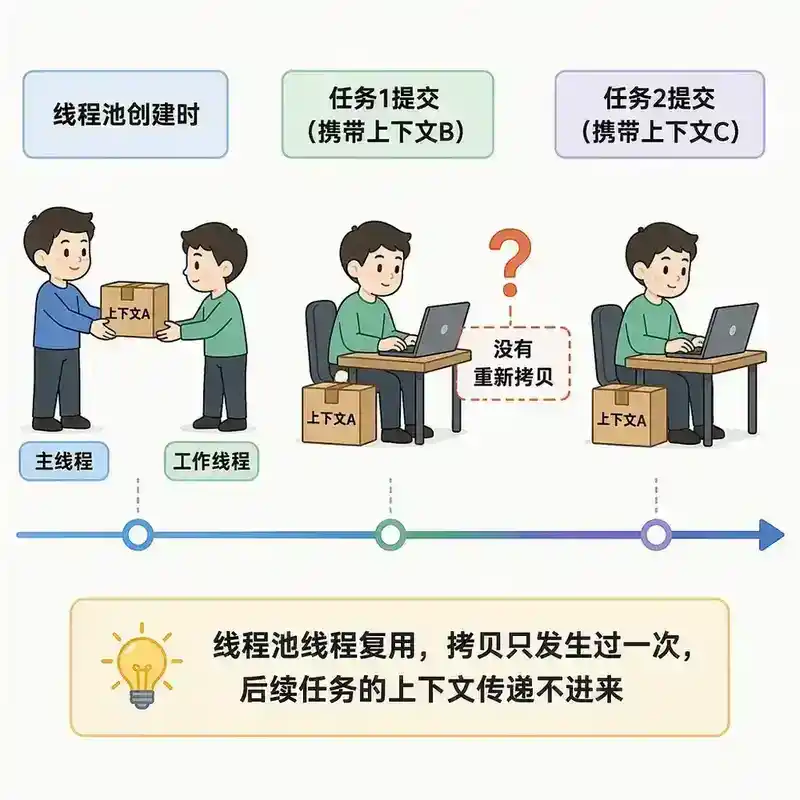
普通的 ThreadLocal 有一个特点:父线程设置的值,子线程是看不到的——因为子线程有自己独立的 threadLocals,跟父线程的完全隔离。InheritableThreadLocal 是为了解决"希望子线程能继承父线程的上下文"这个需求而设计的:Thread 类还有另一个字段 inheritableThreadLocals,在创建新线程的过程中(Thread 的 init 方法里),会把父线程当前的 inheritableThreadLocals 拷贝一份给新创建的子线程。
但这个机制在线程池场景下会失效,原因是拷贝这个动作只发生在线程被创建的那一刻。线程池里的线程是被反复复用的——线程一旦创建,之后每次执行不同的任务,都是同一个线程对象在跑,并不会为每个任务重新创建一次线程,也就不会重新执行一次"拷贝父线程上下文"的逻辑。这意味着线程池里的工作线程拿到的,永远是它第一次被创建时那个提交任务的线程的上下文,跟"当前这次提交任务的线程"完全没有关系。像 traceId 这类需要跟着每一次任务调用走的上下文数据,在线程池场景下用 InheritableThreadLocal 是不管用的,这也是为什么业界会有专门的工具(比如阿里开源的 TransmittableThreadLocal)去解决"任务提交时捕获上下文、任务在线程池线程里执行时恢复上下文、执行完后再还原线程原有上下文"这一整套逻辑。
七、面试追问链
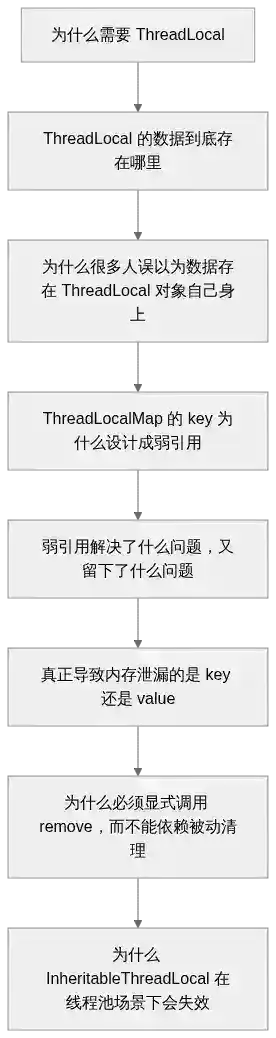
从"为什么需要 ThreadLocal"出发,逐层追问:ThreadLocal 的数据到底存在哪里、为什么很多人会误以为数据存在 ThreadLocal 对象自己身上、ThreadLocalMap 的 key 为什么要设计成弱引用、弱引用解决了什么问题又留下了什么问题、真正导致内存泄漏的是 key 还是 value、为什么必须显式调用 remove 而不能依赖被动清理、以及为什么 InheritableThreadLocal 在线程池场景下会失效,这条链基本能覆盖面试官对 ThreadLocal 体系的核心考察点。
延伸阅读
java.lang.ThreadLocal与ThreadLocal.ThreadLocalMap源码,重点看set/get/remove和expungeStaleEntry的实现java.lang.InheritableThreadLocal源码,对比它与ThreadLocal在Thread.init()里的具体差异- 下一篇预告:线程池核心原理——核心线程、最大线程、工作队列、keepAliveTime
问答(不计入阅读时长)
Q1:为什么不直接搞一个全局的**Map<Thread, T>**,用线程作为 key 来实现"每个线程一份数据",而要单独设计一个 ThreadLocalMap 挂在每个线程身上?
A:如果用一个全局共享的 Map<Thread, T>,那么这个 Map 本身就成了一个被所有线程共同访问的共享资源——多个线程并发调用 put/get 时,仍然需要额外的同步手段来保护这个 Map 自身的线程安全,这就绕回了"用锁保护共享结构"的老路子,只是把锁保护的对象从业务数据换成了这个映射表而已。把数据分散挂在每个 Thread 对象自己身上(也就是每个线程自己的 ThreadLocalMap),意味着不同线程访问的是完全不同的对象实例,天然没有并发访问同一个数据结构的问题,也就不需要任何额外的同步开销。
Q2:ThreadLocalMap 内部是用什么方式解决哈希冲突的,跟普通的 HashMap 一样吗?
A:不一样。普通的 HashMap 遇到哈希冲突时用的是链地址法(同一个桶位挂一条链表或红黑树)。ThreadLocalMap 用的是开放地址法里的线性探测(linear probing)——如果计算出的桶位已经被占用,就顺着往后一个个找空位,直到找到为止。这么设计的原因是:ThreadLocalMap 通常只用来存少量的 Entry(一个线程身上往往只挂了个位数的 ThreadLocal),用链表/红黑树这种为了应对海量数据和高冲突率设计的结构反而是过度设计,线性探测在数据量小、结构简单的场景下实现更轻量,也更省内存。
Q3:ThreadLocalMap 计算哈希值时用到一个很奇怪的常量**0x61c88647**,这是干什么的?
A:这个常量被称为"黄金分割数"哈希增量,每创建一个新的 ThreadLocal 实例,它的哈希值就是在上一个 ThreadLocal 实例的哈希值基础上加上这个常量(内部通过一个 AtomicInteger 累加实现)。这个常量的数学特性是:让连续生成的哈希值,在对 2 的幂大小的数组取模之后,能够非常均匀地分布在整个数组的各个桶位上,尽量避免多个 ThreadLocal 实例扎堆落在同一个桶位造成线性探测链变长。因为 ThreadLocalMap 的核心访问场景就是根据 ThreadLocal 实例直接定位桶位,均匀分布直接决定了查找效率。
Q4:调用**set(null)**和调用**remove()**效果是一样的吗?
A:不一样,而且区别很关键。set(null) 只是把这个 Entry 对应的 value 设置成了 null,但这条 Entry 本身依然存在于 ThreadLocalMap 里,key(也就是对这个 ThreadLocal 实例的弱引用)依然是有效的,只要业务代码里还有地方强引用着这个 ThreadLocal 实例,这条 Entry 就不会被当作"陈旧 Entry"清理掉。而 remove() 是直接把这条 Entry 从 ThreadLocalMap 里彻底删除。虽然 set(null) 之后 value 本身占用的那部分内存确实能被回收(因为 value 已经指向 null 了),但 Entry 结构占用的空间以及潜在的清理时机都不如 remove() 干净彻底——真正想要"用完就彻底清干净",应该用 remove() 而不是 set(null)。
Q5:既然线程池场景下**InheritableThreadLocal**会失效,**TransmittableThreadLocal**(TTL)具体是怎么解决这个问题的?
A:TTL 的核心思路可以概括为"捕获—回放—恢复"三步:在任务被提交到线程池的那一刻(也就是还在提交任务的原始线程上),先把当前需要传递的上下文数据捕获下来打包成一个快照;然后对提交给线程池的 Runnable/Callable 做一层包装,在线程池的工作线程真正开始执行这个任务之前,把刚才捕获的快照回放到当前这个工作线程身上(相当于临时把值设置进这个线程的 ThreadLocalMap);任务执行完之后,再把这个工作线程的 ThreadLocal 值恢复成执行这个任务之前的状态(也就是恢复到它给上一个任务收尾之后遗留的值,避免污染下一个任务)。这一整套"捕获—回放—恢复"是在每一次任务提交和执行的粒度上做的,跟 InheritableThreadLocal 那种"只在线程创建那一刻拷贝一次"完全是两种机制。
Q6:既然 ThreadLocal 是"线程私有"的,那子线程创建的孙子线程(线程链更深一层)用 InheritableThreadLocal 还能不能继续往下传?
A:可以,因为 InheritableThreadLocal 拷贝的时机是"创建新线程时",而不是"只拷贝一层"。子线程在被创建时,会从父线程那里拷贝一份 inheritableThreadLocals;如果子线程之后又去创建了自己的子线程(也就是孙子线程),孙子线程在被创建时,同样会从它的直接父线程(也就是刚才那个子线程)身上拷贝一份 inheritableThreadLocals。所以只要每一层都是"新创建线程"而不是"复用已有线程",这条继承链可以一直往下传递多层。真正会打断这条链的,只有"线程被复用、而不是被重新创建"这一种情况——这正是线程池场景下会失效的根本原因。
Q7:ThreadLocal 存储的值需不需要考虑序列化或者跨 JVM 传递的问题?
A:完全不需要考虑。ThreadLocal 存储的数据始终停留在单个 JVM 进程内部、单个线程的内存空间里,不会跨越线程边界(除了 InheritableThreadLocal/TTL 主动传递的情况),更不会跨越 JVM 进程或者网络边界。这跟"分布式上下文传递"(比如 RPC 调用链路上跨服务传递 traceId)是完全不同层次的问题——ThreadLocal 解决的是"同一个 JVM 进程内、同一条调用栈内"的数据共享,如果要把上下文传递到另一个进程或者另一台机器,需要的是把数据显式地放进请求头、消息体这类跨进程传输的载体里,ThreadLocal 本身管不到这个范围。
Q8:日常写业务代码时,把 ThreadLocal 实例定义成实例变量还是**static final**字段,会有什么区别?
A:几乎总是应该定义成 static final 字段。原因在于 ThreadLocalMap 里的 key 是弱引用指向的这个 ThreadLocal 实例本身——如果 ThreadLocal 是一个实例变量(比如挂在某个业务对象上,每次创建业务对象都 new 一个新的 ThreadLocal),那么每次用同一段逻辑处理请求,实际用来做 key 的都是不同的 ThreadLocal 实例,之前存进 ThreadLocalMap 里、以旧实例为 key 的 Entry 就再也用不上了,只能等着被动清理,这本质上是在制造大量注定要变成"陈旧 Entry"的垃圾。定义成 static final 意味着整个类的生命周期内只有唯一一个 ThreadLocal 实例,同一个 key 能被稳定地复用,get/set/remove 都能精确命中同一条 Entry,不会产生冗余的陈旧数据。