一、为什么需要线程池
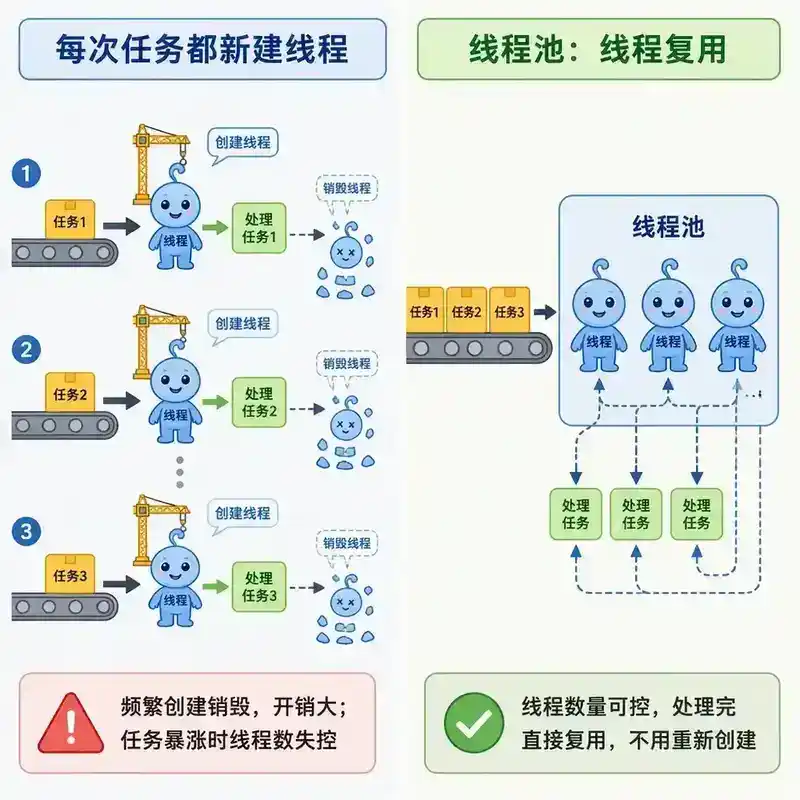
如果每次要执行一个异步任务,都直接 new Thread(task).start(),会带来两个实际的问题。第一,线程的创建和销毁本身是有成本的——操作系统要为每个线程分配独立的栈空间、内核调度结构,创建和销毁的开销在任务量大、任务本身执行很短的场景下会变得不可忽视,甚至可能超过任务本身的执行时间。第二,线程数量完全不可控——如果并发请求量突然暴涨,每个请求都对应创建一个新线程,线程数量可能无限增长,最终耗尽内存或者让操作系统的线程调度开销压垮整个系统,这种"来多少任务就开多少线程"的模式在生产环境里是一颗随时可能爆炸的定时炸弹。
线程池要解决的核心问题是:用一组预先创建、可以被反复复用的线程,去处理数量可能远超线程数本身的任务,把"线程的生命周期管理"和"任务的执行"解耦开——线程本身相对稳定、有限,任务可以源源不断地来,通过排队和复用把两者匹配起来。
二、核心线程数与最大线程数:两个数字分别控制什么
在深入每一个参数之前,先看一张全景图——ThreadPoolExecutor 一共由六个关键参数共同决定它的行为,后面几节会依次展开其中最容易踩坑的几个。
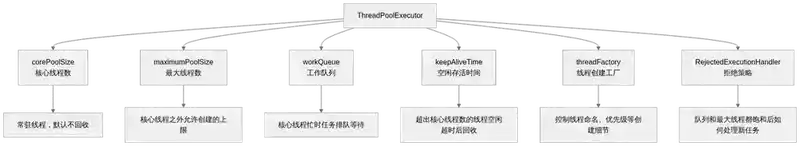
ThreadPoolExecutor 的构造参数里有两个跟线程数量直接相关的参数:corePoolSize(核心线程数)和 maximumPoolSize(最大线程数)。这两个数字描述的不是同一件事:
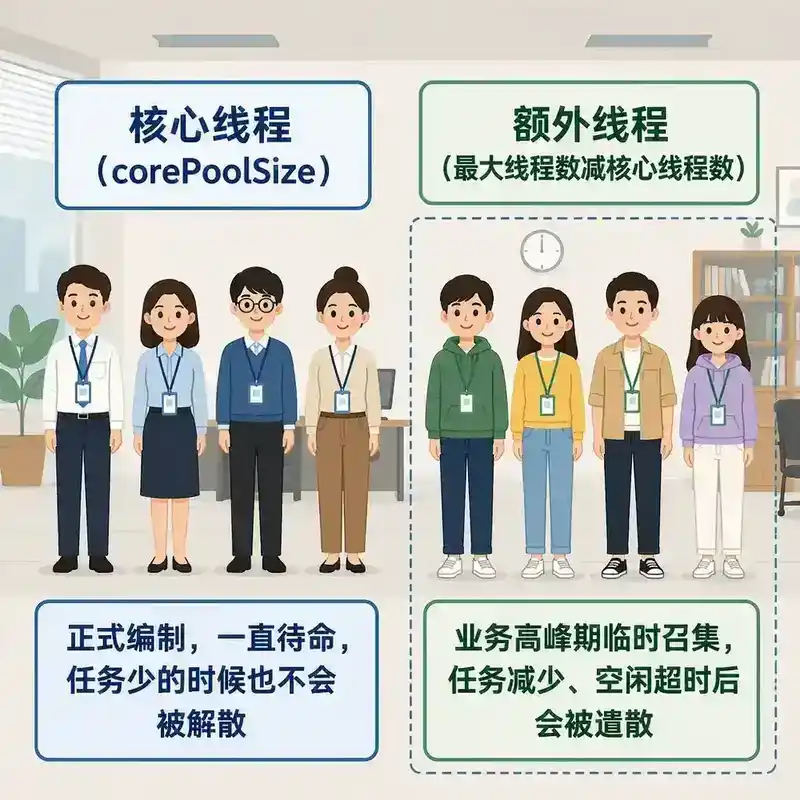
- 核心线程:这是线程池"常驻编制"的线程,正常情况下会一直存活,即使没有任务执行也不会被回收(除非显式配置了
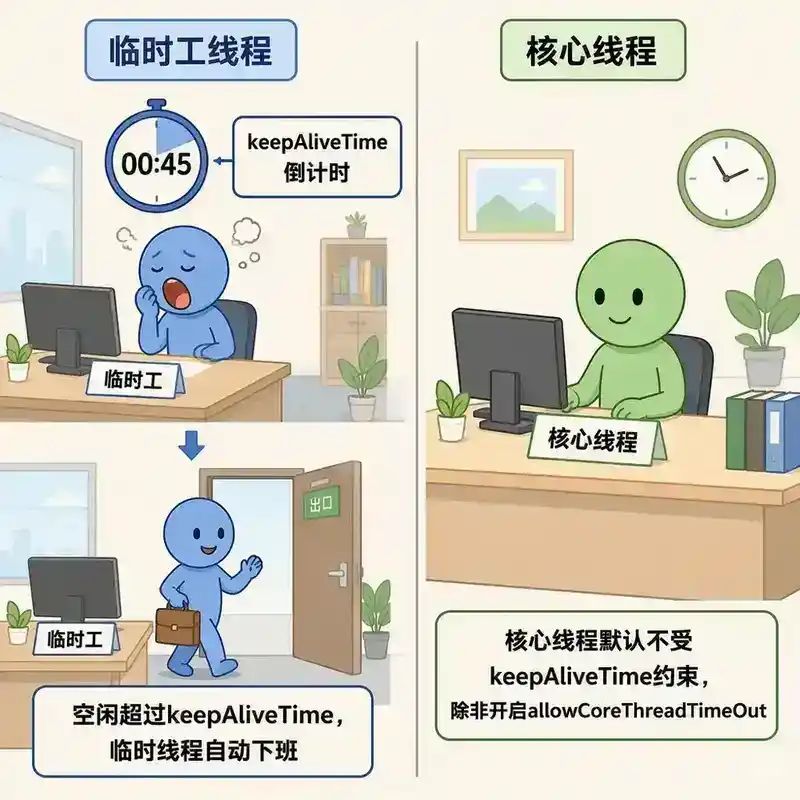
allowCoreThreadTimeOut)。 - 最大线程:这是线程池在压力大、任务堆积严重时,允许临时创建的线程数量上限,超出核心线程数量之外多创建出来的这部分线程,通常在空闲一段时间后会被自动回收,不会一直占着资源。
可以把核心线程理解成"正式员工",把超出核心线程之外、临时创建的那部分线程理解成"临时工"——正式员工数量稳定、随时待命,临时工只在业务高峰期才会被叫来帮忙,任务量恢复正常之后就会被遣散。
三、工作队列:任务在没有空闲线程时去哪里排队
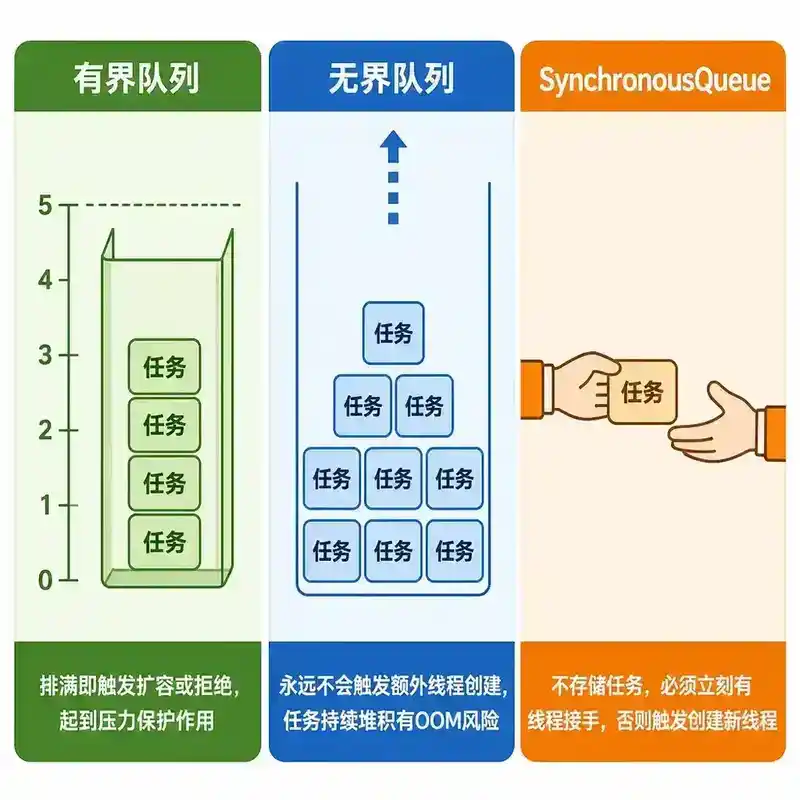
当核心线程都在忙碌、新任务还没到需要创建"临时工"(超出核心线程数)的地步时,新提交的任务会先进入 workQueue(工作队列)里排队等待。工作队列的选型直接影响线程池的行为特征,几种典型选择:
- 有界队列(比如
ArrayBlockingQueue):队列有明确的容量上限,排满之后再有新任务进来,会触发线程池尝试创建"临时工"线程(如果还没到最大线程数),或者最终触发拒绝策略。有界队列能提供一种"压力保护"——不会无限堆积任务,超出承受范围就明确地拒绝或转移压力。 - 无界队列(比如不指定容量的
LinkedBlockingQueue):理论上可以无限存放排队任务。这种配置下,只要核心线程数还够用(哪怕任务堆积很多),线程池永远不会去创建超出 corePoolSize 的额外线程——因为触发创建额外线程的条件是"队列已满",而无界队列永远不会满。这是一个非常容易被忽视的坑:配置了很大的maximumPoolSize却用了无界队列,实际上maximumPoolSize这个参数会形同虚设,任务只会在队列里越堆越多,直到内存耗尽引发 OOM。 - SynchronousQueue:这是一种特殊的队列,它本身不存储任何元素,每一次
put操作必须等到有另一个线程执行take才能完成,相当于"直接交接、不许排队"。用它作为工作队列,意味着一旦核心线程都在忙,新任务会立刻触发线程池尝试创建新线程去直接处理(而不是先排队等待),这种配置常见于需要"任务立即被处理、宁可多开线程也不愿意排队等待"的场景。
四、keepAliveTime:多余线程的"下班"时机
keepAliveTime(配合 TimeUnit 指定单位)控制的是:超出核心线程数之外的那部分线程,在空闲多长时间之后会被自动回收。这个参数默认情况下只对"临时工"线程生效——核心线程即使空闲再久,默认也会一直存活等待任务。
如果希望核心线程在空闲足够长时间之后也能被回收(比如整个应用大部分时间都很空闲,希望进一步节省资源),可以调用 allowCoreThreadTimeOut(true),这样 keepAliveTime 这个超时规则也会套用到核心线程身上,线程池甚至可能在没有任务时把所有线程都回收掉,等到有新任务时再重新创建。这个开关默认是关闭的,因为大多数场景下希望核心线程保持"随时待命"的状态,避免每次任务到来都要重新创建线程的延迟。
五、拒绝策略:线程池撑不住时该怎么办
当核心线程、工作队列、最大线程都已经饱和,还有新任务提交进来,线程池会执行拒绝策略(RejectedExecutionHandler)。JDK 内置了四种:
AbortPolicy(默认):直接抛出RejectedExecutionException异常,拒绝这个任务。CallerRunsPolicy:不抛异常,而是把这个任务交给调用者线程自己去执行——这样做的效果是一种自然的"减速带":调用者线程被迫花时间执行这个任务,暂时没法继续提交新任务,间接给了线程池喘息、消化积压任务的时间。DiscardPolicy:直接悄无声息地丢弃这个任务,不抛异常也不做任何处理——这种策略要非常小心使用,因为它会让任务"静默丢失",出问题时很难排查。DiscardOldestPolicy:丢弃工作队列里排队最久的那个任务,然后把当前这个新任务重新尝试提交——这本质上是认为"新任务比老任务更重要",但同样有丢任务的风险。
选择哪种策略取决于业务对"宁可丢任务也要保持响应"还是"任务绝不能丢、宁可报错让调用方知道"的取舍,很多严肃的生产系统会自定义拒绝策略,比如把拒绝的任务记录日志、上报监控,而不是简单套用内置的四种之一。
六、常见误区
一个经典的坑是使用 Executors 工具类里的静态工厂方法(比如 newFixedThreadPool、newCachedThreadPool)快速创建线程池,而不是自己显式地 new ThreadPoolExecutor(...) 配置每一个参数。这些静态工厂方法内部往往悄悄使用了无界队列(newFixedThreadPool 用的是无界的 LinkedBlockingQueue)或者没有上限的最大线程数(newCachedThreadPool 的 maximumPoolSize 是 Integer.MAX_VALUE),在实际生产环境的高压力场景下,很容易因为上面提到的"无界队列让 maximumPoolSize 形同虚设"或者"线程数量失控"两个问题之一而出故障。阿里巴巴 Java 开发手册明确建议不要直接使用 Executors 的静态方法,而是显式地用 ThreadPoolExecutor 构造函数,把每一个参数的取值都想清楚、写明白。
七、面试追问链
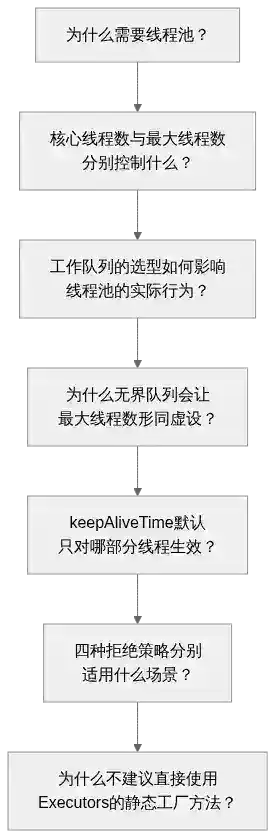
从"为什么需要线程池"出发,逐层追问:核心线程数和最大线程数分别控制什么、工作队列的选型(有界、无界、SynchronousQueue)会如何影响线程池的实际行为、为什么无界队列会让最大线程数形同虚设、keepAliveTime 默认只对哪部分线程生效、四种拒绝策略分别适用什么场景、以及为什么不建议直接使用 Executors 的静态工厂方法,这条链基本能覆盖面试官对线程池参数体系的核心考察点。
延伸阅读
java.util.concurrent.ThreadPoolExecutor源码,重点看构造函数各参数的含义与execute方法整体结构- 《阿里巴巴 Java 开发手册》中关于线程池使用规约的条目,理解为什么不推荐
Executors静态工厂方法 - 下一篇预告:线程池任务提交流程——execute 决策路径、Worker 机制与异常处理
问答(不计入阅读时长)
Q1:既然核心线程"一直存活、不会被回收",那线程池刚创建出来的时候,corePoolSize 个线程是立刻就被创建出来的吗?
A:不是。ThreadPoolExecutor 默认采用的是懒加载策略——线程池刚创建出来的时候,内部并没有任何线程被真正创建,只有当第一个任务被提交(调用 execute)时,才会创建第一个核心线程去处理它,后续每提交一个新任务,只要当前线程数还没达到 corePoolSize,就继续创建新的核心线程,直到核心线程数补满为止。如果确实需要线程池一创建就把所有核心线程提前准备好(比如启动阶段就想让线程"预热"完毕),可以显式调用 prestartAllCoreThreads()(或者 prestartCoreThread() 逐个预启动),这是一个主动选择,而不是默认行为。
Q2:任务提交给线程池之后,**execute**内部大致是按什么顺序去判断"该不该创建新线程、该不该排队、该不该拒绝"的?
A:大致遵循一个三段式的判断顺序:第一步,如果当前线程数还没达到 corePoolSize,直接创建一个新的核心线程来执行这个任务(哪怕当前有其他线程处于空闲状态,也会优先创建新核心线程,而不是塞进队列);第二步,如果核心线程已经补满,就尝试把任务放进工作队列排队;如果放入队列成功,就等着某个空闲线程来取;第三步,如果工作队列已经放不进去了(满了,或者用的是 SynchronousQueue 这种不存储任务的队列),就尝试创建一个超出核心线程数的"临时"线程去直接处理这个任务,前提是当前线程数还没达到 maximumPoolSize;如果连这一步都不行(线程数已经到达上限),才会真正触发拒绝策略。这条链路里有一个容易被忽略的细节:线程池"优先创建核心线程,其次才排队",但"优先排队,最后才创建临时线程"——两个阶段对"创建线程"和"排队"的优先级顺序是相反的,这也是为什么工作队列的选型会直接决定线程池到底会不会用到 maximumPoolSize 这部分容量。
Q3:文章里提到无界队列会让 maximumPoolSize 形同虚设,那如果非要用无界队列,又不想任务无限堆积,还有没有别的手段?
A:有几种常见的思路。一种是给无界队列本身加一层业务级别的容量控制,比如在提交任务之前先检查队列当前的排队长度(ThreadPoolExecutor 提供了 getQueue().size() 这样的方法),超过一个阈值就在业务层主动降级或者拒绝,而不是无脑往下丢。另一种是改用有界队列并配合 CallerRunsPolicy 这样的拒绝策略,让队列满了之后自然地把压力传导回调用方,形成天然的限流效果。还有一种更彻底的思路是不依赖线程池内部的排队机制,而是在业务入口处就用限流组件(比如信号量、令牌桶)控制提交速率,让线程池本身始终工作在一个可预期的负载区间内,不依赖它内部的队列去兜底压力。核心思路都是一样的:队列的排队能力不应该被当作无限的缓冲区来使用,队列越"能装",问题暴露得越晚、越隐蔽。
Q4:keepAliveTime 只对超出核心线程数的部分线程生效,那这个"回收"具体是怎么发生的,是有一个专门的定时器线程在巡检吗?
A:不是靠额外的定时器线程巡检,而是每个工作线程自己在从队列里取任务时,用带超时的取值方式实现的。线程池的工作线程内部有一个循环:不断地从工作队列里取任务来执行;当线程数量超过 corePoolSize 时,这些"临时"线程从队列取任务用的是带超时参数的 poll(keepAliveTime, unit),而不是无限等待的 take()——如果在 keepAliveTime 这么长时间内一直没有等到新任务,poll 就会返回 null,线程发现取不到任务,就会自己判断"我这轮空闲已经超时了",主动结束自己的运行循环、退出。核心线程默认走的是不带超时的 take(),所以会一直阻塞等待,不会因为等待超时而退出——这也解释了为什么 keepAliveTime 默认不影响核心线程:不是有什么特殊豁免规则,而是核心线程压根没有走那条"限时等待"的代码路径。
Q5:四种内置拒绝策略里,DiscardPolicy 和 DiscardOldestPolicy 都会丢任务,实际生产中真的有人会用这两种吗?
A:会用,但使用场景比较特殊,通常是"任务本身允许丢失、且丢失的代价远小于阻塞或者报错的代价"的场景。比如某些监控指标采集、非关键的日志采样上报场景——如果某一次采样点因为线程池繁忙没有被处理,少这一个点位并不影响整体监控趋势的判断,用 DiscardPolicy 悄悄丢掉即可,没必要为了保住这一次采样让调用线程阻塞或者抛异常影响主流程。DiscardOldestPolicy 则更适合"新数据比老数据更有价值"的场景,比如某些实时性要求很高的状态更新,队列里排得越久的旧状态越没有意义,丢弃它给新状态腾位置反而是合理的。但这两种策略共同的风险是:如果业务场景判断错了,丢任务会在很长一段时间内被悄悄忽略,往往是等到下游数据缺失或者对账出问题时才被发现,所以真正在生产中使用这两种策略时,几乎都会配合监控埋点,在丢弃发生的那一刻主动上报一次计数或者日志,而不是让默认的"静默丢弃"行为原封不动地生效。
Q6:**newFixedThreadPool**和自己手写一个**corePoolSize**等于**maximumPoolSize**、用无界队列的**ThreadPoolExecutor**,是完全一样的东西吗?
A:从核心参数上说,newFixedThreadPool(n) 内部确实就是构造了一个 corePoolSize 和 maximumPoolSize 都等于 n、使用无界 LinkedBlockingQueue 的 ThreadPoolExecutor,所以直接自己手写一个参数完全对齐的 ThreadPoolExecutor,运行时行为跟它是一样的。真正的区别不在于运行时行为,而在于**"默认配置是否清晰可见"——用**Executors.newFixedThreadPool**这种工厂方法,无界队列这个关键细节被隐藏在方法名背后,很多人只看到"固定大小的线程池"这几个字就直接用了,根本没意识到背后配的是一个没有容量上限的队列;而自己显式**new ThreadPoolExecutor(n, n, ..., new LinkedBlockingQueue<>())**,队列的选择是摆在代码里明明白白的一行参数,写代码和做 Review 的人都会被迫正视这个选择。这也是为什么说"不建议直接用 Executors 静态方法"更多是一个工程可读性和风险意识**的问题,而不是说这些方法背后的实现本身有 bug。
Q7:文章里说核心线程默认"一直存活",那如果整个应用长期空闲、没有任务提交,这些核心线程会一直占用系统资源吗?
A:会,这正是"核心线程默认不受 keepAliveTime 约束"这个设计带来的直接代价——即使线程一直没有任务执行,处于阻塞等待状态(take() 阻塞),操作系统层面分配给它的线程栈内存等资源依然是被占用着的,不会被释放。这在大多数业务场景下是可以接受的权衡:用一定的常驻资源占用,换取"任务一来就能立刻被处理、不需要重新创建线程"的响应速度。但如果确实是那种"绝大多数时间都空闲、只是偶尔有任务"的场景,并且更在意资源占用而不是响应速度,可以通过 allowCoreThreadTimeOut(true) 让核心线程也应用 keepAliveTime 规则,这样长期空闲时线程池甚至可以把所有线程都回收掉,等到真正有任务到来时再重新创建——这也印证了 allowCoreThreadTimeOut 这个开关本质上是在"响应速度"和"资源占用"这两个目标之间做取舍,没有绝对正确的默认值,只有适不适合当前业务场景。
Q8:线程池里某个任务执行的时候抛出了未捕获的异常,这个线程会怎么样?会不会导致这个工作线程从此"消失",线程池实际可用的线程数悄悄变少?
A:这是一个非常容易被忽略、也确实会导致"线程池可用线程数悄悄变少"的经典坑。如果通过 execute() 提交的 Runnable 在执行过程中抛出了未被内部捕获的运行时异常,这个异常会导致当前工作线程的执行循环直接终止、这个线程真正结束运行,线程池会检测到这个线程"意外死亡",重新创建一个新的线程来补充,从数量上看似乎线程池"自动修复"了,但如果处理不当(比如没有任何日志、没有任何监控告警),这个异常会在完全无声无息的情况下发生,只有等到线程池行为异常(比如吞吐量下降、任务处理变慢)时才可能被发现,排查起来非常困难。相比之下,如果是通过 submit() 提交的 Callable(返回 Future),任务内部抛出的异常会被封装进 Future 对象里,只有在调用 future.get() 时才会以 ExecutionException 的形式重新抛出来——这也是为什么很多团队会约定:通过线程池执行的任务内部必须自己做好异常捕获和日志记录,不能依赖线程池"兜底"处理异常,因为默认行为在这两种提交方式下的表现都不直观,且都有信息丢失或延迟发现的风险。