一、三个经常被混为一谈、但本质不同的问题
多线程编程里,"程序卡住不动了"是最让人头疼的故障现象之一,但"卡住"背后至少对应三种完全不同的机制:死锁(deadlock)、活锁(livelock)、饥饿(starvation)。它们的共同点是"该往前推进的线程没能推进",区别在于线程当时到底在做什么:
- 死锁:涉及的线程全部处于阻塞状态,一个都没有在运行,彼此互相等着对方释放资源,形成了一个谁也无法打破的等待环——线程本身是"静止"的。
- 活锁:涉及的线程都在正常运行、都在做事,CPU 占用率可能还很高,但它们反复做的事情互相抵消,整体状态没有任何净推进——线程是"动"的,但在原地打转。
- 饥饿:某个(或某些)线程长期甚至永久拿不到它需要的资源(CPU 时间片、锁、连接等),而系统里其他线程都在正常运转——问题只发生在被饿死的那一个线程身上,不是全局性的卡死。
这篇把这三个问题分别讲清楚:死锁的产生条件、常见检测手段、几种主流规避思路;活锁和饥饿各自的典型场景以及对应的解决办法;最后给出一张对照表,帮助在遇到"线程好像卡住了"这种笼统症状时,快速判断自己面对的到底是哪一种。
二、死锁:四个条件同时满足才会发生
死锁的经典定义来自操作系统教科书,成立需要同时满足四个必要条件(Coffman 条件),缺一个都不会死锁:
- 互斥条件(Mutual Exclusion):资源一次只能被一个线程持有,比如一把锁同一时刻只能有一个线程拿到。
- 请求与保持条件(Hold and Wait):线程已经持有了至少一个资源,同时又在申请其他被别的线程占用的资源,并且在等待期间不释放已经持有的资源。
- 不可抢占条件(No Preemption):资源只能由持有它的线程主动释放,其他线程或系统不能强行把资源抢走。
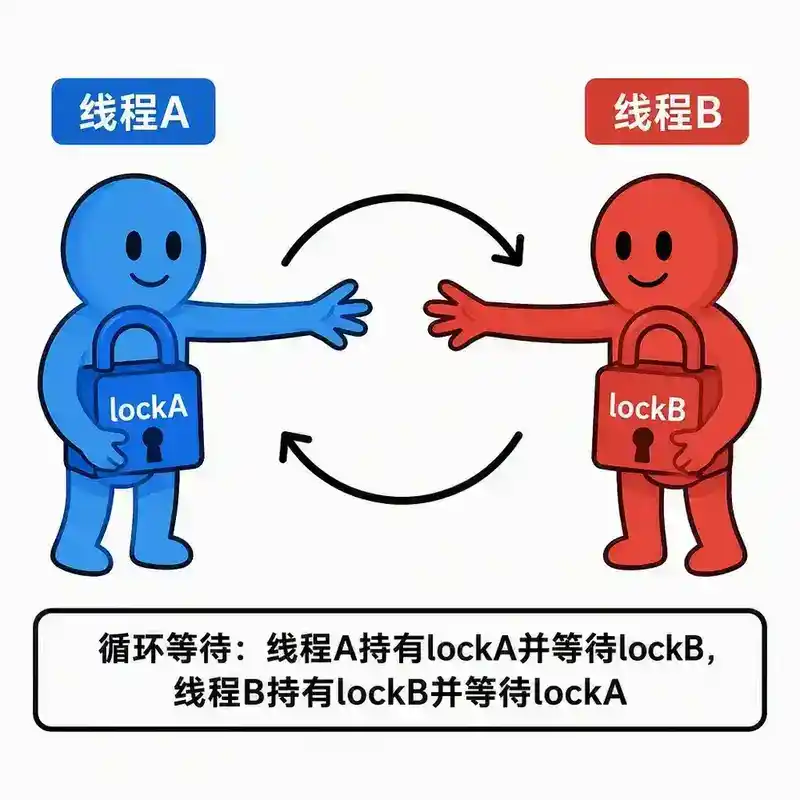
- 循环等待条件(Circular Wait):存在一个线程等待链 T1 等待 T2 持有的资源,T2 等待 T3 持有的资源……最后 Tn 又等待 T1 持有的资源,形成一个闭环。
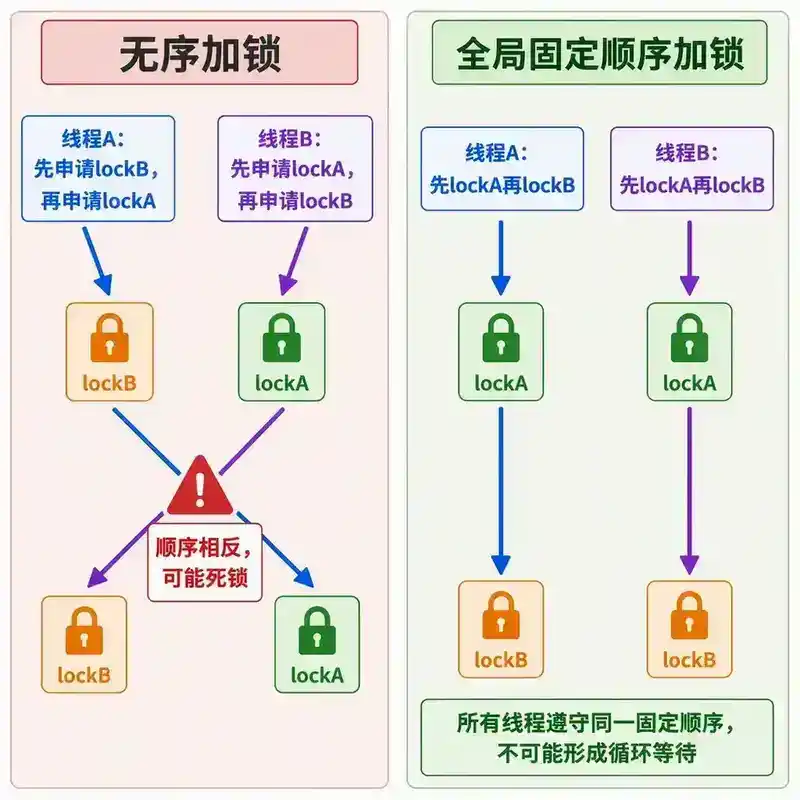
最经典的死锁代码模式是"两个线程以不同顺序申请同一对锁":
// 线程A
synchronized (lockA) {
    synchronized (lockB) { /* ... */ }
}
// 线程B
synchronized (lockB) {
    synchronized (lockA) { /* ... */ }
}
如果线程 A 刚拿到 lockA 还没拿到 lockB,同时线程 B 刚拿到 lockB 还没拿到 lockA,两者就会永远互相等待——这正好同时满足了上面四个条件:synchronized 天然互斥;两个线程都持有一把锁的同时在申请另一把(请求与保持);synchronized 锁不会被外力强行剥夺(不可抢占);A 等 B、B 等 A 形成了长度为 2 的循环等待。
三、死锁怎么被发现:从 jstack 到等待图算法
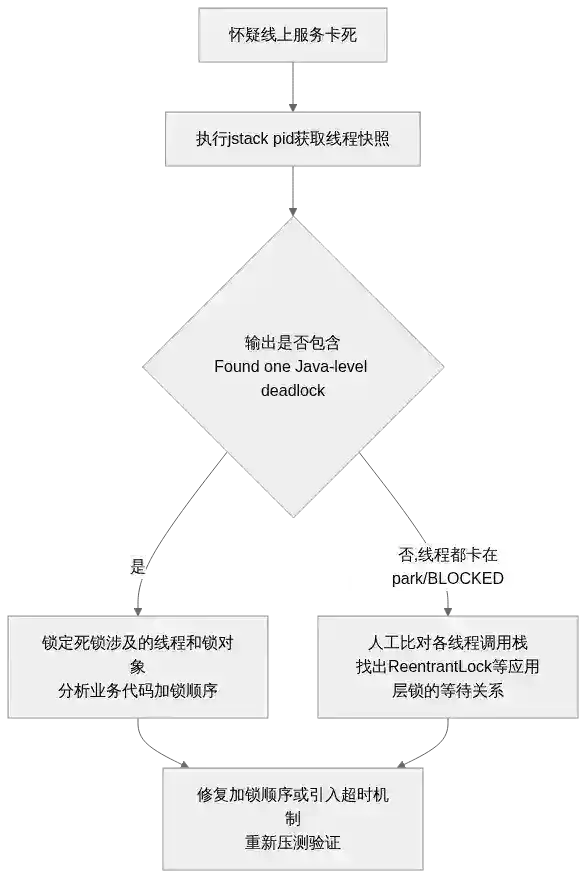
死锁一旦真的发生,涉及的线程会永久卡在 BLOCKED 状态(如果用的是 synchronized)或者 WAITING/TIMED_WAITING(如果用的是 Lock.lock() 且没有设超时)。排查死锁最直接的工具是 JVM 自带的线程栈快照:
**jstack <pid>**:会打印所有线程的调用栈,JVM 内置了针对synchronized锁的死锁检测算法,如果检测到死锁会在输出末尾直接给出一段Found one Java-level deadlock的报告,列出哪些线程互相等待哪些锁,非常直观。**jconsole**/**VisualVM**的线程面板:图形化地展示每个线程的状态,对于synchronized造成的死锁同样能自动识别并高亮显示。- 对基于
**ReentrantLock**/**Lock**接口的死锁:JVM 内置检测只覆盖synchronized关键字对应的 Monitor 锁,ReentrantLock属于应用层实现的锁,JVM 层面看不到"谁在等谁"的语义,jstack通常只能看到线程卡在park()上,不会自动给出死锁报告,需要人工根据每个线程的调用栈和它们持有/等待的锁对象手动比对,或者借助 APM 工具(比如 Arthas 的thread -b命令)辅助定位。
理论层面,死锁检测的标准算法是构造一张资源分配图(Resource Allocation Graph):线程节点指向它请求的资源节点,资源节点指向持有它的线程节点。图里出现环,就意味着存在死锁的可能(对单实例资源,有环即死锁;对多实例资源,还需要结合可用资源数量做更精细的判断,即银行家算法里用到的安全序列检测)。jstack 报出的"Found one Java-level deadlock"本质就是 JVM 在运行时维护的锁持有关系图上做了这样一次环检测。
四、死锁规避:破坏四个条件中的任意一个
因为死锁需要四个条件同时满足,规避思路自然就是想办法让其中一个条件不成立。互斥条件通常是业务本身要求的、不能随意去掉,实践中最常用的是围绕另外三个条件的三类做法:
破坏循环等待——固定加锁顺序:给系统里所有的锁对象定义一个全局的获取顺序(比如按锁对象的 hashCode 或者一个显式编号排序),所有线程申请多把锁时都必须按这个固定顺序申请。只要顺序是全局一致的,就不可能出现循环等待——因为循环意味着链条上一定存在两个方向相反的申请顺序。这是工程实践中最常用、成本最低的手段。
破坏不可抢占——使用带超时的锁:ReentrantLock 提供了 tryLock(timeout, unit),如果在超时时间内没能拿到锁就主动放弃并释放已经持有的其他锁,退避一段随机时间后重试。这样即使短暂出现了循环等待的迹象,也会在超时后被打破,不会无限期僵持下去——代价是需要在业务代码里正确处理"没拿到锁怎么办"的重试逻辑,比 synchronized 复杂。
破坏请求与保持——一次性申请所有需要的资源:如果一个操作需要同时用到多把锁,尽量设计成"一次性尝试获取全部锁,任何一把没拿到就全部释放已拿到的锁",而不是拿一把、干点活、再去申请下一把。这样就不存在"持有着一部分资源、同时还在等另一部分资源"的状态。这种方式对代码结构要求更高,通常出现在数据库事务、分布式锁等对一致性要求严格的场景。
五、活锁:都在忙,但谁也没有前进
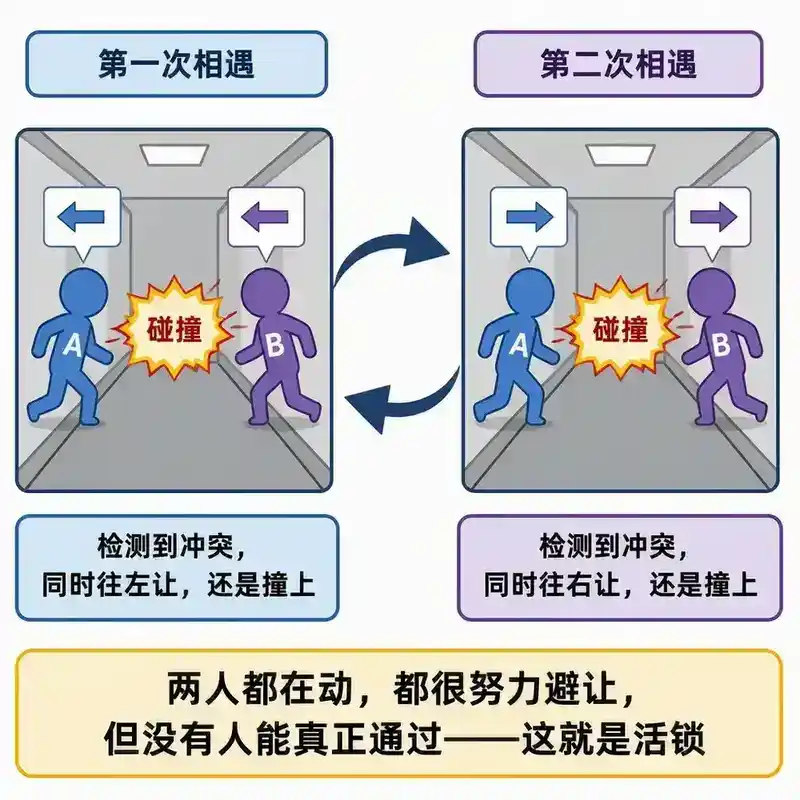
活锁和死锁最大的区别是:涉及的线程没有阻塞,它们都在正常地执行代码、消耗 CPU,只是它们各自的响应策略互相冲突,导致整体状态在原地反复循环,没有任何一方能真正完成自己的操作。
一个经典的类比是两个人在狭窄的走廊里面对面走过来,两人都很有礼貌地想给对方让路,同时往同一侧闪身,结果还是撞在一起;于是两人又同时往另一侧闪,还是撞在一起……如果两人的"让路策略"完全一致(比如都遵循"往对方让的反方向让"这条规则),这个过程会无限重复下去,谁都过不去,但两人确确实实一直在动。
代码里最容易出现活锁的场景是"检测到冲突就主动退让、然后重试"这类逻辑,如果多个线程的重试节奏高度同步(比如所有线程都在检测到失败后立即重试,没有任何随机性),就可能陷入"大家同时退让、同时重试、又同时冲突"的循环。典型例子是两个线程各自持有一把锁,检测到对方也在等待时,都主动释放自己手里的锁想避免死锁,然后立刻重新尝试获取——如果两者的重试时机总是恰好同步,就会变成活锁而不是死锁:表面上"更礼貌",结果却是永远无法都成功。
规避活锁的核心思路是打破这种"同步性":给重试逻辑加入随机化的退避时间(类似网络协议里的指数退避加随机抖动),让各个线程的重试节奏错开,大概率不会一直保持同步冲突。这也是为什么很多重试机制的最佳实践都强调"退避时间要加随机抖动,不能是固定值"。
六、饥饿:一直排队,永远轮不到
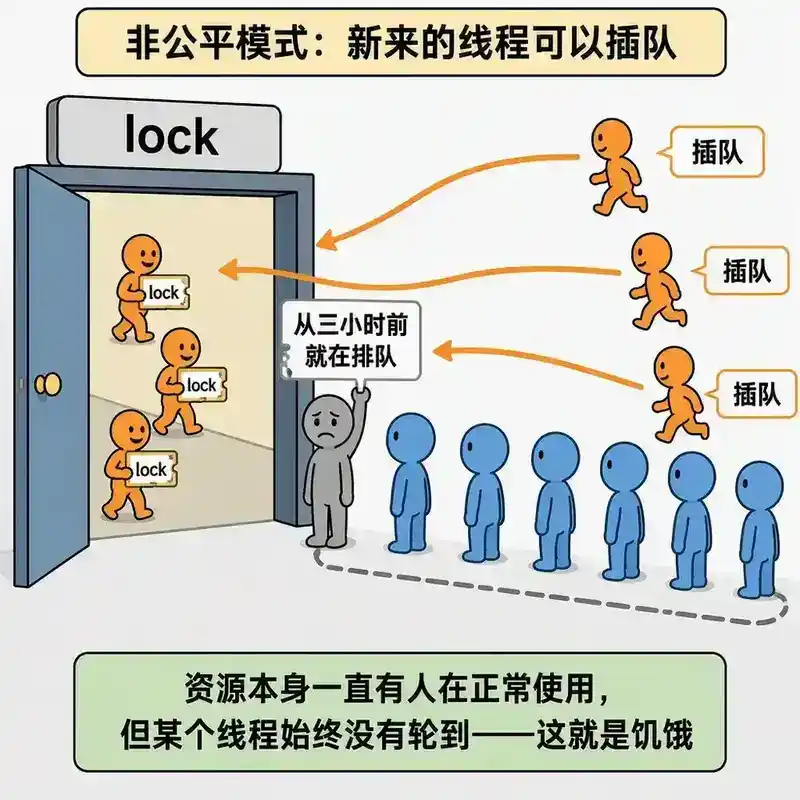
饥饿指的是某个线程持续无法获得它需要的资源,尽管资源本身在被系统里的其他线程正常使用。饥饿不要求"循环等待"这种结构性条件,通常是调度策略或资源分配策略本身"不公平"造成的:
- 线程优先级设置不当:Java 线程支持设置优先级(
Thread.setPriority()),如果某些线程被设置了很低的优先级,在高优先级线程持续繁忙的系统里,低优先级线程可能长期得不到 CPU 时间片。不过现代操作系统的调度器大多做了老化(aging)机制防止无限饥饿,实践中因为优先级导致的饥饿相对少见。 - 非公平锁下的运气不好:
ReentrantLock/Semaphore默认是非公平模式,允许新来的线程"插队"抢到刚释放的锁或许可证。理论上,如果系统里持续有新线程源源不断地插队,某个运气不好、一直排在队列中间的线程可能长期抢不到锁——这不是必然发生,但非公平模式确实放弃了"先来先得"的保证,把这种极端情况的可能性留在了理论层面。 - 持锁时间不均衡:如果某些线程习惯持有锁的时间很长(比如在临界区里做了耗时的 I/O),会显著压缩其他线程获取锁的机会窗口,长期下来容易造成事实上的饥饿现象。
规避饥饿的常见做法:优先级设置上避免设置过于极端的低优先级;对公平性要求较高的场景显式使用公平锁/公平信号量(牺牲一些吞吐量换取"先来先得"的保证);从设计上尽量缩短临界区、减少持锁时间,让锁的周转速度更快,降低任何单个线程被"卡住不放"影响其他线程的概率。
七、三者对照:怎么快速判断自己遇到的是哪一种
线上遇到"响应变慢""请求堆积"的现象时,可以按下面的思路快速定位:
- 先看涉及的线程是否处于阻塞状态(
BLOCKED/WAITING):如果是,且能画出一个互相等待的闭环,是死锁;用jstack基本能确认。 - 如果线程 CPU 占用率不低、看起来一直在运行,但业务指标(比如请求处理完成数)长期没有任何增长,很可能是活锁;需要结合业务日志看是否存在"检测冲突就退让重试"的模式,以及重试节奏是否缺乏随机性。
- 如果只是某一个或者某一小部分线程长期得不到资源,而系统整体其他部分运转正常,是饥饿;重点排查是否用了非公平锁、优先级设置是否合理、是否有持锁时间过长的"大户"线程。
八、面试追问链
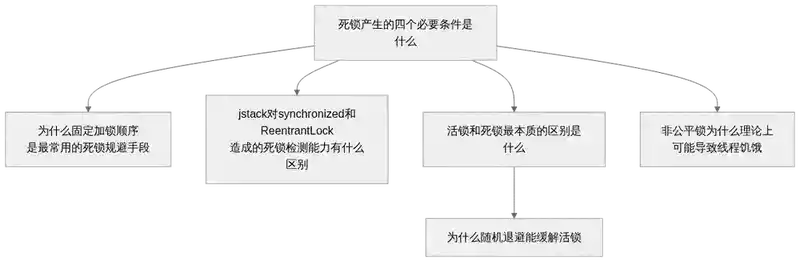
从"死锁产生的四个必要条件是什么"这个基础问题出发,逐层追问:为什么破坏循环等待(固定加锁顺序)是工程上最常用的死锁规避手段、jstack 对 synchronized 和 ReentrantLock 造成的死锁检测能力有什么区别、活锁和死锁最本质的区别是什么、为什么给重试逻辑加入随机退避能缓解活锁、以及非公平锁为什么理论上可能导致某个线程饥饿而公平锁不会,这条链基本覆盖了面试官在这个话题上的核心考察点。
延伸阅读
- 操作系统教科书中关于死锁的银行家算法(Banker's Algorithm),理解多实例资源场景下更精细的死锁避免策略
- JDK 并发包中
ReentrantLock/Semaphore公平模式的源码实现,理解公平队列具体是怎么保证"先来先得"的 - 下一篇预告:虚拟线程(Project Loom):调度模型、pinning、适用场景与平台线程对比
问答(不计入阅读时长)
Q1:死锁的四个必要条件,能不能只满足三个就发生死锁?
A:不能。互斥、请求与保持、不可抢占、循环等待这四个条件必须同时满足才会真正死锁,缺少任何一个都不会。比如去掉循环等待条件(比如通过固定加锁顺序),即使其他三个条件都在,也不会形成死锁——因为不存在一个闭环的等待链。这也是为什么几乎所有死锁规避手段的思路都是"专门破坏其中一个条件",而不是想办法同时对付四个。
Q2:为什么破坏循环等待(固定加锁顺序)是工程上最常用的死锁规避手段,而不是破坏不可抢占或请求与保持?
A:因为固定加锁顺序的改造成本最低,而且是纯粹的编码规范问题,不需要改变锁本身的语义。破坏不可抢占(用 tryLock(timeout))需要在业务代码里额外处理"没拿到锁怎么办"的重试/回滚逻辑,增加了代码复杂度;破坏请求与保持(一次性申请所有资源)对代码结构的侵入性更大,往往需要重新设计临界区的边界。相比之下,只要给锁排好序、约定"谁都得按这个顺序申请",不需要改动任何加锁/解锁的语义,是性价比最高的方案,所以成了工程实践里的默认选择。
Q3:**jstack**对**synchronized**和**ReentrantLock**造成的死锁,检测能力有什么区别?
A:synchronized 对应的是 JVM 内置的 Monitor 锁,JVM 运行时本身就维护着"谁持有哪个锁、谁在等哪个锁"的完整信息,所以 jstack 能在这份信息上直接跑环检测算法,一旦发现死锁就会在输出里打印一段明确的 Found one Java-level deadlock 报告。而 ReentrantLock 是纯 Java 代码实现的应用层锁,JVM 并不理解它的加锁语义,jstack 只能看到线程卡在 park()(AQS 内部用 LockSupport.park 阻塞线程),看不出这次 park 到底是在等谁的锁——所以不会给出死锁报告,需要工程师根据每个线程调用栈里持有和等待的锁对象手动比对,或者借助 Arthas 等工具辅助分析。
Q4:活锁和死锁最本质的区别是什么?只看 CPU 占用率能不能区分两者?
A:最本质的区别在于线程是否处于阻塞状态。死锁涉及的线程全部停在 BLOCKED/WAITING,一行代码都没有在执行,CPU 占用通常很低;活锁涉及的线程一直在正常运行、反复做退让和重试的动作,CPU 占用可能持续偏高,但业务层面的有效进度(比如请求处理完成数)长期不增长。所以看 CPU 占用率确实是一个有效的初步区分信号:CPU 空闲、线程卡在阻塞状态,倾向于死锁;CPU 持续繁忙但吞吐量不涨,倾向于活锁。确诊还是要结合 jstack 看线程状态,以及业务日志看是否存在"检测冲突就退让重试"的模式。
Q5:为什么给重试逻辑加入随机退避能缓解活锁,加一个固定的等待时间不行吗?
A:活锁的根源是多个线程的重试节奏高度同步——大家在完全相同的时机检测到冲突、退让、重试,于是又在完全相同的时机再次冲突。如果退避时间是固定值,这种同步性完全不会被打破:所有线程还是会在同一时刻醒来重试,循环照样发生。随机化退避(尤其是指数退避加随机抖动)的作用是让各个线程的重试时机错开,几乎不可能所有线程在同一时刻醒来,从而大概率打破这种同步冲突的循环。这也是为什么网络协议(比如以太网的 CSMA/CD)和分布式系统的重试机制几乎都会强调"退避要加随机抖动"。
Q6:非公平锁为什么理论上可能导致线程饥饿?既然是"理论上",实践中要不要因此就一律换成公平锁?
A:非公平锁允许新来的线程直接尝试抢占刚释放的锁,而不必排到等待队列末尾,这意味着如果系统里持续有新线程源源不断地插队成功,某个运气不好、一直排在队列中间的线程理论上可能永远抢不到——这是"理论上可能"而非"一定发生",需要一种持续不断插队的极端负载模式才会明显表现出来。实践中并不建议一律切换成公平锁,因为公平锁为了维护严格的先来先得顺序,需要频繁地进行线程切换和排队管理,吞吐量通常明显低于非公平锁。多数场景下非公平锁带来的吞吐收益远大于饥饿风险,只有在业务上确实要求"绝对不能有请求被无限期插队"的场景(比如某些计费、审批类的强顺序场景),才值得为了公平性牺牲吞吐量。
Q7:如果一个操作需要同时持有多把锁,除了固定加锁顺序,还有没有办法从根本上避免死锁?
A:有,思路是"一次性申请所有需要的资源"(对应破坏请求与保持条件):把原来"拿一把锁、做点事、再去申请下一把锁"的模式,改造成"先尝试把这次操作需要的所有锁都拿到手,任何一把没拿到就把已经拿到的全部释放,然后重试",这样就不存在"手里已经攥着一部分资源、同时还在等另一部分资源"的中间状态。这种做法对代码结构的要求比固定加锁顺序高很多,通常只在对一致性要求很严格的场景(比如数据库事务、分布式锁的批量获取)才会专门这样设计,日常业务代码里固定加锁顺序足够应付绝大多数情况。
Q8:饥饿和死锁都表现为"某些操作一直卡着",线上排查时怎么快速判断到底是哪一种?
A:核心是看受影响的范围和涉及线程的状态。死锁是结构性的、全局的:涉及的那几个线程会全部卡在 BLOCKED/WAITING,用 jstack 几乎能立刻确认,而且死锁一旦发生,那几个线程会永久卡住,不会自己恢复。饥饿是局部的、统计性的:只是某一个或某一小部分线程持续得不到资源,系统里其他线程都在正常运转,用 jstack 看这些"饿死"的线程往往并不是卡在某个固定的阻塞点,而是反复处于"尝试获取锁—短暂等待—再尝试"的状态,需要结合监控指标(比如某个线程的任务完成频率明显低于其他同类线程)才能确认,而不是靠一次线程快照就能一眼看出。