一、为什么要把 volatile 单独拎出来讲
前两篇分别讲了 JMM 定义的可见性/有序性/原子性问题,以及 happens-before 规则里"volatile 变量规则"这一条——对一个 volatile 变量的写操作 happens-before 后续对它的读操作。这一篇要往下再深一层:volatile 到底是怎么在底层实现这条规则的? 只停留在"volatile 能保证可见性和有序性,不保证原子性"这个结论上是不够的,面试官往下追问一句"它是怎么做到可见性的""内存屏障具体插在哪",很多人就说不清楚了。这一篇把这几层都讲透。
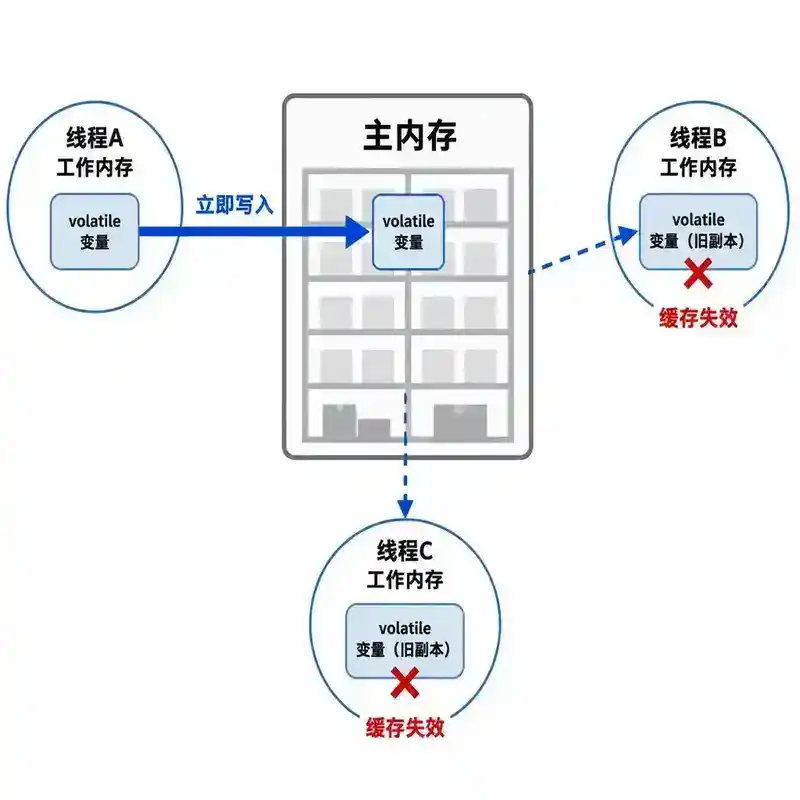
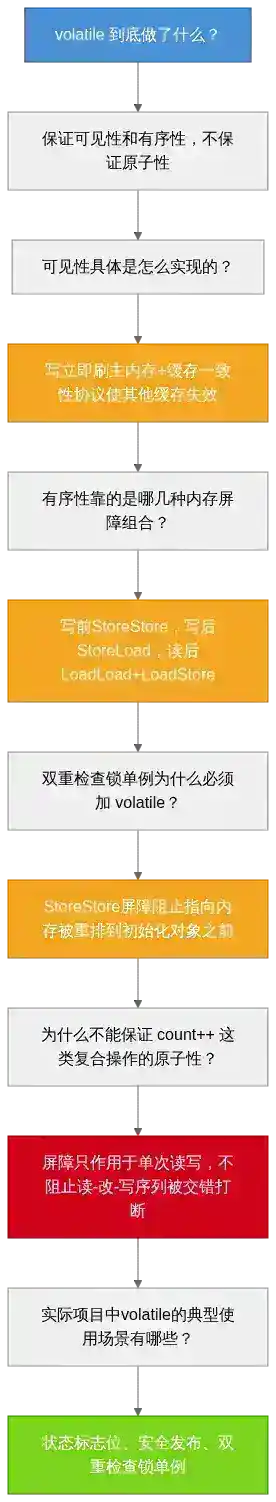
二、可见性保证:写操作如何"穿透"到主内存
一个变量被 volatile 修饰之后,编译器和运行时会区别对待它的每一次读写:
- 写操作:线程对 volatile 变量的修改,会在写完之后立即同步刷新到主内存,而不是像普通变量那样可能只停留在当前线程的工作内存(CPU 缓存)里等待某个不确定的时机才刷回去。
- 读操作:线程读取 volatile 变量时,会强制从主内存重新加载最新值,而不是直接使用自己工作内存里可能已经过期的缓存副本。
再往底层看一层,现代 CPU 通常通过缓存一致性协议(比较典型的是 MESI 协议)来保证多核之间的缓存同步:当一个核心修改了某个被其他核心缓存的内存地址时,会通过总线通知其他核心把自己的缓存行标记为失效(Invalid),其他核心下次读取时就必须重新从主存或其他核心同步最新值。volatile 的可见性保证,正是建立在这套硬件级的缓存一致性机制之上——JVM 通过插入特定的内存屏障指令,触发处理器执行这套协议,而不是自己凭空实现了一套可见性方案。
三、有序性保证:内存屏障插在哪里
要理解 volatile 如何保证有序性,先要知道重排序有四种基本类型,按"前一个操作类型-后一个操作类型"命名:
- LoadLoad:两个读操作之间的重排序
- LoadStore:读操作和它后面的写操作之间的重排序
- StoreStore:两个写操作之间的重排序
- StoreLoad:写操作和它后面的读操作之间的重排序
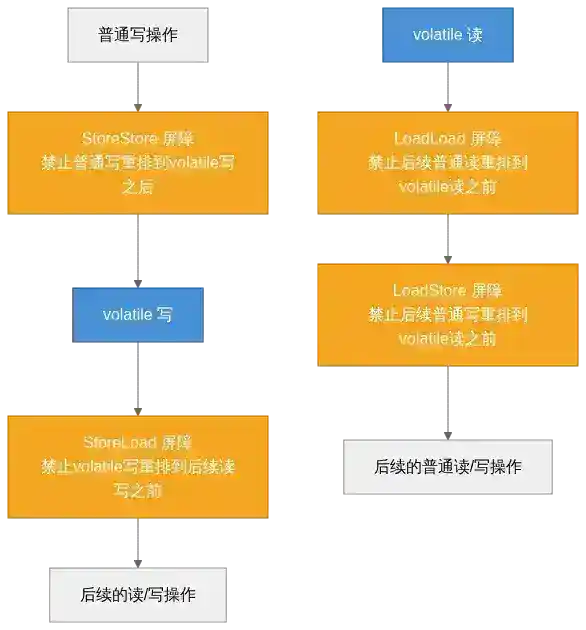
JMM 为 volatile 变量的读写规定了明确的内存屏障插入规则:
- 在每个 volatile 写操作之前,插入一个 StoreStore 屏障——确保在它之前的普通写操作,不会被重排序到 volatile 写之后。
- 在每个 volatile 写操作之后,插入一个 StoreLoad 屏障——确保这次 volatile 写操作不会被重排序到它后面的读写操作之后。
- 在每个 volatile 读操作之后,插入一个 LoadLoad 屏障——确保在它之后的普通读操作,不会被重排序到 volatile 读之前。
- 在每个 volatile 读操作之后,再插入一个 LoadStore 屏障——确保在它之后的普通写操作,不会被重排序到 volatile 读之前。
这套组合规则保证了:volatile 写操作之前的所有修改,不会被重排序到写操作之后才生效;volatile 读操作之后的所有操作,不会被重排序到读操作之前发生。换句话说,volatile 变量的读写就像一道"栅栏",把它前后的普通操作分隔在两侧,禁止跨越栅栏的重排序——这正是它能实现 happens-before 语义的底层机制。
四、双重检查锁单例:内存屏障如何堵住那个漏洞
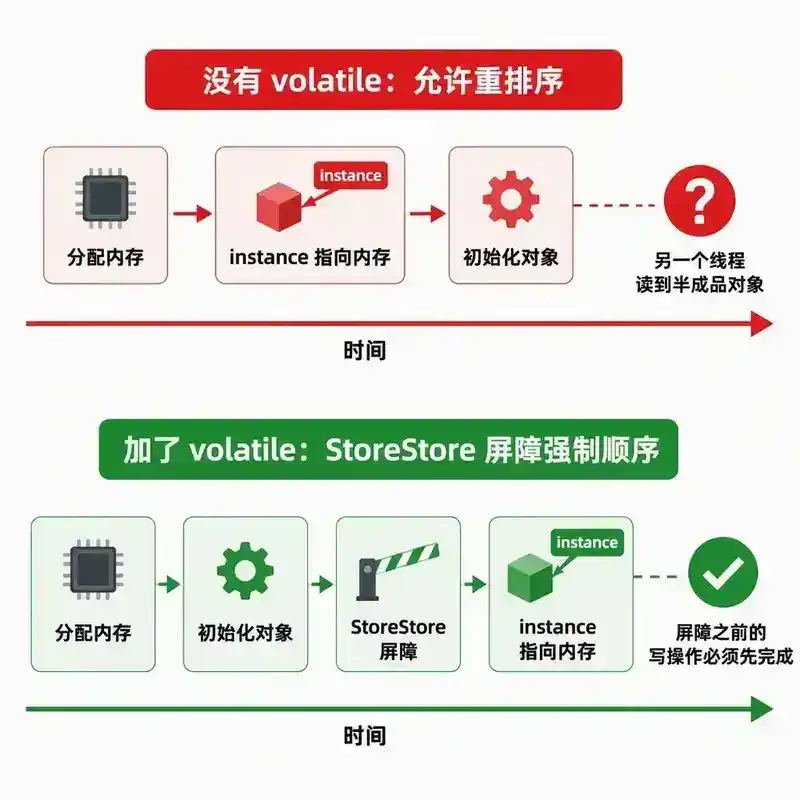
上一篇讲 JMM 时提到过双重检查锁单例模式的重排序陷阱:instance = new Singleton() 底层拆解成"分配内存→初始化对象→instance 指向内存"三步,如果没有 volatile,第二步和第三步可能被重排序,导致另一个线程读到一个指向未初始化完成对象的非空引用。
有了上面内存屏障的知识,现在可以精确解释 volatile 是怎么堵住这个漏洞的:给 instance 加上 volatile 之后,"instance 指向内存"这一步本身就是一次 volatile 写操作,它前面会被插入 StoreStore 屏障。这道屏障强制要求"初始化对象"这一步(一次普通写)必须在"instance 指向内存"(volatile 写)之前完成,不允许重排序到它后面——从根本上保证了任何线程看到 instance 非空的那一刻,指向的对象一定已经初始化完成。
五、volatile 为什么不能保证原子性
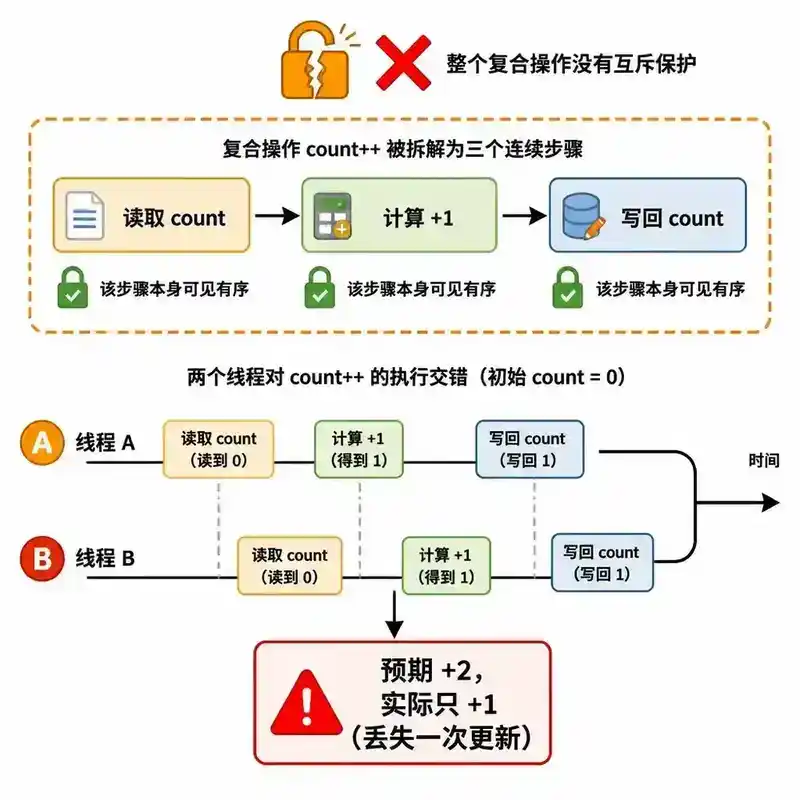
即使理解了上面这套可见性和有序性机制,也要清楚它们解决的问题和原子性是两个维度:可见性和有序性保证的是"一次独立的读或写操作,其结果何时被其他线程感知、顺序是否被打乱",而原子性保证的是"一个复合操作(比如读-改-写三步组成的 count++)在执行过程中不会被其他线程的操作插入进来打断"。
volatile 的内存屏障只作用于单次读或单次写这两个动作本身,对"读取旧值、计算新值、写回新值"这一整个过程不提供任何互斥保护。所以两个线程完全可能同时读到同一个旧值,各自计算出同样的新值,再各自写回——这个过程中屏障保证了每一次单独的读、写都是可见且有序的,但完全没有阻止两个线程的读-改-写序列相互交错。这也是为什么 volatile long count 上执行 count++ 依然会丢更新,必须换成 synchronized、Lock 或者基于 CAS 的 AtomicLong 才能保证整个复合操作的原子性。
六、什么场景该用 volatile,什么场景不该用
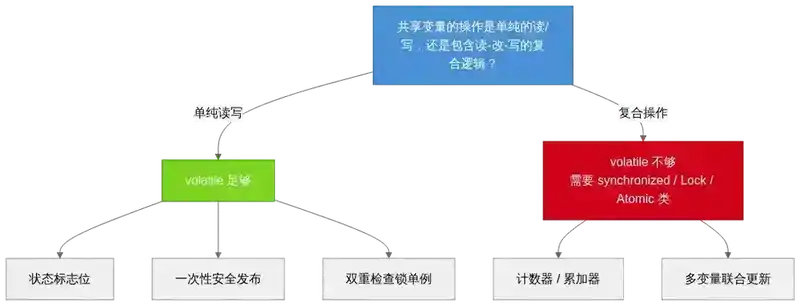
结合以上原理,可以给出一个清晰的判断标准:
适合用 volatile 的场景:
- 状态标志位:比如一个
boolean running用来控制线程循环退出,只有单纯的写和读,没有复合操作。 - 一次性安全发布:结合 happens-before 的传递性,用一个 volatile 标志位保护一批在它之前完成的普通变量写入(比如配置对象的一次性初始化)。
- 双重检查锁单例:如上文所述,专门用来堵住指令重排序漏洞。
不适合只用 volatile 的场景:
- 计数器、累加器等任何"读-改-写"复合操作,哪怕看起来只是简单的
++或+=,都必须换成synchronized、Lock或原子类。 - 需要保证多个变量整体一致性的场景(比如同时更新两个相关联的字段),volatile 只能逐个变量地保证可见性,无法保证多个变量之间的原子性组合。
七、面试追问链
延伸阅读
- 《Java 并发编程的艺术》第 3 章,volatile 关键字的原理与实现
- JSR-133 官方规范中关于内存屏障插入规则的定义
- 下一篇预告:synchronized 原理——对象头、Monitor、锁升级与现代 JVM 优化
问答(不计入阅读时长)
Q1:volatile 的可见性保证,底层到底靠的是什么机制?
A:靠两部分配合:一是 JMM 层面规定 volatile 写操作要立即刷新到主内存、volatile 读操作要强制从主内存重新加载;二是硬件层面通过缓存一致性协议(比如 MESI)来落实——一个核心修改了被其他核心缓存的内存地址时,会通知其他核心把对应缓存行标记为失效,其他核心下次读取就必须重新同步最新值。JVM 通过在字节码执行时插入内存屏障指令来触发这套硬件机制,而不是自己单独实现了一套可见性方案。
Q2:内存屏障一共有哪几种,volatile 具体用了哪些组合?
A:内存屏障按"前一个操作类型-后一个操作类型"分为四种:LoadLoad、LoadStore、StoreStore、StoreLoad。volatile 的规则是:写操作之前插入 StoreStore 屏障(防止前面的普通写被重排到volatile写之后),写操作之后插入 StoreLoad 屏障(防止volatile写被重排到后面的读写之前);读操作之后插入 LoadLoad 屏障和 LoadStore 屏障(防止后面的普通读、普通写被重排到volatile读之前)。这套组合相当于在volatile变量前后各插入一道"栅栏",阻止跨栅栏的重排序。
Q3:为什么双重检查锁单例模式里,instance 变量必须加 volatile?
A:因为 instance = new Singleton() 底层会拆解成"分配内存→初始化对象→instance指向内存"三步,没有volatile的话,"初始化对象"和"instance指向内存"这两步可能被重排序,导致另一个线程读到一个非空但未初始化完成的"半成品"对象。给instance加上volatile后,"instance指向内存"这一步本身就是一次volatile写,它前面会插入StoreStore屏障,强制要求"初始化对象"必须先于它完成,从根本上堵住了这个重排序漏洞。
Q4:volatile 明明保证了可见性和有序性,为什么还是不能保证 count++ 这种操作的原子性?
A:因为内存屏障只作用于"单次独立的读操作"或"单次独立的写操作"这个动作本身,保证的是这一次读或写的结果何时可见、顺序是否被打乱。但 count++ 是"读取旧值、计算新值、写回新值"三个步骤组成的复合操作,屏障并不会把这三步锁成一个不可分割的整体——两个线程完全可能各自读到同一个旧值,分别计算出相同的新值后又都写回,这个过程中每一步单独看都是可见有序的,但整体上还是发生了竞态、丢失了一次更新。
Q5:如果一个 long 或 double 类型的变量被多个线程共享读写,加了 volatile 之后还需要担心什么?
A:加了volatile之后,可见性和有序性问题就解决了,包括之前提到的"64位类型在没有volatile时可能被拆成两次32位读写导致读到诡异中间值"这个问题,volatile也能规避。但要注意的是,如果对这个变量做的是复合操作(比如累加),volatile依然不能保证原子性,这跟int类型的count++是一样的道理,仍然需要配合synchronized、Lock或者AtomicLong。
Q6:实际项目中,volatile 最常见的正确使用场景有哪几种?
A:主要三类:一是纯粹的状态标志位,比如用一个boolean变量控制某个循环或线程的启停,只有单纯的写和读;二是"安全发布"场景,配合happens-before的传递性,用一个volatile标志位保护它之前完成的一批普通变量写入;三是双重检查锁单例模式,专门用来防止指令重排序导致的对象半初始化问题。这三类场景的共同特点是:变量本身只做单纯的读写,不涉及复合的读-改-写逻辑。
Q7:既然 volatile 不能保证原子性,那计数器场景应该怎么选,AtomicInteger 还是 synchronized?
A:单纯做数值累加这类场景,通常优先选AtomicInteger/AtomicLong,它们底层基于CPU提供的CAS(Compare-And-Swap)指令实现,不需要像synchronized那样阻塞等待锁,在竞争不激烈时性能通常更好。如果需要保护的是一段包含多个操作、需要整体一致性的复合逻辑块(不仅仅是一次数值更新),才应该考虑synchronized或Lock。
Q8:volatile 和 synchronized 相比,是不是可以理解成"轻量级的锁"?
A:不建议这样理解,这是一个常见的误导性说法。synchronized提供的是互斥(同一时刻只有一个线程能进入临界区)+可见性+有序性的完整保证,本质上是一种锁机制;而volatile只提供可见性和有序性,完全不提供互斥能力,也就是说它根本不是锁,不能替代synchronized在需要互斥场景下的作用。把volatile理解为"轻量级锁"容易让人误以为它能像锁一样保护复合操作,这正是本文反复强调要避免的误区。