一、为什么会有 CAS:锁之外的另一条路
前几篇讲的 synchronized 走的是"互斥"这条路——同一时刻只让一个线程进入,其他线程排队甚至挂起。这条路很直观,但代价也很实在:线程挂起、唤醒要经过操作系统调度,重量级锁下开销不小。如果一个操作足够简单(比如给一个整数加一),有没有可能完全不用锁,也能保证多线程下的安全?
答案是有,这就是 CAS(Compare-And-Swap,比较并交换)。它是一种由 CPU 硬件直接支持的原子指令,思路很朴素:不提前"抢位置",而是直接尝试修改,修改前先检查这个位置的值有没有被别人动过,动过就重试,没动过就直接改成功。这种"乐观地先试试,冲突了再重来"的思路,就是乐观锁,和 synchronized 那种"先占位再操作"的悲观锁思路正好相反。
二、CAS 的工作原理:三个数决定一切
CAS 操作接收三个参数:
- 内存地址 V:要修改的变量所在的内存位置。
- 期望值 A:线程在读取变量时看到的旧值,也就是它认为"现在应该是这个值"。
- 新值 B:线程想要把变量改成的目标值。
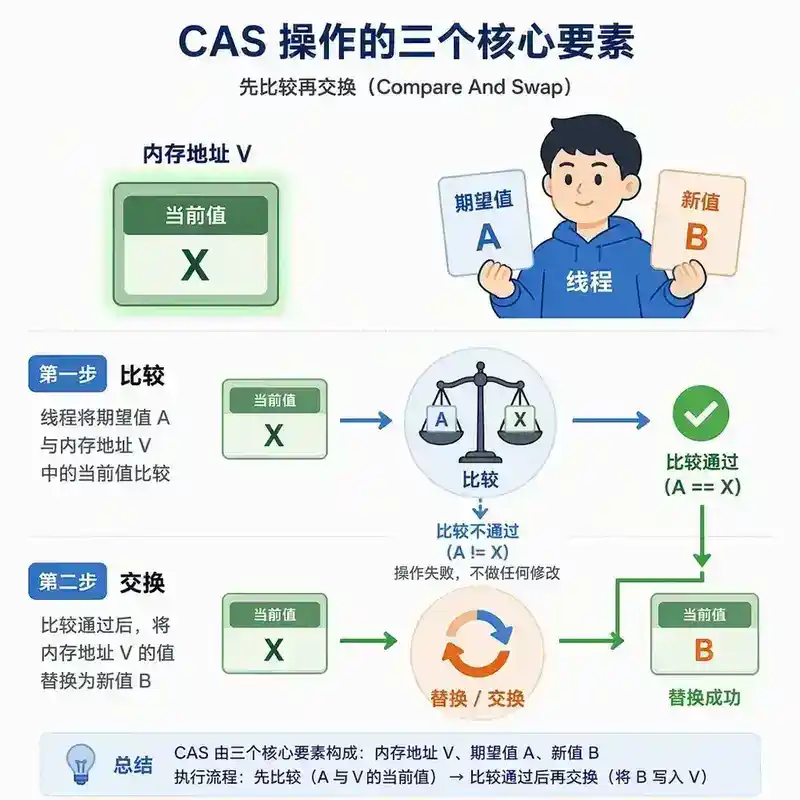
CAS 的执行逻辑是:先比较内存地址 V 当前的实际值是否等于期望值 A。如果相等,说明这段时间没有其他线程修改过这个变量,于是把 V 的值原子性地更新为 B,操作成功;如果不相等,说明有别的线程已经先改过了,这次更新直接失败,不会做任何修改。
关键在于"比较"和"交换"这两步必须是原子的——不能出现"刚比较完发现相等,正准备交换的一瞬间被别的线程插了一刀"的情况。这种原子性不是靠软件加锁实现的,而是直接由 CPU 提供的硬件指令保证的(x86 架构下是 cmpxchg 指令),配合缓存一致性协议锁定对应的内存地址,天然避免了软件层面的竞态窗口。
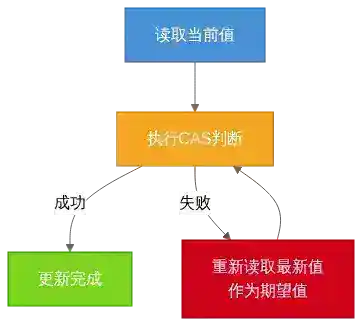
单次 CAS 失败不代表操作失败,通常会配合一个循环:失败就重新读取最新值作为新的期望值,再尝试一次,直到成功为止。这种"失败就重试"的模式就是自旋。
三、Java 里怎么用到 CAS:Unsafe 与原子类
Java 本身的语法层面没有直接暴露 CAS 指令,而是通过 sun.misc.Unsafe 类(Java 9 之后逐步过渡到 java.lang.invoke.VarHandle)间接调用底层的 CAS 硬件指令。日常开发中很少直接使用 Unsafe,而是使用 java.util.concurrent.atomic 包下的一系列原子类,它们内部都基于 CAS 实现:
- AtomicInteger / AtomicLong / AtomicBoolean:对单个基本类型变量的原子操作,最常用的是
incrementAndGet()、compareAndSet()、getAndAdd()等方法,内部都是"读取当前值 → 计算新值 → CAS 尝试写入 → 失败则重试"的循环。 - AtomicReference:对任意对象引用的原子操作,可以用来实现无锁的单例、无锁栈等结构。
- AtomicIntegerArray / AtomicLongArray:对数组中每个元素的原子操作。
- AtomicIntegerFieldUpdater 等:对已有类中某个 volatile 字段的原子更新,避免为每个字段单独包一层原子类对象,节省内存。
这些原子类之所以在多线程下天然安全,靠的是两点:变量本身用 volatile 修饰保证可见性,加上 CAS 保证"读取-判断-修改"这个复合操作的原子性——这正好补齐了上一篇讲到的 volatile 单独存在时的短板:volatile 保证可见性和有序性,但不保证复合操作的原子性;CAS 补上了原子性这一块,两者结合,就有了一套完整的无锁并发方案。
四、ABA 问题:值没变就代表没人动过吗?
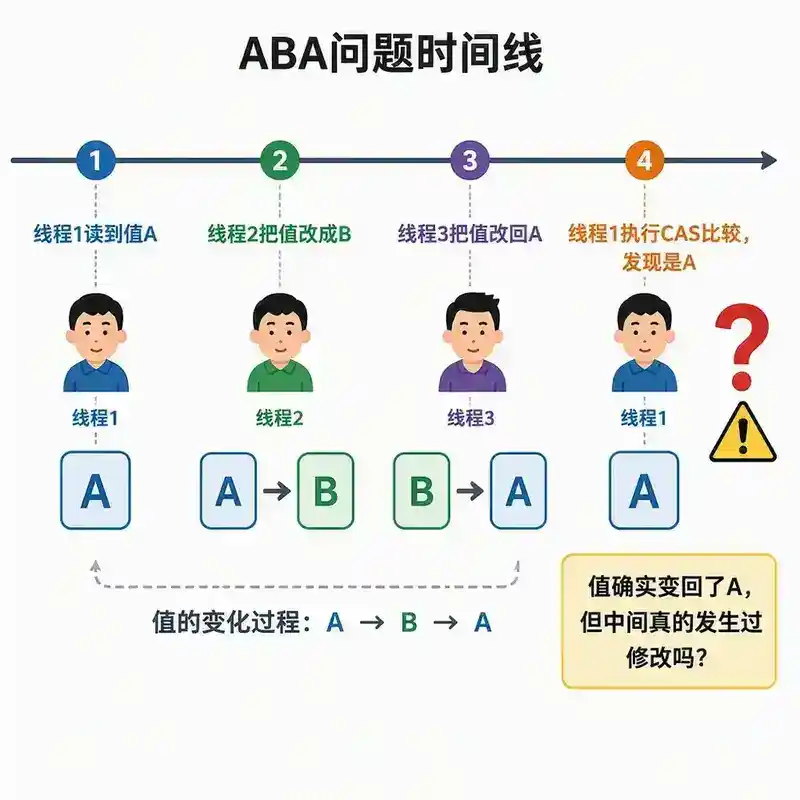
CAS 的判断逻辑有一个隐藏漏洞:它只比较"当前值是否等于期望值",却无法感知这个值在此期间是否被改动过、又改回了原来的样子。这就是经典的 ABA 问题。
举个具体场景:线程1 读到某个变量的值是 A,准备把它 CAS 更新成 C。就在线程1 还没执行 CAS 之前,线程2 抢先把这个值从 A 改成了 B,然后线程3 又把它从 B 改回了 A。这时候线程1 才执行 CAS,它一看当前值确实是 A,和自己最初读到的期望值一致,于是判断"没人动过",顺利把值改成了 C。
问题是,这个变量真的"没被动过"吗?显然不是——它经历了 A→B→A 的完整变化过程,只是最终又恰好变回了 A 这个数值。如果这个变量只是一个单纯的计数器,值本身没有变化,ABA 通常不会造成实际问题。但如果这个变量是一个指向某个对象或某个链表节点的引用,A→B→A 的过程中,原来的 A 对象可能已经被回收、被替换成了另一个新对象(只是内存地址凑巧复用、或者对象内容被重新构造得看起来一样),线程1 基于"值没变"的错误判断继续操作,就可能读到已经失效的中间状态,导致数据结构被破坏——这在无锁链表、无锁栈这类需要频繁修改引用的数据结构中是真实存在的风险。
五、AtomicStampedReference:给每次修改都盖一个时间戳
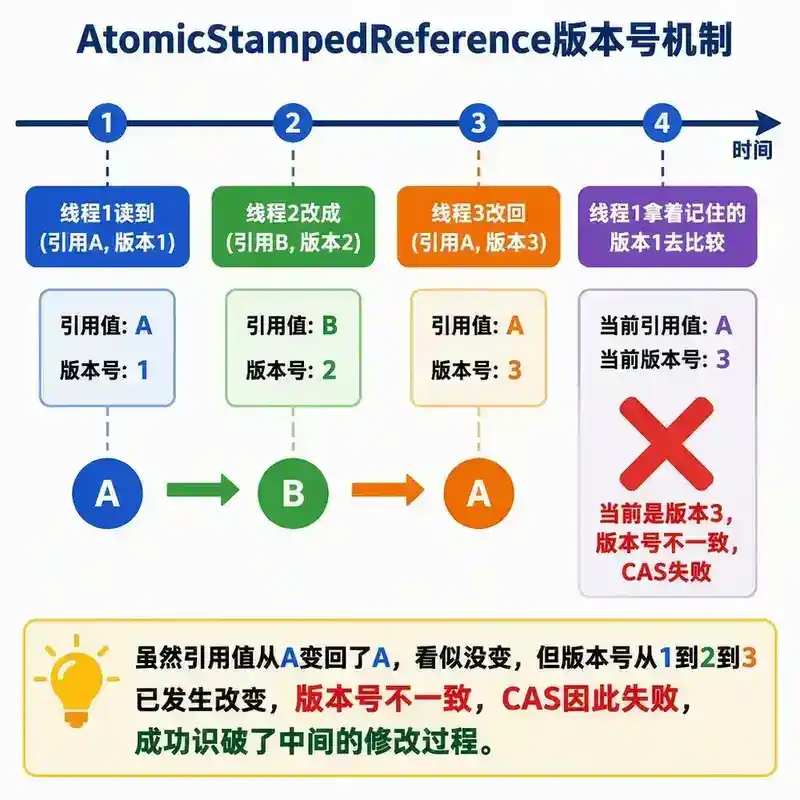
要解决 ABA 问题,核心思路是:不能只比较"值",还要能区分"这是第几次修改"。AtomicStampedReference 就是这样设计的——它把一个引用和一个**版本号(stamp,通常用整数表示)**捆绑在一起,作为一个整体去做 CAS 比较。
它的 compareAndSet 方法签名接收四个参数:期望的引用值、新的引用值、期望的版本号、新的版本号。只有当当前的引用值和版本号同时与期望值一致时,才会执行更新,并把版本号也一起递增。
回到前面的 ABA 场景:线程1 读到的是(引用A,版本1)。线程2 把它改成(引用B,版本2)。线程3 把引用改回了A,但版本号会继续递增为版本3,变成(引用A,版本3)。这时候线程1 拿着自己最初记住的(引用A,版本1)去做比较,会发现当前版本号是3,和自己期望的版本1不一致,CAS 直接失败——即使引用的值看起来"又变回了A",版本号已经清楚地暴露了"中间发生过修改"这个事实。这正是 AtomicStampedReference 解决 ABA 问题的关键:把"值是否相同"这个单一维度的判断,扩展成"值和版本号是否同时相同"的双重判断。
还有一个相关的类 AtomicMarkableReference,思路类似,只是把版本号换成了一个简单的布尔标记,用于只需要区分"是否被标记过"、不需要精确计数的场景。
六、自旋的代价:不是免费的午餐
CAS 配合自旋重试,避开了线程挂起唤醒的系统调用开销,但这不代表它没有代价,只是代价换了个地方:
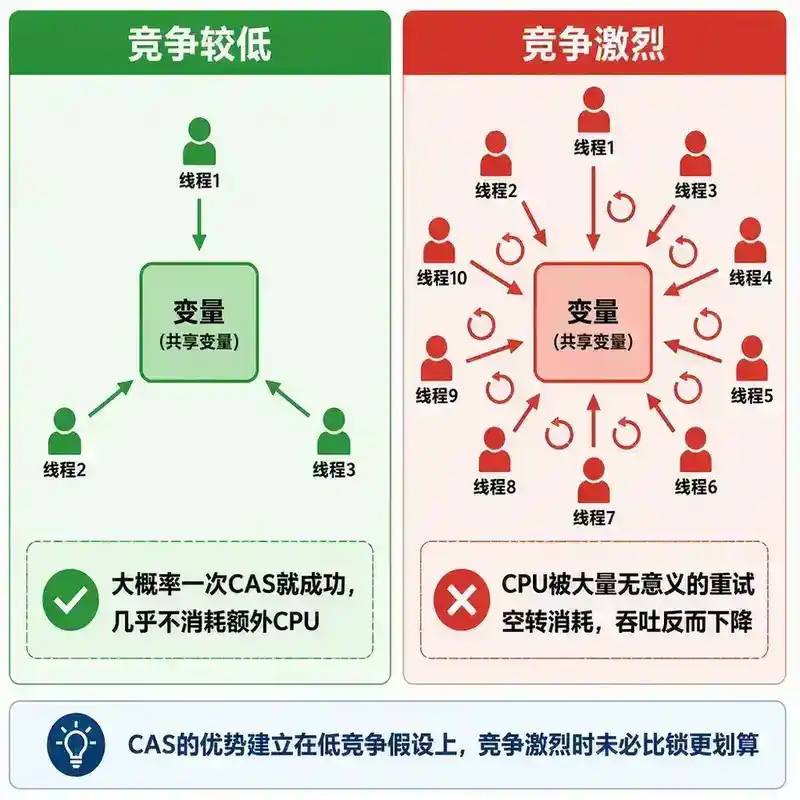
- CPU 空转开销:自旋期间线程不会释放 CPU,会持续占用 CPU 周期不断重试。如果竞争激烈、大量线程同时自旋,CPU 会被大量消耗在无意义的重试上,整体吞吐反而可能下降。
- 竞争越激烈,收益越低:CAS 的优势建立在"大多数情况下一次就能成功、只是偶尔冲突"的假设上。如果线程数远超 CPU 核心数、竞争持续激烈,失败重试的概率会显著上升,自旋的性价比就会大幅下降,这时候用锁把多余的线程挂起反而更划算——这也是 Java 8 引入
LongAdder等分段累加结构的原因,它把单一热点变量拆分成多个槽位分散竞争,比单纯依赖一个 AtomicLong 的 CAS 自旋在高并发下性能更好。 - 只能保护单个变量:CAS 天生只能原子地操作一个内存位置。如果一次业务逻辑需要同时原子性地修改多个变量(比如同时更新余额和交易记录两个字段),单纯用 CAS 是做不到的,这种场景就必须回到锁,或者把多个字段合并封装进一个对象、用 AtomicReference 整体替换。
七、面试追问链
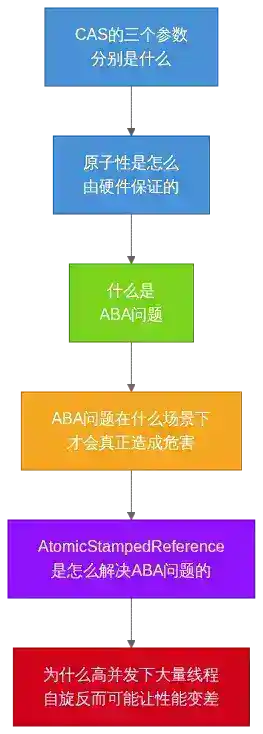
从"什么是 CAS"出发,逐层追问:CAS 的三个参数分别是什么、它的原子性是怎么由硬件保证的、什么是 ABA 问题、ABA 问题在什么场景下才会真正造成危害、AtomicStampedReference 是怎么解决 ABA 问题的、以及为什么高并发下大量线程自旋反而可能让性能变差,这条链基本能覆盖面试官对 CAS 原理和局限性的核心考察点。
延伸阅读
java.util.concurrent.atomic包源码,重点看AtomicInteger和AtomicStampedReference的实现LongAdder分段累加的设计思路,理解高并发下如何进一步降低 CAS 竞争- 下一篇预告:AQS 原理——同步状态、CLH 队列、独占/共享模式和 Condition
问答(不计入阅读时长)
Q1:CAS 和 synchronized 到底是什么关系?是互相替代还是各管各的?
A:两者是解决"多线程安全"这个问题的两条不同路径,不是简单的替代关系。synchronized 是悲观锁思路:假设一定会有竞争,先占位再操作,没抢到的线程排队甚至挂起。CAS 是乐观锁思路:假设大概率不会冲突,直接尝试修改,冲突了再重试。实际上 Java 内部很多机制是两者结合的——比如 synchronized 的轻量级锁阶段本身就用 CAS 去争抢锁标志位,只有竞争足够激烈时才真正升级为重量级锁走互斥这条路。
Q2:CAS 的原子性为什么不需要加锁就能保证?会不会存在"比较"和"交换"中间被打断的情况?
A:不会。CAS 不是软件层面拼出来的两步操作,而是 CPU 直接提供的单条硬件指令(x86 下是 cmpxchg),比较和交换在硬件层面是一个不可分割的整体操作,配合缓存一致性协议锁定对应的内存地址,从硬件设计上就排除了"中间被插入"的可能性,根本不存在软件层面需要额外加锁去保护的中间状态。
Q3:AtomicInteger 的 incrementAndGet() 内部是怎么用 CAS 实现的?和直接用 volatile int 做 count++ 有什么本质区别?
A:incrementAndGet() 内部是一个循环:先读取当前值,计算出加一后的新值,然后调用 CAS 尝试把内存中的值从"当前值"更新为"新值";如果 CAS 失败(说明这段时间被别的线程改过了),就重新读取最新值再试一次,直到成功。而 volatile int 的 count++ 本质是"读取-计算-写回"三个独立步骤,volatile 只保证每一步单独看是可见、有序的,但不能保证这三步作为一个整体不被其他线程插入执行,所以会丢更新。CAS 版本的关键区别在于它有失败重试机制,能保证整个"读取-计算-写入"作为一个逻辑单元最终正确完成,不会丢失任何一次修改。
Q4:ABA 问题具体在什么场景下才会真正引发线上事故?普通的计数器场景需要担心吗?
A:普通计数器场景基本不需要担心。ABA 问题真正有危害的场景,是当这个被CAS操作的值是一个引用、而不是单纯的数值时——比如无锁栈、无锁链表这类数据结构,节点引用在A→B→A的变化过程中,中间的B阶段可能已经对节点做了实质性修改(比如节点被回收后内存复用给了另一个新对象,或者链表结构被重新调整),最后虽然引用值看起来又变回了A,但底层的数据结构状态已经不是最初的样子,基于"值没变"的错误假设继续操作,就可能读到脏数据或破坏数据结构的完整性。
Q5:AtomicStampedReference 的版本号会不会自己溢出?如果一直递增下去会出问题吗?
A:版本号用的是 int 类型,理论上存在溢出的可能,但在实际场景下,能在极短时间内让同一个引用被修改到 int 溢出(超过21亿次)的场景极其罕见,工程上基本不需要特别处理。即便真的溢出回绕,只要不是恰好在同一次比较窗口内绕回到完全相同的数值,就不会重新引入ABA问题,风险在绝大多数实际业务场景下可以忽略。
Q6:为什么说"CAS 只能保护单个变量"是它的局限?实际开发中怎么绕开这个限制?
A:因为CAS指令本身只能原子性地操作一块连续的内存地址,没办法同时对两个不相关的内存位置做原子性的联合判断和修改。如果业务逻辑需要同时原子性地更新多个字段(比如同时改余额和更新交易流水号),单纯靠一个 AtomicInteger 或 AtomicLong 是做不到的。常见的绕开方式有两种:一是把需要联合更新的多个字段封装进一个不可变对象,用 AtomicReference 整体替换这个对象的引用(一次CAS就能"看起来"同时更新了所有字段);二是老老实实回到 synchronized/Lock,用互斥来保证多个字段更新的整体原子性。
Q7:LongAdder 比 AtomicLong 快在哪里?是不是意味着以后都该用 LongAdder?
A:LongAdder 的核心思路是"分散热点":不是让所有线程都去竞争同一个 AtomicLong 的CAS,而是内部维护一组 Cell(槽位),不同线程尽量落到不同槽位上分别做CAS累加,最后需要读取总数时再把所有槽位的值加起来。这样大幅降低了单点竞争,在高并发写入的场景下性能明显优于单一 AtomicLong。但代价是最终读取汇总值时会有额外的遍历汇总开销,且在读多写少或者并发度不高的场景下,AtomicLong 反而更简单直接、开销更低。所以不是无条件都该换成 LongAdder,而是"写多读少、竞争激烈的计数场景优先考虑 LongAdder"。
Q8:既然自旋在竞争激烈时代价很高,为什么 JVM 不干脆一直用锁,非要保留CAS这条路?
A:因为竞争激烈只是众多并发场景中的一种,大多数实际业务里,对共享变量的操作大概率不会真正冲突(比如低频更新的计数器、状态标志位),这种场景下CAS配合极少次数的自旋,代价远低于走锁的挂起、唤醒、上下文切换开销。JVM和Java并发库的设计思路是"按场景选合适的工具":低竞争、简单操作用CAS/原子类;高竞争、复合操作用锁。CAS的存在不是要取代锁,而是给"大概率不冲突"这一大类高频场景提供一个更轻量的选择。