阅读时间:约 45 分钟 | 适用读者:Java 高级工程师 / 技术专家 / 架构师 本文属于「Java 技术专家与架构师面试:250 个高频考点总览」系列第 174 篇。
1. 为什么分布式系统需要时钟
分布式系统没有全局时钟,这是它与单机系统最根本的区别之一。在单机上,System.currentTimeMillis() 对所有线程来说是一致的;但在分布式系统中,每个节点都有自己的时钟,这些时钟之间天然存在偏差。
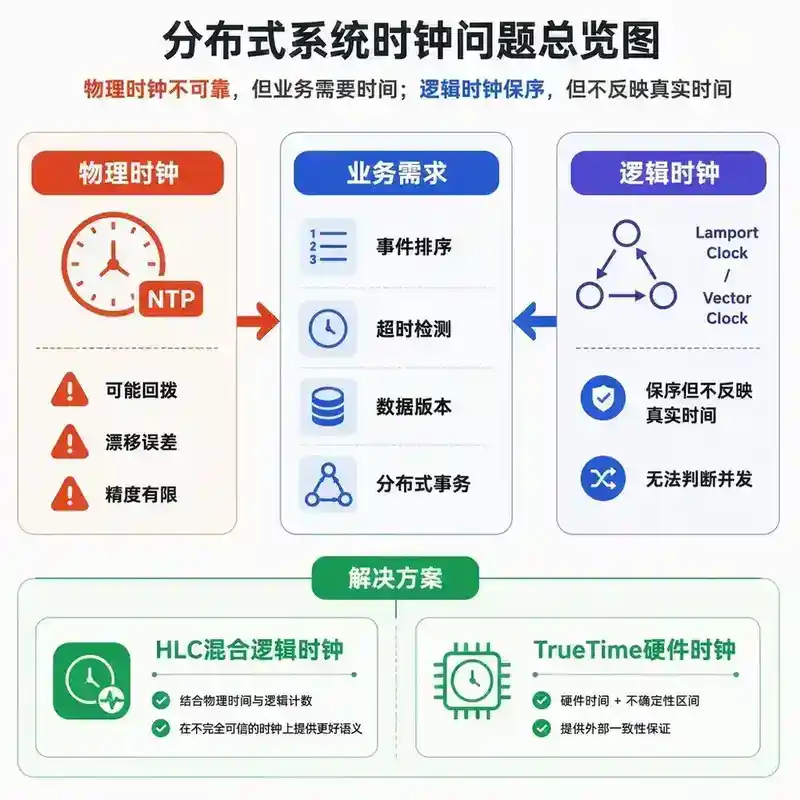
1.1 时钟在分布式系统中的核心作用
| 场景 | 用途 | 依赖的时钟类型 |
|---|---|---|
| 事件排序 | 判断 A 和 B 谁先发生 | 逻辑时钟 / 向量时钟 |
| 因果关系推断 | A 是否导致了 B | 向量时钟 |
| 并发冲突检测 | 两个操作是否并发 | 向量时钟 / 版本向量 |
| 超时检测 | 判断节点是否存活 | 物理时钟(单调) |
| 数据版本管理 | 最后写入胜出(LWW) | 物理时钟 / 混合逻辑时钟 |
| 分布式快照 | 全局一致性快照 | 逻辑时钟 / 向量时钟 |
| TTL / 过期 | 缓存过期、令牌过期 | 物理时钟 |
| 分布式事务 | 超时判断、事务排序 | 混合逻辑时钟 |
▲ 图1:分布式系统中各类时钟的应用场景全景
1.2 核心矛盾
物理时钟不可靠,但业务需要时间;逻辑时钟保序,但不反映真实时间。
这个矛盾贯穿了整个分布式时钟领域的研究和工程实践。
2. 物理时钟与 NTP
2.1 计算机时钟的工作原理
现代计算机通常使用两种时钟:
- 墙上时钟(Wall Clock / Real-time Clock):返回当前真实时间,受 NTP 同步调节,可能回拨。
- 单调时钟(Monotonic Clock):从某个未指定起点开始单调递增,不受 NTP 调节,永不回拨,适合测量时间间隔。
在 Java 中:
// 墙上时钟 —— 可能回拨
long wallClock = System.currentTimeMillis();

// 单调时钟(Java 8+)—— 永不回拨,适合测量时间间隔
long monotonic = System.nanoTime();  // 注意:nanoTime() 不是绝对时间

// Java 9+ 更精确的时钟 API
Instant now = Instant.now();                // 墙上时钟
Instant monotonicNow = Clock.systemUTC().instant();  // 仍为墙上时钟
2.2 NTP(Network Time Protocol)
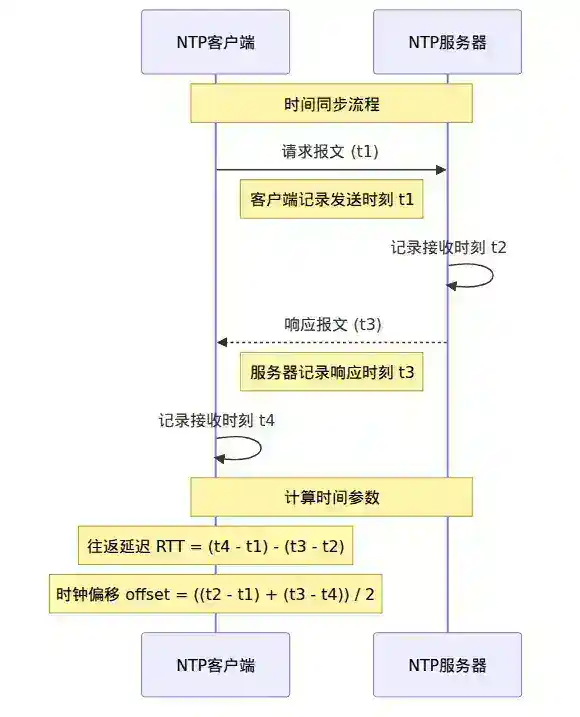
NTP 是互联网上最广泛使用的时间同步协议,工作原理如下:
NTP 同步流程(简化):
客户端                          NTP 服务器
  |                                |
  |--- 请求报文(t1)------------->|
  |                                | 收到(t2)
  |<-- 响应报文(t3)-------------|
  |  收到(t4)                    |
- t1:客户端发送请求的时间戳
- t2:服务器收到请求的时间戳
- t3:服务器发送响应的时间戳
- t4:客户端收到响应的时间戳
偏移量计算:
往返延迟 RTT = (t4 - t1) - (t3 - t2)
时钟偏移 offset = ((t2 - t1) + (t3 - t4)) / 2
然后客户端将本地时钟调整 offset 以对齐服务器。
▲ 图2:NTP 时间同步协议完整交互流程
2.3 NTP 的精度限制
NTP 在局域网中可达到 毫秒级 精度,在广域网中通常为 几十毫秒到几百毫秒。这意味着:
- 两台通过公网 NTP 同步的服务器,时钟偏差可能高达 100ms+
- 对于需要微秒级精度的事件排序,NTP 完全不够用
2.4 NTP 的"回拨"问题
NTP 调整时钟有两种方式:
- slew(渐变):以微小速率调整时钟频率,避免跳跃
- step(步进):直接设置时钟为新值,造成回拨
当 NTP 执行 step 时,System.currentTimeMillis() 可能出现 t2 < t1 的情况,这在分布式系统中是灾难性的。
3. 时间漂移:根源与影响
3.1 什么是时钟漂移(Clock Drift)
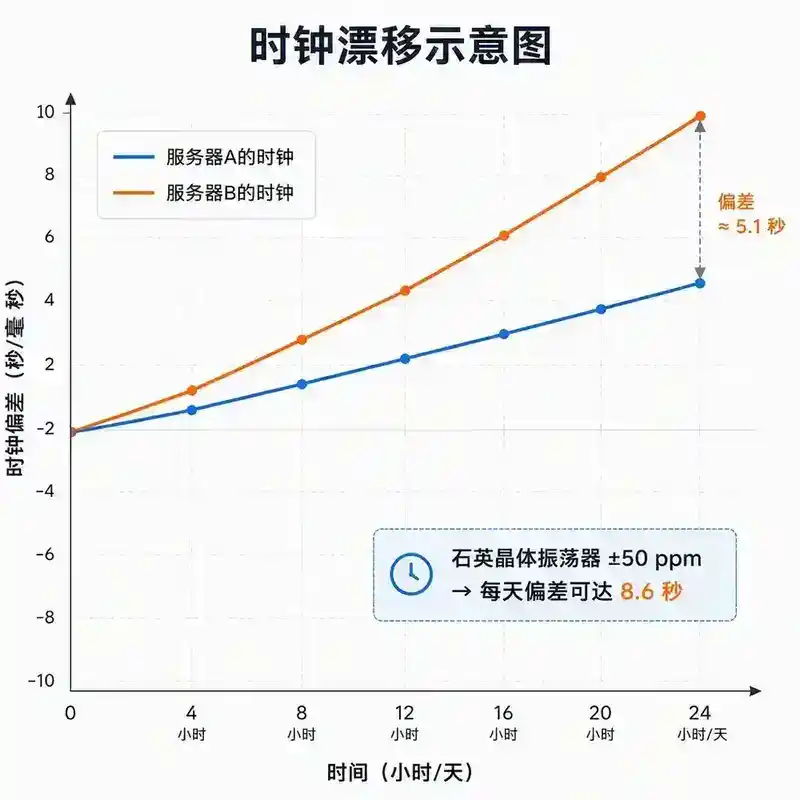
时钟漂移是指计算机的石英晶体振荡器由于温度、电压、老化等因素,导致实际频率与标称频率之间的偏差。漂移率用 ppm(parts per million) 表示:
- 典型石英晶体:±50 ppm(每天偏差约 4.3 秒)
- 温补晶振 TCXO:±1 ppm(每天偏差约 0.086 秒)
- 恒温晶振 OCXO:±0.01 ppm
- 原子钟:±10⁻¹¹
50 ppm 意味着什么? 两台初始同步的服务器,使用 50 ppm 的普通石英晶体,一天后时钟偏差可达 8.6 秒。
▲ 图3:不同精度时钟源的漂移速率对比
3.2 时钟偏移(Clock Skew)vs 时钟漂移(Clock Drift)
- 偏移(Skew):某一时刻两台时钟的差值,是瞬时值
- 漂移(Drift):时钟频率与标准频率的偏差,是速率概念
打个比方:漂移是速度,偏移是距离。漂移决定了偏移随时间累积的速度。
3.3 时钟不可靠导致的真实故障
案例 1:Google Spanner 早期测试
Google 在 Spanner 开发初期发现,即使使用 NTP 同步,数据中心内时钟偏差仍可达几十毫秒。这直接促使他们开发了 TrueTime(见第 7 节)。
案例 2:Snowflake ID 时钟回拨
Twitter Snowflake 分布式 ID 算法依赖时间戳保证趋势递增。如果时钟回拨,可能生成重复 ID。Snowflake 的处理方式:等待时钟追上上次记录的时间。
案例 3:Lease 过期误判
分布式锁的 Lease 机制中,如果持有锁的节点时钟比协调者快,它可能提前释放锁,导致其他节点同时获得锁,破坏互斥性。
4. 逻辑时钟:Lamport 时间戳
4.1 核心思想
1978 年,Leslie Lamport 提出:我们不需要真实时间,只需要事件之间的"happens-before"关系。
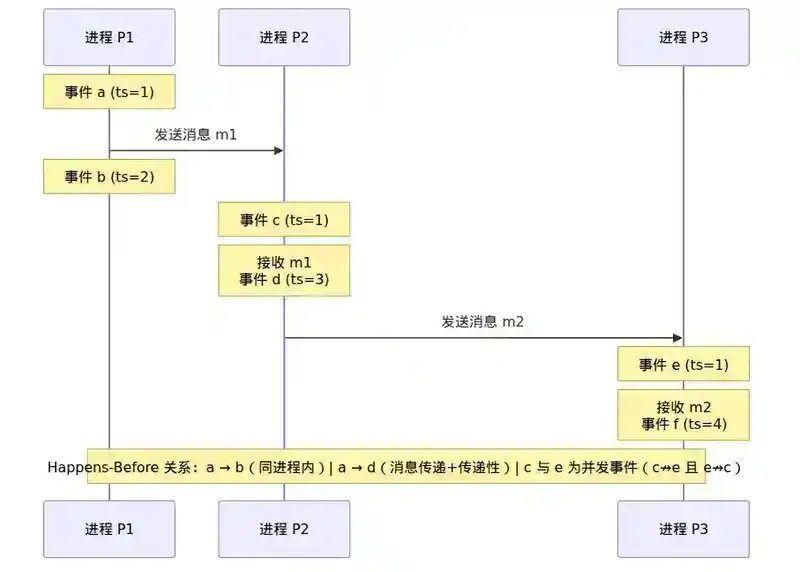
4.2 Happens-Before 关系(→)
定义关系 a → b(a happens before b):
- 同一进程内:如果 a 在 b 之前发生,则
a → b - 消息传递:如果 a 是发送消息事件,b 是接收同一消息事件,则
a → b - 传递性:如果
a → b且b → c,则a → c
如果 a 不→ b 且 b 不→ a,则 a 和 b 是并发事件。
▲ 图4:Lamport 逻辑时钟 Happens-Before 关系示意
4.3 Lamport 时钟算法
每个进程维护一个整数计数器 C:
- 本地事件:
C = C + 1 - 发送消息:
C = C + 1,消息附带时间戳C - 接收消息:
C = max(C_local, C_message) + 1
// Lamport 时钟的简单 Java 实现
public class LamportClock {
    private final AtomicLong counter = new AtomicLong(0);

    public long tick() {
        return counter.incrementAndGet();
    }

    public long send() {
        return counter.incrementAndGet();
    }

    public long receive(long messageTimestamp) {
        counter.updateAndGet(current ->
            Math.max(current, messageTimestamp) + 1);
        return counter.get();
    }

    public long get() {
        return counter.get();
    }
}
4.4 Lamport 时钟的局限性
Lamport 时间戳能保证:如果 a → b,则 C(a) < C(b)
但不保证逆命题:C(a) < C(b) 不意味着 a → b。a 和 b 可能是并发事件。
这个局限性使得 Lamport 时钟无法用于判断并发冲突和因果关系,这正是向量时钟要解决的问题。
5. 向量时钟:因果关系的完整刻画
5.1 核心思想
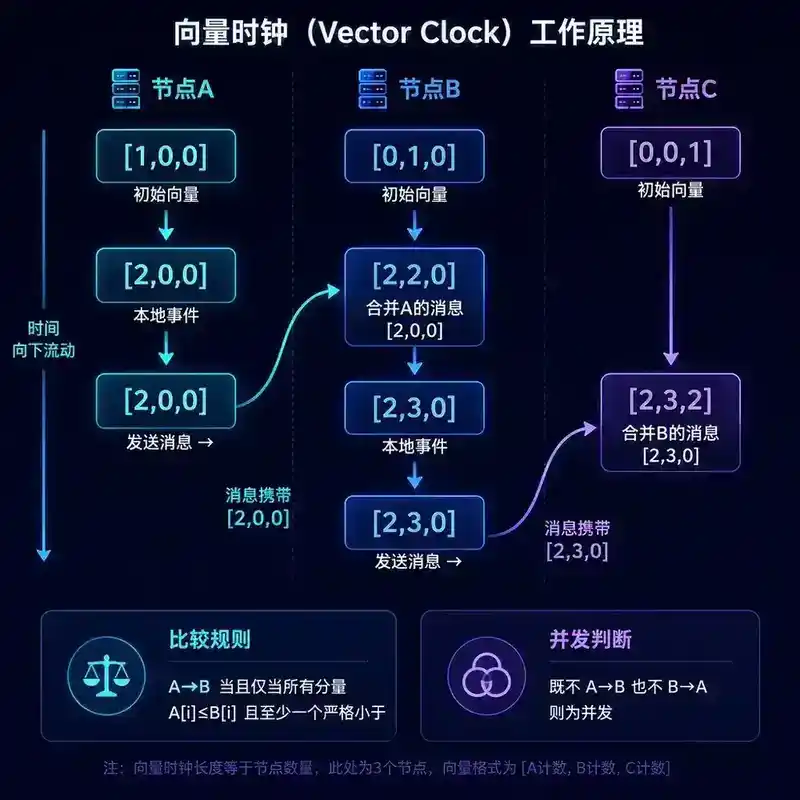
向量时钟为每个进程维护一个长度为 N(节点总数)的向量 VC = [C1, C2, ..., CN],其中 Ci 是对进程 i 事件计数的本地记录。
5.2 向量时钟算法
- 本地事件:
VC_p[p] = VC_p[p] + 1 - 发送消息:
VC_p[p] = VC_p[p] + 1,消息附带整个向量VC_p - 接收消息:
VC_p[p] = VC_p[p] + 1,对所有k ≠ p:VC_p[k] = max(VC_p[k], VC_msg[k])
5.3 向量时钟的比较规则
对于两个向量时钟 A 和 B:
- A 先于 B(
A → B):所有A[i] ≤ B[i]且至少存在一个A[i] < B[i] - B 先于 A(
B → A):所有B[i] ≤ A[i]且至少存在一个B[i] < A[i] - 并发(
A ∥ B):既不是 A→B 也不是 B→A
▲ 图5:向量时钟因果关系判定——3节点场景下的先于、后于、并发关系
5.4 向量时钟的工程问题
问题 1:节点数变化
在动态集群中,节点可能加入或退出。向量长度需要随之变化,这在实际系统中很棘手。
问题 2:存储开销
N 个节点的向量时钟大小为 O(N)。在大型集群中,每个数据版本存储一个向量时钟代价很高。
工程优化:
- Amazon Dynamo 使用版本向量(Version Vector),只存储实际参与修改的节点,而非全集群节点
- Riak 使用带点状修剪(Dotted Version Vector) 优化并发写入
6. 混合逻辑时钟 HLC
6.1 为什么需要 HLC
- 物理时钟:提供真实时间,但不可靠(回拨、漂移)
- 逻辑时钟:可靠保序,但无法反映真实时间
- HLC:结合两者优点——提供接近物理时间的值,同时保证单调递增和因果关系
6.2 HLC 算法
HLC 由两部分组成:(pt, l),其中 pt 是物理时间戳,l 是逻辑计数器。
算法(简化):
初始化:pt = 0, l = 0

本地事件或发送消息:
  pt' = max(pt, 当前物理时间)
  if pt' == pt:
    l = l + 1
  else:
    l = 0
  pt = pt'
  返回 (pt, l)

接收消息 (pt_msg, l_msg):
  pt' = max(pt, pt_msg, 当前物理时间)
  if pt' == pt == pt_msg:
    l = max(l, l_msg) + 1
  else if pt' == pt:
    l = l + 1
  else if pt' == pt_msg:
    l = l_msg + 1
  else:
    l = 0
  pt = pt'
  返回 (pt, l)
6.3 HLC 的性质
- 单调递增:HLC 时间戳严格单调递增,永不会出现
t2 < t1 - 因果关系:满足 Lamport 的 happens-before 条件
- 接近物理时间:
pt部分始终接近 NTP 同步的物理时间,误差在 ε 范围内 - 可比较:HLC 值之间可以直接按字典序比较
▲ 图6:HLC 混合逻辑时钟——物理时钟与逻辑计数器协同工作流程
6.4 HLC 的应用场景
- 分布式数据库:CockroachDB 使用 HLC 实现多版本并发控制和事务排序
- 分布式事务:HLC 提供全局有序的时间戳,用于确定事务提交顺序
- CDC(Change Data Capture):HLC 提供有序的事件时间戳
7. TrueTime 与全局有序时钟
7.1 Google Spanner 的 TrueTime
Google Spanner 是第一个在全局范围内提供**外部一致性(External Consistency)**的分布式数据库,其核心依赖是 TrueTime。
TrueTime 的核心 API:
TT.now() 返回一个区间 [earliest, latest]
保证:真实时间一定在 [earliest, latest] 区间内
7.2 TrueTime 的实现
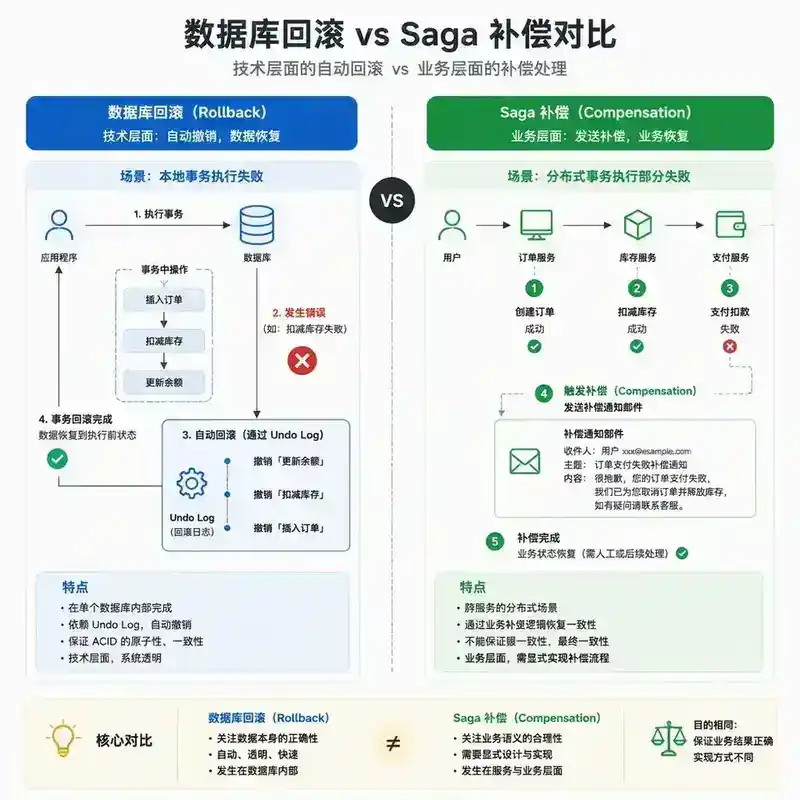
Google 在每个数据中心部署 GPS 接收器和原子钟作为时间主控,通过专用网络同步,确保 latest - earliest 的误差范围 ε 通常在 1-7ms 内。
▲ 图7:Google TrueTime 架构——从 GPS/原子钟到 Spanner 事务提交的完整链路
7.3 Spanner 如何使用 TrueTime
Spanner 的事务提交等待策略:
事务提交时,选择提交时间戳 s = TT.now().latest
然后等待直到 TT.now().earliest > s(即确保真实时间已超过 s)
这个等待过程称为 commit wait,确保所有节点看到的时间戳顺序与真实时间顺序一致。这是实现外部一致性(即线性一致性)的关键。
7.4 为什么普通系统不能复制 TrueTime
- 需要专用硬件(GPS 接收器、原子钟)
- 需要专用网络进行时间同步
- 需要数据中心级别的部署
对于大多数分布式系统,TrueTime 是不可用的。这也是为什么 HLC 和向量时钟等软件方案仍然广泛使用。
8. 生产实践与常见陷阱
8.1 时间相关的常见故障模式
陷阱 1:用**System.currentTimeMillis()**做唯一 ID
// 错误:时钟回拨时可能生成重复 ID
long id = System.currentTimeMillis();
陷阱 2:依赖时间戳做分布式排序
// 错误:不同机器的时钟不一致,排序不可靠
events.sort(Comparator.comparingLong(Event::getTimestamp));
陷阱 3:基于时间戳的 Lease 过期
// 危险:持有者和协调者时钟偏差会导致误判
if (System.currentTimeMillis() > leaseExpiryTime) {
    // 释放锁 —— 但可能真实时间还没到!
}
陷阱 4:GC 暂停导致时间跳跃
JVM 的 Full GC 可能导致线程暂停数秒甚至数十秒。GC 结束后,System.currentTimeMillis() 返回的时间是"正确"的,但程序逻辑上已经错过了关键时间窗口。
8.2 最佳实践
| 场景 | 推荐方案 | 原因 |
|---|---|---|
| 分布式 ID 生成 | Snowflake + 时钟回拨保护 | 趋势递增 + 容错 |
| 事件排序 | 向量时钟 / HLC | 完整因果关系 |
| 超时检测 | 单调时钟 + 心跳 | 不受时钟回拨影响 |
| 数据版本管理 | 版本向量 | 处理并发冲突 |
| 分布式事务 | HLC | 接近物理时间 + 保序 |
| TTL 过期 | 租约(Lease)而非绝对时间 | 避免时钟偏差影响 |
▲ 图8:分布式时钟生产实践全景图——从 ID 生成到超时检测的全场景方案
8.3 Java 中的时钟最佳实践
// 避免直接用 System.currentTimeMillis() 做关键逻辑
// 使用 Java 9+ 的 java.time.Clock 抽象,便于测试

public class OrderService {
    private final Clock clock;

    public OrderService(Clock clock) {
        this.clock = clock;  // 生产用 Clock.systemUTC(),测试用 Clock.fixed()
    }

    public Instant getOrderTime() {
        return Instant.now(clock);
    }

    // 测量时间间隔用单调时钟
    public Duration measureOperation(Runnable op) {
        long start = System.nanoTime();
        op.run();
        return Duration.ofNanos(System.nanoTime() - start);
    }
}
9. 面试追问与参考答案
以下问题从面试官视角出发,不限于本文内容,考察深度理解和实战经验。
Q1:NTP 同步你能信任到什么程度?如果你的系统需要毫秒级精确的事件排序,NTP 够用吗?
参考答案:广域网 NTP 精度通常在 10-100ms 级别,不足以支持毫秒级精确排序。毫秒级精确排序需要 Lamport 逻辑时钟或向量时钟来保证 happens-before 关系,或者使用 Google TrueTime 这类硬件辅助方案。如果业务确实需要真实时间做排序,建议使用 HLC(混合逻辑时钟),它在提供接近物理时间的同时保证了单调递增和因果一致性。
Q2:向量时钟的向量长度如何确定?如果集群节点动态变化怎么办?
参考答案:静态集群中向量长度等于节点数。动态集群中,方案有几种:(1) 版本向量(Dynamo 方案),只保留实际参与修改的节点,而非全集群;(2) 点状版本向量(Dotted Version Vector),在向量基础上增加一个点状标识,用于精确标识单一写入者;(3) 用 HLC 替代向量时钟,完全避免维度问题。选型取决于业务对因果关系精度的需求。
Q3:Snowflake 算法中,如果遇到时钟回拨,你会怎么处理?
参考答案:标准 Snowflake 的处理是等待时钟追上。除此之外:(1) 短时间回拨(<100ms)可以等待或使用备用 worker ID;(2) 中等回拨可以扩展序列号位宽,用逻辑序列号弥补;(3) 长时间回拨需要报警并人工介入,可能切换到备用机器。核心原则是:宁可短暂不可用,也不能生成重复 ID。
Q4:CockroachDB 为什么选择 HLC 而不是 TrueTime 或纯逻辑时钟?
参考答案:CockroachDB 定位为通用分布式数据库,不能依赖 Google 的专用硬件。纯逻辑时钟无法反映真实时间,导致用户无法按时间查询数据版本。HLC 是折中方案:它提供接近物理时间的值(用户可读),同时保证单调递增和因果一致性(系统可用),且不需要特殊硬件。CockroachDB 用 HLC 的 (wall_time, logical) 作为 MVCC 版本号,实现可比较、有因果语义的版本排序。
Q5:分布式系统中,你如何判断一个节点是否真的"挂了",而不是网络分区或 GC 暂停?
参考答案:这是经典的故障检测问题。不能仅依赖时间戳超时,需要综合判断:(1) 心跳机制用单调时钟而非墙上时钟,避免时钟回拨干扰;(2) 使用 φ 累积故障检测器(phi-accrual failure detector),基于心跳到达间隔的动态分布计算怀疑度,而非固定阈值;(3) 多次探测 + 多路径探测降低误判;(4) 区分"疑似故障"和"确认故障",确认前保留安全余量。如 Akka 和 Cassandra 都使用 φ 故障检测器。
Q6:分布式事务中,为什么 HLC 不能替代 TrueTime 实现 Spanner 级别的外部一致性?
参考答案:HLC 保证单调递增和因果一致性,但不保证线性一致性(外部一致性)。原因:HLC 的 pt 部分来自每个节点的本地物理时钟,即使经过 NTP 同步,两个节点在同一真实时刻可能产生不同的 HLC 值。TrueTime 通过 [earliest, latest] 区间 + commit wait 机制,保证提交时间戳排除所有不确定性,从而实现线性一致性。HLC 适合需要因果一致性的场景,对于需要线性一致性的全局事务,仍需 TrueTime 或共识协议。
延伸阅读:(暂无推荐阅读)
本文是「Java 技术专家与架构师面试:250 个高频考点总览」系列第 174 篇。下一篇:175|数据对账与补偿体系。