阅读时间:约 45 分钟 难度:中高级 适用人群:Java 技术专家、分布式系统架构师、后端高级工程师
目录
- 问题定义:分布式世界里的"账本"难题
- 核心原理:对账与补偿的数学本质
- 差异发现:如何在海量数据中找出不一致
- 重放机制:让数据"再来一次"
- 修复策略:从差异到一致
- 审计体系:让每一笔变更都有迹可循
- 闭环设计:从发现到归档的完整链路
- 工程实践:落地一个生产级对账系统
- 常见陷阱与反模式
- 面试追问与参考答案
一、问题定义
1.1 分布式系统中的"账本"困境
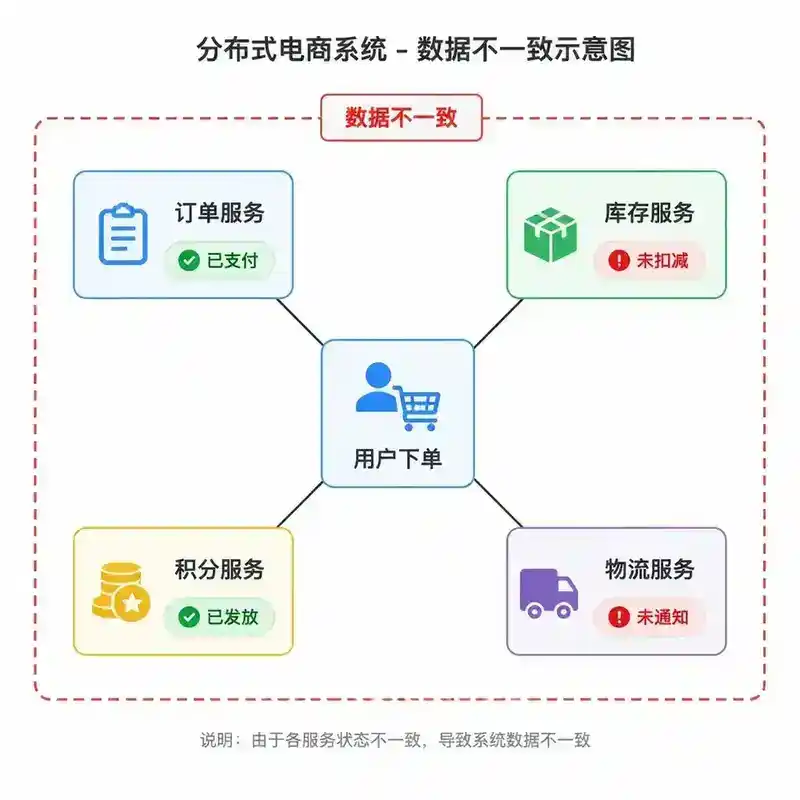
想象一个电商下单场景:用户支付成功后,订单状态变为"已支付",同时需要扣减库存、发放积分、通知物流。这四个操作分别发生在订单服务、库存服务、积分服务、物流服务中——这就是典型的分布式数据一致性场景。
在理想世界里,分布式事务(如 XA/2PC)可以保证所有操作要么全部成功、要么全部回滚。但在高并发、高可用的生产环境中,分布式事务的性能代价和可用性牺牲往往不可接受。于是我们转向最终一致性——接受短暂的不一致,通过异步机制最终达成一致。
但问题来了:你怎么知道数据是否已经一致了?如果不一致,怎么发现?怎么修复?怎么证明修复完成了?
这就是数据对账与补偿体系要回答的四个核心问题。
1.2 对账与补偿的定义
数据对账(Reconciliation):在分布式系统中,对多个数据副本或关联数据源进行比对,发现差异(discrepancy)的过程。
数据补偿(Compensation):对已发现的差异进行修复,使数据恢复到一致状态的过程。补偿可以是"回退"(undo),也可以是"正向推进"(forward recovery)。
闭环(Closed Loop):从差异发现→通知→修复→验证→归档的完整链路,确保每一个差异都被追踪到终态。
1.3 为什么需要专门的体系
很多团队的对账方式是"出了问题再说"——等用户投诉、等业务方反馈、等监控告警。这种被动模式的问题在于:
- 发现滞后:用户可能比你先发现数据不一致,损害用户体验
- 修复成本高:问题发现越晚,关联数据越多,修复越复杂
- 无法量化:你无法回答"当前系统有多少笔数据不一致",也无法向业务方证明"数据已经一致"
- 审计缺失:金融、支付等强监管场景,数据一致性是合规红线
因此,对账与补偿不是"锦上添花"的可选功能,而是分布式系统的基础设施。
二、核心原理
2.1 对账的数学本质
对账本质上是一个集合差集运算。设数据源 A 的数据集合为 S(A),数据源 B 的数据集合为 S(B):
- A 有 B 无 → 差异集 D_AB = S(A) - S(B)
- B 有 A 无 → 差异集 D_BA = S(B) - S(A)
- A 和 B 都有但值不同 → 差异集 D_val =
总差异集 = D_AB ∪ D_BA ∪ D_val。
但在工程实践中,我们不能对两个数据源做全量集合运算(数据量太大),需要借助各种优化手段。
2.2 补偿的本质
补偿不是简单的"把 A 的数据复制到 B"。在实际业务中,补偿需要回答三个关键问题:
- 以谁为准? —— 哪个数据源的版本是"权威"的?
- 怎么补偿? —— 是重新执行业务操作,还是直接修改数据?
- 补偿后会不会引起新的不一致? —— 补偿操作本身也可能失败或产生副作用
业界通常采用**"业务补偿"而非"数据补偿"**的思路:不直接修改数据库,而是重新触发业务操作(如重新发送消息、重新调用接口),让业务逻辑保证数据一致性。
2.3 最终一致性的时间窗口
最终一致性的核心参数是不一致窗口(Inconsistency Window):从数据写入到所有副本达成一致的时间间隔。
对账频率决定了最大不一致窗口。如果每天对账一次,最坏情况下不一致窗口是 24 小时。如果每小时对账一次,最坏情况是 1 小时。
在业务层面,需要根据业务容忍度确定对账频率。金融场景可能要求 T+0 对账(当天),电商场景可能 T+1 对账就可以接受。
三、差异发现
3.1 对账维度
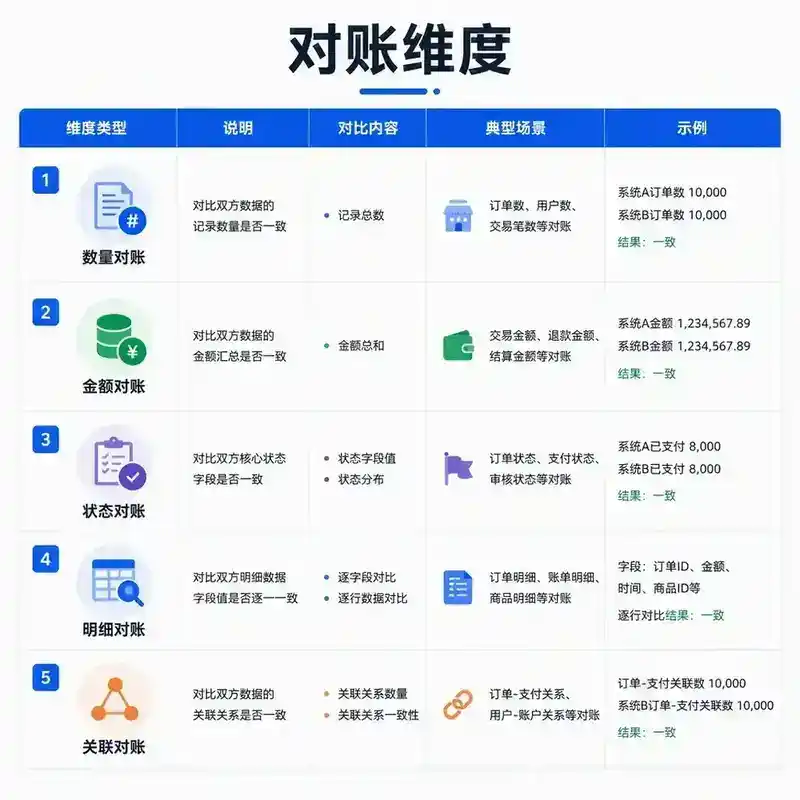
对账可以分为以下几个维度:
| 维度 | 说明 | 示例 |
|---|---|---|
| 数量对账 | 比对记录条数 | 订单表 10000 条,支付表 9998 条 |
| 金额对账 | 比对金额汇总 | 订单总额 100 万,支付总额 99.8 万 |
| 状态对账 | 比对核心状态字段 | 订单"已支付",支付"待支付" |
| 明细对账 | 逐条比对字段值 | 订单金额 100,支付金额 99 |
| 关联对账 | 比对关联关系 | 订单有对应的物流单号 |
3.2 全量对账 vs 增量对账
全量对账:每次对账都扫描两个数据源的全部数据。
- 优点:不漏任何差异,最彻底
- 缺点:数据量大时性能差,对数据库压力大
- 适用:数据量较小(百万级以内),或对账频率低(T+1)
增量对账:只对自上次对账以来变更的数据进行比对。
- 优点:数据量小,对账速度快
- 缺点:需要可靠的数据变更追踪机制(如 binlog、时间戳、版本号)
- 适用:数据量大,对账频率高
典型实现:增量对账 + 定期全量兜底。每天增量对账 N 次,每周全量对账一次作为兜底。
3.3 实时对账 vs 离线对账
实时对账:数据变更后立即(或秒级延迟)进行比对。
- 实现方式:监听 binlog → 实时比对引擎 → 差异告警
- 优点:发现快,不一致窗口小
- 缺点:对实时计算能力要求高,误报率高(正常业务延迟也可能触发差异)
离线对账:定时批量拉取数据,在离线计算引擎中比对。
- 实现方式:定时任务 → 数据抽取 → 批量比对 → 差异报告
- 优点:计算资源可控,比对逻辑灵活
- 缺点:发现延迟大
选型建议:核心交易链路用实时对账,非核心数据用离线对账。实时对账可以设置"延迟容忍窗口"(如 5 分钟),避免正常异步延迟被误报。
3.4 对账算法
!
哈希对账
对数据按 key 排序后,计算每个分片的哈希值。比对两个数据源的哈希值是否一致。哈希对账适合"快速判断有无差异",但无法定位具体差异记录。
// 哈希对账示意
public boolean hashReconcile(String queryA, String queryB) {
    // 对两边数据分别按 key 排序,计算 MD5
    String hashA = computeSortedHash(dataSourceA, queryA);
    String hashB = computeSortedHash(dataSourceB, queryB);
    return hashA.equals(hashB);
}
逐条对账
通过 key 关联两个数据源,逐条比对字段值。适合定位具体差异,但性能开销大。
// 逐条对账示意
public List<DiffRecord> detailReconcile(List<Record> sourceA, List<Record> sourceB) {
    Map<String, Record> mapB = sourceB.stream()
        .collect(toMap(Record::getKey, Function.identity()));
    List<DiffRecord> diffs = new ArrayList<>();
    for (Record a : sourceA) {
        Record b = mapB.get(a.getKey());
        if (b == null) {
            diffs.add(new DiffRecord(a.getKey(), DiffType.MISSING_IN_B));
        } else if (!a.equals(b)) {
            diffs.add(new DiffRecord(a.getKey(), DiffType.VALUE_MISMATCH, a, b));
        }
    }
    // 检查 B 有 A 无
    Set<String> keysA = sourceA.stream().map(Record::getKey).collect(toSet());
    for (Record b : sourceB) {
        if (!keysA.contains(b.getKey())) {
            diffs.add(new DiffRecord(b.getKey(), DiffType.MISSING_IN_A));
        }
    }
    return diffs;
}
抽样对账
对大数据集,随机抽样 N 条进行比对,用统计学方法估算差异率。适合对账精度要求不高的场景。
3.5 对账数据抽取策略
从数据源抽取对账数据时,需要考虑:
- 时间窗口:对账数据的时间范围,需要和业务延迟对齐
- 分页拉取:大数据量用游标分页,避免 offset 分页的性能陷阱
- 数据快照:对账过程中数据源不能变化,需要保证数据一致性快照。可以通过只读从库、指定时间戳等方式实现
- 并发控制:多线程/多节点并行拉取,注意避免重复和遗漏
四、重放机制
4.1 什么是重放
重放(Replay)是指将已发生的事件或数据变更按原始顺序重新执行一遍,以恢复目标数据源的状态。重放是对账后修复差异的核心手段之一。
4.2 事件重放
基于事件溯源(Event Sourcing)模式,所有业务操作以事件形式记录到事件存储中。当需要修复时,从事件存储中重放指定时间范围的事件。
事件存储(Event Store) → 事件消费者 → 目标数据源
关键设计点:
- 事件必须不可变(append-only),保证重放结果一致
- 事件必须包含完整上下文,不依赖外部状态
- 重放需要幂等,保证重复重放不产生副作用
4.3 消息重放
基于消息队列(如 Kafka、RocketMQ),将消息重新投递给消费者。
Kafka 重放:通过重置 Consumer Group 的 offset 实现。
// Kafka 重放示意
consumer.seekToBeginning(partitions); // 重放所有历史消息
// 或指定时间戳
Map<TopicPartition, OffsetAndTimestamp> offsets =
    consumer.offsetsForTimes(timestampMap);
offsets.forEach((tp, offset) -> consumer.seek(tp, offset.offset()));
RocketMQ 重放:通过消息回溯功能,按时间范围重新消费。
4.4 日志重放
基于数据库 binlog(MySQL)或 WAL(PostgreSQL),将数据库变更同步到目标数据源。
常用工具:Canal、Debezium、Flink CDC。
MySQL binlog → Canal → Kafka → 消费者 → 目标数据源
适用场景:
- 数据同步延迟导致的不一致
- 消费者故障导致的消息丢失
- 目标数据源数据修复
4.5 重放的幂等保障
重放的最大风险是重复处理导致数据二次损坏。幂等保障手段:
- 业务唯一键:通过业务唯一键(如订单号 + 事件类型)去重
- 版本号:数据带版本号,只处理版本号高于当前版本的变更
- 状态机:只允许合法状态转换(如"待支付→已支付"不允许重复)
- 去重表:维护已处理的事件 ID 集合,处理前先查去重表
// 幂等重放示意
public void replay(Event event) {
    // 1. 检查是否已处理
    if (dedupTable.exists(event.getEventId())) {
        return; // 已处理,跳过
    }
    // 2. 检查版本号
    Data current = dataStore.get(event.getKey());
    if (current != null && current.getVersion() >= event.getVersion()) {
        dedupTable.insert(event.getEventId()); // 标记已处理(不需要实际处理)
        return;
    }
    // 3. 执行重放
    dataStore.apply(event);
    // 4. 标记已处理
    dedupTable.insert(event.getEventId());
}
五、修复策略
5.1 修复决策树
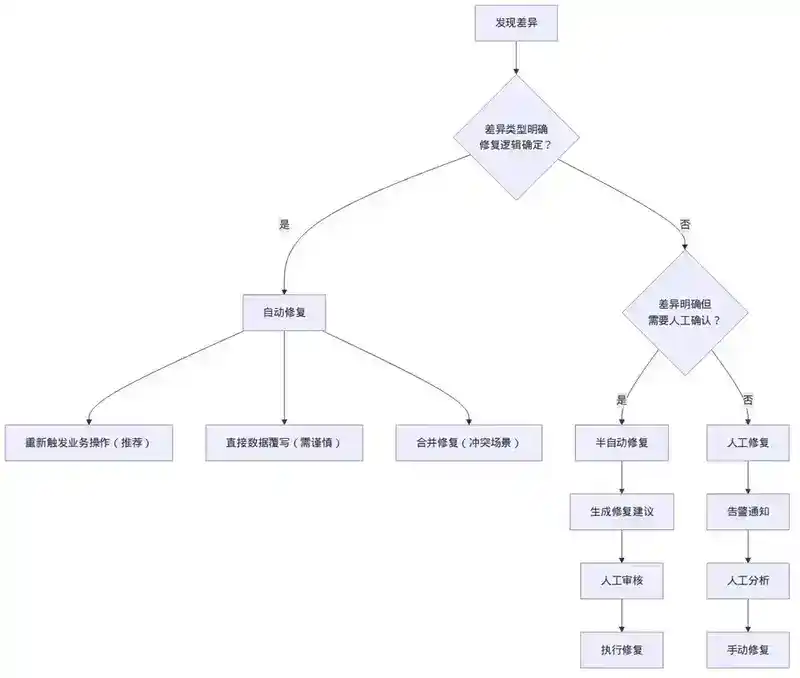
发现差异后,修复策略的选择取决于差异类型和业务影响:
发现差异
├── 自动修复(差异类型明确,修复逻辑确定)
│   ├── 重新触发业务操作(推荐)
│   ├── 直接数据覆写(需谨慎)
│   └── 合并修复(冲突场景)
├── 半自动修复(差异明确但需要人工确认)
│   └── 生成修复建议 → 人工审核 → 执行
└── 人工修复(差异复杂,需人工介入)
    └── 告警通知 → 人工分析 → 手动修复
5.2 以谁为准(数据源权威性)
修复前必须确定数据权威源(Source of Truth):
| 权威性模式 | 说明 | 示例 |
|---|---|---|
| 单一权威源 | 固定以某个数据源为准 | 以支付系统为准修复订单状态 |
| 时间戳优先 | 以最后更新的数据为准 | 以 update_time 较晚的数据为准 |
| 业务规则优先 | 根据业务规则判断 | 退款场景以退款单为准 |
| 人工判断 | 复杂场景人工介入 | 涉及金额纠纷的差异 |
5.3 修复的原子性
修复操作可能涉及多个数据源,需要考虑原子性:
- 单数据源修复:直接使用数据库事务
- 跨数据源修复:使用 Saga 模式或 TCC 模式,确保补偿操作可回滚
- 修复失败处理:记录失败详情,纳入人工处理队列
5.4 修复验证
修复完成后,需要进行二次对账验证修复结果:
public RepairResult repairAndVerify(DiffRecord diff) {
    // 1. 执行修复
    RepairResult repair = doRepair(diff);
    if (!repair.isSuccess()) {
        return repair.withStatus(RepairStatus.FAILED);
    }
    // 2. 二次对账验证
    DiffRecord recheck = reconcile(diff.getKey());
    if (recheck != null) {
        // 修复后仍有差异,标记为修复失败
        return repair.withStatus(RepairStatus.VERIFY_FAILED)
                     .withDetail(recheck);
    }
    // 3. 记录修复审计
    auditLog.record(diff, repair, recheck);
    return repair.withStatus(RepairStatus.SUCCESS);
}
六、审计体系
6.1 审计的必要性
对账与补偿不是"静默"运行的后台任务。在金融、支付、合规等场景,你需要:
- 证明"我们确实在做对账"
- 证明"发现的差异都已被修复"
- 证明"修复操作是正确的"
- 在发生问题时,能够追溯是哪个环节出了问题
6.2 审计日志设计
每条对账记录和修复记录都应包含:
对账审计记录:
├── 对账批次号(batch_id)
├── 对账时间
├── 对账数据源(A 和 B)
├── 对账范围(时间区间、数据量)
├── 差异数量
├── 差异明细列表
└── 对账结果摘要

修复审计记录:
├── 差异 ID
├── 修复时间
├── 修复方式(自动/人工)
├── 修复操作人
├── 修复前值 / 修复后值
├── 修复结果
└── 二次验证结果
6.3 审计追踪
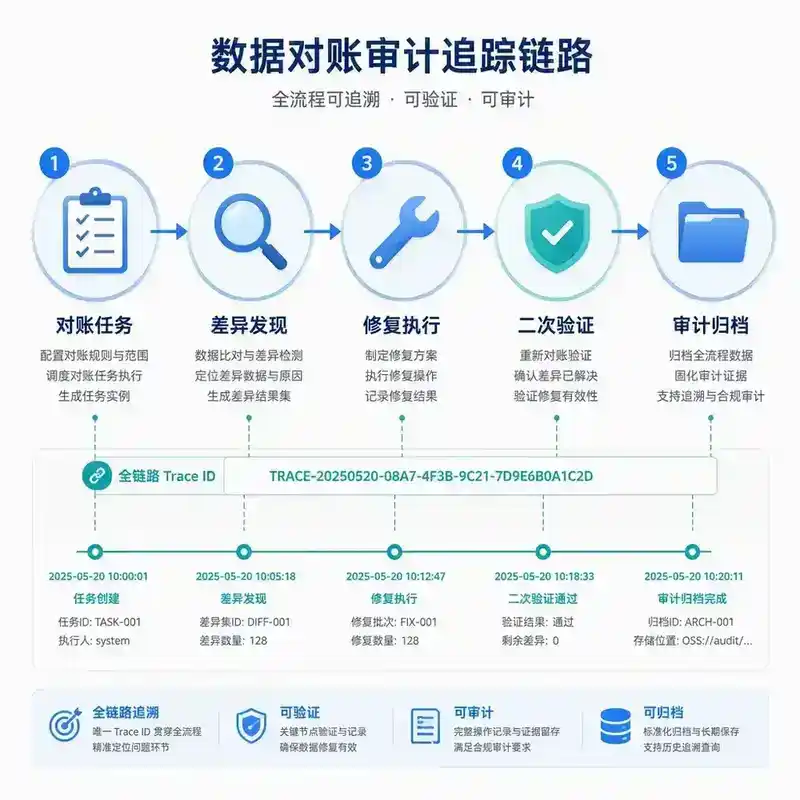
使用分布式链路追踪(Trace)关联对账→修复→验证的完整链路:
对账任务(Trace ID)→ 差异发现(Span)→ 修复执行(Span)→ 二次验证(Span)
这样,任何一个差异都可以追溯到完整的处理链路。
6.4 合规报表
定期生成对账合规报表,包含:
- 对账覆盖率(对账数据量 / 总数据量)
- 差异发现率(差异数量 / 对账数据量)
- 差异修复率(已修复差异 / 总差异)
- 修复时效(差异发现到修复完成的时间)
- 二次验证通过率
七、闭环设计
7.1 闭环的五个阶段
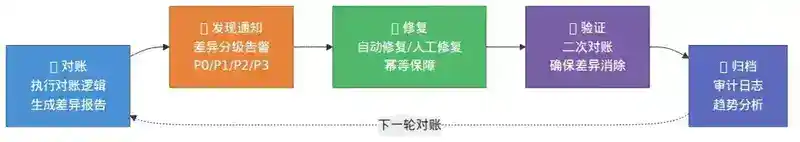
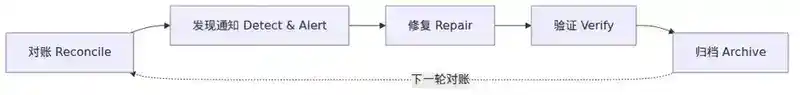
一个完整的对账补偿闭环包含五个阶段:
┌─────────────────────────────────────────────────────────┐
│                    对账补偿闭环                          │
│                                                         │
│  ┌──────┐   ┌──────┐   ┌──────┐   ┌──────┐   ┌──────┐ │
│  │ 对账  │──→│ 发现  │──→│ 修复  │──→│ 验证  │──→│ 归档  │ │
│  │      │   │ 通知  │   │      │   │      │   │      │ │
│  └──────┘   └──────┘   └──────┘   └──────┘   └──────┘ │
│      ↑                                         │        │
│      └─────────────────────────────────────────┘        │
│                    下一轮对账                            │
└─────────────────────────────────────────────────────────┘
阶段 1:对账——执行对账逻辑,生成差异报告。
阶段 2:发现通知——将差异按严重程度分级,通知相关人员。关键差异(如金额不一致)需要实时告警,非关键差异可以汇总日报。
阶段 3:修复——自动或人工修复差异。
阶段 4:验证——修复后二次对账,确保差异已消除。
阶段 5:归档——记录对账结果、修复记录、验证结果,用于审计和趋势分析。
7.2 告警分级
| 级别 | 定义 | 通知方式 | 响应时效 |
|---|---|---|---|
| P0 紧急 | 金额差异、核心交易数据不一致 | 电话 + 钉钉 + 短信 | 15 分钟 |
| P1 严重 | 状态不一致、关联数据缺失 | 钉钉群 + 短信 | 1 小时 |
| P2 一般 | 非核心字段不一致 | 钉钉群 | 4 小时 |
| P3 提示 | 少量对账失败、需人工确认 | 日报汇总 | 次日 |
7.3 对账频率与时效性 SLA
对账频率需要根据业务场景确定:
| 场景 | 对账频率 | 最大不一致窗口 | 修复时效 |
|---|---|---|---|
| 支付/金融 | 5-15 分钟 | 15 分钟 | 30 分钟 |
| 电商交易 | 1 小时 | 1 小时 | 2 小时 |
| 物流配送 | 2 小时 | 2 小时 | 4 小时 |
| 用户积分 | 4 小时 | 4 小时 | 8 小时 |
| 数据报表 | T+1 | 24 小时 | 48 小时 |
八、工程实践
8.1 对账系统架构
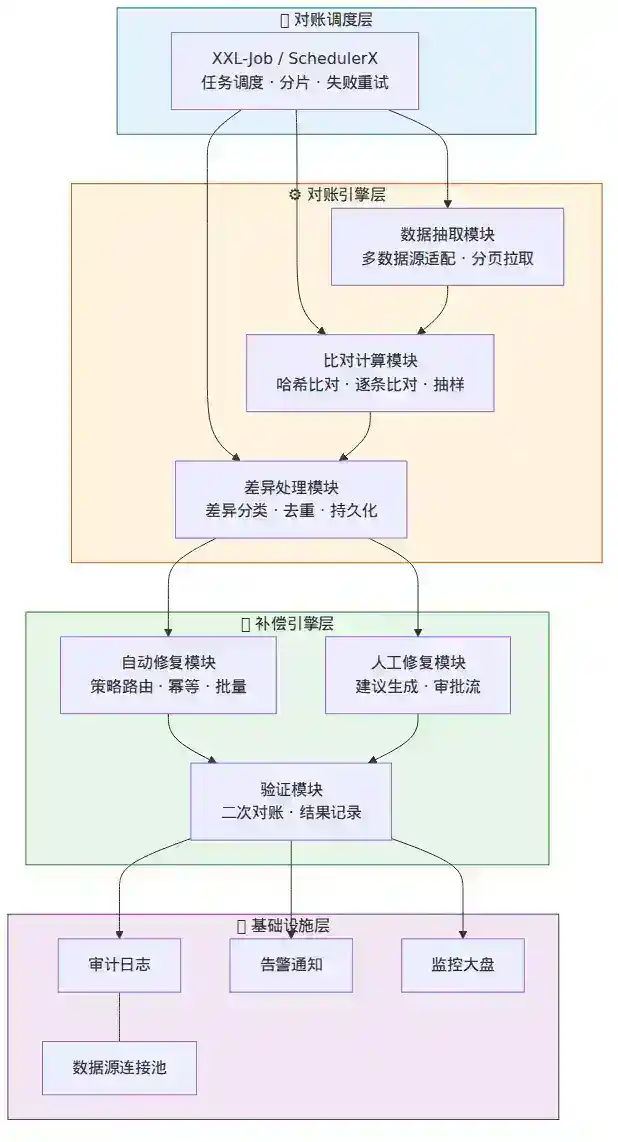
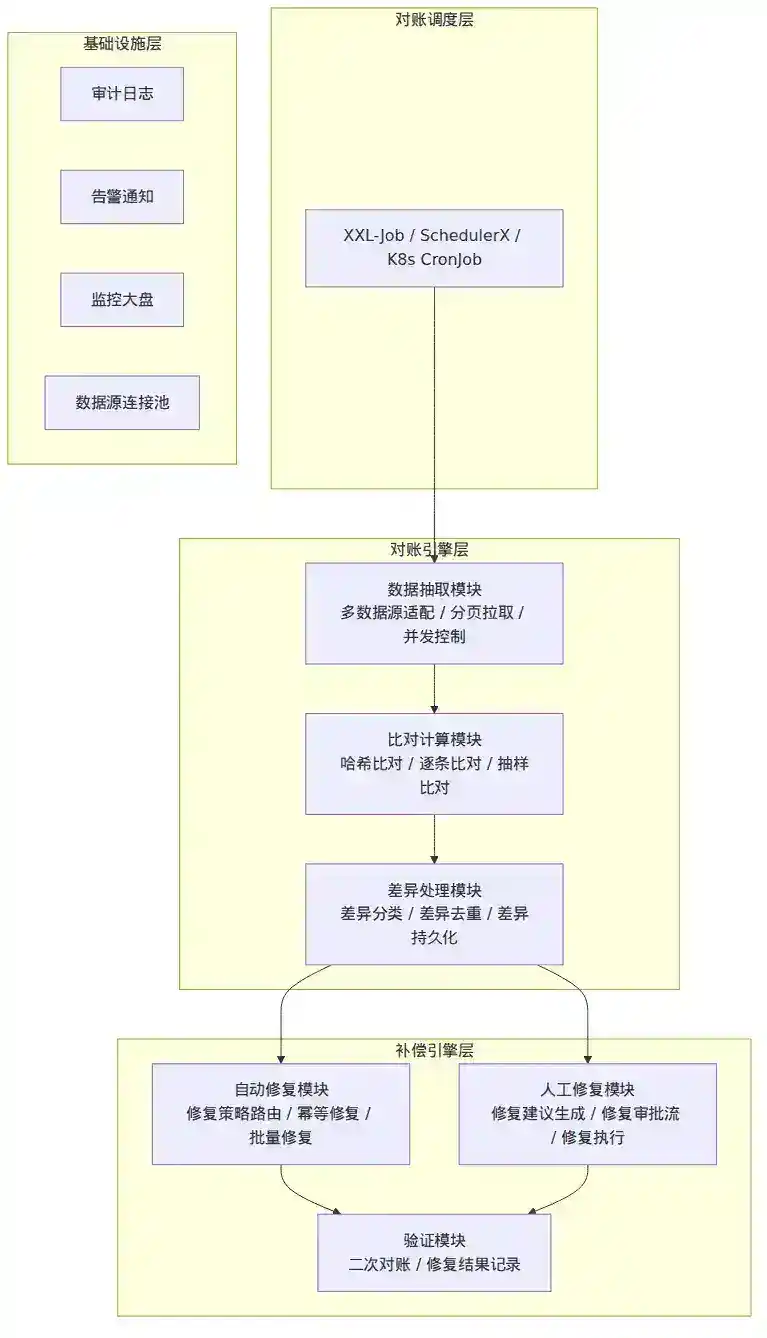
一个生产级对账系统的推荐架构:
┌──────────────────────────────────────────────────────────────┐
│                        对账调度层                              │
│  ┌──────────────────────────────────────────────────────────┐ │
│  │  XXL-Job / SchedulerX / K8s CronJob                      │ │
│  │  对账任务调度、分片、失败重试、监控                         │ │
│  └──────────────────────────────────────────────────────────┘ │
├──────────────────────────────────────────────────────────────┤
│                        对账引擎层                              │
│  ┌──────────────┐  ┌──────────────┐  ┌──────────────────────┐ │
│  │ 数据抽取模块   │  │ 比对计算模块   │  │ 差异处理模块          │ │
│  │ - 多数据源适配 │  │ - 哈希比对    │  │ - 差异分类            │ │
│  │ - 分页拉取    │  │ - 逐条比对    │  │ - 差异去重            │ │
│  │ - 并发控制    │  │ - 抽样比对    │  │ - 差异持久化          │ │
│  └──────────────┘  └──────────────┘  └──────────────────────┘ │
├──────────────────────────────────────────────────────────────┤
│                        补偿引擎层                              │
│  ┌──────────────┐  ┌──────────────┐  ┌──────────────────────┐ │
│  │ 自动修复模块   │  │ 人工修复模块   │  │ 验证模块              │ │
│  │ - 修复策略路由 │  │ - 修复建议生成 │  │ - 二次对账            │ │
│  │ - 幂等修复    │  │ - 修复审批流  │  │ - 修复结果记录        │ │
│  │ - 批量修复    │  │ - 修复执行    │  │                      │ │
│  └──────────────┘  └──────────────┘  └──────────────────────┘ │
├──────────────────────────────────────────────────────────────┤
│                        基础设施层                              │
│  ┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────────────┐ │
│  │ 审计日志  │ │ 告警通知  │ │ 监控大盘  │ │ 数据源连接池       │ │
│  └──────────┘ └──────────┘ └──────────┘ └──────────────────┘ │
└──────────────────────────────────────────────────────────────┘
8.2 对账任务的分片执行
对账数据量大时,需要分片并行执行。典型的分片策略:
// 对账任务分片示意
public class ShardingReconcileJob {
    public void execute(int shardIndex, int shardTotal) {
        // 按 key 取模分片,每个分片处理一部分数据
        // shardIndex: 当前分片编号 (0, 1, 2, ...)
        // shardTotal: 总分片数
        String sql = "SELECT * FROM orders " +
                     "WHERE MOD(CRC32(order_id), ?) = ? " +
                     "AND update_time BETWEEN ? AND ?";
        List<Order> orders = jdbcTemplate.query(sql,
            shardTotal, shardIndex, startTime, endTime);
        // 对当前分片数据进行对账
        reconcile(orders);
    }
}
8.3 对账结果存储
对账结果需要持久化,推荐表结构:
CREATE TABLE reconcile_batch (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    batch_id VARCHAR(64) NOT NULL UNIQUE COMMENT '对账批次号',
    task_type VARCHAR(64) NOT NULL COMMENT '对账类型',
    source_a VARCHAR(128) COMMENT '数据源A',
    source_b VARCHAR(128) COMMENT '数据源B',
    time_start DATETIME NOT NULL COMMENT '对账数据开始时间',
    time_end DATETIME NOT NULL COMMENT '对账数据结束时间',
    total_count INT COMMENT '对账总条数',
    diff_count INT COMMENT '差异条数',
    status VARCHAR(16) COMMENT 'PENDING/RUNNING/DONE/FAILED',
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_batch_id (batch_id),
    INDEX idx_task_type_time (task_type, created_at)
);

CREATE TABLE reconcile_diff (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    batch_id VARCHAR(64) NOT NULL COMMENT '对账批次号',
    diff_key VARCHAR(256) NOT NULL COMMENT '差异记录key',
    diff_type VARCHAR(32) COMMENT 'MISSING_IN_A/MISSING_IN_B/VALUE_MISMATCH',
    field_name VARCHAR(64) COMMENT '差异字段名',
    value_a TEXT COMMENT '数据源A的值',
    value_b TEXT COMMENT '数据源B的值',
    severity VARCHAR(8) COMMENT 'P0/P1/P2/P3',
    repair_status VARCHAR(16) COMMENT 'PENDING/AUTO_REPAIRED/MANUAL/FIXED/FAILED',
    repair_detail TEXT COMMENT '修复详情',
    verify_status VARCHAR(16) COMMENT 'PENDING/PASSED/FAILED',
    created_at DATETIME DEFAULT CURRENT_TIMESTAMP,
    updated_at DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
    INDEX idx_batch_id (batch_id),
    INDEX idx_repair_status (repair_status),
    INDEX idx_created_at (created_at)
);
九、常见陷阱
9.1 对账本身成为性能瓶颈
对账任务从数据源拉取大量数据,可能对生产数据库造成压力。
解决方案:
- 对账使用只读从库,不与主库竞争
- 控制对账并发度,错峰执行
- 增量对账代替全量对账
- 对账数据取样,不必全量
9.2 修复引发二次不一致
修复操作本身可能触发新的业务逻辑,导致新的不一致。例如:修复订单状态为"已支付"时,触发库存扣减,但库存已经扣减过了。
解决方案:
- 修复走"旁路"通道,不触发正常业务逻辑
- 修复前检查目标状态,避免重复操作
- 修复记录与业务操作区分标记
9.3 对账延迟过大
离线对账的延迟可能是 T+1,某些场景下 24 小时的不一致窗口不可接受。
解决方案:
- 核心链路引入实时对账
- 实时对账设置"延迟容忍窗口",避免误报
- 离线对账兜底,防止实时对账遗漏
9.4 对账逻辑与业务耦合
将对账的逻辑硬编码在各业务模块中,导致对账规则分散、难以维护。
解决方案:
- 对账作为独立的基础设施服务
- 对账规则配置化,通过配置定义对账维度、对账频率、修复策略
- 对账结果统一存储、统一告警
9.5 对账覆盖不全
只对账了"数量"和"金额",忽略了"状态"和"关联关系"的对账,导致有些差异发现不了。
解决方案:
- 建立对账覆盖率指标体系
- 定期审计对账覆盖范围
- 新增业务场景时同步新增对账规则
十、面试追问
以下问题从面试官视角设计,不仅考察对文档内容的理解,更考察你在实际项目中落地对账体系的能力。
Q1:你们项目的对账是实时还是离线?为什么选这个方案?如果让你重新设计,你会怎么改进?
考察点:对账方案选型的权衡能力,是否理解业务需求与技术的匹配。
参考思路:先描述业务场景的数据一致性要求(SLA、不一致容忍度),再谈选型理由。改进方向可以从"实时对账覆盖率"、"对账延迟优化"、"自动修复率提升"等角度展开。
Q2:对账发现差异后,你的自动修复率是多少?哪些场景不能自动修复,为什么?
考察点:对修复策略的深入理解,是否清楚自动修复的边界。
参考思路:自动修复适合"差异类型明确、权威源确定、修复逻辑固定"的场景(如消息重放、数据同步重试)。不适合的场景包括:涉及金额纠纷、权威源不明确、修复可能产生业务副作用。自动修复率一般 60%-80% 是合理的。
Q3:如果对账系统本身挂了,你怎么保证差异不丢失?
考察点:对账系统自身的高可用设计。
参考思路:可以从几个层面回答——对账任务的调度保障(调度中心高可用、任务失败重试)、对账进度的 checkpoint 机制(断点续跑)、对账源数据的保留策略(binlog 保留天数、数据快照)、以及告警机制(对账系统本身挂了要有告警)。
Q4:你怎么向业务方证明"数据已经一致了"?
考察点:审计和合规意识,以及与非技术角色的沟通能力。
参考思路:对账覆盖率报表、差异修复率报表、二次验证通过率、对账合规报告。关键是要有可量化的指标和可追溯的审计日志,而不是口头说"应该没问题"。
Q5:在设计对账系统时,你如何保证对账本身不会对业务数据库造成压力?
考察点:工程实践中的数据隔离意识。
参考思路:使用只读从库、增量对账、错峰执行、限制并发度、分页拉取(游标分页)、对账数据量阈值保护(超过阈值不执行全量对账)、对账任务优先级调度(低优先级、可被抢占)。
Q6:分布式事务(如 Seata AT)和对账补偿体系是什么关系?它们能互相替代吗?
考察点:对分布式一致性方案的全局理解。
参考思路:分布式事务是"预防"机制,通过协议保证操作的原子性;对账补偿是"检测+修复"机制,接受短暂不一致,通过异步手段修复。它们是互补关系,不是替代关系。分布式事务保证强一致性但牺牲性能和可用性,对账补偿追求最终一致性但需要接受不一致窗口。实际项目中往往是"核心链路用分布式事务兜底,非核心链路用对账补偿保障"。
总结
数据对账与补偿体系是分布式系统中确保数据最终一致性的基础设施。它由五个核心环节组成:差异发现、重放、修复、审计和闭环。一个成熟的对账体系需要做到:
- 全覆盖:数量、金额、状态、关联关系都要对账
- 快发现:增量实时对账 + 全量离线兜底,最小化不一致窗口
- 准修复:自动修复为主,人工修复兜底,修复后二次验证
- 可追溯:完整的审计日志和追踪链路
- 可量化:对账覆盖率、修复率、时效性等指标可度量
记住:对账不是目的,数据一致性才是目的。 对账补偿体系的价值不在于"发现了多少差异",而在于"让数据从不一致恢复到一致的能力和速度"。
下一篇预告:176|微服务拆分原则:业务边界、团队边界、数据边界和演进式拆分