前言
分布式事务是分布式系统中最棘手的问题之一。一个业务操作跨多个数据库、多个服务,如何保证数据一致性?Seata 的 AT(Automatic Transaction)模式是目前国内使用最广泛的分布式事务方案之一,它通过自动生成 undo log 和全局锁这两大核心机制,在业务零侵入的前提下实现了最终一致性。
本文从 Seata AT 模式的整体架构讲起,逐步深入到 undo log 的结构、全局锁的协调机制、分支事务的两阶段处理,以及在实际生产中经常被忽视的隔离性问题——这也是面试中最容易丢分的深水区。
一、分布式事务的困境
先看一个典型场景:电商下单。一个下单请求需要同时操作三个服务:
- 订单服务:创建订单记录(MySQL)
- 库存服务:扣减商品库存(MySQL)
- 账户服务:扣减用户余额(MySQL)
这三个操作分布在不同的数据库实例上,传统的数据库事务(ACID)无法跨库。如果库存扣减成功了,但余额扣减失败了,订单状态就会不一致。
常见的分布式事务方案有:
| 方案 | 一致性 | 性能 | 侵入性 |
|---|---|---|---|
| XA/2PC | 强一致 | 差(资源锁定) | 低 |
| TCC | 最终一致 | 好 | 高(需要实现 Try/Confirm/Cancel) |
| Saga | 最终一致 | 好 | 中(需要实现补偿) |
| 可靠消息 | 最终一致 | 好 | 中(需要本地消息表) |
| Seata AT | 最终一致 | 较好 | 极低(零侵入) |
Seata AT 的定位很清晰:在保证最终一致性的前提下,让业务代码几乎不需要改动。这背后靠的就是 undo log 自动回滚和全局锁防脏写。
二、Seata AT 模式整体架构
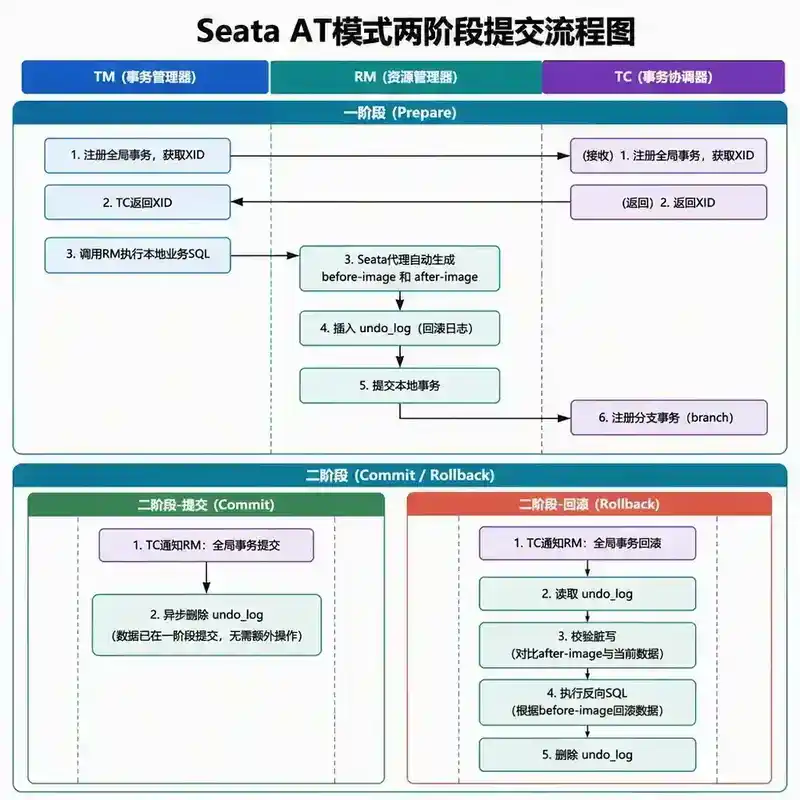
Seata AT 模式沿用了 Seata 经典的三角色架构,但两阶段的行为与 XA 模式有本质区别。
2.1 三角色模型
- TC(Transaction Coordinator):Seata Server 的核心,负责维护全局事务的注册、状态流转和全局锁管理。
- TM(Transaction Manager):标注
@GlobalTransactional的方法所在的服务,负责定义全局事务的边界。 - RM(Resource Manager):参与事务的各个微服务,通过 Seata 的数据源代理(DataSourceProxy)自动管理分支事务。
2.2 两阶段流程概览
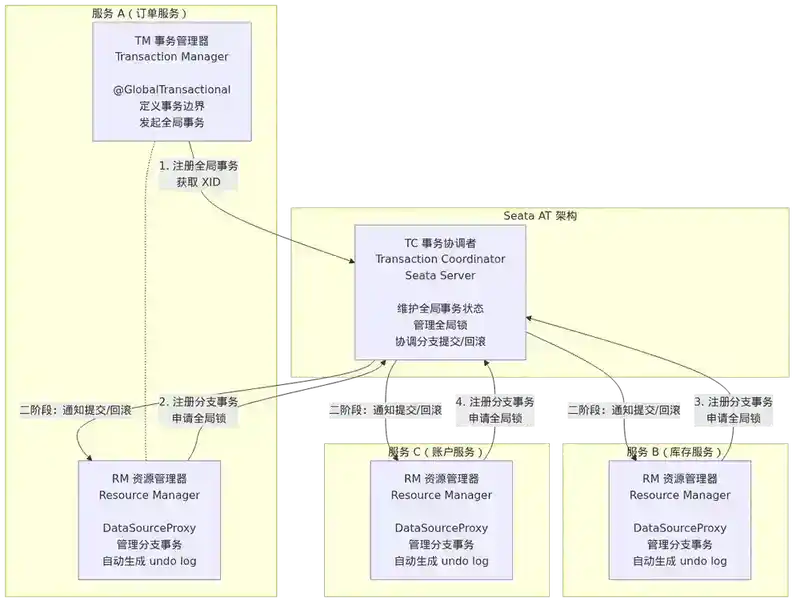
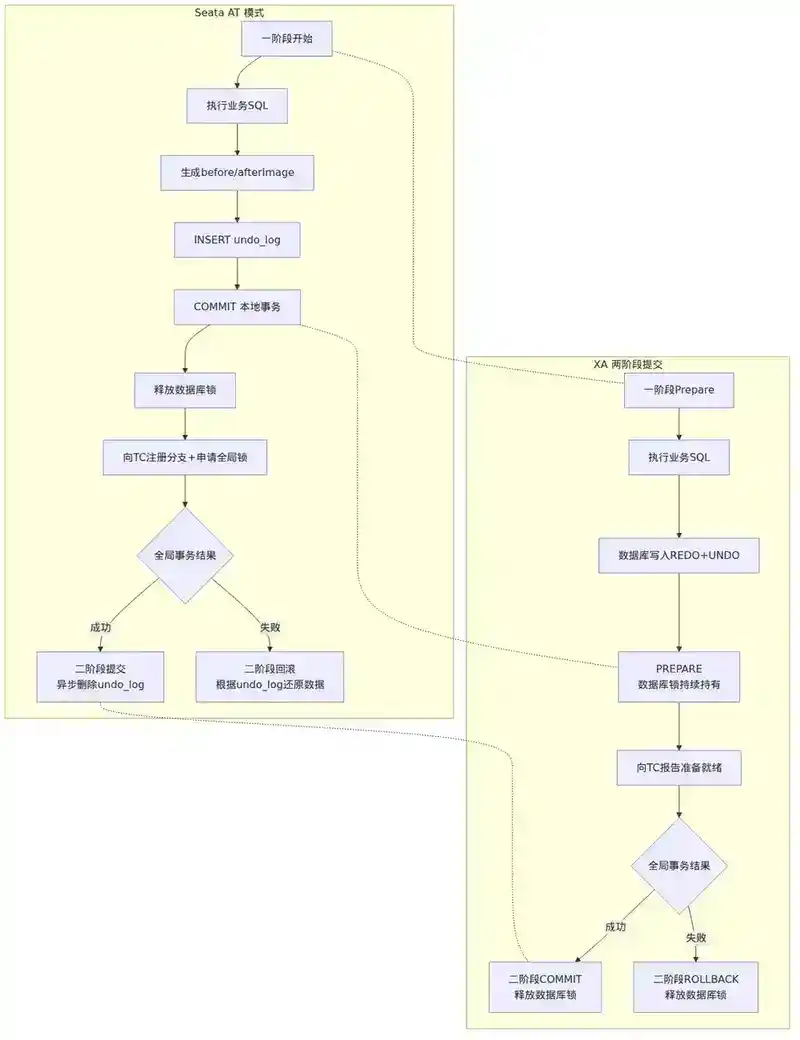
AT 模式的两阶段与 XA 的关键区别在于:一阶段各分支事务就已经提交了本地事务,而不是像 XA 那样一直持有数据库锁等到二阶段。
一阶段(Prepare):
- TM 向 TC 注册全局事务,获取 XID(全局事务 ID)
- 每个 RM 执行本地 SQL 时,Seata 代理层自动解析 SQL,生成前置镜像(before image)和后置镜像(after image)
- 将镜像数据组装成 undo log,插入
undo_log表,与业务 SQL 在同一个本地事务中提交 - RM 向 TC 注册分支事务,报告执行结果
二阶段(Commit/Rollback):
- 全局提交:TC 通知各 RM 异步删除对应的 undo log(因为一阶段已经提交了,不需要再做任何事)
- 全局回滚:TC 通知各 RM 根据 undo log 的前置镜像生成回滚 SQL,还原数据;然后删除 undo log
三、undo log 机制深度解析
undo log 是 Seata AT 模式最核心的机制。它让"自动回滚"成为可能,也是 AT 模式能在业务零侵入的前提下实现回滚的根本原因。
3.1 undo log 的生成过程
Seata 通过 DataSourceProxy 代理了业务的数据源。当业务代码执行一条 SQL 时,实际流程是:
业务 SQL(如 UPDATE product SET stock = stock - 1 WHERE id = 100)
        │
        ▼
┌─────────────────────────────────────┐
│ 1. 前置查询:SELECT stock FROM       │
│    product WHERE id = 100 FOR UPDATE │  ← 先查当前值,同时加锁
│    → before_image: {stock: 50}       │
├─────────────────────────────────────┤
│ 2. 执行业务 SQL:                     │
│    UPDATE product SET stock = 49     │
│    WHERE id = 100                    │
├─────────────────────────────────────┤
│ 3. 后置查询:SELECT stock FROM       │
│    product WHERE id = 100            │
│    → after_image: {stock: 49}        │
├─────────────────────────────────────┤
│ 4. 组装 undo log 并插入 undo_log 表  │
│    (与业务 SQL 在同一本地事务中)     │
└─────────────────────────────────────┘
3.2 undo log 的数据结构
一条 undo log 记录包含以下关键字段:
| 字段 | 说明 |
|---|---|
branch_id |
分支事务 ID |
xid |
全局事务 ID |
context |
上下文信息(序列化后的元数据) |
rollback_info |
回滚信息(核心,包含前后镜像) |
log_status |
日志状态(0:正常, 1:全局已完成) |
log_created / log_modified |
时间戳 |
rollback_info 是核心,它是一个 JSON 结构:
{
  "branchId": 123456789,
  "undoItems": [{
    "beforeImage": {
      "tableName": "product",
      "rows": [{
        "fields": [
          {"name": "id", "type": 4, "value": 100},
          {"name": "stock", "type": 4, "value": 50}
        ]
      }]
    },
    "afterImage": {
      "tableName": "product",
      "rows": [{
        "fields": [
          {"name": "id", "type": 4, "value": 100},
          {"name": "stock", "type": 4, "value": 49}
        ]
      }]
    },
    "sqlType": "UPDATE"
  }]
}
3.3 回滚如何执行
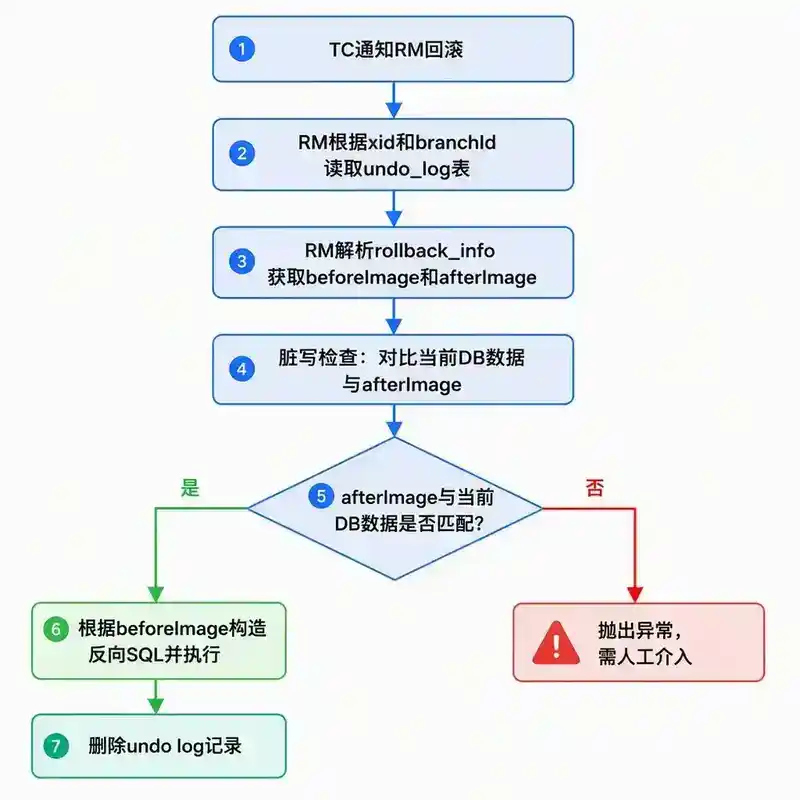
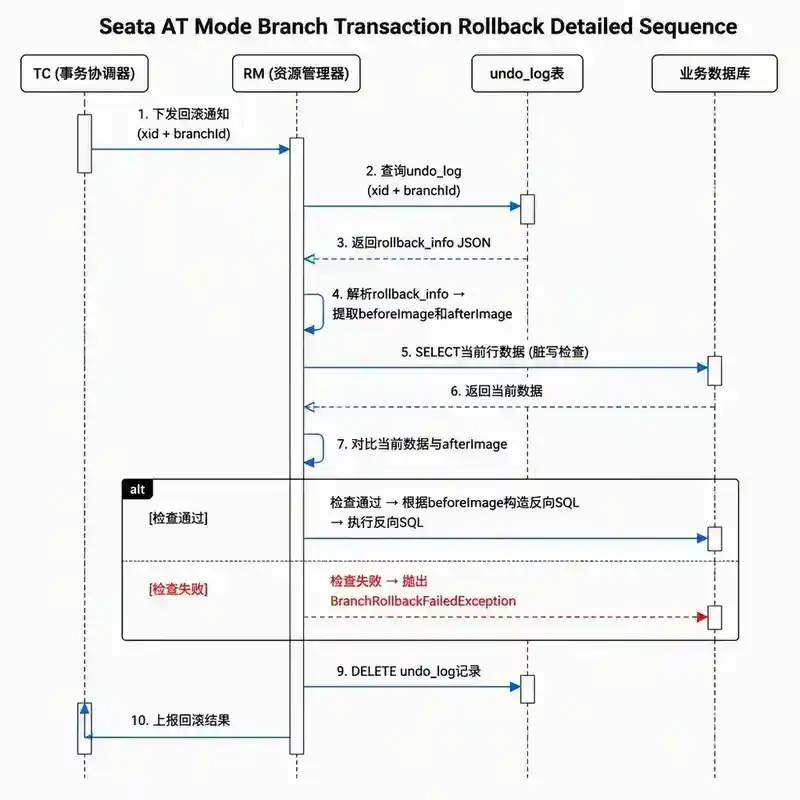
当全局事务需要回滚时,TC 通知各 RM 执行回滚。RM 拿到 rollback_info 后:
- 解析
beforeImage和afterImage - 用
afterImage与当前数据库中的数据做脏写校验(对比当前值是否等于 after_image) - 如果一致,根据
beforeImage构造反向 SQL(如UPDATE product SET stock = 50 WHERE id = 100) - 执行反向 SQL,还原数据
- 删除 undo log 记录
3.4 脏写校验
脏写校验是 Seata AT 模式保证数据正确性的关键机制。在回滚之前,RM 会对比当前数据库记录与 afterImage 是否一致:
- 一致:说明在全局事务的一阶段到二阶段回滚之间,没有其他事务修改过这条数据,可以安全回滚。
- 不一致:说明有"脏写"——其他事务在一阶段提交后、全局回滚前修改了数据。此时 Seata 无法自动回滚,需要人工介入处理。
这个机制本质上是一种乐观锁策略:用 after_image 作为版本号,回滚时检查版本是否匹配。
四、全局锁机制
4.1 为什么需要全局锁
AT 模式的一阶段就提交了本地事务,数据库的本地锁随之释放。这意味着在全局事务尚未完成(提交或回滚)之前,其他事务就有可能读到并修改这些数据,导致脏读和脏写。
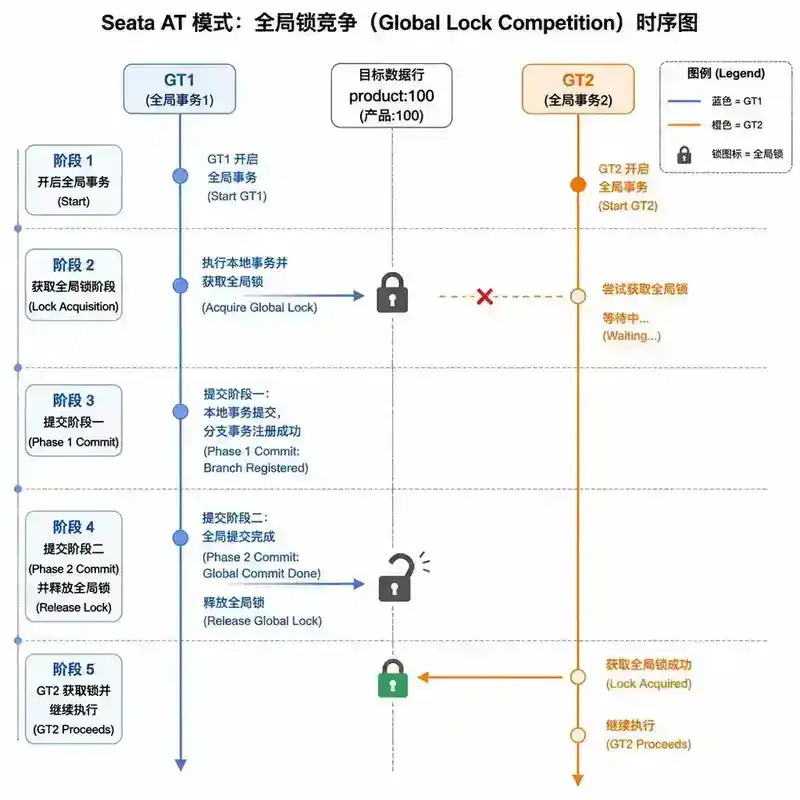
Seata 通过全局锁来解决这个问题:一个全局事务在一阶段提交后,虽然释放了数据库锁,但它在 TC 端持有这些数据的全局锁,防止其他全局事务修改同一行数据。
4.2 全局锁的获取与释放
全局锁的生命周期:
全局事务开始
    │
    ▼
一阶段:各 RM 提交本地事务时,向 TC 注册分支
    │   同时申请全局锁(锁定被修改的行)
    │   全局锁信息:{xid, branchId, tableName, pkValues}
    │
    ▼
[全局锁持有期间]
    │   其他全局事务尝试修改同一行时,需要先获取全局锁
    │   如果锁被占用,会不断重试(可配置重试次数和间隔)
    │
    ▼
二阶段完成(提交或回滚)
    │
    ▼
释放全局锁
4.3 全局锁的存储
全局锁存储在 TC 端(Seata Server),数据结构大致如下:
LOCK_TABLE:
  row_key: 表名 + 主键值(如 "product:100")
  xid: 持有该锁的全局事务 ID
  branch_id: 分支事务 ID
  table_name: 表名
  pk: 主键值
TC 使用内存 + 数据库(或 Redis)存储全局锁,确保 TC 重启后能恢复锁状态。
4.4 全局锁的重试与超时
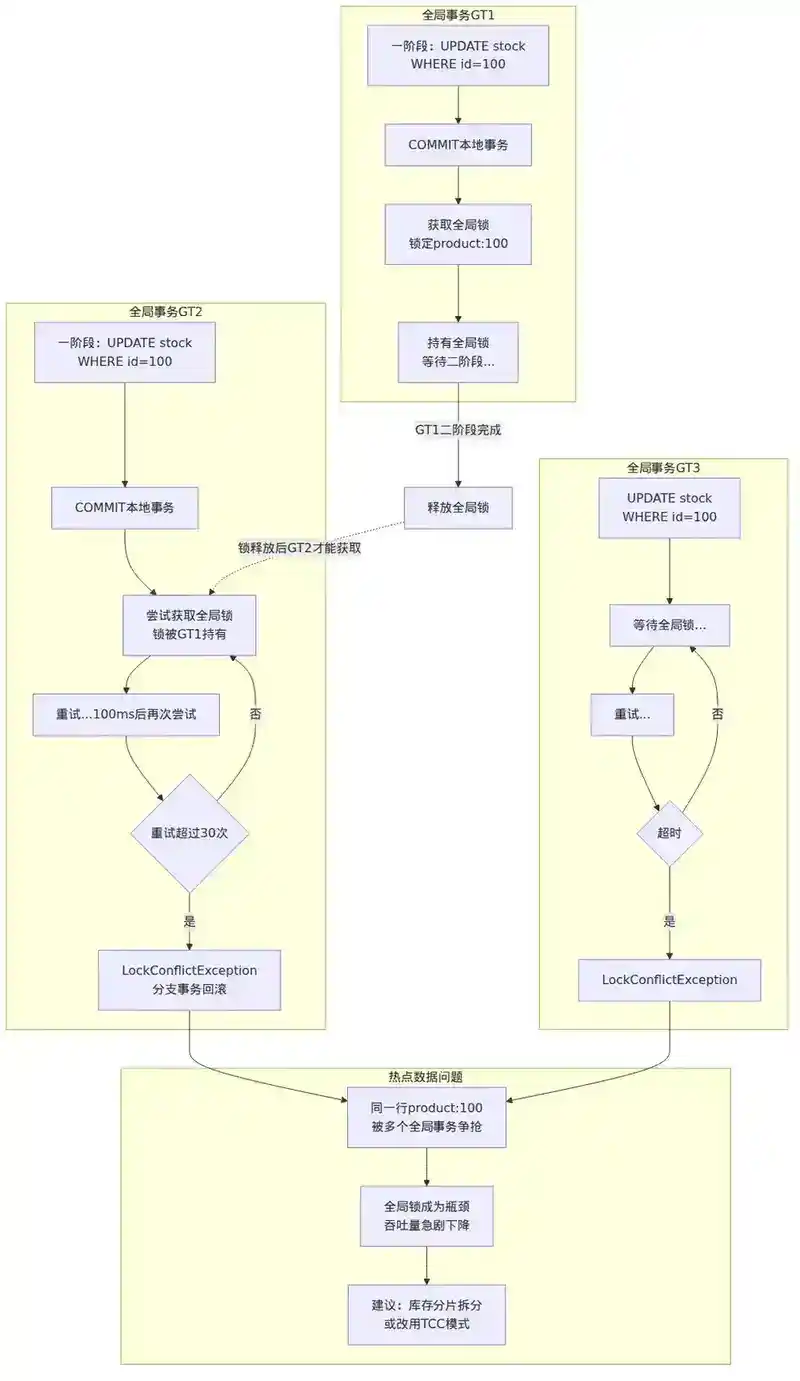
当 RM 尝试获取全局锁失败时(锁被其他全局事务持有),Seata 会:
- 在一定时间内循环重试(默认重试间隔 100ms,重试次数 30 次)
- 如果超时仍未获取到锁,抛出
**LockConflictException**,该分支事务回滚 - 全局事务中任何一个分支获取锁失败,整个全局事务回滚
关键配置:
# 全局锁重试间隔(毫秒)
client.rm.lock.retryInterval=100
# 全局锁重试次数
client.rm.lock.retryTimes=30
# 全局锁存活时间(毫秒),防止死锁
client.rm.lock.retryPolicyBranchRollbackOnConflict=true
五、分支事务详解
5.1 分支注册
每个参与全局事务的 RM 在执行完本地业务 SQL 后,会向 TC 注册一个分支事务:
注册请求包含:
- xid(全局事务 ID)
- branchId(分支事务 ID,由 RM 本地生成)
- resourceId(数据源标识)
- lockKeys(需要锁定的行键列表)
- applicationData(应用数据,如 undo log 的主键)
5.2 分支提交(二阶段提交)
当 TC 通知 RM 执行分支提交时,RM 只需要做一件事:删除对应的 undo log 记录。因为数据已经在一阶段提交了,二阶段提交实际上是一个"清理"操作。
-- 分支提交:删除 undo log
UPDATE undo_log SET log_status = 1 WHERE branch_id = ? AND xid = ?
这是一个异步操作,即使删除失败也不影响业务数据的一致性,只会留下一条无用的 undo log 记录(后续可以定期清理)。
5.3 分支回滚(二阶段回滚)
当 TC 通知 RM 执行分支回滚时,流程如下:
- 根据
xid和branchId查询undo_log表 - 解析
rollback_info字段,获取 beforeImage 和 afterImage - 执行脏写校验:对比当前数据与 afterImage
- 校验通过 → 根据 beforeImage 构造并执行反向 SQL
- 校验失败 → 抛出异常,需要人工处理
- 删除 undo log 记录
六、隔离性——AT 模式最容易被忽视的问题
这是面试中区分高级和初级的分水岭。AT 模式虽然方便,但它的隔离性存在局限。
6.1 读已提交(Read Committed)——默认隔离级别
AT 模式默认的全局隔离级别是读未提交(Read Uncommitted),但可以通过配置升级为读已提交(Read Committed)。
读未提交的问题:
全局事务 GT1:UPDATE product SET stock = 50 WHERE id = 100  (一阶段提交,数据已写入)
全局事务 GT2:SELECT stock FROM product WHERE id = 100        (读到 stock=50)
全局事务 GT1:二阶段回滚(stock 还原为 100)
GT2 读到了 GT1 一阶段提交但最终回滚的中间数据(stock=50),这就是脏读。
读已提交的解决方案:在 SELECT 语句中自动添加 FOR UPDATE,这样在读取数据前先尝试获取全局锁。如果全局锁被其他事务持有,就会等待,从而避免了脏读。
# 配置全局事务隔离级别为读已提交
client.rm.sqlParserType=druid
# 通过代理层对 SELECT 语句做增强
6.2 写隔离——全局锁的局限性
全局锁只能防止两个全局事务同时修改同一行数据,但不能防止以下场景:
场景 1:全局事务与本地事务的并发
GT1(全局事务):一阶段提交,stock=50,持有全局锁
本地事务(非 Seata 管理):UPDATE product SET stock = 30 WHERE id = 100
本地事务不经过 Seata 代理,不会检查全局锁,直接修改了数据。当 GT1 回滚时,脏写校验会发现 afterImage 与当前数据不一致,回滚失败。
场景 2:跨记录的幻读
GT1:INSERT INTO product (id, name, stock) VALUES (101, '新商品', 100)
GT1:一阶段提交,持有全局锁(product:101)
GT2:SELECT COUNT(*) FROM product WHERE stock > 50
GT2 的 SELECT 可能走全表扫描,不会去逐行申请全局锁,所以 GT2 可能读到 GT1 插入但尚未全局提交的数据。
6.3 隔离性总结
| 隔离级别 | AT 模式支持 | 实现方式 | 限制 |
|---|---|---|---|
| 读未提交 | 默认 | 不加锁 | 存在脏读 |
| 读已提交 | 可配置 | SELECT FOR UPDATE 获取全局锁 | 性能有损耗 |
| 可重复读 | 不支持 | — | — |
| 串行化 | 不支持 | — | — |
关键结论:AT 模式本质上是最终一致性方案,不适合需要强一致性的场景。如果你的业务需要严格的隔离性(如金融转账),应该考虑 TCC 模式或 Saga 模式。
七、undo_log 表的设计与运维
7.1 推荐的表结构
每个参与 AT 模式分布式事务的数据库都需要创建 undo_log 表:
CREATE TABLE `undo_log` (
  `id` bigint(20) NOT NULL AUTO_INCREMENT,
  `branch_id` bigint(20) NOT NULL COMMENT '分支事务ID',
  `xid` varchar(128) NOT NULL COMMENT '全局事务ID',
  `context` varchar(128) NOT NULL COMMENT '上下文',
  `rollback_info` longblob NOT NULL COMMENT '回滚信息(before/after image)',
  `log_status` int(11) NOT NULL COMMENT '日志状态 0:正常 1:全局已完成',
  `log_created` datetime NOT NULL COMMENT '创建时间',
  `log_modified` datetime NOT NULL COMMENT '修改时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `ux_undo_log` (`xid`, `branch_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
7.2 运维要点
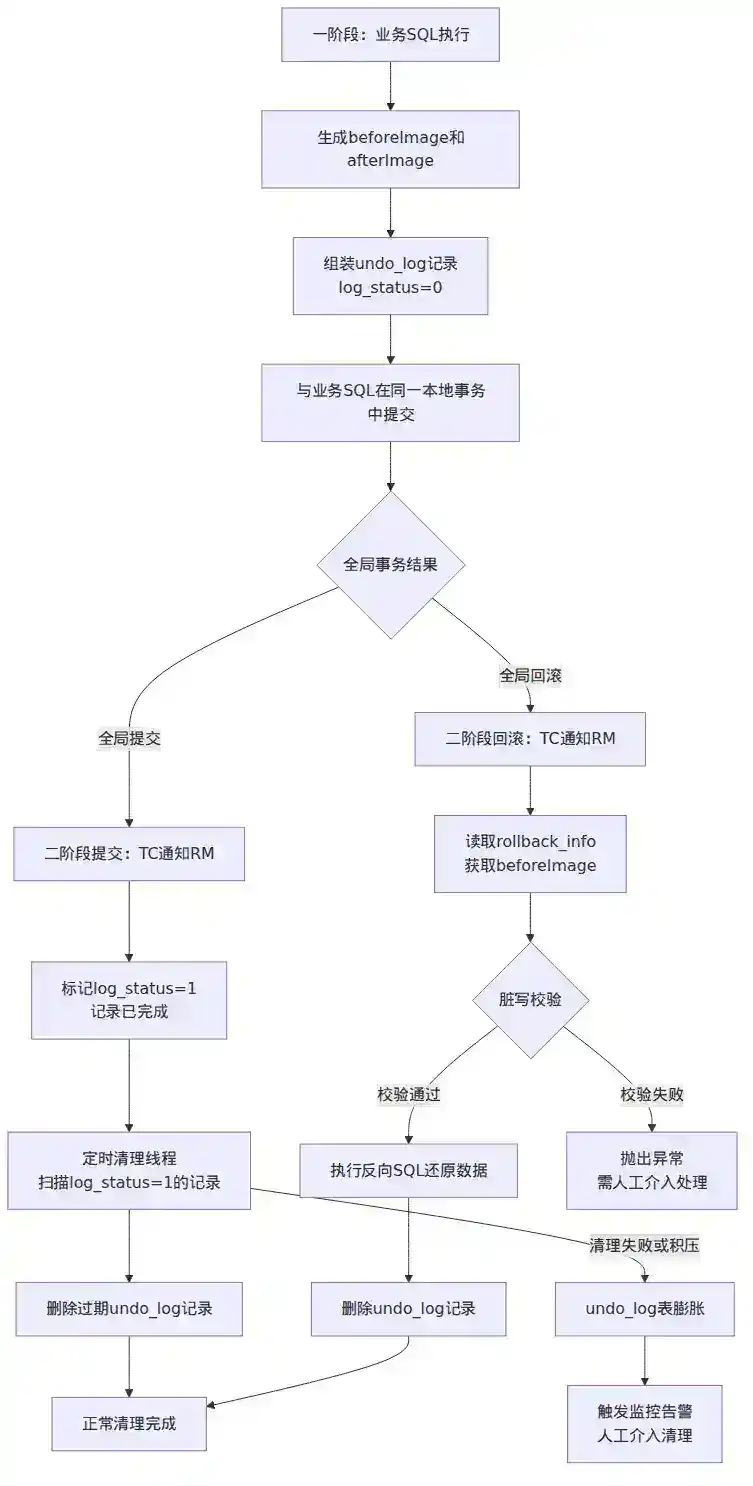
- 定期清理:已完成的全局事务的 undo log(log_status=1)需要定期清理,否则表会无限增长。Seata 提供了自动清理线程,但需要确保配置正确。
- 防膨胀:业务 SQL 如果一次更新大量行,对应的 undo log 也会很大。建议在业务层面控制批量操作的行数。
- 监控:监控 undo_log 表的大小和积压情况,undo log 的异常增长往往意味着全局事务卡住或二阶段清理失败。
八、AT 模式 vs 其他分布式事务方案
| 维度 | AT 模式 | TCC | Saga | XA |
|---|---|---|---|---|
| 业务侵入性 | 极低(零代码改动) | 高(需实现三个接口) | 中(需实现补偿) | 低 |
| 一致性 | 最终一致 | 最终一致 | 最终一致 | 强一致 |
| 性能 | 较好 | 好 | 好 | 差 |
| 回滚方式 | 自动(undo log) | 手工(Cancel) | 手工(补偿) | 自动(数据库) |
| 全局锁 | 有 | 无 | 无 | 有(数据库锁) |
| 适用场景 | 通用 CRUD | 有资源预留需求 | 长事务 | 强一致性要求 |
| 数据库支持 | 需要 undo_log 表 | 不限制 | 不限制 | 需要数据库支持 XA |
九、生产实践与常见陷阱
9.1 全局锁超时导致业务失败
现象:高并发场景下,大量请求报 LockConflictException,业务大面积失败。
原因:多个全局事务修改同一行数据(热点数据),全局锁竞争激烈,超过重试次数后直接抛异常。
解决:
- 在业务层面避免热点数据(如库存分片)
- 调整
client.rm.lock.retryTimes和retryInterval - 对热点数据使用 TCC 模式代替 AT 模式(TCC 的资源预留模式更适合热点场景)
9.2 undo log 回滚失败
现象:全局事务回滚时,脏写校验失败,报 BranchRollbackFailedException。
原因:在一阶段提交后、二阶段回滚前,有非 Seata 管理的事务修改了同一行数据。
解决:
- 确保所有修改 Seata 管理表的操作都走 Seata 代理数据源
- 配置脏写校验失败后的处理策略(人工介入 or 自动重试)
- 减少全局事务的执行时间,缩小窗口期
9.3 TC 单点故障
现象:Seata Server 宕机,所有全局事务无法推进。
解决:
- Seata Server 部署为集群模式(使用数据库或 Redis 存储事务状态)
- 配置 TM/RM 的重试和超时机制
- 监控 TC 的健康状态
9.4 大事务回滚耗时长
现象:一个全局事务包含大量分支,回滚时逐个分支回滚,耗时很长。
解决:
- 控制全局事务的粒度,避免一个全局事务包含过多分支
- 对于批量操作,分批使用多个小的事务
- 考虑使用 Saga 模式处理长事务
十、面试追问
以下问题从面试官视角设计,用于检验是否真正理解 AT 模式的原理和边界。
Q1:Seata AT 模式的 undo log 和 MySQL 的 undo log 有什么区别?
Q2:为什么 AT 模式的一阶段就直接提交了本地事务,而不是像 XA 那样等到二阶段?
Q3:AT 模式的全局锁和数据库行锁有什么关系?如果全局事务 A 持有全局锁,非全局事务 B 能否修改同一行数据?
Q4:假如一个全局事务包含 10 个分支,其中第 9 个分支执行失败。此时 TC 开始通知各分支回滚。但第 1 个分支所在的服务在回滚之前刚好重启了,这个分支能正确回滚吗?
Q5:如何设计一个监控方案,及时发现 AT 模式下的全局锁冲突和 undo log 积压问题?
Q6:AT 模式声称"业务零侵入",但实际使用时有哪些隐性的约束和限制?
Q7:如果在 AT 模式的全局事务中调用了一个外部 API(如发送短信),这个操作如何保证一致性?
Q8:Seata AT 模式的 undo log 何时删除?如果删除失败会有什么影响?
参考答案
A1:MySQL 的 undo log 是 InnoDB 存储引擎层面的,用于实现 MVCC 和事务回滚,存储在共享表空间或 undo 表空间中,是数据库内核机制。Seata AT 的 undo log 是应用层的,存储在业务库的 undo_log 表中,内容为 beforeImage 和 afterImage,用于分布式事务的回滚。前者是"物理+逻辑"层面的,后者是"业务数据快照"层面的。
A2:这是 AT 模式设计的核心权衡。一阶段直接提交可以尽早释放数据库的本地锁,减少锁竞争,提升并发性能。代价是需要在应用层(通过全局锁 + undo log)来补偿可能的数据不一致。如果像 XA 那样等到二阶段,数据库锁会一直持有到全局事务结束,在高并发下性能会急剧恶化。
A3:全局锁是 Seata TC 层面的逻辑锁,数据库行锁是数据库层面的物理锁,两者是独立的。非全局事务(不经过 Seata 代理的 SQL)可以绕过全局锁直接修改数据——这就是 AT 模式的"写隔离"漏洞。如果发生这种情况,GT 回滚时脏写校验会失败。
A4:能。因为 RM 在一阶段就将 undo log 写入了本地数据库的 undo_log 表,并且这个写入与业务 SQL 在同一个本地事务中提交了。即使服务重启,TC 通知回滚时,RM 可以从 undo_log 表中读取到持久化的回滚信息,正常执行回滚。
A5:监控方案包括:① 监控 undo_log 表的数据量增长趋势,设置阈值告警;② 监控 Seata Server 的全局锁等待队列长度和超时次数;③ 在业务代码中捕获 LockConflictException,记录日志并上报指标;④ 监控全局事务的平均耗时和回滚率,异常波动时告警。
A6:隐性约束包括:① 所有参与 AT 的数据库必须创建 undo_log 表;② 所有修改操作必须走 Seata DataSourceProxy,不能绕过;③ 不支持批量 UPDATE/DELETE 的精确回滚(因为 afterImage 可能不完整);④ 数据库必须支持事务(如 InnoDB),不支持 MyISAM;⑤ 对于热点数据,全局锁竞争可能成为瓶颈。
A7:AT 模式无法自动控制外部 API 的一致性。解决方案:① 将外部 API 调用放在全局事务的最后一个分支,这样即使失败也只需补偿这一个分支;② 使用本地消息表 + 定时任务保证最终一致性;③ 使用 Saga 模式,将外部 API 调用作为一个独立的补偿节点。
A8:undo log 在二阶段提交时标记为"已完成"(log_status=1),后续由 Seata 的定时清理线程异步删除。如果删除失败,只会在 undo_log 表中留下一条无用记录,不影响业务数据的一致性。但长期不清理会导致表膨胀,影响查询性能,所以需要确保障清理线程正常运行。
本文为"Java 技术专家 / 架构师面试:250 个高频考点"系列第 170 篇。下一篇:171|分布式 ID:UUID、数据库号段、Snowflake 的趋势递增与时钟回拨。