一、问题定义:分布式系统的"不一致之痛"
想象一个场景:你在淘宝上抢到了一部限量版手机,付款成功、订单显示"已支付",但回头一看库存却显示"已售罄"——你的订单被取消了。这是什么原因?答案是分布式系统的一致性问题。
在单体架构中,所有数据操作都在同一个数据库事务中完成,ACID 保证了强一致性。但分布式系统将数据分散到多个节点上,网络延迟、节点故障、并发写入等因素使得"所有节点同时看到相同数据"成为一件极其困难的事。
一致性模型(Consistency Model)正是用来描述和约束"在一个分布式系统中,数据和操作的可见性顺序"的形式化约定。它本质上是系统对程序员做出的承诺——当多个客户端并发读写数据时,系统保证什么样的行为。
为什么需要一致性模型?
- 正确性保证:某些业务场景(如银行转账、库存扣减)必须保证数据不会出现"多扣"或"少扣"
- 性能权衡:更强的一致性意味着更高的延迟和更低的吞吐,需要根据业务场景选择合适级别
- 可编程性:强一致性模型让程序员可以像写单机程序一样写分布式程序,而弱一致性模型则需要程序员自己处理不一致
- 故障容错:在分区故障(Partition)发生时,系统需要在一致性和可用性之间做出选择
阅读本文,你将理解五种核心一致性模型的定义、原理、实现机制和生产实践。
二、一致性模型全景图

在深入每种模型之前,先建立整体认知。一致性模型可以从两个维度分类:
- 以数据为中心的模型:关注整个系统对外呈现的数据状态,如强一致、顺序一致、因果一致、最终一致
- 以客户为中心的模型:关注单个客户端视角下的数据一致性保证,如会话一致、单调读、单调写、写后读
本文聚焦的五种模型覆盖了从最强到最弱的完整光谱:
强一致性 ──→ 顺序一致性 ──→ 因果一致性 ──→ 会话一致性 ──→ 最终一致性
  (最强)                                                      (最弱)
  高延迟                                                      低延迟
  低可用(分区时)                                              高可用
核心洞察:一致性模型本质上是在定义"操作的合法执行历史"。当多个客户端并发发出读写请求时,一致性模型规定了哪些执行顺序是"合法"的,哪些是"非法"的。
三、强一致性(Strong Consistency / Linearizability)
3.1 定义
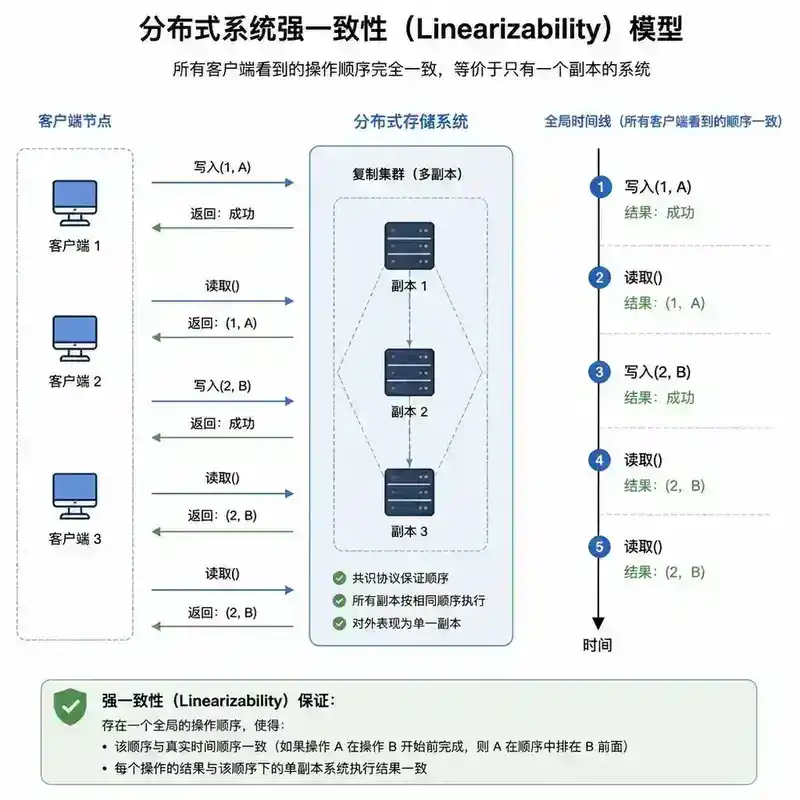
强一致性(也称线性一致性,Linearizability)是最严格的一致性模型。它要求:
- 全局时钟顺序:所有操作看起来都在某个全局的、实时的时间线上按序执行
- 实时保证:如果操作 A 在操作 B 开始之前就已经完成(基于墙上时钟),那么 A 必须在 B 之前生效
- 读己之写:任何客户端在写入完成后,后续的读操作必须能看到该写入的结果(或更新的值)
通俗地说:整个系统表现得就像只有一个副本,所有操作按某个全局顺序串行执行。
3.2 形式化定义
一个执行历史是线性一致的,当且仅当:
- 存在一个全局顺序,使得所有操作按该顺序串行执行的结果与实际并发执行的结果一致
- 如果操作 A 的响应时间早于操作 B 的调用时间(A 在 B 之前完成),则 A 在该全局顺序中必须排在 B 之前
注意:如果两个操作在时间上有重叠(并发),则它们在全局顺序中的先后是任意的——只要整体结果与某个串行执行一致。
3.3 经典案例:注册用户的"消失"
假设有一个用户注册系统,数据存储在三个副本上:
时间线:
T1: Client1 写入 name="Alice", email="alice@example.com"  → 副本1写入成功
T2: Client2 读取 name="Alice"                              → 命中了副本2(还未同步),返回空
T3: Client2 读取 email="alice@example.com"                  → 命中了副本3(已同步),返回数据
在强一致性下,这种现象是不允许的。Client2 要么看到完整的用户数据,要么什么都看不到,绝不能看到"半个"用户。如果系统声称提供强一致性,却出现了上述行为,那就说明系统违约了。
3.4 实现机制
实现强一致性的常见手段:
1. 共识协议(Consensus)
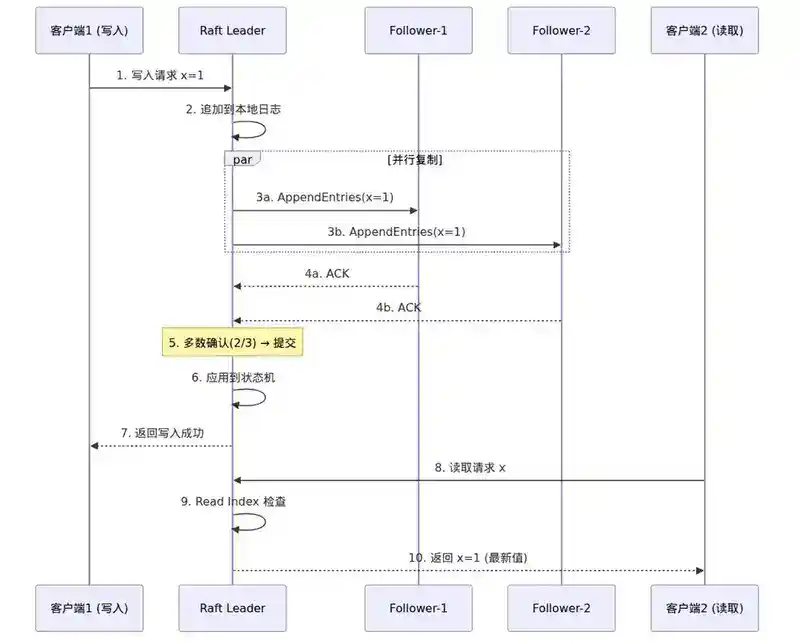
Raft 和 Paxos 是最经典的实现方式。以 Raft 为例:
- 写入请求必须经过 Leader 节点
- Leader 将日志复制到超过半数的 Follower
- 只有被多数节点确认(committed)的日志才对外可见
- 读请求也必须经过 Leader(或通过 read index / lease read 优化)
// 伪代码:Raft 写入流程
void handleWrite(Command cmd) {
    // 1. Leader 将命令追加到本地日志
    log.append(cmd);
    // 2. 并行复制到所有 Follower
    for (Follower f : followers) {
        f.appendEntries(log.lastIndex(), cmd);
    }
    // 3. 等待多数确认
    waitForMajority();
    // 4. 提交并应用到状态机
    commit(log.lastIndex());
    applyToStateMachine(cmd);
    // 5. 返回客户端成功
    respondToClient(SUCCESS);
}
2. 分布式锁 + 原子广播
ZooKeeper 使用 ZAB(ZooKeeper Atomic Broadcast)协议,保证所有写操作按全局顺序应用到所有节点。ZooKeeper 的写操作是线性一致的,但默认的读操作不是——需要调用 sync() 才能保证读到最新数据。
3. 单主复制 + 同步复制
MySQL Group Replication 在配置为 AFTER 模式时,事务提交必须等待多数节点确认,实现强一致性。但代价是写入延迟显著增加。
3.5 CAP 视角
根据 CAP 定理,当网络分区发生时,强一致性系统必须牺牲可用性(选择 CP)。这意味着:
- 如果无法联系到多数节点,系统拒绝写入(甚至拒绝读取)
- 对于金融、库存等场景,这种取舍是必要的
- 对于社交、内容等场景,这种取舍过于昂贵
3.6 性能代价
强一致性的代价是显著的:
- 写入延迟:每次写入需要等待多数节点确认,跨机房场景下延迟可达 50-200ms
- 吞吐限制:所有写操作必须经过 Leader(或共识组),单点瓶颈
- 可用性降低:分区时不可用,节点故障需要选举时间
四、顺序一致性(Sequential Consistency)
4.1 定义
顺序一致性由 Leslie Lamport 在 1979 年提出,定义如下:
一个多处理器系统是顺序一致的,如果所有处理器的执行结果与某个全局顺序一致,且在该全局顺序中,每个处理器内部的操作保持其程序顺序。
关键点:
- 存在全局顺序:所有操作可以排成一个全局序列
- 程序顺序保留:同一个处理器(客户端)内部的操作顺序在全局顺序中保持不变
- 没有实时约束:不要求操作 A 在操作 B 开始之前完成就必须排在 B 前面
4.2 与强一致性的区别
这是面试中最容易被追问的点。区别在于"实时保证":
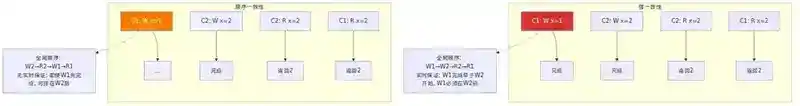
- 强一致性:如果 A 的响应时间 < B 的调用时间,A 必须在 B 之前。这是基于墙上时钟的约束。
- 顺序一致性:没有这个约束。只要每个客户端内部的操作顺序正确,不同客户端之间的操作可以任意交错,即使它们的执行时间完全不重叠。
举例:
Client1:  W(x=1)  ────────────────  R(x) → 2
Client2:           W(x=2)  R(x)→2
在顺序一致性下,以下执行历史是合法的:
- 全局顺序:W1(x=1), W2(x=2), R2(x)→2, R1(x)→2
但如果我们改成:
- 全局顺序:W2(x=2), R2(x)→2, W1(x=1), R1(x)→2
这也是合法的(只要 R1(x) 读到 2 而不是 1),因为顺序一致性不关心墙上时钟的先后。
4.3 现实意义
顺序一致性在工程中较少直接使用,但它是理解内存模型的重要基础。Java 的 volatile 变量和 synchronized 块提供的保证本质上就是顺序一致性的一种形式。
在 Java 内存模型(JMM)中:
- 对
volatile变量的读写操作在所有线程看来是全局有序的 - 进入和退出
synchronized块的操作在所有线程看来是全局有序的 - 但 JMM 不保证"实时顺序"——这也是为什么 JMM 不是强一致性的原因
4.4 实现方式
顺序一致性的实现通常比强一致性更高效:
- 不需要全局时钟同步:不依赖 NTP 或 TrueTime
- 可以使用 FIFO 广播:只要保证消息按发送顺序投递,不需要全序广播
- 延迟更低:不需要等待多数确认——只需要保证每个节点的操作顺序一致
五、因果一致性(Causal Consistency)
5.1 定义
因果一致性是最"实用"的弱一致性模型之一。它保证:
如果操作 A 与操作 B 有因果关系(A happens-before B),那么所有节点看到 A 和 B 的顺序必须一致,即 A 在 B 之前。
如果两个操作没有因果关系(并发操作),则各节点可以以任意顺序看到它们。
5.2 因果关系的判定
什么是"因果关系"?在分布式系统中,因果关系通过以下规则定义:
- 同一进程内的顺序:如果 A 和 B 是同一个客户端发出的,且 A 先于 B,则 A → B(A happens-before B)
- 消息传递:如果 A 是发送消息,B 是接收该消息,则 A → B
- 传递性:如果 A → B 且 B → C,则 A → C
举例:
场景:朋友圈评论系统

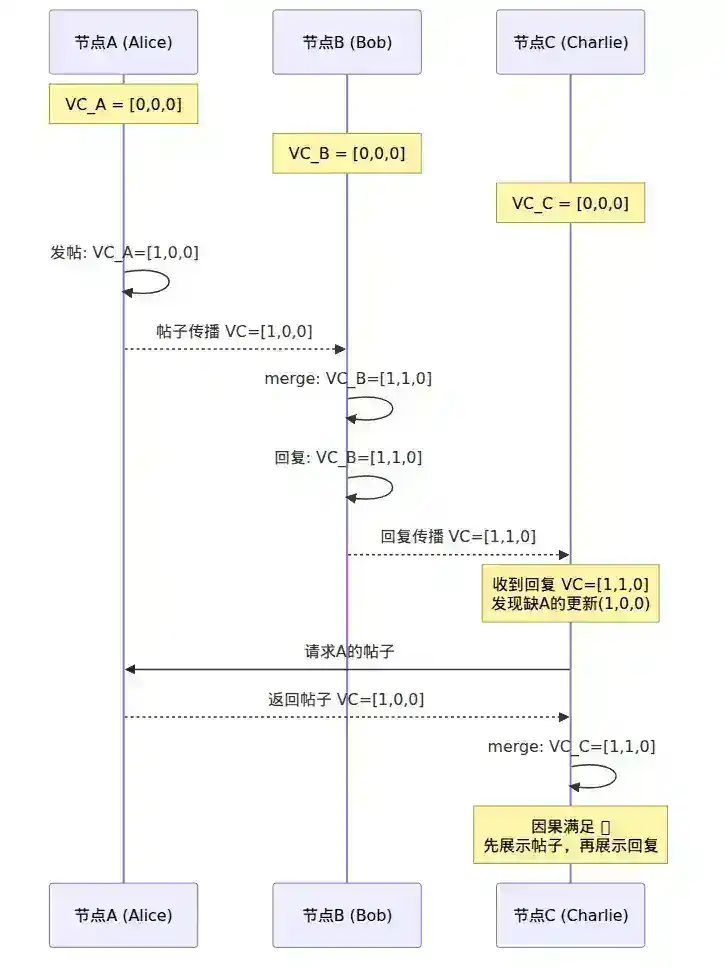
Alice 发了一条朋友圈:"今天天气真好!"
Bob 看到了这条朋友圈,回复:"确实!"
Charlie 看到了 Alice 的朋友圈和 Bob 的评论。

因果约束:
- Alice 发帖 → Bob 看到帖子 → Bob 回复(因果链)
- Charlie 必须先看到 Alice 的帖子,才能看到 Bob 的评论
- 如果 Charlie 先看到 Bob 的评论却看不到 Alice 的帖子,就违反了因果一致性
5.3 实现:向量时钟(Vector Clock)
向量时钟是追踪因果关系的经典数据结构。每个节点维护一个 N 维向量(N = 节点数):
初始状态:VC_A = [0, 0, 0], VC_B = [0, 0, 0], VC_C = [0, 0, 0]

Alice 发帖(节点A):
  VC_A = [1, 0, 0]  // A 的计数器 +1
  帖子携带 VC = [1, 0, 0]

Bob 回复(节点B):
  Bob 收到帖子,VC = [1, 0, 0]
  VC_B = merge([0, 1, 0], [1, 0, 0]) = [1, 1, 0]  // 合并后 B 的计数器 +1
  回复携带 VC = [1, 1, 0]

Charlie 查看(节点C):
  VC_C = [0, 0, 0]
  收到回复 VC = [1, 1, 0],发现缺少帖子(A 的更新)
  → 系统先拉取帖子(因果关系满足),再展示回复
5.4 实际应用
- Amazon DynamoDB:提供因果一致性选项,通过向量时钟解决并发写入冲突
- Riak:基于向量时钟的因果一致性,允许客户端自行解决冲突
- COPS(Clusters of Order-Preserving Servers):在分布式 KV 存储中实现因果一致性,读延迟显著低于强一致性
5.5 因果一致性的优点
- 可用性高:即使在网络分区期间,节点仍可接受写入(只要写入不依赖未同步的数据)
- 延迟低:不需要等待远程节点确认即可返回
- 语义直观:用户能理解"先有帖子才有评论"这样的因果关系
- 收敛性好:最终所有节点会收敛到相同的因果历史
六、最终一致性(Eventual Consistency)
6.1 定义
最终一致性是理论上最弱、工程上最常用的一致性模型。它只保证:
如果系统不再有新的写入,经过足够长的时间后,所有副本最终会收敛到相同的值。
注意"最终"这个词——它没有承诺多久,也没有承诺在收敛之前读到的数据是否正确。
6.2 DNS 的经典案例
DNS(域名系统)是最终一致性的鼻祖和最佳案例:
场景:将 example.com 的 IP 从 1.2.3.4 改为 5.6.7.8

T0: 修改 DNS 记录
T1: 部分 DNS 服务器已更新,返回 5.6.7.8
T2: 部分 DNS 服务器仍缓存旧值,返回 1.2.3.4
T3: 经过 TTL(通常 5 分钟到 24 小时),所有服务器都返回 5.6.7.8
在这段时间内,不同的客户端可能解析到不同的 IP。这就是最终一致性的代价。
6.3 实现模式
1. 异步复制(Asynchronous Replication)
MySQL 主从复制是最终一致性的典型实现:
- 主库写入后立即返回(不等待从库)
- binlog 异步传输到从库
- 从库重放 binlog 更新数据
主库: W(x=1) ──→ 返回成功 ──→ binlog 传输 ──→ 从库应用
                   ↑ 客户端立即得到响应
从库:                          读请求可能 hit 到旧值
2. Gossip 协议
Cassandra 和 Dynamo 使用 Gossip 协议传播更新:
- 每个节点定期与随机选择的邻居交换状态
- 更新通过多轮 Gossip 最终传播到所有节点
- 配合 hinted handoff 和 read repair 加速收敛
3. CRDT(Conflict-free Replicated Data Types)
CRDT 是一种数据结构,设计为并发更新无需协调即可自动合并,数学上保证最终收敛:
// GCounter:只增计数器,使用 CRDT 实现
// 每个节点维护自己的计数,合并时取每个节点的最大值
class GCounter {
    Map<String, Integer> counts; // nodeId -> count

    void increment(String nodeId) {
        counts.put(nodeId, counts.get(nodeId) + 1);
    }

    int value() {
        return counts.values().stream().mapToInt(Integer::intValue).sum();
    }

    void merge(GCounter other) {
        for (var entry : other.counts.entrySet()) {
            counts.merge(entry.getKey(), entry.getValue(), Math::max);
        }
    }
}
6.4 最终一致性的工程挑战
- 读取自己的写入:用户写入后立即刷新页面,可能看到旧数据(需要会话一致性来弥补)
- 单调读:用户可能看到数据"倒退"——第一次读到新值,第二次读到旧值
- 冲突解决:并发写入同一数据时如何合并(Last-Write-Wins vs 自定义合并)
6.5 最终一致性的强弱梯度
实际上,最终一致性不是一个点,而是一个光谱:
最终一致性
  ├── 带会话保证的最终一致性(读己之写)
  ├── 带单调读保证的最终一致性
  ├── 带单调写保证的最终一致性
  └── 带因果保证的最终一致性(因果一致性)
七、会话一致性(Session Consistency)
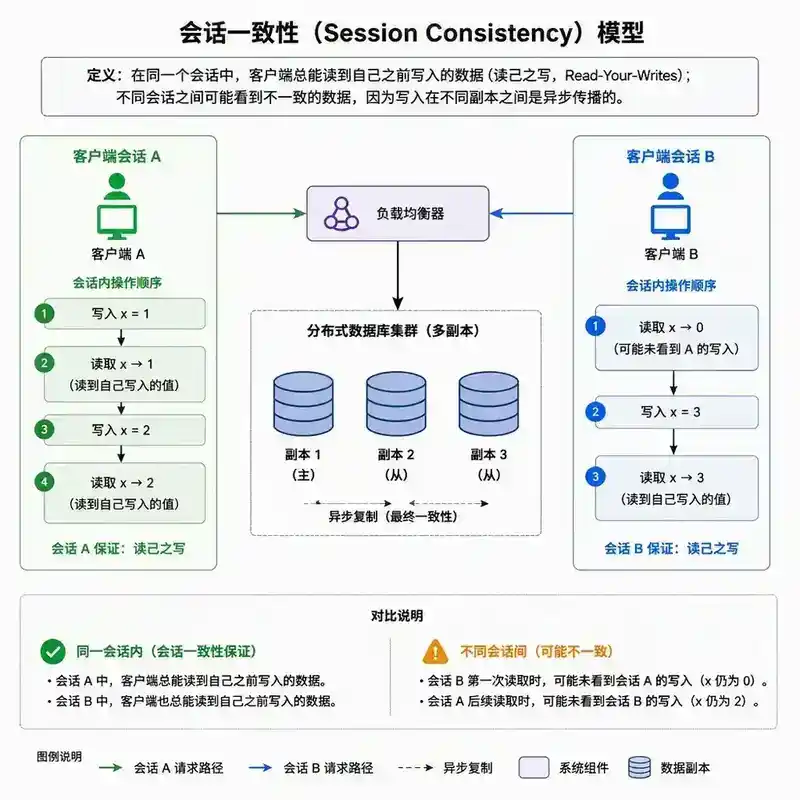
7.1 定义
会话一致性(Session Consistency)是一种以客户为中心的一致性模型。它在最终一致性的基础上,为单个客户端的会话提供额外保证:
在同一个会话内,客户端读取到的数据不会比之前读取到的数据更旧,且客户端一定能读到自己在本次会话中写入的数据。
核心保证:
- 读己之写(Read Your Writes):客户端总能读取到自己刚写入的数据
- 单调读(Monotonic Reads):客户端不会读到比之前更旧的数据
- 单调写(Monotonic Writes):客户端的写入按顺序被应用
- 写后读(Writes Follow Reads):如果客户端读了某个版本的数据,后续写入会基于该版本
7.2 为什么需要会话一致性?
最终一致性最大的痛点就是"读己之写"问题:
用户 Alice 修改了自己的个人资料(昵称从 "Alice" 改为 "Alicia"):
T1: Alice 发送 PUT /profile {name: "Alicia"} → 写入主库
T2: 主库返回成功
T3: Alice 刷新页面 GET /profile → 路由到了从库(尚未同步),返回 {name: "Alice"}
T4: Alice 困惑:"我明明改了,为什么还是旧名字?"
会话一致性通过在会话内维护"粘性"来解决这个问题。
7.3 实现方式
1. 粘性会话(Sticky Session)
最简单的实现:将同一会话的请求路由到同一节点。
负载均衡器维护 session_id → node 映射:
session_abc123 → Node-A

Alice 的写入到 Node-A,后续读取也到 Node-A
Node-A 自然能看到自己的最新写入
缺点:节点故障时会话丢失,需要重新建立。
2. 版本跟踪
客户端跟踪自己看到的版本号,后续请求携带版本号以确保一致性:
// 客户端维护版本号
class SessionAwareClient {
    private long version = 0;

    void write(String key, String value) {
        // 写入时携带当前版本
        WriteResponse resp = db.write(key, value, version);
        version = resp.newVersion;
    }

    String read(String key) {
        // 读取时要求至少看到当前版本
        ReadResponse resp = db.read(key, version);
        if (resp.version > version) {
            version = resp.version;
        }
        return resp.value;
    }
}
3. 写入后读主库
更简单的工程方案:写入后的一段时间内(如 5 秒),该用户的读请求强制走主库。
// 伪代码:Redis 记录写入时间
void handleRead(String userId) {
    Long lastWriteTime = redis.get("last_write:" + userId);
    if (lastWriteTime != null &&
        System.currentTimeMillis() - lastWriteTime < 5000) {
        return masterDb.query(userId);  // 读主库
    }
    return slaveDb.query(userId);  // 读从库
}
7.4 实际应用
- MongoDB:通过
readConcern: "majority"+writeConcern: "majority"实现读己之写 - Amazon S3:为新写入的对象提供读己之写保证
- 大多数 Web 应用:通过粘性会话或 Redis 记录写入时间戳实现
八、五种模型全面对比
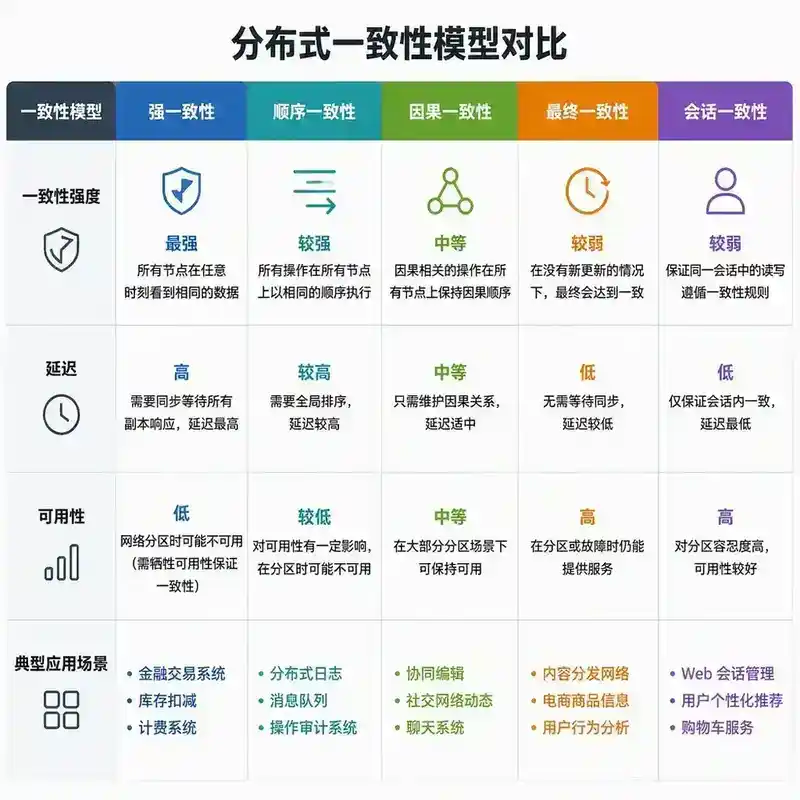
| 维度 | 强一致性 | 顺序一致性 | 因果一致性 | 会话一致性 | 最终一致性 |
|---|---|---|---|---|---|
| 实时保证 | 有 | 无 | 无 | 无 | 无 |
| 全局顺序 | 有(实时) | 有(非实时) | 部分(因果) | 部分(会话内) | 无 |
| 写入延迟 | 高(50-200ms) | 中(10-50ms) | 低(1-10ms) | 低(1-10ms) | 极低(<1ms) |
| 分区可用性 | 不可用 | 取决于实现 | 可用 | 可用 | 可用 |
| 实现复杂度 | 高 | 中高 | 中 | 低 | 低 |
| 典型系统 | ZooKeeper, etcd | JMM volatile | DynamoDB, Riak | MongoDB, S3 | DNS, Cassandra |
| 适用场景 | 金融、库存、选举 | 内存模型 | 社交、协作 | Web 应用 | 缓存、CDN |
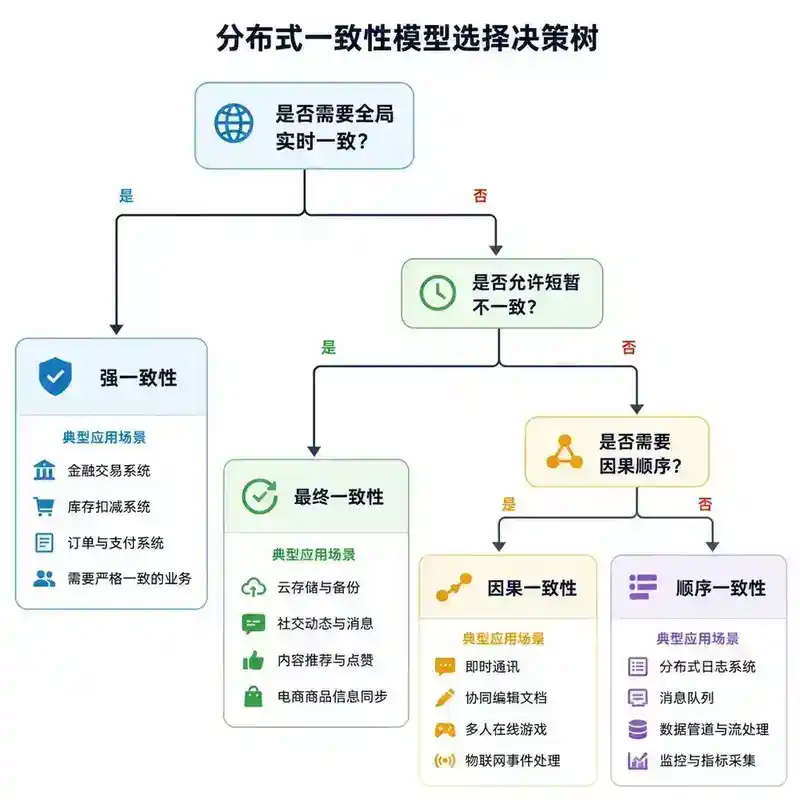
选型决策树
需要全局实时一致? ──是──→ 强一致性(ZooKeeper/etcd/Raft)
  │否
  ├── 需要因果顺序? ──是──→ 因果一致性(DynamoDB/Riak)
  │否
  ├── 用户需要读己之写? ──是──→ 会话一致性(MongoDB/S3)
  │否
  └── → 最终一致性(Cassandra/DNS)
九、生产实践:如何选择一致性模型
9.1 金融交易系统:强一致性
场景:用户 A 向用户 B 转账 100 元

要求:
- A 的余额扣减和 B 的余额增加必须同时成功或同时失败
- 任何时刻,系统总余额必须一致(A+B 不变)
- 不允许出现"A 扣了钱但 B 没收到"的情况

方案:使用支持分布式事务的强一致性系统
- 2PC/XA 事务(传统方案)
- TCC/Saga(微服务方案)
- 或者直接使用单库(避免分布式)
9.2 社交媒体时间线:因果一致性
场景:Twitter/微博的 Feed 流

要求:
- 用户发帖后,粉丝能看到(但允许短暂延迟)
- 评论必须在帖子之后出现(因果约束)
- 不要求所有粉丝同时看到新帖子

方案:使用因果一致性
- 帖子 ID 使用时间戳 + 序列号,保证因果顺序
- 粉丝时间线异步更新(推拉结合)
- 评论通过"父帖子 ID"建立因果依赖
9.3 CDN 缓存:最终一致性
场景:静态资源 CDN 分发

要求:
- 修改源站图片后,CDN 节点最终使用新版本
- 允许不同地区的用户短时间内看到不同版本
- 性能和可用性优先于一致性

方案:最终一致性 + TTL
- 源站修改后,主动 Purge 或等待 TTL 过期
- CDN 节点回源时获取最新版本
- 用户可能在几秒到几分钟内看到旧版本
9.4 用户个人资料:会话一致性
场景:用户修改个人资料后立即查看

要求:
- 用户修改后刷新页面,必须看到新内容
- 其他用户查看时,允许短暂延迟
- 不允许"修改后看到旧版本"的体验

方案:会话一致性
- 写入后一定时间内,该用户的请求路由到主库
- 或客户端携带版本号,确保读取不低于写入版本
- 其他用户正常读从库
十、常见陷阱与面试追问
陷阱 1:混淆"顺序一致性"与"强一致性"
很多人认为只要操作有全局顺序就是强一致性,这是错误的。关键在于实时保证:
面试追问:"如果一个系统保证所有操作按全局顺序执行,它一定是强一致的吗?"
答案:不是。顺序一致性也保证全局顺序,但不保证实时顺序。
如果操作 A 在 12:00:00.000 完成,操作 B 在 12:00:00.001 开始,
顺序一致性允许 B 在全局顺序中排在 A 前面,只要它们不在同一客户端。
陷阱 2:以为"最终一致性"总能收敛
最终一致性在某些条件下可能不收敛:
面试追问:"最终一致性在什么情况下可能不会收敛?"
答案:
1. 冲突解决策略导致数据丢失(如 LWW 用时间戳,NTP 时钟回拨)
2. 网络永久分区(节点永远无法通信)
3. 写操作丢失且没有重试机制
4. 分裂脑(Split Brain)导致两个主节点同时写入
陷阱 3:CAP 中"选择 CP"不等于"强一致性"
面试追问:"选择 CP 的系统一定保证强一致性吗?"
答案:不一定。CP 中的 C 是"原子一致性"(Atomic Consistency),
接近于线性一致性。但很多 CP 系统(如 ZooKeeper)在默认读操作上
不保证线性一致性——ZooKeeper 的默认读可能返回旧数据,
需要 sync() 才能保证读到最新。
陷阱 4:会话一致性不等于最终一致性
面试追问:"如果系统提供会话一致性,它还是最终一致的吗?"
答案:在全局视角下,它仍然是最终一致的。
会话一致性只是在最终一致性的基础上,为单个会话提供了额外保证。
两个不同会话的客户端仍然可能看到不一致的数据。
十一、延伸思考
11.1 Google Spanner 的 TrueTime
Google Spanner 通过 TrueTime(基于 GPS 和原子钟的全局时钟 API)实现了外部一致性(External Consistency),这实际上是分布式系统中的最强一致性——比线性一致性更强,因为它保证了跨事务的全局实时顺序。
TrueTime 的核心思想:不追求绝对精确的时间,而是给出一个时间区间 [earliest, latest]。提交事务时等待 latest 过期,从而保证所有节点看到一致的顺序。
11.2 一致性、隔离性与持久性的关系
在分布式系统中,一致性模型(Consistency Model)与事务隔离级别(Isolation Level)是不同但相关的概念:
- 一致性模型:关注多个副本之间的数据一致性
- 隔离级别:关注并发事务之间的可见性
但它们有交叉:可串行化隔离级别 + 同步复制 ≈ 强一致性。
11.3 PACELC 扩展
CAP 定理的扩展 PACELC 更好地描述了在无分区情况下的权衡:
- 有分区(P):在 A 和 C 之间选择(同 CAP)
- 无分区(E):在 L(延迟)和 C(一致性)之间选择
这解释了为什么即使没有分区,很多系统也选择弱一致性——为了降低延迟。
十二、核心要点总结
- 一致性模型是系统对程序员的承诺,定义了"合法的执行历史"
- 强一致性提供全局实时顺序,代价是延迟和可用性,用于金融和选举场景
- 顺序一致性保留程序顺序但无实时约束,是理解 JMM 的基础
- 因果一致性追踪 happens-before 关系,在可用性和语义直观性之间取得良好平衡
- 最终一致性只保证最终收敛,是 DNS、CDN 等场景的默认选择
- 会话一致性在最终一致性的基础上,为单个会话提供读己之写和单调读保证
- 选型没有银弹:根据业务场景在一致性、可用性、延迟和复杂度之间权衡
面试官提问
Q1:请用一句话区分"强一致性"和"顺序一致性",并给出一个具体场景,说明为什么这个区分在工程中很重要。
A1: 强一致性要求操作"看起来按全局实时顺序执行",而顺序一致性只要求"每个客户端内部的程序顺序被保留,但不同客户端之间可以任意交错,无需考虑墙上时钟先后"。
区分的关键场景是跨客户端实时依赖。假设你在设计一个分布式锁服务:Client A 在 T1 时刻释放锁,Client B 在 T2(T2 > T1 + 网络延迟)尝试获取锁。在强一致性下,B 必须能获取到锁(因为 A 的释放先于 B 的获取);而顺序一致性下,B 可能看到锁仍被持有,因为 A 的释放操作在全局顺序中可能排在 B 的获取之后。如果分布式锁用顺序一致性,会出现"锁已释放但别人无法获取"的诡异现象——这就是为什么 etcd/ZooKeeper 的锁实现必须依赖强一致性(Raft/ZAB)而非顺序一致性。工程上,任何需要"跨客户端实时协调"的场景(选主、分布式锁、库存扣减)都必须强一致性,顺序一致性只适用于"各客户端独立工作"的场景(如 Java 内存模型中的 volatile 变量)。
Q2:你在项目中遇到过"读己之写"(Read Your Writes)的问题吗?是如何解决的?如果让你设计一个支持会话一致性的分布式缓存,你会怎么实现?
A2: 读己之写是最终一致性架构中最常见的坑。典型场景:用户更新订单状态为"已取消",刷新页面后看到的是"待支付"。这是因为写请求去了主库,刷新后的读请求打到了尚未同步的从库。
实战解法有三种,按复杂度递增:(1) 粘性路由 — 写入后 N 秒内,该用户的所有读请求路由到主库。用 Redis 记录 last_write:{userId} 的 TTL,网关层根据此标记决定路由。实施简单,但主库压力会增加。(2) 版本号追踪 — 客户端维护 lastSeenVersion,每次写入后更新;读请求携带此版本号,从库检查自身版本,如果小于客户端版本则透传至主库或等待同步。实施略复杂,但主库压力最小。(3) 写入后跟随 — 写入响应中携带写入的 binlog 位点或 LSN,客户端后续读请求携带此位点,从库确保应用到此位点后才返回数据。这是最严谨的方案,类似 MySQL 8.0 的 SELECT ... FOR UPDATE WAIT n 语义。
设计会话一致性分布式缓存,我会采用方案 (2) 的变体:(a) 缓存节点维护一个单调递增的全局版本号(可用 Hybrid Logical Clock);(b) 客户端在 session cookie 中存储 {key: lastSeenVersion} 映射;(c) 读请求携带 key + minVersion,缓存节点检查本地版本,如果 localVersion < minVersion,则从持久化存储回源并等待版本追赶;(d) 写入时返回新版本号,客户端更新 cookie。补充:为防止 cookie 膨胀,只在最近访问的 10 个 key 上做版本追踪,超出部分采用粘性路由兜底。
Q3:CAP 定理说"分区时只能在 C 和 A 之间选一个",但很多系统声称在分区时"部分可用"——比如允许读但拒绝写。这是否意味着它们找到了 CAP 的漏洞?请说明你的理解。
A3: 这不是 CAP 的漏洞,而是对 CAP 中"可用性"定义的误解。CAP 定理中的 Availability(可用性)有严格定义:每一个非故障节点必须能对所有请求返回非错误的响应。如果一个系统在分区时拒绝写请求,它返回了错误,那它就不满足"可用性"的定义——它选择了 C(一致性),牺牲了 A(可用性)。
"部分可用"(如只读不写)在工程上是有价值的,但它不突破 CAP 的理论边界。CAP 是一个二选一的精确定理,没有"部分选择"的余地。常见的误解来源是:(1) 把"可用性"理解成"系统还能用"而不是"每个请求都能成功";(2) 混淆了 CAP-A 和日常运维中的"高可用"(HA)。你的系统 99.9% 时间可读但不可写,运维上可以说"基本可用",但 CAP 框架下这就是不可用。
深入一步:CAP 定理的微妙之处在于它将"一致性"定义为原子/线性一致性(每个操作看起来瞬间完成)。如果系统提供的是因果一致性或最终一致性,它在理论上已经"选择了 AP"——即使它同时允许读写。所以那些声称"分区时读写都可用"的系统,实际上是牺牲了 C(选择了 AP),只不过它们提供的弱一致性在大多数场景下已经够用。
Q4:因果一致性依赖"因果关系"的追踪。请设计一个方案,在分布式消息系统中保证消息的因果投递(即消息 B 如果依赖消息 A,则 B 一定在 A 之后被消费)。
A4: 核心思路是为每条消息附加因果依赖的元数据,消费者在消费前检查依赖是否已满足。
方案设计:
(1) 依赖标记法(适合显式依赖场景):生产者在发送消息 B 时,如果 B 依赖消息 A,则在 B 的 header 中标记 depends_on: [msgId_A]。Broker 投递 B 给消费者前,检查消费者是否已确认消费了 msgId_A。如果未确认,B 被暂存到"等待队列",消费者侧维护一个 acked_messages 位图,当 msgId_A 被确认后,触发等待队列中依赖已满足的消息投递。各消费者独立维护自己的消费进度,不需要全局协调。
(2) 向量时钟法(适合隐式依赖场景):每条消息携带一个向量时钟 VC = [c1, c2, ..., cn],记录"发送此消息时,发送者已看到的消息数"。具体规则:节点 i 发送消息时,将 VC[i] += 1,消息携带更新后的 VC;节点 i 收到消息后,合并消息 VC 到本地 VC(逐维取 max)。消费者在投递消息时,检查消息的 VC 是否"小于等于"本地已消费 VC——即对于消息的每一维 v,本地已消费计数 ≥ v。如果条件不满足,消息进入等待队列,直到依赖的消息被消费。这本质上是将 Lamport 的 happens-before 关系用一个可比较的向量编码。
(3) 序列号 + 屏障法(适合分区有序场景):如果消息按 partition 有序,每个 partition 内的消息天然有序。跨 partition 的因果关系通过"因果屏障"实现:当 partition-1 的消息 A 产生了 partition-2 的消息 B 时,A 在 partition-1 中插入一个"因果屏障 marker",告诉 partition-2 的消费者"在消费 B 之前,必须先消费完 partition-1 中到 A 为止的所有消息"。Kafka Streams 和 Flink 的 watermark 机制本质上就是这种思路。
实战建议:对于大多数业务场景,方法 (1) 已经足够——不需要向量时钟的复杂度,显式声明依赖即可。只有像协作文档编辑(如 Google Docs 的 OT/CRDT)这种大规模并发场景,才需要向量时钟或更复杂的因果追踪。
Q5:如果业务要求"库存扣减"强一致但"用户浏览记录"最终一致,你会如何在一个系统中同时支持两种一致性模型?架构上需要注意什么?
A5:
架构方案:双轨数据通路(Dual-Track Data Path)
核心思想:不同类型的数据走不同的写入和读取路径,在同一个系统中并存。
写入路径:
- 强一致数据(库存):走 Raft/Paxos 共识组。写入请求必须经过 Leader,等待多数节点确认后才返回成功。使用独立的 etcd 集群或 Raft 组,不与弱一致数据共享存储。
- 最终一致数据(浏览记录):走异步写入路径。写入先落到本地 WAL 或 Kafka,然后异步批量写入存储层。客户端写入后立即返回成功,不等待复制。
读取路径:
- 强一致数据:读请求必须经过共识组 Leader(或通过 read index 保证线性一致性)。使用
etcd.Get(key, WithSerializable(false))或 Raft 的 ReadIndex。 - 最终一致数据:读取任意副本,接受可能读到旧数据。
关键架构注意点:
- 路由层隔离:在 API 网关或服务层,通过 key 前缀或数据类型字段区分强一致和弱一致请求,路由到不同的处理链路。例如
inventory:*→ 强一致路径,browse_history:*→ 弱一致路径。 - 存储层物理隔离:强一致数据使用 etcd/Consul/TiKV(基于 Raft),弱一致数据使用 Cassandra/Redis Cluster(基于 Gossip)。不要试图在一个存储引擎上混用两种一致性模型——那会引入不必要的复杂度。
- 事务边界清晰:强一致数据之间可以放在同一个事务中(如库存扣减 + 订单状态更新),但强一致数据和弱一致数据之间不要放在同一个事务中。如果业务需要两者关联(如"扣减库存后记录浏览事件"),用 Outbox 模式:扣减库存的事务中写一条 Outbox 消息到本地数据库,然后异步投递到消息队列,最终一致路径消费此消息写入浏览记录。
- 防止"虚假一致性":工程师最容易犯的错误是把弱一致数据当成强一致数据使用。例如,在库存扣减的代码路径中读取了浏览记录来判断"用户是否可疑"——这会导致安全决策基于可能过期的数据。建议在代码层通过类型系统或注解标记数据的一致性级别,编译期或 lint 检查禁止跨一致性级别的数据依赖。
- 监控与告警区分:强一致路径的延迟 SLA 和弱一致路径不同,需要分别监控。强一致路径的 P99 延迟可能达到 50-200ms,而弱一致路径的 P99 可能只有 1-5ms。如果强一致路径延迟突然降到 5ms,说明可能有什么地方绕过了共识——这本身就是告警。
Q6:ZooKeeper 常被描述为"强一致性"系统,但它的默认读操作不一定返回最新数据。请解释为什么,以及如何保证 ZooKeeper 读到最新数据。
A6:
为什么默认读不保证最新数据?
ZooKeeper 的写操作基于 ZAB(ZooKeeper Atomic Broadcast)协议,Leader 将写请求广播给所有 Follower,只有超过半数节点确认后(committed)才返回成功。这保证了写操作是线性一致的。但读操作默认在客户端连接的节点上执行——如果客户端连接的是 Follower,它可能还没来得及应用 Leader 的最新 committed 提案。
具体来说,ZooKeeper 的 Follower 在收到 Leader 的 commit 消息后,将提案应用到本地内存数据库。这个应用过程是异步的,存在一个极短的时间窗口:提案已在 Leader 提交,但 Follower 尚未应用。如果客户端刚好在这个窗口内读取 Follower,就会读到旧数据。
这不是设计缺陷,而是性能权衡:如果每次读都要求强一致,ZK 的读吞吐将大幅下降(因为涉及 Leader 交互或等待多数确认)。
如何保证读最新数据?
ZK 提供三种方式:
**sync()**+ 读:客户端在读取前调用zk.sync(path),这会强制 Follower 追上 Leader 的提交进度。sync 的工作原理是:Follower 向 Leader 发送一个 sync 请求,Leader 在完成当前所有已提交的提案后返回确认,Follower 收到确认后再处理读请求。此时 Follower 至少已经应用了 sync 时刻之前的所有提交。这是最常用的方案,代价是一次额外的网络往返(约 1-2ms)。- 直接读 Leader:通过
zk.getData(path, watch, stat)时,如果业务逻辑要求绝对最新,可以先判断当前连接的是不是 Leader,如果不是则切换到 Leader 连接。但 ZK 客户端默认不暴露 Leader 判断,且如果是 Leader 也会导致读压力集中,一般不建议。 - 顺序一致性读(而非线性一致性读):理解 ZK 的设计哲学——ZK 提供的是顺序一致性而非线性一致性。但 ZK 有一个关键保证:同一个客户端的操作按其发送顺序执行(FIFO 客户端顺序)。因此,如果你在同一个 session 中先
sync()再读,或者先写再读,ZK 保证读到的版本 >= 写的版本。大多数场景下,顺序一致性 +sync()已经足够满足业务需求。
面试加分项:可以提及 etcd 的改进——etcd 3.4+ 引入了 ReadIndex 机制,读请求先向 Leader 查询当前已提交的 index,然后在本地等待应用到该 index 再返回。这比 sync() 更优雅,因为它不需要 Follower 回放所有未提交提案,只等待特定 index。