阅读时间:约 45 分钟 前置知识:CAP 定理、分布式系统基础、事务 ACID 难度:进阶
一、为什么需要 BASE:从 CAP 的"不可能三角"说起
在讨论 BASE 之前,必须回顾 CAP 定理。2000 年 Eric Brewer 提出的 CAP 猜想告诉分布式系统设计者一个残酷的事实:一致性(Consistency)、可用性(Availability)、分区容错(Partition Tolerance)三者不可兼得。
CAP 定理的模型如下:
graph TD
    CAP["CAP 定理"]
    C["C: Consistency<br/>所有节点在同一时刻<br/>看到相同的数据"]
    A["A: Availability<br/>每个请求都能获得<br/>非错误的响应"]
    P["P: Partition Tolerance<br/>系统在任意网络分区<br/>故障下仍能继续运行"]
    CAP --> C
    CAP --> A
    CAP --> P
    C -.->|"冲突"| A
    A -.->|"冲突"| P
    C -.->|"冲突"| P
    style C fill:#e1f5fe
    style A fill:#fff3e0
    style P fill:#e8f5e9
现实中的分布式系统,网络分区是不可避免的——交换机故障、机房断网、光缆被挖断,这些事件每天都在发生。因此,P(分区容错)是必须保证的,真正需要权衡的是 C 和 A。
传统关系型数据库(如 MySQL 单机)追求 ACID 强一致性,但在分布式场景下,维持强一致性会牺牲可用性——当一个节点不可达时,系统只能拒绝服务以保持一致性。
BASE 理论正是在这种背景下诞生的。 2008 年,eBay 架构师 Dan Pritchett 在 ACM Queue 上发表文章《BASE: An Acid Alternative》,提出了一种不同于 ACID 的分布式系统设计哲学:与其死守"强一致性"而牺牲可用性,不如接受"最终一致性",换取系统的高可用与弹性。
BASE 的三个字母分别代表:
| 字母 | 全称 | 含义 |
|---|---|---|
| B | Basically Available | 基本可用 |
| S | Soft State | 软状态 |
| E | Eventually Consistent | 最终一致 |
本文将逐一拆解 BASE 的每个组成部分,并结合工程实践,讨论如何在真实系统中落地。
二、Basically Available:基本可用
2.1 不是"降级",而是"策略性取舍"
基本可用不是系统挂了,而是系统在异常情况下,仍然可以提供服务,只是服务能力有所下降。这是一种有策略的、可预期的降级,而不是无计划的崩溃。
一个常见误区是把"基本可用"等同于"随便挂"。实际上,基本可用要求系统在故障时仍然可以响应用户请求,只是响应时间可能变长,或者部分非核心功能暂时不可用。
2.2 基本可用的四种典型表现
graph LR
    subgraph "正常模式"
        A1["用户请求"] --> B1["完整功能链路"]
        B1 --> C1["正常响应<br/>200ms"]
    end
    subgraph "基本可用模式"
        A2["用户请求"] --> B2["降级链路"]
        B2 --> C2["部分响应<br/>3s 或部分功能"]
    end
    style C1 fill:#c8e6c9
    style C2 fill:#fff9c4
(1)响应时间变长
当流量洪峰到来时,系统处理能力达到瓶颈,请求在队列中排队等待。此时系统没有直接拒绝,而是让用户等一等——比如从 200ms 变成 3s。这是最常见的基本可用表现。
(2)非核心功能降级
电商大促期间,推荐系统可能暂时关闭,但下单、支付核心链路正常运行。用户看到的推荐位变成静态内容,但核心交易不受影响。这就是"基本可用"——核心功能可用,非核心功能暂时牺牲。
(3)读操作降级
当主库压力过大时,读请求可能被路由到从库,即使从库数据有几秒延迟。用户看到的是"稍微过时"的数据,但至少能看到,而不是白屏。
(4)写操作异步化
扣减库存从同步变为异步,先返回"下单成功",后台异步确认库存。用户不需要等待库存系统完全确认,提升了体验。
2.3 基本可用的工程实现
实现基本可用,通常依赖以下技术手段:
- 限流:令牌桶、漏桶算法,在入口处保护系统不被冲垮
- 熔断:当依赖服务不可用时,快速失败,避免级联雪崩
- 降级开关:通过配置中心动态控制功能开关
- 兜底数据:缓存热点数据,作为降级时的默认返回
- 隔离:线程池、信号量隔离,确保核心链路不受非核心链路影响
三、Soft State:软状态
3.1 什么是软状态
软状态是指系统中的数据存在一个"中间状态",这个中间状态不会影响系统的整体可用性,但允许数据在多个副本之间存在短暂的不一致。
软状态的核心思想是:接受不完美,追求可容忍。
sequenceDiagram
    participant C as 客户端
    participant S1 as 节点 A(主)
    participant S2 as 节点 B(从)
    participant S3 as 节点 C(从)

    C->>S1: 写入 X=100
    S1->>S1: X=100
    C->>S2: 读取 X
    S2->>C: X=99(旧值)
    Note over S2: 软状态:副本间暂时不一致
    S1->>S2: 异步同步 X=100
    S1->>S3: 异步同步 X=100
    C->>S2: 读取 X
    S2->>C: X=100(已同步)
    Note over S2: 最终一致
3.2 软状态 vs 硬状态
| 维度 | 硬状态(Hard State) | 软状态(Soft State) |
|---|---|---|
| 数据一致性 | 写入后立即可见 | 写入后可能存在延迟 |
| 副本状态 | 所有副本完全一致 | 允许副本间暂时不一致 |
| 典型系统 | 单机数据库、ZooKeeper | Redis Cluster、DNS、CDN |
| 可用性 | 受一致性约束 | 高可用,不受副本同步影响 |
| 写入延迟 | 需等待所有副本确认 | 主副本确认即可返回 |
3.3 软状态的边界
软状态并不意味着"数据可以随便不一致"。关键在于:
- 不一致窗口可控:系统需要能预估或约束数据不一致的最大时间窗口
- 不一致可感知:系统应该能告诉用户当前数据的"新鲜度"
- 不一致可修复:有机制确保数据最终能收敛到一致状态
四、Eventually Consistent:最终一致
4.1 最终一致的定义
最终一致性是指:如果系统停止接收新的写入,经过一段足够长的时间,所有副本上的数据将收敛到相同的值。
这是 BASE 理论中最核心的概念,也是对 ACID 强一致性最大的"妥协"。
4.2 最终一致性的层次(从弱到强)
graph LR
    A["因果一致性<br/>Causal Consistency"] --> B["读己之写<br/>Read Your Writes"]
    B --> C["会话一致性<br/>Session Consistency"]
    C --> D["单调读一致性<br/>Monotonic Read"]
    D --> E["单调写一致性<br/>Monotonic Write"]
    E --> F["最终一致性<br/>Eventually Consistent"]

    style A fill:#ffebee
    style B fill:#fff3e0
    style C fill:#fff9c4
    style D fill:#e8f5e9
    style E fill:#e1f5fe
    style F fill:#e8eaf6
因果一致性(Causal Consistency):有因果关系的操作必须按顺序被看到,无因果关系的操作顺序不重要。比如"评论 → 回复",必须先看到评论才能看到回复。
读己之写(Read Your Writes):用户总是能读到自己刚写入的数据。比如你修改了头像,刷新页面后必须看到新头像(即使其他用户可能需要等一会儿)。
会话一致性(Session Consistency):在一个会话内,读己之写成立。换一个会话(比如换个浏览器),可能暂时看不到最新数据。
单调读一致性(Monotonic Read Consistency):一旦读到某个版本的数据,之后不会读到更旧的版本。不会出现"先看到新头像,刷新后又变回旧头像"的诡异现象。
单调写一致性(Monotonic Write Consistency):同一个进程的写操作按顺序执行。系统不会出现"先执行写 A,后执行写 B,但 B 先被应用"的情况。
4.3 工程中的最终一致性模式
最终一致性不是一句口号,而是需要具体的工程机制来保障。以下是几种常见的落地模式:
模式一:消息队列驱动的最终一致
这是最经典的实现方式。核心思路是:将需要同步的数据变更封装为消息,通过消息队列异步投递到各个消费者,各消费者独立更新本地数据。
┌──────────┐     ┌──────────┐     ┌──────────┐
│ 订单服务  │────▶│  MQ 队列  │────▶│ 库存服务  │
│ 写入订单  │     │          │     │ 扣减库存  │
└──────────┘     └──────────┘     └──────────┘
                              ────▶│ 积分服务  │
                                   │ 增加积分  │
                                   └──────────┘
模式二:本地消息表 + 定时补偿
在本地事务中同时写入业务数据和消息记录,然后通过定时任务扫描未发送的消息进行投递。这是"可靠消息最终一致"的基础。
模式三:CDC(Change Data Capture)+ 事件流
通过监听数据库 binlog 捕获数据变更,将变更事件发送到 Kafka 等消息系统,下游服务消费事件更新自身状态。这种模式解耦程度最高,但链路也最长。
模式四:对账 + 补偿
定期(如每天凌晨)对比源端和目标端数据,发现差异后进行补偿修复。这是一种"兜底"机制,确保即使前面的同步机制出现问题,最终也能通过定期对账达到一致。
五、BASE vs ACID:两种哲学的对立与统一
5.1 设计哲学对比
graph TD
    subgraph "ACID 世界"
        A1["强一致性"]
        A2["事务原子性"]
        A3["即时持久性"]
        A4["严格隔离"]
    end
    subgraph "BASE 世界"
        B1["最终一致性"]
        B2["补偿式原子性"]
        B3["异步持久化"]
        B4["弱隔离/可容忍"]
    end
    A1 -->|"妥协"| B1
    A2 -->|"妥协"| B2
    A3 -->|"妥协"| B3
    A4 -->|"妥协"| B4
    style A1 fill:#e3f2fd
    style A2 fill:#e3f2fd
    style A3 fill:#e3f2fd
    style A4 fill:#e3f2fd
    style B1 fill:#fff3e0
    style B2 fill:#fff3e0
    style B3 fill:#fff3e0
    style B4 fill:#fff3e0
| 维度 | ACID | BASE |
|---|---|---|
| 核心目标 | 强一致性 | 高可用性 |
| 一致性模型 | 即时一致 | 最终一致 |
| 事务模型 | 刚性事务 | 柔性事务 |
| 锁机制 | 悲观锁为主 | 乐观锁/无锁为主 |
| 适用场景 | 金融记账、库存扣减 | 社交、内容、推荐 |
| 扩展性 | 垂直扩展为主 | 水平扩展友好 |
| 延迟 | 低延迟(单机) | 可能高延迟(跨网络) |
| 故障模式 | 拒绝服务 | 降级服务 |
5.2 不是二选一,而是分场景
BASE 和 ACID 不是非此即彼的对立关系。在实际系统中,核心链路用 ACID,非核心链路用 BASE,是更务实的做法。
举个例子:电商下单场景。
- 扣减库存:需要 ACID,确保不超卖
- 发送通知:用 BASE,延迟几秒通知不影响用户体验
- 更新积分:用 BASE,积分晚到账几秒可以接受
- 记录日志:用 BASE,日志最终写入即可
六、BASE 理论的工程落地:从理论到代码
6.1 本地消息表实现最终一致
这是最经典的 BASE 落地模式,也是面试中高频问到的问题。下面给出核心思路和关键代码。
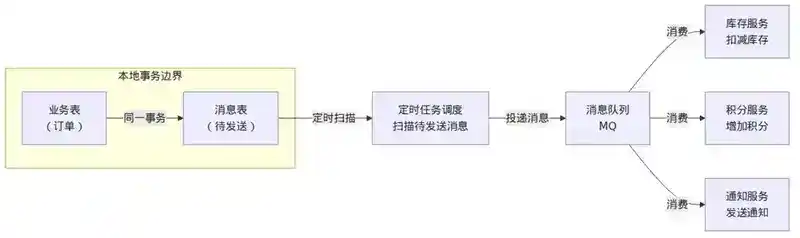
核心思路:在同一个本地事务中,同时写入业务数据和消息记录,然后通过定时任务扫描未发送的消息进行投递。
┌─────────────────────────────────────┐
│           本地事务边界                │
│  ┌──────────┐    ┌──────────────┐   │
│  │ 写入订单  │    │ 写入消息记录   │   │
│  │ (业务表)  │    │ (消息表)      │   │
│  └──────────┘    └──────┬───────┘   │
└─────────────────────────┼───────────┘
                          │
                    ┌─────▼──────┐
                    │  定时任务    │
                    │ 扫描待发送   │
                    └─────┬──────┘
                          │
                    ┌─────▼──────┐
                    │  发送 MQ    │
                    └─────┬──────┘
                          │
              ┌───────────┼───────────┐
        ┌─────▼──────┐ ┌──▼──────┐ ┌──▼──────┐
        │  库存服务    │ │ 积分服务  │ │ 通知服务  │
        └────────────┘ └─────────┘ └─────────┘
关键设计点:
- 消息与业务数据同库:保证本地事务的原子性
- 消息状态机:待发送 → 已发送 → 已消费(或 待发送 → 发送中 → 已发送)
- 定时扫描:处理发送失败的消息,实现"至少一次"投递
- 消费者幂等:消费者需要处理重复消息,通过唯一键去重
- 死信处理:多次重试失败的消息进入死信队列,人工介入
6.2 幂等设计的三个层次
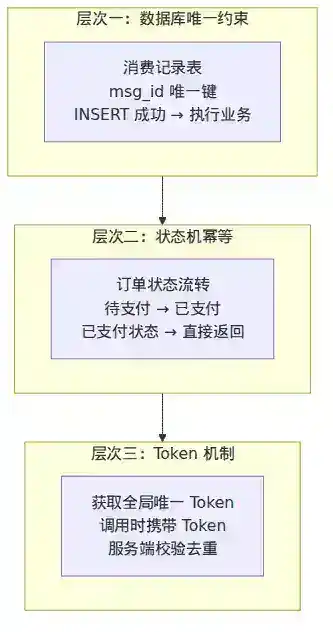
幂等是 BASE 实践的基石。没有幂等,最终一致性就是空中楼阁。
层次一:数据库唯一约束
最简单可靠的幂等方案。在消费者端建一张"消费记录表",以消息 ID 作为唯一键。消费前先插入,插入成功才执行业务逻辑。
层次二:状态机幂等
利用业务本身的状态流转来保证幂等。比如订单状态从"待支付"→"已支付",重复执行"支付"操作时,如果订单已经是"已支付"状态,直接返回成功。
层次三:Token 机制
在调用方先获取一个 Token(全局唯一 ID),调用时携带 Token。服务端校验 Token 是否已使用,未使用则执行,已使用则直接返回。
6.3 最终一致性窗口的监控
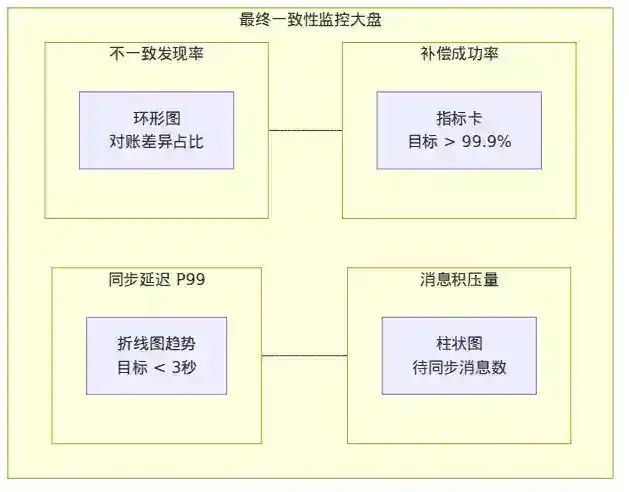
BASE 系统的运维痛点在于:你如何知道"最终"是多长时间?
必须建立最终一致性延迟的监控指标:
- 同步延迟 P99:99% 的消息在多久内完成同步
- 积压量:待同步的消息数量
- 不一致发现率:对账发现的差异记录数 / 总记录数
- 补偿成功率:补偿操作的成功率
七、常见陷阱与反模式
陷阱 1:把"最终"当成"无所谓"
错误认知:最终一致嘛,晚一点无所谓,延迟 10 分钟也没关系。
现实:用户刷新页面看到数据不一致,第一反应是"出 bug 了",然后疯狂刷新,造成更大的系统压力。最终一致性的时间窗口需要控制在用户可接受的范围内,通常应该在秒级,业务高峰期最多不超过分钟级。
陷阱 2:过度使用 BASE,忽略 ACID 的必要性
错误认知:所有场景都用最终一致,包括库存扣减、账户余额。
现实:余额扣减、库存扣减等强一致性场景,必须使用 ACID 或 TCC 等刚性事务。用 BASE 处理扣库存,超卖是必然的。
陷阱 3:忽略幂等,导致重复扣款
错误认知:消息队列有确认机制,不会重复消费。
现实:MQ 的"至少一次"投递语义意味着重复消费是必然的。消费者不实现幂等,重复扣款、重复发货等事故迟早会发生。
陷阱 4:补偿逻辑不完善,形成数据黑洞
错误认知:主流程写好了,补偿逻辑随便写写就行。
现实:补偿逻辑才是最终一致性的保障。补偿逻辑如果写得有问题,数据不一致就会变成"永久不一致",形成数据黑洞,最终需要人工修数据。
陷阱 5:对账周期过长
错误认知:每天对账一次就够了。
现实:对账周期过长,意味着数据不一致可能持续 24 小时。应该在业务高峰期进行更频繁的对账(甚至可以做到准实时对账),早发现早修复。
八、面试官视角:高频追问与回答思路
以下问题设计为面试官视角,考察候选人对 BASE 理论的理解深度和工程落地能力。
Q1:CAP 说 C、A、P 三者不可兼得,BASE 理论是如何绕开这个限制的?
考察点:对 CAP 和 BASE 关系的本质理解。
回答思路:BASE 并没有"绕开" CAP,而是重新定义了"一致性"。CAP 中的 C 是强一致性(所有节点同时看到相同数据),而 BASE 把一致性要求放宽为最终一致性(允许短暂不一致,但最终收敛)。所以 BASE 本质上是在 CAP 中选择了 AP(可用性 + 分区容错),但通过工程手段(消息队列、补偿、对账)把一致性约束从"强"降为"最终",从而在 AP 的基础上实现了"可接受的一致性"。
Q2:在设计一个转账系统时,你会用 ACID 还是 BASE?为什么?
考察点:场景判断和选型能力。
回答思路:核心转账链路(A 扣钱 → B 加钱)必须用 ACID 或 TCC 等刚性事务,因为涉及到资金,不允许出现"钱扣了但没加上"的中间状态。但转账的通知(短信、Push)、转账记录的异步同步到数据仓库、风控系统的异步审核等,可以用 BASE。关键判断标准是:业务是否允许用户看到不一致的状态。资金变动不允许,但通知、日志、分析这些可以。
Q3:如果使用本地消息表实现最终一致,定时任务的扫描间隔如何设计?间隔太短会怎样,太长会怎样?
考察点:工程细节和权衡能力。
回答思路:间隔太短(如 1 秒),会频繁扫描数据库,增加 DB 压力,且大部分扫描是"空扫"(没有待发送消息)。间隔太长(如 10 分钟),消息延迟大,最终一致性窗口过长。实践中通常采用动态间隔策略:有消息积压时缩短间隔(如 1 秒),无消息积压时拉长间隔(如 30 秒)。另外可以考虑用事件驱动替代定时扫描:业务写入消息后直接发一个信号,触发立即投递,定时扫描只作为兜底。
Q4:你的系统用了 Kafka,消息顺序是分区的,消费者如何保证幂等?
考察点:幂等设计的实际落地。
回答思路:Kafka 保证分区内消息有序,但消费者重启、Rebalance 时可能重复消费。幂等方案三个层次:1)数据库唯一约束(建消息消费记录表,msg_id 唯一键);2)业务状态机(如订单已支付则跳过);3)Redis 去重(用 msg_id 做 key,SET NX,适合高并发场景)。需要注意:幂等键的设计要覆盖业务语义,不能只依赖 Kafka 的 offset。
Q5:怎么监控最终一致性是否在正常工作?当发现不一致时,你的处理流程是什么?
考察点:运维意识和故障处理能力。
回答思路:监控层面:1)消息积压监控(Kafka consumer lag);2)对账差异率监控(每天定时对账,差异数 / 总数);3)补偿成功率监控。处理流程:1)发现不一致 → 2)判断影响范围(多少条记录、哪些用户)→ 3)查原因(消费者挂了?消息丢失?补偿逻辑 bug?)→ 4)修复消费者 → 5)触发补偿/对账修复数据 → 6)复盘,改进监控和告警阈值。
Q6:BASE 理论中的"Soft State"和"硬状态"的边界在哪里?如何判断一个状态是否应该"软"?
考察点:对软状态概念的深度理解。
回答思路:判断标准是"不一致窗口的容忍度"。如果业务上数据不一致窗口 < 1 秒可接受,那就可以用软状态;如果必须 0 延迟(如库存扣减),就是硬状态。具体判断维度:1)用户是否直接感知(余额不能软,推荐可以软);2)不一致是否会导致业务错误(超卖不能软,评论排序可以软);3)不一致的修复成本(修复成本低的可以软,成本高的必须硬)。
Q7:在一个电商系统中,下单涉及订单、库存、积分、优惠券四个服务。你如何设计这个场景的最终一致性方案?
考察点:综合设计能力。
回答思路:核心思路:订单服务作为协调者,库存扣减用 ACID 刚性事务,积分和优惠券用 BASE 最终一致。具体设计:1)订单服务先预扣库存(ACID,保证不超卖);2)订单创建成功后,发"订单创建"事件到 MQ;3)积分服务消费事件,增加积分(幂等);4)优惠券服务消费事件,标记优惠券已使用(幂等);5)如果积分或优惠券更新失败,通过死信队列 + 补偿机制处理;6)定时对账,确保订单、积分、优惠券三方数据对齐。关键设计:库存扣减失败则整个下单失败,积分/优惠券失败不影响下单(异步补偿即可)。
总结
BASE 理论是分布式系统设计的核心指导思想之一。它教会我们一个重要的工程哲学:在分布式系统中,追求完美的一致性是昂贵的,有时甚至是不可能的。与其追求"完美",不如追求"足够好"——在可接受的范围内,让系统保持可用、弹性,并通过工程手段确保最终收敛。
三个关键要点:
- 基本可用不是随便降级,而是有策略的取舍
- 软状态是允许短暂不一致,但必须可控、可感知、可修复
- 最终一致需要具体的工程机制保障,不是一句口号
记住:BASE 不是 ACID 的替代品,而是对 ACID 的补充。在正确的场景选择正确的工具,才是架构师的核心能力。