前言
在单机时代,数据库自增主键(AUTO_INCREMENT)就能解决 ID 生成问题。但进入分布式架构后,一个订单服务可能部署了几十个实例,每个实例都在往同一张订单表里写数据——数据库自增主键要么成为单点瓶颈,要么在分库分表场景下产生 ID 冲突。
分布式 ID 看似简单,实则暗藏玄机:趋势递增对 B+Tree 索引的写入性能影响有多大?UUID 的无序性会导致多少页分裂?Snowflake 的时钟回拨如果处理不好,生产环境就是灾难。这些才是面试官真正想听的。

一、分布式 ID 的核心需求
在讨论具体方案之前,先明确分布式 ID 必须满足哪些需求。这不是背八股文,而是理解每个方案为什么这样设计的前提。
1.1 全局唯一
这是最基本的要求。无论有多少个 ID 生成节点,生成的 ID 都不能重复。
1.2 趋势递增
注意是趋势递增,不是严格递增。
MySQL InnoDB 使用 B+Tree 作为主键索引的存储结构。当插入一条新记录时,如果主键是自增的,新记录总是追加到 B+Tree 的最右侧叶子节点,写入效率最高。如果主键是随机的(如 UUID),新记录会随机插入 B+Tree 的任意位置,导致页分裂——原本满的页被拆成两半,数据重新分布,磁盘 I/O 大幅增加。
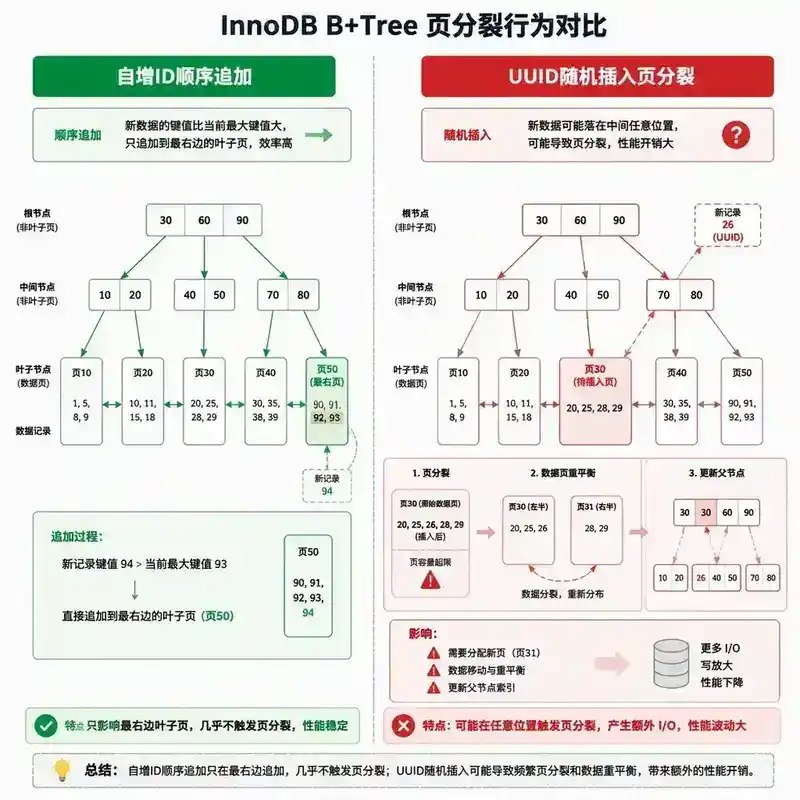
下面的表格量化了这种差异:
| 主键类型 | 插入模式 | 页分裂频率 | 磁盘 I/O 影响 | 索引碎片化 |
|---|---|---|---|---|
| 自增 ID | 顺序追加 | 极少 | 低 | 低 |
| UUID | 随机插入 | 频繁 | 高 | 严重 |
| 趋势递增 ID(Snowflake) | 近似顺序 | 低 | 低 | 低 |
1.3 高可用
ID 生成服务不能成为单点故障。如果 ID 生成器挂了,整个业务链路就断了。
1.4 高性能
ID 生成是每个写请求的前置操作,延迟必须极低。通常要求单节点 QPS 达到数万甚至数十万。
1.5 信息安全
如果 ID 是连续自增的(如 1001, 1002, 1003...),竞争对手可以轻易估算出你的订单量、用户量等商业数据。因此很多场景要求 ID 看起来"无规律"。
二、UUID 方案
2.1 UUID 的标准格式
UUID(Universally Unique Identifier)是 RFC 4122 定义的标准,长度为 128 位(16 字节),通常表示为 32 个十六进制字符加 4 个连字符:
550e8400-e29b-41d4-a716-446655440000
UUID 有多个版本,最常用的是 UUIDv4(基于随机数)和 UUIDv1(基于时间戳 + MAC 地址)。
2.2 UUID 作为主键的问题
UUID 最大的优点是无中心化——每个节点独立生成,天然不冲突。但用它做 MySQL 主键是灾难性的:
问题一:页分裂
UUID 的随机性导致 InnoDB B+Tree 索引频繁页分裂。用一个简单的实验说明:
-- 自增主键插入(顺序写)
INSERT INTO orders (id, ...) VALUES (1, ...);   -- 追加到页末尾
INSERT INTO orders (id, ...) VALUES (2, ...);   -- 追加到页末尾
INSERT INTO orders (id, ...) VALUES (3, ...);   -- 追加到页末尾

-- UUID 主键插入(随机写)
INSERT INTO orders (id, ...) VALUES ('a3f2...', ...); -- 可能插入到页中间
INSERT INTO orders (id, ...) VALUES ('b71c...', ...); -- 可能插入到另一个页
INSERT INTO orders (id, ...) VALUES ('0e4d...', ...); -- 可能触发页分裂
每次页分裂时,InnoDB 需要:
- 分配一个新的数据页
- 将原页的一半数据移动到新页
- 更新 B+Tree 的父节点指针
- 写入 redo log 和 undo log
在高并发写入场景下,这个开销是巨大的。
问题二:存储空间
UUID 占用 16 字节(CHAR(36) 则是 36 字节),而 BIGINT 自增 ID 只占 8 字节。在分库分表场景下,每个二级索引都会存储主键值,UUID 会让所有二级索引膨胀。
问题三:可读性差
排查问题时,UUID 不直观,无法通过 ID 判断数据的大致创建时间或来源。
2.3 UUID 的改良方案
UUIDv7(时间戳前缀):将时间戳放在 UUID 的前 48 位,后 80 位为随机数。这样 UUID 整体趋势递增,大幅减少页分裂:
格式:Unix时间戳(48位) + 随机数(80位)
示例:017F22D0-B058-7000-8000-15B9C0A8321C
UUIDv7 兼顾了去中心化和趋势递增,是 UUID 方案中唯一适合做数据库主键的变体。但目前 MySQL 尚未原生支持 UUIDv7。
三、数据库号段方案
3.1 基本原理
数据库号段方案的核心思想是:从数据库批量获取一段 ID 区间,在内存中分配,用完再取下一段。
┌──────────────────────────────────────┐
│            ID 生成服务(多实例)         │
│                                      │
│  实例 A:号段 [1, 1000]               │
│  实例 B:号段 [1001, 2000]            │
│  实例 C:号段 [2001, 3000]            │
│                                      │
│  每个实例在内存中分配,用完再申请新号段  │
└──────────────┬───────────────────────┘
               │
               ▼
┌──────────────────────────────┐
│     号段表(MySQL)           │
│                              │
│  biz_tag   │ max_id │ step  │
│  ──────────┼────────┼───────│
│  order     │ 3000   │ 1000  │
│  user      │ 5000   │ 1000  │
└──────────────────────────────┘
核心 SQL 只有一条(CAS 乐观锁更新):
UPDATE id_segment SET max_id = max_id + step WHERE biz_tag = 'order';
-- 然后 SELECT max_id 获取当前值,号段为 (max_id - step, max_id]
3.2 美团 Leaf-segment 方案
美团开源的 Leaf 是号段方案最成熟的实现,它解决了几个关键问题:
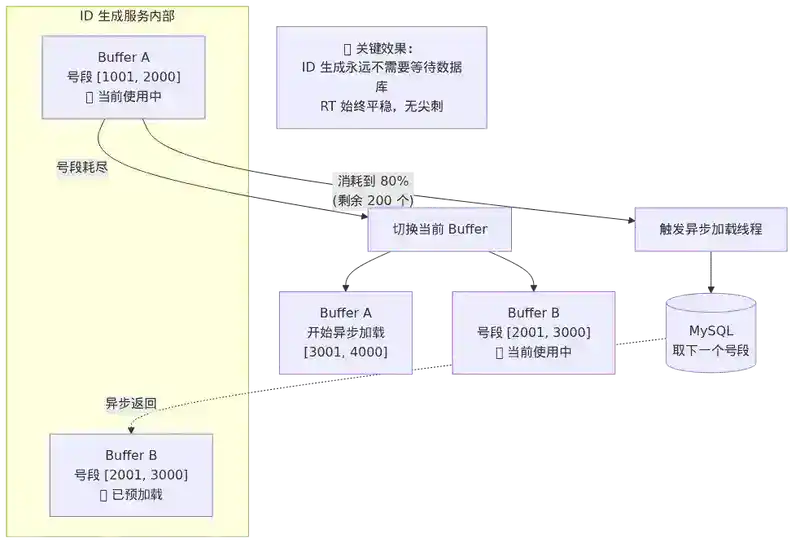
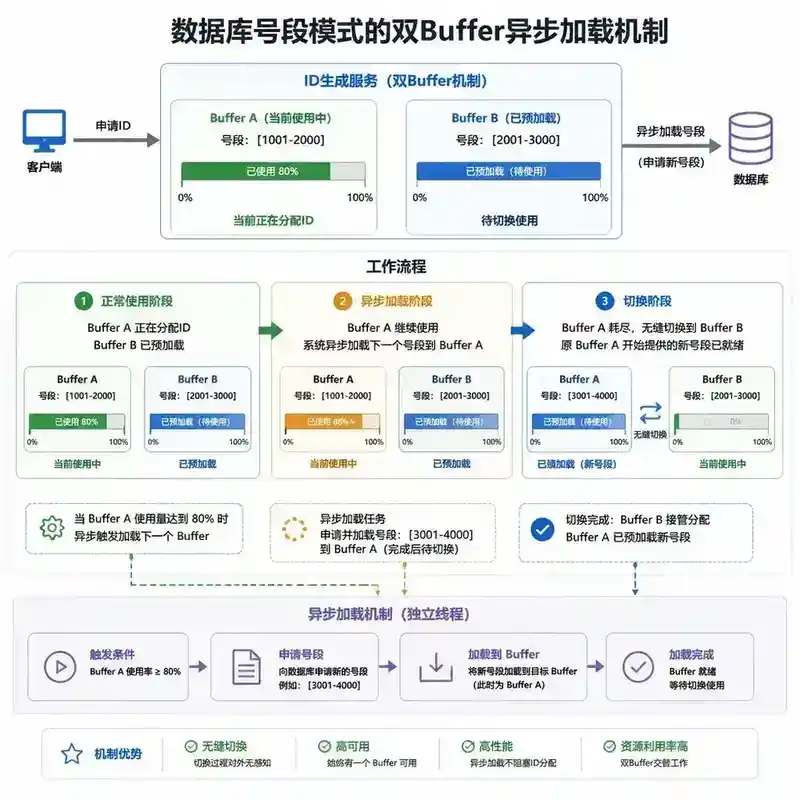
双 Buffer 优化:当号段消耗到一定比例(如 10%)时,异步预加载下一个号段到备用 Buffer。当前号段用完后,直接切换到备用 Buffer,消除获取号段时的阻塞等待。
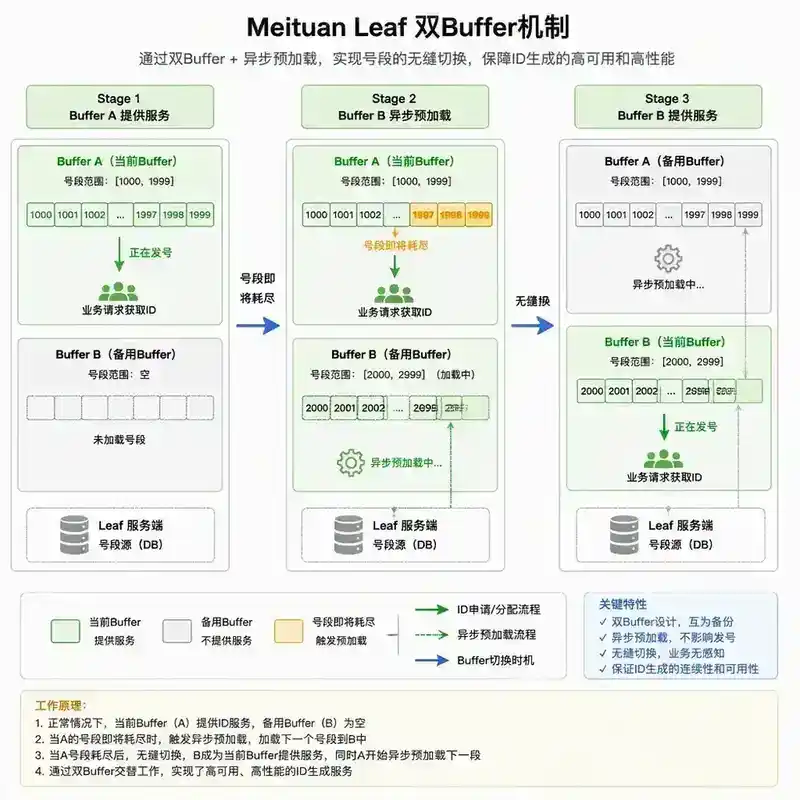
动态步长调整:号段的步长不是固定的。Leaf 根据号段的消耗速度动态调整步长——消耗快则增大步长(减少数据库访问频率),消耗慢则减小步长。但步长调大后,如果服务重启,步长范围内的 ID 就浪费了。
3.3 号段方案的优缺点
优点:
- 实现简单,依赖成熟的 MySQL
- ID 严格递增,对数据库索引友好
- 号段内纯内存分配,性能极高
缺点:
- 强依赖数据库,有单点风险(多主复制可以缓解)
- ID 连续性暴露业务量(可以通过 ID 加密或被调解决)
- 号段步长与 ID 浪费的权衡(步长大 → 重启浪费多;步长小 → 数据库压力大)
- 趋势递增但非严格递增(不同实例的号段区间不同,后申请的实例号段 ID 可能更大)
四、Snowflake 方案
4.1 Snowflake 的 ID 结构
Twitter 于 2010 年开源的 Snowflake 是分布式 ID 的事实标准。它将 64 位长整型按位划分:
┌─┬───────────────────────────────────────────────────────────────┐
│0│                     Snowflake ID (64 bits)                    │
└─┴───────────────────────────────────────────────────────────────┘

┌─────┬─────────────────────┬───────────────┬────────────────────┐
│ 1bit│     41 bits         │   10 bits     │     12 bits        │
│ 符号│    时间戳 (ms)       │  工作机器 ID   │   序列号 (ms内)     │
│ 位  │                     │               │                    │
│ (0) │ 从定义起始时间算起    │ 最多 1024 个   │ 每ms最多 4096 个    │
│     │ 可用约 69 年         │ 工作节点       │ ID                 │
└─────┴─────────────────────┴───────────────┴────────────────────┘
一个具体例子:
时间戳(从2020-01-01开始):  1712345678000 ms
工作机器 ID:                5 号机器
序列号:                     123

生成的 ID(十进制):        7234567890123456789
生成的 ID(二进制):        0110010001...(共 64 位)
4.2 各字段详解
第 1 位(最高位):固定为 0,保证生成的 ID 为正数。因为 Java 中 long 是有符号的,最高位为 1 表示负数。
41 位时间戳:存储的是当前时间与自定义起始时间(epoch)的差值,单位是毫秒。41 位可以表示约 69 年:
2^41 / (365 × 24 × 3600 × 1000) ≈ 69.7 年
10 位工作机器 ID:可以部署 2^10 = 1024 个 ID 生成节点。这个字段的划分方式可以灵活调整,比如 5 位数据中心 ID + 5 位机器 ID。
12 位序列号:同一毫秒内可以生成 2^12 = 4096 个不同的 ID。如果单节点 QPS 超过 4096/ms,需要等待下一毫秒。
4.3 Snowflake 的核心优势
趋势递增:时间戳在高位,所以 ID 整体上随时间递增。这对 MySQL InnoDB 的 B+Tree 索引非常友好——新插入的数据大概率追加到索引的最右侧。
毫秒级精度:毫秒级的时间戳使 ID 天然具备时间排序能力,通过 ID 就能反解出数据的大致创建时间,排查问题时非常方便。
去中心化:每个节点基于自己的机器 ID 和时间戳独立生成 ID,不需要和中心服务通信,性能极高。
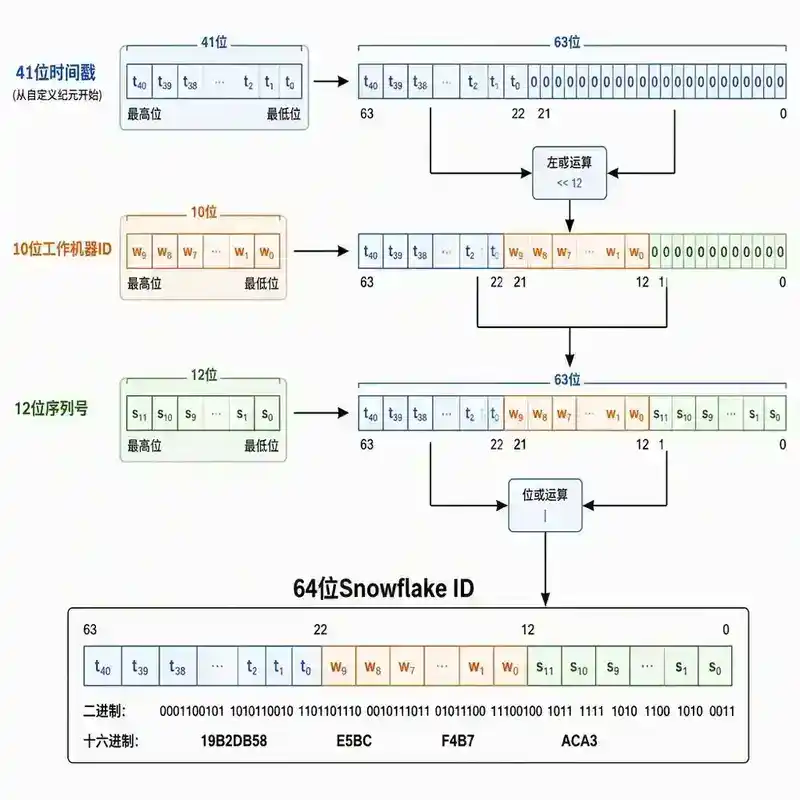
4.4 核心代码实现
public class SnowflakeIdGenerator {
    // 起始时间戳(2020-01-01 00:00:00)
    private final long EPOCH = 1577836800000L;

    // 各部分占用的位数
    private final long WORKER_ID_BITS = 10L;
    private final long SEQUENCE_BITS = 12L;

    // 最大值
    private final long MAX_WORKER_ID = ~(-1L << WORKER_ID_BITS);  // 1023
    private final long MAX_SEQUENCE = ~(-1L << SEQUENCE_BITS);     // 4095

    // 左移位数
    private final long TIMESTAMP_LEFT_SHIFT = WORKER_ID_BITS + SEQUENCE_BITS; // 22
    private final long WORKER_ID_LEFT_SHIFT = SEQUENCE_BITS;                  // 12

    private long workerId;
    private long sequence = 0L;
    private long lastTimestamp = -1L;

    public SnowflakeIdGenerator(long workerId) {
        if (workerId > MAX_WORKER_ID || workerId < 0) {
            throw new IllegalArgumentException("workerId 超出范围");
        }
        this.workerId = workerId;
    }

    public synchronized long nextId() {
        long currentTimestamp = System.currentTimeMillis();

        // 时钟回拨检测
        if (currentTimestamp < lastTimestamp) {
            throw new RuntimeException(
                "时钟回拨 " + (lastTimestamp - currentTimestamp) + " ms,拒绝生成 ID");
        }

        // 同一毫秒内
        if (currentTimestamp == lastTimestamp) {
            sequence = (sequence + 1) & MAX_SEQUENCE;
            // 序列号用完,等待下一毫秒
            if (sequence == 0) {
                currentTimestamp = waitNextMillis(lastTimestamp);
            }
        } else {
            // 新的一毫秒,序列号重置
            sequence = 0L;
        }

        lastTimestamp = currentTimestamp;

        return ((currentTimestamp - EPOCH) << TIMESTAMP_LEFT_SHIFT)
             | (workerId << WORKER_ID_LEFT_SHIFT)
             | sequence;
    }

    private long waitNextMillis(long lastTimestamp) {
        long timestamp = System.currentTimeMillis();
        while (timestamp <= lastTimestamp) {
            timestamp = System.currentTimeMillis();
        }
        return timestamp;
    }
}
4.5 关键设计决策:各字段的位数分配
对于不同规模的公司,Snowflake 的位分配可以调整:
| 场景 | 时间戳位 | 机器位 | 序列位 | 适用规模 |
|---|---|---|---|---|
| 标准(Twitter) | 41 | 10 | 12 | 1024 节点,4096/ms |
| 大厂(机器多) | 40 | 12 | 11 | 4096 节点,2048/ms |
| 小公司 | 41 | 5 | 17 | 32 节点,13万/ms |
| 高 QPS | 39 | 8 | 16 | 256 节点,6.5万/ms |
五、时钟回拨——Snowflake 的阿喀琉斯之踵
5.1 什么是时钟回拨
服务器时钟不是绝对精确的。NTP(Network Time Protocol)同步时,如果发现本地时钟比 NTP 服务器快,就会把时钟往回拨。这就产生了时钟回拨。
正常时间线: t1 → t2 → t3 → t4 → t5
回拨发生时: t1 → t2 → t3 → t2' → t3' → t4'
                        ↑
                    时钟回拨到这个点
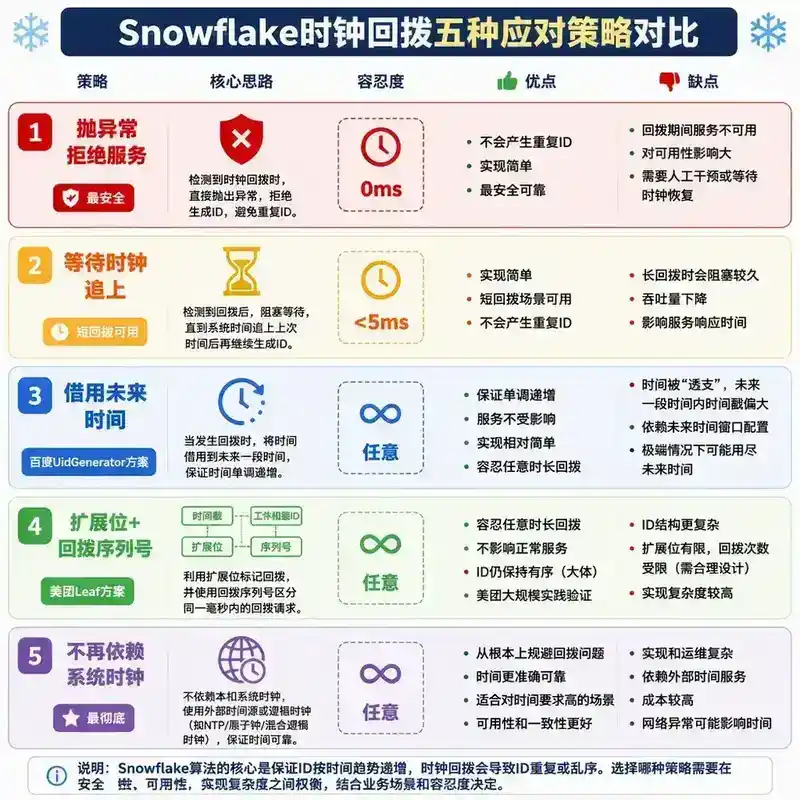
Snowflake 依赖时间戳递增来保证 ID 趋势递增。如果时钟回拨,就可能在新的 t2' 时刻生成与历史 t2 时刻相同时间戳的 ID,虽然序列号不同不会导致 ID 重复,但 ID 不再趋势递增——这可能导致主键冲突或索引写入性能下降。
澄清一个常见误解:单纯的时间戳相同(通过序列号区分)不会导致 ID 重复,因为 Snowflake ID 由「时间戳 + 机器 ID + 序列号」三元组唯一标识。时钟回拨的真正风险是:如果回拨后机器 ID 也相同(比如同一台机器重启后),就可能生成与历史完全相同的 ID。
5.2 百度 UidGenerator 的解决方案
百度开源的 UidGenerator 提供了两种时钟回拨处理策略:
方案一:缓存时间戳(CachedUidGenerator)
使用 RingBuffer 提前生成一批 ID 放入缓存。时钟回拨时,如果回拨幅度在 RingBuffer 覆盖范围内,直接使用缓存中的 ID,无需重新生成。
方案二:借用未来时间(DefaultUidGenerator)
当检测到时钟回拨时,如果回拨幅度较小(比如小于 5 秒),不抛异常,而是借用上次时间戳继续生成,相当于"硬扛"过回拨窗口。等到实际时间追上来后再恢复正常。
// 简化的"借用未来时间"逻辑
if (currentTimestamp < lastTimestamp) {
    long offset = lastTimestamp - currentTimestamp;
    if (offset <= MAX_BACKWARD_MS) {  // 例如 5000ms
        // 借用上次时间戳,用序列号区分
        currentTimestamp = lastTimestamp;
        sequence = (sequence + 1) & MAX_SEQUENCE;
    } else {
        throw new ClockBackwardsException("时钟回拨超过阈值");
    }
}
5.3 美团 Leaf-snowflake 方案
美团 Leaf 的 Snowflake 模式直接使用 ZooKeeper 持久顺序节点来注册 workerId,并在时间回拨时做特殊处理:
- 启动时向 ZK 注册,获取 workerId
- 每 3 秒上报当前时间戳到 ZK
- 生成 ID 时,如果发现时钟回拨:
- 检查回拨时间是否在阈值内(如 5ms)
- 若在阈值内,等待时间追上
- 若超过阈值,拒绝服务,触发告警
5.4 生产环境的时钟回拨防护
除了代码层面的处理,还需要在基础设施层面做防护:
| 防护层 | 措施 | 效果 |
|---|---|---|
| NTP 配置 | 使用 ntpd -x 模式(slew)而非 step 模式 |
时钟仅微调,不会大幅回拨 |
| 监控告警 | 监控各节点 NTP 偏移量,超过阈值告警 | 提前发现时钟异常 |
| 启动检测 | 服务启动时,对比当前时间与上次存储的时间戳 | 防止频繁重启导致的时间戳重复 |
| 多级缓存 | 缓存最近 N 毫秒的最大序列号 | 回拨时检查是否与历史 ID 冲突 |
六、雪花算法的工程变体
6.1 百度 UidGenerator
百度 UidGenerator 在 Snowflake 基础上做了以下改进:
- RingBuffer 预生成:使用 Disruptor 框架的 RingBuffer 提前生成 ID,消除生成 ID 时的锁竞争
- WorkerId 分配:集成数据库 worker_node 表自动分配 workerId,无需手动配置
- 时间回拨处理:如 5.2 节所述
6.2 美团 Leaf
美团 Leaf 同时支持号段模式(Leaf-segment)和 Snowflake 模式(Leaf-snowflake),可以无缝切换:
- Leaf-segment:适合对 ID 趋势递增要求不高的场景,简单可靠
- Leaf-snowflake:适合对 ID 单调递增有严格要求的场景,需要 ZK 依赖
6.3 滴滴 TinyId
滴滴的 TinyId 基于号段模式,但做了改造:
- 使用 HTTP 协议暴露服务,降低接入成本
- 客户端集成本地缓存,减少网络调用
- 支持多业务线隔离
七、方案对比与选型指南
7.1 方案对比总表
| 维度 | UUID | UUIDv7 | 数据库号段 | Snowflake | Leaf(号段) | Leaf(Snowflake) |
|---|---|---|---|---|---|---|
| 全局唯一 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 趋势递增 | ❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
| 纯内存生成 | ✅ | ✅ | ✅(号段内) | ✅ | ✅(双Buffer) | ✅ |
| 强依赖外部 | ❌ | ❌ | MySQL | ❌ | MySQL | ZK |
| 单节点性能 | 极高 | 极高 | 极高 | 极高 | 极高 | 极高 |
| 可读性 | 差 | 中 | 好 | 好 | 好 | 好 |
| 包含时间戳 | ❌ | ✅ | ❌ | ✅ | ❌ | ✅ |
| 时钟回拨风险 | ❌ | ❌ | ❌ | ✅ | ❌ | ✅ |
| 实现复杂度 | 极低 | 低 | 低 | 中 | 中 | 高 |
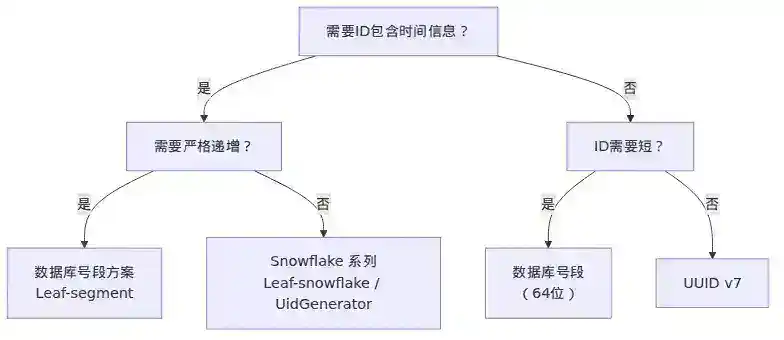
7.2 选型建议
小型项目(< 10 节点):数据库自增主键,或号段模式。最省心。
中型项目(10-50 节点,有 MySQL):美团 Leaf-segment。简单可靠,运维成本低。
大型项目(50+ 节点,需要趋势递增):Snowflake 或其变体。注意时钟回拨和 workerId 管理。
超大规模(100+ 节点,需要时间信息):美团 Leaf-snowflake。配套 ZK 集群,做好监控。
对信息安全要求极高:UUIDv7 或 Snowflake + ID 加密。Snowflake 的 ID 如果连续暴露,可以通过时间戳位反推业务量。
八、生产实践中的常见陷阱
8.1 workerId 分配与回收
Snowflake 的 workerId 需要全局唯一。手动配置容易出错,推荐方案:
- ZooKeeper 持久顺序节点:每个节点启动时创建临时顺序节点,获取序号作为 workerId(美团 Leaf 方案)
- 数据库自增 ID:worker_node 表,每次启动插入一条记录,获取自增 ID 作为 workerId(百度方案)
- Kubernetes StatefulSet:利用 Pod 序号作为 workerId,但要注意 Pod 重建时序号是否变化
8.2 序列号用尽怎么办
当同一毫秒内的序列号用完(达到 4095),需要等待下一毫秒。在 waitNextMillis() 中,经典实现是忙等(busy-wait):
while (timestamp <= lastTimestamp) {
    timestamp = System.currentTimeMillis();
}
如果 QPS 持续超过 4096/ms,这个循环会让 CPU 飙升。可以通过以下方式优化:
- 增加序列号位数(相应的减少机器位数)
- 使用更高精度的时间戳(如微秒),但需要确保时钟精度
- 降级到备用 ID 生成器
8.3 分布式 ID 与分库分表的配合
在分库分表场景中,ID 的生成策略会影响路由策略:
- Snowflake ID + 基因法:从 Snowflake ID 中取最后 N 位作为分片键(用户 ID 的基因),实现同一用户的数据落到同一分片
- 号段 ID + 映射表:维护一个 ID → 分片键的映射关系,查询时先查映射表定位分片
8.4 ID 生成器的性能压测
不要只看单节点 QPS。实际压测时需要关注:
| 指标 | 关注点 | 典型值(Snowflake 单节点) |
|---|---|---|
| QPS | 峰值吞吐量 | 50万-100万/秒 |
| P99 延迟 | 极端情况下的响应时间 | < 1ms |
| 序列号耗尽频率 | 是否需要等待下一毫秒 | QPS > 4096 时触发 |
| 时钟回拨次数 | NTP 同步导致 | 取决于 NTP 配置 |
九、总结
分布式 ID 看似简单,但每个方案的选择背后都有深刻的工程权衡:
- UUID 胜在无中心化,但它的随机性在数据库层面是灾难
- 数据库号段 胜在简单可靠,但强依赖数据库,ID 浪费问题需要关注
- Snowflake 是工业界的事实标准,时间戳在前的设计让 ID 天然趋势递增,但时钟回拨是所有实现者必须直面的问题
面试中,能讲清楚 Snowflake 的位结构不算过关,能讲清楚时钟回拨的五种处理方案才算真正理解。能讲清楚趋势递增对 B+Tree 索引的影响,能对比 Leaf、UidGenerator 的架构差异,才是面试官期望的深度。
面试官提问
(以下问题不计入 40 分钟阅读时间,建议先自行思考,再对照参考答案)
Q1:Snowflake 生成的 ID 在极端情况下可能重复吗?请具体描述场景。
Q2:数据库号段方案中,如果号段步长设为 10000,服务重启 100 次会浪费多少 ID?如何平衡步长与浪费?
Q3:UUIDv7 为什么比 UUIDv4 更适合做数据库主键?
Q4:美团 Leaf 的号段模式为什么不直接用**REPLACE INTO**而用**UPDATE**+**SELECT**?
Q5:如果 Snowflake 的工作节点超过 1024 个怎么办?如何扩展?
Q6:在分库分表场景下,Snowflake ID 如何实现"同一用户的数据落到同一分片"?
Q7:为什么 Snowflake 的 epoch 不直接用 1970-01-01(Unix 纪元),而是要自定义一个起始时间?
参考答案
A1:会。两种场景:
- 时钟回拨 + 快速重启:节点运行在时间 T1,序列号到了 1000。时钟回拨到 T1 之前,节点重启,序列号重置为 0。此时在回拨后的时间点重新生成 ID,时间戳 + 机器 ID + 序列号 = 0 的组合可能与之前(T1 时刻,序号 0)重合。这是最危险的场景。解决方案:启动时检测上次存储的时间戳,如果当前时间早于上次时间,等待或拒绝服务。
- workerId 冲突:两个节点拿到了相同的 workerId(如 ZK 会话超时导致临时节点残留,新节点又创建了同序号节点)。解决方案:workerId 分配使用数据库 CAS 或 ZK 持久顺序节点 + 心跳检测。
A2:浪费 100 × 10000/2 ≈ 50 万(平均浪费半个步长)。平衡策略:
- 动态步长:根据消耗速度调整步长,高 QPS 业务用大步长,低 QPS 用小步长
- 双 Buffer:预加载下一个号段,当前号段耗尽时无缝切换,避免获取号段时的阻塞
- 步长上限:设置最大步长(如 100000),即使浪费也在可控范围内
A3:UUIDv7 将时间戳放在 UUID 的高位(前 48 位),使得 UUID 整体趋势递增。在 InnoDB B+Tree 中,趋势递增的 ID 插入时主要追加到索引的最右侧,页分裂大幅减少。而 UUIDv4 是完全随机的,插入时随机命中 B+Tree 的任意位置,频繁触发页分裂和索引碎片化。实测数据:UUIDv4 做 MySQL 主键时,写入性能只有自增 ID 的 50%-70%,而 UUIDv7 可以恢复到 90% 以上。
A4:REPLACE INTO 是先 DELETE 再 INSERT,有以下几个问题:
- 如果存在外键约束,DELETE 会级联删除关联数据
- DELETE + INSERT 会改变行的隐式
DB_ROW_ID,影响二级索引 - 在高并发场景下,
REPLACE INTO的 DELETE 操作会持有更强的锁,降低并发性能
而 UPDATE ... WHERE ... 是一条原子操作,配合 CAS(比较并交换)的思想,既安全又高效。Leaf 实际使用的 SQL 是:
UPDATE id_segment SET max_id = max_id + step WHERE biz_tag = 'order' AND max_id = ?
通过 max_id = ? 做乐观锁校验,防止并发更新。
A5:三种方案:
- 调整位数分配:减少时间戳位或序列号位,增加机器位。例如将 41+10+12 改为 39+12+11(4096 节点,2048/ms)
- 分区部署:不同业务使用不同的 epoch 起始时间或不同的 ID 前缀,分区隔离
- 引入数据中心 ID:将 10 位机器位拆分为 5 位数据中心 + 5 位机器 ID,可支持 32 个数据中心 × 32 个节点 = 1024 节点,但实际还是 1024。要突破 1024,必须调整位数分配
A6:使用基因法。核心思路:从 Snowflake ID 中提取最后 N 位作为分片基因。
用户 ID = 123456
Snowflake ID = 0(1bit) + 时间戳(41bit) + workerId(10bit) + 序列号(12bit)

基因法:将 Snowflake ID 的最后 6 位替换为用户 ID 的 hash 后 6 位
分片路由时:取 ID 的最后 6 位,映射到对应的分片
这样,同一用户生成的所有 ID 末尾都有相同的"基因",一致性地路由到同一分片。
A7:两个原因:
- 延长可用时间:如果从 1970-01-01 开始,41 位能表示到 2039 年(约 69 年),剩余时间不够。从 2020-01-01 开始,可以用到 2089 年。
- 减小 ID 数值:epoch 越近,时间戳差值越小,生成的 ID 数值也越小,节省存储空间和传输带宽。例如用 2020 年 epoch,第 1 年的 ID 约 10^15 级别;用 1970 年 epoch,第 1 年的 ID 约 10^17 级别。