阅读时间:约 40-50 分钟 难度:进阶 分类:11 分布式理论、事务与一致性(161–175) 前置知识:分布式系统基础概念、CAP 定理、RPC 通信模型
目录
- 为什么需要共识算法
- 共识问题的形式化定义
- FLP 不可能定理与故障模型
- Paxos:共识算法的鼻祖
- Multi-Paxos 与工程优化
- Raft:为可理解性而设计
- Raft 领导者选举
- Raft 日志复制
- Raft 安全性保证
- Paxos 与 Raft 深度对比
- 工程实现与生产实践
- 面试官视角提问
1. 为什么需要共识算法
1.1 分布式系统的核心矛盾
在一个单机系统中,让多个进程就某个值达成一致很简单:共享内存加一把锁就够了。但在分布式系统中,节点之间没有共享内存,只能通过消息传递来通信,而消息传递天然不可靠——延迟、丢包、乱序、重复,甚至节点本身也会宕机。
这就是分布式共识问题的本质:一组节点,通过网络通信,如何在部分节点故障的情况下,就某个值达成一致。
1.2 共识算法的应用场景
共识算法不是学术玩具,而是现代分布式基础设施的基石:
| 场景 | 说明 | 典型系统 |
|---|---|---|
| 分布式锁 | 多节点竞争同一资源,需要确定唯一持有者 | Chubby, ZooKeeper |
| 主节点选举 | 集群中选出一个 Leader 协调工作 | Kafka Controller, Elasticsearch Master |
| 配置管理 | 集群配置变更需原子广播到所有节点 | etcd, Consul |
| 元数据一致性 | 分布式文件系统的命名空间、块位置映射 | HDFS NameNode HA, Ceph Monitor |
| 分布式事务 | 2PC 协调器本身需要高可用 | 各种分布式事务管理器 |
| 复制状态机 | 多副本执行相同的命令序列,保证状态一致 | Raft 的核心应用模型 |
1.3 复制状态机模型
共识算法最经典的应用模型是复制状态机(Replicated State Machine, RSM):
图1|复制状态机架构图
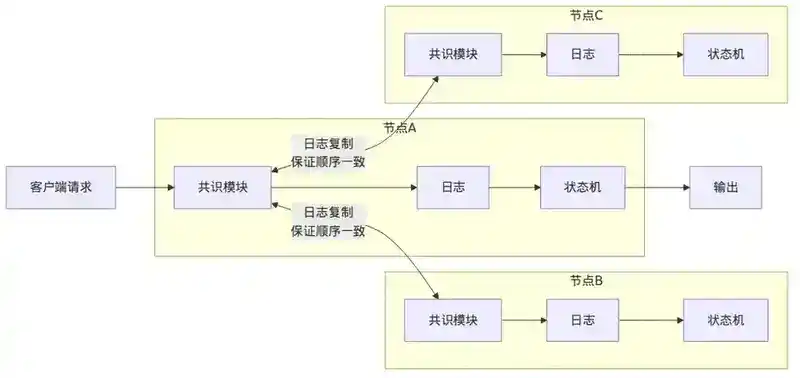
核心思想:如果多个节点以相同的初始状态启动,按相同的顺序执行相同的命令序列,那么它们最终会达到相同的状态。共识算法负责保证"相同的顺序"这一条件。
客户端请求 ──→ [共识模块] ──→ [日志] ──→ [状态机] ──→ 输出
                  │
                  │ (保证所有节点日志顺序一致)
                  │
              [共识模块] ──→ [日志] ──→ [状态机] ──→ 输出  (副本节点)
2. 共识问题的形式化定义
2.1 单值共识(Single-Value Consensus)
最基础的共识问题可以描述为:N 个节点,每个节点可以提议(propose)一个值,协议结束后,所有正常节点必须就同一个值达成一致(decide)。
形式化地,一个正确的共识算法必须满足三个性质:
Termination(终止性):每个正确的节点最终都会决定某个值。 Agreement(一致性):所有正确的节点不会决定不同的值。 Validity(有效性):如果所有节点都提议同一个值 v,那么决定的值必须是 v。
这三条性质也被称为"共识三要素"。Validity 防止了平凡解(比如所有节点总是决定 0),确保算法确实反映了输入。
2.2 全序广播(Total Order Broadcast)
在工程实践中,我们不会只就一个值达成共识,而是需要就一个序列的值达成共识——这就是全序广播。
全序广播满足:
- Validity:如果正确节点广播了消息 m,它最终会投递 m
- Uniform Agreement:如果一个正确节点投递了消息 m,所有正确节点最终都会投递 m
- Integrity:每条消息最多被投递一次
- Total Order:如果两个正确节点都投递了 m1 和 m2,它们投递的顺序相同
全序广播等价于共识——给定一个共识算法,可以构建全序广播;反之亦然。这就是为什么 Paxos 和 Raft 都围绕"日志"这一序列化数据结构来设计。
3. FLP 不可能定理与故障模型
3.1 FLP 定理
在讨论共识算法之前,必须先理解 FLP 不可能定理(Fischer, Lynch, Paterson, 1985):
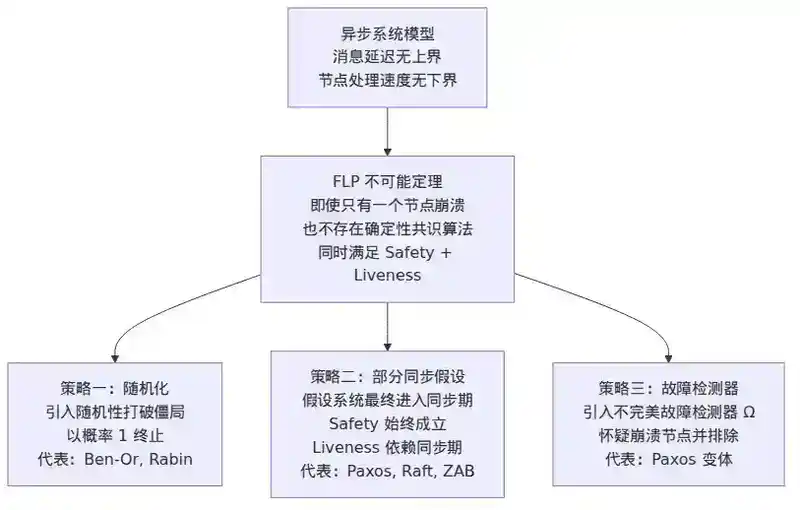
在异步系统中,即使只有一个节点可能发生崩溃故障,也不存在确定性的共识算法能同时满足终止性、一致性和有效性。
这里的"异步"意味着消息延迟没有上界,节点处理速度没有下界——这正是真实网络的抽象模型。
FLP 的结果不是"共识不可能",而是"在异步系统中,你无法同时保证安全性和活性"。实际算法通过引入随机化或部分同步假设来绕过 FLP:
| 策略 | 说明 | 代表算法 |
|---|---|---|
| 随机化 | 引入随机性打破僵局,以概率 1 终止 | Ben-Or, Rabin |
| 部分同步 | 假设系统最终会进入同步期 | Paxos, Raft, ZAB |
| 故障检测器 | 引入不完美的故障检测器 Ω | Paxos 变体 |
Paxos 和 Raft 都采用了"部分同步"假设:它们的安全性(Safety)在任何情况下都成立,而活性(Liveness)依赖于系统最终进入同步期。
图2|FLP 定理与共识算法绕过策略
3.2 故障模型
| 故障模型 | 描述 | 最少节点数 |
|---|---|---|
| 崩溃-停止(Crash-Stop) | 节点崩溃后不再恢复 | 2f+1 |
| 崩溃-恢复(Crash-Recovery) | 节点可能崩溃后恢复,需要持久存储 | 2f+1 |
| 拜占庭故障(Byzantine) | 节点可以任意行为,包括恶意 | 3f+1 |
Paxos 和 Raft 都假设崩溃-恢复模型,不处理拜占庭故障。如果节点可能作恶(如区块链场景),需要使用 PBFT 等拜占庭容错算法。
4. Paxos:共识算法的鼻祖
4.1 历史背景
Paxos 由 Leslie Lamport 在 1990 年提出,但论文直到 1998 年才发表在 ACM Transactions on Computer Systems。Lamport 以一个虚构的希腊岛屿 Paxos 上的议会为背景来描述算法,结果因为"故事太生动"而被审稿人要求重写。直到 2001 年 Lamport 发表了《Paxos Made Simple》,业界才开始真正理解 Paxos。
4.2 三种角色
Paxos 将节点分为三种角色(一个节点可以身兼多角):
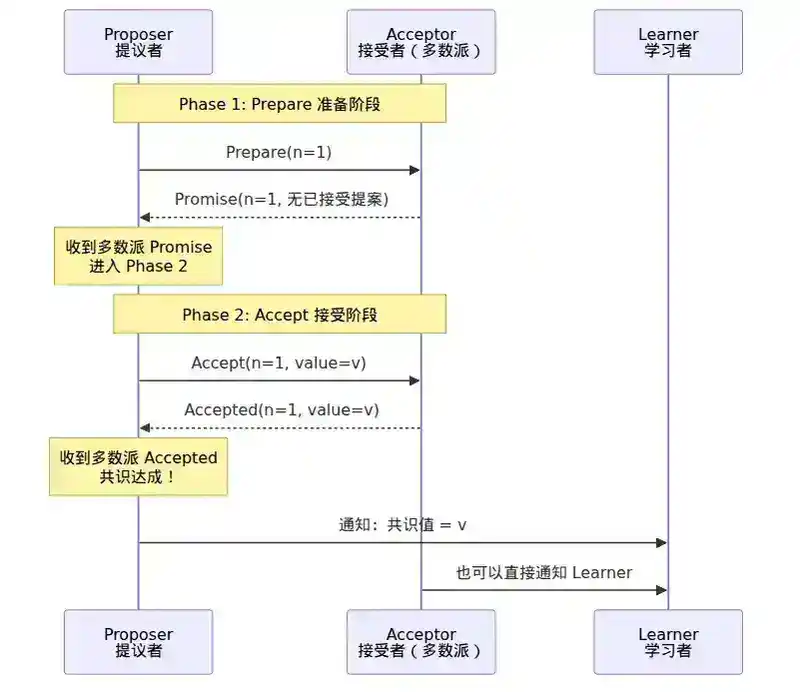
Proposer(提议者):发起提案,推动共识过程。客户端请求通常先到达 Proposer。 Acceptor(接受者):对提案进行投票。一旦足够多的 Acceptor 接受了某个提案,共识就达成了。 Learner(学习者):被动接收已达成共识的值,不参与投票过程。通常是那些需要知道结果的节点。
图3|Paxos 三角色交互图
4.3 Basic Paxos 协议
Basic Paxos 解决的是单个值的共识问题。它分为两个阶段:
Phase 1:Prepare(准备阶段)
- Proposer 选择一个提案编号 n(全局唯一、单调递增),向多数派(Quorum)Acceptor 发送
Prepare(n)请求。 - Acceptor 收到
Prepare(n)后:- 如果 n 大于它之前见过的所有 Prepare 请求的编号,则承诺(Promise)不再接受编号小于 n 的提案,并返回它已经接受的最高编号的提案(如果有的话)。
- 否则,拒绝(或不响应)。
Phase 2:Accept(接受阶段)
- 如果 Proposer 收到了多数派 Acceptor 的 Promise 响应:
- 它从所有响应中选出已接受提案中编号最大的那个值作为自己的提案值。如果所有 Acceptor 都还没接受过任何提案,Proposer 可以自由选择提案值。
- 向多数派 Acceptor 发送
Accept(n, value)请求。
- Acceptor 收到
Accept(n, value)后:- 如果 n 不小于它承诺过的最小编号,则接受该提案,返回
Accepted(n, value)。 - 否则拒绝。
- 如果 n 不小于它承诺过的最小编号,则接受该提案,返回
- 一旦 Proposer 收到多数派 Acceptor 的 Accepted 响应,共识达成。Learner 可以从 Acceptor 处学习到已达成共识的值。
关键洞察:提案编号的作用
Paxos 最精妙的设计在于提案编号。它保证了:
- 即使多个 Proposer 同时提案,也能收敛到一致的值
- 一个值一旦被多数派接受,后续任何达成共识的值都必然等于它(这是 Paxos 安全性的核心证明)
4.4 Basic Paxos 的局限性
Basic Paxos 只能就一个值达成共识。在实际系统中,我们需要连续就多个值(如日志中的多条命令)达成共识。如果每决定一个值就跑一轮 Basic Paxos,代价太高。
此外,Basic Paxos 存在**活锁(Livelock)**问题:两个 Proposer 交替提高提案编号,导致谁也完不成第二轮。解决方案是引入 Leader(Distinguished Proposer),让 Leader 独占提案权。
5. Multi-Paxos 与工程优化
5.1 Multi-Paxos 的核心思想
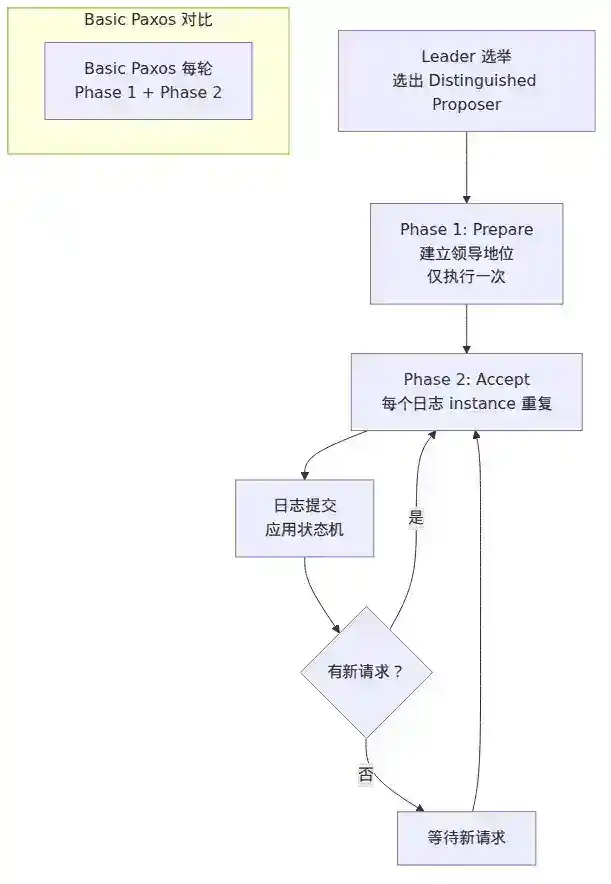
Multi-Paxos 将 Basic Paxos 扩展到连续的多个实例(instance),每个 instance 决定日志中的一个位置(slot)的值。
关键优化:选举一个稳定的 Leader,Leader 只在 Phase 1 执行一次 Prepare(建立领导地位),后续的 instance 直接从 Phase 2(Accept)开始。这大幅减少了消息轮次。
图4|Multi-Paxos 流程图
5.2 Multi-Paxos 的工程挑战
虽然 Multi-Paxos 在概念上简单,但工程实现面临大量细节问题:
| 挑战 | 说明 |
|---|---|
| Leader 选举 | 如何确保同一时刻只有一个 Leader?如何检测 Leader 故障? |
| 日志空洞 | 如果某个 instance 未达成共识,后续 instance 已提交,如何处理? |
| 成员变更 | 集群节点增减时,如何安全地过渡新旧配置? |
| 日志压缩 | 日志无限增长,如何做快照(Snapshot)? |
| 读操作优化 | Lease 读、Read Index 等避免每次读都走共识 |
这些问题在 Paxos 论文中没有明确答案,导致不同实现(Chubby、ZooKeeper 等)各自为战,互不兼容。
6. Raft:为可理解性而设计
6.1 设计哲学
Raft 由 Diego Ongaro 和 John Ousterhout 在 2014 年提出,核心动机是可理解性(Understandability)。Ongaro 在博士论文中指出:Paxos 虽然正确,但极其难以理解,导致工程实现经常出错。
Raft 的设计原则:
- 问题分解:将共识分解为领导者选举、日志复制、安全性三个相对独立的子问题
- 状态空间简化:减少不确定的状态和边缘情况
- 强领导者:所有日志条目从 Leader 流向 Follower,不允许乱序
- 随机化:使用随机超时避免选举冲突
6.2 Raft 的三种角色
图5|Raft 角色状态转换图
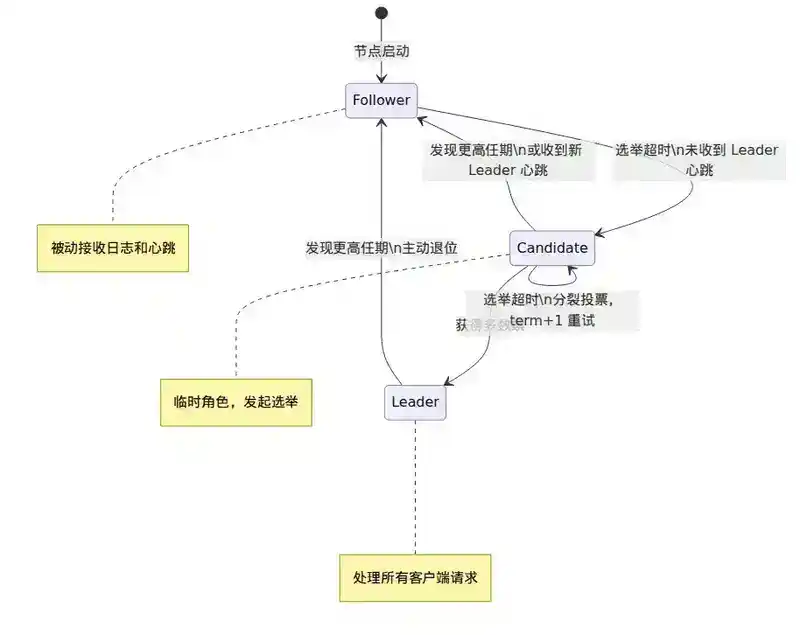
Raft 中每个节点在任意时刻处于三种角色之一:
Leader(领导者):处理所有客户端请求,管理日志复制。集群中最多一个 Leader。 Candidate(候选人):发起选举,试图成为 Leader。这是一个临时角色。 Follower(跟随者):被动接收 Leader 的日志和心跳。不主动发起请求。
角色转换规则:
- 所有节点启动时为 Follower
- Follower 在选举超时(election timeout)内未收到 Leader 心跳,转为 Candidate
- Candidate 获得多数票则成为 Leader
- Candidate 发现更高任期(term)的节点则退回 Follower
- Leader 发现更高任期的节点则退回 Follower
6.3 任期(Term)
Raft 将时间划分为任意长度的任期(Term),每个任期以整数编号,单调递增:
- 每个任期最多有一个 Leader(可能没有,当选举失败时)
- 任期号在 RPC 中传递,用于检测过期信息
- 节点看到更高任期号时,立即更新自己的任期号并转为 Follower
任期是 Raft 的逻辑时钟,起到了 Paxos 中提案编号的作用。
7. Raft 领导者选举
7.1 选举流程
- Follower 的选举定时器超时(150ms–300ms 随机),转为 Candidate
- 任期号 +1,投票给自己,向所有其他节点发送
RequestVoteRPC - 三种可能的结果:
赢得选举:收到多数节点的投票 → 成为 Leader → 立即发送心跳(AppendEntries RPC,entries 为空)确立权威
其他节点赢得选举:收到新 Leader 的 AppendEntries RPC → 如果任期号 ≥ 自己的,退回 Follower
选举超时:没有 Candidate 获得多数票(分裂投票)→ 任期号 +1,重新选举
图6|Raft 选举流程时序图
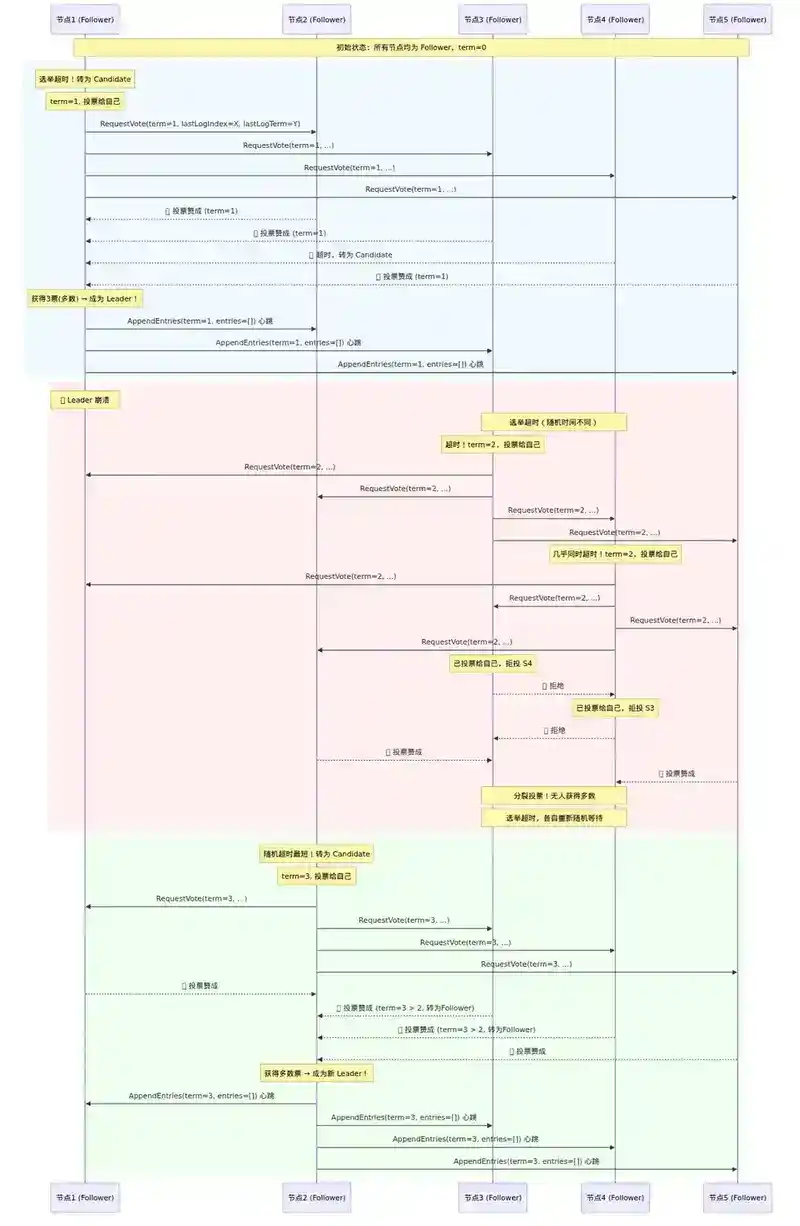
7.2 选举安全性
Raft 的选举不是"谁先来谁当 Leader",而是有严格的资格限制:
投票限制:Candidate 的日志必须"至少和投票者一样新"。判断标准:比较最后一条日志条目的(term, index),谁的 term 大谁新,term 相同则 index 大的新。
这个限制保证了:只有日志包含所有已提交条目的节点才能成为 Leader。这是 Raft 安全性的基石。
为什么这个限制成立?
- 一条日志被提交(committed)意味着它被多数节点存储
- 一个 Candidate 要赢得选举,必须获得多数票
- 这两个多数派必然有交集
- 交集节点中至少有一个拥有已提交的日志
- 该节点投票时会检查 Candidate 的日志是否"至少和自己一样新"
- 因此,赢得选举的 Candidate 必然拥有所有已提交的日志
7.3 随机超时的巧妙之处
每个节点的选举超时在 [T, 2T] 之间随机(通常 T=150ms)。这个设计简单而有效:
- 随机化确保不同节点的超时时间几乎不会相同
- 第一个超时的节点有最大概率成为 Leader
- 即使发生分裂投票,各节点重新随机超时,大概率在下一次选举中成功
这种随机化机制是 Raft 绕过 FLP 的关键:在异步环境下,它保证了以概率 1 最终选出 Leader。
8. Raft 日志复制
8.1 日志结构
Raft 的日志是一个有序的条目序列,每条日志包含:
{term: 任期号, index: 索引位置, command: 状态机命令}
图7|Raft 日志结构图
flowchart LR
    subgraph Leader["Leader 日志 (term=3)"]
        direction LR
        A0["idx:0 t:1<br/>x←3"] --- A1["idx:1 t:1<br/>y←1"] --- A2["idx:2 t:1<br/>z←9"] --- A3["idx:3 t:2<br/>w←4"] --- A4["idx:4 t:3<br/>a←7"] --- A5["idx:5 t:3<br/>b←2"] --- A6["idx:6 t:3<br/>c←5 ✓"]
    end

    subgraph F1["Follower 1 (nextIndex=6, matchIndex=5)"]
        direction LR
        B0["idx:0 t:1<br/>x←3"] --- B1["idx:1 t:1<br/>y←1"] --- B2["idx:2 t:1<br/>z←9"] --- B3["idx:3 t:2<br/>w←4"] --- B4["idx:4 t:3<br/>a←7"] --- B5["idx:5 t:3<br/>b←2"]
    end

    subgraph F2["Follower 2 (nextIndex=3, matchIndex=2)"]
        direction LR
        C0["idx:0 t:1<br/>x←3"] --- C1["idx:1 t:1<br/>y←1"] --- C2["idx:2 t:1<br/>z←9"]
    end
每条日志条目结构为 {term, index, command}。Leader 为每个 Follower 维护 nextIndex(下一条要发送的日志索引)和 matchIndex(已知已匹配的最高索引)。图中 ✓ 标记表示该条目已被多数派确认提交(committed)。
Leader 维护每个 Follower 的 nextIndex(下一条要发送的日志索引)和 matchIndex(已知已匹配的最高索引)。
8.2 正常复制流程
- 客户端向 Leader 发送命令
- Leader 将命令追加到自己的日志(未提交)
- Leader 向所有 Follower 发送
AppendEntriesRPC(并行) - 当 Leader 收到多数派确认后,将该条目标记为
committed,应用到状态机,返回结果给客户端 - Leader 在下一次
AppendEntries(心跳或下一次复制)中告知 Follower 新的leaderCommit索引 - Follower 收到后,将
leaderCommit之前的条目应用到状态机
8.3 日志一致性
Raft 维护一个关键的日志属性——日志匹配特性(Log Matching Property):
如果不同节点的日志中,有两条条目拥有相同的 term 和 index,那么它们存储的命令相同,且这两个日志中该索引之前的所有条目都完全相同。
这个特性由以下不变式保证:
- Leader 在特定 index 和 term 最多创建一条日志条目
AppendEntries会做一致性检查:发送前一条条目的(term, index),Follower 拒绝不匹配的追加
8.4 日志冲突处理
当 Follower 的日志与 Leader 不一致时(例如旧 Leader 崩溃前只复制了部分日志),Raft 通过以下方式解决:
- Leader 从后往前寻找与 Follower 日志一致的位置
- 从该位置开始覆盖 Follower 的日志
具体做法:Leader 为每个 Follower 维护 nextIndex。如果 AppendEntries 被拒绝(一致性检查失败),Leader 递减 nextIndex 并重试。这个过程会快速收敛到一致的位置。
图8|日志冲突处理流程图
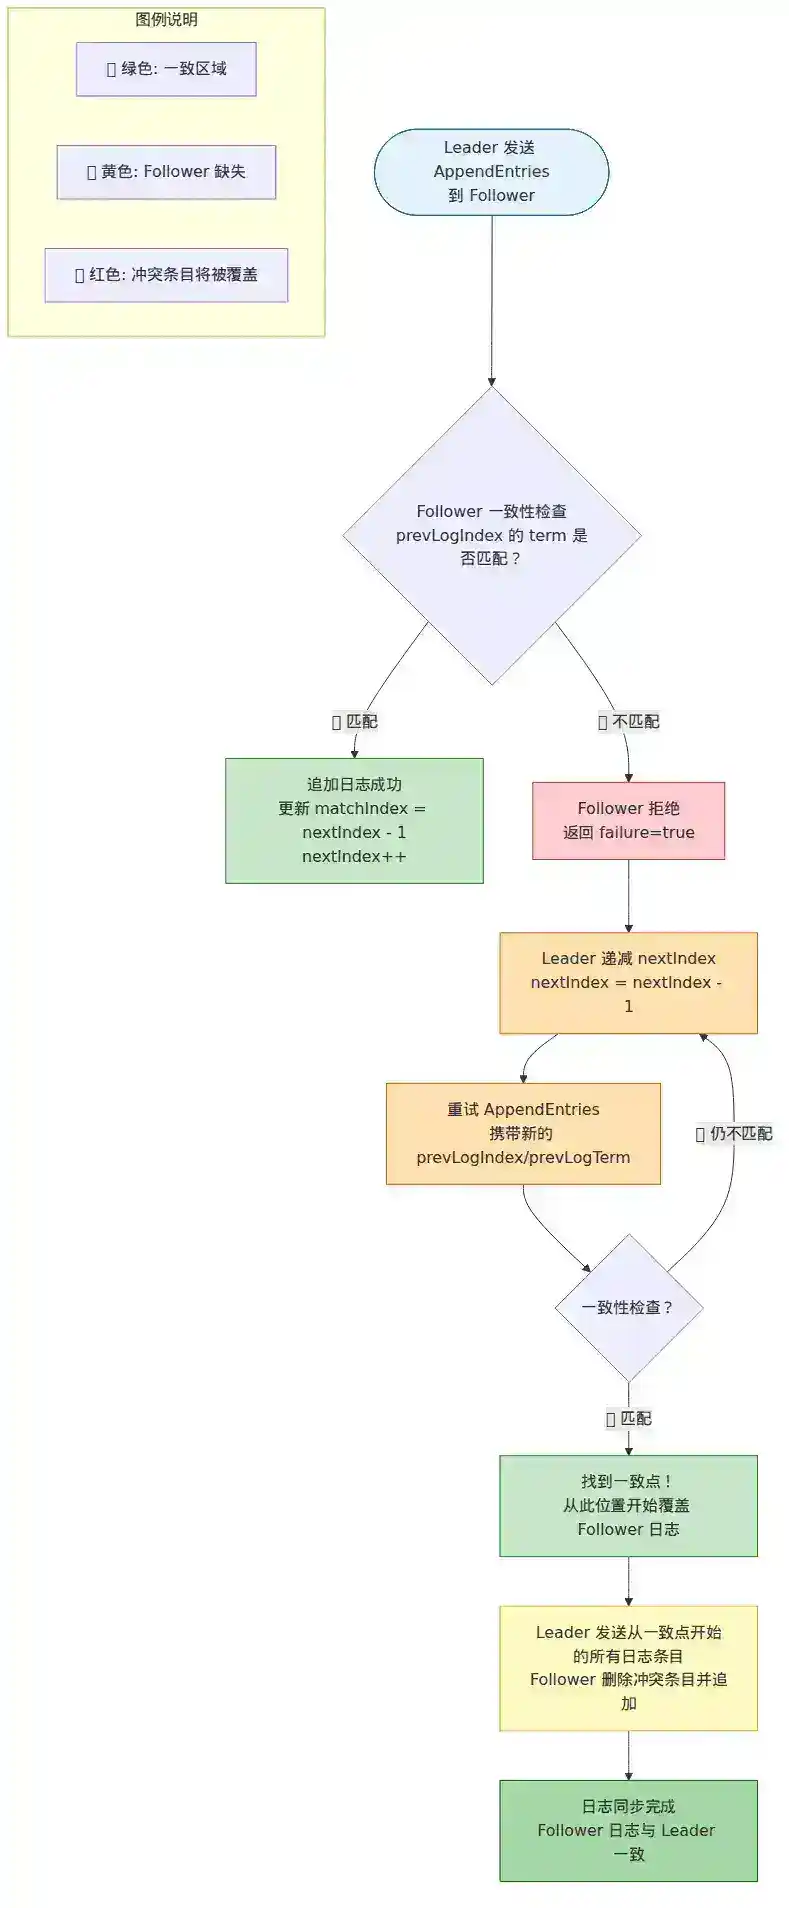
8.5 提交规则
Raft 的提交规则有微妙之处:Leader 只能提交当前任期的日志条目。
这意味着:Leader 不能因为某条旧任期的日志被多数节点存储就提交它。它必须通过提交一条当前任期的日志来"间接提交"之前的日志。
这个规则防止了图 8 中展示的微妙场景:
- (a) S1 是 Leader,在 index=2 处复制了 term=2 的日志,但只复制到了 S2
- (b) S1 崩溃,S5 通过 S3、S4、S5 的投票成为 term=3 的 Leader,在 index=2 处写入了一条新日志
- (c) S5 崩溃,S1 重新成为 term=4 的 Leader,继续复制之前的 term=2 日志到 S3
- 此时,如果 S1 提交了 term=2 的日志(因为它已在多数节点上),然后 S1 崩溃
- (d) S5 可能再次成为 Leader(通过 S2、S3、S4、S5 的投票),并覆盖已提交的 term=2 日志
通过要求 Leader 只能提交当前任期的日志,Raft 消除了这种风险。
9. Raft 安全性保证
9.1 安全性属性
Raft 保证以下安全性属性:
| 属性 | 说明 |
|---|---|
| 选举安全性(Election Safety) | 每个任期最多一个 Leader |
| Leader 仅追加(Leader Append-Only) | Leader 不覆盖或删除自己的日志条目 |
| 日志匹配(Log Matching) | 同 term 同 index 的条目内容相同,前缀相同 |
| Leader 完整性(Leader Completeness) | 已提交的日志条目一定出现在所有未来 Leader 的日志中 |
| 状态机安全性(State Machine Safety) | 所有节点按相同顺序执行相同的命令 |
9.2 安全性证明的关键:选举限制
Raft 安全性的核心在于选举限制:只有日志包含所有已提交条目的节点才能成为 Leader。这个限制通过 RequestVote RPC 中的日志比较实现。
结合 Quorum 交集原理,可以证明:一条已提交的日志(被多数节点存储)和赢得选举的 Candidate(获得多数节点投票)必然在至少一个节点上重叠,因此 Candidate 的日志必须包含已提交的条目。
9.3 成员变更
Raft 使用**联合共识(Joint Consensus)**来处理成员变更,避免在过渡期间出现两个 Leader:
图9|Raft 成员变更流程图
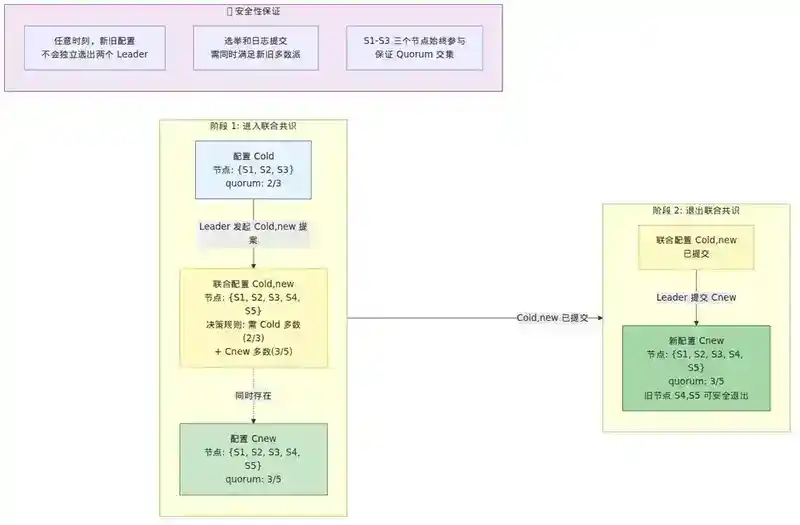
- Leader 向新老配置发起
Cold,new提案(所有节点都会收到) - 在
Cold,new期间,所有决策(选举和提交)需要分别获得新旧配置各自的多数派同意 Cold,new被提交后,Leader 再提交CnewCnew提交后,旧配置中的节点可以安全退出
这种方式保证了在任意时刻,新老配置不会独立选出两个 Leader。
9.4 日志压缩
Raft 使用**快照(Snapshot)**机制来压缩日志:
- 每个节点可以独立地对自己的状态机做快照
- 快照包含状态机当前状态 + 最后的(term, index)
- Leader 可以通过
InstallSnapshotRPC 向落后太多的 Follower 发送快照
10. Paxos 与 Raft 深度对比
10.1 对比总览
| 维度 | Paxos | Raft |
|---|---|---|
| 提出者 | Leslie Lamport (1990) | Ongaro & Ousterhout (2014) |
| 复杂度 | 高,难以理解和工程实现 | 低,为可理解性设计 |
| Leader 角色 | 非必需,但 Multi-Paxos 引入 | 强 Leader 模型,始终存在 |
| 日志方向 | 无强制方向 | 严格的 Leader → Follower 单向 |
| 选举机制 | 无明确标准,实现自行设计 | 明确的随机超时 + 任期 |
| 成员变更 | 无标准方案 | Joint Consensus |
| 日志恢复 | 多种策略,实现自行决定 | 确定性的回退覆盖 |
| 成熟度 | 30+ 年,大量变体 | 10+ 年,快速收敛 |
10.2 核心差异深入分析
可理解性:这是 Raft 最大的优势。Paxos 的单实例证明已经足够复杂,而 Multi-Paxos 的工程细节(空洞填充、Leader 选举、成员变更)在 Lamport 的论文中大多没有涉及,留给实现者自行解决。Raft 将所有细节都明确定义,没有灰色地带。
Leader 机制:Paxos 中 Leader 是优化(Multi-Paxos 引入),不是必须的。Raft 中 Leader 是架构核心,没有 Leader 就无法工作。这意味着 Raft 在 Leader 故障时会短暂不可用,但 Paxos 可以在无 Leader 的情况下继续就单个值达成共识。
日志约束:Paxos 允许日志中存在空洞(某个 instance 先已提交,前面 instance 还空着),Raft 不允许。Raft 的日志严格连续,这简化了实现但限制了并发。
10.3 类比理解
- Paxos 像汇编语言:概念精炼、表达能力极强,但写起来容易出错,需要大量工程经验
- Raft 像高级语言:封装了底层细节,有明确的 API 和约束,降低出错概率
11. 工程实现与生产实践
11.1 主流实现
| 系统 | 算法 | 语言 | 特点 |
|---|---|---|---|
| etcd | Raft | Go | Kubernetes 的配置中心,Raft 的参考实现 |
| Consul | Raft | Go | 服务发现 + KV 存储 |
| TiKV | Raft | Rust | TiDB 的分布式 KV 引擎,支持 Multi-Raft |
| ZooKeeper | ZAB | Java | Apache 生态标配,ZAB 是类 Paxos 协议 |
| Chubby | Paxos | C++ | Google 的分布式锁服务,Paxos 最早的大规模实现 |
| Megastore/Spanner | Paxos | C++ | Google 的全球分布式数据库,跨数据中心 Paxos |
| SOFAJRaft | Raft | Java | 蚂蚁开源的 Raft 实现,生产级 |
| braft | Raft | C++ | 百度开源的 Raft 实现 |
11.2 Multi-Raft 架构
在大规模分布式存储系统中(如 TiKV),单 Raft 组无法满足扩展性需求。Multi-Raft 架构将数据按 Range 分片,每个 Range 运行一个独立的 Raft 组:
图10|Multi-Raft 架构图
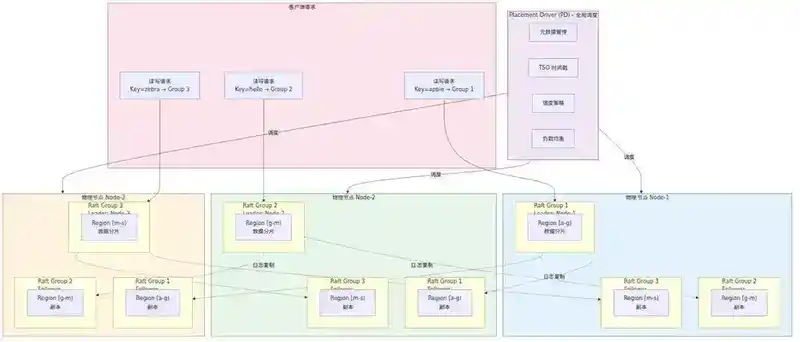
关键设计点:
- 每个物理节点运行多个 Raft 实例
- 每个 Raft Group 独立进行 Leader 选举和日志复制
- Leader 可以分散到不同节点,避免热点
- 通过 Placement Driver(PD)进行全局调度
11.3 性能优化实践
| 优化技术 | 说明 |
|---|---|
| Pipeline | 不等待前一条日志确认就发送下一条,提高吞吐 |
| Batch | 将多条日志批量发送,减少 RPC 次数 |
| Lease Read | Leader 在 Lease 期内直接读本地状态机,不走共识 |
| Read Index | 读请求记录当前 commit index,等待其被应用到状态机再返回 |
| Follower Read | 允许从 Follower 读,需先确认 Leader 仍然有效 |
| 异步应用 | 日志提交和状态机应用解耦,批量应用提高效率 |
| Pre-Vote | 防止网络分区节点的任期号被无意义地提高(Raft 论文 9.6 节) |
11.4 常见故障模式
| 故障 | 影响 | 恢复 |
|---|---|---|
| Leader 宕机 | 短暂不可用(选举超时内) | 自动选举新 Leader |
| Follower 宕机 | 无影响,Leader 继续服务 | 重启后从 Leader 同步日志 |
| 网络分区 | 少数派无法选举 Leader | 分区恢复后自动同步 |
| 磁盘故障 | 节点数据丢失 | 从 Leader 重新同步快照 + 日志 |
| 脑裂 | Raft 通过任期号 + 选举 quorum 防止 | 不会发生(如果正确实现) |
12. 面试官视角提问
以下问题从面试官视角设计,考察对共识算法的深层理解,而非简单复述文档内容。建议在读完正文后尝试回答,参考答案见问题下方。
Q1:Paxos 中,如果两个 Proposer 分别以提案编号 n=1 和 n=2 同时发起 Prepare,且 n=1 的 Proposer 先完成了 Phase 1,n=2 的 Proposer 随后完成 Phase 1,请问最终达成共识的值是谁提出的?请推演完整过程。
点击查看参考答案
完整推演:
- P1 (n=1) 发起 Prepare(1),获得多数派 Acceptor 的 Promise,此时 Acceptor 承诺不接受 n<1 的提案(无实际约束,因为 n 最小为 1)。
- P2 (n=2) 发起 Prepare(2),向多数派 Acceptor 发送请求。这些 Acceptor 中至少有一个也在 P1 的多数派中(Quorum 交集)。该 Acceptor 承诺不再接受 n<2 的提案。
- P1 进入 Phase 2,发送 Accept(1, v1)。但多数派 Acceptor 已经承诺 n≥2 了,所以 Accept(1, v1) 被拒绝。
- P2 收到多数派 Promise,进入 Phase 2。此时 P2 必须检查所有已接受的提案中编号最大的那个——如果存在的话。如果 P1 的 Accept(1, v1) 在 P2 的 Prepare(2) 之前到达了某个 Acceptor,该 Acceptor 会在 Promise 中返回这个已接受的提案 (1, v1)。P2 必须使用 v1 作为自己的提案值。
- P2 发送 Accept(2, v1),获得多数派 Acceptor 的接受,共识达成,值为 v1。
关键洞察:即使 P1 的提案被拒绝,它的值 v1 仍然可能通过 P2 的提案成为共识值。Paxos 的安全性保证了"一旦某个值被多数派接受,后续所有共识的值都等于它"——即使 P1 的 Accept 实际上只被少数 Acceptor 接受了,只要它被 P2 的多数派中的某个 Acceptor 看到,v1 就会成为最终值。
面试官追问:如果 P1 的 Accept(1, v1) 在所有 Acceptor 收到 Prepare(2) 之前就已经被多数派接受了,结果会怎样?
答:那么当 P2 发送 Prepare(2) 时,多数派 Acceptor 中至少有一个已经在 Promise 响应中返回了 (1, v1)。P2 必须使用 v1。最终共识值仍然是 v1。这体现了 Paxos 的核心安全性:一旦一个值被多数派接受,后续任何值都等于它。
Q2:Raft 中,一个节点在什么情况下会拒绝投票给 Candidate?假设你是面试官,请你设计一个场景,考察候选人对投票逻辑的完整理解。
点击查看参考答案
一个节点(Follower)在以下情况下会拒绝投票:
- 任期比 Candidate 小:Candidate 的 term 不在 Follower 的当前 term 之上(过期请求)
- 已经投过票:在当前 term 内已经给另一个 Candidate 投过票(每个 term 每个节点最多投一票)
- 日志不够新:Candidate 的日志比 Follower 的日志"旧"——即 Candidate 最后一条日志的 (term, index) 小于 Follower 的
面试场景设计:
假设 5 节点集群(S1-S5),当前 term=5,S1 是 Leader。S1 复制了日志到 index=100,但 index=100 尚未提交(只复制到 S1 和 S2)。
S1 崩溃,S2-S5 进入选举。S3 的选举超时最先触发,S3 转为 Candidate (term=6),但 S3 的日志只到 index=95。
问题:S2 会投票给 S3 吗?为什么?
答案:会。虽然 S2 的日志到 index=100,但 S2 的日志最后一条是 term=5, index=100。S3 的最后一条是 term=5, index=95。比较时先比 term(相同),再比 index(95 < 100)。S3 的日志不如 S2 新,所以 S2 会拒绝投票。
追问:如果 S3 确实当选了 Leader,会发生什么?已复制到 S2 但未提交的 index=100 日志会怎样?
答案:S3 不可能当选,因为它无法获得多数票(S2 和 S1 都不会投票给它,S1 已崩溃,S2 拒绝)。已复制但未提交的日志可能会被覆盖——这正是 Raft "只有提交的日志才安全"的原因。
更进一步:如果 S1 崩溃前 index=100 已经提交了呢?S3 还能当选吗?
答案:不能。index=100 提交意味着它被多数节点(至少 S1, S2, S3 中的两个)存储。S3 如果日志只到 index=95,它无法获得多数票——因为拥有 index=100 的两个节点(比如 S1 和 S2)中,至少 S2 会拒绝投票。这证明了 Raft 的 Leader Completeness 属性。
Q3:为什么 Raft 要求 Leader 只能提交当前任期的日志,而不能直接提交旧任期的日志?请构造一个具体反例说明。
点击查看参考答案
反例构造(即 Raft 论文 Figure 8 的扩展):
初始状态:5 节点集群 S1-S5,日志初始为空。
- term=2:S1 是 Leader。它在 index=2 处写入一条日志 (term=2, cmd=A),但只复制到了 S2。此时 S1 崩溃。
日志状态:S1, S2: [1, (2,A)]; S3, S4, S5: [1] 2. term=3:S5 成为 Leader(获得 S3, S4, S5 的投票,S1 崩溃,S2 的日志比 S5 新但 S5 获得了多数票——等等,S2 的日志是 (term=2, index=2),S5 的日志是空。S2 不会投票给 S5 因为 S5 的日志不如 S2 新。那 S5 是怎么成为 Leader 的?
修正:S5 获得 S3, S4, S5 的投票——3/5 多数。S2 虽然拒绝投票,但 S5 已经获得了多数票(3≠5 的多数,等等,5 的多数是 3。S1 崩溃,S5 获得 S3+S4+S5=3 票,刚好多数)。S5 在 index=2 处写入 (term=3, cmd=B),复制到 S3, S4。
日志状态:S1: [1, (2,A)]; S2: [1, (2,A)]; S3: [1, (3,B)]; S4: [1, (3,B)]; S5: [1, (3,B)] 3. term=4:S5 崩溃,S1 恢复,成为 Leader(获得 S1, S2, S3, S4 的投票)。S1 开始将 (term=2, cmd=A) 复制到 S3。
日志状态:S1: [1, (2,A)]; S2: [1, (2,A)]; S3: [1, (2,A)]; S4: [1, (3,B)]; S5: [1, (3,B)]
如果此时允许 S1 提交 index=2 的日志:(2,A) 在 S1, S2, S3 上存在,已是多数。S1 提交它,应用到状态机,返回客户端。 4. term=5:S1 崩溃,S5 恢复并成为 Leader(获得 S3, S4, S5 的投票——等等,S3 的日志是 [1, (2,A)],最后一条是 term=2,S5 的日志最后一条是 term=3。S5 的日志比 S3 新,所以 S3 可能投票给 S5。但 S5 需要覆盖 S3 的日志。S5 成为 Leader 后,会将 S3 的 index=2 覆盖为 (3,B)。
此时 (2,A) 已经被提交并应用到 S1, S2, S3 的状态机,但又被 S5 覆盖了!违反了状态机安全性。
Raft 的解决方案:在 step 3 中,S1 不能直接提交 (2,A),因为它不是当前任期(term=4)的日志。S1 必须先提交一条 term=4 的日志,通过这条日志的提交间接提交 (2,A)。这样,当 S1 提交 term=4 的日志时,它必须确保 (2,A) 也在多数节点上,同时 S5 在 term=5 的选举中会因为日志不够新而无法当选。
为什么这个规则有效? 因为提交当前任期的日志意味着 Leader 已经确认了多数节点拥有该任期之前的所有日志——否则一致性检查会失败。
Q4:在生产环境中,你的 Raft 集群频繁发生 Leader 切换(flapping),请分析可能的原因和排查思路。
点击查看参考答案
可能原因:
- 网络延迟/丢包:Leader 的心跳无法及时到达 Follower,导致 Follower 超时发起选举。这是最常见的原因。
- 磁盘 I/O 慢:Leader 的日志持久化(fsync)过慢,阻塞了心跳发送。
- GC 停顿:Leader 进程的 GC 暂停时间超过选举超时,期间无法发送心跳。
- CPU 资源不足:Leader 节点 CPU 被其他进程抢占,无法及时处理心跳。
- 选举超时配置不当:超时时间太短,对网络抖动过于敏感。
- Pre-Vote 未启用:网络分区恢复后,分区节点的高任期号触发不必要的选举。
排查思路:
1. 检查集群节点间的网络延迟和丢包率
   → ping, mtr, tcpdump 分析

2. 检查 Leader 节点的磁盘 I/O 延迟
   → iostat, 关注 fsync 延迟(Raft 日志需要持久化)

3. 检查 GC 日志
   → GC 暂停时间是否超过选举超时
   → 考虑调整 GC 策略或堆大小

4. 检查系统资源使用
   → CPU 使用率、内存、上下文切换次数
   → 确认 Raft 进程没有被 throttling

5. 审查 Raft 配置参数
   → 选举超时(建议 150-300ms)
   → 心跳间隔(建议 选举超时 / 3)
   → 是否启用 Pre-Vote

6. 检查是否有慢查询
   → 某些状态机操作可能耗时过长
   → 考虑异步 apply 或批量 apply
快速止血:如果线上正在 flapping,临时增大选举超时可以缓解,但最终需要找到根因。
Q5:设计一个基于 Raft 的分布式 KV 存储,要求支持线性一致性读。请画出架构并说明读路径上的关键决策。
点击查看参考答案
架构设计:
Client
  │
  ▼
┌─────────────┐
│  Raft Group  │
│              │
│  Leader ─────┼──→ Follower
│    │         │      │
│    ▼         │      ▼
│  State       │  State
│  Machine     │  Machine
│  (RocksDB)   │  (RocksDB)
└─────────────┘
线性一致性读的关键决策点:
- 不能直接读 Leader 本地状态机:Leader 可能已经被网络分区,另一个节点已经当选 Leader。如果旧 Leader 还认为自己有效,直接读会返回过期数据。
- 方案选择:
| 方案 | 实现 | 延迟 | 吞吐 |
|---|---|---|---|
| 走 Raft Log | 读请求也作为日志条目提交 | 高(RTT) | 低 |
| Read Index | 记录 commit index,等待应用 | 中(心跳 RTT) | 中 |
| Lease Read | Leader 在 Lease 期内直接读 | 低(本地读) | 高 |
- Read Index 流程:
a. Leader 记录当前 commitIndex
b. Leader 向多数派发送心跳确认自己仍是 Leader
c. 等待状态机 apply 到 ≥ commitIndex
d. 读取状态机并返回
步骤 b 是关键:确认 Leader 身份防止"旧 Leader 读过期数据"。 4. Lease Read 优化: - Leader 在心跳确认后获得一个 Lease 时间段 - 在 Lease 内,Leader 可以不经过心跳确认直接读 - Lease 时间 < 选举超时,确保不会有两个 Leader 同时持有有效 Lease 5. Follower Read 的实现:
a. Follower 向 Leader 请求当前 ReadIndex
b. Follower 等待自己的状态机 apply 到 ≥ ReadIndex
c. Follower 读取本地状态机并返回
这可以分担 Leader 的读压力。
Q6:Paxos 的"活锁"问题是什么?Raft 是如何从根本上避免的?
点击查看参考答案
Paxos 的活锁问题:
在 Basic Paxos 中,如果两个 Proposer 交替执行:
- P1 完成 Phase 1(Prepare(n=1)),获得多数 Promise
- P2 完成 Phase 1(Prepare(n=2)),使 P1 的 Phase 2 无法完成
- P1 再发起 Prepare(n=3),使 P2 的 Phase 2 无法完成
- 依此类推,无限循环
两个 Proposer 都在不断推进 Phase 1,但谁也无法完成 Phase 2。这在理论上可以无限持续。
Raft 的解决方案:
Raft 从架构层面根本性地避免了活锁:
- 强 Leader 模型:一次只有一个 Leader 处理请求,不存在多个 Proposer 竞争
- 随机超时:节点随机化选举超时,大幅降低同时竞争的概率
- Leader 稳定期:一旦 Leader 被选出,它会持续服务直到故障,不会被抢占
- Follower 不主动:Follower 只在 Leader 心跳超时后才发起选举,不像 Paxos Proposer 可以随时发起提案
对比:Paxos 的活锁在理论上需要 Multi-Paxos 引入 Leader 来解决,但如何选举 Leader 本身就是一个共识问题,Paxos 论文没有给出标准方案。Raft 则将 Leader 选举作为协议的一等公民来设计,从根本上避免了活锁。
一个有趣的思考:Raft 在选举阶段仍然可能出现"分裂投票"导致无人当选,这是另一种形式的"活锁"。但随机超时机制保证了最终收敛——每次分裂投票后,各节点重新随机超时,概率上最终会有一个节点先超时并成功当选。这利用了概率论中的"无限次尝试,成功概率为 1"。
本文完。欢迎在评论区讨论交流。