阅读时间:约 45 分钟 | 难度:中高级 | 分类:分布式理论、事务与一致性
目录
- 什么是分布式锁(10 分钟)
- 分布式锁的核心需求模型(5 分钟)
- 基于数据库的分布式锁(8 分钟)
- 基于 Redis 的分布式锁(8 分钟)
- 基于 ZooKeeper 的分布式锁(8 分钟)
- 三种方案的一致性 vs 可用性对比(6 分钟)
- 生产环境选型决策框架(5 分钟)
- 面试追问与回答(10 分钟)
1. 什么是分布式锁
1.1 从单机锁到分布式锁
在单机 Java 应用中,我们用 synchronized 或 ReentrantLock 保护共享资源:
synchronized (this) {
    // 临界区:只有一个线程能执行
    deductInventory(productId, 1);
}
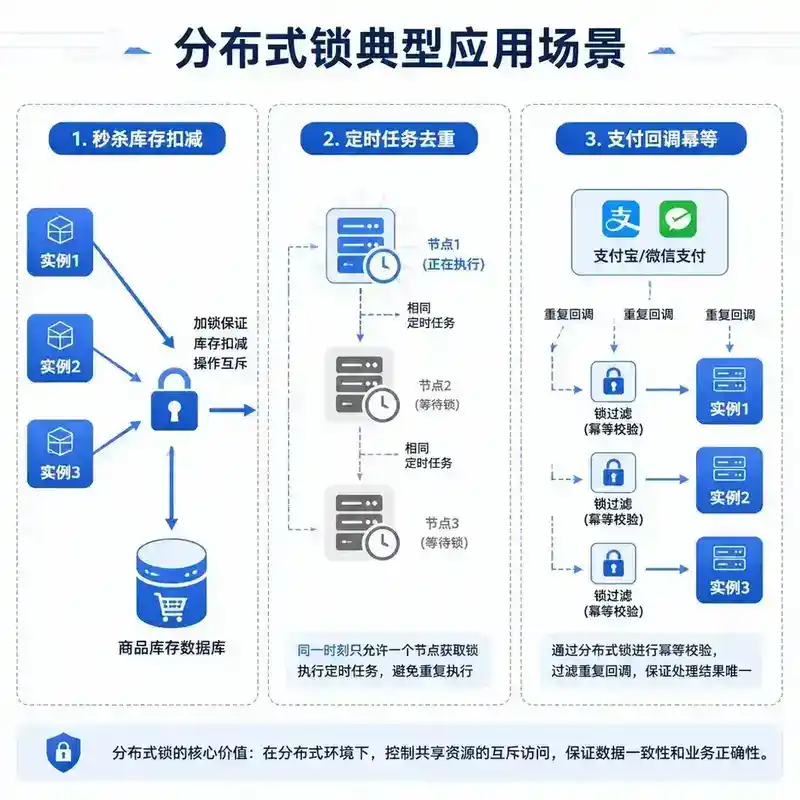
当应用部署到多台机器,JVM 内置锁失效了——不同 JVM 的锁对象互不可见。这就是分布式锁要解决的问题:在多个进程之间协调对共享资源的互斥访问。
1.2 典型场景
- 库存扣减:秒杀场景下多台机器同时扣减同一商品库存
- 定时任务互斥:多实例部署的定时任务,同一时刻只允许一个实例执行
- 幂等性保证:防止同一请求被多次处理
- 配置/数据发布:多个节点争抢"发布者"角色
1.3 分布式锁的本质
分布式锁在「没有一个所有进程都能直接访问的共享内存」的约束下,借助一个外部协调服务来实现互斥。这个协调服务本身需要满足:
- 互斥性:同一时刻只有一个客户端持有锁
- 无死锁:即使持锁客户端崩溃,锁最终也能被释放
- 容错性:只要协调服务的大多数节点存活,锁服务就可用
2. 分布式锁的核心需求模型
不只是"加锁、解锁"这么简单,生产级分布式锁需要考虑:
| 需求维度 | 描述 |
|---|---|
| 互斥(Mutual Exclusion) | 同一时刻只有一个客户端能持有锁 |
| 防死锁(Deadlock-Free) | 锁必须有过期机制,防止客户端崩溃后锁永不释放 |
| 阻塞/非阻塞(Blocking) | 获取不到锁时是自旋等待还是立即返回 |
| 可重入(Reentrant) | 同一客户端在持有锁期间能否再次获取 |
| 公平性(Fairness) | 多个客户端等待时,是否按请求顺序获取 |
| 高性能(Performance) | 加锁/解锁的延迟和吞吐量 |
| 高可用(Availability) | 协调服务自身故障时锁服务是否仍可用 |
CAP 视角:分布式锁的协调服务本质上是一个分布式系统,必然面临 CAP 取舍。你选择的锁方案,决定了你在一致性(C)和可用性(A)之间如何站队。
3. 基于数据库的分布式锁
3.1 唯一索引方案
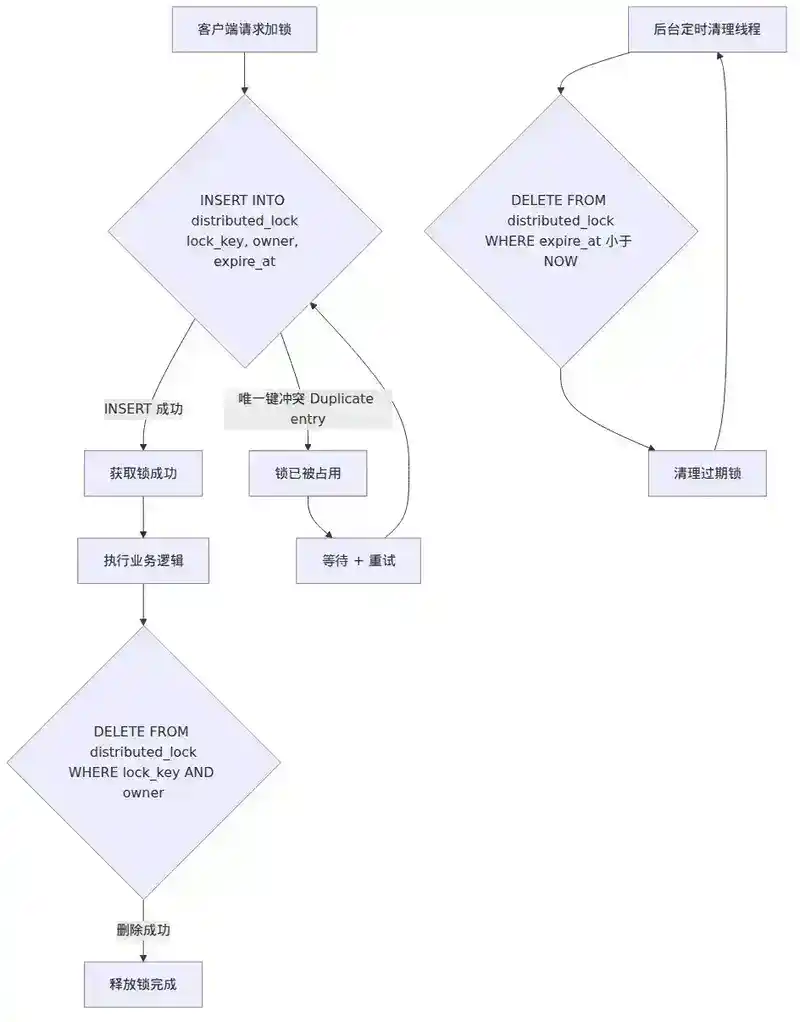
利用数据库唯一约束实现互斥:
-- 加锁:插入一条记录,利用唯一索引保证互斥
INSERT INTO distributed_lock (lock_key, holder, expire_at)
VALUES ('order:12345', 'node-1', NOW() + INTERVAL 30 SECOND);

-- 解锁:删除记录
DELETE FROM distributed_lock
WHERE lock_key = 'order:12345' AND holder = 'node-1';
加锁成功 → INSERT 返回成功;加锁失败 → 唯一键冲突,抛出 DuplicateKeyException。
3.2 乐观锁方案(CAS)
利用版本号实现乐观锁,适用于冲突不频繁的场景:
-- 读出版本号
SELECT version FROM resource WHERE id = 1;  -- version = 5

-- 带版本号更新
UPDATE resource SET value = 'new', version = 6
WHERE id = 1 AND version = 5;
-- affected_rows = 0 → 被其他进程抢先修改了,重试
-- affected_rows = 1 → 成功
3.3 悲观锁方案(SELECT FOR UPDATE)
-- 开启事务
BEGIN;
-- 对目标行加排他锁
SELECT * FROM resource WHERE id = 1 FOR UPDATE;
-- 执行业务操作
UPDATE resource SET value = 'new' WHERE id = 1;
-- 提交事务释放锁
COMMIT;
3.4 数据库方案的关键问题
防死锁:需要一个定时任务扫描并清理过期的锁记录:
DELETE FROM distributed_lock WHERE expire_at < NOW();
性能瓶颈:数据库的 QPS 有限(通常几千到几万),不适合高并发加锁场景。
单点故障:主库挂了锁服务就不可用,虽然可以通过主从切换缓解,但切换期间锁服务中断。
可用性问题:数据库通常是 CP 系统(主从复制有延迟),当发生网络分区时,可能牺牲可用性。
4. 基于 Redis 的分布式锁
4.1 基础实现:SET NX PX
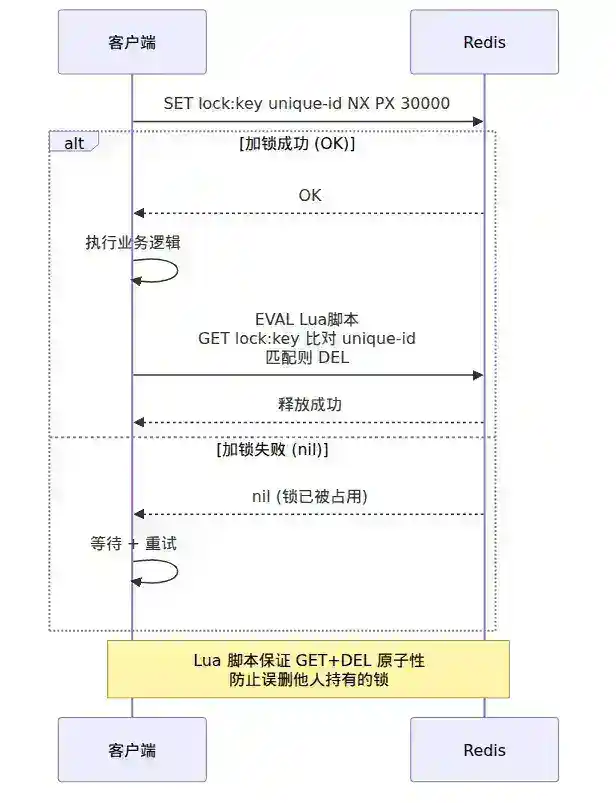
加锁:SET key value NX PX 30000
NX = 不存在时才设置;PX = 毫秒级过期
SET lock:order:12345 node-1 NX PX 30000

解锁:Lua 脚本保证原子性
if redis.call("GET", KEYS[1]) == ARGV[1] then
    return redis.call("DEL", KEYS[1])
else
    return 0
end
4.2 Redisson 的工业级实现
Redisson 解决了很多工程问题:
Watch Dog 自动续期:如果业务还没执行完,看门狗自动延长锁的过期时间(默认每 10 秒续期到 30 秒)。
// 默认 30 秒过期,watchdog 每 10 秒续期
RLock lock = redisson.getLock("order:12345");
lock.lock();  // 阻塞等待
try {
    // 业务逻辑
} finally {
    lock.unlock();
}
可重入:通过 Redis Hash 结构,key 为锁名,field 为客户端 ID,value 为重入次数。
红锁(Redlock):在多个独立的 Redis 节点上依次加锁,过半成功才算获取锁。
4.3 Redis 方案的关键问题
锁丢失风险:Redis 主从异步复制,主节点宕机后锁信息可能丢失。
时间线:
  T1: Client A 在主节点加锁成功
  T2: 主节点宕机,锁信息还未同步到从节点
  T3: 从节点提升为主,锁信息丢失
  T4: Client B 在新主节点上对同一 key 加锁成功
  → 两个客户端同时持锁!
这就是 Redis 分布式锁的核心争议:在 CP 场景下不够安全。
时钟跳跃:Redlock 依赖过期时间,如果系统时钟发生跳跃(NTP 调整),可能导致锁提前过期。
5. 基于 ZooKeeper 的分布式锁
5.1 临时顺序节点方案
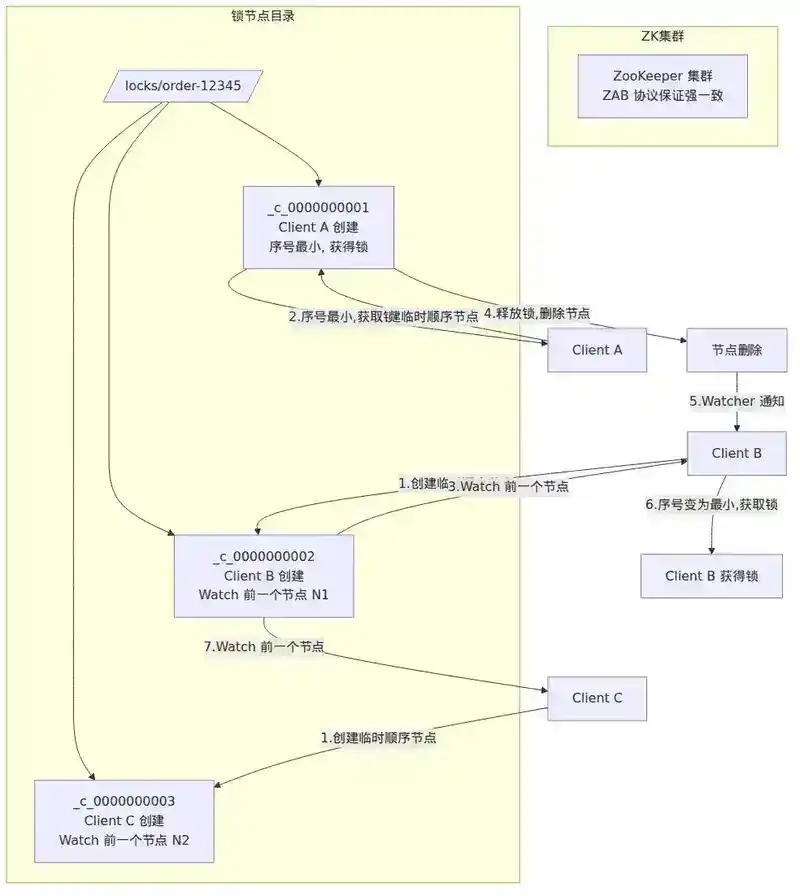
ZooKeeper 通过临时顺序节点 + Watch 机制实现分布式锁:
加锁流程:
1. 在 /lock 下创建临时顺序节点,如 /lock/0000000001
2. 获取 /lock 下所有子节点,排序
3. 如果自己是最小的节点 → 获得锁
4. 如果不是最小 → Watch 前一个节点
5. 前一个节点删除(锁释放)→ 收到通知,回到步骤 2
5.2 Curator 实现
InterProcessMutex lock = new InterProcessMutex(client, "/lock/order:12345");
if (lock.acquire(10, TimeUnit.SECONDS)) {
    try {
        // 业务逻辑
    } finally {
        lock.release();
    }
}
5.3 ZooKeeper 方案的优势
强一致性:ZooKeeper 基于 ZAB 协议,保证所有节点数据一致。客户端只会看到线性一致的锁状态。
自动释放:临时节点与客户端 Session 绑定,客户端崩溃 → Session 超时 → 临时节点自动删除 → 锁自动释放。天然防死锁。
公平锁:按节点序号排队,谁先来谁先得,天然的公平锁。
Watcher 通知:等待锁的客户端不需要轮询,前一个节点释放时 ZK 主动通知。
5.4 ZooKeeper 方案的关键问题
性能较低:每次加锁都需要创建临时节点并同步到半数以上节点,延迟较高(通常 2-10ms)。
Session 超时风险:GC 长时间停顿、网络抖动可能导致 Session 超时,锁被意外释放。
羊群效应:如果所有等待者都 Watch 同一个节点,锁释放时所有等待者同时被唤醒,造成惊群。Curator 通过 Watch 前一个节点来避免。
运维成本:ZK 集群需要专门的运维,不像 Redis 那样普及。
6. 三种方案的一致性 vs 可用性对比
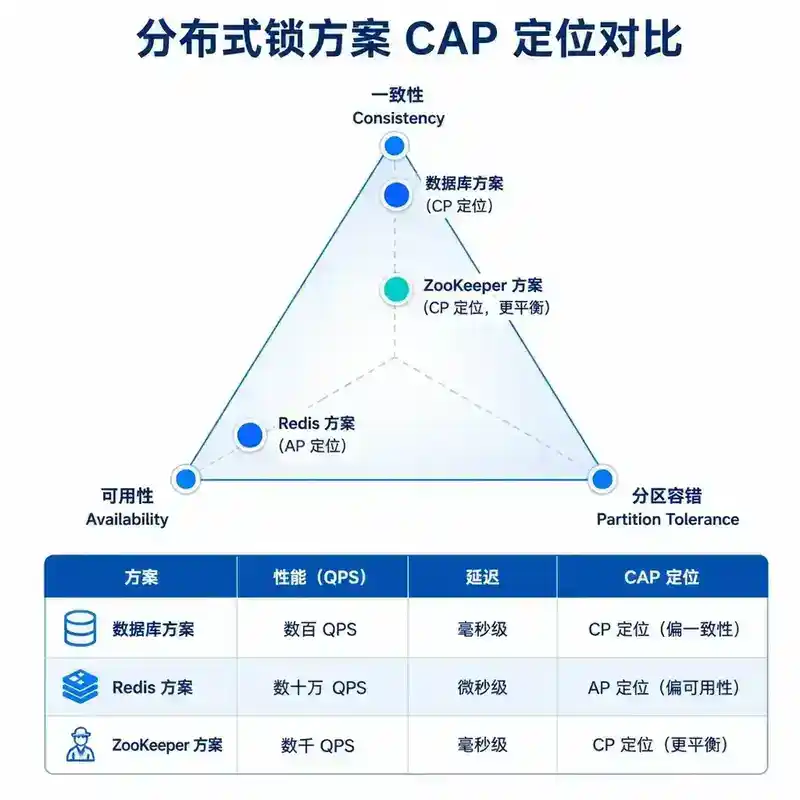
┌──────────────────────────────────────────────────────────────────┐
│                    分布式锁方案 CAP 定位                           │
├──────────────┬───────────────┬──────────────┬────────────────────┤
│    方案      │   一致性(C)   │  可用性(A)   │   分区容错(P)       │
├──────────────┼───────────────┼──────────────┼────────────────────┤
│  数据库      │  强(主库)   │  中(主从切换 │   必须满足          │
│              │               │   有中断)    │                    │
│   Redis      │  弱(异步复制 │  高(哨兵/    │   必须满足          │
│              │   可能丢锁)  │  集群自动切换)│                    │
│  ZooKeeper   │  强(ZAB协议)│  中(选主期间 │   必须满足          │
│              │               │   不可用)    │                    │
└──────────────┴───────────────┴──────────────┴────────────────────┘
| 维度 | 数据库 | Redis | ZooKeeper |
|---|---|---|---|
| 互斥性 | ✅ 唯一索引保证 | ⚠️ 主从异步复制可能丢锁 | ✅ ZAB 协议保证 |
| 防死锁 | ⚠️ 需要定时清理 | ✅ 过期时间 | ✅ 临时节点自动释放 |
| 阻塞等待 | ❌ 需要自旋轮询 | ✅ 发布订阅/自旋 | ✅ Watcher 通知 |
| 可重入 | ❌ 需自行实现 | ✅ Redisson 内置 | ✅ Curator 内置 |
| 性能(QPS) | 低(~1K) | 高(~10W) | 中(~1W) |
| 一致性 | 强(单主) | 弱(最终一致) | 强(线性一致) |
| 可用性 | 中 | 高 | 中 |
| 运维成本 | 低(已有DB) | 中(已有Redis) | 高(需专门运维) |
7. 生产环境选型决策框架
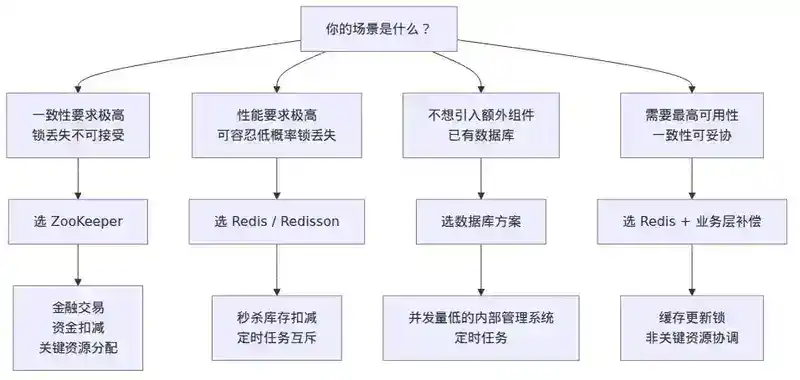
7.1 决策树
你的场景是什么?
│
├── 对一致性的要求极高,锁丢失不可接受
│   └── 选 ZooKeeper
│       例如:金融交易、资金扣减、关键资源分配
│
├── 对性能要求极高,可容忍极低概率的锁丢失
│   └── 选 Redis(Redisson)
│       例如:秒杀库存扣减(有最终对账兜底)、定时任务互斥
│
├── 不想引入额外组件,已有数据库
│   └── 选数据库方案
│       例如:并发量低的内部管理系统、定时任务
│
└── 需要最高可用性,一致性可妥协
    └── 选 Redis + 业务层补偿
        例如:缓存更新锁、非关键资源协调
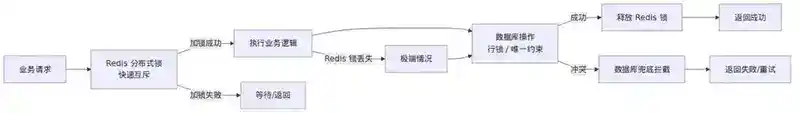
7.2 混合方案:Redis + 业务兜底
业界常见做法:用 Redis 分布式锁做快速互斥,用数据库唯一约束做最终兜底。
public void deductInventory(String productId, int quantity) {
    String lockKey = "lock:inventory:" + productId;
    RLock lock = redisson.getLock(lockKey);
    try {
        if (lock.tryLock(100, 30000, TimeUnit.MILLISECONDS)) {
            // Redis 锁保护,大概率成功
            int stock = inventoryMapper.selectForUpdate(productId).getStock();
            if (stock >= quantity) {
                inventoryMapper.deduct(productId, quantity);
            }
        }
    } finally {
        lock.unlock();
    }
}
// 数据库行锁 + 唯一约束是最后的防线
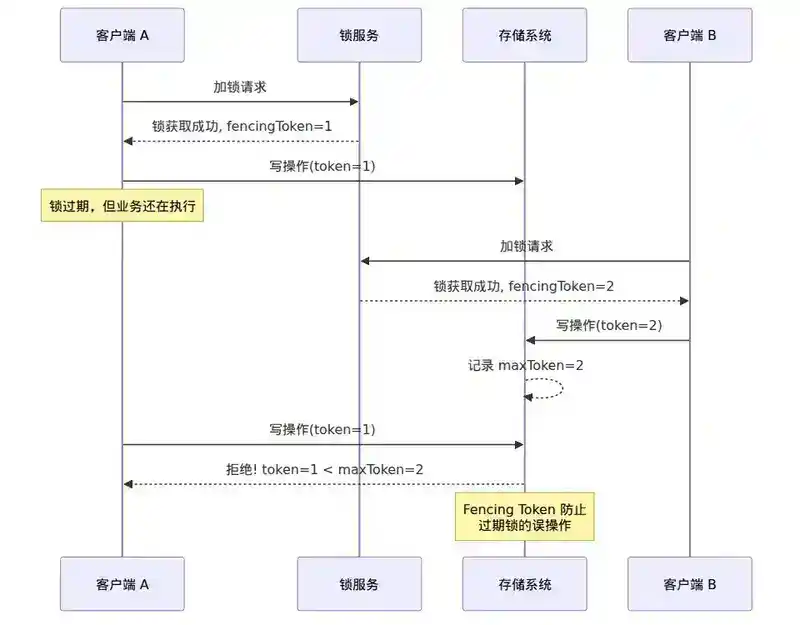
7.3 Fencing Token:防止锁过期后的误操作
当锁过期但业务还在执行时,需要一个递增的 token 来防止"前任"的错误写入:
// 加锁时返回 fencing token
long token = acquireLockWithToken("resource:123");

// 写操作时带上 token
// 存储系统只接受 token 大于当前已处理 token 的写请求
storage.writeWithToken("resource:123", data, token);
ZooKeeper 的 zxid 和 Redlock 协议中都有类似的 fencing 机制。
8. 面试追问与回答
以下问题从面试官视角设计,考察你对分布式锁的深度理解,不限于本文内容。
Q1:如果 Redis 主节点宕机,Redlock 算法能否保证锁的安全性?有什么边界条件?
Q2:ZooKeeper 分布式锁中,客户端 GC 停顿 30 秒导致 Session 超时,锁被释放,另一个客户端拿到了锁。GC 恢复后原客户端以为自己还持有锁,继续操作——如何防止这种"脑裂"?
Q3:你设计一个秒杀系统,库存扣减用 Redis 分布式锁还是 ZooKeeper 分布式锁?为什么?如果 Redis 锁丢了怎么办?
Q4:数据库方案中,定时清理过期锁的任务如果也挂了怎么办?如何保证锁不被永久占用?
Q5:分布式锁和数据库行锁(SELECT FOR UPDATE)有什么区别?在什么场景下应该用分布式锁而不是数据库行锁?
Q6:有没有不需要分布式锁就能保证互斥的架构方案?请举例说明。
下一篇:173|幂等设计:幂等键、去重、状态机、Token 与唯一约束
📝 参考答案
A1:Redlock 的安全性边界条件
Redlock 算法(Redis 作者 antirez 提出)的核心思路:在 N 个独立 Redis 节点上依次加锁,过半(N/2+1)成功才算获取锁。但它有严格的安全边界:
能保证安全的前提:
- 所有 Redis 节点没有持久化(重启后数据清空),且锁的过期时间远小于节点重启时间
- 客户端在有效时间内(锁过期时间 - 时钟漂移 - 网络延迟)完成加锁
- 各节点时钟偏差在可控范围内
无法保证安全的场景:
- 节点重启:如果 Redis 节点开启了 AOF/RDB 持久化,重启后可能恢复旧的锁信息,导致两个客户端同时持锁。Martin Kleppmann 在《How to do distributed locking》中详细论证了这一点。
- 时钟跳跃:NTP 大幅调整系统时钟时,锁可能提前过期。Redlock 依赖"过期时间"作为安全边界,而时钟是不可靠的。
- GC 停顿:客户端 GC 停顿期间锁过期,其他客户端拿到锁,原客户端恢复后继续操作。
结论:Redlock 在不重启、时钟稳定、网络可靠的理想条件下是安全的,但生产环境很难同时满足。它更适合作为"效率锁"(提高效率,降低冲突概率)而非"正确性锁"(保证数据绝对正确)。
A2:ZooKeeper GC 停顿导致脑裂的防护方案
核心问题是:客户端不知道自己已经"过期"了。解决方案:
- Fencing Token(栅栏令牌):每次加锁时,ZK 的 zxid 或自定义递增 ID 作为 token 返回。写共享资源时,必须携带 token,资源存储层只接受 token 大于当前已处理 token 的写请求。Curator 的 InterProcessSemaphoreMutex 配合 Lease 可实现此机制。
- 版本号校验:在共享资源上维护版本号,加锁时获取当前版本号,写入时做 CAS 校验。如果版本号已被其他客户端更新,则写入失败。
- 客户端侧 Token 自检:在每次写操作前,检查本地 Session 状态是否仍然有效:
if (client.getState() == CuratorFrameworkState.STARTED
    && client.getZookeeperClient().isConnected()) {
    // 执行写操作
} else {
    throw new LockExpiredException();
}
- 共享存储层防护:不管用什么锁,最终的防线在数据层——数据库的乐观锁版本号、唯一约束、状态机——这些是"不相信锁"的兜底。
A3:秒杀系统的分布式锁选型
选 Redis 分布式锁(Redisson),理由:
- 性能:秒杀场景 QPS 极高,ZK 的延迟(2-10ms)是 Redis 的 10 倍以上,会成为瓶颈
- 可用性:Redis 哨兵/集群模式在主节点宕机时能快速切换,ZK 选主期间(通常 200ms-2s)锁服务不可用
- Redis 锁丢失的兜底:数据库行锁 + 唯一约束 + 库存扣减原子操作是最后防线。即使 Redis 锁丢了,两个请求同时走到数据库,SELECT FOR UPDATE + 行锁也能保证不会超卖
核心设计:
// 第一层:Redis 分布式锁(快速互斥,减少 DB 压力)
RLock lock = redisson.getLock("seckill:" + productId);
if (lock.tryLock(10, 5000, TimeUnit.MILLISECONDS)) {
    try {
        // 第二层:数据库兜底(行锁 + 唯一约束)
        int affected = inventoryMapper.deductIfStockEnough(productId, 1);
        if (affected == 0) throw new SoldOutException();
    } finally {
        lock.unlock();
    }
}
如果没有数据库兜底:那就不能只用 Redis 锁——ZooKeeper 锁更安全,或者用 Redlock + fencing token 方案。
A4:数据库定时清理任务故障的防护
定时清理任务挂了,锁记录会一直留在表里,导致这些锁永久不可用。防护措施:
- 锁记录自带过期字段:加锁时写入 expire_at,业务代码在加锁前先清理过期锁,不依赖定时任务:
-- 加锁前先清理过期锁
DELETE FROM distributed_lock WHERE expire_at < NOW();
-- 然后尝试加锁
INSERT INTO distributed_lock (lock_key, holder, expire_at)
VALUES ('order:12345', 'node-1', NOW() + INTERVAL 30 SECOND);
- 定时任务多实例 + 分布式锁保护:清理任务本身用分布式锁保证只有一个实例执行,但多个实例都在竞争执行权,挂了一个另一个顶上。
- 数据库 Event Scheduler:MySQL 内置的定时任务,不需要外部进程:
CREATE EVENT clean_expired_locks
ON SCHEDULE EVERY 10 SECOND
DO DELETE FROM distributed_lock WHERE expire_at < NOW();
- 监控告警:对 distributed_lock 表的记录数设置告警阈值,异常增长时及时通知。
A5:分布式锁 vs 数据库行锁的区别与选型
| 维度 | 分布式锁 | 数据库行锁(SELECT FOR UPDATE) |
|---|---|---|
| 作用范围 | 跨进程、跨 JVM | 数据库连接/事务内 |
| 保护对象 | 任意共享资源 | 数据库中的行数据 |
| 锁粒度 | 自定义(key 粒度) | 行级 |
| 阻塞行为 | 可阻塞、可超时 | 事务提交/回滚时释放 |
| 性能 | Redis 可达 10W QPS | 受限于数据库连接数和事务吞吐 |
该用分布式锁而非数据库行锁的场景:
- 保护非数据库资源:如文件系统、第三方 API 调用频率控制
- 跨数据库的协调:多个数据库之间的数据一致性需要分布式锁
- 锁持有时间较长:持有数据库行锁意味着持有数据库连接和事务,长事务会阻塞其他请求、影响连接池
- 减少数据库压力:高并发场景下,先用分布式锁过滤掉大部分请求,减少打到数据库的流量
该用数据库行锁的场景:
- 锁和数据在同一事务中,需要原子性保证
- 并发量不高,不想引入额外组件
- 作为分布式锁的最终兜底
A6:不需要分布式锁的互斥方案
有几种架构设计可以从根本上避免分布式锁:
- 消息队列 + 单线程消费:将互斥操作序列化,通过消息队列的 Partition 机制,同一 key 的消息路由到同一 Partition,由单线程消费者处理。RocketMQ 的 MessageQueue 和 Kafka Partition 天然支持。
- 数据库唯一约束 + 乐观锁:对于幂等性要求,直接在数据库层面用唯一约束保证:
INSERT INTO order (order_id, ...) VALUES (?, ...); -- 重复插入直接报错
对于状态更新,用乐观锁版本号:
UPDATE resource SET status = 'processing', version = version + 1
WHERE id = ? AND version = ?;
- Actor 模型:每个资源对应一个 Actor,所有对该资源的操作都发给这个 Actor 串行处理。Akka、Orleans 等框架天然支持。
- Redis 原子操作:如果操作本身可以在 Redis 内完成(如 INCR、DECR、lua 脚本),就不需要分布式锁:
-- 原子扣减库存
local stock = redis.call('GET', KEYS[1])
if stock and tonumber(stock) > 0 then
    return redis.call('DECR', KEYS[1])
else
    return -1
end
- 分片 + 路由:将资源按 key 哈希分片,同一资源的所有请求路由到同一台机器,单机内用 JVM 锁即可。典型实现:一致性哈希路由 + 单机 ReentrantLock。
核心思想:问自己——"能不能不做分布式锁?"如果可以通过架构设计消除竞争,那比任何分布式锁方案都更优雅。