阅读时间:约 45 分钟 | 分类:11 分布式理论、事务与一致性
一、问题的起点:为什么需要分布式事务?
在单机数据库时代,事务是简单的——一个 BEGIN/COMMIT/ROLLBACK 就能保证 ACID。但到了分布式系统,数据被拆分到多个数据库实例、多个微服务中,一个业务操作可能涉及:
- 订单服务写 MySQL
- 库存服务扣减 Redis
- 支付服务调用外部银行接口
- 消息队列发送通知
这时,保证"要么全成功,要么全失败"变成了一个分布式协调问题。这就是分布式事务要解决的核心问题。
关键洞察:分布式事务的本质不是"让多个节点同时成功",而是"让多个节点对同一个结果达成共识"——要么都提交,要么都回滚。
二、XA 协议:分布式事务的标准化接口
2.1 X/Open DTP 模型
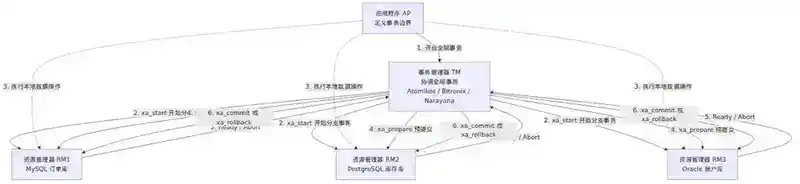
XA 是 X/Open 组织定义的分布式事务处理标准。它定义了三个角色:
- AP(Application Program):应用程序,定义事务边界
- TM(Transaction Manager):事务管理器,协调全局事务。通常由应用服务器(如 JBoss、WebLogic)或独立 TM(如 Atomikos、Bitronix)充当
- RM(Resource Manager):资源管理器,管理具体资源。如 MySQL、PostgreSQL、Oracle、ActiveMQ 等
关键概念是 全局事务(Global Transaction) 和 分支事务(Branch Transaction) 的关系:一个全局事务包含多个分支事务,每个分支事务对应一个 RM。TM 通过 xa_start、xa_end、xa_prepare、xa_commit、xa_rollback 等接口与 RM 交互。
2.2 XA 接口详解
XA 规范定义了 RM 必须实现的接口:
xa_start(xid)    — 开始一个分支事务,关联到全局事务 xid
xa_end(xid)      — 结束分支事务的工作(不再有新的数据操作)
xa_prepare(xid)  — 预提交:RM 将事务状态持久化,承诺后续可以提交或回滚
xa_commit(xid)   — 最终提交
xa_rollback(xid) — 回滚
xa_recover()     — 获取已 prepare 但未完成的分支事务列表(用于故障恢复)
XID(Transaction ID) 是全局事务的唯一标识,包含三部分:
- Format ID:标识格式
- Global Transaction ID:全局事务标识
- Branch Qualifier:分支标识
2.3 MySQL 对 XA 的支持
MySQL(InnoDB)从 5.0.3 开始支持 XA 事务。以两条 SQL 语句为例:
XA START 'xid_001';
INSERT INTO orders VALUES (1001, 'pending');
XA END 'xid_001';
XA PREPARE 'xid_001';
-- 此时事务已写入 redo log,但尚未提交,对其他事务不可见
XA COMMIT 'xid_001';
如果 PREPARE 后 MySQL 宕机,重启时 InnoDB 会扫描 redo log 中所有处于 PREPARE 状态的事务,通过 xa_recover() 返回给 TM,由 TM 决定提交还是回滚。
三、两阶段提交(2PC):最经典的分布式事务协议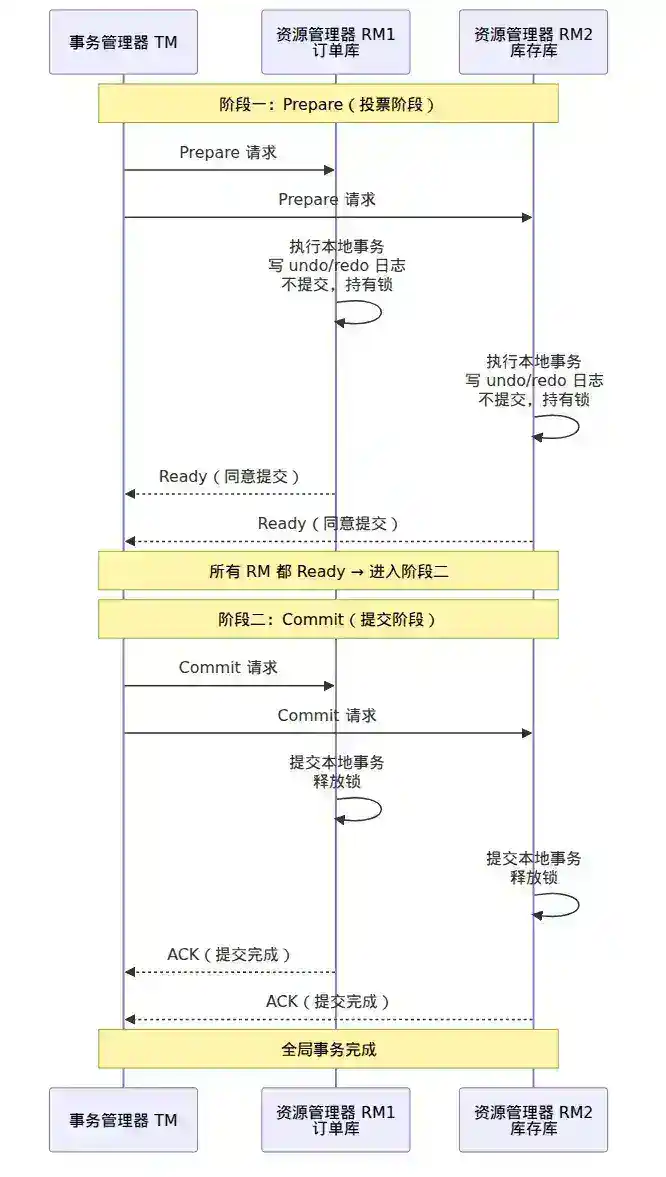
文章配图
3.1 协议流程
2PC 将一个全局事务的提交分为两个阶段:
阶段一:Prepare(投票阶段)
- TM 向所有参与的 RM 发送 Prepare 请求
- 每个 RM 执行本地事务的预提交:将 undo/redo 日志写入磁盘,但不真正提交
- RM 返回 "Ready"(同意提交)或 "Abort"(拒绝提交)
- 如果 TM 在规定时间内未收到某个 RM 的响应,视为超时,等同于 Abort
阶段二:Commit(提交阶段)
- 如果所有 RM 都返回 Ready:
- TM 向所有 RM 发送 Commit 请求
- 每个 RM 执行本地提交,释放锁
- RM 返回 ACK 确认完成
- 如果任一 RM 返回 Abort 或超时:
- TM 向所有 RM 发送 Rollback 请求
- 每个 RM 执行本地回滚,释放锁
- RM 返回 ACK 确认完成
3.2 2PC 的关键特点
同步阻塞:Prepare 阶段完成后,RM 进入"就绪"状态,锁定资源等待 TM 的最终决策。在收到 Commit/Rollback 之前,RM 不能释放锁,也不能自主决定——这是 2PC 最大的问题。
TM 单点:TM 是整个协议的核心,如果 TM 在发出 Commit 指令后、部分 RM 提交前宕机,系统进入不一致状态。
数据一致性保证:所有 RM 最终要么全部提交,要么全部回滚——这是 2PC 提供的强一致性保证。
3.3 2PC 的故障场景分析
| 故障场景 | 后果 | 严重程度 |
|---|---|---|
| Prepare 阶段某 RM 宕机 | TM 收不到响应,超时后全局回滚 | 低——可自动恢复 |
| Prepare 阶段 TM 宕机 | RM 一直等待,超时后可自行回滚 | 中——需超时机制 |
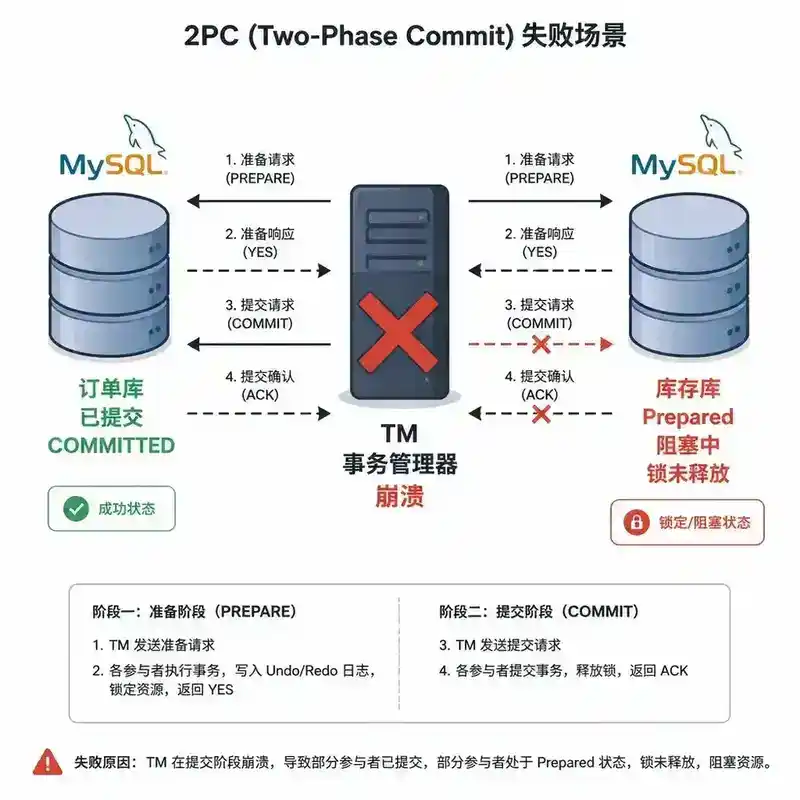
| Commit 阶段 TM 宕机(部分 RM 已提交) | 部分已提交,部分未提交,数据不一致 | 高——严重 |
| Commit 阶段某 RM 宕机 | TM 重试,直到 RM 恢复后完成提交 | 中——需重试机制 |
| 网络分区 | 可能出现部分 RM 联系不上 TM | 高——需要协调者 |
最严重的故障:TM 在发送 Commit 给 RM1 后、发送 Commit 给 RM2 前宕机。此时 RM1 已提交,RM2 处于 Prepared 状态等待。这就是所谓的"协调者故障导致的数据不一致"。
四、三阶段提交(3PC):对 2PC 阻塞问题的改进
4.1 为什么需要 3PC?
2PC 的核心缺陷是:一旦 RM 进入 Prepared 状态,它就被 TM 阻塞了——不能自行决定提交或回滚。如果 TM 宕机,RM 上的资源锁永远无法释放。3PC 在 2PC 的基础上引入了超时机制和预提交阶段来解决这个问题。
4.2 协议流程
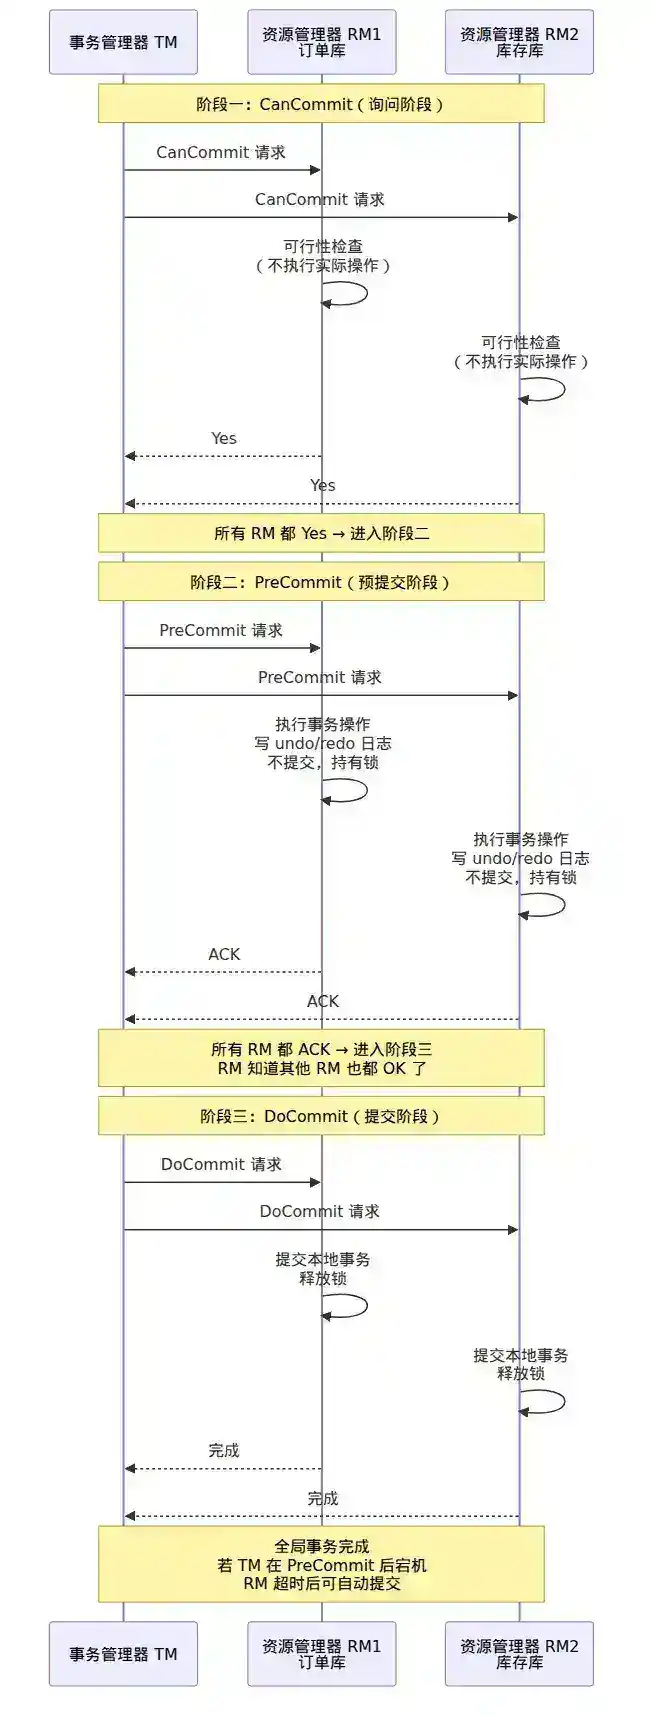
阶段一:CanCommit(询问阶段)
- TM 向所有 RM 发送 CanCommit 请求
- 每个 RM 判断自己是否可以执行事务(不执行任何实际操作,只做可行性检查)
- RM 返回 Yes 或 No
- 超时或 No 则全局中止
阶段二:PreCommit(预提交阶段)
- 如果所有 RM 都返回 Yes:
- TM 发送 PreCommit 请求
- RM 执行事务操作,记录 undo/redo 日志,但不提交
- RM 返回 ACK 或 Abort
- 如果任一 RM 返回 No 或超时:TM 发送 Abort 全局中断
阶段三:DoCommit(提交阶段)
- 如果所有 RM 都返回 ACK:
- TM 发送 DoCommit 请求
- RM 执行提交,释放锁
- 如果 TM 超时未收到所有 ACK 或网络中断:TM 发送 Abort
- 关键改进:如果 RM 在 PreCommit 后长时间未收到 TM 的下一个指令,RM 可以超时后自动提交(前提是 RM 知道其他 RM 也都进入了 PreCommit 状态)
4.3 3PC 相对 2PC 的改进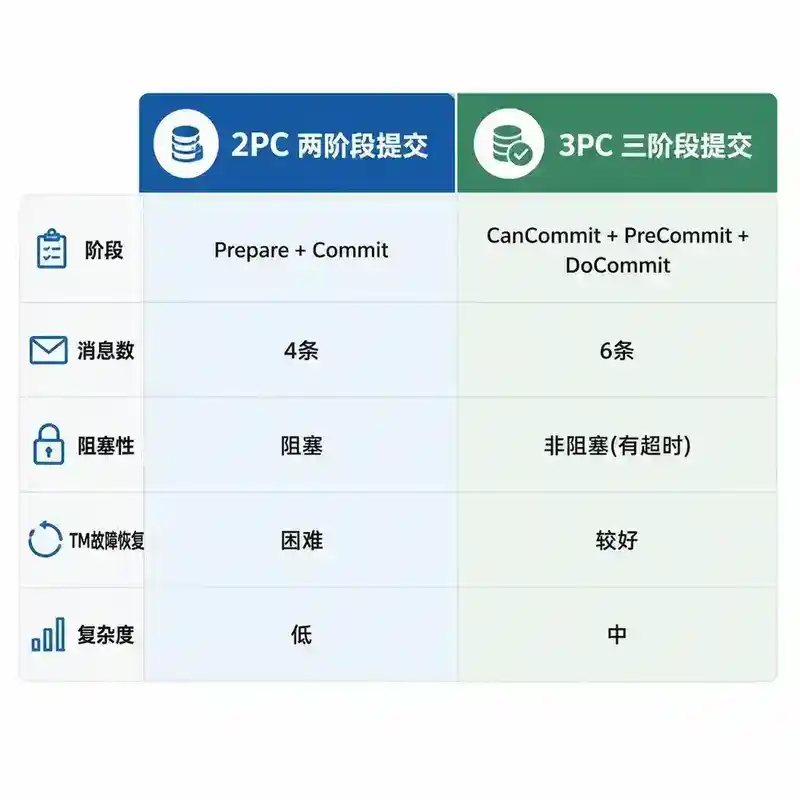
文章配图
| 特性 | 2PC | 3PC |
|---|---|---|
| 阶段数 | 2 | 3 |
| 消息开销 | 4 条消息 | 6 条消息 |
| 阻塞性 | 阻塞(Prepare 后) | 非阻塞(有超时机制) |
| TM 单点故障恢复 | 困难 | 较好(RM 有超时机制) |
| 网络分区容忍度 | 低 | 中等 |
| 复杂度 | 低 | 中 |
3PC 的核心思想:在 2PC 的 Prepare 和 Commit 之间插入一个 PreCommit 阶段,让所有 RM 知道"其他 RM 也都 OK 了",这样即使 TM 后续宕机,RM 也可以安全地自行决定提交。
4.4 3PC 的局限性
3PC 并非完美:
- 网络分区场景下仍可能不一致:如果 PreCommit 后发生网络分区,RM 可能超时自动提交,但 TM 可能因为未收到 ACK 而发送 Abort
- 消息开销更大:每个事务多了 2 条消息(一轮 CanCommit 交互)
- 实际落地较少:3PC 在工程实践中很少被直接使用,更多作为理论上的改进方案被讨论
五、2PC 与 3PC 的深度对比
5.1 协议状态机
2PC 状态机:
- RM:INIT → PREPARED → COMMITTED/ABORTED
- TM:INIT → WAITING → COMMITTING/ABORTING → DONE
3PC 状态机:
- RM:INIT → CAN_COMMIT → PRE_COMMITTED → COMMITTED/ABORTED
- TM:INIT → CAN_COMMITTING → PRE_COMMITTING → COMMITTING/ABORTING → DONE
5.2 时间复杂度
- 2PC:2 轮消息(Prepare + Commit),不考虑 ACK 则为 2 轮
- 3PC:3 轮消息(CanCommit + PreCommit + DoCommit),比 2PC 多 50% 的延迟
5.3 故障恢复能力
2PC 的"悬垂事务":如果 TM 在 Commit 阶段宕机,部分 RM 处于 Prepared 状态,形成"悬垂事务"。这些 RM 必须等待 TM 恢复后通过 xa_recover() 来获取决策。这就是为什么 2PC 被称为"阻塞协议"。
3PC 的参与者超时:在 PreCommit 后,如果 RM 在指定时间内未收到 TM 指令,可以自动提交。这避免了 2PC 的无限阻塞问题,但代价是可能在网络分区时产生不一致。
六、XA/2PC 的工程实践与陷阱
6.1 实际使用场景
适合 XA/2PC 的场景:
- 对数据一致性要求极高(强一致性)的业务
- 事务参与者较少(通常 2-3 个)
- 事务执行时间短(秒级)
- 数据库本身就支持 XA(MySQL、PostgreSQL、Oracle 等)
不适合的场景:
- 高并发、低延迟要求的场景
- 事务链路过长(参与者多)
- 涉及非数据库资源(如外部 HTTP API)
- 微服务跨服务调用(服务间不适合用 XA)
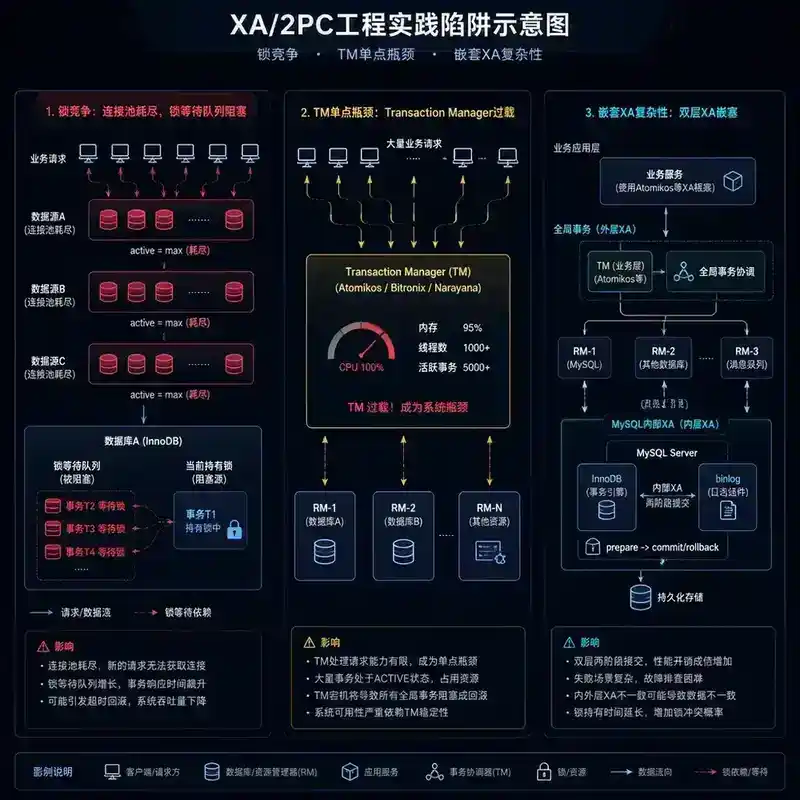
6.2 常见陷阱
陷阱 1:锁定时间过长 Prepare 后 RM 持有的锁要到 Commit 才释放。如果网络延迟高或 TM 处理慢,锁持有时间可能达到秒级甚至分钟级,严重影响并发性能。
陷阱 2:TM 成为瓶颈 所有事务协调都经过 TM,TM 的吞吐量等于整个系统的分布式事务吞吐量。TM 本身的性能、可用性成为瓶颈。
陷阱 3:并非所有系统都支持 XA 很多 NoSQL 数据库(如 Redis、MongoDB 早期版本)不支持 XA 协议。如果事务涉及这些系统,2PC 无法直接使用。
陷阱 4:故障恢复的复杂性 TM 故障恢复需要持久化事务日志,恢复时需要处理各种中间状态。实际部署中,TM 的日志管理、恢复策略、幂等重试都比理论模型复杂得多。
陷阱 5:MySQL 的 XA 事务与 binlog 的交互 MySQL 的内部 XA 用于协调 InnoDB 和 binlog(两阶段提交保证 binlog 和 redo log 一致)。如果业务层又使用 XA 事务,会形成"嵌套 XA",增加复杂性。
6.3 真实故障案例
案例:TM 进程 OOM 导致全局事务悬挂
某电商平台使用 Atomikos 作为 TM,在一次大促中,TM 的 JVM 堆内存不足触发 Full GC,导致 TM 在发送 Commit 给订单库后、发送给库存库前长时间停顿。结果:
- 订单库已提交,订单状态为"已支付"
- 库存库处于 Prepared 状态,锁未释放,其他扣库存操作全部阻塞
- 30 秒后库存库连接超时,但因为没有 TM 的决策,无法自行回滚
- 最终需要人工介入:查询 TM 日志,手动回滚库存库的悬挂事务
教训:2PC 的 TM 必须高可用,且必须有完善的超时和恢复机制。
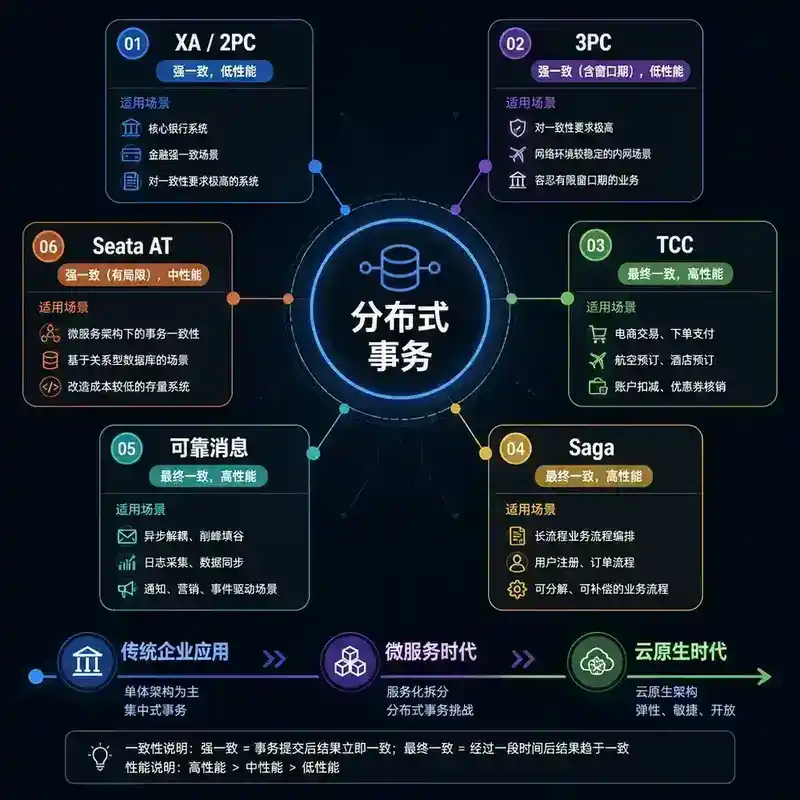
七、2PC/3PC 与现代分布式事务方案的对比
| 方案 | 一致性 | 性能 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| XA/2PC | 强一致 | 低 | 中 | 传统企业应用,少量 RM |
| 3PC | 强一致(有窗口) | 低 | 高 | 对阻塞敏感的场景 |
| TCC | 最终一致 | 高 | 高 | 微服务,业务可拆分 |
| Saga | 最终一致 | 高 | 中 | 长事务,微服务编排 |
| 可靠消息 | 最终一致 | 高 | 中 | 异步场景,可接受短暂不一致 |
| Seata AT | 强一致(有局限) | 中 | 中 | 与 2PC 类似但更轻量 |
2PC 并未被淘汰:虽然 2PC 有很多缺点,但在数据库层面(如 MySQL 的 binlog/redo log 协调)仍然广泛使用。在业务层面,随着微服务的普及,更轻量的最终一致性方案(TCC、Saga、消息表)逐渐成为主流。
八、总结
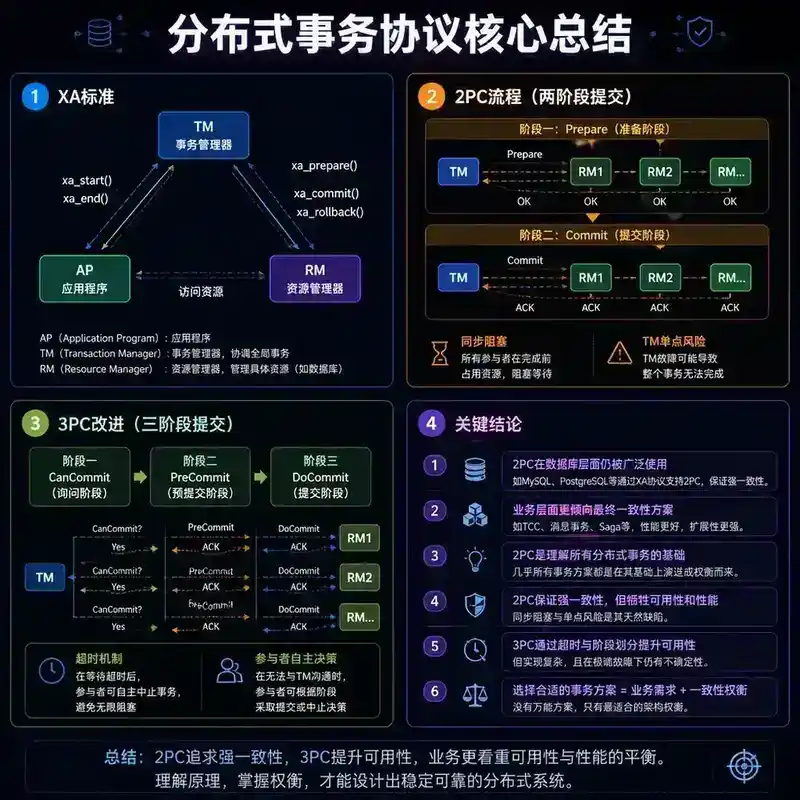
- XA 提供了分布式事务的标准接口,2PC 和 3PC 是基于 XA 的协调协议
- 2PC 通过 Prepare 和 Commit 两个阶段保证所有参与者要么全提交、要么全回滚
- 2PC 的核心缺陷是同步阻塞和TM 单点故障导致的数据不一致风险
- 3PC 在 2PC 基础上增加了 CanCommit 阶段和参与者超时机制,降低了阻塞风险但增加了消息开销
- 实际工程中,2PC 在数据库层面仍广泛使用,业务层面越来越多地采用最终一致性方案
- 理解 2PC/3PC 是理解所有分布式事务方案(TCC、Saga、Seata)的基础
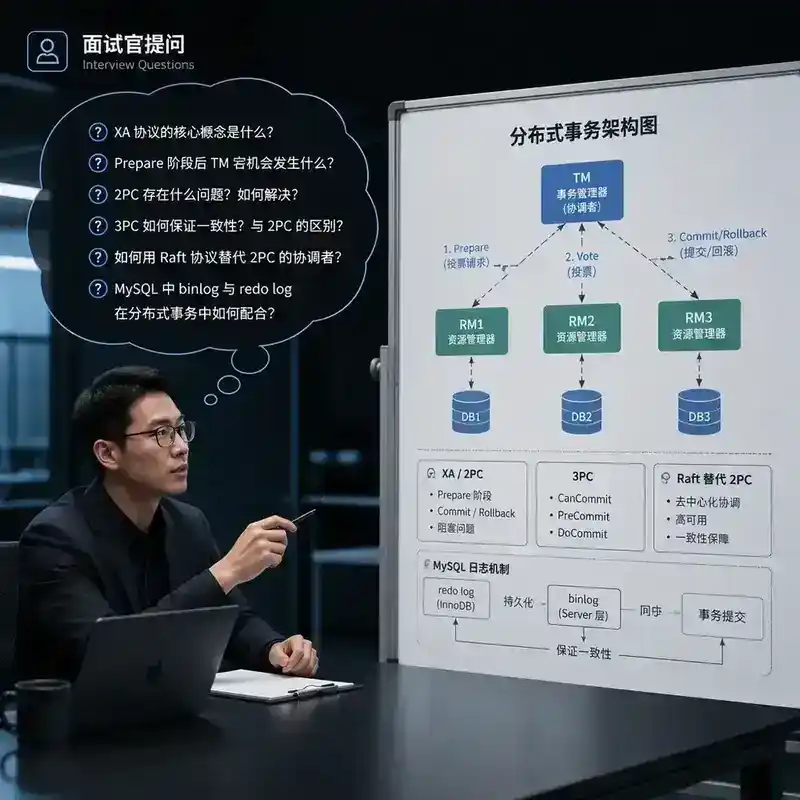
面试官视角提问与解答
以下问题从面试官视角出发,考察对分布式事务原理的深度理解。建议先尝试独立回答,再看参考解答。
Q1:2PC 的 Prepare 阶段,RM 返回 Ready 后,如果 TM 立刻宕机,会发生什么?RM 能自行决定回滚吗?
答:RM 不能自行决定回滚。这正是 2PC 最核心的缺陷——同步阻塞。
RM 返回 Ready 意味着它已经完成了本地事务的预提交(undo/redo 日志已持久化),并向 TM 做出了"承诺"——后续可以按 TM 指令提交或回滚。这个承诺是单向的:RM 放弃了自主决策权,必须等待 TM 的最终指令。
TM 宕机后,RM 上的事务处于"悬挂"(in-doubt)状态:
- 锁资源无法释放(因为不知道最终是提交还是回滚)
- 其他需要访问这些资源的事务会被阻塞
- 如果没有超时机制,这种阻塞是无限期的
实际系统中,TM 恢复后会通过 xa_recover() 查询所有处于 Prepared 状态的分支事务,然后根据事务日志决定提交或回滚。如果 TM 的日志也丢失了(比如 TM 本身没有持久化),那就需要人工介入——这也是为什么生产环境中 TM 必须高可用且持久化事务日志。
追问:如果给 RM 设置超时自动回滚呢?这其实就是 3PC 的部分思路,但 2PC 协议本身不允许这样做——因为 RM 不知道其他 RM 是否已经收到 Commit 指令。如果 RM1 超时回滚了,但 RM2 在 TM 宕机前已经收到了 Commit 并提交了,数据就不一致了。
Q2:3PC 声称解决了 2PC 的阻塞问题,但如果 PreCommit 阶段后发生网络分区,所有 RM 都超时自动提交了,但 TM 在超时前已经发送了 Abort 给部分 RM——这会产生什么结果?3PC 真的解决了不一致问题吗?
答:这就是 3PC 的致命缺陷——网络分区场景下的数据不一致。
场景还原:
- TM 发送 PreCommit,所有 RM 返回 ACK
- 网络分区发生:TM 与部分 RM(比如 RM1)的网络中断,但与 RM2 的网络正常
- TM 超时未收到 RM1 的 ACK(实际上 RM1 已经发了 ACK 但被网络丢弃了),TM 判定全局失败,向 RM2 发送 Abort
- RM2 收到 Abort,回滚
- 与此同时,RM1 因为超时未收到 TM 的下一个指令,根据 3PC 的超时机制,自动提交
- 结果:RM1 已提交,RM2 已回滚 → 数据不一致
3PC 并没有真正解决不一致问题,它只是把"TM 宕机导致的无限阻塞"转换成了"网络分区可能导致的不一致"。这是一个 trade-off:
- 2PC 的哲学:宁可阻塞,也不能不一致(强一致性优先)
- 3PC 的哲学:宁可不一致,也不能无限阻塞(可用性优先)
在实际工程中,这个 trade-off 往往不被接受——大多数业务系统宁可阻塞后人工恢复,也不愿接受静默的数据不一致。这也是 3PC 在工程中很少被直接使用的原因。
补充:要真正解决网络分区下的不一致,需要共识算法(如 Paxos/Raft),而不是 2PC/3PC 这种简单的协调协议。
Q3:为什么 MySQL 的 binlog 和 redo log 之间使用内部 XA(二阶段提交)?如果不用 XA 会有什么问题?
答:这是 MySQL 内部 XA 最经典的工程应用,也是面试中考察"为什么需要 XA"的必问题。
背景:MySQL 中,redo log 由 InnoDB 管理,binlog 由 Server 层管理——这是两个独立的"资源"。
如果不使用 XA,可能的执行顺序是:
先写 redo log(prepare),再写 binlog:
- 如果写完 redo log 后、写 binlog 前宕机:redo log 有记录但 binlog 没有。从库没有这条数据,主从不一致。
- 崩溃恢复时,InnoDB 会重放 redo log,主库有数据,但 binlog 缺少,从库永远无法同步。
先写 binlog,再写 redo log:
- 如果写完 binlog 后、写 redo log 前宕机:binlog 有记录但 InnoDB 没有持久化,从库会多出数据。
- 崩溃恢复时,InnoDB 没有对应的 redo log,事务丢失,主从又不一致。
使用 XA 后的正确流程:
- InnoDB 写 redo log,状态为 PREPARE
- Server 层写 binlog
- InnoDB 将 redo log 状态改为 COMMIT
崩溃恢复时:
- 如果 binlog 中有对应事务 → redo log 从 PREPARE 改为 COMMIT(提交)
- 如果 binlog 中没有对应事务 → redo log 从 PREPARE 改为 ROLLBACK(回滚)
这就是 MySQL 的"内部 XA"——用一个 2PC 协议保证了 redo log 和 binlog 的一致性,进而保证了主从数据一致。
关键启示:这个例子说明,2PC 不是一个"业务层"的协议,它在数据库内核中发挥着不可替代的作用。理解这一点,会让你在面试中脱颖而出。
Q4:在一个涉及 5 个微服务的分布式事务中,你会选择 2PC 吗?为什么?如果不选,你会用什么方案?
答:不会选择 2PC。原因如下:
- 锁竞争和性能:5 个微服务意味着 5 个 RM,Prepare 阶段需要等待所有 RM 返回 Ready,任何一个慢查询都会拖慢整个事务。锁持有时间 = 最长 RM 执行时间 + 两轮网络延迟,对高并发场景不可接受。
- 可用性:TM 成为单点瓶颈和故障点。5 个服务的协调者宕机,所有分布式事务都会悬挂。
- 紧耦合:2PC 要求所有 RM 都支持 XA 协议。微服务中可能涉及 Redis、MongoDB、消息队列等不支持 XA 的资源,2PC 无法覆盖。
- 长事务问题:微服务调用链通常涉及远程 RPC,事务时间不可控。2PC 锁持有时间过长,系统吞吐量急剧下降。
推荐替代方案(按场景选择):
- TCC(Try-Confirm-Cancel):适合资金类、库存类场景。业务自行实现 Try(预留资源)、Confirm(确认提交)、Cancel(释放资源)。无锁、高性能,但业务侵入性强。
- Saga 编排:适合长事务、多服务编排。将全局事务拆分为多个本地事务,每个本地事务有对应的补偿操作。通过编排器(Orchestrator)或事件(Choreography)驱动。
- 可靠消息最终一致:适合异步场景。通过本地消息表或事务消息(如 RocketMQ),保证消息和本地事务的原子性,下游消费消息完成后续操作。
- Seata AT 模式:适合不想改造业务的场景。通过代理数据源自动生成 undo log,实现自动回滚,对业务代码侵入小。
核心原则:在微服务架构中,优先考虑最终一致性方案,而不是强一致性。大多数业务场景是"可以短暂不一致,但不能永久不一致"。
Q5:Paxos/Raft 这类共识算法也能解决分布式一致性问题,它们和 2PC 有什么区别?为什么不用 Raft 代替 2PC?
答:这是两个层面完全不同的问题,经常会混淆。
核心区别:
| 维度 | 2PC/3PC | Paxos/Raft |
|---|---|---|
| 解决的问题 | 原子提交(Atomic Commit) | 共识(Consensus)——多副本状态机 |
| 参与者角色 | TM + RM,角色固定 | 所有节点平等,选主后分为 Leader/Follower |
| 容错模型 | 任一 RM 失败 → 全局失败 | 多数派存活即可继续工作 |
| 故障恢复 | 依赖 TM 持久化日志 | 通过日志复制和 Leader 选举自动恢复 |
| 阻塞性 | 可能阻塞(TM 故障) | 非阻塞(只要多数派存活) |
| 适用场景 | 异构系统间的原子提交 | 同构系统间的状态复制 |
为什么不用 Raft 代替 2PC?
- Raft 解决的是"多副本一致性":比如 3 个 MySQL 副本,Raft 保证它们的数据一模一样。但 2PC 解决的是"多资源原子提交":订单库和库存库是两个不同的数据库,存储的是不同的数据,Raft 无法适用。
- Raft 要求所有参与者运行相同的状态机:不能把"写 MySQL 订单表"和"写 Redis 库存"放到同一个 Raft 状态机里。
- Raft 需要多数派:如果只有 2 个 RM,Raft 无法容忍任何故障(需要 3 个节点才能容忍 1 个故障)。而 2PC 在 2 个 RM 的情况下可以正常工作(只要 TM 不挂)。
- Raft 的性能开销:Raft 的每次操作都需要日志复制到多数派,延迟远高于 2PC 的单轮通信。
正确的理解:2PC 和 Raft 解决的是不同层次的问题,它们不是替代关系。在分布式系统中,经常需要两者结合使用——比如用 Raft 保证 TM 本身的高可用(多个 TM 副本通过 Raft 实现 Leader 选举和日志复制),再用 2PC 协调多个 RM 的原子提交。
Q6:你设计一个分布式事务协调器(TM),需要持久化哪些状态?故障恢复时如何处理"部分已提交"的情况?
答:这是考察工程落地能力的问题,需要对 TM 的内部实现有深入理解。
需要持久化的状态:
- 全局事务日志(最关键):
- 事务 ID(XID)
- 事务状态:ACTIVE → PREPARING → PREPARED → COMMITTING → COMMITTED / ABORTING → ABORTED
- 参与该事务的所有 RM 列表
- 每个 RM 的分支事务 ID
- 每个 RM 的当前状态(初始 / Prepared / Committed / Aborted)
- 创建时间、超时时间
- 事务决策记录:
- 最终决策:COMMIT 还是 ROLLBACK
- 决策时间
- 每个 RM 的提交/回滚结果
- 超时配置:
- Prepare 阶段超时时间
- 事务整体超时时间
持久化时机:
- 事务开始时:记录 ACTIVE 状态
- Prepare 完成(收集齐所有 RM 的 Ready/Abort)后:记录决策(COMMIT/ROLLBACK),此步骤必须在发送 Commit/Rollback 指令之前完成(Write-Ahead Log)
- 每个 RM 提交/回滚完成后:记录该 RM 的完成状态
故障恢复处理"部分已提交":
TM 重启后,扫描事务日志,对每个未完成的事务:
- 状态为 ACTIVE 或 PREPARING:直接回滚,向所有 RM 发送 Rollback
- 状态为 PREPARED 但决策未记录:调用
xa_recover()获取所有 RM 的悬挂事务,重新收集状态,根据所有 RM 是否 Ready 决定提交或回滚 - 决策已记录为 COMMIT,但部分 RM 未完成:这是"部分已提交"场景。TM 向所有未完成的 RM 重发 Commit 指令(幂等重试,直到所有 RM 确认完成)
- 决策已记录为 ROLLBACK,但部分 RM 未完成:同理,向所有未完成的 RM 重发 Rollback 指令
关键设计原则:
- Write-Ahead Log:决策必须先持久化,再发送指令。如果在发送 Commit 之前宕机,重启后日志中无决策记录,可以安全回滚
- 幂等重试:Commit/Rollback 指令必须幂等,TM 可以无限重试直到成功
- 超时与告警:如果某个 RM 长时间未响应,不应无限重试——需要上报告警,人工介入
- RM 的路由信息持久化:如果 TM 的内存中丢失了 RM 的连接信息,需要有地方恢复(持久化 RM 地址或通过服务发现重建)
进阶考虑:
- 如果 TM 本身也故障了(比如磁盘损坏,日志丢失),怎么办?这需要 TM 的高可用方案——比如多 TM 副本通过 Raft 保证日志一致性,或者将日志存储到高可用的外部存储中。
下一篇:167|TCC 模式:Try/Confirm/Cancel、空回滚、悬挂和幂等