阅读时间:约 42 分钟 | 难度:高级 | 适用范围:分布式系统、微服务架构、金融交易系统
一、开篇:一个电商下单的分布式困境
假设你在开发一个电商下单服务。用户提交订单后,系统需要完成三件事:
- 订单服务:创建订单,状态置为"待支付"
- 库存服务:扣减对应商品的库存
- 积分服务:给用户增加下单积分
在一个单体应用中,这三个操作可以放在一个数据库事务中,要么全部成功,要么全部回滚。但在微服务架构下,每个服务拥有独立的数据库,事务边界被打破——如何在多个服务之间保证数据一致性?
这就是分布式事务要解决的核心问题。本文聚焦于一种工业界最广泛使用的分布式事务解决方案——可靠消息最终一致性。
二、分布式事务的十字路口:我们有哪些选择?
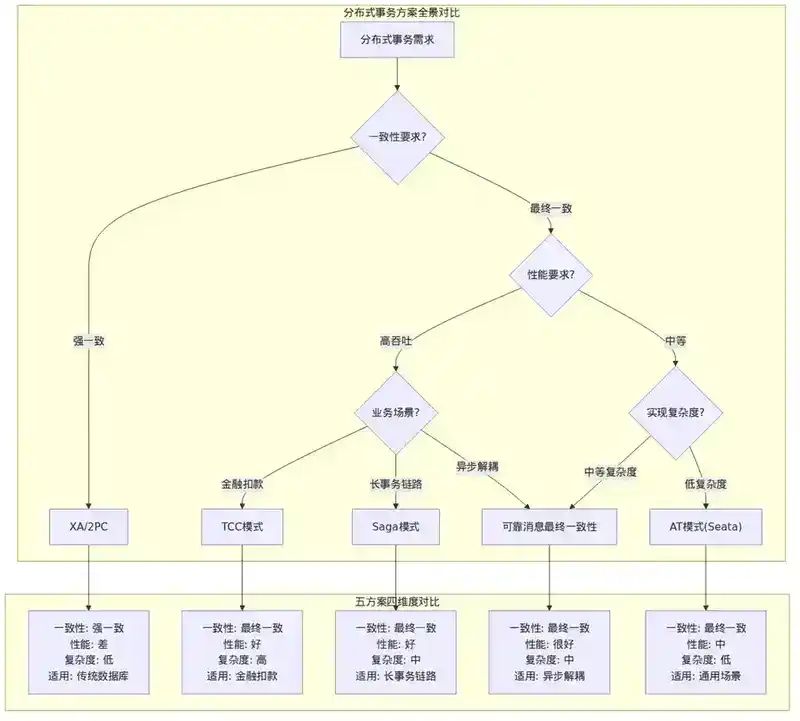
在讨论可靠消息之前,必须理解分布式事务的解法全景:
| 方案 | 一致性 | 性能 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| XA/2PC | 强一致 | 差 | 低 | 传统数据库场景 |
| TCC | 最终一致 | 好 | 高 | 金融扣款 |
| Saga | 最终一致 | 好 | 中 | 长事务链路 |
| 可靠消息 | 最终一致 | 很好 | 中 | 异步解耦场景 |
| AT 模式(Seata) | 最终一致 | 中 | 低 | 通用场景 |
可靠消息最终一致性的核心思想非常简单:通过消息队列确保本地事务执行和消息发送的原子性,下游服务消费消息执行自己的本地事务,通过重试和补偿机制最终达到一致状态。
三、核心原理:一个简单的类比
理解可靠消息最终一致性,可以用一个生活场景类比:
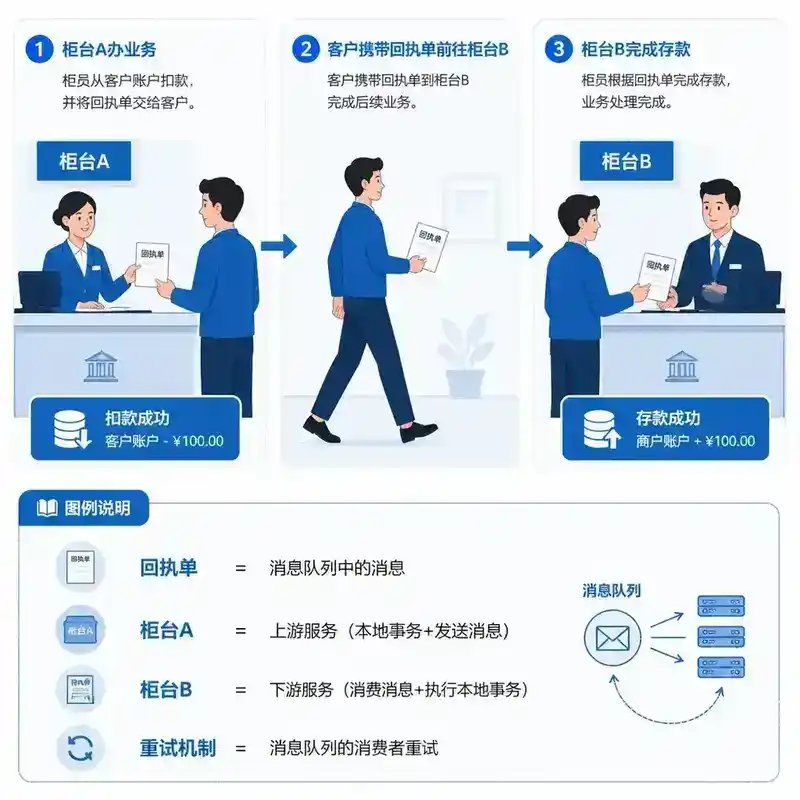
你去银行柜台办理转账。柜员先在你的账户上扣款,然后给你一张回执单。你拿着回执单去另一个柜台,那边的柜员根据回执单给对方账户加钱。如果另一个柜台暂时关闭,回执单不会丢失——你改天再去,或者系统自动帮你重试。
在这个类比中:
- 回执单 = 消息队列中的消息
- 第一个柜台 = 上游服务(本地事务 + 发送消息)
- 第二个柜台 = 下游服务(消费消息 + 执行本地事务)
- 重试机制 = 消息队列的消费者重试
关键技术挑战是:如何保证上游服务的本地事务和消息发送是原子操作——即"业务操作"和"消息发送"必须同时成功或同时失败。
四、方案一:本地消息表(Local Message Table)
4.1 核心思想
本地消息表是最经典、最可靠的方案之一。它的核心思想是:将"消息"作为业务数据的一部分,与业务操作在同一个数据库事务中落盘,然后由一个独立的定时任务轮询消息表,将消息发送到消息队列。
4.2 工作原理
┌─────────────────────────────────────────────────────────────────┐
│                    本地消息表方案架构                              │
│                                                                 │
│   ┌──────────┐     ┌──────────────┐     ┌──────────────┐        │
│   │ 业务服务  │────▶│ 本地消息表    │────▶│ 消息发送调度器 │        │
│   │          │     │ (同库同事务)   │     │ (定时轮询)    │        │
│   └──────────┘     └──────────────┘     └──────┬───────┘        │
│                                                 │               │
│                                                 ▼               │
│                                          ┌──────────────┐       │
│                                          │  消息队列     │       │
│                                          │ (Kafka/RMQ)  │       │
│                                          └──────┬───────┘       │
│                                                 │               │
│                                                 ▼               │
│                                          ┌──────────────┐       │
│                                          │  下游服务     │       │
│                                          │ (消费+本地事务)│       │
│                                          └──────────────┘       │
└─────────────────────────────────────────────────────────────────┘
4.3 实现步骤
第一步:本地事务中同时写入业务数据和消息记录
-- 在同一事务中完成
BEGIN TRANSACTION;

-- 1. 业务操作
INSERT INTO orders (id, user_id, amount, status)
VALUES (1001, 2001, 99.00, 'CREATED');

-- 2. 写入本地消息表
INSERT INTO outbox_message (
    id, topic, message_key, payload, status, create_time
) VALUES (
    'msg_1001', 'ORDER_CREATED', '1001',
    '{"orderId":1001,"userId":2001,"amount":99.00}',
    'PENDING', NOW()
);

COMMIT;
第二步:定时任务轮询并发送消息
@Component
public class MessageSendScheduler {

    @Scheduled(fixedDelay = 1000)  // 每1秒轮询一次
    public void sendPendingMessages() {
        // 查询待发送的消息(限制批量大小)
        List<OutboxMessage> messages = outboxMessageMapper
            .selectPending(100);  // 每次最多100条

        for (OutboxMessage msg : messages) {
            try {
                // 发送到消息队列
                SendResult result = producer.send(
                    msg.getTopic(),
                    msg.getMessageKey(),
                    msg.getPayload()
                );

                // 更新消息状态为已发送
                outboxMessageMapper.updateStatus(
                    msg.getId(), "SENT", result.getMsgId()
                );
            } catch (Exception e) {
                // 记录失败次数,达到阈值后告警
                outboxMessageMapper.incrementRetry(msg.getId());
                log.error("消息发送失败: {}", msg.getId(), e);
            }
        }
    }
}
第三步:下游消费消息并执行本地事务
@KafkaListener(topics = "ORDER_CREATED")
public void handleOrderCreated(String payload) {
    OrderEvent event = JSON.parseObject(payload, OrderEvent.class);

    // 幂等校验:检查是否已处理
    if (idempotentService.isProcessed(event.getOrderId())) {
        return; // 已处理,跳过
    }

    // 执行本地事务
    inventoryService.deductStock(event.getOrderId());
    pointsService.addPoints(event.getUserId(), event.getAmount());

    // 标记已处理
    idempotentService.markProcessed(event.getOrderId());
}
4.4 关键设计要点
1. 消息表设计
CREATE TABLE outbox_message (
    id          BIGINT PRIMARY KEY AUTO_INCREMENT,
    message_id  VARCHAR(64) NOT NULL UNIQUE,  -- 业务唯一ID
    topic       VARCHAR(128) NOT NULL,         -- 消息主题
    message_key VARCHAR(128),                  -- 分区键
    payload     TEXT NOT NULL,                 -- 消息体
    status      VARCHAR(16) NOT NULL DEFAULT 'PENDING',
    retry_count INT DEFAULT 0,                 -- 重试次数
    max_retry   INT DEFAULT 10,                -- 最大重试次数
    next_retry  DATETIME,                      -- 下次重试时间
    send_result VARCHAR(512),                  -- 发送结果
    create_time DATETIME NOT NULL,
    update_time DATETIME,
    INDEX idx_status_retry (status, next_retry)
);
2. 消息发送的可靠性保障
- 主动轮询:定时任务扫描
status=PENDING且next_retry <= NOW()的记录 - 指数退避:重试间隔按照 1s、2s、4s、8s... 递增,避免雪崩
- 熔断机制:当消息队列不可用时,停止发送但不丢弃消息,等待恢复
- 死信转移:超过最大重试次数的消息,转移到死信表,人工介入
3. 下游消费的幂等性
消息可能被重复发送,下游必须保证幂等。常见幂等方案:
- 唯一键去重:在消费端维护一张已处理消息表,以
message_id为唯一键 - 业务状态机:通过业务状态判断是否已处理(如订单状态已为"已支付"则跳过扣款)
- Token 机制:上游生成唯一 Token,下游校验 Token 是否已使用
4.5 优缺点
优点:
- 实现简单,不依赖特定的消息队列能力
- 与业务数据库事务天然绑定,一致性强
- 消息不丢失,有持久化保障
缺点:
- 业务耦合:消息表与业务数据同库,不可避免侵入业务库
- 定时轮询有延迟:非实时发送,存在秒级延迟
- 单表膨胀:高并发场景下消息表数据量增长快,需要定期归档
五、方案二:事务消息(Transactional Message)
5.1 核心思想
事务消息将"业务操作"和"消息发送"的原子性保障从应用层下沉到消息队列自身。消息队列提供事务消息发送能力,只有当业务方确认本地事务提交后,消息才会被投递给下游消费者。
5.2 RocketMQ 事务消息实现
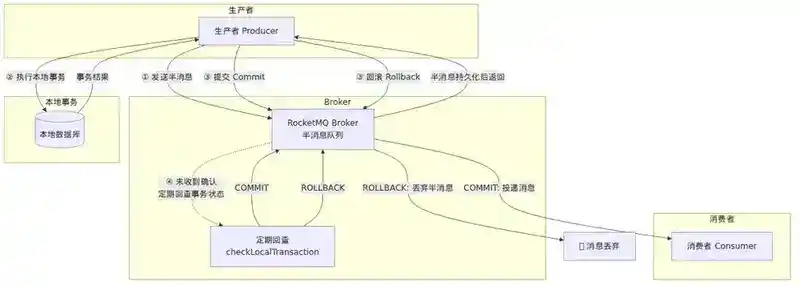
RocketMQ 是业界对事务消息支持最成熟的消息队列之一。其事务消息流程如下:
┌──────────────────────────────────────────────────────────────────┐
│                  RocketMQ 事务消息流程                             │
│                                                                  │
│  ┌──────────┐   ①发送半消息     ┌──────────────┐                 │
│  │  生产者   │─────────────────▶│  RocketMQ    │                 │
│  │          │                   │  Broker      │                 │
│  └────┬─────┘                   │              │                 │
│       │                         │ 半消息不可见 │                 │
│       │ ②执行本地事务            │              │                 │
│       ▼                         └──────┬───────┘                 │
│  ┌──────────┐                          │                         │
│  │ 本地数据库│                          │ ④定期回查                 │
│  └────┬─────┘                          │ (事务状态未知时)           │
│       │                                ▼                         │
│       │ ③提交/回滚              ┌──────────────┐                 │
│       └─────────────────────────▶│  事务状态检查  │                 │
│                                  │  (checkLocal) │                 │
│                                  └──────┬───────┘                 │
│                                         │                         │
│                            ┌────────────┴────────────┐           │
│                            ▼                         ▼           │
│                    ┌──────────────┐          ┌──────────────┐     │
│                    │ COMMIT 消息   │          │ ROLLBACK 消息 │     │
│                    │ → 投递给消费者 │          │ → 丢弃半消息   │     │
│                    └──────────────┘          └──────────────┘     │
└──────────────────────────────────────────────────────────────────┘
5.3 代码实现
@Service
public class OrderTransactionService {

    private TransactionMQProducer producer;

    public void createOrder(Order order) {
        // 构造事务消息
        Message msg = new Message("ORDER_CREATED",
            JSON.toJSONBytes(order));

        // 发送事务消息
        TransactionSendResult result = producer.sendMessageInTransaction(
            msg,
            new TransactionListener() {

                @Override
                public LocalTransactionState executeLocalTransaction(
                        Message msg, Object arg) {
                    // ② 执行本地事务
                    try {
                        orderService.insertOrder(order);
                        outboxService.recordMessage(msg);
                        return LocalTransactionState.COMMIT_MESSAGE;
                    } catch (Exception e) {
                        return LocalTransactionState.ROLLBACK_MESSAGE;
                    }
                }

                @Override
                public LocalTransactionState checkLocalTransaction(
                        MessageExt msg) {
                    // ④ 回查本地事务状态
                    // 当 Broker 未收到 COMMIT/ROLLBACK 时回调
                    String orderId = msg.getKeys();
                    Order order = orderService.getById(orderId);
                    if (order != null) {
                        return LocalTransactionState.COMMIT_MESSAGE;
                    }
                    return LocalTransactionState.ROLLBACK_MESSAGE;
                }
            }
        );
    }
}
5.4 关键机制:事务回查
事务回查是事务消息最核心的保障机制。当 Broker 发送了半消息但未收到 COMMIT 或 ROLLBACK 确认时(可能因为网络超时、生产者宕机等),Broker 会主动回调 checkLocalTransaction 方法查询本地事务状态。
回查要点:
- 回查有次数限制(默认 15 次),超过后标记为"未知"需要人工处理
- 回查间隔逐次递增,避免对业务系统造成压力
- 回查方法必须是幂等的,且不能包含副作用操作
5.5 Kafka 的事务消息
Kafka 从 0.11 版本开始也支持事务消息,但语义与 RocketMQ 有所不同:
// Kafka 事务生产者
producer.initTransactions();
producer.beginTransaction();
producer.send(new ProducerRecord<>("topic", key, value));
// 可以同时发送多条消息,跨多个分区
producer.commitTransaction();
// 或 producer.abortTransaction();
Kafka 的典型使用场景是消费-转换-生产(Consume-Transform-Produce)模式:在一个事务中消费一条消息,处理后将结果生产到另一个 Topic,保证"消费-处理-生产"的原子性。
5.6 事务消息 vs 本地消息表
| 维度 | 本地消息表 | 事务消息 |
|---|---|---|
| 实现复杂度 | 中(需要定时任务) | 低(MQ 原生支持) |
| 基础设施依赖 | 仅需数据库 | 需要支持事务消息的 MQ |
| 消息发送延迟 | 秒级(轮询间隔) | 毫秒级 |
| 消息可靠性 | 高(数据库持久化) | 高(MQ 保证 + 回查) |
| 业务侵入性 | 高(耦合消息表) | 低 |
| 适用场景 | 任意 MQ 或无需 MQ | RocketMQ/Kafka |
六、方案三:CDC + Outbox 模式
除了上述两种方案,还有一种更现代的方法——利用 CDC(Change Data Capture) 捕获数据库变更,自动化消息发送。
<pre><code>┌──────────────────────────────────────────────────────────────────┐<br>│ CDC + Outbox 模式 │<br>│ │<br>│ ┌──────────┐ 写入outbox ┌──────────────┐ │<br>│ │ 业务服务 │────────────────▶│ 业务数据库 │ │<br>│ │ │ │ outbox表 │ │<br>│ └──────────┘ └──────┬───────┘ │<br>│ │ 读取binlog │<br>│ ▼ │<br>│ ┌──────────────┐ │<br>│ │ Debezium │ │<br>│ │ (CDC工具) │ │<br>│ └──────┬───────┘ │<br>│ │ 推送变更事件 │<br>│ ▼ │<br>│ ┌──────────────┐ │<br>│ │ Kafka │ │<br>│ │ Connect │ │<br>│ └──────┬───────┘ │<br>│ │ │<br>│ ▼ │<br>│ ┌──────────────┐ │<br>│ │ 下游服务 │ │<br>│ └──────────────┘ │<br>└──────────────────────────────────────────────────────────────────┘</code></pre>
这种方案的优势在于: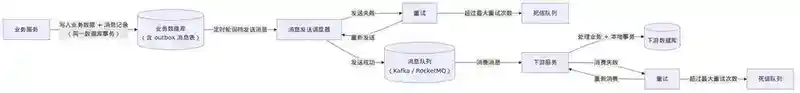
- 业务代码只需写入 outbox 表,无需关心消息发送逻辑
- 消息发送由 CDC 工具自动完成,生产代码零侵入
- 天然支持消息顺序性和不丢失
七、补偿机制:当事务出了意外
7.1 为什么需要补偿?
可靠消息最终一致性不是"从不失败",而是"失败后能恢复"。在分布式环境下,可能出现:
- 下游服务消费消息后执行本地事务,但写入数据库失败
- 消息队列故障导致消息无法投递
- 下游服务 Bug 导致消费异常
- 网络分区导致消息延迟
这种情况需要补偿机制来兜底。
7.2 补偿的分类
1. 正向补偿(重试)
这是最常用的补偿方式——消费失败后自动重试,直到成功:
@KafkaListener(topics = "ORDER_CREATED")
@Retryable(
    maxAttempts = 5,
    backoff = @Backoff(delay = 1000, multiplier = 2.0)
)
public void handleOrderCreated(String payload) {
    // 业务逻辑
}
2. 反向补偿(回滚)
当重试达到上限仍失败时,需要执行反向操作,将数据恢复为一致状态:
// 补偿服务
public void compensateOrder(OrderEvent event) {
    // 1. 恢复库存
    inventoryService.restoreStock(event.getOrderId());
    // 2. 扣回积分
    pointsService.deductPoints(event.getUserId(), event.getAmount());
    // 3. 更新订单状态
    orderService.updateStatus(event.getOrderId(), "CANCELLED");
}
3. 人工补偿(兜底)
当自动补偿也不可用时,需要人工介入。所以必须设计完善的异常记录和管理后台,支持运营人员手动触发补偿操作。
7.3 补偿的设计原则
- 幂等性:补偿操作必须可重复执行,不会造成二次影响
- 可观测性:每次补偿操作都要记录完整日志,便于审计
- 守护线程:补偿也应有重试机制,不是一次性的
- 错峰补偿:避免大量补偿操作同时执行造成系统压力
八、对账体系:发现隐藏的不一致
8.1 对账的核心价值
补偿机制可以处理"已知的失败",但分布式系统中还存在静默失败(Silent Failure)——系统没有报错,但数据实际上已经不一致。例如:
- 消息消费成功但本地事务未提交(数据库连接超时但方法返回成功)
- 并发消费导致数据被覆盖
- 逻辑 Bug 导致部分字段更新错误
对账(Reconciliation) 就是通过定期或实时比对不同系统的数据,发现这些隐藏的不一致,并触发修复。
8.2 对账系统架构
┌──────────────────────────────────────────────────────────────────┐
│                       对账系统架构                                 │
│                                                                  │
│  ┌──────────┐     ┌──────────┐     ┌──────────┐                 │
│  │ 订单系统  │     │ 支付系统  │     │ 库存系统  │                 │
│  └────┬─────┘     └────┬─────┘     └────┬─────┘                 │
│       │                │                │                        │
│       ▼                ▼                ▼                        │
│  ┌──────────────────────────────────────────────┐                │
│  │              对账引擎(Reconciliation Engine)  │                │
│  │                                              │                │
│  │  ┌──────────┐  ┌──────────┐  ┌──────────┐   │                │
│  │  │ 数据抽取  │  │ 数据比对  │  │ 差异处理  │   │                │
│  │  │ (Extract) │  │ (Compare) │  │ (Fix)    │   │                │
│  │  └──────────┘  └──────────┘  └──────────┘   │                │
│  └──────────────────────────────────────────────┘                │
│       │                                                          │
│       ▼                                                          │
│  ┌──────────┐  ┌──────────┐  ┌──────────┐                      │
│  │ 差异记录  │  │ 自动修复  │  │ 告警通知  │                      │
│  └──────────┘  └──────────┘  └──────────┘                      │
└──────────────────────────────────────────────────────────────────┘
8.3 对账策略
1. 定时 T+1 对账
每天凌晨对上一天的数据进行全量或增量对账。实现方式:
-- 对账 SQL 示例:比对订单和支付状态
SELECT
    o.order_id,
    o.status AS order_status,
    p.status AS payment_status,
    o.amount,
    p.paid_amount
FROM orders o
LEFT JOIN payments p ON o.order_id = p.order_id
WHERE o.create_date = CURDATE() - INTERVAL 1 DAY
  AND (
    -- 订单已支付但支付记录不存在
    (o.status = 'PAID' AND p.id IS NULL)
    -- 或金额不一致
    OR (o.status = 'PAID' AND o.amount != p.paid_amount)
    -- 或支付成功但订单状态不对
    OR (p.status = 'SUCCESS' AND o.status != 'PAID')
  );
2. 实时对账
关键业务场景需要实时对账,在秒级到分钟级发现差异:
@Component
public class RealTimeReconciliation {

    @KafkaListener(topics = "ORDER_PAID")
    public void onOrderPaid(OrderPaidEvent event) {
        // 在支付事件发生后,立即比对订单状态
        Order order = orderService.getById(event.getOrderId());
        Payment payment = paymentService.getByOrderId(event.getOrderId());

        if (!ReconciliationRule.isConsistent(order, payment)) {
            // 立即触发差异修复
            reconciliationService.fix(order, payment);
            // 同时记录差异用于监控
            alertService.sendAlert("订单支付不一致", event.getOrderId());
        }
    }
}
3. 全量对账
定期对全量历史数据进行对账(如每月一次),确保没有遗漏的历史差异。
8.4 对账节奏和策略
| 类型 | 频率 | 范围 | 适用场景 |
|---|---|---|---|
| 实时对账 | 秒级~分钟级 | 单笔 | 支付、扣款等资金类操作 |
| T+1 对账 | 每日 | 上一日增量 | 订单、库存、积分等 |
| 全量对账 | 每周/每月 | 全量 | 资金对账、审计合规 |
| 专项对账 | 按需 | 特定维度 | 异常排查、数据修复 |

九、生产实践:完整方案落地
9.1 最佳实践架构
一个完整的可靠消息最终一致性方案,通常组合使用多种技术:
┌──────────────────────────────────────────────────────────────────────┐
│                    可靠消息最终一致性 - 完整架构                         │
│                                                                      │
│   ┌──────────────────────────────────────────────────────────────┐   │
│   │                        上游服务                                │   │
│   │  ┌────────────────┐         ┌────────────────┐               │   │
│   │  │ 业务逻辑 +        │────────▶│ 事务消息        │               │   │
│   │  │ 本地消息表写入     │         │ (RocketMQ)     │               │   │
│   │  └────────────────┘         └───────┬────────┘               │   │
│   └────────────────────────────────────┼──────────────────────────┘   │
│                                        │                             │
│                          ┌─────────────┴─────────────┐              │
│                          │       消息队列             │              │
│                          │   (RocketMQ / Kafka)      │              │
│                          └─────────────┬─────────────┘              │
│                                        │                             │
│   ┌────────────────────────────────────┼──────────────────────────┐   │
│   │                        下游服务      │                          │   │
│   │  ┌────────────────┐                │                          │   │
│   │  │ 消费 + 幂等校验  │◀───────────────┘                          │   │
│   │  └───────┬────────┘                                           │   │
│   │          │                                                     │   │
│   │          ▼                                                     │   │
│   │  ┌────────────────┐    失败    ┌────────────────┐             │   │
│   │  │ 执行本地事务     │──────────▶│ 重试 / 死信队列  │             │   │
│   │  └───────┬────────┘           └────────────────┘             │   │
│   │          │ 成功                                                │   │
│   │          ▼                                                     │   │
│   │  ┌────────────────┐                                           │   │
│   │  │ 标记已处理       │                                           │   │
│   │  └────────────────┘                                           │   │
│   └──────────────────────────────────────────────────────────────┘   │
│                                                                      │
│   ┌──────────────────────────────────────────────────────────────┐   │
│   │                      补偿与对账层                              │   │
│   │  ┌────────────────┐  ┌────────────────┐  ┌────────────────┐  │   │
│   │  │ 定时补偿任务     │  │  T+1 对账      │  │ 实时对账        │  │   │
│   │  │ (扫描失败记录)   │  │ (日终数据比对)  │  │ (关键事件触发)  │  │   │
│   │  └────────────────┘  └────────────────┘  └────────────────┘  │   │
│   └──────────────────────────────────────────────────────────────┘   │
└──────────────────────────────────────────────────────────────────────┘
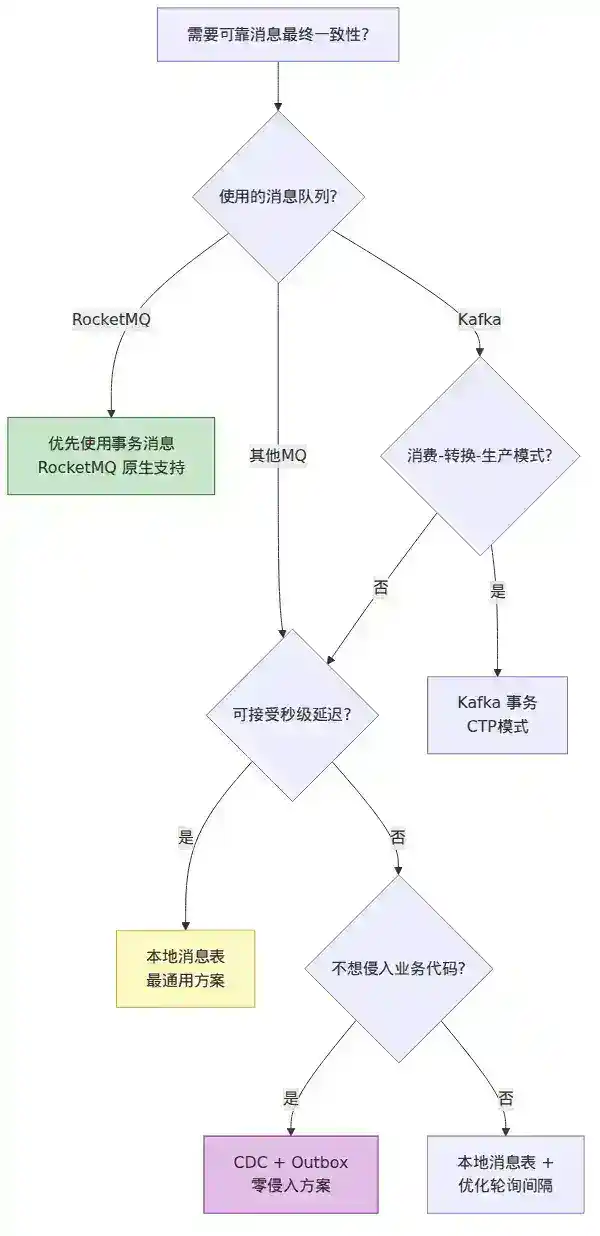
9.2 监控与告警
实施可靠消息最终一致性后,必须建立完善的监控体系:
| 监控指标 | 告警阈值 | 说明 |
|---|---|---|
| 消息发送延迟 | > 5s P99 | 消息从业务产生到发送至 MQ 的时间 |
| 消息积压量 | > 10000 | 消费端积压的消息数量 |
| 消费失败率 | > 1% | 消费失败占比 |
| 补偿执行次数 | 增长趋势 | 异常增长意味着系统问题 |
| 对账差异数 | > 0 | 任何差异都应告警 |
| 死信消息数 | > 0 | 需要人工介入处理 |
十、常见陷阱与故障案例
陷阱一:先发消息再落库(反向操作)
// ❌ 错误做法:先发消息,再写数据库
producer.send(msg);  // 消息已发出
orderService.insert(order);  // 如果这里失败,消息已无法撤回

// ✅ 正确做法:先落库,再发消息
orderService.insert(order);  // 先保证数据持久化
producer.send(msg);  // 再发送消息(配合本地消息表或事务消息)
陷阱二:消费端未做幂等
// ❌ 错误做法:消费消息直接执行,不做幂等
@KafkaListener(topics = "ORDER_CREATED")
public void handle(OrderEvent event) {
    inventoryService.deductStock(event.getOrderId());  // 重复消费会导致重复扣库存
}

// ✅ 正确做法:先查幂等,再执行
@KafkaListener(topics = "ORDER_CREATED")
public void handle(OrderEvent event) {
    if (idempotentService.isProcessed(event.getOrderId())) {
        return;
    }
    inventoryService.deductStock(event.getOrderId());
    idempotentService.markProcessed(event.getOrderId());
}
陷阱三:事务消息回查逻辑有副作用
// ❌ 错误做法:回查方法中执行了写操作
public LocalTransactionState checkLocalTransaction(MessageExt msg) {
    // 在回查中发送 HTTP 请求查询状态——这是副作用!
    String status = httpClient.get("http://other-service/status/" + msg.getKeys());
    return "SUCCESS".equals(status) ? COMMIT_MESSAGE : ROLLBACK_MESSAGE;
}
回查方法可能被 Broker 多次调用,不应包含任何有副作用的操作(如调用外部接口、写数据库等),只能查询本地事务状态。
真实故障案例:消息积压导致对账延迟
某电商平台在"双十一"大促期间,订单量暴涨 10 倍,消息队列消费端处理能力不足,导致消息积压超过 100 万条。对账系统在 T+1 凌晨运行时发现大量订单状态不一致——订单已支付但库存未扣减。问题根因是消费端限流设置不当,且缺乏动态扩容能力。
改进措施:
- 增加消费端弹性扩容能力(基于消息积压量自动增加消费者实例)
- 消息积压超过阈值时触发实时对账,不等 T+1
- 建立消费端处理能力压测基线,大促前提前扩容
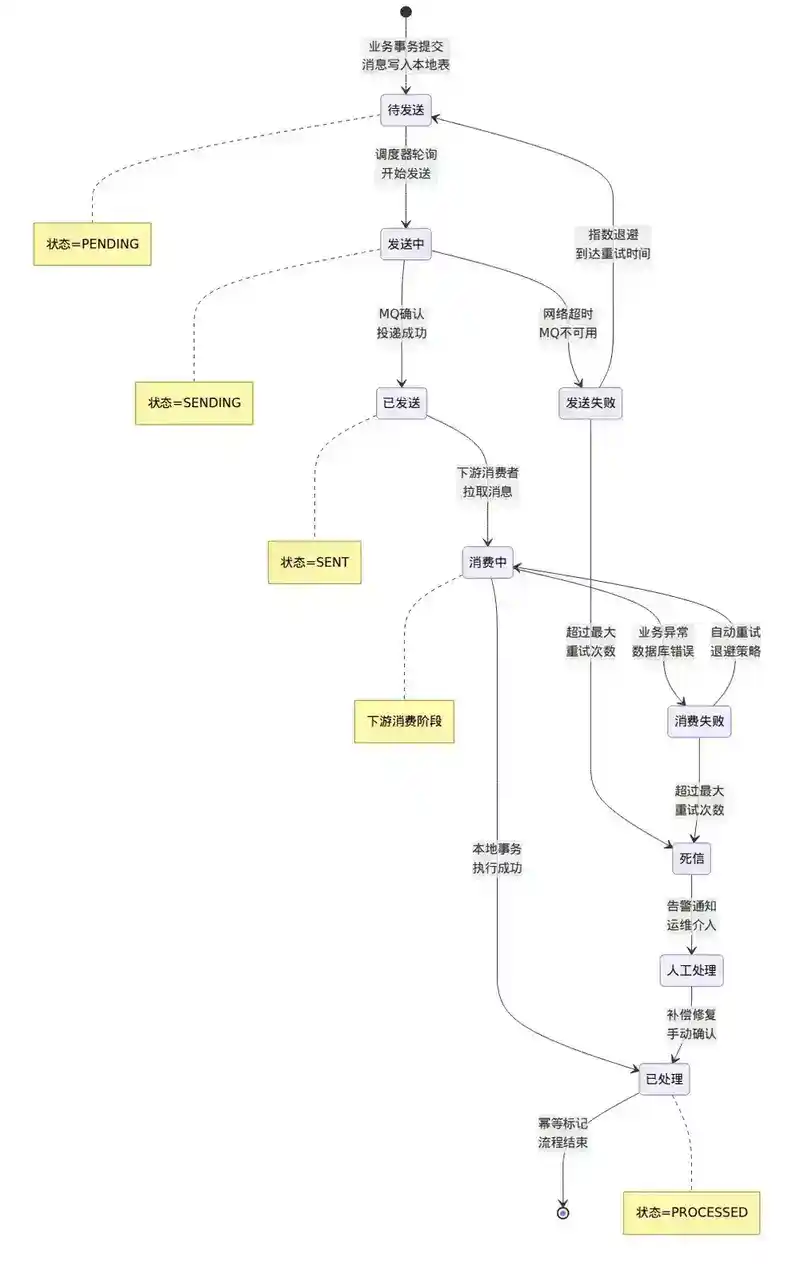
十一、选型决策树
需要可靠消息最终一致性?
│
├── 使用的消息队列是 RocketMQ?
│   ├── 是 → 优先使用事务消息(RocketMQ 原生支持)
│   └── 否 ↓
│
├── 使用的是 Kafka?
│   ├── 是 → 使用 Kafka 事务(适合 CTP 模式)或本地消息表
│   └── 否 ↓
│
├── 可以接受秒级延迟?
│   ├── 是 → 本地消息表(最通用,不依赖特定 MQ)
│   └── 否 ↓
│
└── 需要高实时性且不想侵入业务代码?
    ├── 是 → CDC + Outbox 模式
    └── 否 → 本地消息表
十二、总结
可靠消息最终一致性是分布式系统中解决数据一致性问题的最实用方案之一。核心要点:
- 核心思想:通过消息队列将分布式事务拆分为多个本地事务,通过重试和对账最终达成一致
- 本地消息表:最通用的方案,业务数据与消息在同一事务中落库,定时任务轮询发送
- 事务消息:RocketMQ 原生支持,将事务原子性保障下沉到 MQ 层,降低开发复杂度
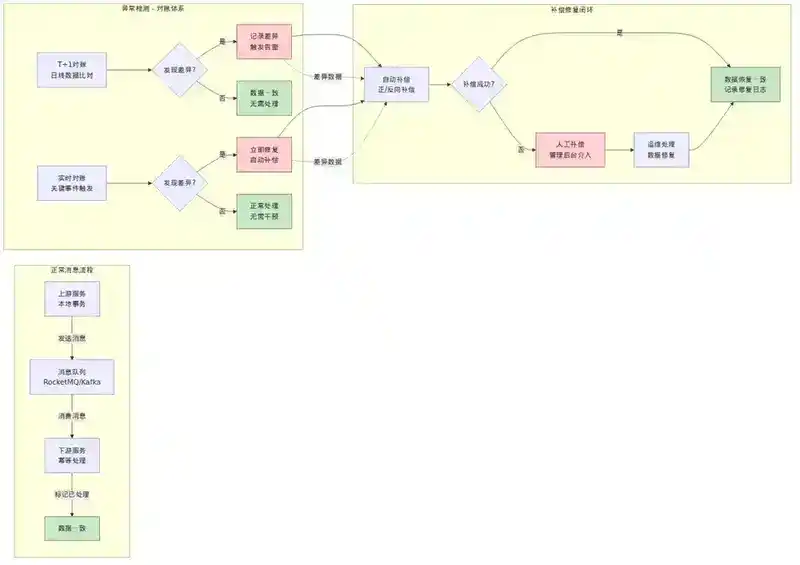
- 补偿机制:正向补偿(重试)+ 反向补偿(回滚)+ 人工兜底,形成完整闭环
- 对账体系:T+1 对账 + 实时对账 + 全量对账,三管齐下发现静默失败
- 幂等性是第一原则:所有消费端、补偿端、对账修复端都必须保证幂等
记住:分布式系统中不存在完美的强一致性方案,可靠消息最终一致性是 CAP 定理下追求可用性和分区容错 的务实选择。它承认"不一致是常态",但通过工程手段确保"不一致会被发现和修复"。
十三、面试官提问
Q1:本地消息表和 RocketMQ 事务消息,你在生产环境中会怎么选?说一个让你选本地消息表而不是事务消息的具体场景。
答: 大多数场景优先选 RocketMQ 事务消息,因为它的延迟更低、代码侵入更小。但以下场景我会选本地消息表:
- 消息队列不统一:团队同时使用 RabbitMQ 和 Kafka,没有统一的 RocketMQ 集群,本地消息表是 MQ 无关的。
- 需要消息历史可追溯:本地消息表天然保留了消息发送历史,可以直接查询某条消息的发送状态、重试次数,运维排查比查 MQ 日志方便得多。
- 消息和业务查询需要 JOIN:比如运营后台需要"查询所有发送失败消息对应的订单",本地消息表可以直接 JOIN 业务表,事务消息做不到。
实际项目中,我倾向于两者结合:核心链路用事务消息降低延迟,边缘链路用本地消息表做兜底。
Q2:假设消息队列集群完全宕机 30 分钟,你的系统如何保证最终一致性?
答: 分三层应对:
- 第一层——本地消息表兜底:即使使用事务消息,我也会在业务库保留一张
outbox表。MQ 不可用时,消息写入 outbox 表,状态PENDING。MQ 恢复后,定时任务自动扫描并补发。 - 第二层——对账发现:MQ 宕机期间,下游服务收不到消息,两边数据必然出现差异。T+1 对账会扫描出所有差异,生成差异报告。
- 第三层——补偿修复:对账发现的差异,通过补偿任务批量修复。关键点在于补偿任务必须做限流——MQ 刚恢复时如果一次性补发 30 分钟积压的消息,可能直接把下游打崩。我会按时间分片,每批 1000 条,间隔 2 秒,逐步消化积压。
另外,MQ 集群本身应该有跨机房容灾。如果单集群宕机 30 分钟都扛不住,说明基础设施层面有更大的问题需要解决。
Q3:事务消息的 **checkLocalTransaction** 回查方法中,你查的是本地数据库,但如果本地数据库也查不到记录,怎么办?
答: 这是一个经典的边界问题。场景分析:
- 正常情况:本地事务已提交,数据库有记录,返回
COMMIT_MESSAGE - 本地事务回滚:数据库无记录,返回
ROLLBACK_MESSAGE - 雷区——本地事务提交了但数据库主从延迟:主库已写入,查询走了从库还没同步到,返回
ROLLBACK_MESSAGE导致消息被误丢弃
解决方案:
- 回查强制走主库:
checkLocalTransaction中查询必须SELECT ... FOR UPDATE或指定hint走主库,保证读到最新数据。 - 设置回查窗口期:Broker 第一次回查不是立即触发,而是等 6 秒(默认),给主从同步留出时间窗口。
- 兜底对账:如果真的因为回查误判导致消息丢失,T+1 对账会发现订单状态不一致,触发补偿。
此外,回查有次数上限(默认 15 次),超过后消息标记为"未知",需要人工处理。所以必须监控"未知"事务消息的数量,这是生产环境的重要告警指标。
Q4:你在设计对账系统时,发现订单状态是"已支付"但支付记录不存在,应该执行正向补偿(补创建支付记录)还是反向补偿(取消订单)?基于什么判断?
答: 这不能一刀切,需要结合外部事实源来判断:
- 先查支付网关:这是最终的权威数据源。如果支付网关显示确实扣款成功了,说明是支付记录写入失败,应执行正向补偿——补创建支付记录。
- 如果支付网关也无记录:说明支付可能根本没发生,订单状态是错的。检查订单创建时间,如果超过 30 分钟,执行反向补偿——将订单状态改为"已取消",释放库存。
- 灰色地带——支付网关返回超时:这是最棘手的情况。支付网关调用超时,不知道扣款是否成功。此时应:
- 先冻结订单(状态置为"对账中"),防止用户重复支付
- 调用支付网关的查询接口获取最终状态
- 基于查询结果决定正向还是反向补偿
- 如果查询接口也超时,走人工介入流程
核心原则:补偿方向必须基于外部权威数据源判断,不能仅凭本地数据推测。资金类操作尤其如此,宁可多这一步查询,也不能错补。
Q5:消费端做了幂等,但如果 **isProcessed** 和 **markProcessed** 之间发生了并发——两个线程同时消费了同一条消息的重复副本,怎么保证不重复执行?
答: 这是幂等实现中最容易踩的坑。isProcessed 和 markProcessed 不是原子操作,存在竞态条件。
方案一:数据库唯一约束(推荐)
CREATE TABLE processed_messages (
    message_id VARCHAR(64) PRIMARY KEY,
    processed_at DATETIME NOT NULL
);
消费逻辑改为:
try {
    // 直接插入,利用主键冲突做幂等
    processedMessageMapper.insert(messageId);
    // 插入成功 = 第一次处理,执行实际业务
    doActualBusiness();
} catch (DuplicateKeyException e) {
    // 主键冲突 = 已处理,直接跳过
    log.info("消息已处理: {}", messageId);
}
利用数据库唯一索引保证原子性,插入成功才能执行业务,天然避免了并发问题。
方案二:Redis SETNX + 业务状态机
// SETNX 是原子操作
Boolean acquired = redis.setIfAbsent("msg:" + messageId, "1", 3600);
if (!acquired) return;

try {
    doActualBusiness();
} finally {
    // 不要立即删除 key,让它自然过期,防止极端情况下的并发穿透
}
方案三:业务状态机判断
如果业务本身有状态机(如订单状态),可以更进一步:
UPDATE inventory SET stock = stock - 1
WHERE order_id = #{orderId} AND status = 'PENDING';
如果 affected_rows = 0 说明已经被处理过,直接跳过。优点是不需要额外的幂等表,缺点是适用面窄。
Q6:一个订单创建后需要通知库存、积分、物流三个下游服务,这三个服务之间没有依赖关系,但都要求最终一致性。你会怎么设计消息发送策略?
答: 这本质上是 1 对多分发问题。
推荐方案:单 Topic + 消费组分发
上游发送一条消息到 ORDER_CREATED Topic,三个下游服务各自一个消费组,独立消费:
ORDER_CREATED Topic
    ├── consumer-group-inventory  → 库存服务
    ├── consumer-group-points     → 积分服务
    └── consumer-group-logistics  → 物流服务
优点:简单,Kafka/RocketMQ 原生支持。三个下游独立消费,互不影响。上游只写一条消息到 outbox 表,定时任务发送到 Topic,保持上游简单性。
为什么不选多 Topic 分发? 上游分别发送到三个 Topic,需要保证这三条消息"要么全发、要么全不发"——又回到了分布式事务问题,反而增加了复杂度。
如果某个下游长期消费失败,通过该下游自己的死信队列 + 对账来兜底。
Q7:如果让你给"可靠消息最终一致性"这套方案打分(满分 10 分),你会打几分?扣分扣在哪里?
答: 我会打 8 分。
扣分项:
- 最终一致 ≠ 实时一致(-1 分):从消息发出到下游消费完成,存在秒级到分钟级的不一致窗口。在这个窗口内查询数据,可能看到中间状态。对于需要实时一致性的场景(如余额扣减后立即查询余额),需要额外处理"读已写"问题。
- 运维复杂度(-0.5 分):需要维护消息表、定时任务、对账系统、补偿机制、死信队列、监控告警等一系列配套。小团队如果基础设施不完善,落地成本很高。
- 对账修复的完整性难以 100% 保证(-0.5 分):对账能发现大部分差异,但"对账脚本本身的 Bug 导致漏掉差异"、"补偿操作执行失败"、"历史数据被归档后无法对账"等边缘情况,存在极小概率的数据不一致被遗漏。
不扣分但值得警惕的隐形成本:
- 幂等逻辑散落在各个消费端,代码审查时容易被忽略
- 新人接手时,不一定理解"消息可能重复"这个前提,容易写出非幂等的消费逻辑
- 对账 SQL 随业务逻辑变化需要持续维护,容易腐化
总体来说,可靠消息最终一致性是工程上最务实的选择——它不追求完美的理论一致性,而是用扎实的工程手段把不一致的概率降到可接受的范围内,并确保不一致能被发现和修复。
参考资料
- RocketMQ 事务消息官方文档
- 《企业IT架构转型之道》- 阿里巴巴中间件团队
- Chris Richardson, "Microservices Patterns"
- 《分布式服务架构:原理、设计与实战》
- Apache Kafka 事务文档