阅读时间:约 40-50 分钟 适用方向:高级 Java 工程师、技术专家、应用架构师、分布式系统架构师
一、开篇:分布式系统的"不可能三角"
2000 年,Eric Brewer 在 ACM PODC 会议上提出了一个猜想:在一个分布式系统中,无法同时满足一致性(Consistency)、可用性(Availability)和分区容错性(Partition Tolerance)。两年后,Seth Gilbert 和 Nancy Lynch 用数学严格证明了这一定理,CAP 从此成为分布式系统设计的"第一性原理"。
但 CAP 远不止三段论那么简单。实践中工程师们发现,CAP 给出的"二选一"过于粗糙——它假设网络分区要么存在要么不存在,而真实系统中,分区的发生是短暂的,更多时候系统处于"正常"状态下,此时可用性和一致性之间仍然存在一个重要的权衡:延迟。
2012 年,Daniel Abadi 提出了 PACELC 理论,将 CAP 从"分区时选什么"扩展为"分区时选什么,正常时选什么"——这是对 CAP 最重要的一次理论补全。
本文将带你从 CAP 的严格定义出发,深入到 PACELC 的工程实践,理解分布式系统设计中"一致性-可用性-延迟"这个永恒三角的本质。
二、CAP 定理:严格定义
2.1 三个字母的真含义
C — Consistency(一致性)
CAP 中的"一致性"不是数据库事务中的 ACID 之 C(那是指数据满足业务约束),而是特指原子一致性(Atomic Consistency)或线性一致性(Linearizability):所有节点在同一时刻看到的数据完全相同。更严格地说:任何一个读操作,必须能够读到最近一次写操作的结果。
关键特征:
- 写操作完成后,所有后续的读都必须返回该值(或更新的值)
- 所有操作看起来像是按某种全局顺序原子执行的
- 不存在"读到旧数据"的情况
A — Availability(可用性)
CAP 中的可用性定义是:每一个非故障节点收到的请求,都必须在有限时间内返回一个非错误的响应。注意"非故障节点"这个限定——如果节点本身宕机了,不返回响应不算违反可用性。
关键特征:
- 节点必须响应,不能无限等待
- 响应可以是"失败"但不能是"错误"(error 不同于 timeout)
- 只要节点活着,就必须响应
P — Partition Tolerance(分区容错性)
分区容错性是指:系统在任意数量的消息丢失或节点间网络延迟的情况下,仍然能继续运行。网络分区(Partition)是指节点之间的通信被中断——可能是交换机故障、网络拥塞、光纤被挖断等等。
关键特征:
- 分区意味着节点之间无法通信,但节点本身还在运行
- 分区容错不是"可选项"——除非你运行在单机上,否则分区必然会发生
- 一旦分区发生,节点必须在"返回可能过期的数据"和"返回错误"之间选择
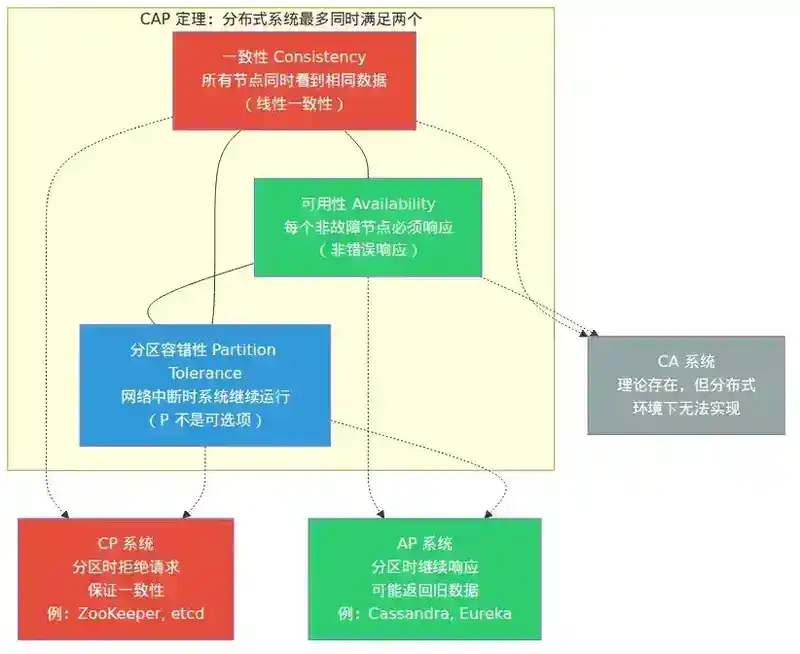
2.2 CAP 的"二选三"逻辑
CAP 定理说:一个分布式系统最多只能同时满足 CAP 中的两个。但这里有一个关键的理解:P 不是可选的。
在分布式系统中,网络分区是客观存在的,你无法阻止它发生。所以真正的选择是:当分区发生时,你选择 C 还是 A?
- 选择 CP(一致性 + 分区容错):分区发生时,为了保持一致性,系统拒绝响应请求(牺牲可用性)
- 选择 AP(可用性 + 分区容错):分区发生时,系统继续响应请求,但可能返回不一致的数据(牺牲一致性)
- CA 在分布式系统中不存在:没有分区容错的分布式系统实际上不是分布式系统
三、CAP 的深入理解
3.1 为什么 CAP 不能同时满足?
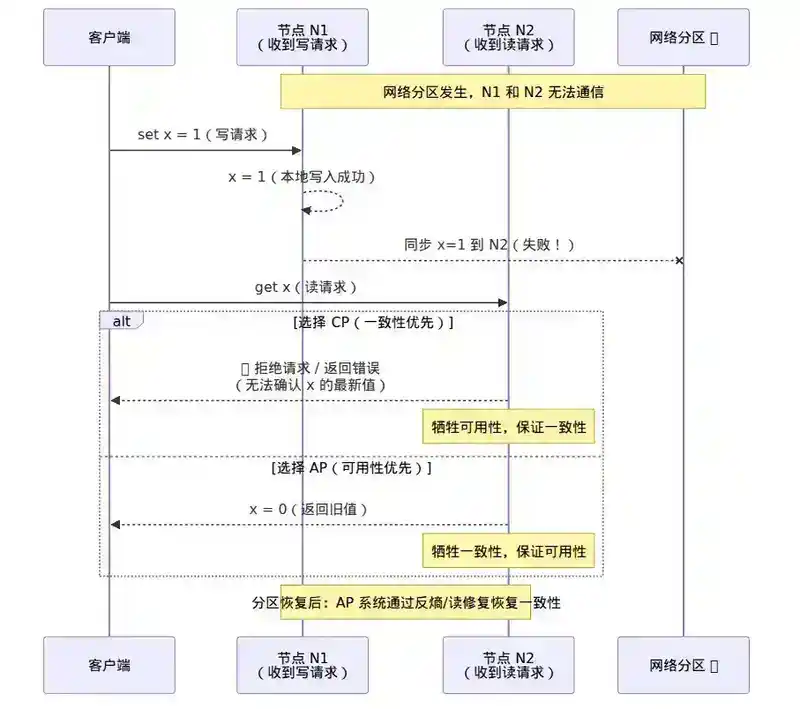
CAP 可以通过一个简单的场景来理解:
假设有两个节点 N1 和 N2,它们之间发生了网络分区。N1 收到一个写请求 set x=1,N2 收到一个读请求 get x。
- 如果系统保证 C(一致性):N2 必须读到 x=1,但 N1 无法把 x=1 同步给 N2(分区中),所以 N2 必须拒绝读请求 → 牺牲了 A
- 如果系统保证 A(可用性):N2 必须响应,但它不知道 x 已经被改为 1,只能返回旧值 → 牺牲了 C
- 如果系统两者都想要:N2 既不能返回旧值(违反 C),又不能拒绝请求(违反 A),也拿不到新值(分区中)→ 不可能
3.2 CAP 的常见误解
误解 1:CAP 是"三选二"
很多人认为可以从 CAP 中任选两个。但实际上 P 是必须的,真正选择的是 C 还是 A。一个更准确的表述是:当网络分区发生时,你要么保证一致性,要么保证可用性。
误解 2:选择 CP 就意味着系统不可用
CP 系统只在分区期间不可用,分区恢复后立刻恢复可用。而且,现代 CP 系统的不可用通常是"部分不可用"——只有参与分区的节点才不可用,多数派节点仍然正常服务。
误解 3:选择 AP 就意味着数据一定不一致
AP 系统在分区期间可能返回旧数据,但分区恢复后可以通过反熵(anti-entropy)或读修复(read repair)恢复一致性。不一致是暂时的,不是永久的。
误解 4:CAP 是一个严格的分类,每个系统只能属于 CP 或 AP
实际上,许多系统允许你按操作粒度选择取舍。例如 DynamoDB 允许你为每个操作指定一致性级别。真正的系统设计是"在哪条路上走多远"的连续谱,而非二选一。
3.3 CAP 的"一致性"有多少种?
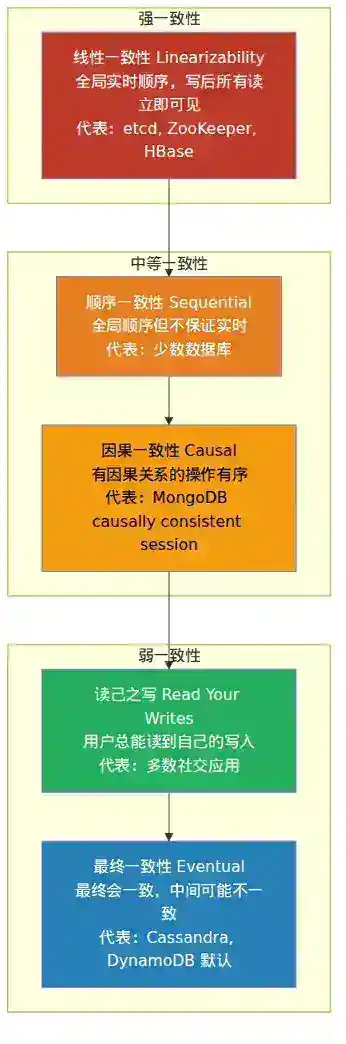
CAP 的一致性(线性一致性)是非常强的要求。实践中,分布式系统通常使用更弱的一致性模型:
| 一致性级别 | 含义 | 典型系统 |
|---|---|---|
| 线性一致性(Linearizability) | 全局实时顺序,写后所有读可见 | etcd、ZooKeeper、HBase |
| 顺序一致性(Sequential) | 全局顺序,但不保证实时 | 少数数据库 |
| 因果一致性(Causal) | 有因果关系的操作有顺序 | MongoDB(causally consistent session) |
| 最终一致性(Eventual) | 最终会一致,但中间可能不一致 | Cassandra、DynamoDB(默认) |
| 读己之写(Read your writes) | 用户总能读到自己的写入 | 多数社交应用 |
CAP 的 C 指的是线性一致性。你放弃线性一致性,不代表你放弃了所有一致性保证——你只是选择了一个更弱的一致性模型,换取了更好的可用性和性能。
四、真实世界中的 CAP 实践
4.1 为什么大多数互联网系统选择 AP?
互联网应用(电商、社交、视频等)通常选择 AP 的原因:
- 用户体验 > 数据强一致:用户看到"旧数据"比看到"错误页面"好得多
- 分区通常短暂:网络分区一般持续几秒到几分钟,最终一致性足以恢复
- 99.9% 的时间没有分区:为 0.1% 的场景牺牲 99.9% 的可用性不划算
- 业务可容忍短暂不一致:购物车少一个商品、Feed 流晚一秒出现,用户几乎无感
4.2 什么时候必须选 CP?
有些场景绝对不能容忍不一致:
- 金融账户余额:转账不能出现"钱扣了但余额没变"
- 分布式锁:锁的互斥性不能有任何妥协
- 选主/Leader 选举:不能出现两个 Leader 同时存在
- 配置中心:配置的下发必须一致,不能出现"部分节点拿到旧配置"
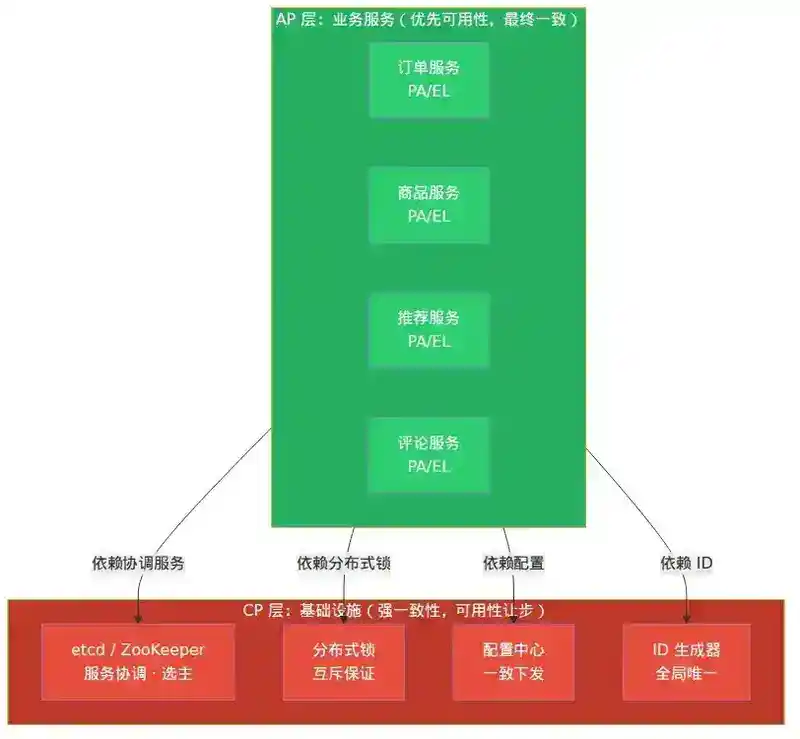
4.3 一个常见的工程模式:CP 核心 + AP 边缘
成熟的分布式系统往往采用"混合策略":
┌─────────────────────────────────────────────────────┐
│                    AP 层(业务服务)                    │
│  订单服务 · 商品服务 · 推荐服务 · 评论服务                  │
│  → 最终一致,优先保证可用性                              │
├─────────────────────────────────────────────────────┤
│                    CP 层(基础设施)                     │
│  etcd/ZooKeeper(协调) · 分布式锁 · 配置中心 · ID 生成   │
│  → 强一致,可用性让步                                   │
└─────────────────────────────────────────────────────┘
五、PACELC:CAP 的扩展理论
5.1 为什么需要 PACELC?
CAP 有一个隐含的假设:我们只关心分区发生时的行为。但真实系统中:
- 分区是罕见的(通常 < 0.1% 的时间)
- 在 99.9% 的正常时间里,系统面临的是另一个权衡:一致性(Consistency)vs 延迟(Latency)
这就是 PACELC 的核心思想:如果存在分区(P),选择 A 还是 C;否则(E),选择 L 还是 C。
P → Partition(分区) A → Availability(可用性) C → Consistency(一致性) E → Else(否则,即正常运行) L → Latency(延迟) C → Consistency(一致性)
5.2 PACELC 的四个分类
PACELC 将系统分为四类:
PC/EC(分区选 C,正常选 C)
- 特征:始终追求强一致性
- 代表:Bigtable、HBase、VoltDB
- 行为:分区时拒绝请求(牺牲可用性),正常时所有节点同步确认后再返回(牺牲延迟)
- 适用:对一致性要求极高的场景,如金融交易记录
PC/EL(分区选 C,正常选 L)
- 特征:分区时保证一致性,正常时优先低延迟
- 代表:MongoDB(默认配置)、PNUTS
- 行为:分区时拒绝部分请求,正常时主节点确认即返回(异步复制)
- 适用:一致性要求较高但可容忍正常时弱一致读的场景
PA/EC(分区选 A,正常选 C)
- 特征:分区时保证可用性,正常时追求一致性
- 代表:DynamoDB(强一致读模式)、Cassandra(QUORUM 读写)
- 行为:分区时返回可能不一致的数据,正常时使用 Quorum 读写保证一致性
- 适用:正常时需要强一致但分区时优先可用性的场景
PA/EL(分区选 A,正常选 L)
- 特征:始终优先可用性和低延迟
- 代表:DynamoDB(默认)、Cassandra(默认)、Riak、CouchDB
- 行为:分区时返回可能不一致的数据,正常时也优先低延迟(最终一致)
- 适用:大多数互联网应用,追求极致性能和可用性
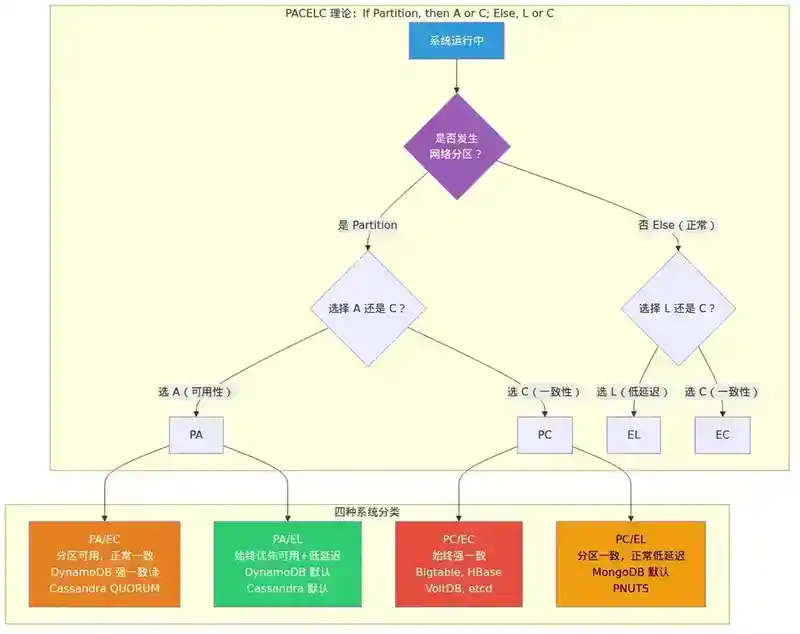
5.3 PACELC 的工程含义
PACELC 的最大贡献是将"正常运行时的权衡"显式化。在 CAP 中,正常运行时我们似乎可以同时拥有 C 和 A,但 PACELC 指出:
正常运行时,如果要保证强一致性(C),就必须付出延迟代价(L),因为需要等待所有副本确认。如果要保证低延迟(L),就必须接受可能读到旧数据(弱 C)。
这意味着:即使没有分区,一致性和延迟之间也存在根本性的权衡。
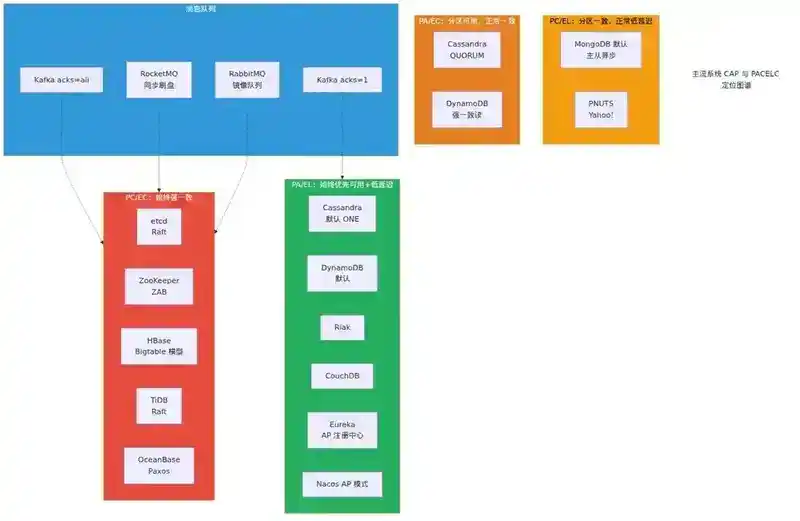
六、主流系统的 CAP/PACELC 定位
6.1 分布式数据库
| 系统 | CAP 定位 | PACELC 定位 | 说明 |
|---|---|---|---|
| MySQL(单机) | CA | N/A | 单机天然无分区,但非分布式 |
| MySQL 主从(异步) | AP | PA/EL | 主从延迟导致读可能不一致 |
| MySQL 主从(半同步) | CP(倾向) | PC/EL | 至少一个从库确认,但主库可用 |
| MySQL Group Replication | CP | PC/EC | 基于 Paxos,多数派确认 |
| TiDB | CP(默认) | PC/EC | 基于 Raft,多数派确认 |
| OceanBase | CP | PC/EC | 基于 Paxos,强一致 |
6.2 NoSQL 系统
| 系统 | CAP 定位 | PACELC 定位 | 说明 |
|---|---|---|---|
| MongoDB(默认) | CP | PC/EL | 主节点写入,从节点异步复制 |
| MongoDB(write concern majority) | CP | PC/EC | 多数派确认 |
| Cassandra(QUORUM) | AP | PA/EC | 正常时 Quorum 提供强一致 |
| Cassandra(ONE) | AP | PA/EL | 极致性能和可用性 |
| HBase | CP | PC/EC | 强一致,基于 HDFS + ZooKeeper |
| Redis Cluster | CP | PC/EL | 主从异步复制,但故障转移强一致 |
6.3 协调服务
| 系统 | CAP 定位 | PACELC 定位 | 说明 |
|---|---|---|---|
| ZooKeeper | CP | PC/EC | 基于 ZAB 协议,强一致 |
| etcd | CP | PC/EC | 基于 Raft,强一致 |
| Consul | CP | PC/EC | 基于 Raft,强一致 |
| Nacos(AP 模式) | AP | PA/EL | 最终一致,优先可用 |
| Eureka | AP | PA/EL | 优先可用,自我保护模式 |
6.4 消息队列
| 系统 | CAP 定位 | PACELC 定位 | 说明 |
|---|---|---|---|
| Kafka(acks=all) | CP | PC/EC | ISR 全部确认 |
| Kafka(acks=1) | AP | PA/EL | 仅 Leader 确认 |
| RocketMQ(同步刷盘) | CP | PC/EC | 强一致 |
| RabbitMQ(镜像队列) | CP | PC/EC | 镜像同步 |
七、工程实践:如何在 CAP/PACELC 框架下做设计决策
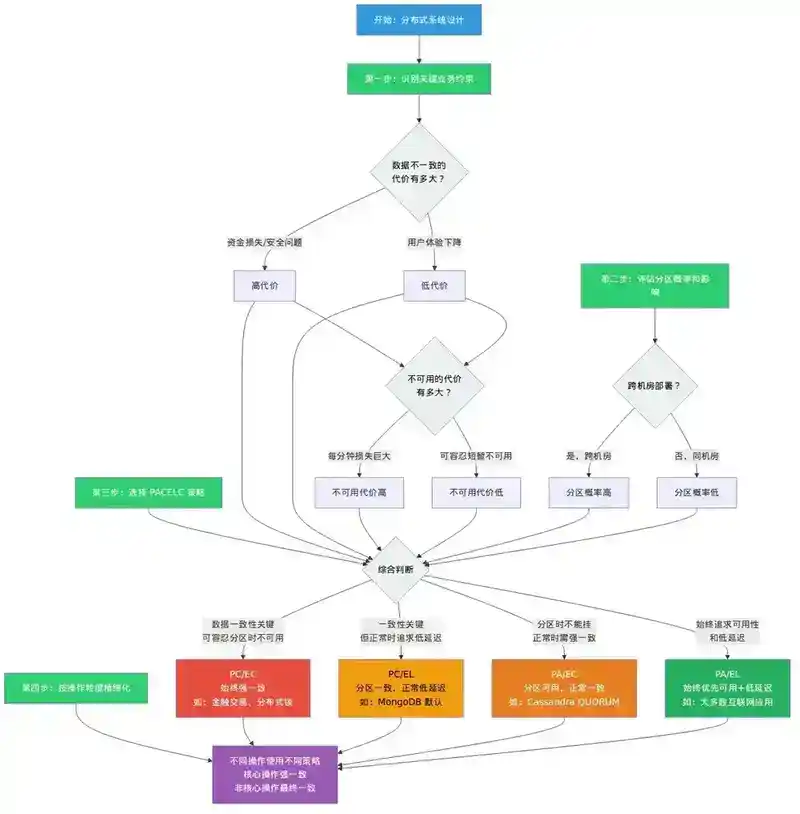
7.1 决策框架
面对分布式系统设计,可以按以下步骤思考:
第一步:识别关键业务约束
- 数据不一致的代价有多大?是"用户体验下降"还是"资金损失"?
- 不可用的代价有多大?每分钟损失多少收入?
- 延迟要求是什么?P99 延迟 < 50ms 还是 < 1s?
第二步:评估分区概率和影响
- 网络分区的概率有多大?(跨机房 > 同机房 > 单机)
- 分区通常持续多久?
- 分区的影响范围有多大?
第三步:选择 PACELC 分类
- 分区时:选 A 还是 C?
- 正常时:选 L 还是 C?
第四步:按操作精细化
- 核心操作(支付、扣库存)→ 强一致
- 非核心操作(浏览、评论、点赞)→ 最终一致
- 不同操作可以使用不同的读写策略
7.2 实践案例:电商订单系统
┌──────────────────────────────────────────────────┐
│                    订单系统                        │
│                                                    │
│  ┌──────────┐   ┌──────────┐   ┌──────────┐      │
│  │ 下单服务  │   │ 库存服务  │   │ 支付服务  │      │
│  │   PA/EL  │   │   PC/EC  │   │   PC/EC  │      │
│  │ 最终一致 │   │  强一致  │   │  强一致  │      │
│  └──────────┘   └──────────┘   └──────────┘      │
│                                                    │
│  ┌──────────┐   ┌──────────┐   ┌──────────┐      │
│  │ 商品浏览  │   │ 评论服务  │   │ 推荐服务  │      │
│  │   PA/EL  │   │   PA/EL  │   │   PA/EL  │      │
│  │ 最终一致 │   │ 最终一致 │   │ 最终一致 │      │
│  └──────────┘   └──────────┘   └──────────┘      │
└──────────────────────────────────────────────────┘
- 库存扣减、支付:PC/EC——数据不一致的代价是金钱损失
- 下单:PA/EL——下单时库存可能已经变化,后续通过库存校验确认
- 商品浏览、评论、推荐:PA/EL——短暂不一致完全可接受,用户无感
7.3 常见陷阱
陷阱 1:过度追求强一致
将所有服务都设计为 CP 会导致系统在分区时大面积不可用,一个网络抖动可能引发连锁故障。
陷阱 2:忽视正常时的延迟权衡
很多团队在 CAP 的框架下只思考"分区时怎么办",而忽视了 99.9% 的正常时间里,同步复制带来的延迟代价。
陷阱 3:认为"最终一致"就是"不一致"
最终一致性是有保证的一致性模型——它承诺数据最终会达到一致。配合版本向量、CRDT 等技术,最终一致系统可以做到很好的用户体验。
陷阱 4:低估了"部分可用"的价值
CP 系统在分区时,多数派节点仍然可用。合理的部署策略(如 5 节点跨 3 机房)可以同时获得高可用和强一致。
八、总结
CAP 定理是分布式系统理论的基石,但它只是一个起点。真正的工程实践需要考虑:
- CAP 不是"三选二",而是"分区时选 C 还是 A"
- PACELC 补全了正常运行时的一致性-延迟权衡
- 系统分类不是二元的,而是连续谱上的选择
- 不同操作可以有不同的 CAP/PACELC 策略
- 一致性是有代价的——要么付出可用性(分区时),要么付出延迟(正常时)
理解 CAP 和 PACELC,不是为了记住某个系统属于哪个分类,而是为了在面对设计决策时,清楚地知道你在用什么东西换取什么,以及这个代价是否值得。
面试问答
Q1:CAP 说分布式系统只能三选二,那为什么 MySQL 主从集群(异步复制)看起来同时满足了 C、A、P?
答:MySQL 主从异步复制集群看起来同时满足 C、A、P,但实际上它牺牲了 C,属于 AP 系统。关键点在于:在异步复制模式下,主库写入成功后立即返回,从库的数据可能滞后。当主库宕机、从库提升为新主库时,原主库上已提交但尚未同步到从库的数据会丢失——这意味着系统不满足线性一致性(写操作完成后,后续读操作可能读不到该值)。CAP 中的 C 是线性一致性,不是"大多数时候一致"。MySQL 主从集群在正常运行时"看起来"一致,但发生主从切换时就会暴露不一致——这正是 CAP 要描述的场景:当故障(分区)发生时,你选择 C 还是 A?异步复制选择了 A(允许数据丢失以保持服务可用),放弃了 C。
Q2:假设你设计一个分布式缓存系统,要求 P99 延迟 < 1ms,数据量 10TB,你会如何做 CAP/PACELC 的取舍?为什么?
答:这个场景下,PA/EL 几乎是唯一选择。原因分析:
- 延迟约束是第一性原理:P99 < 1ms 意味着不能有任何跨节点同步等待——Raft 共识的一个 round-trip 在最好的网络上也要 0.5-1ms,加上序列化开销,不可能满足 P99 < 1ms。所以正常运行时必须选 L(低延迟),即 PA/EL 中的 EL。
- 分区时也必须选 A:缓存的核心价值是加速,如果缓存因为分区不可用而让所有请求穿透到后端数据库,数据库会被瞬间打垮——这叫"缓存雪崩"。缓存的可用性优先级远高于一致性。
- 10TB 数据量意味着必须分片(sharding),每个分片独立决策。可以用一致性哈希做数据分布,客户端直连节点,消除代理层延迟。
- 一致性补偿:缓存不一致的代价通常是"用户短暂看到旧数据",对大多数业务可接受。可以通过 TTL 过期 + 主动失效 + 版本号校验来降低不一致窗口。如果真的需要强一致读,改为走数据库而不是缓存。
Q3:一个系统选择了 AP,但用户投诉"刚下的订单查不到"。在不改变 AP 架构的前提下,有哪些技术手段可以缓解这个问题?
答:这是典型的"读己之写"(Read Your Writes)一致性问题。在不改变 AP 架构的前提下,有这些手段:
- 读己之写(Read Your Writes):用户自己的写操作,总是从主节点(或写入的节点)读取。可以在用户 session 中记录"最后写入的节点/分片",后续读路由到同一节点。
- 写后路由粘性(Sticky Session / Session Affinity):用户下单后的一段时间内(如 30 秒),所有读请求路由到同一数据节点,确保看到自己的写入。
- 客户端版本追踪:客户端在写入时获取一个版本号(如 HLC 混合逻辑时钟),后续读请求带上"我见过的最小版本号",服务端返回版本 >= 该值的副本。
- 读修复(Read Repair):每次读取时,同时从多个副本读取,检测到不一致后立即修复旧副本。Cassandra 的 QUORUM 读内部就做了读修复。
- 缩短不一致窗口:减少异步复制延迟(如使用更快的网络、批量同步优化),让数据在几百毫秒内同步到所有副本。
- 关键操作走主库:下单后立即跳转到订单详情页时,这个查询强制走主库,其他非关键查询走从库。
Q4:CAP 定理中的 C(一致性)和数据库 ACID 中的 C(一致性)是同一个概念吗?如果不是,它们的区别是什么?
答:不是同一个概念,这是分布式系统面试中非常经典的问题。
| 维度 | CAP 中的 C(Consistency) | ACID 中的 C(Consistency) |
|---|---|---|
| 定义 | 原子一致性/线性一致性:所有节点同时看到相同数据,读操作必须返回最新写入的值 | 数据满足所有预定义的业务规则和约束(主键唯一、外键约束、CHECK 约束等) |
| 关注点 | 分布式副本之间的数据可见性 | 单节点上数据的逻辑正确性 |
| 保证方 | 复制协议(Paxos/Raft/Gossip) | 数据库引擎(约束检查、触发器) |
| 违反后果 | 读到旧数据/脏数据 | 数据违反业务规则(如余额为负) |
| 典型违反 | 主从延迟导致读不到刚写入的数据 | 插入重复主键、外键引用不存在的数据 |
简单来说:ACID 的 C 是"数据对"(符合规则),CAP 的 C 是"数据新"(最新版本)。一个系统可以满足 ACID 的 C 但违反 CAP 的 C(如单机 MySQL 满足 ACID,但主从异步复制违反了 CAP 的 C)。反之亦然——一个 AP 系统读到了旧数据(违反 CAP 的 C),但旧数据本身可能完全满足业务约束(满足 ACID 的 C)。
Q5:Paxos/Raft 协议保证了线性一致性,那为什么基于 Raft 的 etcd 在分区时(少数派分区)会不可用?这和 CAP 的 CP 选择有什么关系?
答:这正是 CAP 定理在共识协议中的具体体现。Raft 协议要求多数派(majority)确认才能提交一个写操作。当网络分区发生时:
- 多数派分区(如 5 节点中 3 个可以通信):可以选出 Leader,可以提交写操作,服务正常。这是 CAP 中"CP 系统的部分可用"——多数派同时满足了 C 和 A。
- 少数派分区(如 5 节点中 2 个被隔离):无法选出 Leader(得不到多数票),也无法提交任何写操作。读操作(如果配置为 linearizable read)也需要多数派确认。所以少数派分区的节点拒绝服务——这是 CAP 中"为了 C 牺牲 A"。
原因在于:如果少数派分区允许写入,分区恢复后就会出现两个独立的写入历史,无法合并为一个线性一致的历史。Raft 通过"只允许多数派操作"来保证任意两个多数派必有交集——这个交集保证了一致性,代价是少数派不可用。
这正是 CP 系统的本质:一致性是通过"拒绝服务"来保证的。不是"CP 系统永远可用",而是"CP 系统只在能保证一致性的前提下才可用"。
本文基于 CAP 定理(Eric Brewer, 2000)和 PACELC 理论(Daniel Abadi, 2012)编写。