阅读时间:约 40-50 分钟 前置知识:分布式系统基础概念、CAP 理论、网络通信基础 难度:进阶 分类:11 分布式理论、事务与一致性
1. 为什么需要共识算法
1.1 从一个简单的场景开始
假设你有一个三节点的分布式系统,现在要决定一个值 x = 5。最简单的做法是:一个节点提议,其他节点确认。但网络是不可靠的:
- 提议者可能在收到确认后宕机,其他节点不知道要不要执行
- 网络分区可能导致两个节点各自主张不同的值
- 消息可能延迟、丢失、乱序
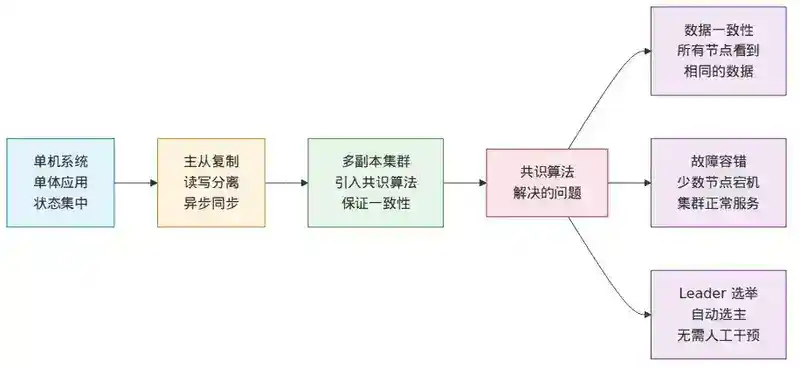
共识算法解决的核心问题就是:让一组节点在即使有节点故障、网络分区的情况下,仍然能就某个值达成一致。
共识算法需要满足三个安全性(Safety)属性:
| 属性 | 含义 |
|---|---|
| 一致性(Agreement) | 所有正确节点最终对同一个值达成一致 |
| 完整性(Integrity) | 每个节点最多决策一次,不会反复横跳 |
| 有效性(Validity) | 决策的值必须是某个节点提议的,不能凭空产生 |
1.2 FLP 不可能定理
在讨论共识算法之前,必须了解一个理论基础:FLP 不可能定理(Fischer, Lynch, Paterson, 1985)。
在异步通信模型中,即使只有一个节点可能故障,也不存在一个确定性算法能在有限时间内保证达成共识。
这句话听起来很绝望,但它说的是纯异步模型——即消息延迟没有上限的情况。而实际系统中,我们通常假设部分同步模型:消息最终会到达,只是延迟可能有波动。Raft 和 Paxos 都是在这个假设下工作的:它们保证安全性(Safety)在任何情况下都成立,而活性(Liveness)在大多数节点正常工作时成立。
图1
2. Raft 概述:可理解性优先的设计
2.1 为什么 Paxos 不够好
在 Raft 之前,Paxos 是分布式共识领域的"黄金标准"。但 Paxos 有一个致命的问题:难以理解。
Leslie Lamport 在 1998 年发表的 "The Part-Time Parliament" 用了希腊城邦议会作为比喻,导致论文发表后多年无人真正理解其工程含义。即使是简化版的 Paxos(Basic Paxos),学习曲线也异常陡峭,Multi-Paxos 的工程实现更是充满细节陷阱。
Diego Ongaro 和 John Ousterhout 在 2014 年发表的 Raft 论文 "In Search of an Understandable Consensus Algorithm" 明确提出了设计目标:可理解性。
2.2 Raft 的设计哲学
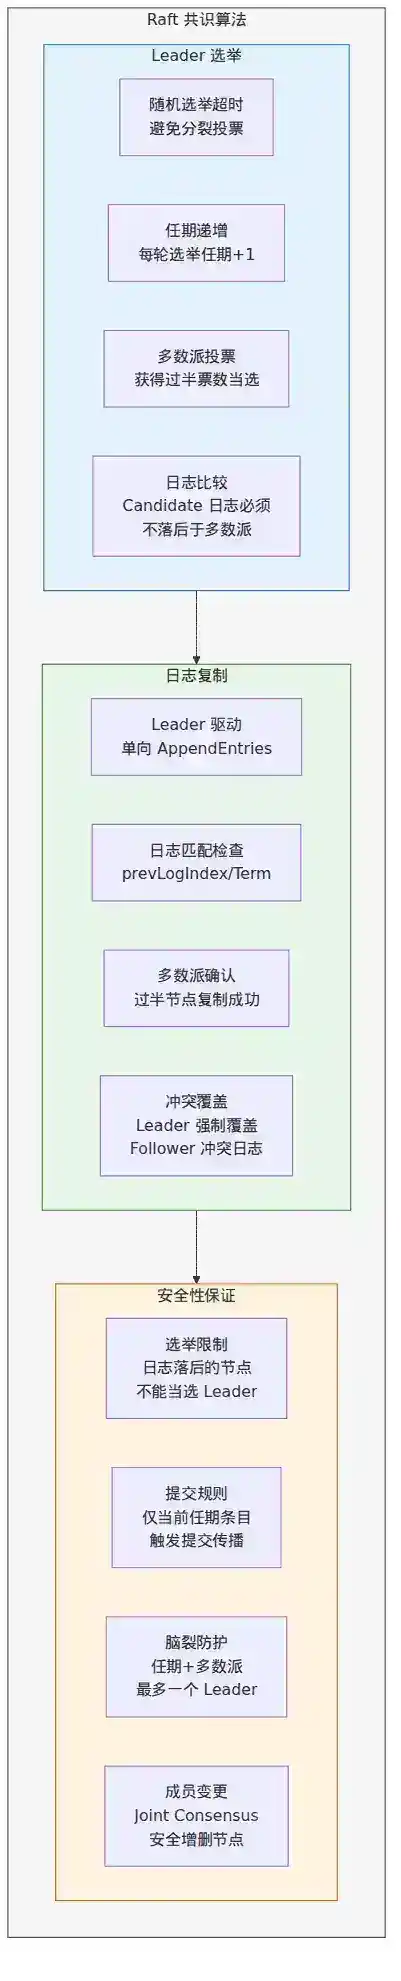
Raft 通过问题分解降低复杂度,将共识问题拆分为三个相对独立的子问题:
| 子问题 | Raft 的解法 |
|---|---|
| Leader 选举 | 随机超时、任期递增、多数派投票 |
| 日志复制 | Leader 驱动、AppendEntries 单向流、多数派确认 |
| 安全性保证 | 选举限制、提交规则、任期比较 |
此外,Raft 还通过成员变更(Joint Consensus)和日志压缩(Snapshot)来支持集群运维操作。
图2
3. 核心概念:任期、角色与状态机
3.1 三种角色
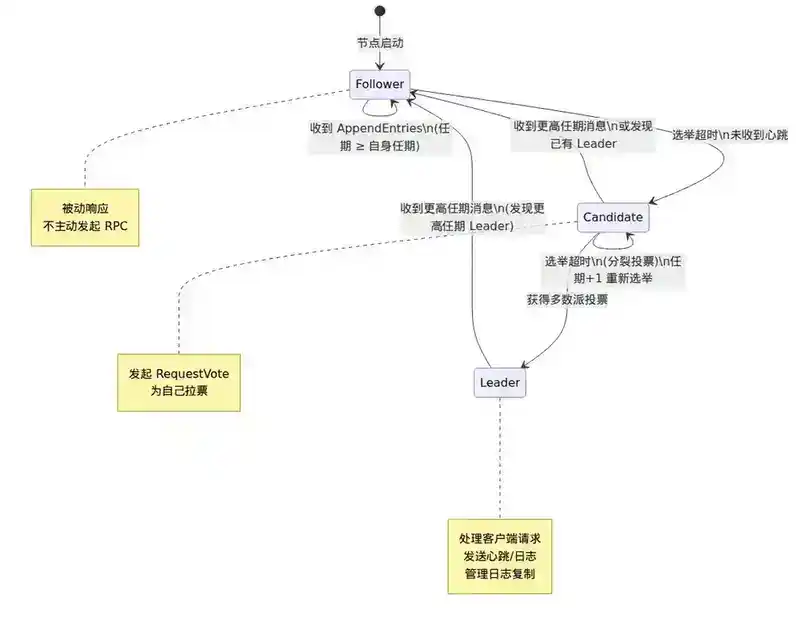
Raft 集群中的每个节点在任意时刻处于三种角色之一:
| 角色 | 职责 | 触发条件 |
|---|---|---|
| Leader | 处理所有客户端请求,管理日志复制,发送心跳 | 赢得选举 |
| Follower | 被动响应 Leader 的 RPC,不主动发起请求 | 初始状态 / 选举失败 |
| Candidate | 发起选举,为自己拉票 | 选举超时 |
关键约束:一个 Raft 集群中,任意时刻最多只有一个合法的 Leader。这是 Raft 保证线性一致性(Linearizability)的基础。
3.2 任期(Term)
任期是 Raft 中的逻辑时钟,是整个算法的核心概念:
- 任期是一个单调递增的整数(从 0 开始)
- 每个任期最多有一个 Leader
- 每个 RPC 消息都携带发送者当前的任期号
- 如果节点收到一个比自己任期更高的消息,立即更新自己的任期并降级为 Follower
任期的作用是多方面的:
- 检测过期信息:如果一个节点持有旧任期的 Leader 身份,它的消息会被更高任期的节点拒绝
- 防止脑裂:两个 Leader 不可能属于同一个任期
- 日志一致性:任期号 + 日志索引唯一标识一条日志条目
时间线示例:

Term 0          Term 1           Term 2          Term 3
|---------------|----------------|---------------|----------------|
  选举失败           Leader A         选举失败          Leader B
                   (正常工作)                       (正常工作)
3.3 状态机转换
每个节点维护一个持久化的状态机,角色转换遵循以下规则:
        启动 / 超时            收到更高任期
Follower ──────────► Candidate ──────────► Follower
    ▲                    │                     ▲
    │     赢得选举        │                     │
    │    ┌───────────────┘                     │
    │    ▼                                     │
    │ Leader ────────────────────────────────► Follower
    │         发现更高任期 / 失去多数派联系
    │
    └──────────────────────────────────────────┘
        收到 AppendEntries(任期 ≥ 自身任期)
图3
4. Leader 选举:谁说了算
4.1 选举触发条件
Follower 在选举超时(Election Timeout)内没有收到来自 Leader 的心跳消息,就会发起选举。
选举超时是一个随机值,通常在 150ms-300ms 之间随机选取。这个随机化是 Raft 设计的精髓之一:
- 假设所有节点用相同的超时,它们会同时超时、同时变成 Candidate,导致永远选不出 Leader
- 随机超时确保不同节点的超时时间错开,最先超时的节点有最大概率赢得选举
4.2 选举过程(RequestVote RPC)
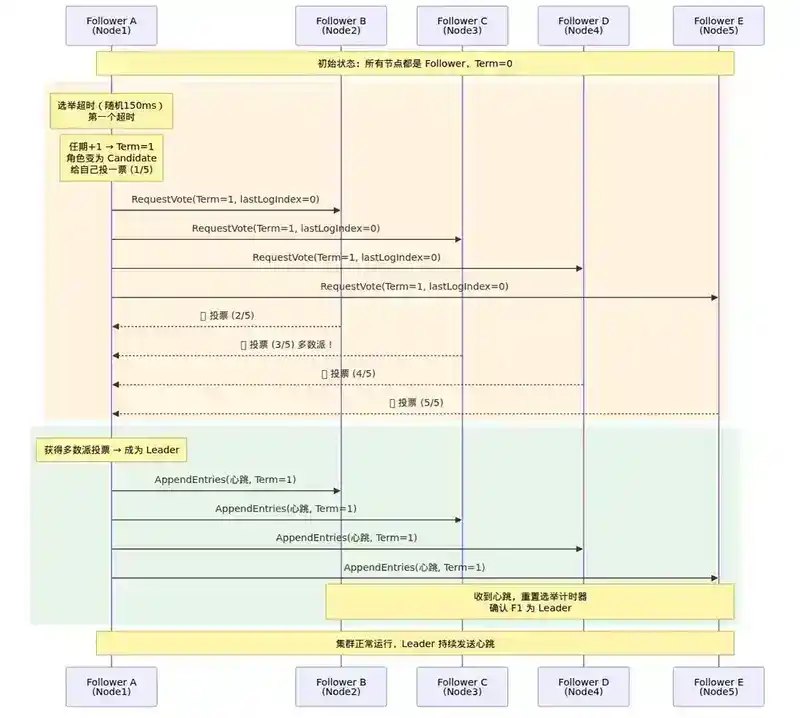
当 Follower 超时后,执行以下步骤:
1. 将自身任期 term++,角色变为 Candidate
2. 给自己投一票
3. 向所有其他节点并行发送 RequestVote RPC
4. 等待结果:
   - 收到多数派投票 → 成为 Leader
   - 收到 AppendEntries(任期 ≥ 自身)→ 已有 Leader,降级为 Follower
   - 选举超时 → 重新发起选举(分裂投票处理)
RequestVote RPC 的请求参数:
| 参数 | 含义 |
|---|---|
term |
Candidate 的当前任期 |
candidateId |
Candidate 的节点 ID |
lastLogIndex |
Candidate 最后一条日志的索引 |
lastLogTerm |
Candidate 最后一条日志的任期 |
4.3 投票规则(安全性约束)
节点收到 RequestVote 后,不是无条件投票,而是遵循严格的投票规则:
- 任期检查:如果
args.term < currentTerm,拒绝投票 - 每个任期只投一票:如果已经在这个任期投过票,拒绝
- 日志比较(最关键):Candidate 的日志必须至少和自己一样新
日志比较规则("至少一样新"的判断):
如果 args.lastLogTerm > 自身最后日志的任期 → 投票
如果 args.lastLogTerm == 自身最后日志的任期 && args.lastLogIndex >= 自身最后日志的索引 → 投票
否则 → 拒绝投票
为什么需要日志比较? 这是 Raft 保证 Leader 完整性(Leader Completeness)的关键:被选出的 Leader 必须拥有所有已提交的日志条目。如果 Candidate 的日志落后太多,即使它获得多数票也不能成为 Leader——这样保证了已提交的日志不会丢失。
4.4 分裂投票与重试
如果在同一任期内,多个 Candidate 几乎同时发起选举,投票可能被均分,导致无人获得多数票。这就是分裂投票(Split Vote)。
Raft 的处理方式非常简洁:随机超时重试。每个 Candidate 使用不同的随机超时,使得某个 Candidate 在下一轮有更大机会率先超时并发起选举。
时序图:

Node A: [Follower──────────────────][Candidate: 获得自己+Node B 的票(2/5)][Follower──]
Node B: [Follower──][Candidate: 获得自己+Node A 的票(2/5)][Follower──────────────────]
Node C: [Follower───────────────────────────────────────────────────────────────────]
Node D: [Follower───────────────────────────────────────────────────────────────────]
Node E: [Follower───────────────────────────────────────────────────────────────────]

→ A 和 B 各自获得 2 票,无人达到多数派(3),分裂投票
→ 随机超时后,C 率先超时,以更高任期发起选举,成功获得多数票
图4
5. 日志复制:让所有人保持一致
5.1 日志结构
Raft 的日志是一个有序的日志条目序列,每个条目包含:
| 字段 | 说明 |
|---|---|
term |
创建该条目时 Leader 所处的任期号 |
index |
条目在日志中的位置(从 1 开始递增) |
command |
客户端提交的状态机指令 |
日志示例:

Index:   1        2        3        4        5        6
       ┌────────┬────────┬────────┬────────┬────────┬────────┐
Term:  │   1    │   1    │   2    │   2    │   3    │   3    │
       ├────────┼────────┼────────┼────────┼────────┼────────┤
Cmd:   │set x=1 │set y=2 │set x=3 │set z=4 │set x=5 │set y=6 │
       └────────┴────────┴────────┴────────┴────────┴────────┘
                                                      ↑
                                               committedIndex = 4
                                               lastApplied = 5
- committed:被多数派节点复制且满足提交条件的日志条目
- applied:已提交并应用到状态机的日志条目
- 通常
lastApplied ≤ committedIndex
5.2 AppendEntries RPC
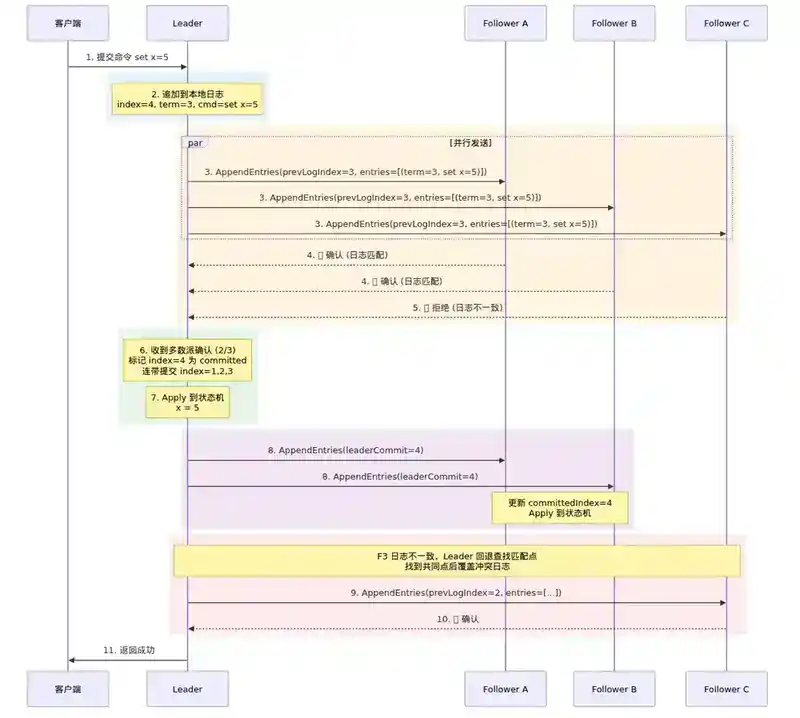
Leader 通过 AppendEntries RPC 实现日志复制。这个 RPC 兼具心跳和日志同步双重功能:
| 参数 | 含义 |
|---|---|
term |
Leader 的当前任期 |
leaderId |
Leader 的节点 ID(用于客户端重定向) |
prevLogIndex |
新条目之前一条日志的索引 |
prevLogTerm |
新条目之前一条日志的任期 |
| entries[ ] | 要复制的日志条目(心跳时为空) |
| leaderCommit | Leader 的 committedIndex |
Follower 的处理逻辑:
1. 如果 args.term < currentTerm → 拒绝(Leader 过期)
2. 如果 args.term >= currentTerm → 更新 currentTerm,降级为 Follower(如果之前是 Candidate)
3. 检查日志匹配:
   - 如果 prevLogIndex 位置没有日志,或该位置的 term != prevLogTerm → 拒绝(日志不一致)
   - 如果匹配 → 追加 entries,删除冲突的后续条目
4. 更新 committedIndex = min(leaderCommit, 最后一条新条目的 index)
5. 返回成功
5.3 日志一致性保证
Raft 通过 Log Matching Property(日志匹配特性)保证日志一致性:
如果两个节点在同一个 index 位置的日志条目有相同的 term,那么它们在该位置之前的所有日志条目都完全相同。
这个特性的推导过程:
- Leader 在每个 index 位置最多创建一条日志条目(同一任期)
- AppendEntries 的一致性检查确保日志从 prevLogIndex 开始连续匹配
- 通过数学归纳法,可以证明所有前缀都一致
5.4 日志冲突处理
当 Follower 的日志与 Leader 不一致时,Leader 需要找到最后的共同点,然后覆盖 Follower 的冲突部分。
Raft 的做法是Leader 强制覆盖 Follower(而不是反过来):
Leader 日志: [1,1] [1,2] [2,3] [2,4] [3,5] [3,6]
Follower 日志:[1,1] [1,2] [2,3] [4,4] [4,5]

Leader 发送 AppendEntries(prevLogIndex=3, prevLogTerm=2, entries=[(3,5),(3,6)])
→ Follower 检查 index=3 位置的 term=2,匹配!
→ Follower 删除 index=4,5 的旧条目,追加 (3,5) 和 (3,6)
→ 最终两者日志一致
为了优化冲突查找的效率(避免逐个回退),Raft 论文中建议 Follower 在拒绝时返回冲突信息:
拒绝时返回:
- conflictIndex: 冲突的起始索引
- conflictTerm: 该位置的 term

Leader 收到后可以直接跳到该 term 的第一个条目之前,大幅减少 RPC 轮次
图5
6. 提交规则:什么时候才算"确认"
6.1 基本提交规则
在 Raft 中,一条日志条目被"提交"(committed)需要满足:
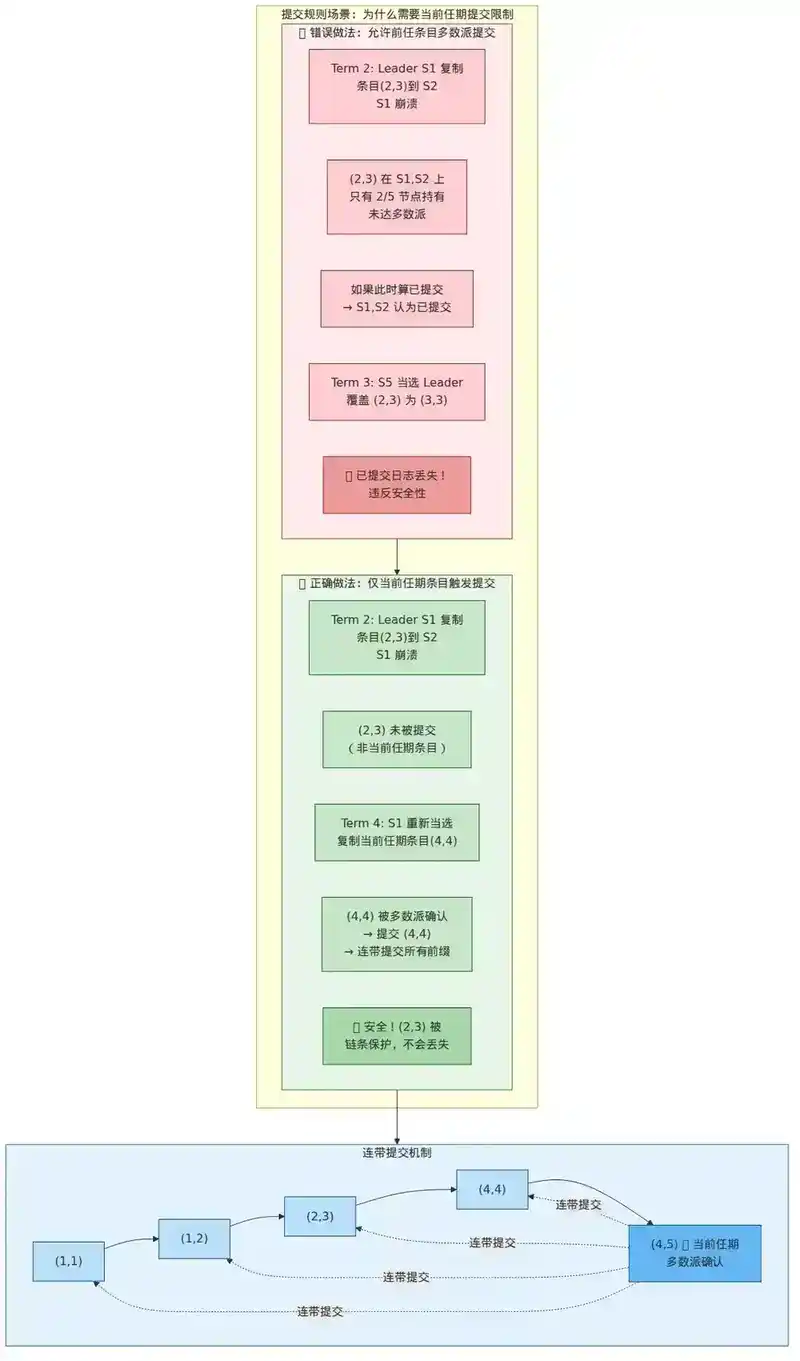
Leader 在它当前任期内创建的日志条目,只有当该条目被复制到多数派节点后,才会被提交。
这是 Raft 论文 §5.4.2 中明确的安全约束。这个规则看似简单,但背后有深刻的原因——如果不加这个限制,就会出现已提交日志被覆盖的问题。
6.2 为什么不能"前任期的条目也算提交"
考虑以下场景(Raft 论文 Figure 8):
时序:S1 是 Leader(Term 2),S5 是 Leader(Term 3),S1 是 Leader(Term 4)

初始状态(所有节点):
S1-S5: [1,1] [1,2]

1. Term 2: S1(Leader) 向 S2 复制了 index=3 的条目 (2,3),但 S1 崩溃
   状态:S1,S2: [1,1][1,2][2,3]  |  S3,S4,S5: [1,1][1,2]

2. Term 3: S5 当选 Leader,向 S3,S4 复制了 index=3 的条目 (3,3),
   但此时(2,3)只在 S1,S2 上,(3,3)只在 S3,S4,S5 上,都没达到多数派
   S5 崩溃
   状态:S1,S2: [1,1][1,2][2,3]  |  S3,S4,S5: [1,1][1,2][3,3]

3. Term 4: S1 再次当选 Leader(它的日志比 S3,S4,S5 更新,term 2 > term 1? 不对...)
其实这个场景更关键的问题在于:如果 S1 作为 Term 4 的 Leader,它能通过复制当前任期的条目(4,4)来间接提交旧的(2,3)吗?
答案是:不能直接算提交。因为(2,3)是 Term 2 的条目,Raft 规定只有当前任期的条目被多数派确认后,才能连带提交之前的条目。如果允许"只要前任条目被多数派持有就提交",那么:
假设在 Term 2,S1 复制了 (2,3) 到 S2,然后 S1 崩溃
如果此时就算 (2,3) 已提交 → S1 和 S2 认为已提交
但 S5 当选 Term 3 Leader 后,覆盖了 (2,3) → 已提交的日志丢失!
6.3 提交的间接传播
Raft 中,日志的提交是连带的:
Leader 日志: [1,1] [1,2] [2,3] [4,4] [4,5]
                                        ↑
                            当前任期条目,被多数派复制
                            → 提交 (4,5)
                            → 连带提交 (4,4)、(2,3)、(1,2)、(1,1)
因为 Log Matching Property 保证:如果 index=5 的条目被提交,那么 index=1-4 的条目也一定在所有持有该日志的节点上一致。
图6
7. 脑裂防护:一个集群不能有两个 Leader
7.1 脑裂是怎么发生的
脑裂(Split-Brain)指分布式集群中出现了两个或多个节点同时认为自己是 Leader 的情况。
在 Raft 中,脑裂可能由以下原因触发:
- 网络分区:集群被物理分割成两个或多个无法通信的子集
- Leader 假死:老 Leader 因为 GC 停顿或网络延迟,短暂的"消失"后又"复活"
- 时钟偏移:不同节点的时钟差异导致超时判断不一致
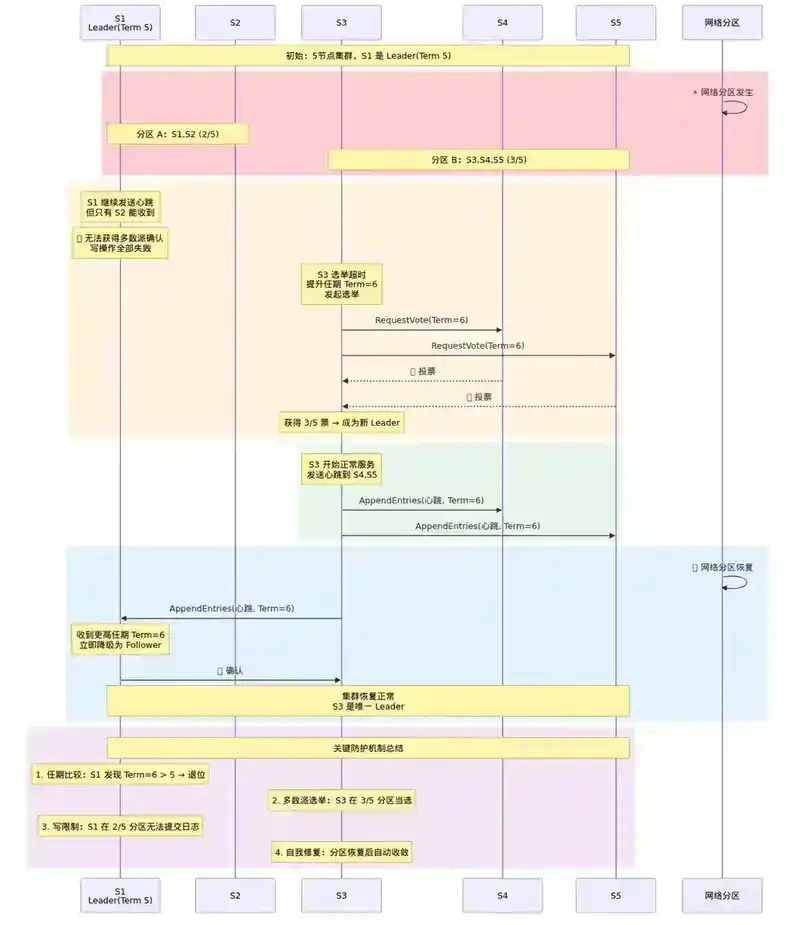
7.2 Raft 的脑裂防护机制
Raft 通过多层机制联合防止脑裂造成数据损坏:
第一层:任期机制
每个 RPC 都携带任期号。如果两个节点同时声称自己是 Leader 且任期不同,任期低的那个必须退位。
场景:网络分区导致 S1 和 S3 同时成为 Leader

S1(Leader, Term 5) ←→ S2 ←→ 网络隔离 ←→ S3(Leader, Term 5) ←→ S4 ←→ S5

问题:S1 和 S3 在同一个任期不可能同时当选!
→ 如果 S1 在 Term 5 当选,S3 必须获得更高的 Term 才能当选
→ S3 当选 Leader 后,S1 收到 S3 的 AppendEntries(term=6),立即降级
第二层:选举限制
Candidate 必须获得多数派的投票才能成为 Leader。在 5 节点集群中,至少需要 3 票。如果网络分区将集群分成 3+2,那么:
- 3 节点分区可以选出 Leader
- 2 节点分区无法选出 Leader(永远达不到多数派)
第三层:读写限制
Leader 在写入日志时,必须将日志条目复制到多数派节点才能提交。在 5 节点集群中,如果 Leader 确实在 3 节点分区中,它可以正常写入;如果它在 2 节点分区中,它虽然当选了 Leader(理论上不可能,但考虑极端情况),也无法完成任何写操作。
第四层:客户端请求的防护
客户端请求通常携带当前请求的预期状态。如果老 Leader 在返回客户端后网络才恢复,客户端的后续请求可能已经路由到新 Leader:
客户端 → 老 Leader S1: "写入 x=5"
S1 返回成功(但实际未提交,因为网络分区)
客户端 → 新 Leader S3: "读取 x" → 返回旧值

→ 客户端感知到不一致,需要重试
7.3 常见的脑裂保护实现
在生产系统中,除了 Raft 自身的机制,通常还会使用额外的防护手段:
| 手段 | 说明 |
|---|---|
| Fencing Token | 每次 Leader 变更时分配一个递增的 token,写请求携带 token,存储层拒绝过期 token 的写入 |
| Lease 机制 | Leader 获得一个有时限的租约,在租约内可以读取,过期后自动失效 |
| Quorum 读写 | 读操作也走多数派确认,避免读到过期 Leader 的脏数据(Raft 的 linearizable read) |
图7
8. 成员变更:动态增删节点
8.1 为什么成员变更是难点
在 Raft 集群运行期间增删节点,如果处理不当,可能导致两个不同的多数派同时存在:
初始:5 个节点 S1-S5,多数派 = 3
新增:S6, S7,多数派 = 4

如果 S1-S5 还在用旧配置(多数派 = 3),S1-S7 用新配置(多数派 = 4):
→ S1+S2+S3(3/5)以为自己构成多数派
→ S3+S4+S5+S6(4/7)也以为自己构成多数派
→ 两个"多数派"可以各自选出不同的 Leader → 脑裂!
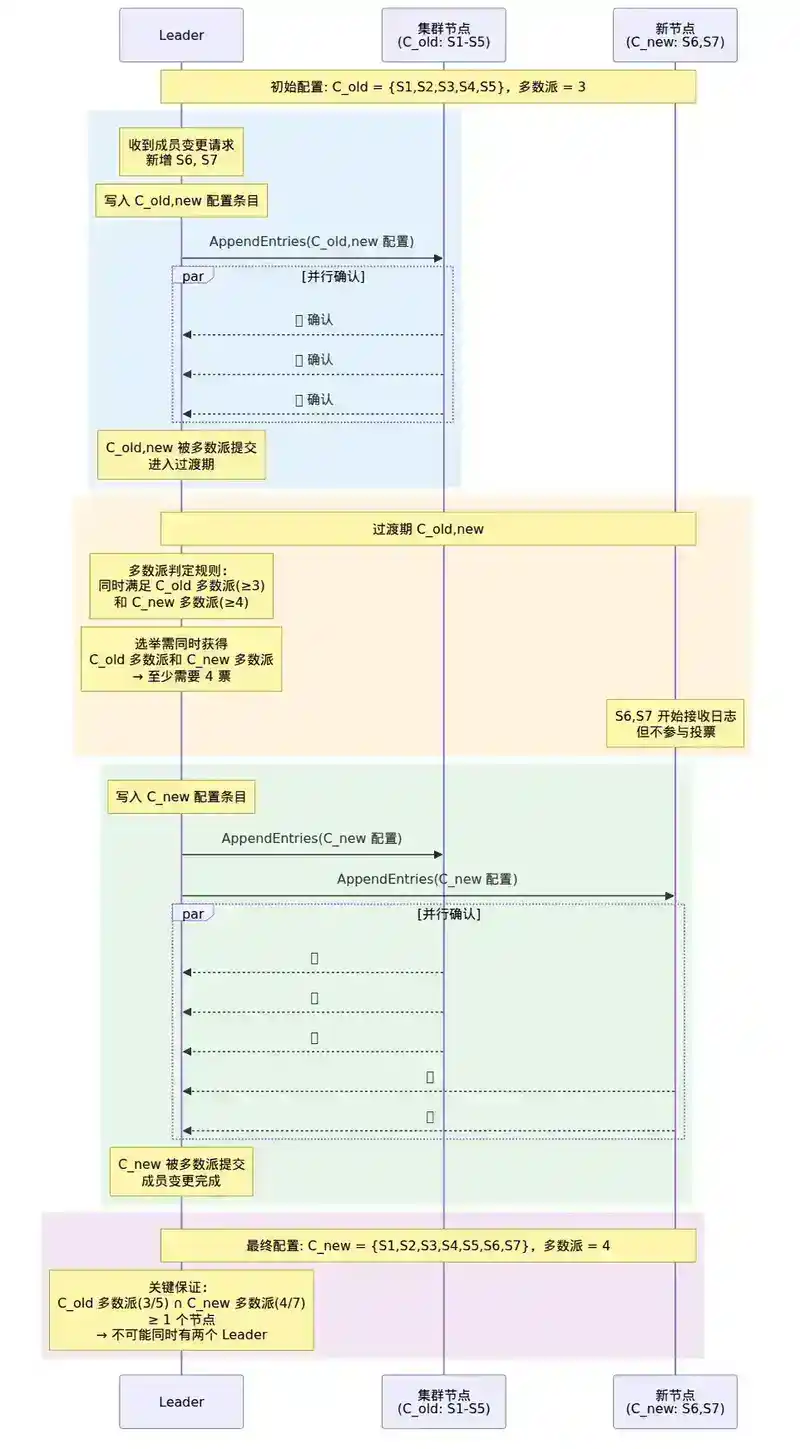
8.2 Joint Consensus(联合共识)
Raft 使用两阶段联合共识来安全地处理成员变更:
阶段 1:C_old,new(过渡配置)
- 多数派判定需要同时满足 C_old 和 C_new 的多数派
- Leader 写入 C_old,new 条目,一旦提交,进入过渡期

阶段 2:C_new(新配置)
- Leader 写入 C_new 条目,一旦提交,变更完成
- 之后只用 C_new 判定多数派

关键保证:C_old 和 C_new 的多数派一定有交集
→ 因此在过渡期,任何时刻最多只有一个 Leader
示例:5 个节点 → 新增 2 个节点
C_old = {S1, S2, S3, S4, S5} 多数派 = 3 C_new = {S1, S2, S3, S4, S5, S6, S7} 多数派 = 4
过渡期 C_old,new:
- 对于 C_old 的多数派判定:需要 ≥ 3 票
- 对于 C_new 的多数派判定:需要 ≥ 4 票
- 选举需要同时满足两者 → 至少需要 4 票(C_old 的 3 票 + C_new 的 4 票,取交集 → 至少 C_old 的多数派中有节点也在 C_new 的多数派中)
简化理解:过渡期需要 C_old 多数派(3/5)和 C_new 多数派(4/7) → 两个多数派的交集至少是 1 个节点 → 不可能有第二个 Leader 同时满足两个多数派
> **图8**
8.3 单节点变更(Single-Server Change)
在实际实现中,很多系统(如 etcd)使用单节点变更来进一步简化:
- 每次只增或删一个节点
- 单节点变更时,新旧配置的多数派天然有交集,不需要联合共识
- 例如:5→6 节点,旧多数派=3,新多数派=4,交集 ≥ 2
9. 生产实践与常见陷阱
9.1 常见实现
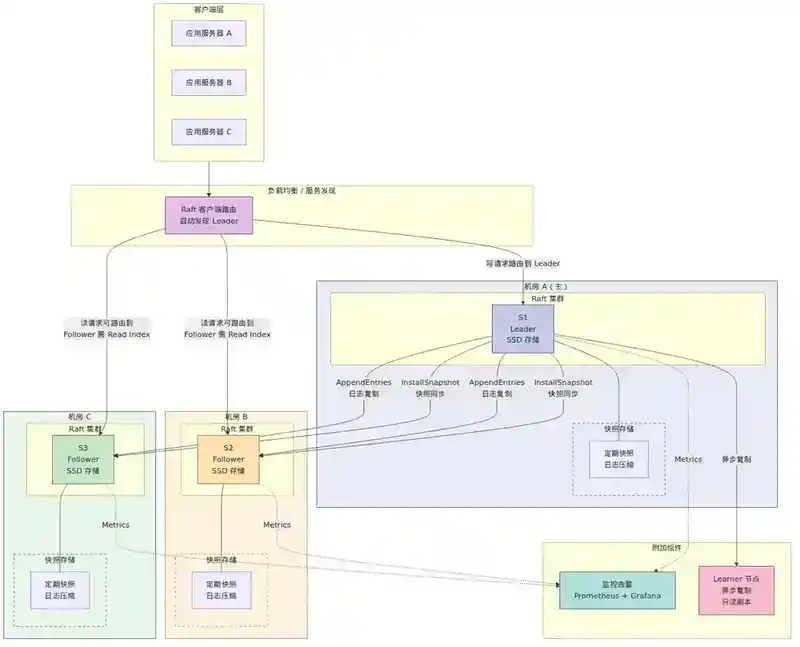
Raft 在工业界有大量成熟实现,最知名的包括:
| 实现 | 语言 | 特点 |
|---|---|---|
| etcd | Go | Kubernetes 的核心依赖,久经考验 |
| TiKV | Rust | PingCAP 的分布式 KV 引擎,支持 Raft Learner |
| Consul | Go | HashiCorp 的服务发现,Raft + Gossip |
| SOFAJRaft | Java | 蚂蚁开源的 Java 实现,阿里系广泛使用 |
| braft | C++ | 百度开源的工业级实现 |
9.2 常见陷阱
陷阱 1:Read Index 与线性读
Raft 的 Leader 不能直接返回本地状态机数据,因为 Leader 可能已经过期但还没发现自己不再是 Leader。正确的做法是Read Index:
1. Leader 记录当前的 committedIndex
2. 向多数派发送心跳确认自己仍是 Leader
3. 等待状态机 apply 到 committedIndex
4. 返回结果
如果不做这个确认,可能出现:客户端从老 Leader 读到旧数据(新 Leader 已经提交了更新)。
陷阱 2:日志无限增长
如果不做日志压缩,Raft 日志会无限增长。解决方案是快照(Snapshot):
- Leader 定期将状态机快照和快照对应的最后日志索引发送给 Follower
- Follower 收到快照后,丢弃快照之前的所有日志
- 新加入的节点直接从 Leader 接收快照,跳过日志回放
陷阱 3:批量与 Pipeline
单个 RPC 一条日志效率太低。生产实现通常:
- 批量发送:多个日志条目打包在一个 AppendEntries 中
- Pipeline:不等前一个 RPC 确认就发送下一个(类似 TCP 滑动窗口)
- 异步 Apply:日志提交和状态机 apply 解耦
陷阱 4:PreVote 防止无效选举
网络分区恢复后,被隔离的节点可能因为任期落后而以高任期发起选举,导致正常工作的 Leader 被迫退位。PreVote 机制在正式选举前先做一轮预投票:
PreVote 阶段:
- Candidate 发送 PreVote RPC(不带任期递增)
- 只有获得多数派 PreVote 才进入正式选举(任期递增)
- 被隔离的节点无法获得多数派 PreVote → 不会发起无效选举
陷阱 5:磁盘写入延迟
Raft 的持久化状态(currentTerm、votedFor、log[ ])必须在响应 RPC 之前写入磁盘。如果磁盘写入慢,整个 Raft 集群的性能都会受影响。生产环境通常要求:
- 使用 SSD 或 NVMe
- 将 Raft 日志单独放在低延迟磁盘上
- 批量写入减少 fsync 次数(但需要权衡安全性)
图9
10. Raft vs Paxos:为什么要有 Raft
10.1 对比总览
| 维度 | Raft | Paxos (Multi-Paxos) |
|---|---|---|
| 可理解性 | 高,问题分解清晰 | 低,理论与实践差距大 |
| Leader 选举 | 随机超时,任期递增 | 需要额外的 Leader 选举协议 |
| 日志复制 | Leader 驱动,单向 | Basic Paxos 需要两阶段 |
| 成员变更 | Joint Consensus | 需要额外设计 |
| 工程实现 | 标准化,生态丰富 | 每个实现都有差异 |
| 性能 | 略低(单 Leader 瓶颈) | 理论上可并行,实践中也常用单 Leader |
10.2 为什么 Raft 在实际中被广泛采用
- 教学友好:Raft 论文比 Paxos 论文容易理解一个数量级
- 实现标准化:Raft 的每个模块有明确的接口和状态,降低了实现出错的概率
- 验证工具:Raft 论文使用 TLA+ 进行了形式化验证,规范明确
- 生态成熟:etcd、TiKV 等大规模验证过的实现可直接参考
10.3 Raft 的局限性
- 单 Leader 瓶颈:所有写操作必须经过 Leader,吞吐量受限于单节点
- 无法跨地域优化:Leader 固定在一个位置,跨地域的 Follower 延迟高
- 只保证多数派:少数派节点可能落后,不适合强一致性读
11. 面试问答
以下问题从面试官视角出发,考察对 Raft 的深层理解而非简单记忆。这些问题不基于文档内容复述,而是需要综合思考。
Q1:Raft 中为什么要用随机选举超时而不是固定超时?如果极端情况下两个节点的随机超时恰好一样,会发生什么?
参考答案: 随机超时的核心目的是避免选举活锁——如果所有节点用相同的超时时间,它们会同步超时、同步发起选举、同步投票给自己,永远无法产生多数派。即使两个节点随机出相同的超时(概率极低),Raft 也能处理:它们会在同一任期发起选举,投票可能被均分导致分裂投票,然后各自以新的随机超时重试,最终其中一个会率先超时。Raft 的活性(Liveness)保证并不要求每次选举都成功,只要求最终能选出 Leader。
Q2:为什么 Raft 的 Leader 只能追加日志,不能修改或删除已存在的日志?这个设计约束带来了什么好处?
参考答案: 这是 Raft 保证日志一致性的核心设计。如果 Leader 可以修改已存在的日志,就需要额外的协调机制来保证所有节点上的日志都正确更新,复杂度会急剧上升。只追加不修改的好处:1)Log Matching Property 自动成立——相同 index+term 的条目必定内容相同;2)冲突检测简单——只需比较 prevLogTerm 和 prevLogIndex;3)Follower 的恢复逻辑极度简化——找到最后一致点,删除后面的再追加即可。代价是错误写入的日志条目需要新条目覆盖,但这在 Raft 的应用模型中不是问题。
Q3:考虑一个场景:5 节点集群,Leader 在 Term 3 写入了一条日志到 index=10,复制到了自己和 S2,然后 Leader 崩溃。S3 当选 Term 4 的 Leader,它没有这条日志。S3 在 index=10 写入了自己的日志并复制到多数派。当 S1 恢复后,它的 index=10 的日志(Term 3)会被覆盖吗?这对已提交的日志意味着什么?
参考答案: S1 的 index=10 日志(Term 3)会被覆盖。因为 S3 是 Term 4 的合法 Leader,它获得了多数派投票,说明 S1 上的 Term 3 日志从未被提交(如果被提交了,S3 的日志不可能比 S1 旧,无法当选)。Raft 的选举限制保证了这一点:S3 能当选意味着它的日志至少和多数派一样新,而 S1 的 Term 3 日志只复制到了 S1 和 S2(2/5,不是多数派),所以 S3 不包含它。恢复后 S1 收到 S3 的 AppendEntries,发现 index=10 的 term 不匹配,会删除自己的冲突条目并同步 S3 的日志。这个场景体现了 Raft 的安全性:只有被多数派确认的日志才是安全的,没达到多数派的日志随时可能被覆盖。
Q4:Raft 论文 §5.4.2 的限制——"Leader 只能提交当前任期的日志条目"——这个规则的存在是为了解决什么问题?如果去掉这个限制,请构造一个具体的反例。
参考答案: 这个规则防止已提交日志被覆盖。反例(Raft 论文 Figure 8):5 节点集群,初始所有日志为空。Term 2 时 S1 当选 Leader,复制条目 (2,3) 到 S1 和 S2 后崩溃。(2,3) 只在 2 个节点上,不是多数派。Term 3 时 S5 当选 Leader,写入 (3,3) 到 index=3,复制到 S3、S4、S5。Term 4 时 S1 再次当选(S1 有 (2,3),S3/S4/S5 有 (3,3),S1 的日志更新因为 Term 2 > Term 1),S1 将 (2,3) 复制到 S3,此时 (2,3) 在 S1、S2、S3 上(多数派)。如果允许"前任期条目被多数派持有就提交",(2,3) 就被提交了。然后 S1 崩溃。Term 5 时 S5 可以当选(S5 有 (3,3) 在 index=3,Term 3 > Term 2,S5 的日志不比 S1 旧),S5 会覆盖 index=3 的 (2,3) 为 (3,3)。但 (2,3) 已被提交!矛盾。所以 Raft 规定 S1 在 Term 4 不能直接提交 (2,3),必须等当前任期的一条新日志被多数派复制后,才能连带提交。
Q5:在 Raft 集群中,如果 Leader 因为 GC 停顿导致心跳超时,Follower 发起选举选出了新 Leader。当老 Leader 的 GC 恢复后,它仍然认为自己是 Leader 并尝试写入。Raft 是如何防止这种情况导致数据不一致的?如果读写请求走的是老 Leader,客户端会看到什么?
参考答案: 多层防护:1)任期机制——老 Leader 发送 AppendEntries 时携带旧任期号,新 Leader 和 Follower 的任期更高,收到后返回 term > currentTerm 拒绝,老 Leader 发现更高任期后立即降级为 Follower。2)提交规则——即使老 Leader 在降级前发送了写入,它也无法获得多数派确认(因为多数派节点已经在新任期),写入永远不会被提交。3)客户端视角——如果客户端向老 Leader 发起写入,老 Leader 在尝试复制日志时会发现无法获得多数派确认(或收到任期拒绝),返回错误给客户端。客户端需要重试到新 Leader。对于读请求,使用 Raft 的 linearizable read(Read Index),老 Leader 在确认自己仍是 Leader 时(需要向多数派发心跳)就会发现自己已过期,拒绝读请求返回重定向。
Q6:PreVote 机制解决了什么问题?它和标准 Raft 选举的区别是什么?为什么 etcd 默认启用了 PreVote?
参考答案: PreVote 解决的是网络分区恢复后的无效选举风暴。场景:一个节点被网络隔离,它的任期不断递增(因为选举超时),当网络恢复后,它以一个非常高的任期发起 RequestVote,导致正常工作的 Leader 收到更高任期后被迫退位——整个集群发生不必要的 Leader 切换。PreVote 的区别:在正式递增任期前,先发一轮 PreVote RPC(不递增任期),只有获得多数派 PreVote 才进入正式选举。被隔离的节点无法获得多数派 PreVote,因此不会递增任期干扰集群。etcd 启用 PreVote 是因为在 Kubernetes 等大规模集群中,网络抖动频繁,无效选举会严重影响集群稳定性。
Q7:解释 Raft 的 Linearizable Read(线性读)实现。如果 Leader 刚当选,committedIndex 还没更新,它能否直接返回本地状态机数据?
参考答案: 不能。Leader 刚当选时,committedIndex 可能还没更新到最新(前任 Leader 可能已提交了 Leader 不知道的日志),且 Leader 本身可能已经过期(如 Q5 所述)。正确的 Linearizable Read 流程:1)Leader 记录当前的 committedIndex;2)向多数派发送心跳确认自己仍是 Leader(防止读到过期 Leader 的脏数据);3)等待状态机 apply 到 committedIndex(确保状态机包含所有已提交的日志);4)返回结果。这意味着读操作也需要网络往返——Raft 的读操作不是免费的。优化手段包括:Lease Read(租约内跳过心跳确认)、Follower Read(需要特殊处理)。
Q8:如果 Raft 集群的 Leader 持续收到大量写请求,但 Follower 的磁盘写入很慢,会发生什么?这会导致什么连锁反应?如何解决?
参考答案: 连锁反应:1)Leader 的 AppendEntries 发送给慢 Follower 后,该 Follower 响应延迟高;2)Leader 需要等待多数派确认才能提交,如果多数派中有慢节点,整个集群的提交延迟会增加;3)Leader 的日志持续增长,因为已提交但未 apply 的日志堆积;4)如果慢 Follower 的日志落后太多,后续追赶时需要传输大量日志,进一步加剧延迟。解决方案:1)使用 Pipeline 和批量发送,不等慢节点响应就发下一个 batch;2)对慢 Follower 做降级或摘除(需要成员变更);3)Leader 维护 committedIndex 时只等待多数派中最快的多数派(而非等待所有节点);4)硬件层面保证 Follower 使用相同或相近的磁盘性能;5)定期 Snapshot 减少日志传输量。
Q9:在 Raft 中,为什么 Leader 不能直接删除 Follower 上冲突的日志,而是通过 AppendEntries 的一致性检查来间接覆盖?这种设计有什么深层考虑?
参考答案: 这是 Raft 最小化 Leader 权限的设计哲学。如果 Leader 可以直接删除 Follower 的日志,Leader 的错误或恶意行为会导致 Follower 数据丢失。Raft 的设计是:Leader 只提供"正确"的日志,由 Follower 自己判断并删除冲突部分。具体来说:1)Follower 收到 AppendEntries 后,根据 prevLogIndex/prevLogTerm 找到最后一致点;2)Follower 自己删除冲突的后续条目;3)然后追加 Leader 的 entries。这个设计的好处是:Follower 始终保留对自己日志的控制权,即使 Leader 出现 bug 或网络问题导致 AppendEntries 携带错误的 prevLogIndex,Follower 也能通过一致性检查拒绝,不会丢失数据。
Q10:一个 5 节点的 Raft 集群,如果 3 个 Follower 同时故障(只剩 Leader 和 1 个 Follower),集群还能正常工作吗?读写请求会怎样?如果这 3 个节点后来恢复了,集群会自动恢复吗?
参考答案: 只剩 2 个节点(5 节点集群,多数派 = 3):不能正常工作。写请求:Leader 无法将日志复制到多数派(需要 3 个节点),日志永远无法提交,所有写操作会超时或阻塞。读请求:如果使用 Linearizable Read,Leader 无法向多数派确认自己仍是 Leader,读也会失败。如果使用 Lease Read 且租约未过期,可能还能读到旧数据。3 个节点恢复后:集群自动恢复。恢复的节点会收到 Leader 的 AppendEntries(心跳),同步日志后重新加入集群,多数派恢复为 3,读写恢复正常。但如果 Leader 在这 3 个节点故障期间也崩溃了(比如只剩 2 个节点且 Leader 也挂了),剩下的 1 个节点无法选出新 Leader,集群永久不可用——这就是为什么 Raft 需要多数派节点存活。
Q11:在实际系统中,Raft 的持久化状态(currentTerm、votedFor、log)必须在响应 RPC 之前 fsync 到磁盘。如果某次 fsync 失败(比如磁盘满),节点应该怎么做?能不能忽略这个错误继续运行?
参考答案: 绝对不能忽略。如果节点在未持久化 votedFor 的情况下响应了 RequestVote,它可能在同一个任期投票给两个不同的 Candidate(第一次投票后崩溃,重启后忘记投过票,又投了一次),导致两个 Candidate 同时获得多数票——脑裂。如果日志未持久化就响应 AppendEntries 返回成功,Leader 会认为该日志已复制,但该节点重启后丢失了这些日志,Leader 崩溃后这些"已提交"的日志就永久丢失了。正确的做法:fsync 失败时,该节点应该立即 panic/crash,不要继续参与 Raft 协议。重启后从持久化的状态恢复,通过日志追赶重新同步。etcd 的 WAL 实现就是这样的——WAL 写入失败直接 panic。
问答模块不计入 40 分钟阅读时间,建议花 30 分钟独立思考和验证。