阅读时间:约 40-45 分钟 适用人群:高级 Java 工程师、技术专家、应用架构师 前置知识:HTTP 协议基础、微服务架构基本概念
一、引言:一道面试题引出的架构抉择
"你们公司内部服务之间用的是什么通信协议?为什么选它而不是另外两种?"
这是架构师面试中几乎必问的一道题。它考察的不是"会不会用",而是"为什么这么选"——这背后是对 API 风格、契约模型、性能特征和团队协作模式的综合理解。
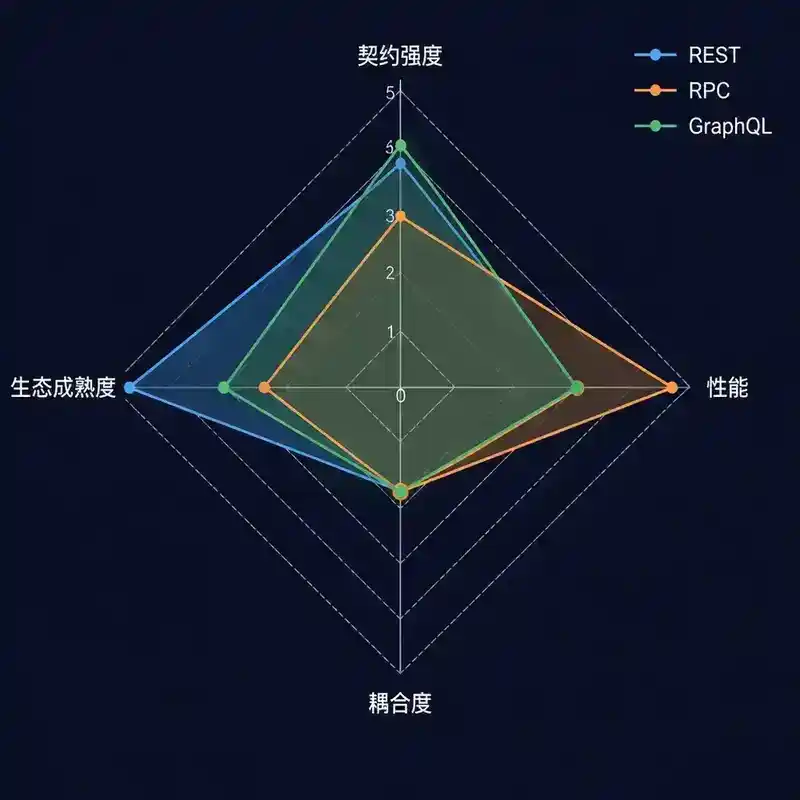
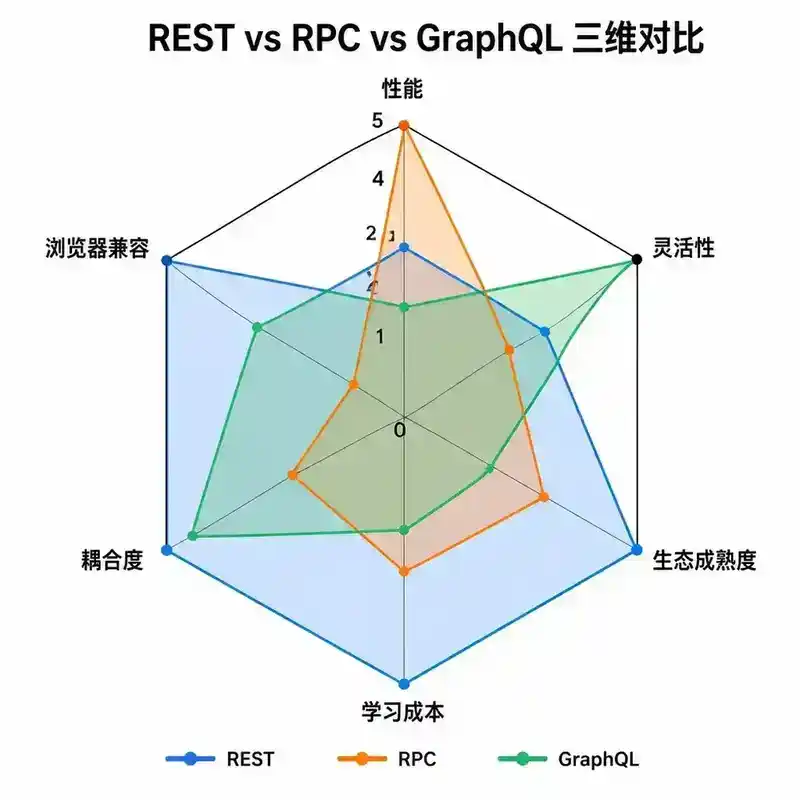
REST、RPC、GraphQL 是当今分布式系统中三种主流的 API 风格。它们不是简单的"好与坏"之分,而是代表了三种不同的设计哲学:面向资源、面向过程和面向查询。本文将从契约定义、性能特性、耦合度分析和生态差异四个维度,系统性地剖析三者的选型逻辑。
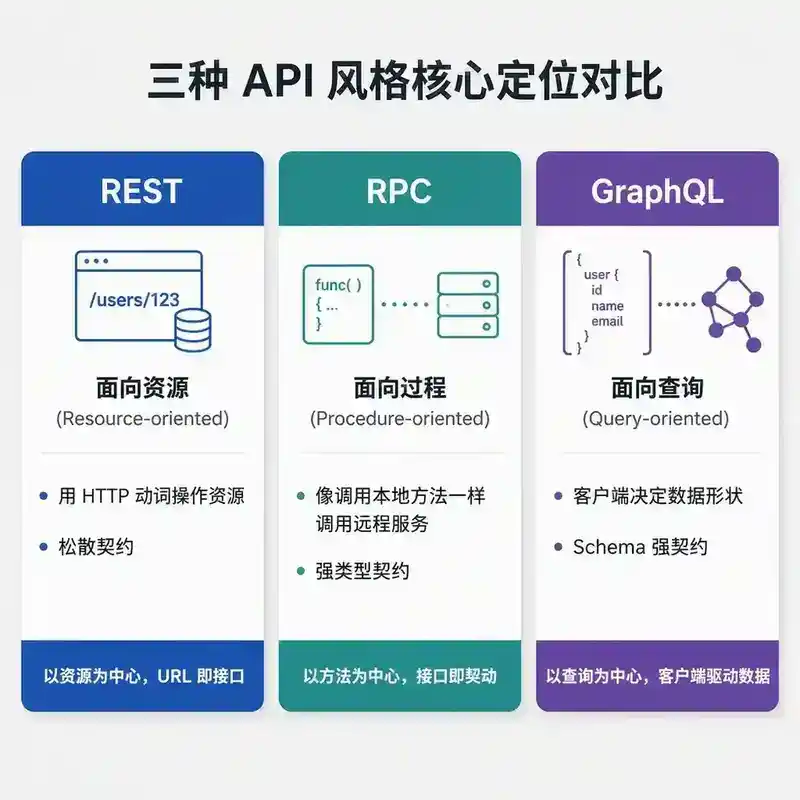
二、REST:资源导向的架构风格
2.1 REST 不是协议,是约束
很多人把 REST 等同于"用 HTTP + JSON",这是对 REST 最大的误解。Roy Fielding 在 2000 年的博士论文中定义了 REST 的六大约束:
| 约束 | 含义 | 违反后果 |
|---|---|---|
| 客户端-服务器 | 关注点分离,客户端不关心数据存储,服务器不关心 UI | 前后端耦合,无法独立演进 |
| 无状态 | 每个请求包含所有必要信息,服务器不保存客户端上下文 | 需要额外传递 token/session 信息 |
| 可缓存 | 响应必须显式标记是否可缓存 | 重复请求浪费带宽,无法利用缓存加速 |
| 分层系统 | 客户端不知道连接的是代理还是最终服务器 | 无法插入中间层(网关、负载均衡) |
| 统一接口 | 资源由 URI 标识,通过表述操作,消息自描述 | 接口风格不一致,学习成本高 |
| 按需代码(可选) | 服务器可向客户端发送可执行代码(如 JavaScript) | 无法实现富客户端动态扩展 |
统一接口是其中最核心的约束,它又包含四个子约束:资源标识(URI)、通过表述操作资源、自描述消息、HATEOAS(超媒体作为应用状态引擎)。
2.2 Richardson 成熟度模型:你的 API 有多 REST?
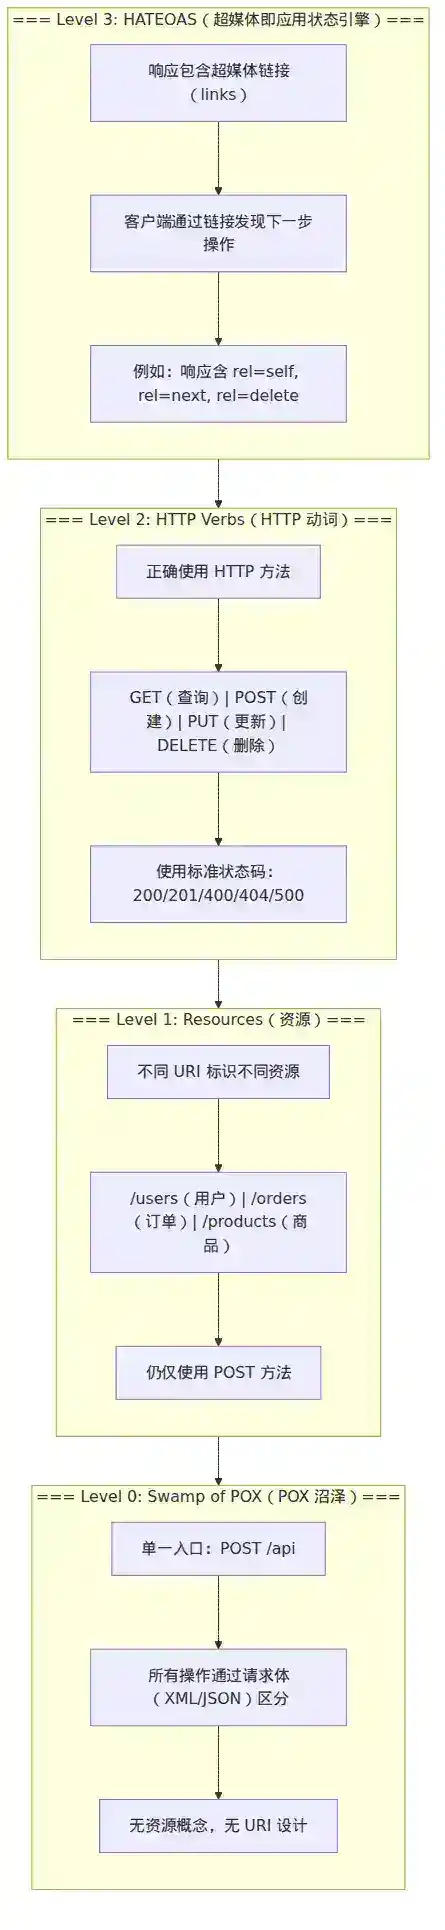
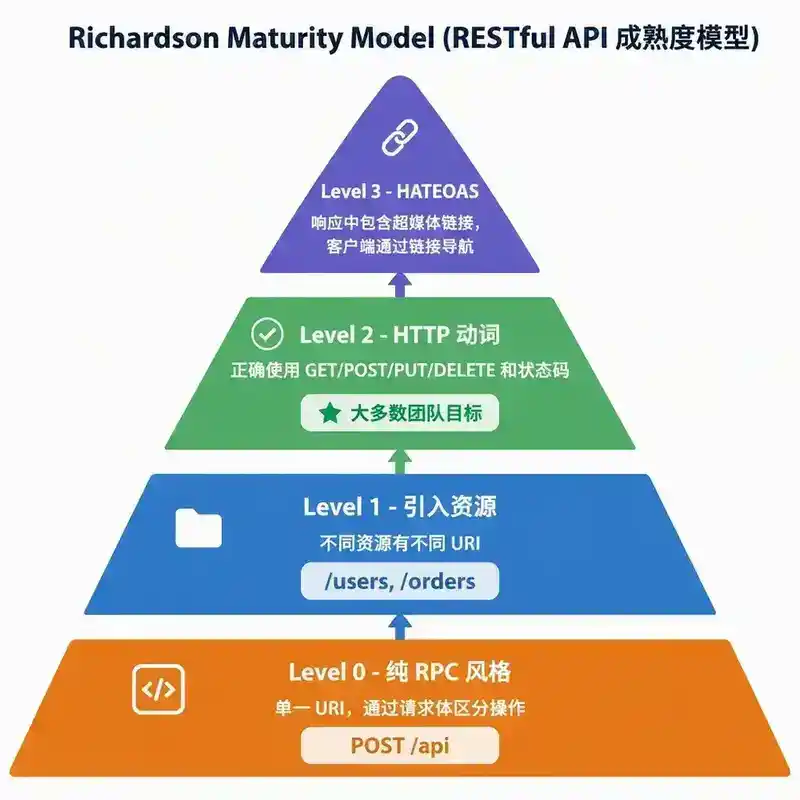
Leonard Richardson 提出的成熟度模型将 RESTful API 分为四个等级:
- Level 0:纯 RPC 风格,所有请求打到同一个 URI(如
/api),通过请求体区分操作。本质上就是 SOAP 或最原始的 HTTP RPC。 - Level 1:引入资源概念,不同资源有不同 URI(如
/users、/orders),但 HTTP 方法只用 POST。 - Level 2:正确使用 HTTP 动词(GET/POST/PUT/DELETE/PATCH)和状态码(200/201/400/404/500)。这是大多数团队声称"RESTful"实际达到的水平。
- Level 3:HATEOAS,响应中包含超媒体链接,客户端通过链接发现下一步可执行的操作。这是真正的 REST,但业界极少实现。
Level 0: POST /api { "method": "getUser", "id": 1 }
Level 1: POST /users/1
Level 2: GET /users/1 → 200 OK + JSON body
Level 3: GET /users/1 → 200 OK + JSON body + _links: { "orders": "/users/1/orders" }
生产实践:绝大多数团队将 Level 2 作为目标,Level 3 投入产出比太低。但这不意味着了解 HATEOAS 没有价值——它揭示了"客户端应该通过服务端返回的链接来导航"这一解耦思想。
2.3 RESTful API 设计实践
一个好的 RESTful API 设计,至少需要关注以下六个方面:
(1)资源命名
✅ 好的设计:
GET    /users              # 获取用户列表
GET    /users/{id}         # 获取单个用户
POST   /users              # 创建用户
PUT    /users/{id}         # 完整更新用户
PATCH  /users/{id}         # 部分更新用户
DELETE /users/{id}         # 删除用户

❌ 坏的设计:
GET    /getUser?id=1       # 动词出现在 URI 中
POST   /users/create       # 动作在 URI 而非 HTTP 方法
GET    /deleteUser?id=1    # GET 做非幂等操作
(2)版本控制
三种主流方式:
| 方式 | 示例 | 优点 | 缺点 |
|---|---|---|---|
| URI 版本 | /v1/users |
简单直观 | URI 污染,不同版本是不同资源 |
| Header 版本 | Accept: application/vnd.api+json;version=1 |
URI 干净 | 调试不便,缓存策略复杂 |
| 查询参数版本 | /users?version=1 |
实现简单 | 容易被忽略,语义不明确 |
生产建议:小团队用 URI 版本;中大型团队考虑 Header 版本以获得更好的 URI 稳定性。
(3)分页、过滤、排序
GET /users?page=2&size=20&sort=created_at,desc&filter=status:active
响应应包含分页元数据:
{
  "data": [...],
  "meta": {
    "page": 2, "size": 20, "total": 156, "total_pages": 8
  },
  "_links": {
    "self": "/users?page=2&size=20",
    "next": "/users?page=3&size=20",
    "prev": "/users?page=1&size=20"
  }
}
(4)错误处理
{
  "error": {
    "code": "INVALID_PARAMETER",
    "message": "email 格式不正确",
    "details": [
      {
        "field": "email",
        "reason": "must match pattern ^[\w.-]+@[\w.-]+\\.\w+$",
        "value": "user@"
      }
    ],
    "request_id": "req_a1b2c3d4"
  }
}
关键原则:错误信息要结构化、可追踪(request_id)、可排查(details)。
(5)超媒体链接(HATEOAS 的实用主义实现)
{
  "id": 42,
  "name": "张三",
  "email": "zhangsan@example.com",
  "_links": {
    "self": { "href": "/users/42" },
    "orders": { "href": "/users/42/orders" },
    "deactivate": { "href": "/users/42/deactivate", "method": "POST" }
  }
}
即使不完全实现 HATEOAS,在响应中嵌入关联资源的链接也是一种良好的实践。
(6)幂等性设计
| HTTP 方法 | 幂等性 | 说明 |
|---|---|---|
| GET | ✅ 幂等 | 多次请求结果相同,不应有副作用 |
| PUT | ✅ 幂等 | 多次请求结果相同(全量替换) |
| DELETE | ✅ 幂等 | 多次删除结果相同(资源不存在不算错误) |
| POST | ❌ 不幂等 | 每次请求可能创建新资源 |
| PATCH | ⚠️ 可设计为幂等 | 取决于具体实现 |
2.4 REST 的契约:OpenAPI / Swagger
REST 的契约定义工具经历了从 Swagger 2.0 到 OpenAPI 3.x 的演进。OpenAPI 规范定义了 API 的完整描述:路径、方法、参数、请求体、响应、认证方式等。
openapi: "3.0.0"
info:
  title: User Service API
  version: "1.0.0"
paths:
  /users/{id}:
    get:
      summary: 获取用户详情
      parameters:
        - name: id
          in: path
          required: true
          schema:
            type: integer
      responses:
        '200':
          description: 成功
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/User'
        '404':
          description: 用户不存在
OpenAPI 的价值:
- 代码生成:自动生成服务端接口骨架和客户端 SDK
- 文档驱动:Swagger UI 提供交互式 API 文档
- 契约测试:Provider 和 Consumer 可以基于同一份契约进行验证
- 网关集成:API 网关可以直接消费 OpenAPI 规范进行路由和校验
局限:
- OpenAPI 本质上是一个静态文档,无法保证运行时行为与文档一致
- 复杂的请求/响应模型在 OpenAPI 中表达困难
- 版本演进时的兼容性校验需要额外工具支持
三、RPC:面向过程的远程调用
3.1 RPC 的核心思想:让远程调用像本地调用
RPC(Remote Procedure Call)的核心愿景是调用透明性:开发者调用远程服务的方法,就像调用本地方法一样简单。这个愿景从 1970 年代的 RFC 707 开始,经历了 Sun RPC、DCE/RPC、CORBA、SOAP,到今天的 gRPC、Dubbo、Thrift。
RPC 框架的核心组件:
┌──────────────────────────────────────────────────┐
│                   Client                         │
│  Client.invoke() → Stub(Proxy) → Serialize       │
│                       ↓                          │
│               Network Transport                  │
│                       ↓                          │
│  Server.dispatch() ← Skeleton ← Deserialize      │
│  Server.invoke() → Result → Serialize            │
│                       ↓                          │
│               Network Transport                  │
│                       ↓                          │
│  Client ← Stub ← Deserialize ← Result            │
└──────────────────────────────────────────────────┘
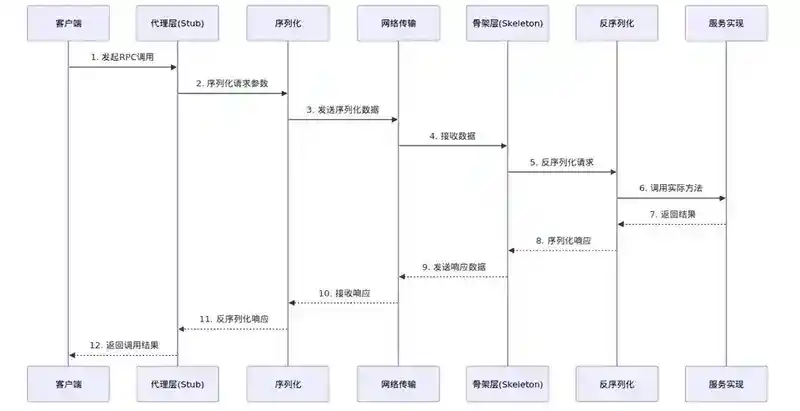
核心抽象层:
| 层次 | 职责 | 典型实现 |
|---|---|---|
| 代理层(Proxy/Stub) | 为调用方提供本地接口,屏蔽远程调用细节 | JDK 动态代理、Javassist、ByteBuddy |
| 序列化层 | 将对象转换为字节流 | Protobuf、Hessian2、JSON、Kryo、FST |
| 协议层 | 定义请求/响应格式(Header + Body) | HTTP/2、自定义 TCP 协议、Triple |
| 传输层 | 网络 I/O 和连接管理 | Netty、Mina |
| 路由层 | 服务发现、负载均衡、容错策略 | Nacos/ZooKeeper/Consul + 内置策略 |
3.2 gRPC 与 Protocol Buffers:现代 RPC 的标杆
gRPC 是 Google 开源的 RPC 框架,使用 Protocol Buffers(protobuf)作为接口定义语言和序列化协议。它是目前性能最优、生态最完善的 RPC 框架之一。
Proto 定义(契约):
syntax = "proto3";

package user.v1;

service UserService {
  rpc GetUser (GetUserRequest) returns (GetUserResponse);
  rpc ListUsers (ListUsersRequest) returns (stream User);  // 服务端流式
  rpc BatchUpdate (stream UpdateUserRequest) returns (stream UpdateUserResponse);  // 双向流式
}

message GetUserRequest {
  int64 id = 1;
}

message GetUserResponse {
  int64 id = 1;
  string name = 2;
  string email = 3;
  UserStatus status = 4;
}

enum UserStatus {
  USER_STATUS_UNSPECIFIED = 0;
  USER_STATUS_ACTIVE = 1;
  USER_STATUS_INACTIVE = 2;
}
gRPC 的核心优势:
1. 强类型契约 Proto 文件是编译期强类型的契约,编译器会检查字段类型、枚举值、服务定义。任何契约变更在编译阶段就能被发现,这是 REST 的 OpenAPI 文档做不到的。
2. 高性能序列化 Protobuf 使用变长编码(Varint)和字段编号(而非字段名),序列化后的体积远小于 JSON:
字段名 "user_id" 的值 12345:
JSON:{"user_id": 12345} → 18 字节
Protobuf:08 B9 60 → 3 字节
3. HTTP/2 多路复用 gRPC 基于 HTTP/2,天然支持多路复用、双向流式通信、头部压缩和服务端推送。
4. 四种调用模式
| 模式 | 客户端 | 服务端 | 典型场景 |
|---|---|---|---|
| 一元 RPC | 发送一个请求 | 返回一个响应 | 查询、更新 |
| 服务端流式 | 发送一个请求 | 返回多个响应 | 大文件下载、实时推送 |
| 客户端流式 | 发送多个请求 | 返回一个响应 | 大文件上传、批量处理 |
| 双向流式 | 发送多个请求 | 返回多个响应 | 实时聊天、协同编辑 |
gRPC 的局限:
- 浏览器支持有限:浏览器原生不支持 HTTP/2 trailers,需要 gRPC-Web 代理层
- 调试不便:二进制协议不可读,需要用 grpcurl 等专用工具
- 负载均衡复杂:HTTP/2 长连接导致传统四层负载均衡失效,需要客户端负载均衡或七层代理
- 学习成本:团队需要学习 Proto 语法和 gRPC 生态工具链
3.3 Dubbo:Java 生态的 RPC 王者
Dubbo 是阿里巴巴开源的高性能 RPC 框架,在 Java 技术栈中占据主导地位,尤其在中国互联网公司中广泛使用。
Dubbo 的核心架构(Dubbo 3.x):
┌──────────┐    ┌──────────────┐    ┌──────────┐
│ Consumer │    │  Registry    │    │ Provider │
│          │───→│  (Nacos/ZK)  │←───│          │
│          │    │              │    │          │
│          │───────→  RPC Call ──────→│          │
└──────────┘    └──────────────┘    └──────────┘
       ↓                                  ↓
┌──────────┐                       ┌──────────┐
│ Monitor  │←──────────────────────│          │
└──────────┘                       └──────────┘
Dubbo 的核心能力:
| 能力 | 说明 |
|---|---|
| 服务注册与发现 | 支持 Nacos、ZooKeeper、Consul、etcd 等多种注册中心 |
| 多协议支持 | dubbo://(TCP)、tri://(gRPC 兼容)、rest://(HTTP) |
| 多序列化 | Hessian2、Protobuf、JSON、Kryo、FST、Java 原生 |
| 集群容错 | Failover、Failfast、Failsafe、Failback、Forking、Broadcast |
| 负载均衡 | Random、RoundRobin、LeastActive、ConsistentHash、ShortestResponse |
| 服务治理 | 动态路由、条件路由、标签路由、权重调整、灰度发布 |
| 可观测性 | Metrics、Tracing、调用链集成 |
Dubbo 3.x 的重要演进:
- Triple 协议:基于 HTTP/2 的全新协议,兼容 gRPC,支持流式调用和 Reactive 编程模型
- 应用级服务发现:从接口级(IP:Port:Interface)升级到应用级(IP:Port:Application),大幅降低注册中心压力
- 云原生支持:支持 Kubernetes Proxyless Service Mesh,与 Istio 等控制面集成
Dubbo 接口定义(Java Interface 作为契约):
public interface UserService {
    User getUser(Long id);
    List<User> listUsers(ListUsersRequest request);
    Result<User> batchUpdate(List<UpdateUserRequest> requests);
}
这种契约方式的好处是零学习成本——对 Java 开发者来说,定义接口就是定义契约。但代价是语言绑定——接口定义与 Java 强耦合,跨语言调用需要额外工作。
3.4 RPC 的契约模型对比
| 契约方式 | 代表框架 | 契约定义 | 校验时机 | 跨语言 |
|---|---|---|---|---|
| IDL 编译 | gRPC、Thrift | .proto / .thrift 文件 | 编译期 | ✅ 原生支持 |
| 接口定义 | Dubbo | Java Interface | 编译期 | ⚠️ 需额外适配 |
| 代码生成 | Feign | Java Interface + 注解 | 编译期 | ❌ Java 绑定 |
四、GraphQL:查询驱动的数据获取
4.1 问题的起源:REST 的过度获取与欠获取
GraphQL 由 Facebook 在 2012 年内部开发,2015 年开源。它的诞生源于移动端的一个痛点:
场景:一个用户 Profile 页面需要展示用户信息、最近 3 篇文章的标题和粉丝数。
REST 方案:
1. GET /users/42          → 返回所有字段(包括不需要的 20 个字段)→ 过度获取
2. GET /users/42/posts?limit=3  → 返回文章所有字段(只需要标题)
3. GET /users/42/followers/count → 独立请求

// 三次 HTTP 请求,数据冗余,客户端需要聚合
GraphQL 方案: query { user(id: 42) { name avatar posts(limit: 3) { title } followerCount } }
// 一次请求,精确返回需要的数据,无冗余
这就是 GraphQL 的核心价值:**客户端决定需要什么数据,服务端精确返回**。

### 4.2 Schema-First 设计

GraphQL 是**强类型**的,一切从 Schema 定义开始:
# Schema Definition Language (SDL) — 这是 GraphQL 的"契约"
type User {
  id: ID!
  name: String!
  email: String!
  age: Int
  posts(limit: Int = 10): [Post!]!
  followerCount: Int!
}

type Post {
  id: ID!
  title: String!
  content: String!
  author: User!
  createdAt: String!
}

type Query {
  user(id: ID!): User
  users(page: Int, size: Int): [User!]!
  posts(filter: PostFilter): [Post!]!
}

type Mutation {
  createUser(input: CreateUserInput!): User!
  updateUser(id: ID!, input: UpdateUserInput!): User!
  deleteUser(id: ID!): Boolean!
}

type Subscription {
  userOnline(userId: ID!): Boolean!
}
Schema 是 GraphQL 的契约——它定义了:
- 有哪些类型、每个类型有哪些字段
- 字段的类型、是否可空(
!表示非空) - 有哪些查询(Query)、变更(Mutation)、订阅(Subscription)
- 参数的类型和默认值
4.3 Resolver 与执行模型
GraphQL 的查询执行通过 Resolver 函数 完成。每个字段对应一个 Resolver:
// 使用 Netflix DGS 框架(Java 生态的 GraphQL 实现)
@DgsComponent
public class UserDataFetcher {

    @DgsQuery
    public User user(@InputArgument Long id) {
        return userService.findById(id);
    }

    @DgsData(parentType = "User", field = "posts")
    public List<Post> posts(DgsDataFetchingEnvironment dfe) {
        User user = dfe.getSource();  // 获取父对象
        return postService.findByAuthorId(user.getId());
    }

    @DgsData(parentType = "User", field = "followerCount")
    public int followerCount(DgsDataFetchingEnvironment dfe) {
        User user = dfe.getSource();
        return followService.countFollowers(user.getId());
    }
}
GraphQL 的执行流程:
1. 解析查询 → AST
2. 验证查询(与 Schema 校验)
3. 执行查询(并发调用各字段的 Resolver)
4. 返回结果(精确匹配查询结构)
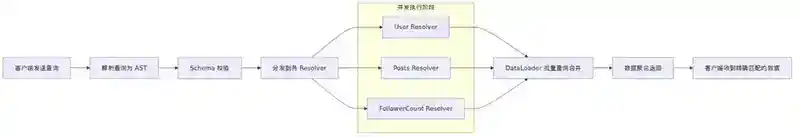
关键特性:GraphQL 的字段解析是并发执行的,每个字段的 Resolver 可以独立运行,天然适合数据聚合场景。
4.4 N+1 问题与 DataLoader
GraphQL 最大的性能陷阱是 N+1 查询问题:
query {
  users {     # 1 次查询,返回 N 个用户
    name
    posts {   # 每个用户查询 1 次 → N 次查询
      title
    }
  }
}
# 总计:1 + N 次数据库查询
解决方案:DataLoader(批处理 + 缓存)
@DgsDataLoader(name = "posts")
public class PostsDataLoader implements MappedBatchLoader<Long, List<Post>> {
    @Override
    public CompletionStage<Map<Long, List<Post>>> load(Set<Long> authorIds) {
        // 将 N 次查询合并为 1 次:SELECT * FROM posts WHERE author_id IN (...)
        List<Post> posts = postService.findByAuthorIds(new ArrayList<>(authorIds));
        return CompletableFuture.completedFuture(
            posts.stream().collect(Collectors.groupingBy(Post::getAuthorId))
        );
    }
}
DataLoader 不仅合并查询,还具有请求级别的缓存——同一请求中多次查询相同 ID 只会命中一次。
4.5 GraphQL 的契约:SDL 与 Introspection
GraphQL 的契约定义在 Schema 中,具有运行时自省能力:
# 查询 Schema 本身(Introspection)
{
  __schema {
    types {
      name
      fields {
        name
        type {
          name
          kind
        }
      }
    }
  }
}
这带来了一个强大特性:GraphQL Playground / GraphiQL 等工具可以自动生成交互式 API 文档,无需手动维护。
SDL 契约 vs OpenAPI 契约:
| 维度 | GraphQL SDL | OpenAPI (REST) |
|---|---|---|
| 定义方式 | 描述数据图 | 描述端点 |
| 类型系统 | 强制类型,编译期可校验 | 通过 JSON Schema 描述,运行时校验 |
| 工具链 | GraphQL Code Generator | OpenAPI Generator |
| 契约测试 | Schema 比对 | 契约测试框架(Pact、Spring Cloud Contract) |
| 运行时自省 | 原生支持 | 无标准支持 |
五、四维对比:契约、性能、耦合度、生态
5.1 契约维度
| 维度 | REST | RPC (gRPC) | RPC (Dubbo) | GraphQL |
|---|---|---|---|---|
| 契约定义方式 | OpenAPI/Swagger 文档 | .proto IDL | Java Interface | SDL Schema |
| 契约强制力 | 弱(文档可能过时) | 强(编译期校验) | 中(编译期校验,但接口可能不兼容) | 强(编译期 + 运行时校验) |
| 契约演化 | 灵活(宽松的 JSON) | 严格(字段编号不可变) | 灵活(依赖接口版本管理) | 中等(新增字段安全,删除需要废弃标记 @deprecated) |
| 向后兼容 | 天然友好(JSON 忽略未知字段) | 需要遵守 Proto 演化规则 | 需要接口版本管理 | 渐进式废弃 + 字段使用分析 |
| 代码生成 | OpenAPI Generator | protoc 编译器 | 无(接口即代码) | GraphQL Code Generator |
契约强度的权衡:
- REST 的契约最"松",给了团队最大的灵活性,但也最容易出现"文档与实现不一致"
- RPC 的契约最"紧",Proto 编译期校验避免了很多低级错误,但演化时需要更谨慎
- GraphQL 处于中间,Schema 作为强契约,但通过
@deprecated和字段使用分析提供了优雅的演化路径
5.2 性能维度
序列化性能对比(以传输 1000 个 User 对象为例):
| 序列化方式 | 体积(相对) | 序列化耗时(相对) | 反序列化耗时(相对) |
|---|---|---|---|
| Protobuf | 1x | 1x | 1x |
| Hessian2 | ~1.5x | ~1.2x | ~1.5x |
| JSON (Jackson) | ~3x | ~2x | ~3x |
| XML | ~8x | ~5x | ~6x |
注:以上为相对数量级对比,实际数值取决于具体数据结构和字段数量。Protobuf 在数值型字段和枚举上的优势尤为明显。
网络传输效率:
- gRPC:基于 HTTP/2,多路复用、头部压缩(HPACK),单连接承载大量并发请求
- Dubbo:自定义 TCP 协议,单连接复用,无需 HTTP 头部开销,网络效率最高
- REST:HTTP/1.1 每个请求一个连接(或 Keep-Alive 复用),HTTP 头部开销大(每次请求可能达 1KB+)
- GraphQL:通常基于 HTTP POST,单次请求可能包含大量字段,响应体积由查询决定
流式处理:
| 能力 | REST | gRPC | Dubbo | GraphQL |
|---|---|---|---|---|
| 请求-响应 | ✅ | ✅ | ✅ | ✅ |
| 服务端推送 | ❌(需 SSE/WebSocket) | ✅(原生) | ✅(Triple 协议) | ✅(Subscription) |
| 客户端流式 | ❌ | ✅ | ✅(Triple) | ❌ |
| 双向流式 | ❌ | ✅ | ✅(Triple) | ❌ |
5.3 耦合度维度
这是架构选型中最容易被忽略但最重要的维度之一。
数据耦合:
REST:客户端依赖服务端的资源模型
  Client → GET /users/42 → 收到完整 User 对象
  问题:服务端新增字段,客户端可能不需要但被迫接收

RPC:客户端依赖服务端的接口定义
  Client → userService.getUser(42) → 收到 User 对象
  问题:接口变更 → 客户端必须重新编译/升级

GraphQL:客户端定义数据需求,服务端适配
  Client → query { user(id: 42) { name, email } } → 只收到需要的字段
  优势:服务端新增字段不影响现有客户端
  问题:客户端查询可能过于复杂,服务端难以优化
技术耦合:
| 维度 | REST | gRPC | Dubbo | GraphQL |
|---|---|---|---|---|
| 语言绑定 | 无 | 弱(Proto 跨语言) | 强(Java 优先) | 无 |
| 框架绑定 | 无 | 中(gRPC 生态) | 强(Dubbo 生态) | 中(GraphQL 服务端框架) |
| 协议绑定 | HTTP | HTTP/2 | 自定义 TCP | HTTP |
| 工具链绑定 | 无 | 强(protoc) | 中(Dubbo Admin) | 中(GraphQL 工具链) |
团队耦合:
REST 的松散契约让前后端团队可以相对独立工作,但增加了沟通成本("这个字段是什么意思?")。RPC 的强契约降低了沟通成本,但要求前后端协同变更。GraphQL 通过 Schema 充当了"合约",前端的字段使用分析让后端了解哪些字段被哪些客户端使用,从而做出更安全的演化决策。
5.4 生态差异
| 维度 | REST | gRPC | Dubbo | GraphQL |
|---|---|---|---|---|
| 网关支持 | 非常成熟(Kong、APISIX、Spring Cloud Gateway) | 需要 gRPC 网关(Envoy、grpc-gateway) | Dubbo Admin / 自建网关 | GraphQL 网关(Apollo Gateway) |
| 负载均衡 | 成熟(四层/七层) | 需客户端 LB 或支持 HTTP/2 的代理 | 客户端 LB(内置) | 同 REST |
| 可观测性 | 成熟(HTTP 天然可观测) | 较成熟(OpenTelemetry 支持) | Dubbo 生态(Metrics、Tracing) | 较新(Apollo Tracing) |
| 安全 | 成熟(OAuth2、JWT、API Key) | 较成熟(TLS、JWT、自定义拦截器) | Dubbo 生态(Token、TLS) | 中等(基于 HTTP 的安全方案可用) |
| 缓存 | 非常成熟(HTTP 缓存、CDN) | 不适用(二进制协议) | 不适用 | 较复杂(需客户端缓存,如 Apollo Client) |
| 浏览器兼容 | 原生支持 | 需 gRPC-Web 代理 | 不适用 | 原生支持(HTTP POST) |
| 测试工具 | 非常丰富(Postman、curl、JMeter) | gRPCurl、BloomRPC | Dubbo Admin、自建工具 | GraphQL Playground、Apollo Studio |
| 社区活跃度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐(中国社区强) | ⭐⭐⭐⭐ |
六、选型决策框架
6.1 决策树
需要对外暴露 API(给第三方/前端)?
├── 是 → 需要浏览器兼容?
│        ├── 是 → REST(对外 API 首选)
│        └── 否 → 需要客户端决定数据形状?
│                  ├── 是 → GraphQL(移动端/多端数据聚合)
│                  └── 否 → REST + GraphQL 混合
└── 否(内部服务间通信)→ 需要极致性能?
                         ├── 是 → 需要跨语言?
                         │        ├── 是 → gRPC
                         │        └── 否 → Dubbo(Java 生态)/ gRPC
                         └── 否 → 需要流式处理?
                                  ├── 是 → gRPC / Dubbo Triple
                                  └── 否 → 团队技术栈?
                                           ├── Java 为主 → Dubbo + REST
                                           ├── 多语言 → gRPC + REST
                                           └── 前端驱动 → GraphQL + gRPC
6.2 场景-方案映射
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 对外 REST API(给第三方开发者) | REST | 生态最成熟、文档工具丰富、缓存友好 |
| 移动端 BFF(Backend for Frontend) | GraphQL | 精确数据获取、减少请求次数、降低流量 |
| 微服务内部通信(Java 技术栈) | Dubbo + gRPC | 高性能、强类型、治理能力成熟 |
| 微服务内部通信(多语言) | gRPC | 跨语言支持、高性能、Proto 强契约 |
| 实时数据推送 | gRPC 流式 / WebSocket | 双向通信、低延迟 |
| 数据聚合层(聚合多个服务的数据) | GraphQL | 天然的数据编织能力、并发 Resolver |
| 管理后台 API | REST | 简单直接、调试方便、前端生态成熟 |
| IoT / 边缘计算 | gRPC | 二进制协议、体积小、低带宽友好 |
6.3 混合架构:生产实践中的真实选择
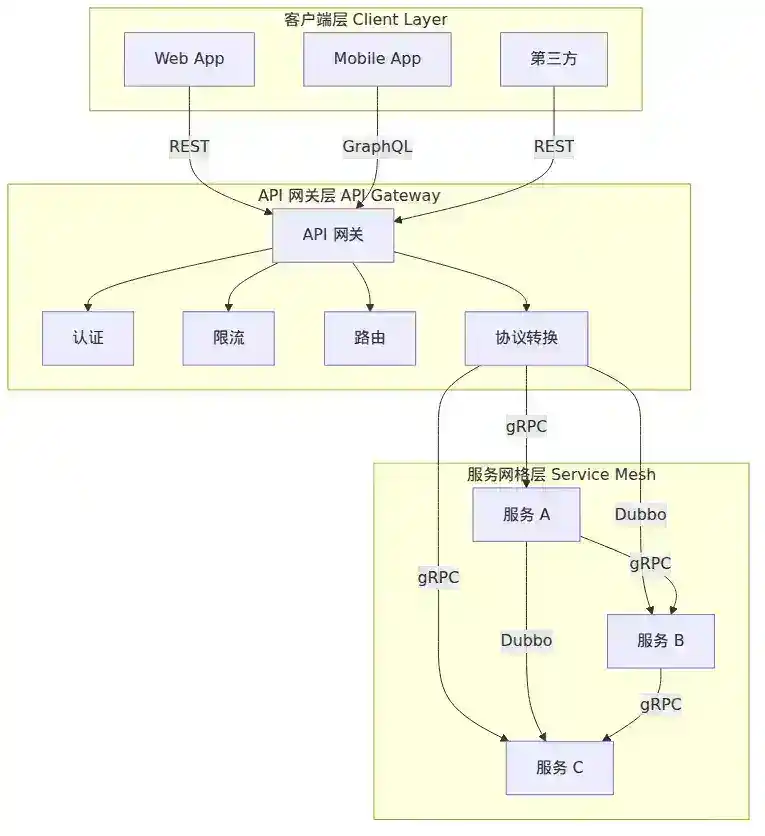
真实的大型系统很少只使用一种 API 风格。以下是一个典型的混合架构:
┌─────────────────────────────────────────────────────┐
│                    客户端层                          │
│  Web App ←→ REST (对外 API)                         │
│  Mobile App ←→ GraphQL (BFF)                        │
│  第三方 ←→ REST (Open API)                          │
└─────────────┬───────────────────────────────────────┘
              │
┌─────────────▼───────────────────────────────────────┐
│                  API 网关层                          │
│  认证、限流、路由、协议转换、聚合                     │
│  REST → gRPC 协议转换(grpc-gateway)               │
└─────────────┬───────────────────────────────────────┘
              │
┌─────────────▼───────────────────────────────────────┐
│                 服务网格层                            │
│  内部服务间通信:gRPC / Dubbo                        │
│  Service A ←→ Service B (gRPC)                      │
│  Service B ←→ Service C (Dubbo)                     │
│  Service D (GraphQL BFF) ←→ Service A, B, C (gRPC)  │
└─────────────────────────────────────────────────────┘
七、实战案例
案例 1:电商订单系统的 API 选型
背景:某电商平台,Java 技术栈,日订单量 500 万。
需求分析:
- 订单创建:高并发、低延迟、强一致性
- 订单查询:多维度查询、需要实时性
- 订单列表:分页、筛选、排序
- 订单事件:状态变更通知(支付成功、发货、签收)
选型方案:
| 场景 | 方案 | 理由 |
|---|---|---|
| 订单创建 | Dubbo (TCP) | 极致性能、服务治理、容错策略 |
| 订单查询 | Dubbo + REST | 内部 Dubbo,对外 REST |
| 订单事件 | RocketMQ(异步消息) | 解耦、削峰、可靠投递 |
| 管理后台 | REST | 调试方便、前端生态成熟 |
关键设计:
- 订单创建接口的 SLA 为 99.99% 可用、P99 < 500ms
- Dubbo 使用 Failfast 容错(创建订单失败不应重试,防止重复下单)
- 查询接口使用 Failover 容错(查询失败可重试其他节点)
案例 2:内容平台的 GraphQL 聚合层
背景:某内容平台,需要聚合用户服务、文章服务、推荐服务的数据。
痛点:移动端一个页面需要调用 5-7 个 REST 接口,客户端性能和开发体验差。
方案:引入 GraphQL 作为 BFF 层。
之前(REST):
  Mobile App → 5-7 次 HTTP 请求 → 客户端聚合 → 渲染

之后(GraphQL BFF):
  Mobile App → 1 次 GraphQL 查询 → BFF 并发获取 → 聚合返回 → 渲染
效果:
- 移动端请求数减少 70%
- 数据传输量减少 45%
- 客户端代码复杂度显著降低
- BFF 层的 DataLoader 将 N+1 查询合并为批量查询
代价:
- 引入新的中间层,增加运维复杂度
- GraphQL 的复杂查询可能导致服务端性能问题(需要查询复杂度分析和限流)
- 团队需要学习 GraphQL 技术栈
八、面试追问:从面试官视角看 API 选型
问题 1:REST 和 RPC 的本质区别是什么?不仅仅是"一个是 HTTP,一个是二进制"。
考察点:对设计哲学的理解深度。
参考答案:
REST 和 RPC 的本质区别在于抽象层次和设计中心:
- REST 是面向资源的,核心概念是"资源"(Resource)和"表述"(Representation)。URI 标识资源,HTTP 方法表达操作,状态通过表述传递。它是数据导向的。
- RPC 是面向过程的,核心概念是"方法"(Method)和"参数"(Parameter)。远程调用就像调用本地方法。它是行为导向的。
更深层的差异在于耦合模型:
- REST 的客户端只需要知道资源的 URI 和媒体类型,服务端可以独立演化资源之间的关系
- RPC 的客户端需要知道具体的方法签名,服务端接口变更直接影响客户端
问题 2:为什么说 GraphQL 解决了 REST 的"过度获取"问题,但又引入了新的问题?
考察点:辩证思维,对 GraphQL 的深入理解。
参考答案:
GraphQL 确实解决了过度获取(Over-fetching)和欠获取(Under-fetching)问题,但引入了:
- 查询复杂度不可预测:客户端可以构造任意深度的查询,服务端难以做容量规划。需要引入查询复杂度分析和深度限制。
- N+1 问题:虽然 DataLoader 可以缓解,但需要开发者主动识别和优化,不如 REST 的批量查询直观。
- 缓存困难:GraphQL 通常使用 POST 请求,无法利用 HTTP 缓存。客户端缓存(如 Apollo Client)比 HTTP 缓存复杂得多。
- 错误处理:GraphQL 返回 200 OK 即使部分字段失败,错误信息散落在响应中,监控和告警需要额外处理。
- 文件上传:GraphQL 原生不支持文件上传,需要额外的规范(如 GraphQL Multipart Request Specification)。
问题 3:如果让你设计一个面向第三方开发者的开放平台 API,你会选 REST 还是 GraphQL?为什么?
考察点:对 API 消费者视角的考虑。
参考答案:
选择 REST,理由:
- 生态成熟度:第三方开发者几乎都熟悉 REST,学习成本最低。GraphQL 对传统后端开发者仍然有学习曲线。
- 缓存:REST 的 GET 请求天然支持 HTTP 缓存和 CDN,对开放平台的高流量场景至关重要。
- 调试工具:curl、Postman、各种语言的 HTTP 库,生态极度丰富。
- 版本管理:REST 的版本策略(URI 版本或 Header 版本)更直观,第三方开发者更容易管理升级。
- 限流和计费:REST 的"一个端点一个操作"模型让限流和计费更简单(按 API 端点分别计数)。
但会提供 GraphQL 作为补充选项,给有经验的开发者更灵活的数据获取能力。
问题 4:你们公司内部 RPC 框架选 Dubbo 还是 gRPC?请给出技术判断依据。
考察点:技术选型能力,对团队和业务的综合考量。
参考答案:
| 考量因素 | 选 Dubbo | 选 gRPC |
|---|---|---|
| 技术栈 | 纯 Java/Spring 生态 | 多语言(Go、Python、Node.js 等) |
| 服务治理需求 | 需要丰富的路由、灰度、权重等治理能力 | 治理需求简单,或依赖 Service Mesh |
| 社区与支持 | 国内团队,需要中文文档和社区支持 | 国际化团队,需要全球社区 |
| 云原生 | 传统部署为主 | Kubernetes + Service Mesh(Istio) |
| 性能要求 | 极致性能,自定义 TCP 协议 | 高性能,但可接受 HTTP/2 开销 |
我的判断:如果公司是纯 Java 技术栈、国内部署、需要丰富的服务治理能力 → Dubbo。如果多语言技术栈、云原生部署、需要与 gRPC 生态集成 → gRPC。
问题 5:Proto 文件中字段编号为什么不能随意修改?如果删除了一个字段,它的编号可以复用吗?
考察点:对 Protobuf 序列化机制的深入理解。
参考答案:
字段编号在 Protobuf 序列化时用于标识字段,而非字段名。序列化后只存储 (field_number, type, value),不存储字段名。
不能随意修改编号的原因:
- 已序列化的数据使用旧编号,新代码使用新编号解析 → 数据错乱
- 例如:编号 1 原来是
name,改为email,旧数据中的name值会被解析为email
已删除字段的编号不可复用:
- 旧数据中可能仍包含该编号的数据
- 如果复用编号给新字段,旧数据会被错误解析
- 正确的做法是标记为
reserved:
message User {
  reserved 2, 5, 9 to 11;  // 永久保留这些编号
  reserved "old_field", "deprecated_field";  // 也可以保留字段名
  string name = 1;
  string email = 3;
}
九、总结
REST、RPC、GraphQL 不是竞争对手,而是解决不同问题的工具:
- REST 是互联网的通用语言,最适合对外 API 和跨组织协作
- RPC(gRPC/Dubbo)是内部服务通信的利器,高性能和强契约是核心优势
- GraphQL 是前端驱动的数据获取方式,适合多端数据聚合和复杂查询场景
选择的标准不是"哪个更好",而是"哪个更合适"。理解三者的设计哲学、性能特征和耦合模型,才能在架构决策中做出正确的权衡。
本文为 Java 技术专家/架构师面试 250 个高频考点系列第 182 篇。
十、面试官视角:Q&A 深度追问
以下问题从面试官视角设计,考察候选人对 REST/RPC/GraphQL 选型的真正理解深度,而非记忆性知识。
Q1:你说 REST 是"无状态"的,但业务显然需要登录态。这个矛盾怎么解释?
面试官意图:考察对 REST 无状态约束的精确理解,区分"应用状态"和"资源状态"。
REST 的"无状态"不是指业务没有状态,而是指每个请求必须包含理解该请求所需的全部信息,服务器不存储客户端会话上下文。登录态通过 Token(JWT/Opaque)在每次请求中携带,服务器从 Token 解析身份,不依赖之前请求的上下文。违反无状态的典型反例:服务器端 Session 存储用户购物车,客户端只传 Session ID——这导致扩容需要 Session 同步、重启丢失会话状态。
评分要点:能区分"认证状态"和"服务器端会话状态" → 优秀;只说"用 Token 解决" → 一般。
Q2:gRPC 使用 HTTP/2 的 HPACK 头压缩,在微服务场景下反而可能成为瓶颈,为什么?
面试官意图:考察对底层机制的理解,能否识别"优势"技术在某些场景下的反作用。
HPACK 通过动态表压缩 HTTP 头。浏览器场景下(同一连接大量请求)效果显著。但在微服务场景下:每个服务间通常只有 1-2 个长连接,请求频率低,动态表填充缓慢;gRPC 头部通常只有几个 metadata,压缩收益有限;每个连接维护独立 HPACK 编解码器,在服务网格中大量 sidecar 连接的内存开销不可忽视;HPACK 动态表更新依赖严格顺序,乱序导致解压失败。
评分要点:能说出动态表机制和微服务场景的差异 → 优秀。
Q3:GraphQL 的 N+1 问题,DataLoader 能解决到什么程度?什么场景下它也无能为力?
面试官意图:考察对 GraphQL 性能问题的实战经验。
DataLoader 能解决:同一请求内同字段的批量加载(10 个 Post 的作者 → 1 次 batchGetUsers),利用事件循环 tick 聚批。但它无法解决:跨请求的 N+1(缓存仅请求生命周期内有效);跨服务的 N+1(Post.author 调用户服务、Post.comments 调评论服务,无法跨服务合并);深度嵌套的延迟累加;条件分支中无法预判批处理范围。根治方案:CQRS 读模型、持久化查询、@defer/@stream 延迟加载。
评分要点:能说出跨服务、跨请求、深度嵌套的局限性 → 优秀。
Q4:Proto3 为什么把 Proto2 的 required 去掉了?
面试官意图:考察对 API 演化实践的深度理解,理解设计决策背后的教训。
required 有三大问题:永远无法删除——一旦标记为 required,后续所有版本必须保留,否则旧代码解析新数据直接失败;向后兼容灾难——即使字段业务含义已废弃也必须保留;增量升级困难——无法保证所有服务同时升级,A 升级后不发送 required 字段,旧版 B 解析失败。Google 真实案例:某内部服务将 user_id 标记为 required,后来需要支持匿名用户,无法改为 optional,最终只能定义新 message 绕过。Proto3 的设计哲学:所有字段都是 optional 语义,业务校验在应用层完成。
评分要点:能说出"删除困难"和"增量升级"两个核心痛点 → 优秀。
Q5:你们同时用了 REST 和 gRPC,API 网关怎么统一管理?gRPC 协议转换有什么坑?
面试官意图:考察混合架构的工程落地能力和踩坑经验。
统一管理:使用 Envoy/APISIX 统一网关同时支持 HTTP/1.1 和 HTTP/2,gRPC 通过 grpc-gateway 自动生成 RESTful API。常见坑:① HTTP 状态码映射——gRPC 状态码体系与 HTTP 非一一对应,默认映射不一定符合预期;② 字段命名差异——Proto 用 snake_case,REST JSON 期望 camelCase;③ 枚举序列化——gRPC 枚举默认整数,REST 期望字符串;④ Timestamp 序列化——可能产生奇怪的 JSON 输出;⑤ 流式转换——server-streaming 映射为 SSE 或分块传输需要特殊处理;⑥ 错误详情——google.rpc.Status.details 在转换中可能丢失。
评分要点:能说出 3 个以上具体坑点 → 优秀。
Q6:开放性问题:五年后 REST / gRPC / GraphQL 的格局会怎么变?
面试官意图:考察技术视野和行业趋势判断力,无标准答案。
REST 不会消失——它是 HTTP 原语最直接的利用,对外 API 和跨组织协作的通用语言地位不可替代。gRPC 在内部通信中继续增长——云原生 + Service Mesh 普及让 gRPC 成为内部通信事实标准。GraphQL 边界更清晰——在 BFF 层和移动端场景站稳,但不会取代 REST。新兴趋势:AsyncAPI 填补事件驱动 API 标准化空白;tRPC/Connect 模糊 RPC 和 REST 边界;AI 时代 LLM 调用 API 时,GraphQL Schema 自描述能力比 REST 文档更有优势,但 Function Calling 的 JSON Schema 又创造新的契约形式。最终胜出的不是某个协议,而是能同时支持多种协议、自动生成客户端代码和文档的契约驱动开发模式。
评分要点:能说出多种协议合理分工和融合趋势,而非简单预测"某个取代某个" → 优秀。
本文为 Java 技术专家/架构师面试 250 个高频考点系列第 182 篇。