阅读时间:约 45 分钟 适合人群:Java 中高级工程师、架构师 前置知识:分布式系统基础、HTTP/RPC 调用、Java 并发编程
一、从一个线上事故说起
2023 年双十一,某电商平台的订单服务突然大面积超时。排查发现:库存服务的一个慢查询导致响应时间从 50ms 飙升到 5s,调用方订单服务的线程池迅速耗尽,大量请求失败后触发重试逻辑,重试请求进一步压垮库存服务,最终形成雪崩。这个事故的根源,就是缺少一套完整的超时-重试-退避机制。
这个场景包含了我们今天要讨论的全部四个概念:超时配置不当 → 重试触发 → 重试风暴 → 缺少退避和抖动 → 系统雪崩。
二、超时:分布式调用的第一道防线
2.1 三层超时模型
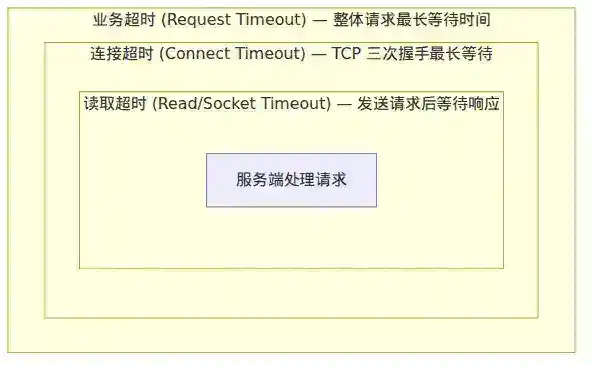
在 Java 生态中,一次远程调用通常涉及三层超时:
┌─────────────────────────────────────────────────┐
│                 业务超时 (Request Timeout)         │
│  ┌───────────────────────────────────────────┐  │
│  │            连接超时 (Connect Timeout)       │  │
│  │  ┌─────────────────────────────────────┐  │  │
│  │  │      读取超时 (Read/Socket Timeout)  │  │  │
│  │  │                                     │  │  │
│  │  └─────────────────────────────────────┘  │  │
│  └───────────────────────────────────────────┘  │
└─────────────────────────────────────────────────┘
连接超时(Connect Timeout):TCP 三次握手的最长等待时间。通常设置在 100ms-1s 之间。连接超时过大会导致线程长时间阻塞在建立连接阶段;过小则正常网络抖动也会触发超时。
读取超时(Read/Socket Timeout):发送请求后等待响应的最长时间。这是最关键的配置,直接决定了调用方感知的延迟上限。
请求超时(Request Timeout):业务层面的整体超时,涵盖了连接、读取以及可能的中间件处理时间。在 gRPC 中叫 Deadline,在 Resillience4j 中叫 TimeLimiter。
2.2 超时配置的常见错误
错误一:不设超时
// 危险:默认超时可能是无穷大
RestTemplate restTemplate = new RestTemplate();
// SimpleClientHttpRequestFactory 默认 connectTimeout=-1, readTimeout=-1(无限等待)
String result = restTemplate.getForObject("http://inventory-service/stock", String.class);
错误二:超时设置过大
// 假设这个接口的 P99 是 200ms,SLA 是 1s
// 设置 30s 超时意味着:线程会被阻塞 30s 才能释放
// 在 1000 QPS 下,如果下游变慢到 5s,30s 内会积累 30000 个阻塞线程
httpClient.setReadTimeout(30, TimeUnit.SECONDS);
错误三:超时设置过小
// P99 是 200ms,但 P99.9 是 800ms
// 设置 500ms 超时会把 0.1% 的正常请求也干掉
httpClient.setReadTimeout(500, TimeUnit.MILLISECONDS);
正确做法:超时值 = P99.9 延迟 × 1.5~2 倍,或根据 SLA 反推。例如接口 SLA 承诺 1s 返回,则读取超时不应超过 1s。
2.3 超时配置表
| 层级 | 超时类型 | 推荐值 | 说明 |
|---|---|---|---|
| HTTP 连接池 | connectTimeout | 200ms-1s | 建立连接,失败应快速重试其他节点 |
| HTTP 读取 | socketTimeout | 1s-5s | 视业务而定,不应超过上游 SLA |
| RPC 框架 | requestTimeout | 1s-10s | Dubbo 默认 1s,gRPC 建议显式设置 deadline |
| 数据库连接池 | connectionTimeout | 1s-5s | HikariCP 默认 30s,通常偏大 |
| 数据库查询 | queryTimeout | 1s-30s | 按 SQL 复杂度分级 |
| 缓存 | timeout | 50ms-200ms | 缓存应该极快,超时即降级 |
| 消息队列 | pollTimeout | 100ms-1s | 长轮询除外 |
2.4 超时与线程池的关系
超时时间和线程池大小决定了系统的并发承载能力。根据 Little's Law:
并发数 = 吞吐量 × 平均响应时间
如果线程池大小为 200,每个请求平均耗时 100ms,则理论最大吞吐量为 2000 QPS。当响应时间因下游变慢而增加到 5s 时,如果不设超时,200 个线程将全部阻塞,吞吐量降为 40 QPS;如果设置了 1s 超时,则线程最多阻塞 1s 即可释放,吞吐量仍可维持在 200 QPS。
三、重试:双刃剑

3.1 什么时候该重试
重试的前提是操作是幂等的。幂等意味着多次执行的结果与执行一次相同。
适合重试的场景:
- 读操作(天然幂等)
- 网络瞬时故障(连接超时、连接重置)
- 服务返回 429(限流)或 503(临时不可用)
- 乐观锁冲突
不适合重试的场景:
- 非幂等的写操作(扣库存、扣余额)——除非有幂等键
- 服务返回明确的业务错误(参数校验失败、余额不足)
- 超时但请求可能已到达服务端——这就是"超时歧义"问题
3.2 重试风暴:分布式系统的噩梦
重试风暴是指:一个服务变慢 → 上游请求超时重试 → 重试请求叠加在原请求之上 → 服务负载翻倍 → 更慢 → 更多超时 → 更多重试 → 正反馈循环直至崩溃。
时间线                   请求数
─────────────────────────────────────
T0: 正常                  1000
T1: 服务变慢(P99=5s)       1000
T2: 上游超时(1s), 重试×3   4000  ← 重试风暴开始
T3: 更慢(P99=10s)          4000
T4: 更多超时, 重试×3       16000 ← 指数级增长
T5: 服务崩溃                 0
关键认知:重试不是免费的。每次重试都会消耗服务端资源(CPU、内存、连接、线程)。在服务端已有压力的情况下,重试是在"火上浇油"。
3.3 重试策略设计
最大重试次数:通常 2-3 次。超过 3 次的重试对可用性的提升微乎其微,但会显著增加下游压力。
重试条件:只重试可重试的错误。在 Java 中:
// 使用 Resilience4j 定义重试条件
RetryConfig config = RetryConfig.custom()
    .maxAttempts(3)
    .retryOnException(e -> {
        if (e instanceof SocketTimeoutException) return true;        // 网络超时
        if (e instanceof ConnectException) return true;              // 连接失败
        if (e instanceof IllegalStateException
            && e.getMessage().contains("429")) return true;          // 限流
        return false;  // 其他异常不重试
    })
    .build();
重试与超时的配合:每次重试的耗时不应超过接口 SLA。如果某次重试中读取超时是 5s,重试 3 次的理论最长耗时是 15s,这显然不可接受。因此:
单次重试超时 = min(原超时, SLA / 重试次数)
例如 SLA 为 3s,重试 3 次,则单次超时不应超过 1s。
四、指数退避:给服务端喘息的时间

4.1 为什么需要退避
假设 1000 个客户端同时超时并立即重试,服务端会瞬间收到 1000 个新请求——这 1000 个请求几乎同时到达,形成"羊群效应"(Thundering Herd)。退避的核心思想是:让重试请求在时间上分散开,给服务端恢复的时间窗口。
4.2 指数退避算法
指数退避的基本公式:
delay = min(cap, base × multiplier^attempt)
- base:基础等待时间,如 100ms
- multiplier:指数基数,通常为 2
- cap:最大等待时间上限,如 30s
- attempt:当前重试次数(从 0 开始)
| 重试次数 | 退避时间 (base=100ms) | 退避时间 (base=1s) |
|---|---|---|
| 第 1 次 | 100ms | 1s |
| 第 2 次 | 200ms | 2s |
| 第 3 次 | 400ms | 4s |
| 第 4 次 | 800ms | 8s |
| 第 5 次 | 1.6s | 16s |
| 第 6 次 | 3.2s | 30s (cap) |
4.3 Java 实现
public class ExponentialBackoff {
    private final long baseMillis;
    private final double multiplier;
    private final long maxMillis;
    private final Random random = new Random();

    public ExponentialBackoff(long baseMillis, double multiplier, long maxMillis) {
        this.baseMillis = baseMillis;
        this.multiplier = multiplier;
        this.maxMillis = maxMillis;
    }

    public long nextDelay(int attempt) {
        double exponential = baseMillis * Math.pow(multiplier, attempt);
        return (long) Math.min(exponential, maxMillis);
    }
}
4.4 指数退避的局限性
纯指数退避的问题是:当大量客户端同时失败时,它们仍然会在"相同的时间点"上重试。因为退避时间是由重试次数决定的,所有客户端在第 N 次重试时的等待时间是一样。
五、抖动:打破同步的魔法
5.1 抖动的本质
抖动(Jitter)是在退避时间上加入随机性,让重试请求在时间维度上均匀分布。AWS 架构博客中有一句经典总结:
"In a large-scale distributed system, the best thing you can do is to be a little bit random."
5.2 三种抖动策略
Full Jitter(完全抖动):
delay = random(0, min(cap, base × 2^attempt))
每次重试的等待时间在 0 到指数退避时间之间随机选取。这是 AWS 推荐的做法,在大量客户端场景下表现最好。
Equal Jitter(等量抖动):
temp = min(cap, base × 2^attempt)
delay = temp/2 + random(0, temp/2)
保留一半的确定性退避时间,另一半随机化。在中等规模场景下是折中方案。
Decorrelated Jitter(去相关抖动):
delay = min(cap, random(base, delay_prev × 3))
每次重试的等待时间与上一次相关,但不超过上一次的 3 倍。这种策略使同一次"重试浪潮"中的请求自然分散,不会聚拢。
5.3 三种策略的效果对比
场景:1000 个客户端同时第 3 次重试,base=1s

无抖动:所有客户端在 4s 后同时重试 → 1000 个请求同时到达
Equal Jitter:在 2s~4s 之间均匀分布 → 每秒约 500 个请求
Full Jitter:在 0~4s 之间均匀分布 → 每秒约 250 个请求
Decorrelated Jitter:在 1s~12s 之间按对数分布 → 高度分散
选择建议:单个服务内部重试用 Equal Jitter;客户端 SDK(如 AWS SDK、gRPC)用 Full Jitter;长时间重试(如消息重投递)用 Decorrelated Jitter。
5.4 Java 实现
public class BackoffWithJitter {
    private final long baseMillis;
    private final long maxMillis;
    private final Random random = new Random();
    private long prevDelay = 0;

    // Full Jitter
    public long fullJitter(int attempt) {
        long cap = (long) Math.min(maxMillis, baseMillis * Math.pow(2, attempt));
        return random.nextLong(cap + 1);
    }

    // Equal Jitter
    public long equalJitter(int attempt) {
        long cap = (long) Math.min(maxMillis, baseMillis * Math.pow(2, attempt));
        long half = cap / 2;
        return half + random.nextLong(half + 1);
    }

    // Decorrelated Jitter
    public long decorrelatedJitter() {
        long cap = Math.min(maxMillis, Math.max(baseMillis, prevDelay * 3));
        prevDelay = baseMillis + random.nextLong(Math.max(1, cap - baseMillis + 1));
        return prevDelay;
    }
}
六、截止时间传播:超时在分布式调用链中的传递
6.1 问题:局部超时 vs 全局超时
考虑以下调用链:
用户请求 (SLA: 3s)
  └─ API Gateway → 订单服务 (超时 2s)
       ├─ 库存服务 (超时 1s)
       ├─ 优惠券服务 (超时 500ms)
       └─ 用户服务 (超时 500ms)
如果 API Gateway 的超时是 3s,订单服务的超时是 2s,而库存服务的超时是 1s——看起来合理。但问题在于:
- 订单服务调用库存服务花了 800ms
- 订单服务调用优惠券服务花了 400ms
- 订单服务调用用户服务花了 400ms
- 订单服务总耗时 800ms,但 API Gateway 已经等了 2s(因为前面的链路有延迟)
如果优惠券服务在 400ms 内没返回,它应该继续等还是提前放弃?局部超时不知道全局还剩多少时间。
6.2 截止时间传播机制
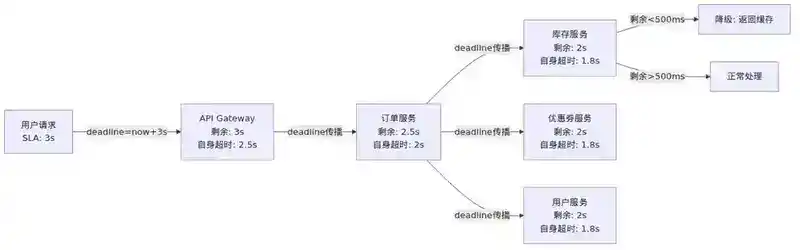
截止时间传播(Deadline Propagation)的核心思想是:每个下游服务都应该知道"上游还能等多久"。
请求进入时携带 deadline = now + 3s
  ↓
API Gateway: 剩余 = 3s, 设置自身超时 = 2.5s
  ↓
订单服务: 收到 deadline, 剩余 = 2.5s, 设置自身超时 = 2s
  ↓
库存服务: 收到 deadline, 剩余 = 2s, 设置自身超时 = 1.8s
  ↓
库存服务发现: 自身处理需要 1.5s, 但只剩 1.8s 可用 → 可以继续
6.3 gRPC Deadline 实现
gRPC 原生支持截止时间传播:
// 客户端设置 deadline
ManageOrderServiceGrpc.ManageOrderServiceBlockingStub stub =
    ManageOrderServiceGrpc.newBlockingStub(channel)
        .withDeadlineAfter(3000, TimeUnit.MILLISECONDS); // 3 秒截止

// 服务端获取剩余时间
@Override
public void createOrder(CreateOrderRequest request,
                        StreamObserver<CreateOrderResponse> responseObserver) {
    long remainingNanos = Context.current()
        .getDeadline()
        .timeRemaining(TimeUnit.NANOSECONDS);

    if (remainingNanos < 500_000_000) { // 剩余不到 500ms
        // 不再调用下游,直接返回降级结果
        responseObserver.onNext(CreateOrderResponse.newBuilder()
            .setStatus(Status.DEGRADED).build());
        responseObserver.onCompleted();
        return;
    }

    // 调用下游时自动传递 deadline
    inventoryStub.checkStock(request);
}
gRPC 的 deadline 会自动在每次 RPC 调用中传播:服务端收到请求时,gRPC 框架会将 deadline 写入 gRPC Context,当该服务再去调用下游时,deadline 被自动携带。
6.4 非 gRPC 场景的截止时间传播
在 HTTP/REST 或 Dubbo 场景中,没有原生的 deadline 传播机制,需要手动实现:
// 在 HTTP Header 中传递 deadline
public class DeadlinePropagationFilter implements Filter {

    private static final String DEADLINE_HEADER = "X-Request-Deadline";

    @Override
    public void doFilter(ServletRequest request, ServletResponse response,
                         FilterChain chain) throws IOException, ServletException {
        HttpServletRequest httpReq = (HttpServletRequest) request;
        String deadlineStr = httpReq.getHeader(DEADLINE_HEADER);

        if (deadlineStr != null) {
            long deadline = Long.parseLong(deadlineStr);
            long remaining = deadline - System.currentTimeMillis();

            if (remaining <= 0) {
                // 截止时间已过,不再处理
                HttpServletResponse httpResp = (HttpServletResponse) response;
                httpResp.setStatus(408); // Request Timeout
                return;
            }

            // 将剩余时间存入线程上下文
            DeadlineContext.set(deadline);
        }

        try {
            chain.doFilter(request, response);
        } finally {
            DeadlineContext.clear();
        }
    }
}
6.5 剩余时间预算的价值
有了截止时间传播,服务可以做出更智能的决策:
- 跳过非关键调用:如果剩余时间不够,直接跳过推荐、日志等非关键功能
- 提前降级:剩余时间不足时,返回缓存结果或默认值
- 避免资源浪费:下游服务不再处理"上游已经放弃"的请求
七、组合策略:构建弹性调用链路
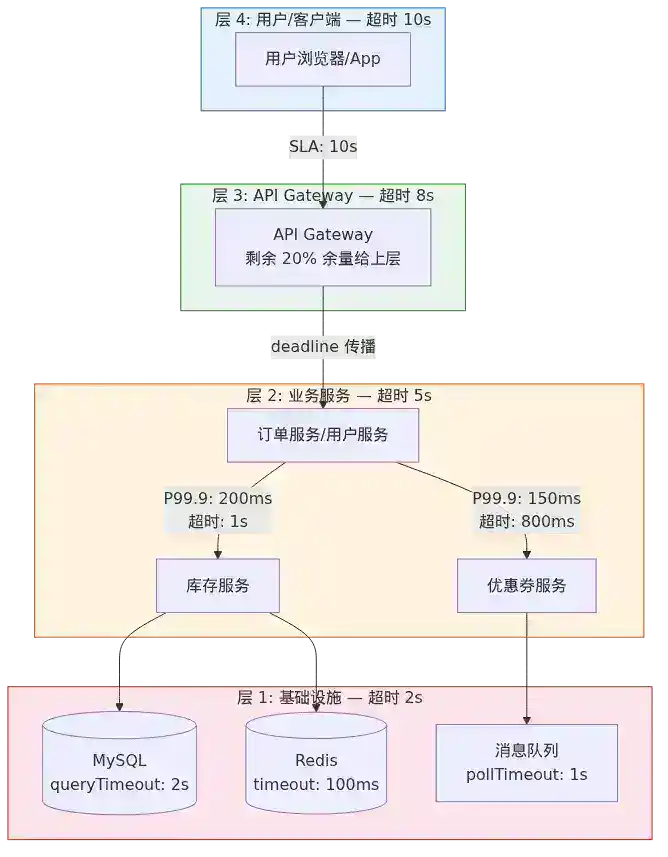
7.1 组合公式
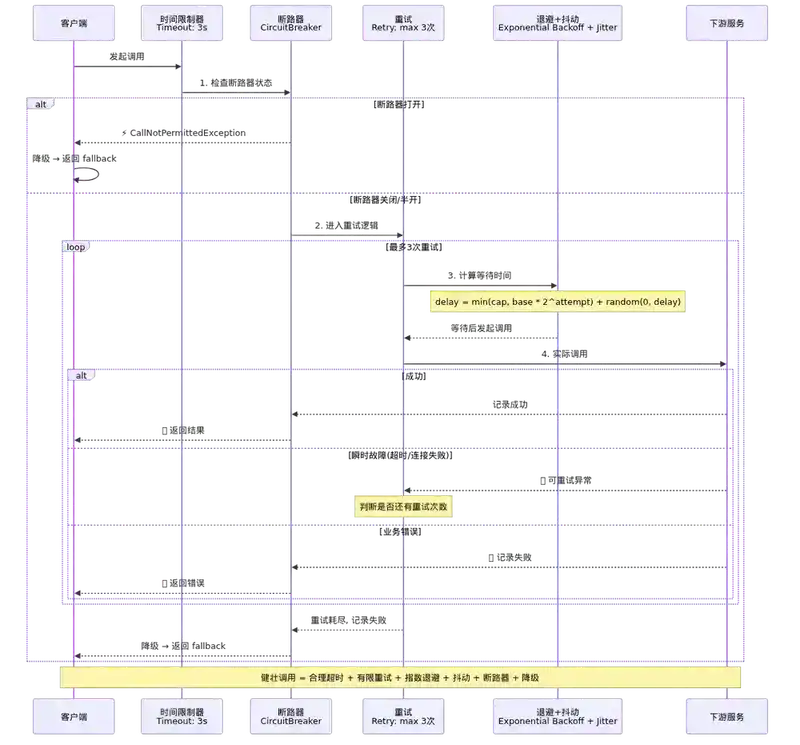
一个健壮的远程调用应该包含以下要素:
健壮调用 = 合理超时 + 有限重试 + 指数退避 + 抖动 + 截止时间传播 + 断路器 + 降级
7.2 Resilience4j 组合示例
// 1. 配置重试(含退避和抖动)
RetryConfig retryConfig = RetryConfig.<String>custom()
    .maxAttempts(3)
    .waitDuration(Duration.ofMillis(100))           // base
    .intervalFunction(IntervalFunction.ofExponentialRandomBackoff(
        100, 2.0, Duration.ofSeconds(30)))          // 指数退避 + 随机抖动
    .retryOnResult(result -> result == null)
    .retryOnException(e -> e instanceof TimeoutException)
    .build();

// 2. 配置断路器
CircuitBreakerConfig cbConfig = CircuitBreakerConfig.custom()
    .failureRateThreshold(50)                        // 50% 失败率打开
    .slowCallRateThreshold(50)                       // 50% 慢调用率
    .slowCallDurationThreshold(Duration.ofSeconds(2)) // 慢调用阈值
    .waitDurationInOpenState(Duration.ofSeconds(30))  // 打开后 30s 转半开
    .slidingWindowSize(100)
    .build();

// 3. 配置时间限制器
TimeLimiterConfig timeLimiterConfig = TimeLimiterConfig.custom()
    .timeoutDuration(Duration.ofSeconds(3))           // 整体超时
    .cancelRunningFuture(true)
    .build();

// 4. 组合使用
Retry retry = Retry.of("inventoryService", retryConfig);
CircuitBreaker cb = CircuitBreaker.of("inventoryService", cbConfig);
TimeLimiter timeLimiter = TimeLimiter.of(timeLimiterConfig);

// 装饰后调用
Supplier<String> decoratedSupplier = Decorators.ofSupplier(() -> callInventory())
    .withCircuitBreaker(cb)
    .withRetry(retry)
    .withTimeLimiter(timeLimiter, Executors.newScheduledThreadPool(10))
    .withFallback(asList(TimeoutException.class, CallNotPermittedException.class),
                  e -> "degraded-inventory-data")
    .decorate();

String result = Try.ofSupplier(decoratedSupplier).getOrElse("fallback");
7.3 各层超时梯级配置
在多层架构中,超时应该形成"梯级":
层 4: 用户/客户端     超时 10s
层 3: API Gateway     超时 8s
层 2: 业务服务        超时 5s
层 1: 基础设施(DB/缓存) 超时 2s
越高层超时越大,越低层超时越小。这样当底层超时时,上层还有时间进行重试或降级。
八、面试官视角:常见考察点
8.1 重试一定好吗?什么情况下重试会让系统更糟?
参考答案:重试是双刃剑。当服务端已经过载时,重试会叠加负载,形成正反馈循环导致雪崩。关键判断依据是:错误类型是否可重试(瞬时故障 vs 业务错误),以及当前服务端是否已有压力(需要结合断路器、负载反馈来判断)。AWS 的经验是:当错误率超过一定阈值时,应该停止重试,直接快速失败。
8.2 为什么有了指数退避还需要加抖动?
参考答案:指数退避解决的是"单个客户端重试间隔递增"的问题,但不能解决"多个客户端同时重试"的羊群效应。所有客户端在第 N 次重试时的等待时间都相同,所以它们仍然会在同一时刻同时重试。抖动通过随机化打破这种同步,让重试请求在时间轴上均匀分布。
8.3 超时和断路器有什么区别?能否只用一个?
参考答案:超时是请求级别的防护,保护单个请求不被无限阻塞;断路器是服务级别的防护,保护整个服务不被下游的持续故障拖垮。两者解决不同层面的问题,不可互相替代。比喻:超时是安全帽,断路器是防火墙——安全帽保护个人,防火墙保护整栋楼。
8.4 分布式系统中,如何确定一个合理的超时值?
参考答案:不是拍脑袋,而是基于数据。步骤:① 收集 P50/P99/P99.9 延迟数据;② 超时值 = P99.9 × 1.5~2 倍;③ 与 SLA 对齐(超时不应超过 SLA 承诺时间);④ 区分接口——快接口超时短(如缓存 50ms),慢接口超时长(报表 30s);⑤ 灰度验证,观察超时率是否在可接受范围内。
8.5 截止时间传播在非 gRPC 系统中如何实现?有什么挑战?
参考答案:通过自定义 Header 传递(如 X-Request-Deadline)。挑战:① 需要所有中间服务配合,改造工作量较大;② 时钟同步问题——不同机器的时间可能有偏差,建议使用相对时间(remaining)而非绝对时间戳;③ 异步场景(消息队列)中的截止时间传播更加复杂,因为处理时间不确定。
九、总结
| 概念 | 核心作用 | 配置要点 |
|---|---|---|
| 超时 | 防止资源无限占用 | 基于 P99.9 × 1.5~2,与 SLA 对齐 |
| 重试 | 提高可用性,应对瞬时故障 | 最多 3 次,只重试可重试的错误 |
| 指数退避 | 给服务端恢复时间 | base=100ms~1s, multiplier=2, cap=30s |
| 抖动 | 避免羊群效应 | 优先 Full Jitter,SDK 场景选 Decorrelated |
| 截止时间传播 | 避免无意义等待 | 每层预留 10%-20% 余量 |
| 断路器 | 防止级联故障 | 失败率 50%,open 30s |
最后,记住两条铁律:
- 永远不要无限制地等待——每个远程调用都必须有超时
- 永远不要无节制地重试——每次重试前都应该问自己:这次重试会帮助服务端恢复,还是会让它更糟?
下一篇预告:186|分布式事务:2PC、TCC、Saga 和最终一致性