阅读时间:约 45 分钟 难度:中级 → 高级 前置知识:微服务基本概念、网络通信基础
一、为什么需要服务注册与发现
想象一个场景:你维护着一个单体应用,所有功能都在一个进程里,调用就是方法调用,地址就是 localhost:8080。有一天业务膨胀,你拆成了 50 个微服务,每个服务还有 3~10 个实例分布在不同的机器上。现在问题来了——
服务 A 怎么知道服务 B 的实例在哪里?
你可能会说:"写死在配置文件里不就行了?" 确实可以,但接下来你会遇到:
- 实例扩容/缩容,配置要跟着改
- 某台机器挂了,调用方还在往死地址发请求
- 上线发布时实例 IP 会变,配置文件得同步更新
- 50 个服务互相调用,配置矩阵爆炸
这就是服务注册与发现要解决的核心问题:在动态变化的分布式环境中,让服务消费者能够自动、实时地找到服务提供者的网络地址。
1.1 核心三元组
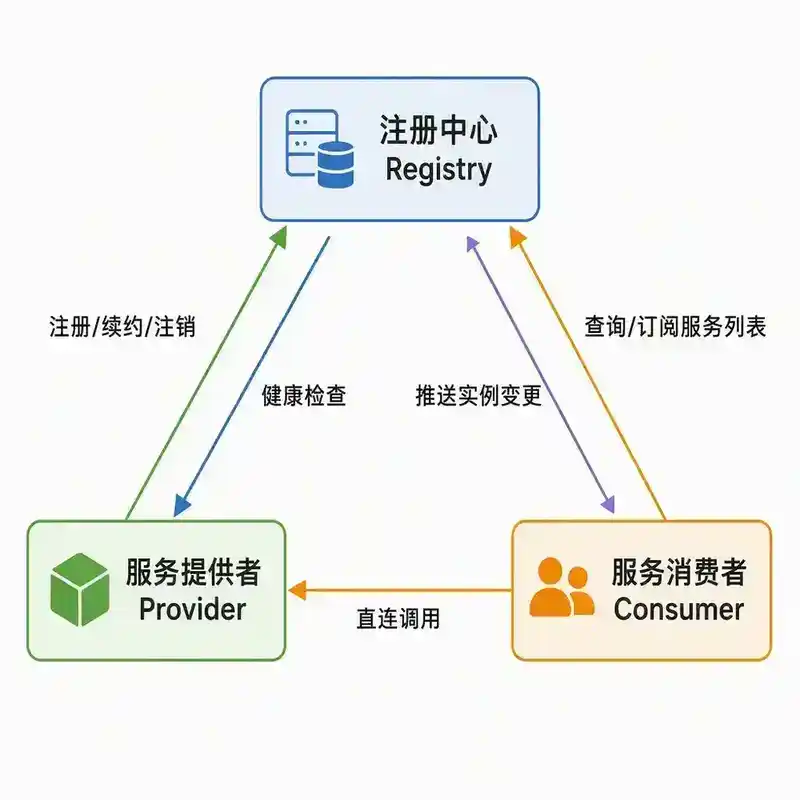
服务注册与发现本质上是三个角色的协作:
┌──────────────┐     注册/续约     ┌──────────────┐     查询/订阅     ┌──────────────┐
│  服务提供者   │ ───────────────→ │   注册中心    │ ←─────────────── │  服务消费者   │
│  (Provider)  │ ←─────────────── │  (Registry)  │ ───────────────→ │  (Consumer)  │
└──────────────┘   健康检查/摘除   └──────────────┘   推送变更/缓存   └──────────────┘
| 角色 | 职责 |
|---|---|
| 注册中心(Registry) | 存储服务实例元数据,提供查询和变更通知能力 |
| 服务提供者(Provider) | 启动时注册自己,定期续约,下线时注销 |
| 服务消费者(Consumer) | 从注册中心获取服务列表,感知实例上下线 |
二、两种服务发现模式
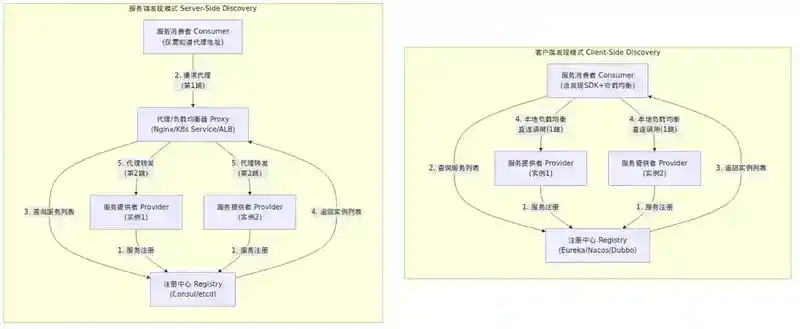
业界有两种经典的架构模式,选型直接影响系统的复杂度、可用性和性能。
2.1 客户端发现(Client-Side Discovery)
┌──────────┐                        ┌──────────┐
│ Consumer │ ──── 2. 查询服务列表 ──→│ Registry │
└──────────┘                        └──────────┘
     │                                    ↑
     │ 1. 注册                            │
     ↓                                    │
┌──────────┐   3. 客户端负载均衡选择实例   │
│ Provider │ ←───────────────────────────┘
│ (实例1)   │
└──────────┘
┌──────────┐
│ Provider │
│ (实例2)   │
└──────────┘
工作流程:
- Provider 启动后向 Registry 注册(IP、端口、元数据)
- Consumer 从 Registry 拉取 Provider 的全部实例列表,并缓存到本地
- Consumer 在本地通过负载均衡算法选择一个实例发起调用
- Registry 通过心跳或长轮询通知 Consumer 实例变更
代表实现: Netflix Eureka、Dubbo(直连 Registry 模式)、Nacos(客户端模式)
优点:
- 没有额外的网络跳转,Consumer 直连 Provider,延迟更低
- 负载均衡策略灵活,客户端可以根据业务需求自定义路由
- Registry 只负责元数据,不承载流量转发,架构更简单
缺点:
- Consumer 需要集成服务发现 SDK,存在语言绑定
- 多语言环境下要为每种语言维护对应 SDK
- 客户端负载均衡逻辑分散在各服务中,升级和治理困难
关键代码模式(以 Eureka 为例):
// Provider 注册
@EnableEurekaClient
@SpringBootApplication
public class ProviderApplication {

    public static void main(String[ ] args) {

        SpringApplication.run(ProviderApplication.class, args);
    }
}

// Consumer 发现 + 负载均衡
@Bean
@LoadBalanced  // 开启 Ribbon 客户端负载均衡
public RestTemplate restTemplate() {
    return new RestTemplate();
}

// 调用时使用服务名而非 IP
String result = restTemplate.getForObject(
    "http://PROVIDER-SERVICE/api/data", String.class);
2.2 服务端发现(Server-Side Discovery)
┌──────────┐                        ┌──────────┐
│ Consumer │ ──── 2. 请求代理 ────→ │  Proxy   │
└──────────┘                        │ (LB/网关) │
                                    └──────────┘
                                         │
                              1. 查询服务列表
                                         │
                                         ↓
                                    ┌──────────┐
                                    │ Registry │
                                    └──────────┘
                                         ↑
                                   注册/续约
                                         │
┌──────────┐                             │
│ Provider │ ←───────────────────────────┘
└──────────┘
工作流程:
- Provider 向 Registry 注册
- Consumer 向代理(如负载均衡器、API 网关)发起请求
- 代理查询 Registry 获取可用实例列表
- 代理选择实例并转发请求
代表实现: Kubernetes Service + kube-proxy、AWS ELB/ALB、Consul Connect(代理模式)
优点:
- Consumer 无需关心服务发现逻辑,只需要知道代理地址
- 客户端极其简单,对多语言生态友好
- 负载均衡、路由、熔断等治理能力集中在代理层,统一管控
缺点:
- 多了一次网络跳转,增加延迟
- 代理层成为单点,需要高可用部署
- 代理层需要处理所有流量,对性能要求高
2.3 直面对比
| 维度 | 客户端发现 | 服务端发现 |
|---|---|---|
| 网络跳数 | 1 跳(Consumer → Provider) | 2 跳(Consumer → Proxy → Provider) |
| 客户端复杂度 | 高(需集成 SDK) | 低(只知道代理地址) |
| 负载均衡位置 | Consumer 侧 | 代理侧 |
| 多语言支持 | 差(每种语言需 SDK) | 好(代理统一处理) |
| 治理灵活性 | 高(每个 Consumer 可定制策略) | 中(代理层统一配置) |
| 单点风险 | 无(Consumer 直连) | 有(代理层需高可用) |
| 典型实现 | Eureka、Dubbo | K8s Service、AWS ALB |
选型建议: 如果技术栈统一(全 Java),客户端发现是更高效的选择;如果多语言混合或已有成熟的网关/Service Mesh 基础设施,服务端发现更合适。现代 Service Mesh(如 Istio)实际上是服务端发现的进化形态——Sidecar 代理接管了所有流量,Consumer 和 Provider 都无需感知注册中心。
三、健康检查:注册中心的"免疫系统"
注册中心里存的是"活着"的实例,但网络抖动、GC 停顿、死锁等都可能让实例看起来活着实际上已经废了。健康检查就是用来区分"真活"和"假活"的。
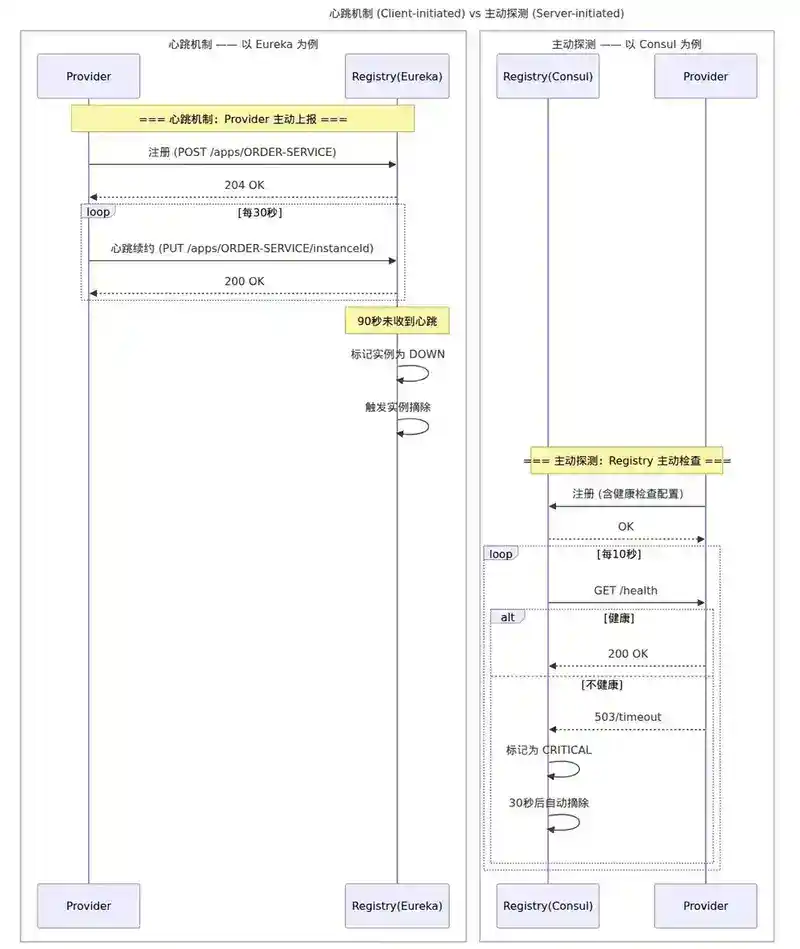
3.1 两种健康检查机制
3.1.1 心跳机制(Client-initiated)
Provider 定期向 Registry 发送心跳,Registry 在超时窗口内未收到心跳则判定实例不健康。
时间轴:
t0: Provider 注册,Registry 记录 t0
t1: 心跳到达,Registry 更新 lastHeartbeat = t1
t2: 心跳到达,Registry 更新 lastHeartbeat = t2
t3: 心跳超时未到
t3 + timeout: Registry 判定实例 DOWN,触发摘除
关键参数:
| 参数 | 典型值 | 含义 |
|---|---|---|
| 心跳间隔 | 30s | Provider 多久发一次心跳 |
| 超时阈值 | 90s | 多长时间没收到心跳算 DOWN |
| 续约间隔 | 30s | 等同于心跳间隔(Eureka 术语) |
Eureka 的自我保护机制——一个著名的坑:
Eureka 有一个"自我保护模式":如果 15 分钟内超过 85% 的实例心跳异常,Eureka 会认为这是网络分区而非实例故障,此时不会摘除任何实例。
这个设计在 CAP 理论中偏向 AP(可用性+分区容错),牺牲了一致性:宁可保留过期实例让调用失败,也不摘除可能还活着的实例。
// Eureka Server 自我保护配置
eureka.server.enable-self-preservation=true  // 默认开启
eureka.server.renewal-percent-threshold=0.85 // 续约阈值
生产建议: 在稳定的内网环境中,建议关闭自我保护,避免因网络抖动导致大量过期实例残留。
3.1.2 主动探测(Server-initiated)
Registry 主动向 Provider 发起健康检查请求(如 HTTP /health、TCP 连接、gRPC health check)。
Registry                            Provider
   │                                    │
   │──── GET /health ──────────────────→│
   │                                    │
   │←──── 200 OK ──────────────────────│  ← 健康
   │                                    │
   │──── GET /health ──────────────────→│
   │                                    │
   │←──── 503 / timeout ───────────────│  ← 不健康
   │                                    │
   │  标记为 UNHEALTHY,随后摘除         │
典型实现:Consul
Consul 支持多种检查类型:
- HTTP Check:定时 GET 一个 HTTP 端点,2xx 为健康
- TCP Check:尝试 TCP 连接,成功为健康
- Script Check:执行本地脚本,退出码 0 为健康
- gRPC Check:调用 gRPC 标准健康检查接口
- TTL Check:混合模式,Provider 周期性更新 TTL(类似心跳)
// Consul 注册时定义健康检查
{
  "service": {
    "name": "order-service",
    "port": 8080,
    "check": {
      "http": "http://localhost:8080/actuator/health",
      "interval": "10s",
      "timeout": "3s",
      "deregister_critical_service_after": "30s"
    }
  }
}
3.2 健康检查的设计权衡
心跳 vs 主动探测,怎么选?
| 维度 | 心跳(如 Eureka) | 主动探测(如 Consul) |
|---|---|---|
| Registry 压力 | 低(被动接收) | 高(主动发起,N 个实例 × 探测频率) |
| 准确度 | 低(只能判断进程存活) | 高(可以验证业务逻辑是否正常) |
| 延迟 | 依赖心跳间隔(秒级) | 依赖探测间隔(秒级) |
| 实现复杂度 | 低 | 中 |
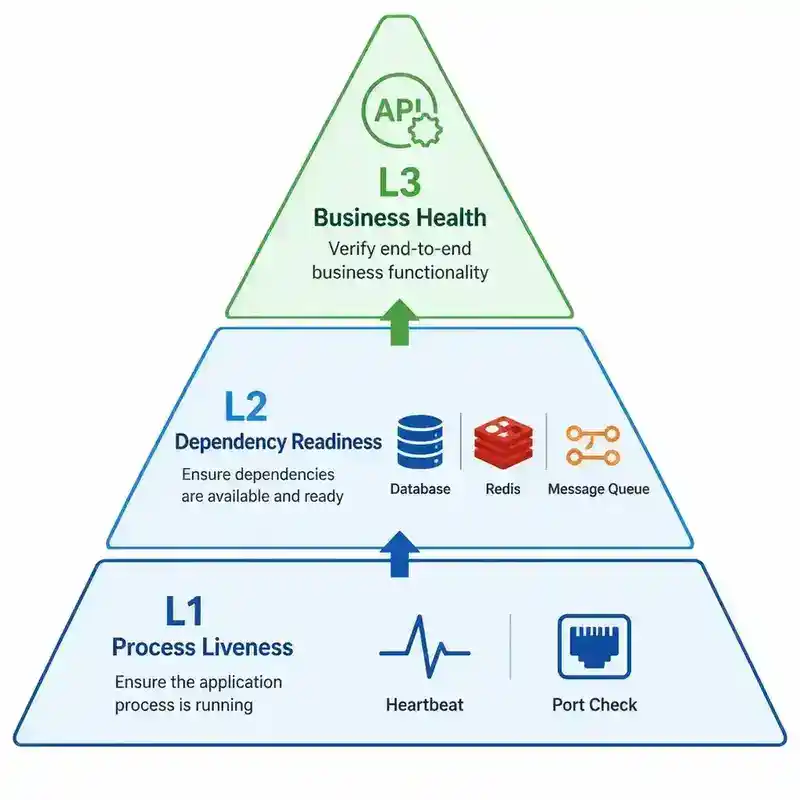
最佳实践:分层健康检查
单独靠心跳或单独靠主动探测都不够好。成熟的系统应该分层:
L1: 进程存活(心跳/端口监听)
L2: 依赖就绪(DB/Redis/MQ 连接正常)
L3: 业务健康(关键接口能正常响应)
Spring Boot Actuator 的 health 端点天然支持这种分层:
management:
  endpoint:
    health:
      show-details: always
      probes:
        enabled: true
  health:
    db:
      enabled: true    # L2: 数据库连接
    redis:
      enabled: true   # L2: Redis 连接
Kubernetes 则把三层拆成了两个探针:
- livenessProbe:进程是否活着(对应 L1)
- readinessProbe:是否准备好接受流量(对应 L2/L3)
四、实例摘除:把"僵尸"清理出去
健康检查发现不健康的实例后,下一步就是摘除——把该实例从可用列表中移除,让流量不再打过去。
4.1 摘除的策略
主动摘除(服务优雅下线):
Provider 在关闭前主动向 Registry 发送注销请求,告知"我要下线了"。
// Spring Cloud 应用通过 Actuator 优雅下线
@PreDestroy
public void shutdown() {
    // 1. 从注册中心注销
    discoveryClient.deregister();
    // 2. 等待正在处理的请求完成
    Thread.sleep(5000); // 等待负载均衡器刷新缓存
    // 3. 关闭连接池等资源
}
被动摘除(不健康判定):
Registry 检测到实例不健康后将其标记为 DOWN,并在一定时间后从注册表中删除。
关键问题:摘除不是瞬时的
从实例故障到所有 Consumer 不再调用它,存在一个"不一致窗口":
实例故障 → Registry 检测到(心跳超时 90s)→ Consumer 感知到(缓存刷新 30s)→ 流量不再打到该实例
总延迟可能达到 120s+
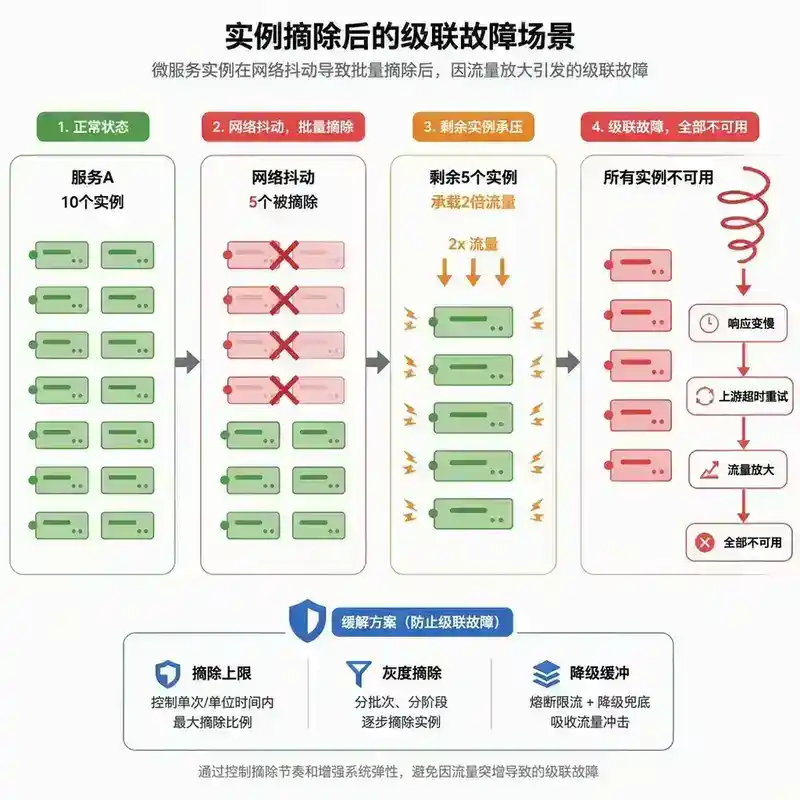
4.2 摘除后的连锁反应
摘除一个实例看似简单,但如果处理不当,可能引发雪崩:
场景:服务 A 有 10 个实例,因网络抖动,5 个实例心跳超时被摘除。
- 剩余 5 个实例突然承载 2 倍流量
- 如果 5 个实例扛不住,响应变慢
- 上游服务的超时重试进一步放大流量
- 最终全部 10 个实例都不可用
应对策略:
- 设置摘除上限:Nacos 支持配置一次最多摘除的实例比例
- 摘除前先降级:先将实例标记为"不可用"但不立即摘除,观察一段时间
- 灰度摘除:逐步减少实例权重,给 Consumer 和上游系统缓冲时间
4.3 Nacos 的健康检查与摘除机制
Nacos 的临时实例(ephemeral=true)使用心跳机制,永久实例(ephemeral=false)使用主动探测。
// Nacos 临时实例的摘除流程
// 1. 心跳超时 → 标记为 unhealthy
// 2. 超过 30s 仍为 unhealthy → 摘除实例
// 3. 通过 UDP 推送变更给所有订阅者
Nacos 1.x 的内存注册表结构:
Map<namespace, Map<group::serviceName, Service>>
  └── Service
        ├── Map<clusterName, Cluster>
        │     └── Cluster
        │           ├── Set<Instance> (临时实例)
        │           └── persistentInstances (持久实例)
        └── lastModifiedMillis
Nacos 2.x 之后,实例数据不再通过 HTTP 定时轮询同步,而是通过 gRPC 长连接推送,订阅者可以通过 notify 机制实时感知变更,延迟从秒级降到毫秒级。
五、CAP 视角下的注册中心选型
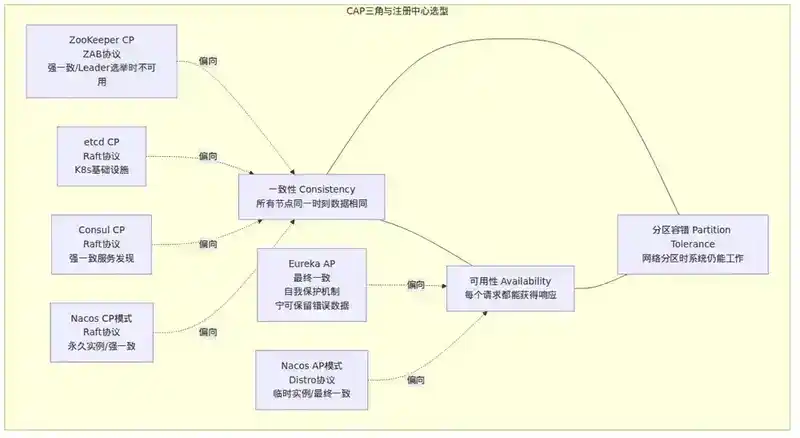
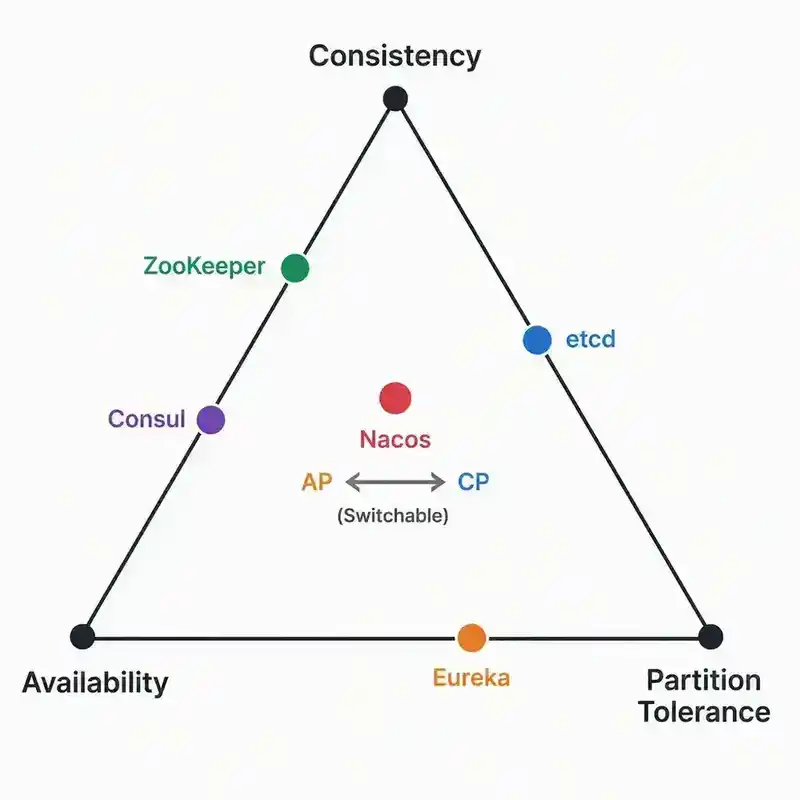
注册中心本质上是分布式存储系统,逃不开 CAP 定理。不同产品在 CAP 三角中选择了不同的位置。
| 注册中心 | CAP 偏向 | 一致性模型 | 典型场景 |
|---|---|---|---|
| Eureka | AP | 最终一致 | Netflix 内部,容忍短暂不一致 |
| Consul | CP | 强一致(Raft) | 需要强一致性的服务发现 |
| Nacos | AP/CP 可切换 | AP 模式最终一致,CP 模式强一致 | 国内主流,灵活适配 |
| ZooKeeper | CP | 强一致(ZAB) | 对一致性要求极高的场景 |
| etcd | CP | 强一致(Raft) | Kubernetes 基础设施 |
AP 模式的风险:
Eureka 的 AP 模式在发生网络分区时,两个分区的 Consumer 可能拿到不同的实例列表,各自调用各自看到的实例,可能导致数据不一致。
CP 模式的风险:
ZooKeeper 在 Leader 选举期间(通常 30s~120s),整个集群不可用,导致注册中心完全停摆——这对微服务系统来说是灾难性的。
Nacos 的 AP/CP 切换——一个聪明的设计:
// 临时实例走 AP 模式(Distro 协议)
// 特点:高可用优先,数据异步同步,短暂不一致可接受
// 适用:微服务实例注册(实例变化频繁,容忍短暂不一致)

// 永久实例走 CP 模式(Raft 协议)
// 特点:强一致性优先,数据同步确认后才返回
// 适用:配置管理(配置变更需要严格一致)
六、生产环境中的常见问题与解决方案
6.1 注册中心网络分区
现象: 注册中心集群跨机房部署,机房间网络中断。
后果:
- AP 模式:两个机房的实例列表分化,各自调用各自的,可能出现双写
- CP 模式:少数派机房失去 Leader,注册中心不可用
应对:
- 注册中心不要跨机房部署,每个机房独立部署注册中心集群
- 服务调用尽量不出机房,减少跨机房故障的爆炸半径
6.2 Consumer 缓存过期
现象: Consumer 本地缓存的实例列表已经过期,但还没有收到 Registry 的推送。
后果: 调用到已下线的实例,请求失败。
应对:
- 设置合理的缓存刷新间隔(通常 30s)
- 调用失败时立即刷新本地缓存(兜底机制)
- 使用重试机制,失败后换一个实例重试
// Dubbo 的失败重试与缓存刷新
@DubboReference(
    retries = 2,           // 失败后重试 2 次
    cluster = "failover",  // 集群容错策略
    check = false          // 启动时不检查 Provider 可用性
)
private OrderService orderService;
6.3 注册中心雪崩
现象: 大量 Provider 同时重启,瞬间向 Registry 发送注册请求,Registry 过载。
应对:
- 注册请求加入随机延迟(jitter),避免惊群效应
- Registry 做限流保护
- 分批发布,控制同时重启的实例数量
6.4 僵尸实例
现象: 实例已不可用,但因各种原因未从 Registry 中摘除。
原因:
- Provider 进程被 kill -9,没有机会发送注销请求
- 心跳机制暂时失效但 Registry 处于自我保护模式
- 网络恢复后旧实例残留
应对:
- 开启主动探测作为心跳的补充
- 设置合理的超时摘除时间
- 定期巡检 Registry 中的实例列表,清理长期未更新的记录
七、服务注册与发现的演进:Service Mesh
传统服务发现模式中,SDK 嵌入在应用进程内,这带来了几个问题:
- SDK 升级需要重新编译和发布应用
- 多语言支持困难
- 业务代码和基础设施代码耦合
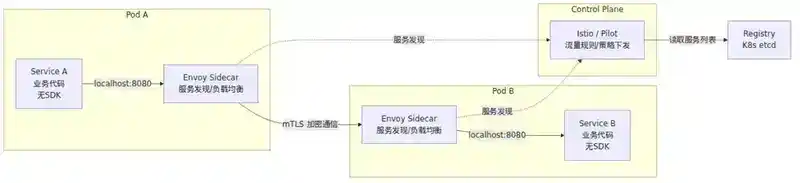
Service Mesh 将服务发现、负载均衡、熔断等能力下沉到 Sidecar 代理(如 Envoy),应用进程完全不需要关心这些:
┌──────────────────────┐        ┌──────────────────────┐
│    Service A         │        │    Service B         │
│  (业务代码, 无 SDK)   │        │  (业务代码, 无 SDK)   │
│                      │        │                      │
│  http://localhost/   │        │  http://localhost/   │
└──────────┬───────────┘        └──────────┬───────────┘
           │                               │
┌──────────▼───────────┐        ┌──────────▼───────────┐
│   Envoy Sidecar      │ ←mTLS→ │   Envoy Sidecar      │
│   (服务发现/负载均衡)  │        │   (服务发现/负载均衡)  │
└──────────┬───────────┘        └──────────┬───────────┘
           │                               │
           └───────────┬───────────────────┘
                       │
              ┌────────▼────────┐
              │  Control Plane  │
              │  (Istio/Pilot)  │
              └────────┬────────┘
                       │
              ┌────────▼────────┐
              │   Registry      │
              │   (K8s etcd)    │
              └─────────────────┘
这是服务端发现模式的终极形态,但不要被"高大上"迷惑——Sidecar 代理也带来了额外的资源消耗(每个 Pod 多一个 Envoy 容器)和调试复杂度。
八、面试官视角:高频追问
以下是面试中围绕"服务注册与发现"常见的高阶追问,建议在理解上述内容的基础上准备。
Q1:Eureka 的自我保护机制是什么?为什么要设计它?在什么场景下应该关闭?
参考答案: Eureka 的自我保护机制是:当 15 分钟内超过 85% 的客户端实例心跳异常时,Eureka Server 不会摘除任何实例,而是进入"自我保护模式",保留所有已注册的实例。设计初衷是应对网络分区——如果因为网络故障导致大量实例心跳丢失,Eureka 会认为这是网络问题而非实例故障,避免误摘除。设计哲学是"宁可保留错误数据,也不丢失正确数据"。关闭场景: 在内网稳定环境中,网络分区的概率极低,此时自我保护更可能掩盖真实的实例故障,建议关闭并设置合理的超时时间。
Q2:如果注册中心本身挂了,Consumer 和 Provider 之间的调用还能继续吗?什么条件下可以?
**参考答案:**可以继续,但前提是 Consumer 有本地缓存。Eureka Client 会缓存一份服务实例列表到本地,即使 Eureka Server 全部宕机,Consumer 仍能根据缓存里的地址调用 Provider。但有两个限制:① 新的 Provider 实例无法注册,Consumer 感知不到;② 已下线的实例不会被摘除,可能导致调用失败。Dubbo 也有类似机制——Consumer 从 Registry 订阅后本地缓存,Registry 宕机不影响已有调用。这也是为什么注册中心应该优先保证可用性(AP)而非一致性(CP)。
Q3:Nacos 的临时实例和永久实例有什么区别?分别在什么场景下使用?
参考答案:****临时实例基于心跳机制,由 Provider 主动上报健康状态,超时未续约则自动摘除;使用 Distro 协议(AP 模式),数据最终一致。永久实例由 Nacos Server 主动探测健康状态,不会被自动摘除(需手动或 API 操作);使用 Raft 协议(CP 模式),数据强一致。场景: 微服务实例(Pod/容器)频繁启停、扩缩容,用临时实例;数据库、缓存等基础设施地址相对固定,用永久实例。
Q4:描述一个你遇到的因注册中心问题导致的生产故障,怎么排查和解决的?
考察点: 实战经验、故障排查思路、系统理解深度。
典型场景: 某次发布后,调用方日志大量 No instances available 异常。排查发现:发布时新旧实例切换期间,Provider 的新实例注册成功但还未通过健康检查,旧实例已经注销,Consumer 缓存刷新恰好在这个空窗期触发,导致列表中无可用实例。解决:① 调整优雅下线策略,旧实例在关闭前等待 2 倍缓存刷新周期;② 开启 Consumer 的失败重试机制;③ 调整健康检查探测频率,加快新实例就绪速度。
Q5:服务发现和负载均衡是什么关系?为什么说"服务发现解决了 '找谁' 的问题,负载均衡解决了 '找哪个' 的问题"?
参考答案: 服务发现负责维护"有哪些可用实例"这个集合,负载均衡负责从这个集合中"选一个来调用"。可以用一个类比:服务发现是电话簿,负载均衡是拨号逻辑——电话簿告诉你这个人的所有号码,但你先打哪个、打不通时换哪个,是负载均衡的事。两者通常配合使用:客户端发现模式下,Consumer 从 Registry 拉取实例列表后,在本地通过 Round Robin、随机、加权、一致性哈希等算法选择一个实例;服务端发现模式下,代理层同时承担了发现和负载均衡的职责。
Q6:为什么 Kubernetes 的 Service 不需要应用集成 SDK 就能实现服务发现?
参考答案: Kubernetes 使用的是服务端发现模式。① 每个 Service 创建时会分配一个固定的 ClusterIP 和一个 DNS 名称(如 my-service.default.svc.cluster.local);② kube-proxy 在每个 Node 上维护 iptables/IPVS 规则,将对 ClusterIP 的请求转发到后端 Pod;③ CoreDNS 提供集群内 DNS 解析,Pod 通过 DNS 名称访问 Service,完全不需要知道 Pod IP。应用只需要知道 Service 名称,剩下的全部由 K8s 基础设施处理。代价是:多了一次网络跳转(请求经过 kube-proxy),且 iptables 规则数和 Pod 数量成正比,大规模集群下规则爆炸是已知问题(IPVS 模式可以缓解)。
总结
服务注册与发现是微服务架构的"通讯录",没有它,微服务之间的调用就是盲人摸象。核心要点:
- 客户端发现 vs 服务端发现:前者直连低延迟但 SDK 侵入,后者架构简单但有代理层开销
- 健康检查:心跳(快但不准)和主动探测(准但贵)各有优劣,推荐分层检查
- 实例摘除:不是瞬时的,存在不一致窗口,需要优雅下线和兜底策略
- CAP 权衡:注册中心优先选 AP,宁可短暂不一致也不要完全不可用
- Service Mesh:未来的方向,但不要为了新潮而引入不必要的复杂度
下一考点预告:178|Nacos 原理:注册中心、配置中心、AP/CP 模式和推拉结合。