阅读时间:约 45 分钟 难度:中高级 前置知识:微服务基础架构、分布式系统基本原理
引言
微服务架构将单体拆分为独立部署的服务单元,每个服务可独立扩缩容、独立迭代。但拆分也带来了分布式系统固有的复杂性:一个服务的故障可能像多米诺骨牌一样推倒整个系统。故障治理不是"出了事再修",而是一套贯穿设计、开发、测试、运维全周期的系统性工程实践。
本文从四个维度展开:级联故障的根因与阻断、流量控制的策略与实现、故障演练的方法论、自愈能力的构建。读完你将理解:为什么 Netflix 的 Chaos Monkey 要在生产环境随机杀实例?为什么 Sentinel 的滑动窗口比固定窗口更精确?为什么重试不是越多越好?
一、级联故障:从单点异常到全局雪崩
1.1 什么是级联故障
级联故障(Cascading Failure) 是指分布式系统中,一个组件的故障引发依赖它的其他组件也相继故障,最终导致整个系统不可用。这个过程像多米诺骨牌:第一张倒下后,连锁反应不可阻挡。
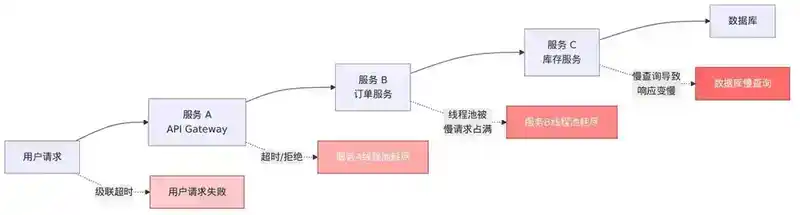
经典案例:假设服务 A 调用服务 B,服务 B 调用服务 C。如果 C 的数据库发生慢查询,导致 C 响应变慢,B 的线程池被 C 的慢请求占满,A 调用 B 也开始超时,最终整个调用链全部阻塞。
1.2 级联故障的三种典型模式
模式一:线程池耗尽(Thread Pool Exhaustion)
每个服务通常使用线程池处理请求。当下游服务响应变慢时,上游的线程会长时间阻塞等待响应,线程池逐渐被占满。新的请求到来时无法获取线程,直接被拒绝或超时。
请求 → [服务A 线程池满] → 超时
         ↓ 等待
       [服务B 线程池满] → 超时
         ↓ 等待
       [服务C 响应慢]
关键指标:线程池活跃线程数、队列长度、拒绝次数。
模式二:重试风暴(Retry Storm)
当一个请求失败后,调用方自动重试。如果重试策略不当,一个下游的短暂抖动可能被上游的重试放大数倍甚至数十倍,形成"重试风暴"。
假设服务 A 每秒 1000 QPS 调用服务 B,B 出现 1 秒抖动导致 10% 失败。如果 A 配置了 3 次重试,那么这 1 秒内:
- 正常请求:900 次
- 失败请求:100 次,触发 300 次重试
- 总计 B 收到的请求:900 + 300 = 1200 次
重试放大了 20% 的流量,可能让 B 的抖动变成彻底崩溃。
模式三:资源争抢(Resource Contention)
多个服务共享同一资源(数据库连接池、Redis 连接、CPU、内存),一个服务的异常使用导致其他服务无法获取资源。例如,一个服务的慢 SQL 占满数据库连接池,导致所有依赖该数据库的服务都不可用。
1.3 阻断级联故障的核心武器
熔断器(Circuit Breaker)
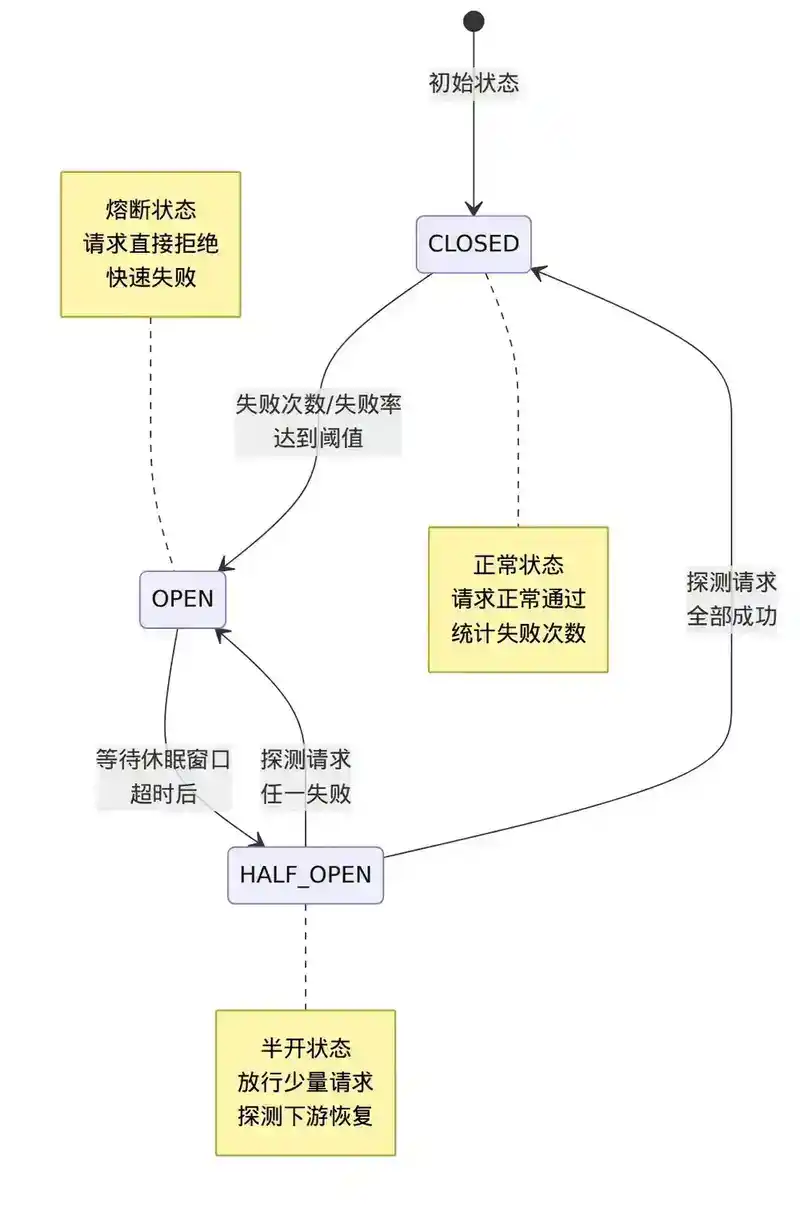
熔断器是阻断级联故障最经典的机制,灵感来自电气工程中的断路器。
三种状态:
         ┌──────────┐
         │  CLOSED  │ ← 正常状态,请求正常通过
         └────┬─────┘
              │ 失败次数达到阈值
              ▼
         ┌──────────┐
         │   OPEN   │ ← 熔断状态,请求直接拒绝(快速失败)
         └────┬─────┘
              │ 等待一段时间(Sleep Window)
              ▼
         ┌──────────┐
         │ HALF_OPEN│ ← 半开状态,放行少量请求探测
         └────┬─────┘
              │ 探测成功 → CLOSED
              │ 探测失败 → OPEN
              ▼
关键参数:
- 失败阈值:滑动窗口内失败次数或失败率超过阈值时触发熔断
- 休眠窗口:熔断后等待多久进入半开状态
- 半开最大请求数:半开状态下允许通过的探测请求数
- 慢调用阈值:响应时间超过此值也计入失败(Resilience4j 支持)
Resilience4j 熔断器示例:
CircuitBreakerConfig config = CircuitBreakerConfig.custom()
    .failureRateThreshold(50)          // 失败率 50% 触发熔断
    .slowCallRateThreshold(50)         // 慢调用率 50% 触发熔断
    .slowCallDurationThreshold(Duration.ofSeconds(2))  // 超过 2s 算慢调用
    .slidingWindowType(SlidingWindowType.COUNT_BASED)  // 基于计数
    .slidingWindowSize(10)             // 窗口大小 10 次
    .minimumNumberOfCalls(5)           // 最少 5 次调用才开始计算
    .waitDurationInOpenState(Duration.ofSeconds(10))  // 熔断 10s
    .permittedNumberOfCallsInHalfOpenState(3)  // 半开放行 3 次
    .build();

CircuitBreaker circuitBreaker = CircuitBreaker.of("backendService", config);

// 使用熔断器包装调用
Supplier<String> decorated = CircuitBreaker.decorateSupplier(
    circuitBreaker, () -> backendService.call()
);
Sentinel 熔断规则:
DegradeRule rule = new DegradeRule("resourceName")
    .setGrade(RuleConstant.DEGRADE_GRADE_EXCEPTION_RATIO)  // 异常比例
    .setCount(0.5)       // 异常比例阈值 50%
    .setTimeWindow(10);  // 熔断时长 10s
DegradeRuleManager.loadRules(Collections.singletonList(rule));
Sentinel 支持三种熔断策略:
- 慢调用比例:响应时间超过最大 RT 的请求比例
- 异常比例:异常数占总请求数的比例
- 异常数:分钟级异常数绝对值
舱壁隔离(Bulkhead)
舱壁模式借鉴了船舶设计:船体被分成多个密封舱,一个舱进水不会导致整船沉没。
两种实现方式:
1. 线程池隔离:为不同下游服务分配独立的线程池。
// Hystrix 线程池隔离(已停维,但思想值得理解)
@HystrixCommand(
    threadPoolKey = "serviceA-pool",
    threadPoolProperties = {
        @HystrixProperty(name = "coreSize", value = "10"),
        @HystrixProperty(name = "maxQueueSize", value = "5")
    }
)
2. 信号量隔离:限制同时访问某个资源的并发数。
// Resilience4j 信号量舱壁
BulkheadConfig config = BulkheadConfig.custom()
    .maxConcurrentCalls(10)     // 最大并发调用数
    .maxWaitDuration(Duration.ofMillis(100))  // 等待超时
    .build();

Bulkhead bulkhead = Bulkhead.of("serviceB", config);
线程池隔离 vs 信号量隔离:
| 维度 | 线程池隔离 | 信号量隔离 |
|---|---|---|
| 隔离程度 | 强(不同线程池) | 弱(仅限制并发数) |
| 开销 | 大(线程切换、队列) | 小(仅计数器) |
| 超时控制 | 支持异步超时 | 不支持 |
| ThreadLocal 传递 | 需要额外处理 | 天然支持 |
| 适用场景 | 对外部依赖的高隔离要求 | 对内部服务的高性能隔离 |
重试策略的理性设计
重试不是越多越好,需要遵循以下原则:
1. 退避(Backoff):重试间隔应逐渐增大,避免瞬时冲击。
// 指数退避
long waitTime = (long) (Math.pow(2, retryCount) * baseInterval);
// retryCount=0: 1s, retryCount=1: 2s, retryCount=2: 4s, retryCount=3: 8s
2. 抖动(Jitter):在退避基础上增加随机偏移,避免多个客户端同时重试形成"惊群效应"。
long waitTime = (long) (Math.pow(2, retryCount) * baseInterval
    + ThreadLocalRandom.current().nextLong(0, 1000));
3. 幂等性保证:重试的请求必须是幂等的,否则重复执行可能造成数据错误。
4. 熔断感知:重试应在熔断器未打开时进行,熔断期间不应重试。
5. 超时控制:每次重试请求都要有独立的超时时间,且总超时不应超过上游可接受的等待时间。
超时与快速失败
超时是最基本也最容易被忽视的防护手段。没有超时,一个慢请求会无限期占用线程。
// HTTP 客户端超时配置
HttpClient client = HttpClient.newBuilder()
    .connectTimeout(Duration.ofSeconds(1))  // 连接超时
    .build();

HttpRequest request = HttpRequest.newBuilder()
    .uri(URI.create("http://service-b/api"))
    .timeout(Duration.ofSeconds(3))  // 请求超时
    .build();
超时配置的黄金法则:
- 超时时间应小于上游调用方的超时时间(避免上游先超时)
- 连接超时 < 读取超时 < 总超时
- 超时不宜过短(正常请求可能被误杀),也不宜过长(故障时线程占用太久)
二、流量控制:在洪峰中守住底线
2.1 为什么要做流量控制
微服务架构中,每个服务的容量是有限的。当流量超过服务容量时,如果不对流量进行控制,服务会:
- 响应变慢 → 线程池堆积 → 内存暴涨 → OOM(Out of Memory)
- 数据库连接耗尽 → 所有请求失败
- 级联影响上游服务
流量控制的目标是:在服务过载时,优雅地拒绝超出能力的请求,保证核心功能的可用性。
2.2 限流算法对比
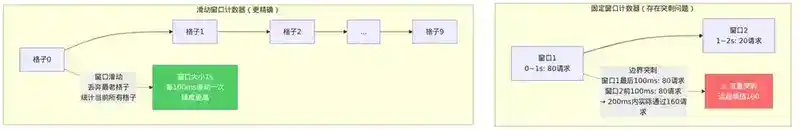
固定窗口计数器
时间线:|--窗口1--|--窗口2--|--窗口3--|
请求数:   80         20         90
阈值:100
问题:在窗口边界可能产生流量突刺。例如,窗口 1 的最后 100ms 来了 80 个请求,窗口 2 的前 100ms 来了 80 个请求,在 200ms 内实际通过了 160 个请求,远超阈值。
滑动窗口计数器
将时间窗口细分为多个小格子,统计时滑动计算。
窗口大小:1s,格子数:10(每个格子 100ms)
             [0][1][2][3][4][5][6][7][8][9]
当前时间 →
每 100ms 滑动一次窗口,丢弃最老的格子,统计当前窗口内的请求总数。这比固定窗口更精确,但仍存在"格子边界"问题。
滑动窗口日志(Sliding Window Log)
记录每个请求的时间戳,统计最近 N 秒内的请求数。精度最高,但内存开销大。
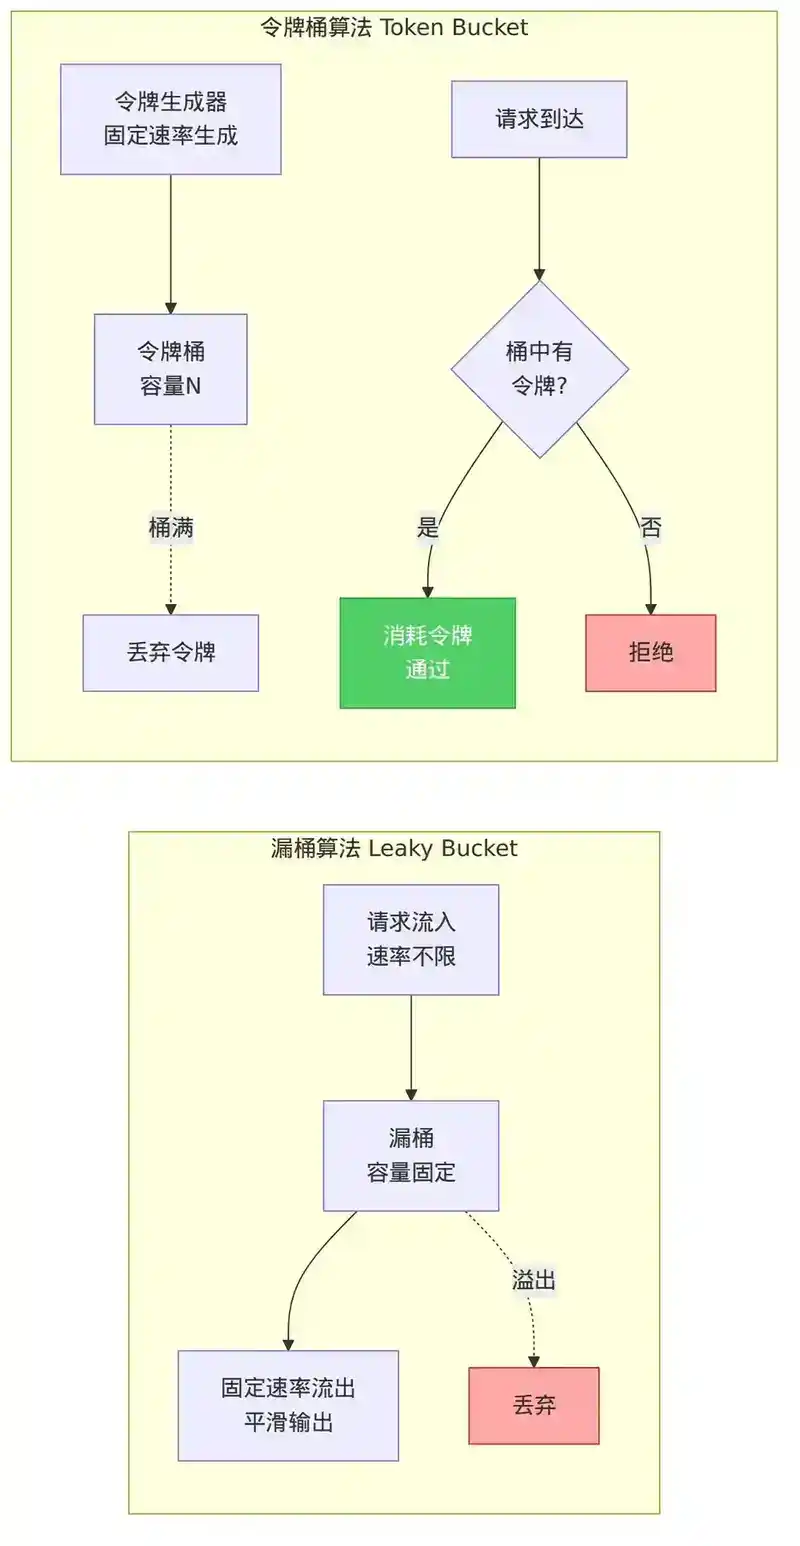
漏桶(Leaky Bucket)
请求先进入漏桶,以固定速率流出。不管进入速率多快,流出速率恒定。
请求 → → → → [漏桶] → → →(固定速率流出)
      ↓ 溢出丢弃
特点:强制平滑输出,适用于需要严格控制输出速率的场景。
令牌桶(Token Bucket)
以固定速率生成令牌放入桶中,桶满则丢弃令牌。请求到达时消耗一个令牌,无令牌则拒绝。
令牌生成器 → → [令牌桶: 容量 N] → 请求消耗令牌
                     ↓ 桶满丢弃令牌
特点:允许一定的突发流量(桶内积累的令牌可一次性消费),更加灵活。Sentinel 默认使用令牌桶算法。
2.3 Sentinel 流量控制实战
Sentinel 是阿里巴巴开源的流量治理组件,提供了丰富的流控策略。
核心概念:
- 资源(Resource):需要保护的代码块,可以是方法、接口等
- 规则(Rule):对资源的流控规则
- Entry:进入一个资源的入口,资源调用结束时退出
流控规则示例:
// QPS 限流:每秒最多 100 个请求
FlowRule rule = new FlowRule("getUserById")
    .setGrade(RuleConstant.FLOW_GRADE_QPS)  // 按 QPS 限流
    .setCount(100);  // QPS 阈值
FlowRuleManager.loadRules(Collections.singletonList(rule));
基于调用关系的流控策略:
FlowRule rule = new FlowRule("resource")
    .setStrategy(RuleConstant.STRATEGY_RELATE)  // 关联流控
    .setRefResource("writeResource");

// 当 writeResource 达到阈值时,限制 resource 的流量
// 典型场景:写操作繁忙时,限制读操作,保证写入优先
链路流控(只限制入口资源):
FlowRule rule = new FlowRule("resource")
    .setStrategy(RuleConstant.STRATEGY_CHAIN)
    .setRefResource("entryA");

// 只限制从 entryA 入口访问 resource 的流量
流控效果:
// 1. 直接拒绝(默认)
rule.setControlBehavior(RuleConstant.CONTROL_BEHAVIOR_DEFAULT);

// 2. 匀速排队(漏桶效果)
rule.setControlBehavior(RuleConstant.CONTROL_BEHAVIOR_RATE_LIMITER)
    .setMaxQueueingTimeMs(500);  // 最长排队时间

// 3. 冷启动(预热)
rule.setControlBehavior(RuleConstant.CONTROL_BEHAVIOR_WARM_UP)
    .setWarmUpPeriodSec(10);  // 预热时长 10s
2.4 负载丢弃(Load Shedding)
当系统负载超过阈值时,主动丢弃部分请求,优先保证核心功能。
丢弃策略:
- 随机丢弃:最简单的策略,但不区分请求重要性
- 优先级丢弃:根据请求的优先级矩阵决定丢弃哪些请求
- 按比例降级:丢弃非核心功能,保留核心功能
Netflix 的 Adaptive Concurrency Limit:
Netflix 使用梯度算法(Gradient Algorithm)动态调整并发限制。核心思想:通过观察系统指标(如延迟),动态调整并发上限,当延迟开始上升时减小并发限制,延迟下降时增大并发限制。
// Netflix concurrency-limits 库的核心算法
// 使用 Vegas 算法(类似 TCP Vegas)
// 通过 RTT 变化探测系统是否过载

long currentLimit = 100;
long rtt = measureRTT();  // 当前往返时间
long minRtt = getMinRTT(); // 历史最小 RTT

if (rtt > minRtt * 2) {
    // RTT 显著增加,减小并发限制
    currentLimit = currentLimit / 2;
} else {
    // RTT 正常,逐步增加并发限制
    currentLimit = currentLimit + 1;
}
2.5 背压(Backpressure)
背压是一种下游通知上游"我处理不过来了,慢一点"的机制。在响应式编程中,背压是核心概念。
实现方式:
- 应用层:通过请求头传递限流信号(如
X-RateLimit-Remaining) - 协议层:HTTP/2 的流控、TCP 的滑动窗口、gRPC 的 flow control
- 消息队列:消费者拉取模式天然支持背压
// Reactor 的背压机制
Flux.range(1, 1000)
    .onBackpressureBuffer(100)  // 缓冲 100 个元素
    .subscribe(new BaseSubscriber<Integer>() {
        @Override
        protected void hookOnSubscribe(Subscription subscription) {
            request(10);  // 初始只请求 10 个
        }
        @Override
        protected void hookOnNext(Integer value) {
            process(value);
            request(1);  // 处理完一个再请求下一个
        }
    });
三、故障演练:在可控的混乱中建立信心
3.1 混沌工程(Chaos Engineering)
混沌工程由 Netflix 在 2010 年提出,核心理念是:与其等待故障发生,不如主动注入故障,验证系统的容错能力。
混沌工程的五个原则(来自《混沌工程》一书):
- 建立稳态假设:定义系统正常运行的指标(如延迟、错误率、吞吐量)
- 多样化现实事件:模拟真实世界中可能发生的故障
- 在生产环境运行:预发环境无法完全模拟生产环境的行为
- 自动化持续运行:混沌实验应成为持续集成的一部分
- 最小化爆炸半径:控制实验的影响范围,避免造成大面积故障
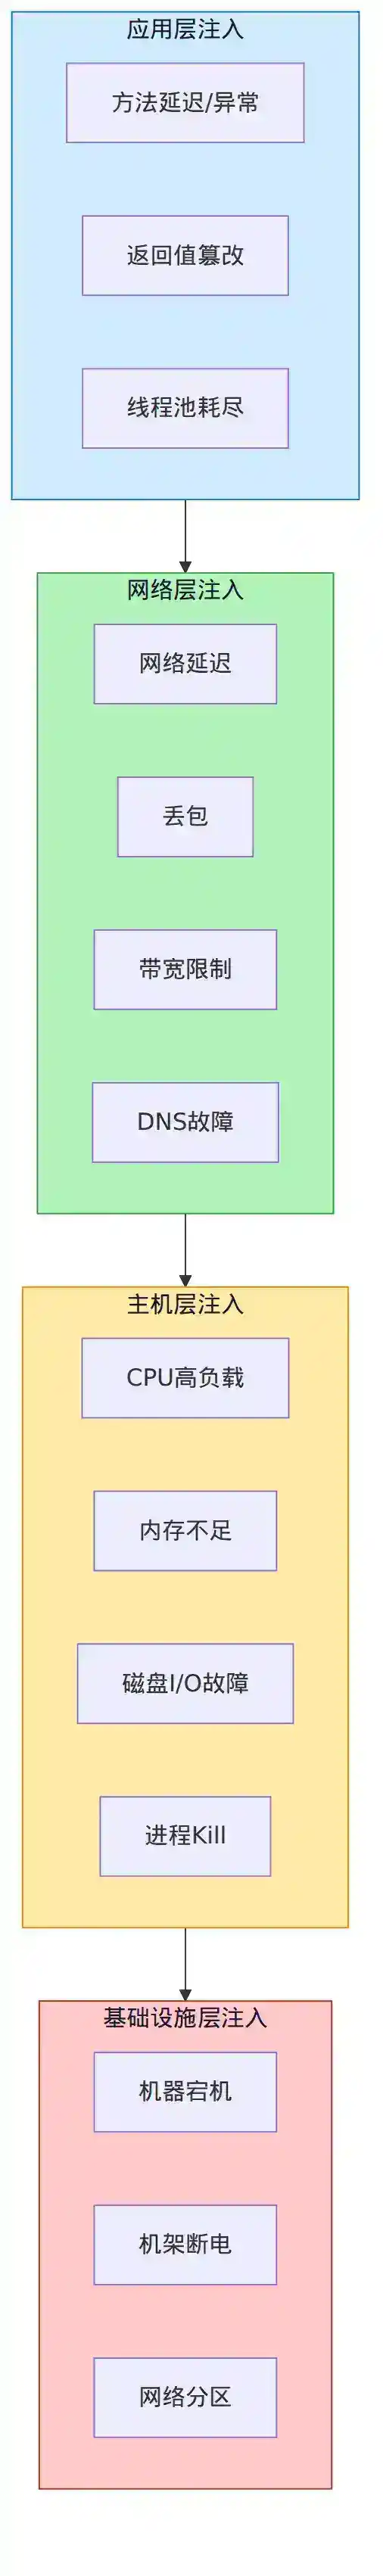
3.2 故障注入层次
从底层到上层,故障注入可以分为多个层次:
┌─────────────────────────────────┐
│        应用层注入                │
│  - 方法延迟/异常                 │
│  - 返回值篡改                    │
│  - 线程池耗尽                    │
├─────────────────────────────────┤
│        网络层注入                │
│  - 网络延迟                      │
│  - 丢包                          │
│  - 带宽限制                      │
│  - DNS 故障                      │
├─────────────────────────────────┤
│        主机层注入                │
│  - CPU 高负载                    │
│  - 内存不足                      │
│  - 磁盘 I/O 故障                 │
│  - 进程 Kill                      │
├─────────────────────────────────┤
│        基础设施层注入             │
│  - 机器宕机                      │
│  - 机架断电                      │
│  - 数据中心网络分区               │
└─────────────────────────────────┘
3.3 混沌工程工具选型
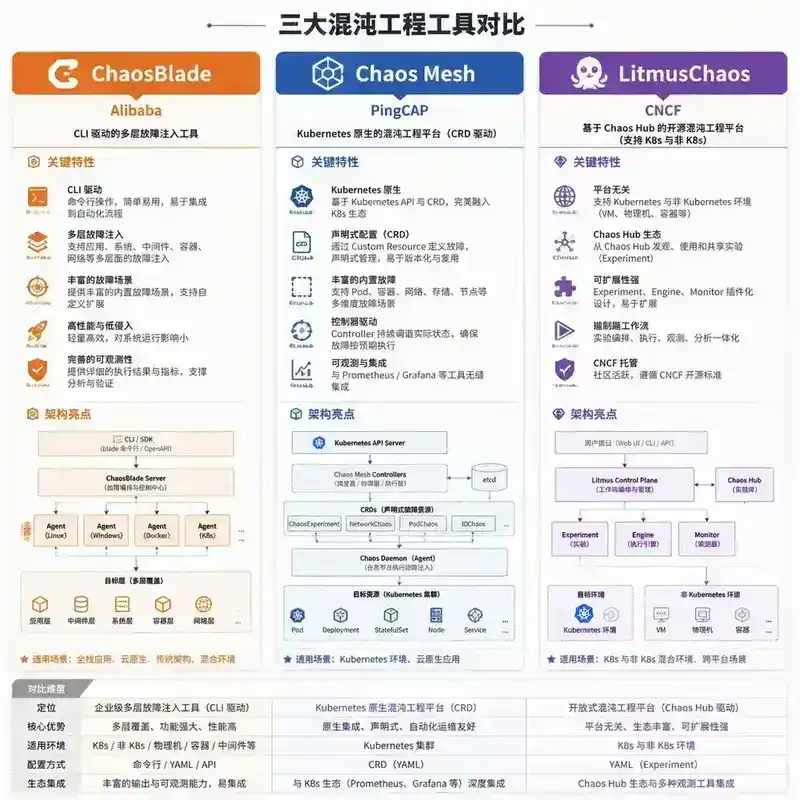
ChaosBlade(阿里开源)
ChaosBlade 支持多层次的故障注入,使用简单:
# CPU 负载注入:CPU 使用率提升到 60%
blade create cpu load --cpu-percent 60

# 网络延迟注入:eth0 网卡延迟 3s,偏移 100ms
blade create network delay --time 3000 --offset 100 --interface eth0

# 磁盘 I/O 故障注入:磁盘读负载 80%
blade create disk burn --read --path /data

# 进程 Kill:杀掉指定进程
blade create process kill --process java

# 实验结束
blade destroy <uid>
Chaos Mesh(PingCAP 开源)
Chaos Mesh 是 Kubernetes 原生的混沌工程平台,通过 CRD 定义混沌实验:
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata:
  name: web-show-network-delay
spec:
  action: delay
  mode: one
  selector:
    namespaces:
      - default
    labelSelectors:
      "app": "web-show"
  delay:
    latency: "10ms"
    correlation: "100"
    jitter: "0ms"
  duration: "30s"
LitmusChaos
LitmusChaos 是 CNCF 项目,提供丰富的混沌实验 Hub,支持 Kubernetes 和非 Kubernetes 环境。
3.4 故障演练的完整流程
阶段一:演练计划
1. 确定演练目标:验证哪个系统的哪个容错能力?
2. 定义稳态指标:哪些指标正常才算系统正常?
3. 选择故障类型:注入什么故障?
4. 确定爆炸半径:影响范围多大?如何回滚?
5. 制定终止条件:什么情况下立即停止实验?
阶段二:演练执行
1. 通知相关人员
2. 确认监控和告警正常
3. 注入故障
4. 观察系统行为
5. 记录指标变化
阶段三:复盘与改进
1. 系统是否按预期容错?
2. 是否有预期外的故障传播?
3. 告警是否及时触发?
4. 恢复时间是否在 SLA 范围内?
5. 形成改进 Action Item
3.5 生产环境演练的最佳实践
Netflix 的实践经验表明,真正有效的混沌工程必须在生产环境进行。但生产环境演练需要严格的安全控制:
- 从小范围开始:先在单个实例上实验,再扩展到多个实例
- 吃饭时间演练:选择流量低谷期进行
- 随时可终止:实验触发自动熔断,系统可一键回滚
- 可观测性先行:充分监控后再开始实验
- 渐进式复杂度:从简单故障(CPU 高负载)到复杂故障(网络分区)
四、自愈:让系统自己修复自己
4.1 自愈的三个层次
层次一:被动自愈(Reactive)
故障发生后,系统通过健康检查发现异常,触发恢复动作。
# Kubernetes 健康检查
livenessProbe:
  httpGet:
    path: /health
    port: 8080
  initialDelaySeconds: 30
  periodSeconds: 10
  failureThreshold: 3  # 连续 3 次失败后重启 Pod
层次二:主动自愈(Proactive)
系统监控指标趋势,在故障发生前采取预防措施。
// 内存使用率超过 80% 时主动触发 GC 并发出告警
if (memoryUsage > 0.8) {
    System.gc();  // 主动 GC
    alertManager.send("内存使用率过高,当前: " + memoryUsage);
}
层次三:智能自愈(Intelligent)
系统基于历史数据和机器学习模型,自动判断最优恢复策略。
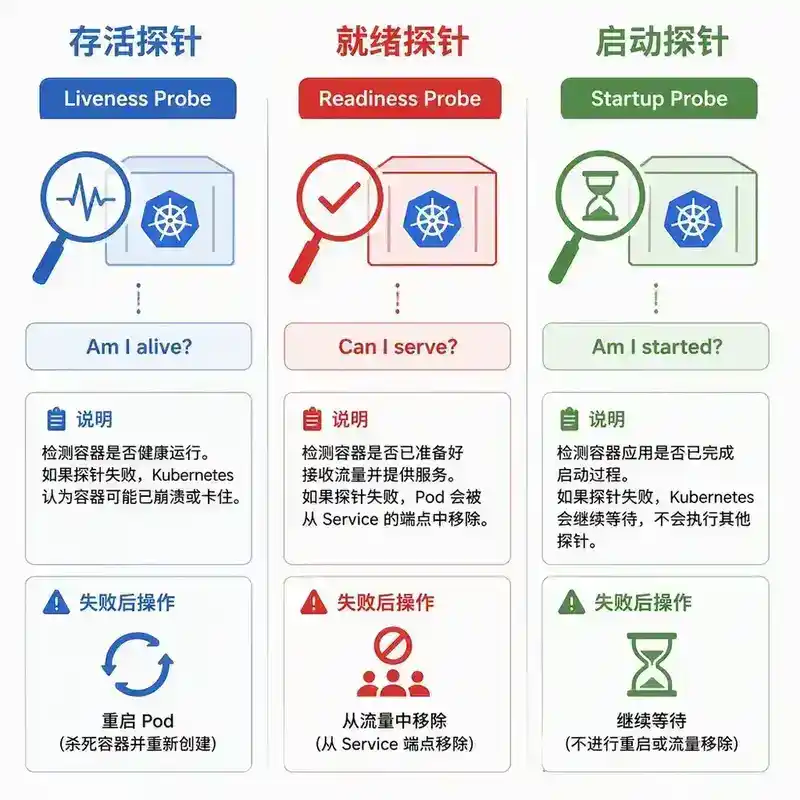
4.2 健康检查的三种模式
┌──────────────┐  ┌──────────────┐  ┌──────────────┐
│  Liveness    │  │  Readiness   │  │  Startup     │
│  Probe       │  │  Probe       │  │  Probe       │
├──────────────┤  ├──────────────┤  ├──────────────┤
│ "我还活着吗?"│  │ "能接请求吗?"│  │ "启动完了吗?"│
│              │  │              │  │              │
│ 失败 → 重启  │  │ 失败 → 摘流  │  │ 失败 → 等待  │
│              │  │              │  │              │
│ 频繁检查      │  │ 频繁检查     │  │ 仅启动时检查  │
└──────────────┘  └──────────────┘  └──────────────┘
Liveness 和 Readiness 的关键区别:
- Liveness 探针失败意味着进程已死或僵死,唯一选择是重启
- Readiness 探针失败意味着进程还活着但暂时不能服务(如连接池满了、正在预热),应从负载均衡中摘除,但不重启
Liveness 探针的常见陷阱:
- 探针依赖外部服务(如数据库)→ 外部服务故障导致所有 Pod 重启
- 探针过重(执行复杂逻辑)→ 探针本身消耗大量资源
- 探针过轻(只检查端口)→ 进程僵死时探针仍通过
4.3 自动扩缩容(Auto Scaling)
自愈的一个重要维度是自动扩缩容:当系统负载上升时自动扩容,负载下降时自动缩容。
Kubernetes HPA(Horizontal Pod Autoscaler):
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
  - type: Pods
    pods:
      metric:
        name: http_requests_per_second
      target:
        type: AverageValue
        averageValue: "1000"
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300  # 缩容前等待 5 分钟
      policies:
      - type: Percent
        value: 10
        periodSeconds: 60
    scaleUp:
      stabilizationWindowSeconds: 0    # 扩容立即触发
      policies:
      - type: Percent
        value: 100
        periodSeconds: 15
4.4 故障自愈的自动化流程
一个完整的自愈流程包含以下步骤:
1. 检测(Detect)
   ↓ 监控告警 / 健康检查失败
2. 诊断(Diagnose)
   ↓ 日志分析 / 指标关联 / 链路追踪
3. 决策(Decide)
   ↓ 从预定义策略中选择恢复操作
4. 执行(Execute)
   ↓ 重启、扩容、降级、切流、回滚
5. 验证(Verify)
   ↓ 确认服务恢复,指标恢复正常
6. 闭环(Close)
   ↓ 记录事件,更新知识库,触发改进
恢复策略矩阵:
| 故障类型 | 恢复策略 | 恢复时间 | 自动化程度 |
|---|---|---|---|
| 进程 Crash | 重启 Pod | 秒级 | 全自动 |
| 内存泄漏 | 定期重启 + 告警 | 分钟级 | 半自动 |
| 慢 SQL | 自动 Kill 慢查询 + 告警 | 分钟级 | 半自动 |
| 依赖服务故障 | 熔断 + 降级 | 秒级 | 全自动 |
| 数据不一致 | 人工介入 | 小时级 | 手动 |
| 网络分区 | 牺牲一致性/可用性 | 分钟级 | 半自动 |
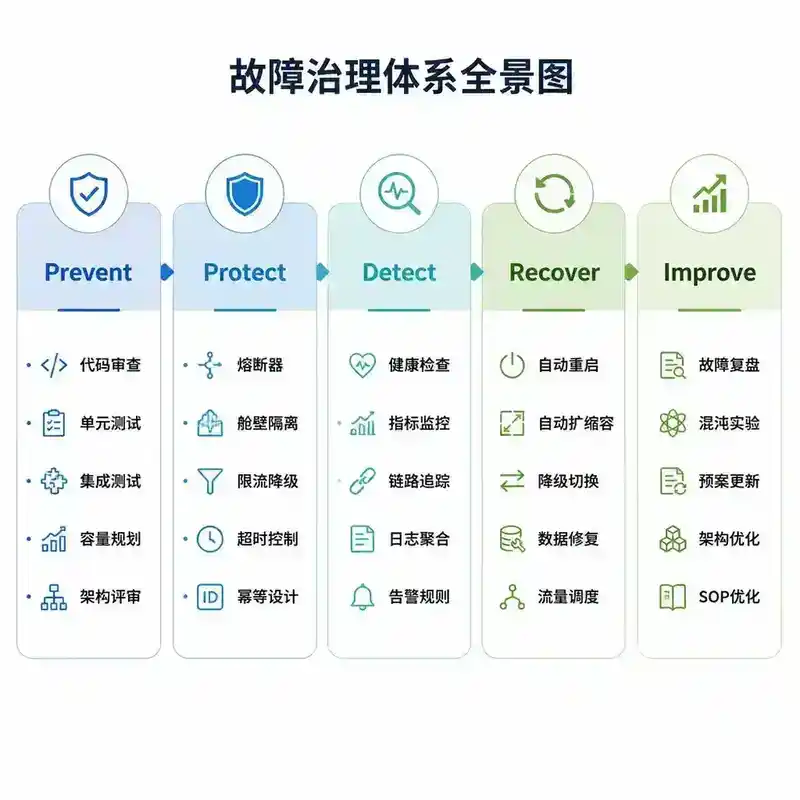
五、故障治理体系的全景图
将以上四个维度整合,形成完整的故障治理体系:
                    ┌─────────────────────────────────┐
                    │       故障治理体系全景           │
                    └─────────────────────────────────┘
                                    │
        ┌───────────┬───────────────┼───────────────┬───────────┐
        ▼           ▼               ▼               ▼           ▼
   ┌─────────┐ ┌─────────┐   ┌─────────┐     ┌─────────┐ ┌─────────┐
   │ 预防    │ │ 防护    │   │ 检测    │     │ 恢复    │ │ 改进    │
   │Prevent  │ │Protect  │   │Detect   │     │Recover  │ │Improve  │
   └────┬────┘ └────┬────┘   └────┬────┘     └────┬────┘ └────┬────┘
        │           │             │               │           │
   ·代码审查    ·熔断器       ·健康检查        ·自动重启    ·故障复盘
   ·单元测试    ·舱壁隔离     ·指标监控        ·自动扩缩容  ·混沌实验
   ·集成测试    ·限流降级     ·链路追踪        ·降级切换    ·预案更新
   ·容量规划    ·超时控制     ·日志聚合        ·数据修复    ·架构优化
   ·架构评审    ·幂等设计     ·告警规则        ·流量调度    ·SOP 优化
5.1 技术选型参考
| 能力 | 开源方案 | 云厂商方案 |
|---|---|---|
| 熔断/限流 | Sentinel, Resilience4j | AWS Service Quotas, GCP Quota |
| 服务网格 | Istio, Linkerd | AWS App Mesh, ASM |
| 混沌工程 | ChaosBlade, Chaos Mesh, Litmus | AWS FIS, GCP Chaos |
| 可观测性 | Prometheus + Grafana, SkyWalking | CloudWatch, ARMS |
| 自动扩缩 | K8s HPA/VPA, KEDA | AWS Auto Scaling, AS |
六、面试官视角提问
以下问题从面试官视角出发,考察候选人对故障治理的深度理解和实践经验。每题附参考答案。
Q1:你在项目中遇到过最严重的级联故障是什么?根因是什么?你是如何"止血"和"根治"的?
考察点:故障排查能力、应急响应经验、系统性思维。
参考答案:
面试官期待的答案应当包含三个层次:
故障场景:以典型的"线程池耗尽 → 级联超时"为例。某次大促期间,订单服务调用库存服务的 RT 从 50ms 飙升至 5s,原因是库存服务依赖的 Redis 集群发生主从切换。订单服务的 Tomcat 线程池(200 线程)在 3 秒内被全部占满,进而导致网关层超时,用户端大量报错。
止血方案(1-3 分钟内):
- 立即摘除库存服务的故障节点,切流到备集群
- 对订单服务的
/order/create接口做手动限流,降至正常 QPS 的 50% - 重启订单服务实例,释放堆积的线程池
根治方案(事后):
- 为订单服务接入熔断器(Sentinel),当库存服务错误率 > 50% 时自动熔断
- 设置合理的超时时间(连接超时 1s + 读取超时 3s),避免线程无限期等待
- 引入舱壁隔离,为库存服务调用分配独立线程池(20 线程),防止其耗尽主线程池
- Redis 集群增加哨兵监控,缩短故障转移时间
Q2:一个服务调用链为 A → B → C,B 配置了 3 次重试(指数退避,初始间隔 100ms),C 配置了 2 次重试。如果 C 有 10% 概率超时,A 的一个请求在最坏情况下会产生多少次对 C 的调用?这种重试放大效应如何治理?
考察点:重试风暴的定量分析,以及系统化治理思路。
参考答案:
定量分析:A 发 1 次请求 → B 收到 1 次。B 调用 C 时,如果 C 超时,B 最多重试 3 次,即 B 最多调用 C 共 4 次(1 次原始 + 3 次重试)。C 每次收到请求后如果内部超时,C 最多重试 2 次,即每个到达 C 的请求最多产生 3 次内部调用。因此最坏情况:1 × 4 × 3 = 12 次。如果链路上还有更多跳,放大效应呈指数增长。
治理方案:
- 重试上限:全链路总重试次数不超过 3 次,通过请求头传递
x-retry-count,每跳递减 - 退避 + 抖动:指数退避(100ms → 200ms → 400ms)+ 随机抖动(±50ms),避免惊群
- 熔断感知:重试前检查熔断器状态,已熔断则直接失败不重试
- 幂等保证:所有重试请求携带幂等键(如
idempotency-key),下游通过去重表保证只执行一次 - 超时总和约束:每个请求携带
x-deadline-ms(截止时间),链路上每跳的超时时间之和不超过截止时间
Q3:Sentinel 的滑动窗口和固定窗口计数器在限流精度上有什么区别?如果在 1 秒窗口的前 100ms 来了 100 个请求,后 900ms 没有请求,固定窗口和滑动窗口分别会怎样处理窗口边界处的请求?
考察点:限流算法的深入理解,以及能否识别边界条件问题。
参考答案:
固定窗口问题:假设限流阈值 100 QPS。窗口 1(0s-1s)的前 100ms 来了 100 个请求,全部通过。窗口 1 的后 900ms 没有请求。窗口 2(1s-2s)的前 100ms 又来了 100 个请求,全部通过。在 200ms 的时间窗口内(窗口 1 末尾 100ms + 窗口 2 开头 100ms),实际通过了 200 个请求——是阈值的 2 倍。这就是"临界突刺"问题。
滑动窗口改进:Sentinel 将 1 秒窗口划分为 N 个格子(默认 2 个,可通过 sampleCount 配置)。每个格子独立计数,窗口滑动时丢弃最老的格子,用当前窗口内所有格子的计数之和判断是否限流。当窗口 2 的请求到来时,窗口 1 前 100ms 的请求计数已被丢弃,当前窗口统计的是窗口 1 后 900ms(0 请求)+ 窗口 2 前 100ms(100 请求)= 100,不超过阈值,不会误限。
滑动窗口的局限性:格子数是固定的,如果请求恰好集中在格子边界,仍可能出现微小的精度偏差。但通过增加格子数(如 10 个格子,每个 100ms),可以将偏差控制在可接受范围内。
画图说明(面试时建议在白板上画出时间轴):
固定窗口:|==窗口1(100通过)==|==窗口2(100通过)==|  → 200ms内通过200,超限
滑动窗口:|格1(100)|格2(0)|  → 滑动后:|格2(0)|格3(100)|  → 100,不超限
Q4:你如何设计一个生产环境的混沌实验?从计划到执行到复盘,每一步需要考虑什么?爆炸半径如何控制?
考察点:混沌工程的实践经验和方法论。
参考答案:
实验计划(最重要的阶段):
- 明确假设:例如"订单服务在库存服务延迟 3s 时,应在 500ms 内返回降级响应"
- 定义稳态指标:业务指标(下单成功率 > 99.9%)+ 技术指标(P99 延迟 < 200ms,错误率 < 0.1%)
- 选择故障类型:网络延迟注入(对库存服务的 50% 流量注入 3s 延迟)
- 控制爆炸半径:
- 范围:仅影响 1 个可用区的 2 个 Pod(共 10 个 Pod)
- 流量:通过服务网格给 20% 流量染色,只对染色流量注入故障
- 时间:选择业务低峰期(凌晨 3 点),实验时长 5 分钟
- 制定终止条件:下单成功率 < 95% 持续 30 秒,或 P99 延迟 > 1s,立即终止实验
执行过程:
- 提前 30 分钟通知值班人员和相关团队
- 确认监控大盘、告警规则正常
- 通过 ChaosBlade 注入故障:
blade create network delay --time 3000 --interface eth0 --percent 50 - 实时观察稳态指标变化
- 实验结束后执行
blade destroy清理
复盘输出:
- 系统是否按预期容错?(熔断器是否在 2s 内触发?降级逻辑是否生效?)
- 是否有预期外的故障传播?(是否影响了其他服务?)
- 告警是否及时?(从故障注入到告警触发的延迟是多少?)
- 恢复时间是否达标?(故障停止后,服务多久恢复正常?)
- 形成 Action Item:如"熔断器阈值需要从 50% 调整为 30%""降级响应需要增加缓存兜底"
Q5:Kubernetes 的 Liveness Probe 和 Readiness Probe 有什么区别?如果一个服务的 Liveness Probe 检查了数据库连接,会有什么问题?请给出正确的探针设计。
考察点:对健康检查模式的深入理解,以及能否识别反模式。
参考答案:
核心区别:
| 维度 | Liveness Probe | Readiness Probe |
|---|---|---|
| 语义 | "进程还活着吗?" | "能接请求吗?" |
| 失败动作 | 重启 Pod(kubelet 杀进程) | 从 Service Endpoint 摘除 |
| 检查内容 | 死锁、无限循环、进程僵死 | 依赖就绪、连接池可用、预热完成 |
| 频率 | 应该较低 | 可以较高 |
| 恢复方式 | 重启后重建所有状态 | 重新加入 Endpoint 即可 |
Liveness 检查数据库连接的问题(经典反模式):
数据库短暂故障(如主从切换 5s)
  → 所有 Pod 的 Liveness 探针连接数据库失败
  → Kubelet 杀掉所有 Pod 并重启
  → 新 Pod 启动时也需要连接数据库来初始化
  → 数据库压力更大,恢复更慢
  → 探针继续失败,Pod 循环重启
  → 服务彻底不可用,远超原始故障影响
正确设计:
- Liveness Probe:只检查进程本身——如
/health/liveness端点仅返回 200(不访问任何外部依赖)。如果进程僵死(如死锁导致 HTTP 端口不响应),探针自然失败。 - Readiness Probe:可以检查数据库连接池可用性、Redis 连接状态等。失败时摘除流量但不重启,给依赖服务恢复的时间窗口。
- 为 Liveness 设置更长的
initialDelaySeconds(如 60s)和failureThreshold(如 5 次),避免启动阶段误杀。
Q6:在微服务架构中,重试、超时、熔断、限流、舱壁这些机制应该如何协同工作?它们之间有依赖关系吗?请画出它们的协作顺序,并说明每个机制的职责边界。
考察点:系统化思维,能否理解各机制之间的协作关系。
参考答案:
协作顺序(一次请求的完整经过):
请求到达
  ↓
[1. 限流] —— 是否超过系统容量?超过 → 快速拒绝(429 Too Many Requests)
  ↓ 通过
[2. 舱壁] —— 是否有可用的隔离资源?无 → 拒绝(信号量/线程池满)
  ↓ 获取资源
[3. 熔断检查] —— 下游是否已熔断?是 → 快速失败(CircuitBreakerOpenException)
  ↓ 未熔断
[4. 执行调用] —— 发起 HTTP/RPC 调用
  ↓
[5. 超时控制] —— 是否在 deadline 内返回?超时 → TimeoutException
  ↓ 成功
[6. 返回结果]
  ↓ 失败(超时/异常)
[7. 重试判断] —— 是否可重试?(幂等?次数未超?熔断未开?)
  ↓ 是 → 回到步骤 4(带退避+抖动)
  ↓ 否
[8. 熔断记录] —— 本次失败计入熔断器统计
  ↓
[9. 降级返回] —— 返回兜底结果或抛出异常
职责边界:
- 限流:保护自身,控制入口流量不超过系统容量
- 舱壁:资源隔离,防止一个下游的问题耗尽所有资源
- 熔断:快速失败,防止反复调用已故障的下游
- 超时:线程保护,防止无限期等待
- 重试:提高成功率,但需幂等+退避+熔断感知
协同关键点:
- 重试前必须检查熔断器状态,熔断期间不重试
- 重试的超时时间要小于原始超时,且总超时不超过上游 deadline
- 限流应分层:网关层全局限流 + 服务层接口限流 + 方法级热点限流
- 熔断和舱壁可以组合使用:同一服务的不同接口用不同舱壁,每个舱壁有独立熔断器
总结
微服务故障治理不是单一的"熔断"或"限流",而是一套贯穿全生命周期的系统工程:
- 级联故障是分布式系统的固有风险,需要熔断器、舱壁隔离、理性重试、超时控制等多层防护
- 流量控制是服务过载时的最后防线,从固定窗口到滑动窗口到令牌桶,算法选择决定精度和性能
- 故障演练是把"未知的未知"变成"已知的已知"的手段,混沌工程不是"搞破坏",而是"建立信心"
- 自愈能力是系统成熟度的标志,从被动重启到主动预防到智能决策,自动化程度越高,运维负担越低
记住:故障一定会发生,区别在于你是有备而来还是措手不及。
下一篇预告:191|架构质量属性:可用性、性能、扩展性、安全性、可维护性和成本