一、开篇:微服务入口的"守门人"
想象一个场景:你的公司有 200+ 微服务,每个服务都有自己的鉴权逻辑、限流策略、日志格式、CORS 配置。有一天安全团队要求所有接口统一加上 JWT 校验,你需要在 200 个服务里逐一修改代码、测试、上线——这显然是灾难。
API 网关(API Gateway)就是为了解决这类问题而生的。它位于客户端和后端服务之间,是所有请求的统一入口。无论你用的是 Spring Cloud Gateway、Kong、APISIX 还是 Envoy,网关的本质职责都是:把公共关注点从业务服务中剥离,集中到网关层处理。
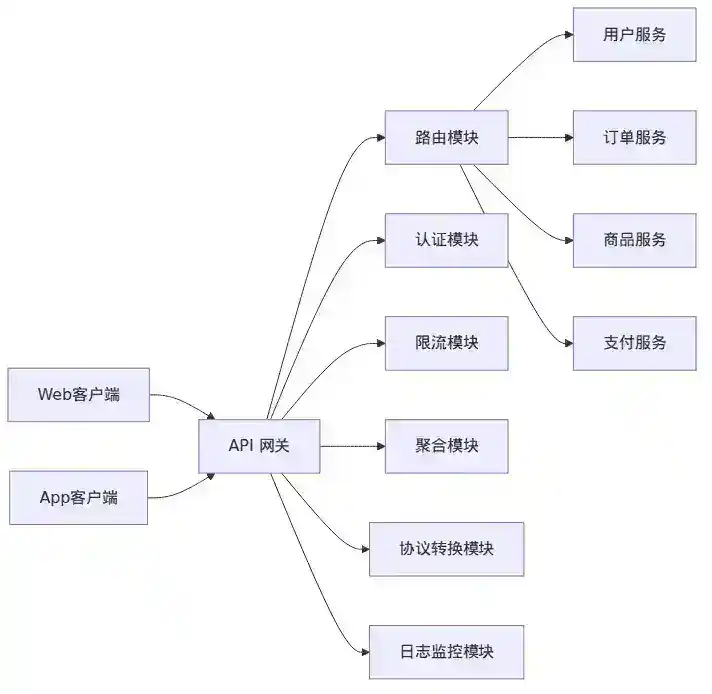
这篇文章将从路由、认证、限流、聚合、协议转换、高可用六个维度,深入剖析 API 网关的设计原理与工程实践。
二、路由:请求的"智能导航"
2.1 路由的本质
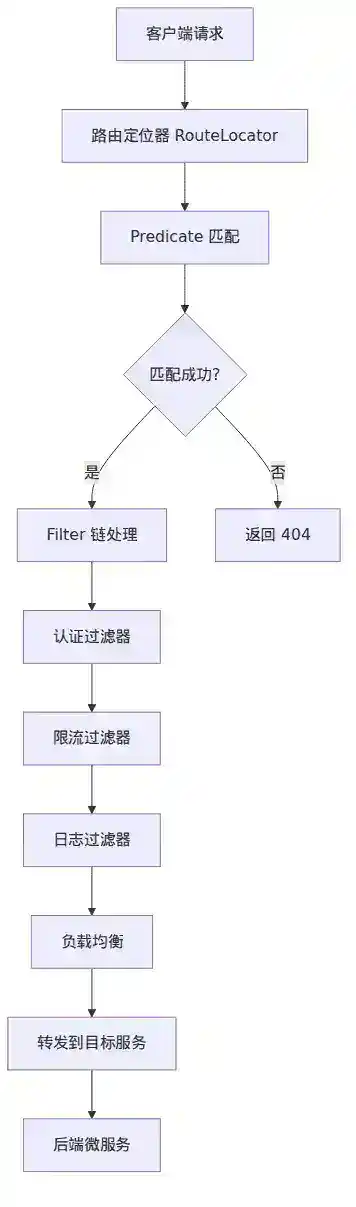
路由是网关最基本的功能:根据请求的 URL、Header、参数等特征,将请求转发到对应的后端服务。听起来简单,但工程实践中有大量细节。
路由的核心数据结构:
public class Route {
    private String id;                    // 路由唯一标识
    private List<Predicate> predicates;   // 匹配条件(谓词)
    private List<Filter> filters;         // 过滤器链
    private URI uri;                      // 目标服务地址
    private int order;                    // 优先级(越小越优先)
}
Spring Cloud Gateway 采用 Predicate + Filter 模型,其中 Predicate 来自 Java 8 的 java.util.function.Predicate,Filter 是 WebFlux 的 GatewayFilter。
2.2 路由匹配策略
路由匹配远不止 URL 前缀匹配这么简单,常见策略包括:
| 策略 | 示例 | 说明 |
|---|---|---|
| Path 匹配 | /api/user/**** |
最常用,按路径前缀 |
| Header 匹配 | X-Region: cn-east |
按请求头分流 |
| Query 参数 | ?version=v2 |
灰度发布常用 |
| Host 匹配 | user.api.company.com |
按域名分流 |
| Method 匹配 | GET/POST/PUT | 按 HTTP 方法 |
| Cookie 匹配 | env=gray |
灰度染色 |
| 权重路由 | 80%→v1, 20%→v2 | 金丝雀发布 |
| 自定义谓词 | 按 IP 段、时间段等 | 灵活扩展 |
2.3 动态路由的实现
静态路由只能应对固定拓扑,生产环境需要动态路由——路由规则变更后无需重启网关。
实现方案:
- 配置中心推送:路由规则存储在 Nacos/Apollo/Consul 中,变更时推送通知网关刷新。Spring Cloud Gateway 通过
RouteDefinitionRepository接口支持。 - 事件驱动刷新:网关监听配置变更事件(如 Spring Cloud 的
RefreshScope),增量更新路由表,而非全量重建。 - 数据库 + 缓存:路由规则存 MySQL,网关启动时加载到本地缓存,变更时通过消息队列(如 Kafka)通知所有网关节点刷新。
关键代码示意(Spring Cloud Gateway 动态路由):
@Component
public class DynamicRouteService {
    @Autowired
    private RouteDefinitionWriter routeDefinitionWriter;

    public void addRoute(RouteDefinition definition) {
        routeDefinitionWriter.save(Mono.just(definition)).subscribe();
    }

    public void updateRoute(RouteDefinition definition) {
        routeDefinitionWriter.delete(Mono.just(definition.getId()));
        routeDefinitionWriter.save(Mono.just(definition)).subscribe();
    }
}
2.4 路由的性能考量
路由匹配是每个请求的必经之路。当路由数量从几十增长到几百甚至上千时,线性遍历所有 Predicate 的代价不可忽视。
优化手段:
- 前缀树(Trie)索引:对 Path 类型谓词建立 Trie 树,O(n) 降到 O(k),k 为路径长度。
- 谓词排序:将匹配概率高的路由排在前面,减少平均匹配次数。
- 缓存匹配结果:对相同 URL 模式的请求,缓存路由查找结果。
三、认证与鉴权:安全的"统一关卡"
3.1 认证(Authentication)vs 鉴权(Authorization)
- 认证:你是谁?——验证用户身份,产出 token/凭证。
- 鉴权:你能做什么?——基于角色/权限判断是否允许访问某资源。
网关层主要负责认证,将用户身份信息透传给下游服务;鉴权逻辑通常由各服务自行处理,或通过网关的粗粒度鉴权(如 RBAC 角色校验)做第一道过滤。
3.2 JWT 认证流程
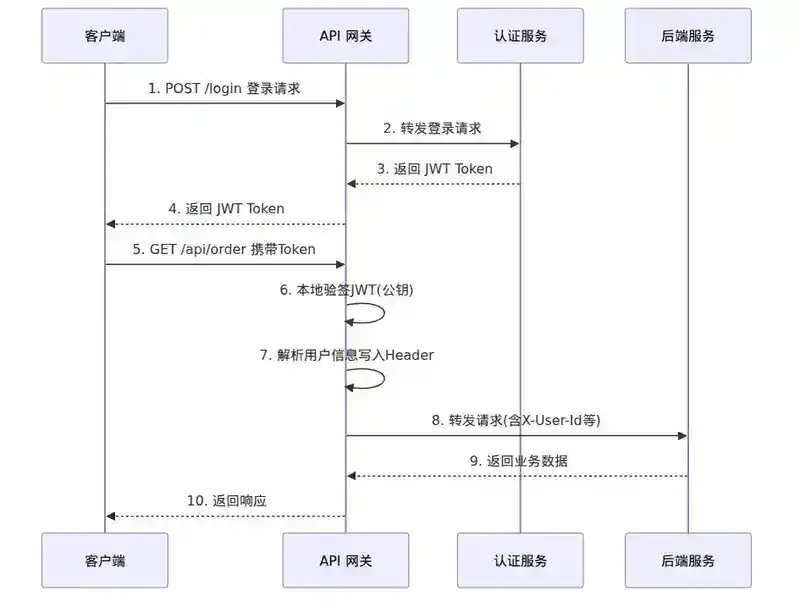
网关验证 JWT 的关键逻辑:
// 伪代码:网关 JWT 过滤器
public class JwtAuthFilter implements GlobalFilter {
    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        String token = extractToken(exchange.getRequest());
        if (token == null) {
            return unauthorized(exchange, "缺少认证令牌");
        }
        try {
            Claims claims = Jwts.parser()
                .setSigningKey(publicKey)  // 公钥验签,无需访问认证服务
                .parseClaimsJws(token)
                .getBody();
            // 将用户信息写入请求头,透传给下游
            exchange.getRequest().mutate()
                .header("X-User-Id", claims.getSubject())
                .header("X-User-Role", claims.get("role", String.class));
            return chain.filter(exchange);
        } catch (JwtException e) {
            return unauthorized(exchange, "令牌无效或已过期");
        }
    }
}
3.3 认证方案的选型对比
| 方案 | 原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| JWT 无状态 | 网关本地验签 | 高性能,不依赖认证服务 | 无法主动踢人,token 体积大 | 内部服务间调用 |
| OAuth2 + Token 校验 | 网关调认证服务验 token | 安全性高,可主动撤销 | 每次请求多一次 RPC | 对外 API |
| Session + Redis | 网关查 Redis 获取 session | 成熟稳定,可控性强 | Redis 成为瓶颈 | 传统 Web 应用 |
| mTLS | 双向证书认证 | 零信任,安全性极高 | 证书管理复杂 | 服务网格内部 |
3.4 认证架构的演进
阶段一:网关直接认证 — 网关持有用户凭证,直接验证。简单但耦合。
阶段二:网关 + 独立认证服务 — 网关转发认证请求到独立服务,解耦但不减少网络开销。
阶段三:网关本地验签(JWT)+ 认证服务兜底 — 这是最常用的生产方案。网关用公钥本地验签 JWT,无需调用认证服务;token 过期或被吊销时,才回源认证服务。
四、限流:保护后端的"安全阀"
4.1 为什么需要限流
限流不是"限制用户",而是保护系统。当流量超过系统容量时,如果没有限流,系统会尝试处理所有请求 → 资源耗尽 → 响应变慢 → 调用方超时重试 → 更多请求涌入 → 雪崩。
限流在网关层实施是最佳位置:请求还没到达业务服务就被拦截,保护效果最好。
4.2 限流算法深度对比
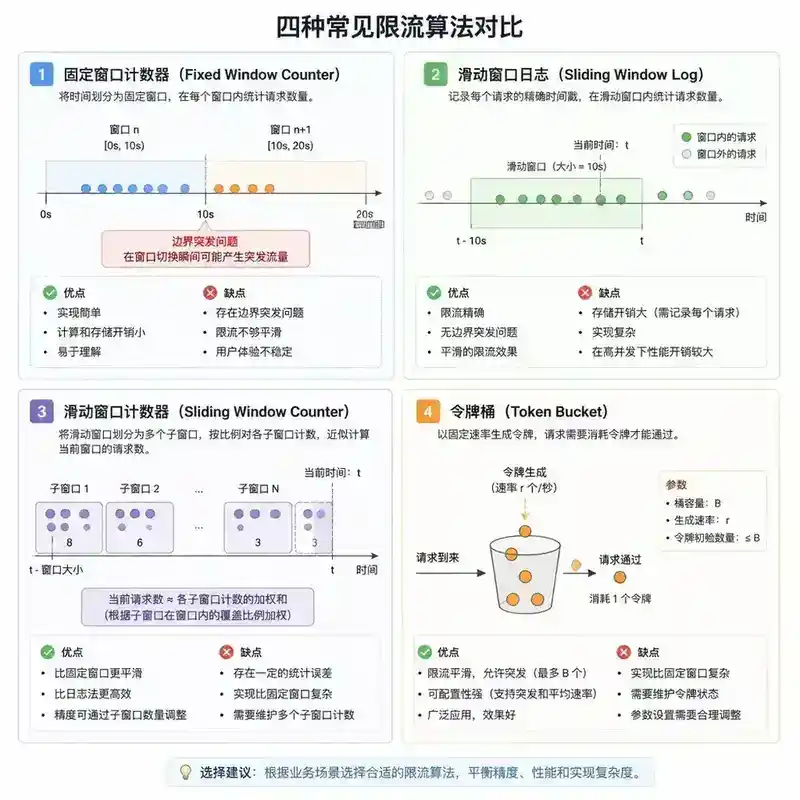
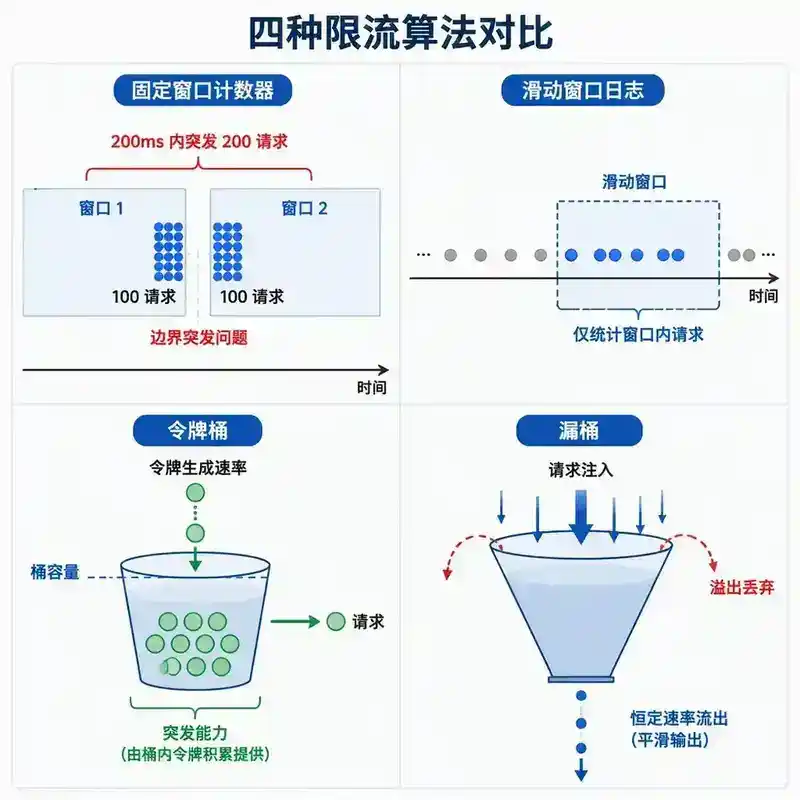
4.2.1 固定窗口计数器
问题:窗口边界突发。假设限制 100 QPS,在窗口 1 的最后 100ms 和窗口 2 的最初 100ms 内,实际上可以涌入 200 个请求,这 200ms 内的实际 QPS 是 200/0.2 = 1000。
4.2.2 滑动窗口日志
记录每个请求的时间戳,判断过去一个窗口内有多少请求。精确但内存开销大。
4.2.3 滑动窗口计数器(常用折中)
将窗口切分为多个小格子(如 1 秒窗口切为 10 个 100ms 格子),当前窗口计数 = 当前窗口内所有格子计数之和。解决了边界突发问题,且内存可控。
4.2.4 令牌桶(Token Bucket)
目前最主流的限流算法,Spring Cloud Gateway 和 Sentinel 都默认使用。
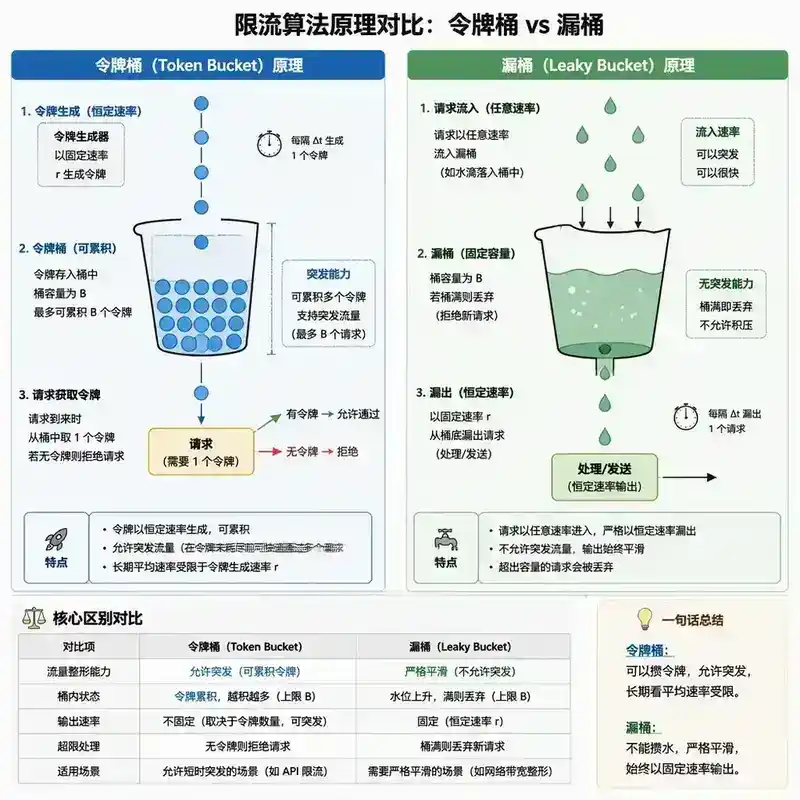
核心参数:
- rate:令牌生成速率(如 100/s)
- burst:桶容量,允许的突发流量(如 200)
优点:允许一定程度的突发流量(桶里的令牌可以累积),同时限制长期平均速率。
4.2.5 漏桶(Leaky Bucket)
请求进入漏桶,以恒定速率"漏出"处理。比令牌桶更严格——完全平滑流量,不允许突发。
4.3 分布式限流的挑战
单机限流用 Guava RateLimiter 即可,但网关通常是多节点部署,需要分布式限流。
核心问题:多节点共享同一个限流计数器,需要原子操作。
Redis 实现方案:
-- Redis Lua 脚本:滑动窗口限流
local key = KEYS[1]              -- 限流 key
local window = tonumber(ARGV[1]) -- 窗口大小(毫秒)
local limit = tonumber(ARGV[2])  -- 限制数量
local now = tonumber(ARGV[3])    -- 当前时间戳

-- 移除窗口外的过期记录
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)
-- 当前窗口内请求数
local count = redis.call('ZCARD', key)
if count < limit then
    redis.call('ZADD', key, now, now .. '-' .. math.random())
    redis.call('PEXPIRE', key, window)
    return 1  -- 放行
else
    return 0  -- 限流
end
工程实践:Sentinel 的集群限流方案通过 Token Server 统一分配令牌,避免了 Redis 的额外依赖,且支持自动故障转移——Token Server 不可用时降级为单机限流。
4.4 限流的多维度设计
实际生产环境的限流远不止"每个用户 100 QPS"这么简单:
| 维度 | 示例 | 说明 |
|---|---|---|
| 用户级 | 每用户 100 QPS | 防止单个用户滥用 |
| IP 级 | 每 IP 1000 QPS | 防止爬虫/攻击 |
| API 级 | /api/payment 50 QPS | 核心接口严格限流 |
| 服务级 | user-service 5000 QPS | 保护下游服务容量 |
| 租户级 | SaaS 不同套餐不同额度 | 商业限流 |
| 全局级 | 整个网关 10 万 QPS | 兜底保护 |
五、聚合:化零为整的"数据编排"
5.1 什么是 API 聚合
在微服务架构中,一个页面可能需要调用多个服务才能完成渲染。例如电商商品详情页:
- 商品基本信息(商品服务)
- 库存信息(库存服务)
- 价格信息(价格服务)
- 评价信息(评价服务)
- 推荐信息(推荐服务)
如果让客户端依次调用 5 个服务,会增加网络延迟和客户端复杂度。网关的聚合功能可以将这 5 个请求合并为一个,由网关并行调用后端服务并组装结果。
5.2 聚合的实现方式
方式一:网关层编排(BFF 模式)
BFF(Backend for Frontend)为每种客户端(Web、iOS、Android)提供专属的聚合接口。网关并行调用多个下游服务,组装后返回。
方式二:GraphQL 聚合
GraphQL 天然支持聚合——客户端声明需要哪些字段,网关自动从多个数据源拉取。
5.3 聚合的工程挑战
(1)响应超时与部分失败
并行调用 5 个服务,1 个超时怎么办?策略:
- 快速失败:任一失败则整体失败(严格一致性场景)
- 降级返回:失败的服务返回默认值/缓存数据(用户体验优先)
- 超时熔断:设置合理超时,超时后跳过该服务
(2)结果组装与数据一致性
各服务返回格式不统一,需要一个统一的响应模型。Spring Cloud Gateway 可以通过自定义 GatewayFilter 实现:
// 聚合过滤器伪代码
public class AggregationFilter implements GlobalFilter {
    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        // 并行调用多个下游服务
        Mono<Product> productMono = webClient.get()
            .uri("http://product-service/api/product/" + productId)
            .retrieve().bodyToMono(Product.class);

        Mono<Inventory> inventoryMono = webClient.get()
            .uri("http://inventory-service/api/inventory/" + productId)
            .retrieve().bodyToMono(Inventory.class);

        Mono<Price> priceMono = webClient.get()
            .uri("http://pricing-service/api/price/" + productId)
            .retrieve().bodyToMono(Price.class);

        // 合并结果
        return Mono.zip(productMono, inventoryMono, priceMono)
            .map(tuple -> new AggregatedResponse(tuple.getT1(), tuple.getT2(), tuple.getT3()))
            .flatMap(response -> writeResponse(exchange, response));
    }
}
(3)聚合带来的延迟放大
一个聚合请求的延迟取决于最慢的下游服务。优化手段:
- 设置合理的超时时间
- 使用异步非阻塞 IO(WebFlux/Reactor)
- 对非关键数据使用缓存
六、协议转换:多语言的"翻译官"
6.1 为什么需要协议转换
微服务体系中,不同服务可能使用不同的通信协议:
- 对外暴露 HTTP/REST API
- 内部服务间使用 gRPC(高性能)
- 老系统使用 Dubbo/Thrift
- 移动端可能需要 WebSocket 推送
网关的协议转换能力让客户端无需关心后端服务的协议细节。
6.2 常见的协议转换场景
| 转换方向 | 场景 | 实现 |
|---|---|---|
| HTTP → gRPC | 对外的 REST API 转内部 gRPC | 解析 HTTP 参数 → 构造 protobuf → 调 gRPC |
| HTTP → Dubbo | 老 Dubbo 服务对外暴露 HTTP | 解析 HTTP → 构造 Dubbo Invocation |
| WebSocket → HTTP | 实时推送用 WS,内部用 HTTP | WebSocket 帧 ↔ HTTP 请求/响应 |
| HTTP/1.1 → HTTP/2 | 对外 HTTP/2,内部 HTTP/1.1 | 协议升级/降级 |
| JSON → Protobuf | REST 请求体转 protobuf 二进制 | 序列化格式转换 |
6.3 gRPC 转 REST 的实现
这是最常见的协议转换场景。以 APISIX 为例,它通过 grpc-transcode 插件实现:
# APISIX 配置示例
plugins:
  grpc-transcode:
    proto_id: "proto/product.proto"  # .proto 文件
    service: "ProductService"        # gRPC 服务名
    method: "GetProduct"             # gRPC 方法名
网关读取 .proto 文件中的服务定义,自动将 HTTP JSON 请求转换为 gRPC protobuf 调用。
6.4 协议转换的代价
协议转换不是免费的:
- 性能损耗:每次转换都需要序列化/反序列化,增加 CPU 开销
- 字段映射:不同协议的字段命名风格不同(JSON 的 camelCase vs protobuf 的 snake_case)
- 类型系统差异:HTTP 的 "一切皆字符串" vs gRPC 的强类型
- 错误码映射:HTTP 状态码 vs gRPC status code 的语义差异
七、高可用:网关自身的"防护盾"
网关是所有流量的入口,网关挂了 = 整个系统不可访问。因此网关的高可用设计是重中之重。
7.1 无状态 + 水平扩展
网关节点必须无状态:路由配置从外部存储(配置中心/数据库)加载,会话信息不存储在网关本地。这样任意节点都可以处理任意请求,线性扩展。
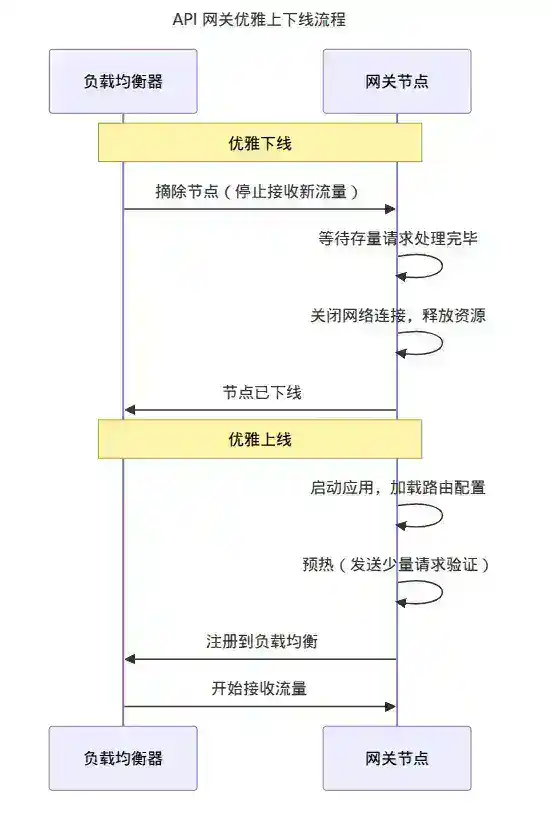
7.2 优雅上下线
优雅下线:
- 从负载均衡摘除节点(停止接收新流量)
- 等待存量请求处理完毕(graceful shutdown)
- 关闭网络连接,释放资源
优雅上线:
- 启动应用,加载路由配置
- 预热(发送少量请求验证)
- 注册到负载均衡
Spring Cloud Gateway 基于 Netty + Reactor,天然支持优雅关闭:
// 优雅关闭配置
server:
  shutdown: graceful
spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
7.3 多级容错
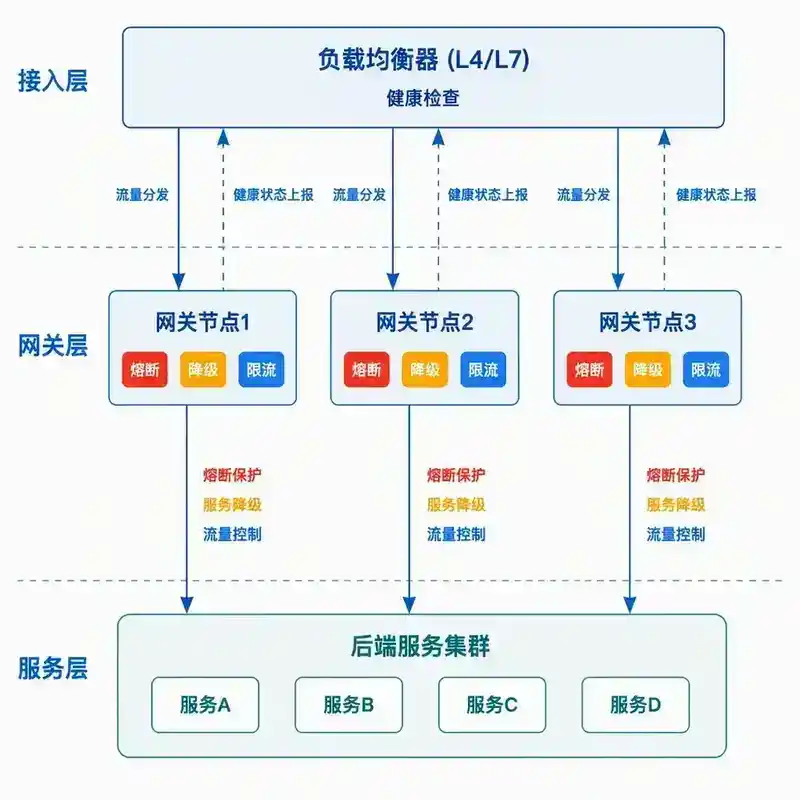
网关层也需要容错机制:
熔断:当某个后端服务持续失败,网关自动熔断该路由,快速失败而非等待超时。
降级:当后端服务不可用时,返回预设的降级响应(如缓存数据、默认值、友好提示)。
限流:保护网关自身不被流量冲垮。网关不仅要限流后端服务,也要限制自身接受的请求量。
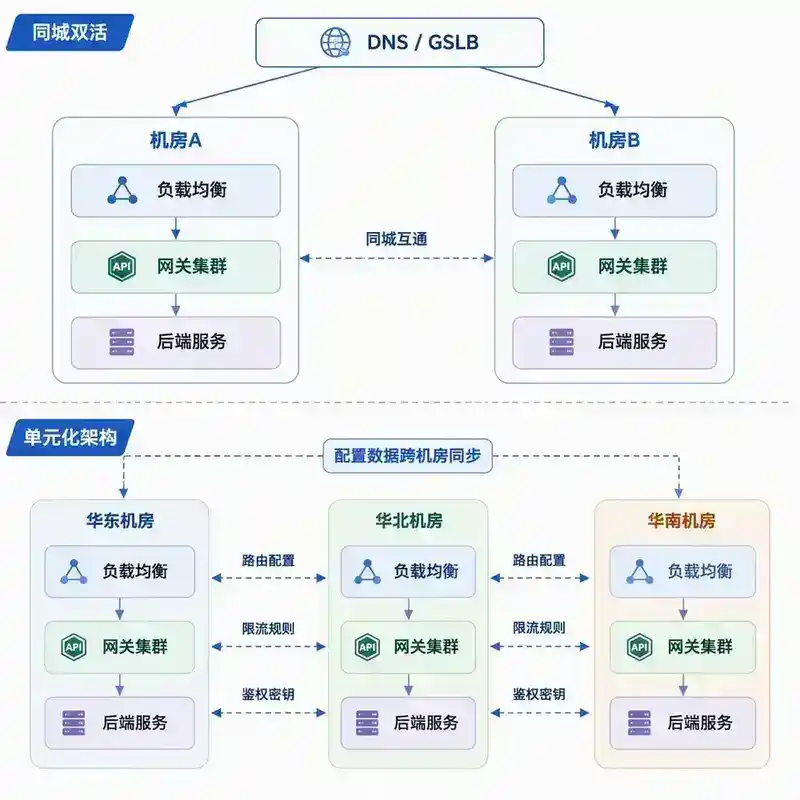
7.4 多活与异地容灾
对于高要求场景,网关需要多活部署:
- 同城双活:两个机房各部署一套网关,通过 DNS/GSLB 分流
- 异地多活:单元化架构,每个地域独立部署全套网关+服务
- 数据同步:路由配置、限流规则、认证密钥等配置数据需要跨机房同步
7.5 网关的监控与告警
网关是流量入口,天然是可观测性的最佳埋点位置:
- QPS / 延迟 / 错误率:按路由、按后端服务分组
- 限流/熔断事件:触发次数、触发频率
- 慢请求追踪:识别慢路由、慢后端
- 认证失败率:检测攻击行为
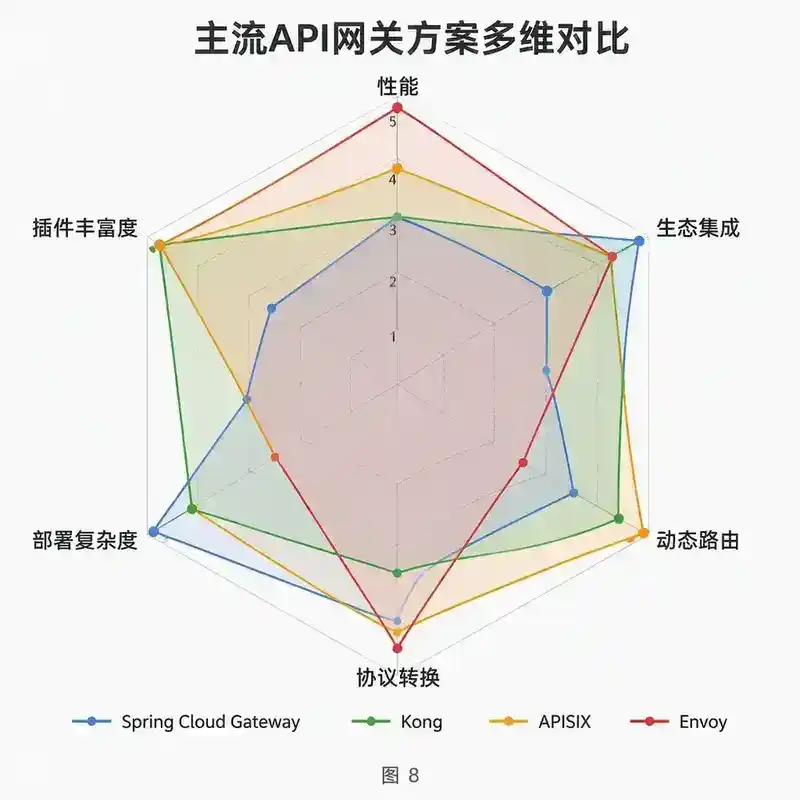
八、主流网关方案对比
| 维度 | Spring Cloud Gateway | Kong | APISIX | Envoy |
|---|---|---|---|---|
| 语言 | Java | OpenResty(Lua) | OpenResty(Lua) | C++ |
| 性能 | 中等 | 高 | 高 | 极高 |
| 生态 | Spring 生态集成 | 插件丰富 | 插件丰富 | 服务网格标配 |
| 动态路由 | 支持(需配置中心) | 原生支持 | 原生支持 | 通过 xDS |
| 协议转换 | 一般 | HTTP→gRPC | HTTP→gRPC/Dubbo | 全协议支持 |
| 限流 | 令牌桶 | 多种算法 | 多种算法 | 令牌桶 |
| 部署复杂度 | 低(Java 生态) | 中 | 中 | 高 |
| 适用场景 | Spring 技术栈 | 通用 API 管理 | 高性能网关 | 服务网格 Sidecar |
九、总结
API 网关是微服务架构中不可或缺的组件。核心能力可以归纳为:
- 路由:将请求智能分发到正确的后端服务,支持动态变更
- 认证:统一验证用户身份,透传身份信息给下游
- 限流:保护后端服务免受过载,支持多维度限流
- 聚合:减少客户端请求次数,编排多个后端服务的数据
- 协议转换:屏蔽后端服务协议差异,统一对外接口
- 高可用:网关自身必须无状态、可水平扩展、具备容错能力
记住一句话:把基础设施的复杂性交给网关,让业务开发专注于业务逻辑。
十、面试官视角:Q&A 深度追问
以下问题从面试官视角设计,考察候选人对 API 网关的工程落地能力和架构决策能力,而非概念背诵。
Q1:API 网关和反向代理(Nginx)有什么区别?网关能替代 Nginx 吗?
面试官意图:考察对网关和反向代理边界的精确理解,区分"L4/L7 代理"和"API 管理层"。
Nginx 是通用反向代理,工作在 HTTP 层,核心能力是请求转发、负载均衡、静态资源服务、SSL 终结。API 网关是应用层网关,在反向代理的基础上增加了业务感知能力:认证鉴权、限流熔断、API 聚合、协议转换、路由动态编排、请求/响应改写。
关键区别:Nginx 不理解请求内容——它不知道这个请求是下单还是退款,它只看 URL/Header;API 网关理解 API 语义——它知道 /api/order 需要 JWT 认证、限流 100 QPS、路由到 order-service v2。Nginx 的配置是静态的(reload 有性能代价),API 网关支持动态路由热更新。
网关不能替代 Nginx:Nginx 在四层负载、静态资源、连接管理方面的性能远超 Java 网关。典型架构是 Nginx/OpenResty 做第一层四层/七层接入(TLS 终结、WAF、DDoS 防护),API 网关做第二层应用路由。部分高性能网关(Kong/APISIX 基于 OpenResty,Envoy 基于 C++)可以合并这两层,但 Spring Cloud Gateway 不建议放在最前端。
评分要点:能说出"业务感知"和"动态路由"两个核心差异 → 优秀;只说"网关功能更多" → 一般。
Q2:Spring Cloud Gateway 基于 WebFlux 和 Netty,它的线程模型是怎样的?为什么不用 Tomcat?
面试官意图:考察对异步非阻塞 IO 模型的理解,以及为什么网关场景下反应式编程是刚需而非炫技。
Spring Cloud Gateway 基于 Spring WebFlux(Reactor 实现),底层使用 Netty 作为网络引擎。线程模型:少量 EventLoop 线程(通常等于 CPU 核数)处理所有 IO 事件——接收连接、读写数据、编解码、事件分发,所有这些操作都是非阻塞的。业务逻辑在 EventLoop 线程上以 Reactive 流的形式执行,不阻塞线程。
为什么不用 Tomcat?Tomcat 基于 Servlet 规范,一个请求绑定一个线程(thread-per-request 模型)。在网关场景下,网关需要调用多个后端服务,如果每个后端调用都阻塞线程等待,200 个并发请求就需要 200 个线程。当后端响应慢(如 500ms),线程池很快耗尽,新请求排队或拒绝。而 Netty + WebFlux 模型下,IO 等待不占用线程——网关发起后端请求后立即释放 EventLoop 线程去处理其他请求,后端响应到达时 EventLoop 再通过事件回调继续处理。一个 4 核 CPU 的网关可以轻松处理数万并发连接。
关键代码理解:Mono 和 Flux 不是"线程池任务",而是"数据流声明"。webClient.get().uri(...).retrieve().bodyToMono(...) 这一行代码不会发起 HTTP 请求——它只是声明了"当被订阅时,发起 GET 请求"。真正执行发生在 subscribe() 时,且整个链路是非阻塞的。
评分要点:能说出"thread-per-request vs event-loop"和"IO 等待不占用线程" → 优秀;只说"性能更好" → 一般。
Q3:如果网关需要承载 10 万 QPS,设计上需要考虑哪些点?请从网络、内存、CPU、部署架构几个维度分析。
面试官意图:考察大规模分布式系统的全链路设计能力,面试官会逐层深挖。
网络层:
- 使用 DPDK/XDP 绕过内核协议栈,减少数据拷贝和上下文切换
- 启用 TCP_REUSEPORT,多进程/多线程绑定同一端口,内核级负载均衡
- HTTP/2 多路复用减少连接数,但注意 Head-of-Line Blocking(HTTP/2 在 TCP 层仍有队头阻塞,HTTP/3 QUIC 才能彻底解决)
- 调优内核参数:
somaxconn、tcp_tw_reuse、net.core.netdev_max_backlog
内存层:
- 堆外内存(Direct Memory)避免 GC 抖动——Netty 默认使用堆外内存做 IO 缓冲
- 路由表、限流计数器用本地缓存(Caffeine)+ 定期同步,避免每次请求查 Redis
- JVM 调优:用 G1GC 或 ZGC,堆大小控制在 4-8GB(过大反而导致 GC 停顿长)
- 避免在网关内存中累积请求体——流式转发,不做全量缓冲
CPU 层:
- 绑定 CPU 亲和性(affinity),减少上下文切换和缓存失效
- 减少不必要的序列化/反序列化——网关应尽量透传 body,只在必要时解析(如认证、限流需要读 body 时)
- 异步日志(RingBuffer/Disruptor),避免日志 IO 阻塞 EventLoop
部署架构:
- 无状态水平扩展:网关节点不存储任何会话数据,通过 DNS/GSLB 或硬件负载均衡(F5/SLB)分发流量
- 分级部署:边缘网关(抗 DDoS、TLS 终结)→ 核心网关(路由、认证、限流)→ BFF 层(端侧聚合)
- 容量规划:单节点压测 5000 QPS → 10 万 QPS 需要 20+ 节点(含冗余),预留 30% 余量
- 灰度发布:金丝雀路由(按 Header/Cookie 染色),逐步切流,异常自动回滚
评分要点:每个维度都能说出 2 个以上具体措施 → 优秀;只泛泛说"加机器" → 不合格。
Q4:JWT 在网关层验签,token 过期了但用户仍在操作,如何做到无感刷新?
面试官意图:考察对认证用户体验和安全的平衡,以及双 token 机制的工程实现。
双 Token 机制是标准答案:
- Access Token:短有效期(15-30 分钟),用于网关验签,每次请求携带
- Refresh Token:长有效期(7-30 天),仅用于换取新 Access Token,存储在安全位置(httpOnly Secure Cookie)
无感刷新流程:
- 网关验签 Access Token 失败(过期),返回 401
- 客户端拦截器捕获 401,用 Refresh Token 请求
/auth/refresh接口 - 认证服务验证 Refresh Token(检查是否被吊销、是否在有效期内),签发新 Access Token + 可选轮换 Refresh Token
- 客户端用新 Access Token 重试原请求
- 如果 Refresh Token 也过期,则跳转登录页
工程细节:
- 并发刷新:多个请求同时发现 token 过期时,需要排队——只发一次 refresh 请求,其他请求等待其结果。可用 Promise 锁或单例模式
- Refresh Token 轮换(Rotation):每次刷新时同时返回新 Refresh Token,旧 Refresh Token 立即失效。防止 Refresh Token 泄露后被长期利用
- 滑动过期:用户持续操作时,Access Token 过期不应强制重新登录。Refresh Token 可以设置"绝对过期时间"(如 30 天),在此期间内持续刷新
- 网关侧:网关只验 Access Token,不关心 Refresh Token。Refresh Token 的验证和管理全部在认证服务
评分要点:能说出双 Token 机制和并发刷新 → 优秀;只说"用 Refresh Token" → 一般。
Q5:网关的限流规则是存在 Redis 里的,如果 Redis 挂了限流怎么办?Sentinel 是如何解决这个问题的?
面试官意图:考察对分布式限流高可用方案的实战经验,以及对 Sentinel 核心原理的理解。
Redis 挂了的典型处理策略:
| 策略 | 做法 | 风险 |
|---|---|---|
| 降级为单机限流 | Redis 不可用时,各网关节点用本地计数器限流 | 全局限流不准(N 节点 × 单机限额 = 实际 N 倍) |
| 降级为放行 | Redis 不可用时,跳过限流检查 | 可能击垮后端 |
| 降级为保守限流 | 单机限额 = 全局限额 / 节点数 | 全局限额过低,误伤正常用户 |
| 容灾 Redis | 主从 + Sentinel 自动切换 | 增加运维复杂度 |
Sentinel 的集群限流方案:Sentinel 不依赖 Redis,而是通过 Token Server 模式实现分布式限流。
- 架构:集群中选出一个或多个节点作为 Token Server,负责统一分配令牌。其他节点作为 Token Client,向 Token Server 请求令牌。Token Server 通过嵌入式模式(Embedded)运行在网关进程内,或独立部署。
- 故障转移:Token Server 不可用时,Token Client 自动降级为单机限流模式。Token Server 恢复后自动切回集群模式。这个切换是秒级的,对业务无感知。
- 与 Redis 方案对比:Sentinel 方案不依赖外部存储,减少了一次网络调用(Redis 方案需要
MULTI/EVAL操作),延迟更低。缺点是 Token Server 本身有单点风险,虽然可以多 Token Server 做分片,但复杂度增加。 - 核心算法:Sentinel 使用滑动窗口 + 令牌桶,窗口统计数据存储在本地内存,通过 Netty 通信在 Token Server 和 Client 之间同步。
评分要点:能说出 Sentinel 的 Token Server 模式和自动降级 → 优秀;只说"加 Redis 哨兵" → 一般。
Q6:BFF(Backend for Frontend)和传统 API 网关的聚合有什么区别?什么场景下需要独立的 BFF 层?
面试官意图:考察对 BFF 模式的深入理解,以及在微服务架构中层次划分的工程判断力。
本质区别:
| 维度 | 传统 API 网关聚合 | BFF 聚合 |
|---|---|---|
| 服务对象 | 所有客户端共用 | 特定客户端(Web/iOS/Android)专属 |
| 聚合粒度 | 通用、粗粒度 | 端侧定制、页面级 |
| 响应格式 | 统一 JSON 模型 | 针对端侧优化(字段裁剪、格式适配) |
| 变更频率 | 低(影响所有客户端) | 高(端侧迭代快,独立发布) |
| 归属 | 基础架构团队 | 前端/端侧团队 |
需要独立 BFF 层的场景:
- 多端差异大:Web 需要完整字段,移动端只需要摘要;iOS 用 camelCase,Android 用 snake_case
- 端侧迭代独立:App 发版周期长,需要 BFF 做版本兼容;Web 迭代快,BFF 随 Web 一起发布
- 后端服务粒度不匹配:后端是按领域划分的微服务,前端需要的是页面级数据——BFF 将多个微服务编排为页面级接口
- GraphQL 场景:BFF 是 GraphQL 最自然的落地层——前端声明数据需求,BFF 从多个数据源聚合
不推荐 BFF 的场景:只有一两个客户端且需求差异小,BFF 层反而增加维护成本。此时网关聚合足够。
评分要点:能说出"端侧专属"和"页面级粒度"两个核心差异 → 优秀;只说"BFF 更灵活" → 一般。
Q7:网关做协议转换(HTTP→gRPC)时,HTTP 是无状态的,gRPC 支持 streaming,这种差异网关如何处理?
面试官意图:考察对协议转换的深度理解,特别是 streaming 场景下的工程挑战。
HTTP 到 gRPC Unary(一元调用):这是最常见的场景,网关将 HTTP 请求的 JSON body 解析为 protobuf 消息,调用 gRPC 方法,将 protobuf 响应转回 JSON。这是标准的一对一映射,网关作为中间层完成序列化转换。
Streaming 的四种模式及网关处理:
| gRPC 模式 | HTTP 映射 | 网关处理方式 |
|---|---|---|
| Unary(一元) | HTTP POST → JSON Response | 标准转换,无特殊处理 |
| Server Streaming | HTTP → SSE(Server-Sent Events)或 Chunked Transfer | 网关将 gRPC 流中的每条消息转为 SSE 事件,持续推送给客户端 |
| Client Streaming | HTTP Chunked Transfer → gRPC Stream | 客户端分块上传,网关累积后转发 gRPC 流 |
| Bidi Streaming | WebSocket | 唯一合理方案——HTTP 半双工无法支持双向流,网关建立 WebSocket 连接,上下行分别映射为 gRPC 流 |
工程挑战:
- 超时管理:HTTP 请求有超时,但 streaming 可能持续数分钟甚至数小时。网关需要区分"连接超时"和"流空闲超时"——连接建立后不设总超时,但设置空闲超时(如 60 秒无数据则断开)
- 背压(Backpressure):gRPC 支持流控,如果消费端处理慢,生产端应减速。但 HTTP→gRPC 转换中,HTTP 侧的背压信号(TCP 窗口)和 gRPC 侧的流控信号(HTTP/2 WINDOW_UPDATE)需要正确传递,网关不能无限制地缓冲数据
- 错误处理:gRPC streaming 中途出错,错误码和 detail 需要在 HTTP 侧有对应的表达——SSE 场景下可以发送
event: error事件,WebSocket 场景下发 close frame 带状态码 - 连接管理:HTTP 是短连接模型,gRPC streaming 是长连接模型。网关需要维护连接池,避免频繁建连/断连
评分要点:能说出 SSE 和 WebSocket 两种映射方案及背压问题 → 优秀;只说"网关做转换" → 不合格。
本文为 Java 技术专家/架构师面试 250 个高频考点系列第 183 篇。