阅读时间:约 42 分钟 | 分类:微服务与服务治理
一、问题定义:为什么需要灰度发布?
在微服务架构中,一次代码变更从开发者提交到最终全量上线,中间隔着巨大的风险鸿沟。传统的"停机部署"或"直接全量替换"模式在分布式系统中几乎不可行——一旦新版本存在缺陷,影响面就是 100% 的用户。
灰度发布(Gradual Release)的核心思想是:用一小部分流量验证新版本的稳定性,逐步扩大范围,最终完成全量切换。它不是"要不要做"的问题,而是"怎么做才对"的问题。
在面试中,灰度发布通常被拆解为以下几个子话题:
| 维度 | 核心问题 |
|---|---|
| 蓝绿部署 | 如何实现零停机切换? |
| 金丝雀发布 | 如何用小流量验证新版本? |
| 流量染色 | 如何将特定请求路由到特定版本? |
| 版本兼容性 | 新旧版本共存时接口和数据如何兼容? |
下面逐一深入。
二、蓝绿部署(Blue-Green Deployment)
2.1 核心思想
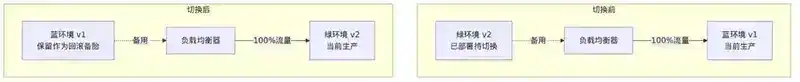
蓝绿部署由 Martin Fowler 团队的 Jez Humble 在《Continuous Delivery》中系统化提出。它的模型极其简单:
- 蓝环境(Blue):当前正在运行的生产环境(旧版本 v1)
- 绿环境(Green):部署了新版本(v2)的完整独立环境
- 切换:通过负载均衡器或路由层,将全部流量从蓝环境瞬间切换到绿环境
[全部流量] ──→ [负载均衡器] ──→ [蓝环境 v1]  ← 当前
                                 [绿环境 v2]  ← 已部署,待切换

切换后:
[全部流量] ──→ [负载均衡器] ──→ [蓝环境 v1]  ← 保留作为回滚备胎
                                 [绿环境 v2]  ← 当前生产
2.2 蓝绿部署的关键细节
(1)环境独立性
蓝绿环境必须是完全独立的——包括应用实例、配置、数据库连接等。在 Kubernetes 中,这意味着两套完整的 Deployment + Service,只是共享同一个数据库(或者各自连接读库)。
(2)切换方式
切换发生在流量入口层,常见方式有:
- DNS 切换:将域名指向绿环境,但受 DNS 缓存 TTL 影响,切换不实时
- 负载均衡器切换:Nginx/HAProxy 修改 upstream,秒级生效
- Kubernetes Service Selector 切换:修改 Service 的 label selector,瞬时生效
- API 网关路由切换:网关层修改路由规则,最灵活
(3)数据库兼容性——蓝绿部署的最大痛点
蓝绿部署最棘手的问题不是应用层,而是数据库层。在切换瞬间,蓝环境和绿环境需要共享同一个数据库,这就要求:
- 数据库 Schema 变更必须向后兼容:不能有破坏性变更(如删除列、重命名列)
- 采用"扩展-收缩"模式:先加新列(扩展),待旧版本下线后再删旧列(收缩)
- 事务一致性:切换瞬间正在进行的数据库事务可能跨两个环境
(4)回滚能力
蓝绿部署的回滚能力极强——只需把流量切回蓝环境即可。回滚时间取决于流量切换方式,通常可以在秒级到分钟级完成。这是蓝绿部署最大的优势。
2.3 蓝绿部署的适用场景
| 场景 | 适合度 | 原因 |
|---|---|---|
| 重大版本升级 | ★★★★★ | 快速回滚能力至关重要 |
| 基础设施变更 | ★★★★★ | 可验证完整的新环境 |
| 频繁小迭代 | ★★☆☆☆ | 资源成本过高 |
| 数据库 Schema 变更 | ★★☆☆☆ | 需要额外的兼容性处理 |
| 有状态服务 | ★☆☆☆☆ | 状态迁移困难 |
2.4 蓝绿部署的资源成本
蓝绿部署需要维护两套完整环境,资源成本翻倍。在云原生时代,可以通过以下方式优化:
- 使用弹性伸缩,绿环境初始只部署最小副本数,切换后再扩容
- 切换完成后,蓝环境缩小到最小副本数作为回滚备用
- 利用 Kubernetes HPA 根据流量自动调整副本数
三、金丝雀发布(Canary Release)
3.1 核心思想
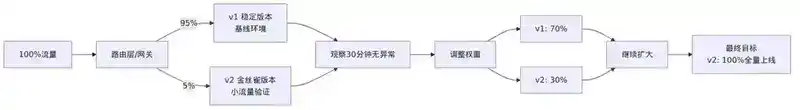
"金丝雀"一词源自煤矿工人:矿工下井时会带一只金丝雀,如果金丝雀死亡,说明井内有毒气,矿工立即撤离。在软件发布中,金丝雀发布就是将新版本先暴露给一小部分用户,观察其行为,确认无问题后再逐步扩大。
[100% 流量] ──→ [路由层] ──→ 95% → [v1 稳定版本]
                              ──→  5% → [v2 金丝雀版本]

观察 30 分钟无异常:
                              ──→ 70% → [v1 稳定版本]
                              ──→ 30% → [v2 金丝雀版本]

继续观察,逐步提升到 100%
3.2 金丝雀发布的流量分配策略
(1)基于权重的流量分配
最基础的策略:在负载均衡器或网关上配置权重,如 95:5、70:30、0:100。
# Istio VirtualService 示例
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: my-service
spec:
  hosts:
  - my-service
  http:
  - route:
    - destination:
        host: my-service
        subset: v1
      weight: 95
    - destination:
        host: my-service
        subset: v2
      weight: 5
(2)基于用户特征的金丝雀
更精细的策略:只让特定用户群体看到新版本,如:
- 内部员工:先让公司内部员工使用新版本("吃自己的狗粮")
- Beta 用户:选择注册了 Beta 计划的用户
- 地域维度:先在某个低风险地区发布
- 用户 ID 哈希:按 userId 哈希值固定分配到某个版本
(3)基于请求特征的金丝雀
按请求头路由:如 X-Canary: true 头的请求路由到金丝雀版本。
3.3 金丝雀发布的观测与自动化
金丝雀发布的核心不是"怎么切流量",而是"怎么判断能不能继续"。
关键观测指标:
| 指标类型 | 具体指标 | 判定标准 |
|---|---|---|
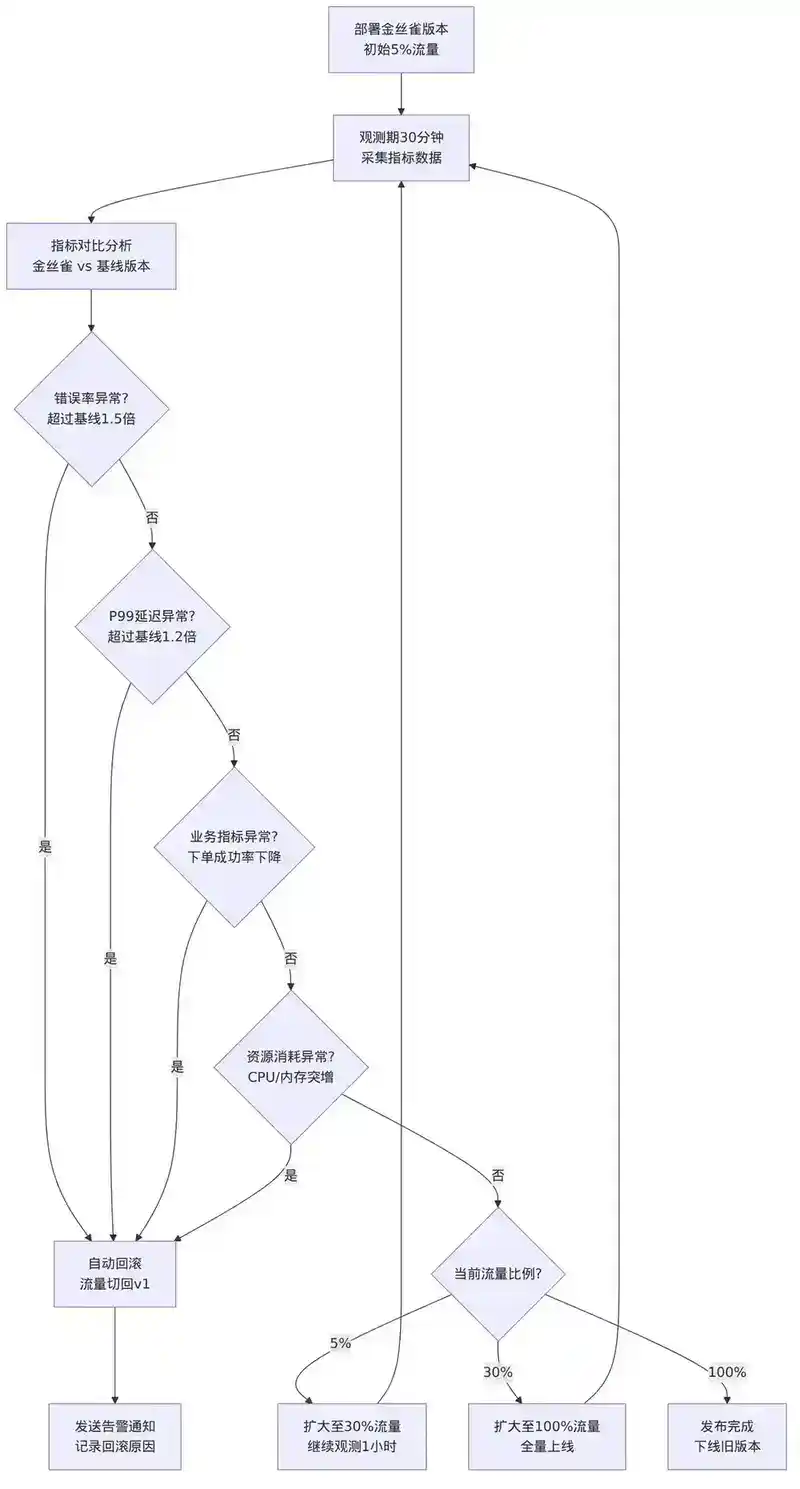
| 错误率 | HTTP 5xx 比例 | 金丝雀错误率 > 基线 1.5x → 回滚 |
| 延迟 | P99 响应时间 | 金丝雀 P99 > 基线 1.2x → 回滚 |
| 业务指标 | 下单成功率 | 金丝雀下单成功率 < 基线 99% → 回滚 |
| 资源消耗 | CPU/内存 | 金丝雀资源消耗 > 基线 1.3x → 回滚 |
| 日志异常 | ERROR 日志量 | 新类型异常突增 → 回滚 |
自动化金丝雀分析(如 Argo Rollouts、Spinnaker):
┌──────────┐    ┌──────────────┐    ┌──────────┐
│ 部署 v2  │───→│ 金丝雀分析    │───→│ 决策      │
│ (5%流量) │    │ (30分钟观测)  │    │          │
└──────────┘    └──────────────┘    └──────────┘
                                          │
                            ┌─────────────┼─────────────┐
                            ▼             ▼             ▼
                       继续扩大       保持当前       立即回滚
                       (5%→30%)      (延长时间)     (切回v1)
3.4 蓝绿 vs 金丝雀:选型对比
| 维度 | 蓝绿部署 | 金丝雀发布 |
|---|---|---|
| 切换方式 | 瞬间全量切换 | 逐步扩大流量 |
| 回滚速度 | 极快(秒级) | 快(分钟级,但影响面小) |
| 资源成本 | 高(双倍环境) | 低(仅额外金丝雀实例) |
| 风险控制 | 切换后仍有全量风险 | 渐进式,风险可控 |
| 验证粒度 | 环境级 | 流量级 |
| 适用场景 | 重大变更、基础设施 | 日常迭代、频繁发布 |
面试官视角:二者不是互斥的。很多团队采用"蓝绿准备 + 金丝雀验证"的组合:先部署绿环境,通过金丝雀方式逐步引流到绿环境,最终完成蓝绿切换。
四、流量染色(Traffic Coloring)
4.1 什么是流量染色?
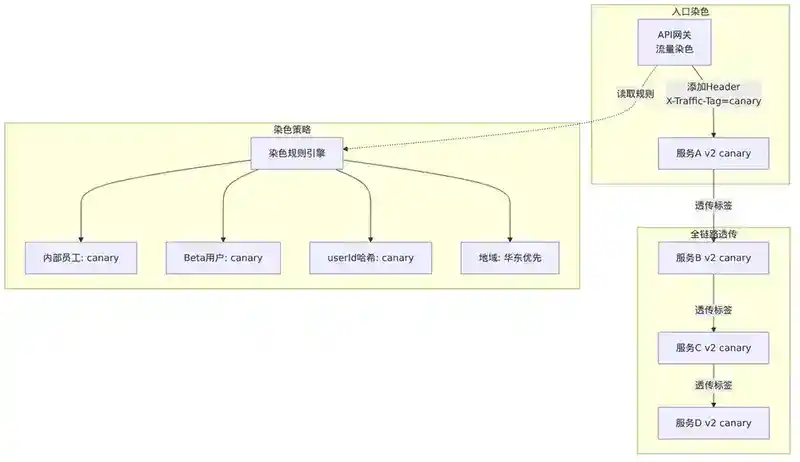
流量染色(Traffic Coloring / Traffic Tagging)是指给请求打上标记(标签),使整个调用链路上的所有服务都能根据标记做出路由决策。
用户请求 (userId=123, 标签: canary)
    │
    ▼
[API 网关] ── 识别标签,添加 Header: X-Traffic-Tag=canary
    │
    ▼
[服务A - v2 (canary)] ── 调用下游时透传 X-Traffic-Tag=canary
    │
    ▼
[服务B - v2 (canary)] ── 透传标签
    │
    ▼
[服务C - v2 (canary)]
4.2 流量染色的技术实现
(1)HTTP Header 透传
最通用的方式:在请求的 HTTP Header 中携带染色标记,全链路透传。
// 网关层染色
public class TrafficDyeingFilter implements GlobalFilter {
    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        String userId = exchange.getRequest().getHeaders().getFirst("X-User-Id");
        String tag = dyeingRule.match(userId); // 根据用户ID匹配染色规则
        if (tag != null) {
            exchange.getRequest().mutate()
                .header("X-Traffic-Tag", tag)
                .build();
        }
        return chain.filter(exchange);
    }
}
// 服务间透传(Feign 拦截器)
public class TrafficTagFeignInterceptor implements RequestInterceptor {
    @Override
    public void apply(RequestTemplate template) {
        String tag = TrafficContext.getTag(); // 从上下文获取
        if (tag != null) {
            template.header("X-Traffic-Tag", tag);
        }
    }
}
(2)RPC 上下文传递
在 Dubbo/gRPC 等 RPC 框架中,通过 Attachment/Metadata 传递染色标记:
// Dubbo 染色传递
RpcContext.getClientAttachment().setAttachment("traffic-tag", "canary");

// 服务端接收
String tag = RpcContext.getServerAttachment().getAttachment("traffic-tag");
(3)消息队列染色
异步消息的染色更复杂,需要将染色标记作为消息头传递:
// Kafka 生产端
ProducerRecord<String, String> record = new ProducerRecord<>("topic", key, value);
record.headers().add("traffic-tag", "canary".getBytes(StandardCharsets.UTF_8));

// 消费端
String tag = new String(record.headers().lastHeader("traffic-tag").value());
4.3 全链路灰度
流量染色的最终目标是实现全链路灰度:一个被打上"金丝雀"标签的请求,在整个调用链路上都被路由到金丝雀版本的服务实例。
                   ┌─────────────────────────────────────┐
                   │           全链路灰度架构              │
                   │                                     │
  [网关] ──染色──→ [服务A] ──透传──→ [服务B] ──透传──→ [服务C]
    │                │                 │                 │
    │                │                 │                 │
    ▼                ▼                 ▼                 ▼
  [A-v1]           [A-v2]          [B-v2]            [C-v2]
  [A-v2] ✓         [A-v1]          [B-v1]            [C-v1]
                   │                 │                 │
                   └── 当前请求全链路使用 v2 版本 ──────┘
实现要点:
- 染色标记在入口处生成:网关或业务入口根据规则生成流量标签
- 全链路透传:所有中间件(HTTP、RPC、MQ、定时任务)都要透传标签
- 服务路由:注册中心(Nacos/Consul)配合标签路由,将请求路由到对应版本的实例
- 泳道隔离:在极端情况下,可以创建完全的"泳道"——一个逻辑上隔离的调用链
4.4 泳道(Swimlane)概念
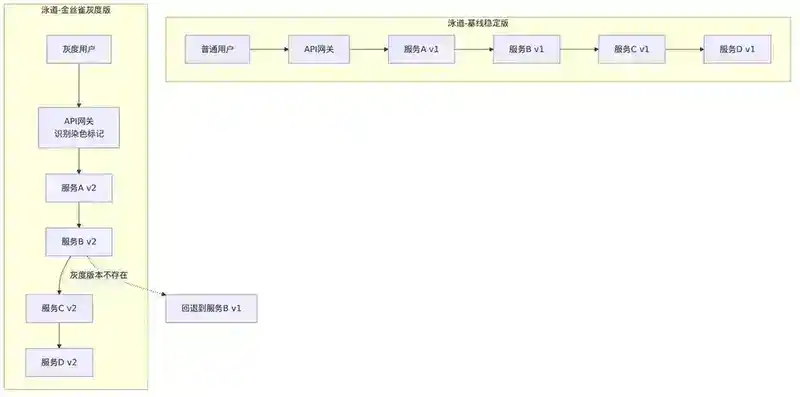
泳道是全链路灰度的物理实现:为每个版本创建一条独立的调用链路,用户请求在泳道内闭环。
泳道-基线(稳定版):
  [用户] → [网关] → [服务A-v1] → [服务B-v1] → [服务C-v1]

泳道-金丝雀(灰度版):
  [灰度用户] → [网关] → [服务A-v2] → [服务B-v2] → [服务C-v2]
注意:泳道隔离需要所有下游服务都部署了对应的灰度版本,否则需要"泳道回退"——即找不到灰度版本时回退到基线版本。
五、版本兼容性
灰度发布的核心挑战不是怎么切流量,而是新旧版本能否和平共存。如果两个版本不能同时运行,灰度发布就无从谈起。
5.1 接口兼容性
(1)向后兼容(Backward Compatibility)
新版本的服务端能处理旧版本客户端发来的请求。这是灰度发布的最低要求。
// v1 接口
@PostMapping("/order")
public Order createOrder(@RequestBody CreateOrderRequest req) {
    // req 只有 amount, productId
}

// v2 接口(向后兼容)
@PostMapping("/order")
public Order createOrder(@RequestBody CreateOrderRequestV2 req) {
    // req 新增了 couponId 字段(带默认值 null)
    // 旧客户端不传 couponId,v2 服务端正确处理
}
向后兼容原则:
- 新增字段必须有默认值
- 不能删除已有字段(可以标记为 @Deprecated)
- 不能改变已有字段的类型或语义
- 不能收紧参数校验规则(如原来允许空字符串,现在不允许)
(2)向前兼容(Forward Compatibility)
旧版本的服务端能处理新版本客户端发来的请求。这在金丝雀发布中同样重要——如果金丝雀用户只占总用户的 5%,那么这 5% 的用户可能调用到尚未升级的旧版下游服务。
向前兼容原则:
- 使用"宽容读取"策略:忽略未知字段
- 不依赖新增字段做核心逻辑判断
- 对未知字段保持默认行为
5.2 数据兼容性
(1)数据库 Schema 兼容
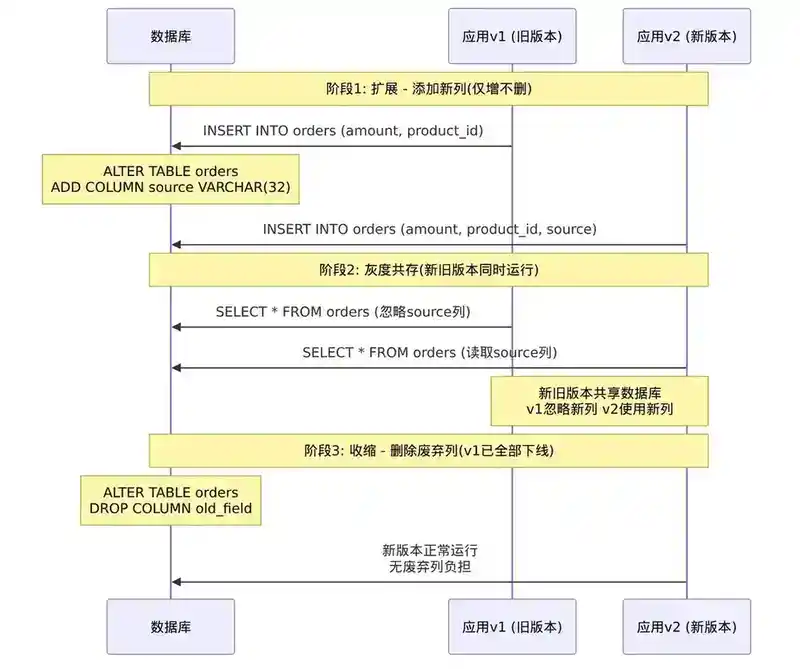
Schema 变更必须遵循"扩展-收缩"模式:
阶段 1(扩展):
  ALTER TABLE orders ADD COLUMN source VARCHAR(32) DEFAULT NULL;
  -- 只加列,不删列,不修改已有列

阶段 2(部署新版本,逐步灰度):
  -- 新版本写入 source 字段,旧版本忽略

阶段 3(全量上线后,收缩):
  -- 确认旧版本已全部下线,删除废弃列
  ALTER TABLE orders DROP COLUMN old_column;
(2)消息格式兼容
消息队列中的消息格式变更也需要兼容:
// v1 消息
{"orderId": "123", "amount": 100}

// v2 消息(向后兼容)
{"orderId": "123", "amount": 100, "channel": "APP"}

// 消费者需要处理两种格式
// Avro/Protobuf 等 Schema 演进方案天然支持
(3)缓存兼容
缓存数据在新旧版本间也需要兼容。常见做法:
- 在缓存 Key 中加入版本号:
user:123:v2 - 使用序列化框架的 Schema 演进能力(如 Protobuf)
- 切换时做缓存预热或允许缓存 miss 回源
5.3 协议兼容性
| 协议 | 兼容性方案 |
|---|---|
| HTTP/REST | 新增字段、新增接口、废弃标记 |
| gRPC/Protobuf | 字段编号不可变,只增不减;reserved 关键字 |
| Dubbo | 接口版本号,多版本同时暴露 |
| Thrift | 字段 ID 不可变,optional 字段 |
| Avro | Schema 注册中心,读写 Schema 分离 |
5.4 依赖服务兼容性
灰度发布时,如果新版本依赖了新的下游服务或新版本的下游服务,需要考虑依赖链路的兼容性:
场景:服务A v2 调用服务B v2(新接口),但服务B v2 还是金丝雀状态

错误做法:
  服务A v2 强依赖服务B v2 的新接口 → 服务B v2 不可用时服务A v2 崩溃

正确做法:
  服务A v2 降级兼容:先尝试调用服务B v2 新接口,失败时回退到旧接口
六、灰度发布的工程实践
6.1 常见的灰度发布平台/工具
| 工具 | 类型 | 核心能力 |
|---|---|---|
| Istio | Service Mesh | 流量路由、权重分配、Header 匹配 |
| Argo Rollouts | Kubernetes CRD | 金丝雀部署、蓝绿部署、自动分析 |
| Spinnaker | 多云发布平台 | 金丝雀分析、自动回滚、多阶段部署 |
| Flagger | Kubernetes Operator | 金丝雀部署、A/B 测试、指标分析 |
| Nacos | 注册中心 | 标签路由、灰度发布 |
| Spring Cloud Gateway | API 网关 | 路由规则、权重路由 |
| 自研发布平台 | 内部平台 | 结合业务特性的定制化灰度 |
6.2 灰度发布的标准流程
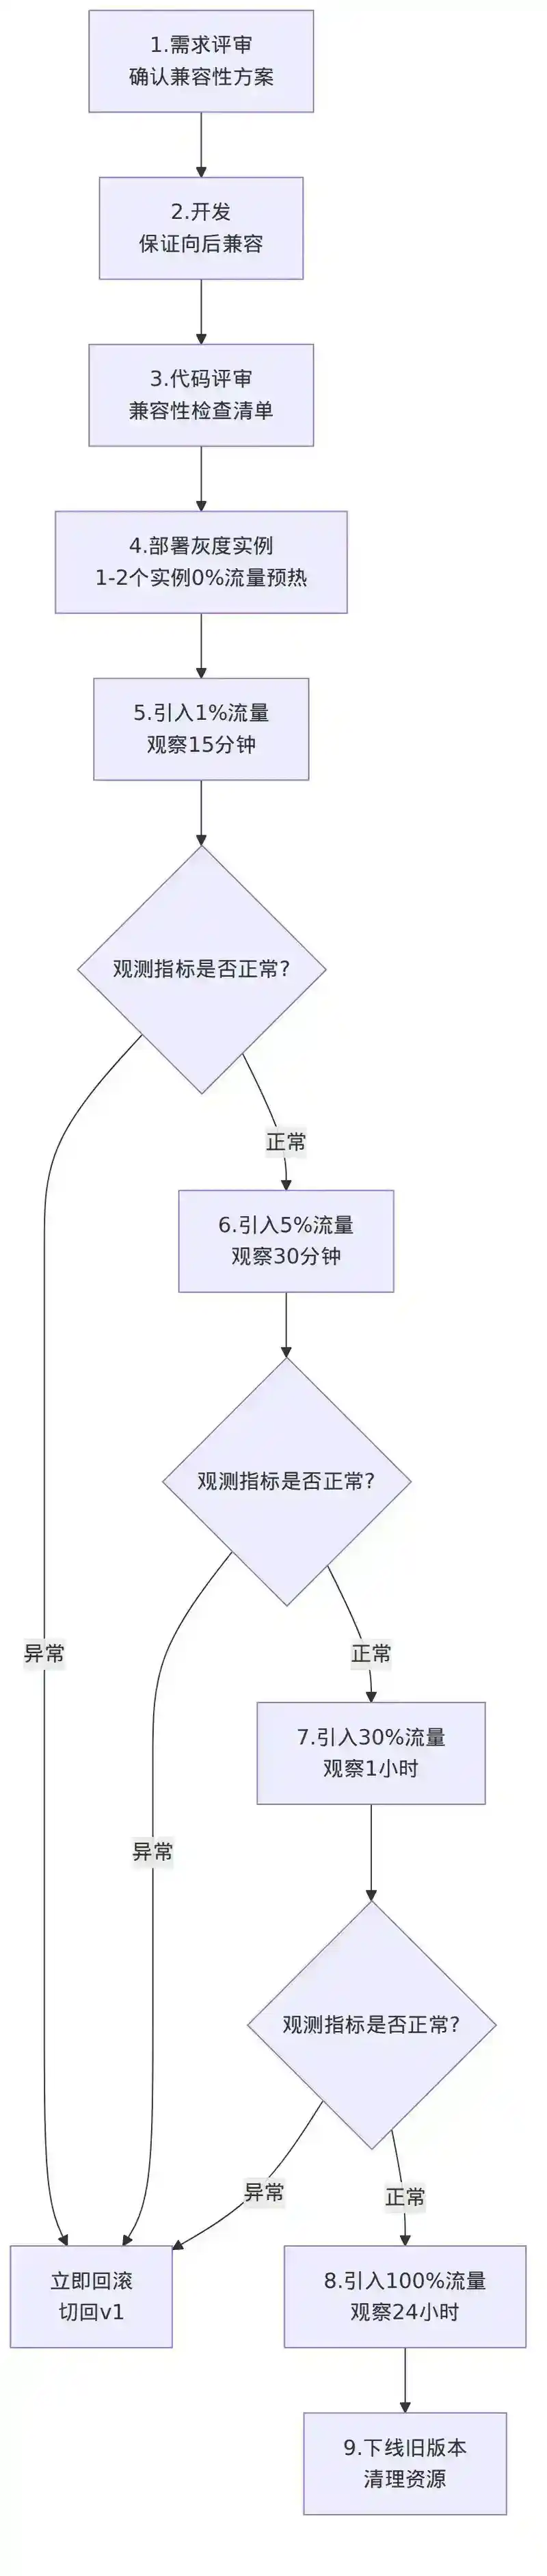
1. 需求评审 → 确认兼容性方案
2. 开发 → 保证向后兼容
3. 代码评审 → 兼容性检查清单
4. 部署灰度实例 → 1-2 个实例,0% 流量(预热)
5. 引入 1% 流量 → 观察 15 分钟
6. 引入 5% 流量 → 观察 30 分钟
7. 引入 30% 流量 → 观察 1 小时
8. 引入 100% 流量 → 观察 24 小时
9. 下线旧版本 → 清理资源
6.3 灰度发布中的"回滚"策略
回滚不只是"切回旧版本",还需要考虑:
- 数据回滚:如果新版本写入了新格式的数据,旧版本能否正确读取?
- 缓存回滚:新版本可能污染了缓存,回滚后缓存是否有效?
- 消息回滚:已经发送到消息队列的新格式消息,旧版本消费者能否处理?
- 第三方回调:如果新版本触发了对第三方的回调,回滚后第三方状态是否一致?
硅谷实践:很多公司更倾向于"前滚(roll forward)"而非"回滚(roll back)"——即发现新版本有问题时,不是回退到旧版本,而是快速修复并发布一个更新的版本。这要求团队的 CI/CD 流水线足够快。
七、常见陷阱
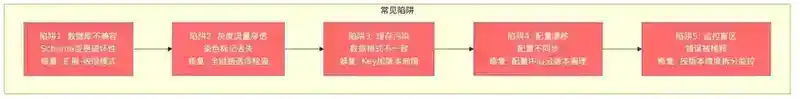
陷阱 1:数据库不兼容导致灰度失败
症状:灰度 5% 流量后,基线版本开始报错 "Unknown column"。
原因:灰度版本添加了新字段,但基线版本的 ORM 查询了全字段(SELECT *),导致字段映射失败。
修复:Schema 变更严格遵循"扩展-收缩"模式;ORM 配置使用显式字段列表,不用 SELECT *。
陷阱 2:灰度流量穿透到基线版本
症状:灰度版本调用下游服务时,下游服务(基线版本)不认识新参数,导致业务异常。
原因:灰度标签在服务调用时丢失,请求被路由到了基线版本的下游服务。
修复:检查全链路标签透传机制;确保所有 RPC 框架、HTTP 客户端、消息队列都正确透传染色标记。
陷阱 3:缓存污染
症状:灰度发布后,部分用户看到的数据不一致。
原因:灰度版本和基线版本共享同一个缓存集群,新版本写入的数据格式与旧版本不兼容。
修复:缓存 Key 加版本前缀;灰度期间使用独立的缓存 namespace;或确保缓存数据格式向后兼容。
陷阱 4:配置漂移
症状:灰度版本与基线版本使用了不同的配置,导致行为不一致。
原因:灰度实例的配置未与基线实例同步更新,或者配置中心按版本标签推送了不同的配置。
修复:配置中心支持"灰度配置"和"基线配置"两套管理;配置变更纳入发布流程管控。
陷阱 5:监控盲区
症状:灰度版本已经出现异常,但监控面板没有告警。
原因:监控大盘是按"服务"维度聚合的,灰度版本的错误被基线版本的正常流量稀释了。
修复:监控必须按版本维度拆分;金丝雀分析必须对比"金丝雀版本 vs 基线版本"的同环比指标。
八、面试追问与参考答案
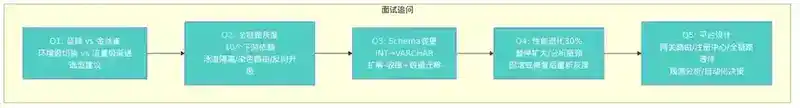
以下问题来自面试官视角,考察候选人对灰度发布的理解深度和工程实践能力。
Q1:蓝绿部署和金丝雀发布的核心区别是什么?什么场景选哪种?
参考答案:
蓝绿部署是"环境级切换",金丝雀发布是"流量级渐进"。蓝绿需要维护两套完整环境,切换瞬间完成,回滚极快;金丝雀只需要少量额外实例,逐步扩大流量,风险更可控。
选型建议:
- 蓝绿部署:适合重大版本升级、基础设施变更。因为需要快速回滚能力,且验证整环境的一致性。
- 金丝雀发布:适合日常迭代。因为资源成本低,且渐进式验证能尽早发现问题。
- 组合使用:先部署绿环境,再通过金丝雀方式逐步引流到绿环境,兼顾回滚速度和发布风险。
Q2:一个服务有 10 个下游依赖,做金丝雀发布时,如何保证全链路都需要灰度版本的实例?
参考答案:
这是全链路灰度的核心问题。方案有几种:
- 泳道隔离:为灰度版本创建独立的调用链路,所有下游服务都部署灰度实例。成本最高,隔离最彻底。
- 染色 + 路由:在请求中携带染色标记,注册中心根据标记路由到对应版本的实例。如果下游没有灰度实例,路由回退到基线版本。
- 逐步升级依赖:按依赖 topology 的反向顺序发布——先发布最下游的服务,再逐步向上游发布。确保上游灰度时,下游灰度实例已经就绪。
Q3:如果新版本修改了数据库 Schema(比如把 age 字段类型从 INT 改为 VARCHAR),怎么做灰度发布?
参考答案:
直接修改字段类型是破坏性变更,不能直接灰度。需要分阶段:
- 扩展阶段:添加新字段
age_str VARCHAR,同时保留ageINT。应用层同时写入两个字段,读取时优先读age_str。 - 数据迁移:后台任务将
age的值迁移到age_str。 - 灰度发布新版本:新版本只读写
age_str,旧版本仍然可以读写age。 - 全量上线后:删除
age字段。
这个过程中,数据库始终有两个版本的应用都能正确读写。
Q4:灰度发布时,发现新版本性能比旧版本差 30%,但功能正常。你会怎么做?
参考答案:
- 立即暂停灰度扩大:保持当前流量比例,不再增大。
- 分析性能瓶颈:对比新旧版本的 CPU profile、内存分配、GC 日志、慢 SQL 等。
- 判断是否回滚:如果性能退化会导致当前灰度用户受损,先回滚;如果影响可控,保留灰度实例用于排查。
- 修复后重新灰度:优化性能后重新走灰度流程。
关键是:性能退化也是"异常",灰度发布不仅要看功能正确性,还要看性能指标。
Q5:说说你们公司的灰度发布平台是怎么设计的?
考察点:候选人的系统设计能力,是否理解灰度发布的全链路。
优秀回答应覆盖:
- 流量入口层:网关/负载均衡器的路由规则管理
- 服务路由层:注册中心的标签路由能力
- 全链路透传:染色标记的传递机制
- 观测分析:金丝雀版本与基线版本的指标对比
- 自动化:金丝雀分析 → 自动扩大/暂停/回滚的决策闭环
- 兼容性治理:接口/Schema 兼容性检查作为发布前置条件
九、总结
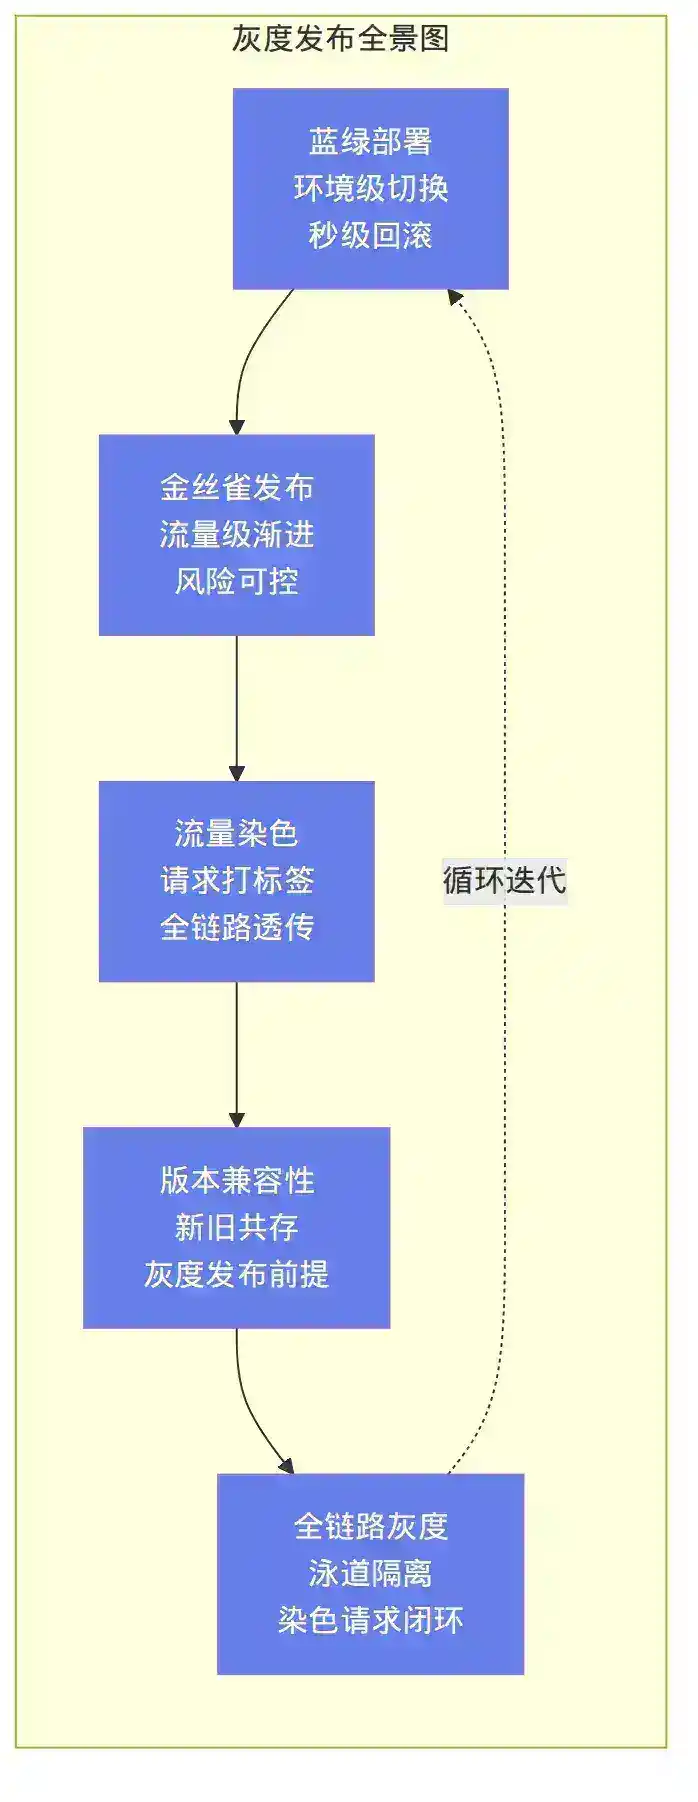
| 概念 | 一句话总结 |
|---|---|
| 蓝绿部署 | 准备两套环境,瞬间切换,快速回滚 |
| 金丝雀发布 | 小流量验证,逐步扩大,渐进式上线 |
| 流量染色 | 给请求打标签,全链路透传,精准路由 |
| 版本兼容性 | 新旧版本能和平共存,是灰度发布的前提 |
| 全链路灰度 | 染色请求在整条调用链路上都使用灰度版本 |
核心原则:灰度发布不是技术问题,而是风险控制问题。 技术手段(蓝绿、金丝雀、染色)服务于风险控制目标(尽早发现问题、最小化影响面、快速恢复)。
十、延伸阅读
- 《Continuous Delivery》by Jez Humble & David Farley — 第 10 章:蓝绿部署与金丝雀发布
- Martin Fowler: BlueGreenDeployment
- Kubernetes: Argo Rollouts 官方文档
- Istio: Traffic Management — 基于权重的路由和 Header 匹配
- 《Google SRE Workbook》— 第 16 章:金丝雀发布与渐进式交付
- 阿里巴巴 Nacos 文档:标签路由与灰度发布