阅读时间:约 40-50 分钟 | 难度:中高级 | 适用:Java 技术专家 / 架构师面试
为什么微服务拆分比"拆"本身更难?
如果我问你"怎么把单体拆成微服务",你大概率会回答"按业务拆"。这个答案没错,但只对了一半。真正的问题在于:拆完之后,你发现系统比以前更复杂了——分布式事务满天飞、一个需求要改 5 个服务、联调环境永远跑不起来、线上问题定位要靠猜。
这不是微服务的问题,而是拆分原则没搞对。今天我们不谈"微服务好不好",只谈怎么拆才不会后悔。
1. 业务边界:DDD 限界上下文驱动的拆分
1.1 从"功能模块"到"业务能力"
单体时代,我们习惯按"功能模块"组织代码:com.xxx.order、com.xxx.payment、com.xxx.inventory。这看起来没问题,但致命的缺陷是——模块边界是技术视角的,不是业务视角的。
微服务拆分的正确姿势是:一个服务 = 一个业务能力。什么是业务能力?就是"这个业务能独立创造什么价值"。
以电商为例:
| 业务能力 | 核心价值 | 是否独立服务 |
|---|---|---|
| 商品管理 | 商家上架商品、管理 SKU | ✅ 商品服务 |
| 订单管理 | 用户下单、订单状态流转 | ✅ 订单服务 |
| 支付 | 收付款、退款 | ✅ 支付服务 |
| 库存管理 | 库存扣减、预占、释放 | ✅ 库存服务 |
| 物流追踪 | 发货、物流状态 | ✅ 物流服务 |
| 用户认证 | 登录、注册、权限 | ✅ 用户服务 |
但这里有一个常见的坑:很多人会把"订单搜索"也拆成一个独立服务,理由是"搜索是独立能力"。错——订单搜索是订单业务的子能力,不是独立的业务能力。判断标准:如果这个"能力"不能独立对外提供价值,就不应该拆成独立服务。
1.2 DDD 限界上下文:拆分的理论锚点
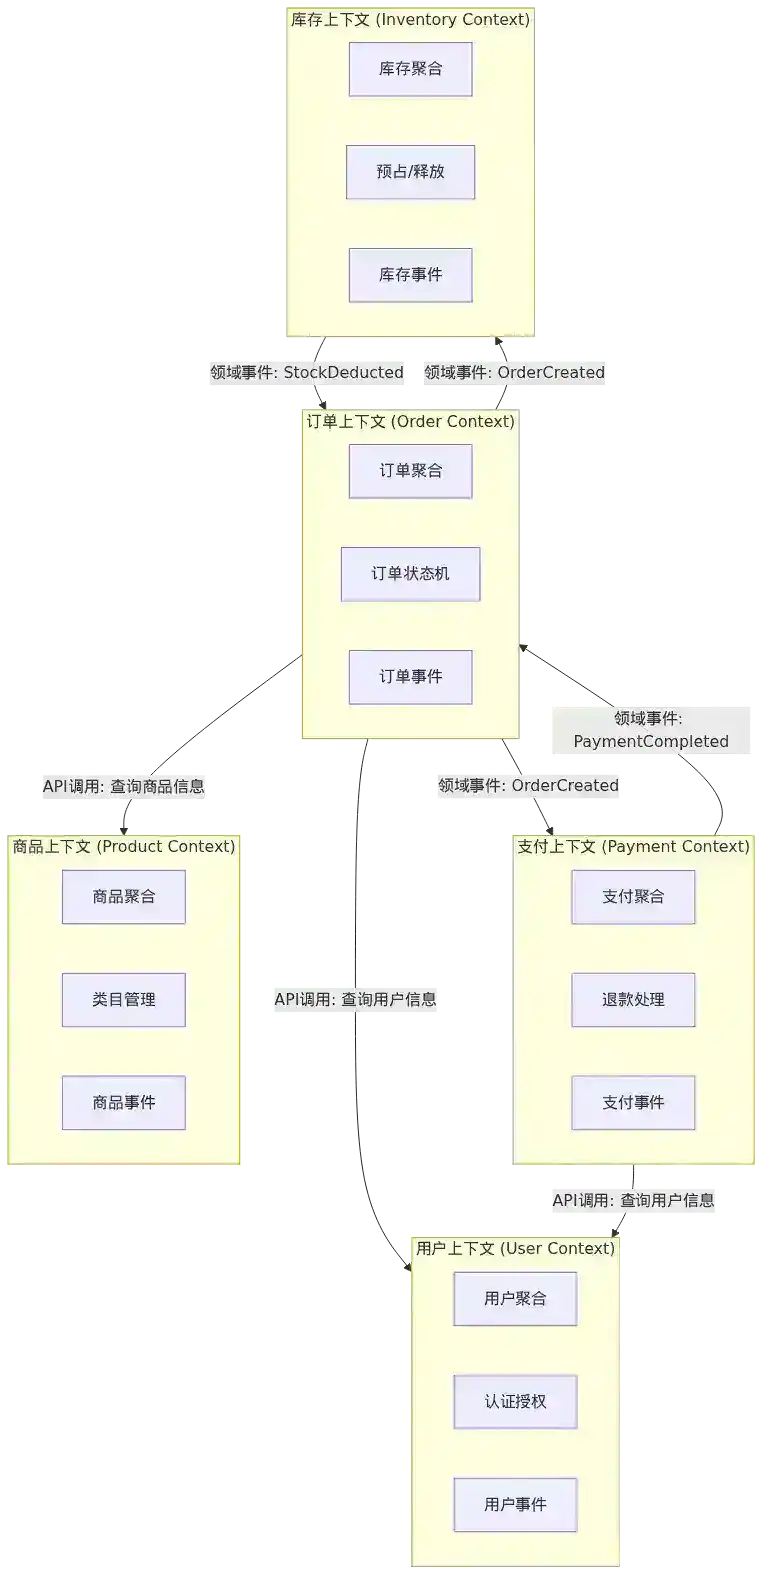
领域驱动设计(DDD)中的**限界上下文(Bounded Context)**是微服务拆分的天然理论锚点。一个限界上下文 = 一个微服务,这几乎是行业共识。
但很多团队在做 DDD 时犯了一个错:把领域模型当成了数据模型。限界上下文的核心不是"数据归谁",而是"语言边界"——同一个词在不同上下文中有不同含义。
举个例子:
// 订单上下文中的"商品"
class Product {
    Long productId;
    String name;
    Money price;        // 关心价格
    String imageUrl;    // 关心图片
}

// 库存上下文中的"商品"
class Product {
    Long productId;
    String skuCode;
    Integer quantity;   // 关心数量
    String warehouseId; // 关心仓库
}
同一个"商品"概念,在不同上下文中是完全不同的模型。如果你把这两个模型放在同一个服务里,你迟早会写出一个"万能"的 Product 类,包含 100 个字段,然后每次改一个字段都要担心影响其他业务。
拆分原则 1:按限界上下文拆分,一个上下文一个服务。上下文之间通过领域事件通信,而不是直接调 API。
文章配图
2. 团队边界:康威定律与逆康威定律
2.1 康威定律说了什么
"任何组织在设计系统时,都会设计出与组织沟通结构一致的架构。" —— Melvin Conway, 1967
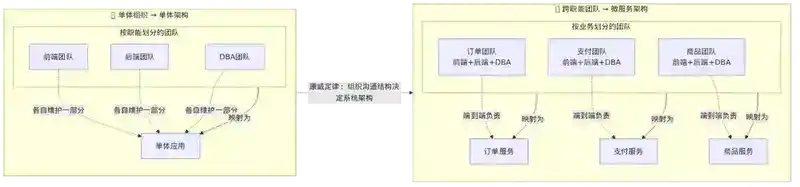
翻译成人话:如果你的团队是按前端/后端/数据库分的,你永远做不出真正的微服务。
康威定律在微服务场景下的推论:
- 一个微服务应该由一个团队端到端负责。这个团队要能独立完成需求分析、设计、开发、测试、部署、运维。
- 如果两个团队共享一个服务,这个服务就会变成"公共厕所"——没人愿意认真维护,出了问题互相推诿。
- 跨团队协作的成本决定了服务拆分的粒度。如果两个服务需要频繁协同变更,考虑合并。
2.2 逆康威定律:用架构反推组织
很多公司做微服务改造的路径是:先定架构 → 再调组织。但逆康威定律告诉我们:也可以先调组织,让组织结构反推架构演进。
具体做法:
- 识别业务域的独立团队:把负责订单的人、负责支付的人、负责商品的人物理上分成独立团队
- 给每个团队分配独立的代码仓库、CI/CD 流水线、数据库
- 让团队在独立环境中自然演进出自己的服务边界
Netflix 的实践就是典型的逆康威定律:他们先组建了独立的产品团队,每个团队负责一个"可独立部署的单元",架构自然就变成了微服务。
2.3 两个披萨原则
Amazon 的 Bezos 提出"两个披萨原则":一个团队如果两个披萨不够吃,就太大了。对应到微服务:
- 一个团队负责 1-3 个微服务比较合理
- 如果一个团队要维护 10+ 个微服务,说明拆分过细
- 如果一个服务需要 3 个团队共同维护,说明拆分粒度不对
拆分原则 2:服务边界要对齐团队边界。一个团队端到端拥有一个服务,团队的认知负荷决定了服务的大小。
文章配图
3. 数据边界:每个服务拥有自己的数据
3.1 共享数据库是微服务的原罪
这是微服务拆分中最容易被忽视、但后果最严重的问题。
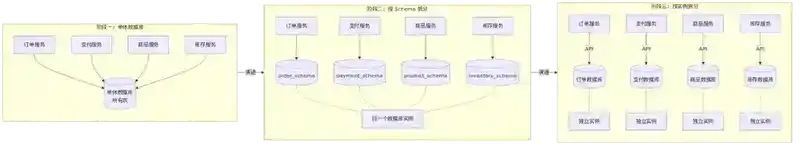
如果你拆了代码但没拆数据库,你做的不是微服务,是分布式单体。
分布式单体的症状:
- 订单服务可以直接查支付服务的表,绕过业务逻辑
- 修改一个表结构,不知道哪些服务会受影响
- 想做数据库迁移,要协调 5 个团队同时上线
- 数据库连接池被多个服务抢光,谁也查不出是谁干的
正确做法:每个微服务拥有自己的数据库(或 Schema),其他服务只能通过 API 访问数据。
// ❌ 错误:订单服务直接查支付表
@Repository
public class OrderDao {
    @Autowired
    private JdbcTemplate jdbcTemplate;

    public PaymentInfo getPayment(Long orderId) {
        // 直接跨库查支付服务的表
        return jdbcTemplate.queryForObject(
            "SELECT * FROM payment_db.t_payment WHERE order_id = ?",
            PaymentInfo.class, orderId);
    }
}

// ✅ 正确:订单服务通过 API 获取支付信息
@Service
public class OrderService {
    @Autowired
    private PaymentClient paymentClient;  // Feign/Dubbo 调用

    public OrderDetail getOrderDetail(Long orderId) {
        Order order = orderDao.findById(orderId);
        // 通过 API 获取,而不是直接查表
        PaymentInfo payment = paymentClient.getPaymentByOrderId(orderId);
        return OrderDetail.of(order, payment);
    }
}
3.2 数据一致性:从 ACID 到 BASE
拆了数据库之后,最大的挑战是分布式事务。单体的 @Transactional 一包,要么全成功要么全失败。微服务里,你没法这样做。
这就是为什么需要从 ACID(原子性、一致性、隔离性、持久性)转向 BASE(基本可用、软状态、最终一致性)。
常见的最终一致性方案:
方案一:本地消息表 + 定时任务
// 订单服务:创建订单 + 写入本地消息表(同一个本地事务)
@Transactional
public void createOrder(CreateOrderRequest req) {
    // 1. 保存订单
    orderDao.save(order);
    // 2. 写入本地消息表(同一个数据库,ACID 保证)
    eventPublisher.publish("order.created", order);
    // 3. 定时任务扫描消息表,发送到 MQ
}

// 定时任务:扫描未发送消息
@Scheduled(fixedDelay = 1000)
public void sendPendingMessages() {
    List<EventMessage> messages = eventDao.findPendingMessages();
    for (EventMessage msg : messages) {
        try {
            mqProducer.send(msg);
            eventDao.markAsSent(msg.getId());
        } catch (Exception e) {
            log.error("发送失败,等待重试", e);
        }
    }
}
方案二:事务消息(RocketMQ 实现)
// 使用 RocketMQ 事务消息实现分布式事务
public void createOrder(Order order) {
    // 1. 发送半消息
    TransactionSendResult result = rocketMQTemplate.sendMessageInTransaction(
        "order-topic",
        MessageBuilder.withPayload(order).build(),
        order
    );
}

// 2. 执行本地事务
@RocketMQTransactionListener
public class OrderTransactionListener implements RocketMQLocalTransactionListener {
    @Override
    public RocketMQLocalTransactionState executeLocalTransaction(Message msg, Object arg) {
        try {
            orderDao.save((Order) arg);
            return RocketMQLocalTransactionState.COMMIT;  // 本地事务成功,提交消息
        } catch (Exception e) {
            return RocketMQLocalTransactionState.ROLLBACK; // 本地事务失败,回滚消息
        }
    }

    // 3. 回查(MQ 未收到确认时)
    @Override
    public RocketMQLocalTransactionState checkLocalTransaction(Message msg) {
        Order order = (Order) msg.getPayload();
        if (orderDao.existsById(order.getId())) {
            return RocketMQLocalTransactionState.COMMIT;
        }
        return RocketMQLocalTransactionState.ROLLBACK;
    }
}
方案三:Saga 模式
Saga 把一个大事务拆成多个小事务,每个小事务有对应的补偿操作:
正向流程:创建订单 → 扣减库存 → 扣款
补偿流程:退款 → 恢复库存 → 取消订单
// Saga 编排示例
public class CreateOrderSaga {
    public void execute(CreateOrderRequest req) {
        SagaContext ctx = new SagaContext();
        try {
            // Step 1: 创建订单
            ctx.orderId = orderService.createOrder(req);
            // Step 2: 扣减库存
            inventoryService.deduct(req.products);
            // Step 3: 扣款
            paymentService.charge(req.paymentInfo);
        } catch (Exception e) {
            // 补偿:反向执行
            if (ctx.orderId != null) {
                paymentService.refund(ctx.paymentId);         // 退款
                inventoryService.restore(req.products);       // 恢复库存
                orderService.cancel(ctx.orderId);             // 取消订单
            }
        }
    }
}
3.3 数据拆分策略
拆分数据库时有几种策略:
| 策略 | 做法 | 适用场景 |
|---|---|---|
| 按 Schema 拆分 | 不同服务用同一个数据库实例的不同 Schema | 中小规模,减少运维成本 |
| 按实例拆分 | 每个服务拥有独立的数据库实例 | 大规模,需要独立扩展 |
| 按表拆分 | 把共享表归属到某个服务,其他服务通过 API 访问 | 过渡阶段 |
拆分原则 3:每个服务拥有自己的数据存储。服务间数据共享只能通过 API,不允许绕过 API 直接访问数据库。选择合适的一致性方案(本地消息表 / 事务消息 / Saga),放弃强一致性,拥抱最终一致性。
文章配图
4. 演进式拆分:别想一步到位
4.1 "大爆炸"拆分的灾难
很多团队拿着 DDD 画完限界上下文后,就开始做"大爆炸"拆分:所有服务同时开发、同时上线。结果:
- 上线当天发现 20 个服务有 15 个没起来
- 链路追踪工具还没配好,不知道哪个服务调用失败了
- 回滚要回滚 20 个服务,操作比单体还复杂
- 运维团队原地爆炸
正确做法是演进式拆分。 关于演进式架构的核心原则,引用 ThoughtWorks 的理念:
"演进式架构支持跨多个维度的增量式、有指导的变更。"
4.2 绞杀者模式(Strangler Fig Pattern)
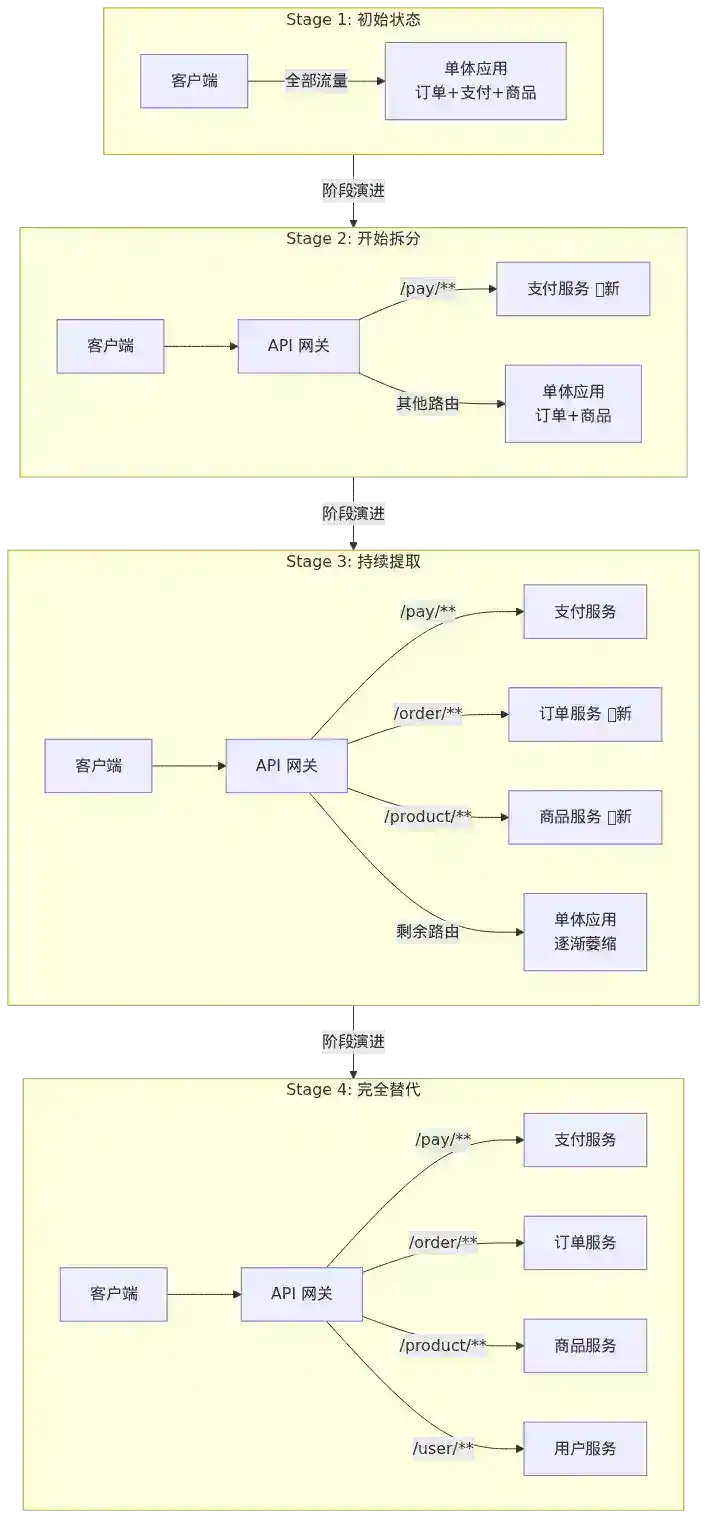
绞杀者模式的核心思想:不是"拆"单体,而是让单体被新服务"替代"。
Stage 1: 单体应用
  ┌──────────────────────────────────┐
  │  Monolith (Order + Pay + Prod)  │
  └──────────────────────────────────┘

Stage 2: 路由层引入,新服务逐步建设
  ┌──────────────┐    ┌──────────┐
  │   路由层      │───▶│ 单体     │
  │ (API Gateway) │    └──────────┘
  │              │    ┌──────────┐
  │              │───▶│ 支付服务  │  ← 新拆出来的
  └──────────────┘    └──────────┘

Stage 3: 持续提取,单体逐步萎缩
  ┌──────────────┐    ┌──────────┐
  │   路由层      │    │ 单体     │  ← 越来越小
  │              │    └──────────┘
  │              │    ┌──────────┐
  │              │───▶│ 支付服务  │
  │              │    └──────────┘
  │              │    ┌──────────┐
  │              │───▶│ 订单服务  │  ← 新拆出来的
  └──────────────┘    └──────────┘

Stage 4: 单体完全被替代
  ┌──────────────┐    ┌──────────┐
  │   路由层      │───▶│ 支付服务  │
  │              │    └──────────┘
  │              │    ┌──────────┐
  │              │───▶│ 订单服务  │
  │              │    └──────────┘
  │              │    ┌──────────┐
  │              │───▶│ 商品服务  │
  └──────────────┘    └──────────┘
4.3 抽象分支模式(Branch by Abstraction)
在代码层面,抽象分支模式允许你逐步替换实现:
// Step 1: 定义抽象接口
public interface InventoryService {
    boolean deduct(Long productId, int quantity);
    void restore(Long productId, int quantity);
}

// Step 2: 单体中的实现(直接操作本地数据库)
@Primary
@Service("localInventoryService")
public class LocalInventoryService implements InventoryService {
    @Override
    public boolean deduct(Long productId, int quantity) {
        // 直接操作本地数据库
        return inventoryDao.deduct(productId, quantity) > 0;
    }
}

// Step 3: 远程实现(调用微服务)
@Service("remoteInventoryService")
public class RemoteInventoryService implements InventoryService {
    @Autowired
    private InventoryClient inventoryClient;

    @Override
    public boolean deduct(Long productId, int quantity) {
        // 调用远程微服务
        return inventoryClient.deduct(productId, quantity);
    }
}

// Step 4: 通过配置开关切换
// application.yml
// feature.toggles.inventory-remote: false  → 先关掉
// feature.toggles.inventory-remote: true   → 灰度验证通过后打开
4.4 拆分优先级:从"最容易拆"到"最难拆"
不要一上来就拆最核心的订单系统。拆分的优先级应该是:
第一梯队(优先拆):
- 无状态服务(如短信、邮件通知)
- 读多写少的服务(如商品详情)
- 独立业务能力(如用户认证)
第二梯队(中等难度):
- 有状态但数据关系简单的服务(如购物车)
- 与核心链路耦合度低的服务
第三梯队(最后拆):
- 核心交易链路(下单、支付)
- 强一致性要求的服务
- 数据关系复杂的服务
拆分原则 4:不要一口气拆完。用绞杀者模式逐步替换单体功能,从边缘到核心,每个阶段可独立验证和回滚。
文章配图
5. 拆分粒度的"金发姑娘原则"
5.1 拆分过细的代价
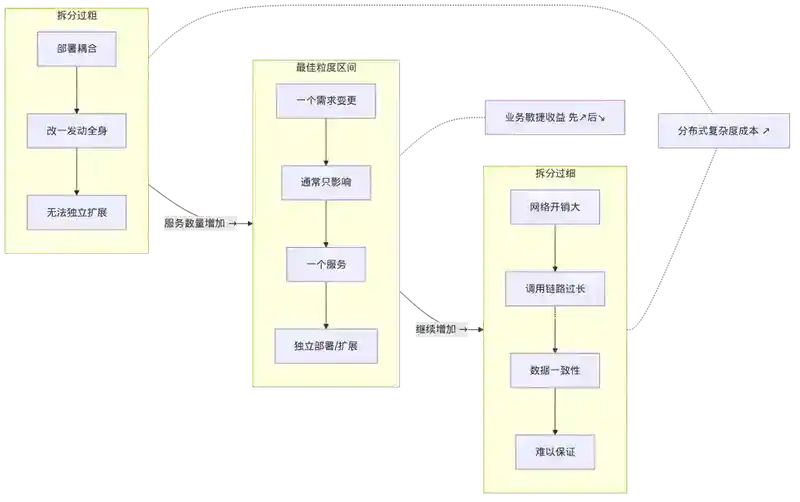
微服务不是越细越好。拆分过细会带来:
// 一个下单流程跨 7 个服务
public class OrderFlow {
    void placeOrder() {
        userService.validate();         // 1. 用户校验
        productService.checkStock();    // 2. 库存检查
        couponService.verifyCoupon();   // 3. 优惠券校验
        priceService.calculatePrice();  // 4. 价格计算
        orderService.createOrder();     // 5. 创建订单
        paymentService.pay();           // 6. 支付
        notificationService.notify();   // 7. 通知
    }
}
每个 RPC 调用都是潜在的故障点和延迟源。假设每个服务调用有 99.9% 可用性,7 个服务串行调用的整体可用性 = 99.9%^7 ≈ 99.3%,看上去还行。但如果每个服务内部还有下级调用,级联下去可用性会急剧下降。
5.2 拆分过粗的代价
反之,拆分过粗(一个服务包含了太多业务边界)的问题:
- 部署粒度太大,改一行代码要部署整个服务
- 无法独立扩展瓶颈模块
- 团队协作冲突频繁
- 技术栈锁定,无法为不同业务选择最优技术方案
5.3 判断粒度是否合适的几个指标
| 指标 | 太细的信号 | 太粗的信号 | 合适的信号 |
|---|---|---|---|
| 团队人数 | 一个团队维护 10+ 服务 | 3+ 团队改同一个服务 | 一个团队维护 1-3 个服务 |
| 变更频率 | 每次改需求都要改多个服务 | 改一个功能要动一大片代码 | 大部分需求只改一个服务 |
| 数据依赖 | 接口调用链路过长,查一个数据要调 3 层 | 服务内部有多套数据模型混在一起 | 一个服务处理一个聚合的数据 |
| 部署独立性 | 部署一个服务,必须同时部署其他服务 | 部署一个服务,需要协调所有团队 | 每个服务可以独立部署 |
拆分原则 5:服务粒度既不能太大也不能太小。以"一个需求变更通常只影响一个服务"为标准,以"一个团队能完整维护"为边界。
文章配图
6. 拆分后的服务通信设计
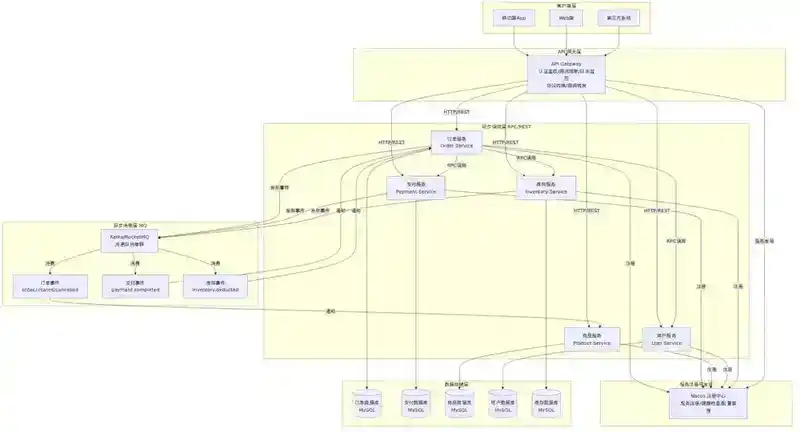
6.1 同步 vs 异步的选择
拆分完成后,服务间通信的设计是关键:
| 维度 | 同步调用(RPC/HTTP) | 异步消息(MQ) |
|---|---|---|
| 耦合度 | 高(调用方依赖被调用方可用) | 低(生产者不关心消费者) |
| 延迟 | 低(实时响应) | 高(异步处理) |
| 一致性 | 强一致性(调用方立即知道结果) | 最终一致性 |
| 适用场景 | 查询、实时操作 | 状态变更通知、异步处理 |
核心原则:查询用同步,命令用异步。
// 查询:同步调用(需要即时结果)
@GetMapping("/order/{id}")
public OrderDetail getOrder(@PathVariable Long id) {
    Order order = orderService.getById(id);
    // 用户需要看到完整的订单详情,这是实时查询
    UserInfo user = userClient.getUser(order.getUserId());  // 同步
    return OrderDetail.of(order, user);
}

// 命令:异步事件(不需要即时结果)
@PostMapping("/order")
public void createOrder(@RequestBody CreateOrderRequest req) {
    orderService.create(req);
    // 订单创建后,通知其他系统——不需要等待结果
    eventBus.publish(new OrderCreatedEvent(order));  // 异步
    // 库存扣减、积分发放、通知发送等下游服务异步消费
}
6.2 API 网关:流量入口的统一管控
微服务架构中,API 网关不是可选项,而是必需品:
移动端 ──┐
Web端  ──┼──▶ API Gateway ──▶ 订单服务
第三方 ──┘       │            ──▶ 支付服务
                 │            ──▶ 商品服务
                 ├── 认证鉴权
                 ├── 限流熔断
                 ├── 日志监控
                 ├── 协议转换
                 └── 路由转发
网关的核心职责:认证、路由、限流、日志、协议转换——但不应该包含业务逻辑。
6.3 服务发现与负载均衡
// Spring Cloud + Nacos 服务发现
@Bean
@LoadBalanced  // 开启客户端负载均衡
public RestTemplate restTemplate() {
    return new RestTemplate();
}

// 使用服务名调用,由 Nacos 解析到具体实例
@Autowired
private RestTemplate restTemplate;

public Order callOrderService() {
    // "order-service" 是服务名,不是 IP
    return restTemplate.getForObject(
        "http://order-service/api/orders/123",
        Order.class);
}
文章配图
7. 实战案例:一个电商平台的拆分路径
7.1 背景
某电商平台原单体应用:
- 代码量:50 万行 Java
- 数据库:200 张表,单实例 MySQL
- 部署:500 个接口,每周全量发布一次
- 问题:发布周期长、故障影响面大、团队协作冲突
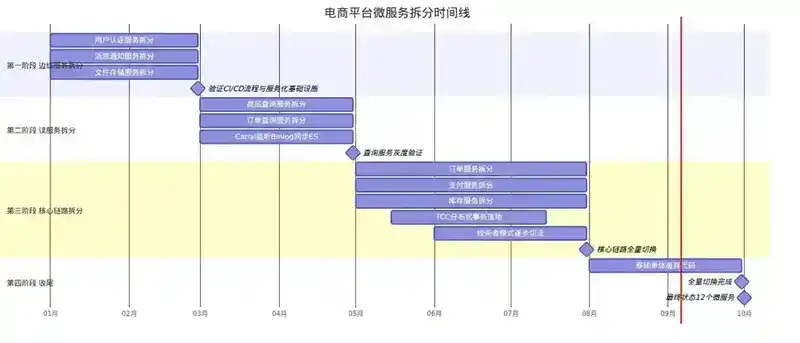
7.2 拆分路径
第一阶段(第 1-2 个月):边缘服务拆分
拆出:用户认证服务、消息通知服务、文件存储服务
原因:无状态、独立业务、不影响核心交易链路
收益:验证了 CI/CD 流程、服务化基础设施、团队获得微服务经验
第二阶段(第 3-4 个月):读服务拆分
拆出:商品查询服务、订单查询服务
原因:读多写少、数据可通过 CDC 同步、不影响写入链路
技术方案:Canal 监听 MySQL binlog → 同步到 ES → 查询服务读取 ES
第三阶段(第 5-7 个月):核心链路拆分
拆出:订单服务、支付服务、库存服务
原因:核心链路,需要最谨慎
策略:绞杀者模式,先在灰度环境验证,逐步切流
关键:TCC 分布式事务解决下单、支付、库存的一致性
第四阶段(第 8-10 个月):收尾
移除单体中已废弃的代码,完成全量切换。
7.3 拆分过程中的关键数字
| 指标 | 拆分前 | 拆分后 |
|---|---|---|
| 服务数 | 1 | 12 |
| 单服务代码量 | 50 万行 | 平均 4 万行 |
| 发布频率 | 每周 1 次 | 每天 10+ 次 |
| 故障影响面 | 全局 | 单服务 |
| 数据库 | 1 个实例 | 8 个实例 |
| 团队数 | 3 个团队改同一个仓库 | 8 个团队各有独立仓库 |
文章配图
8. 拆分自检清单
在做微服务拆分时,问自己以下问题:
业务边界:
- [ ] 这个服务的业务能力是否独立?能否独立对外提供价值?
- [ ] 是否进行了限界上下文分析?同一个词在不同上下文中的含义是否一致?
- [ ] 服务间的数据依赖是否通过 API 解耦了?
团队边界:
- [ ] 一个团队是否能端到端负责这个服务?
- [ ] 跨团队协调成本是否在可接受范围内?
- [ ] 团队的认知负荷是否合理(一个团队维护 1-3 个服务)?
数据边界:
- [ ] 每个服务是否拥有自己的数据库(或 Schema)?
- [ ] 是否禁止了跨服务的数据库直接访问?
- [ ] 选定了合适的数据一致性方案(本地消息表 / 事务消息 / Saga)?
演进策略:
- [ ] 是否采用了渐进式拆分而不是"大爆炸"?
- [ ] 是否从边缘服务开始拆分?
- [ ] 每个阶段是否有独立的回滚方案?
粒度:
- [ ] 一个需求变更是否通常只影响一个服务?
- [ ] 服务是否可以独立部署和扩展?
- [ ] 服务间调用链路是否在 3 层以内?
面试官视角:高频追问
以下问题来自真实面试场景,建议在理解全文后尝试回答:
Q1:你说"按业务能力拆分",那"用户积分"应不应该拆成独立服务?
Q2:如果两个服务共享一张配置表(比如行政区划表),怎么处理?做数据冗余还是做个独立的配置服务?
Q3:你们公司用了 Saga 模式吗?如果补偿操作本身也失败了怎么办?
Q4:康威定律说"架构由组织决定",那如果组织暂时无法调整(比如团队划分本身就混乱),微服务架构还能做吗?
Q5:拆分过程中,旧的单体还在运行,新的服务也在上线,数据库怎么迁移?具体说说你经历过的数据迁移方案。
Q6:拆分后你发现一个下单流程要跨 7 个服务,每个服务 p99 延迟 50ms,用户感知延迟是多少?怎么优化?
本文是 Java 技术专家与架构师面试 250 个高频考点系列的第 176 篇,下一篇将探讨"服务注册与发现:Nacos、Eureka 与 Consul 的原理与选型"。
文末提示:本文属于"12 微服务与服务治理"分类,面试中常与"分布式事务(161-175)"和"架构设计(191-213)"结合提问。
面试官追问:参考答案与深度解析
以下回答不是标准答案,而是面试中展现深度思考的参考框架。真正优秀的回答,需要结合你自己的项目经验。
Q1:你说"按业务能力拆分",那"用户积分"应不应该拆成独立服务?
核心判断维度:积分是否具备独立的业务价值。
如果积分只是营销活动中的一个附属功能(比如"下单送积分、积分抵现"),它不应该拆成独立服务——积分规则和订单、营销紧密耦合,拆出去反而增加了分布式复杂度。
但如果积分已经发展成一个独立的业务体系——有积分商城、积分兑换、积分过期策略、积分风控、积分等级体系——那它就是一个独立的业务能力,应该拆。
面试中展现深度的回答:
从三个维度判断:
- 数据独立性:积分是否有自己的核心数据模型?积分的余额、流水、过期时间是否独立于订单和用户?如果有,拆。
- 团队独立性:是否有专门的团队(或至少专门的人)负责积分业务?如果有,拆。
- 变更独立性:积分规则的变更(比如修改过期策略、新增积分来源)是否经常独立于其他业务?如果是,拆。
反例:一个创业公司,积分只是拉新活动中的一个小功能,总共就两个接口(发积分、查积分),拆成独立服务纯属过度设计。
关键金句:"微服务拆分的粒度不是由技术决定的,而是由业务成熟度和团队规模决定的。Don't split based on what you think you'll need, split based on what you've already proven you need."
Q2:如果两个服务共享一张配置表(比如行政区划表),怎么处理?做数据冗余还是做个独立的配置服务?
这个问题考察的是"共享数据"在微服务中的处理策略,没有标准答案,关键看场景。
方案一:独立配置服务(推荐大多数场景)
订单服务 ──▶ 配置服务(行政区划)◀── 物流服务
                │
                └── 数据库:config_db.t_district
- 优点:单一数据源,修改一处全局生效
- 缺点:增加了一个服务依赖,配置服务挂了影响面大
- 适用:数据有权威来源、需要保证一致性、数据变更频繁
方案二:数据冗余(读多写少场景)
订单服务 ── 本地表:order_db.t_district(通过 CDC 同步)
物流服务 ── 本地表:logistics_db.t_district(通过 CDC 同步)
- 优点:无运行时依赖,性能最好
- 缺点:数据不一致窗口,需要同步机制
- 适用:数据几乎不变(行政区划确实很少变)、查询频繁、对一致性不敏感
方案三:代码枚举(数据极少且固定)
如果行政区划数据量小且基本不变(比如中国省份就 34 个),直接在代码里用枚举或配置文件,比任何数据库方案都简单。
面试中展现深度的回答:
"我经历过一个案例:早期我们做了独立的配置服务,结果发现行政区划表一年才改一次,但配置服务本身因为各种原因挂了三次。后来我们改成用 Canal 监听配置库的 binlog,同步到各服务的本地缓存,配置服务挂了也不影响查询。对于这种读多写极少的数据,'冗余 + 最终一致'比'集中 + 实时查询'更可靠。"
Q3:你们公司用了 Saga 模式吗?如果补偿操作本身也失败了怎么办?
这是一个经典的分布式事务难题,面试官想听的是你对"最终一致性兜底"的理解。
补偿失败的处理策略:
第一层:自动重试(解决瞬时故障)
// 补偿操作自带重试
@Retryable(maxAttempts = 3, backoff = @Backoff(delay = 2000))
public void refundCompensation(Long paymentId) {
    paymentService.refund(paymentId);
}
第二层:持久化 + 定时任务(解决持久故障)
// 补偿失败后写入补偿任务表
@Recover
public void recoverRefund(Exception e, Long paymentId) {
    compensationTaskDao.save(new CompensationTask(
        "refund", paymentId, "PENDING"
    ));
}

// 定时任务扫描未完成的补偿
@Scheduled(fixedDelay = 60000)
public void processPendingCompensations() {
    List<CompensationTask> tasks = compensationTaskDao.findPending();
    for (CompensationTask task : tasks) {
        try {
            executeCompensation(task);
            compensationTaskDao.markAsCompleted(task.getId());
        } catch (Exception e) {
            compensationTaskDao.incrementRetryCount(task.getId());
            if (task.getRetryCount() >= MAX_RETRY) {
                // 第三层:人工介入
                alertService.sendAlert("补偿失败,需人工处理", task);
            }
        }
    }
}
第三层:人工介入(终极兜底)
设置告警阈值,超过自动重试上限后发送钉钉/企微通知,运营/开发手动处理。关键是要有对账机制——定期比对各系统的数据,发现不一致自动告警。
面试中展现深度的回答:
"Saga 不是银弹,我见过很多团队用它但最后都加了一层人工兜底。关键不是'补偿失败怎么办',而是'你怎么知道补偿失败了'。我们做了两件事:
- 每个 Sagas 步骤都有业务流水号,补偿操作记录到补偿表,定时对账
- 补偿任务表有重试次数和最大重试上限,超过上限自动升级为工单
另外,能不用 Saga 就尽量不用。很多场景下,本地消息表 + 幂等消费比 Saga 简单得多。Saga 的真正价值在于长事务(比如跨多个服务、执行时间超过 10 秒的流程),短事务用本地消息表就够了。"
Q4:康威定律说"架构由组织决定",那如果组织暂时无法调整(比如团队划分本身就混乱),微服务架构还能做吗?
直接回答:可以做,但必须接受"架构会反映组织的混乱"这个事实。
现实策略:
策略一:先从单体内部做模块化(推荐)
组织混乱时,不要急着拆服务。先在单体内部用 DDD 划分限界上下文,用包结构、模块化来隔离业务边界。这不需要组织调整,但为未来拆分做好了准备。
com.example
├── order          // 订单模块(包级别隔离)
│   ├── domain
│   ├── application
│   └── infrastructure
├── payment        // 支付模块(包级别隔离)
│   ├── domain
│   ├── application
│   └── infrastructure
└── shared         // 共享内核
等组织调整到位后,把 order 包拆成独立服务,几乎不需要改代码结构。
策略二:用"技术债"换"业务敏捷"
如果必须在组织混乱时拆分,那就接受一个事实:服务边界会跟组织一样混乱。你的策略是:
- 先拆出最独立的服务(通知、文件、认证)
- 标记哪些服务边界是"临时不正确"的(文档化技术债)
- 等组织调整后重新划分服务边界
策略三:反向使用康威定律
如果组织混乱是因为"没有人知道谁该负责什么",那就先定义服务边界,再根据服务边界来重组团队。这其实就是逆康威定律——让架构反推组织。
面试中展现深度的回答:
"我辅导过的一个团队,当时 30 个人在一个仓库里开发,组织上按前端/后端/DBA 划分。我们没急着拆服务,而是先做了三件事:
- 在代码里按业务域划分了 6 个 Maven 模块
- 每个模块指定了 owner(虽然这些人还在同一个团队里)
- 定了一个规则:跨模块的改动必须找 owner review
就这三步,不需要任何组织调整,代码的耦合度就大幅下降了。三个月后,组织调整水到渠成。核心逻辑:先让代码结构对齐你想要的架构,再让组织对齐代码结构,最后才是服务拆分。"
Q5:拆分过程中,旧的单体还在运行,新的服务也在上线,数据库怎么迁移?具体说说你经历过的数据迁移方案。
这是面试中最能体现工程经验的问题。没有实战过的人通常会卡壳。
标准方案:双写 + 灰度 + 对账
阶段一:影子模式(第 0-2 周)
// 新服务上线,但不接流量,只做数据同步验证
@PostMapping("/order")
public void createOrder(@RequestBody Order order) {
    // 1. 写单体数据库(正常流程,不变)
    monolithDb.save(order);

    // 2. 异步写新服务数据库(影子模式)
    newOrderClient.createOrderShadow(order);

    // 3. 对账:比较两个数据库的数据是否一致
    reconciliationService.compare(order.getId());
}
阶段二:双写阶段(第 3-4 周)
// 新服务开始接流量,但单体仍然全量写入
@PostMapping("/order")
public void createOrder(@RequestBody Order order) {
    // 同时写两个数据库
    monolithDb.save(order);       // 旧库
    newOrderClient.createOrder(order);  // 新库

    // 如果新库写入失败,记录到补偿表
    if (!newWriteSuccess) {
        compensationTaskDao.save(order);
    }
}
阶段三:灰度切流(第 5-6 周)
// 根据用户 ID 哈希,逐步将读流量切到新服务
public Order getOrder(Long orderId) {
    Long userId = getUserIdByOrderId(orderId);
    if (userId % 100 < grayPercent) {
        return newOrderClient.getOrder(orderId);  // 新服务
    }
    return monolithDb.getOrder(orderId);  // 旧服务
}
阶段四:全量切换 + 废弃旧表(第 7-8 周)
灰度 100% 后,再观察 1-2 周,确认无问题后下线旧表。
物理数据迁移(一次性):
对于历史数据,不要边拆边迁,而是:
- 找一个低峰期(比如凌晨 3 点)
- 用工具(如 DataX、Canal、自研脚本)批量迁移
- 迁移期间开启双写,确保不丢数据
- 迁移完成后运行对账脚本
面试中展现深度的回答:
"我经历过一次 MySQL 到 MySQL 的拆分迁移,200 张表拆到 8 个独立实例。最大的坑不是技术,而是数据不一致的回滚预案。
我们做了三件事来保证安全:
- 双写期间,所有写入操作都记录到一张
**migration_log**表,记录了旧库 ID、新库 ID、操作时间、操作类型。如果新库有问题,可以根据这张表回滚 - 对账脚本每小时跑一次,对比新旧两边的数据,发现不一致自动告警
- 灰度不是只按百分比,而是按业务线。先灰度一个非核心业务线(比如内部管理系统),跑一周,再灰度一个 C 端小业务线,最后才灰度核心交易链路
另外,很多人忽略了一个点:数据库迁移不只是数据,还有定时任务、存储过程、视图。这些也要一并迁移或改造。"
Q6:拆分后你发现一个下单流程要跨 7 个服务,每个服务 p99 延迟 50ms,用户感知延迟是多少?怎么优化?
延迟计算:
如果 7 个服务是串行调用,用户感知延迟 ≈ 7 × 50ms = 350ms。但如果考虑长尾效应(p99 叠加),实际 p99 延迟远超 350ms。
数学上:每个服务 p99=50ms,串行 7 个的 p99:
- 乐观情况(独立同分布):≈ 50ms × 7 = 350ms(但尾延迟叠加后会更差)
- 实际工程中:由于网络抖动、GC 停顿、线程池排队等因素,7 个服务串行的 p99 很可能在 500ms-800ms
优化策略(按优先级排):
策略一:并行化(最直接)
// 串行:350ms
UserInfo user = userClient.getUser(userId);           // 50ms
Product product = productClient.getProduct(productId); // 50ms
Inventory inv = inventoryClient.checkStock(productId); // 50ms
Coupon coupon = couponClient.verifyCoupon(couponId);   // 50ms
Price price = priceClient.calculatePrice(items);        // 50ms
// ... 总共 350ms+

// 并行化:≈ 50ms(取最慢的那个)
CompletableFuture<UserInfo> userFuture =
    CompletableFuture.supplyAsync(() -> userClient.getUser(userId));
CompletableFuture<Product> productFuture =
    CompletableFuture.supplyAsync(() -> productClient.getProduct(productId));
CompletableFuture<Inventory> invFuture =
    CompletableFuture.supplyAsync(() -> inventoryClient.checkStock(productId));
CompletableFuture<Coupon> couponFuture =
    CompletableFuture.supplyAsync(() -> couponClient.verifyCoupon(couponId));

CompletableFuture.allOf(userFuture, productFuture, invFuture, couponFuture).join();
策略二:数据冗余/缓存
如果商品信息在订单流程中频繁出现,直接在订单服务里冗余一份商品快照,下单时不需要远程调商品服务。
// 订单服务本地冗余商品信息
public class OrderService {
    public void createOrder(CreateOrderRequest req) {
        // 不需要调商品服务,直接用发布时的商品快照
        ProductSnapshot snapshot = productSnapshotCache.get(req.getProductId());
        // 如果缓存未命中,降级调商品服务,但这是少数情况
    }
}
策略三:异步化(非关键路径)
下单流程中,不是所有步骤都需要同步完成。比如:
- 发送通知 → 异步
- 发优惠券 → 异步
- 更新用户画像 → 异步
策略四:合并请求(减少调用次数)
// 不要这样:每个商品调一次库存服务
for (CartItem item : cart.getItems()) {
    inventoryClient.checkStock(item.getProductId());  // N 次调用
}

// 应该这样:一次批量查询
inventoryClient.batchCheckStock(cart.getItemIds());  // 1 次调用
面试中展现深度的回答:
"从 350ms 优化到 50ms 的关键一定是并行化。但并行化之后,你的瓶颈就变成了线程池。
我遇到过一个真实案例:并行化后,p99 从 350ms 降到了 80ms,但 QPS 上来后发现线程池满了,大量请求排队。原因是我们用了 ForkJoinPool.commonPool(),它被所有 CompletableFuture 共享,当请求量上去后,线程池成了新的瓶颈。
解决方案是为下单流程分配独立的线程池,并根据 Little 定律计算线程数:线程数 = 目标 QPS × 平均响应时间。对于 1000 QPS、平均响应 50ms,需要约 50 个线程。
另外,如果并行化之后还不能满足延迟要求,就要考虑数据冗余。把商品信息、用户信息在下单时冗余一份到订单里,这是用空间换时间,但要注意数据一致性问题——商品价格变了,订单里的快照还是旧价格。这需要业务上接受'订单记录的是下单时的价格'这个语义。"
面试建议:以上问题在面试中通常会以"连环追问"的形式出现——面试官会根据你的回答不断深入追问。建议你不仅记住答案,更要理解每个答案背后的权衡逻辑。好的架构师不是说"这个方案最好",而是说"在这个场景下,这个方案比那个方案更好,因为……"。
本文是 Java 技术专家与架构师面试 250 个高频考点系列的第 176 篇。