阅读时间:约 45 分钟 适用人群:Java 高级工程师、技术专家、架构师 前置知识:RPC 基础概念、Java SPI 机制、Spring 容器基础
一、为什么 Dubbo 是面试必问的微服务框架
在 Java 生态中,Dubbo 不是你"用过"的框架,而是你需要"理解"的框架。它和 Spring Cloud 一起构成了国内微服务架构的两大支柱,但 Dubbo 的设计哲学更贴近高性能 RPC 的本质——它不绑定 HTTP、不依赖 Servlet 容器、以协议和序列化可插拔为设计目标。
面试官问 Dubbo,不是在问"你会不会配置 XML",而是在问:
- 你理解 RPC 框架从代理到网络传输的完整链路吗?
- 你知道一个服务是如何从本地调用变成远程调用的吗?
- 集群容错、路由、负载均衡这些概念在代码层面是怎么串联的?
- 当一个框架设计了 300+ 个扩展点,它是如何在"稳定性"和"灵活性"之间取得平衡的?
这篇文章会从 Dubbo 的核心架构出发,逐层拆解服务暴露、服务引用、集群容错、路由和负载均衡的实现原理,并且以 SPI 扩展机制为线索串联整个体系。
二、Dubbo 分层架构总览
Dubbo 的整体架构可以概括为 三层 + 两大机制:
- 三层:业务层(Business)、RPC 层(Remote Procedure Call)、Remoting 层(远程通信)
- 两大机制:SPI 扩展机制(横切所有层)、服务治理机制(注册中心、配置中心、元数据中心)
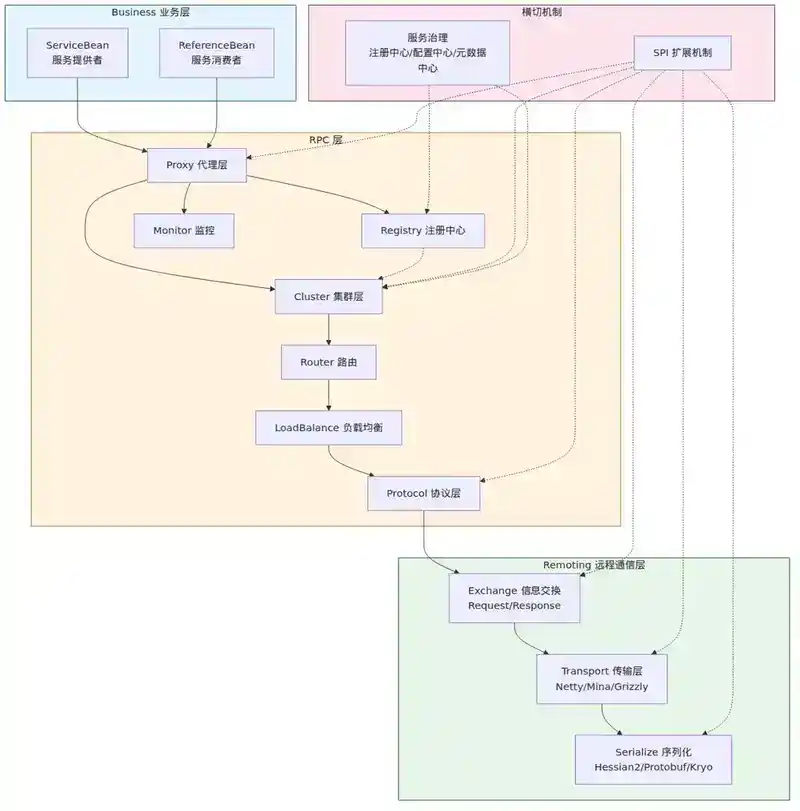
2.1 三层架构详解
业务层(Business):面向用户的 API 层。开发者通过 @DubboService 暴露服务,通过 @DubboReference 引用服务。这一层负责将业务接口转换为 Dubbo 内部的 ServiceConfig 和 ReferenceConfig。
RPC 层(核心):这是 Dubbo 最复杂的部分,负责:
- 代理(Proxy):生成服务的客户端代理和服务端 Invoker 包装
- 注册中心(Registry):服务地址的注册与发现
- 集群(Cluster):将多个服务提供者抽象为一个 Cluster Invoker,内部包含路由、负载均衡和容错
- 协议(Protocol):服务暴露和引用的入口,管理 Exporter 和 Invoker 的生命周期
- 监控(Monitor):调用次数、耗时等统计
Remoting 层:负责网络通信,包括:
- 信息交换(Exchange):将请求/响应模型封装为 Request/Response 对象
- 传输层(Transport):抽象了 Netty、Mina、Grizzly 等网络框架
- 序列化(Serialize):Hessian2、Protobuf、Kryo、Fastjson2 等
2.2 核心领域模型
理解 Dubbo 源码,首先要理解这几个核心对象的关系:
| 对象 | 职责 | 生命周期 |
|---|---|---|
Invoker |
可执行对象,封装了服务的地址和调用方法 | 调用期间 |
Invocation |
一次调用的上下文,包含方法名、参数、返回值类型等 | 单次调用 |
Exporter |
服务暴露后的持有对象,维护了 Invoker 与 URL 的映射 | 服务运行期间 |
URL |
Dubbo 的"配置总线",所有配置都以 URL 参数的形式传递 | 全局 |
Result |
RPC 调用的返回结果,包含返回值或异常 | 单次调用 |
其中 URL 是 Dubbo 最核心的设计——它不是 HTTP 的 URL,而是 Dubbo 内部的一个配置传递模型,格式为:protocol://host:port/path?key1=value1&key2=value2。Dubbo 的整个扩展点体系都依赖 URL 进行参数传递和配置决策。
2.3 Dubbo 调用链全景
一次完整的 Dubbo RPC 调用链路如下:
Consumer 端:
  Proxy(JDK/Javassist) → ClusterInvoker → Directory(Registry) → Router → LoadBalance
  → Filter Chain → Protocol(Invoker) → ExchangeClient → Transport(Netty) → Serialize

Provider 端:
  Transport(Netty) → Deserialize → ExchangeServer → Protocol(Exporter)
  → Filter Chain → Invoker(ServiceBean) → 实际业务实现
三、Dubbo SPI —— 框架的"灵魂插件"
Dubbo 的 SPI(Service Provider Interface)不是 JDK 原生的 SPI,而是 Dubbo 自研的增强版 SPI。它是理解 Dubbo 所有扩展机制的前提。
3.1 JDK SPI 的局限
JDK 原生 SPI 有三个核心问题 Dubbo 不能接受:
- 全量加载:
ServiceLoader.load()会实例化所有实现类,Dubbo 有 300+ 扩展点,全部加载不可接受 - 无扩展点命名:无法按名称获取特定实现,只能用
Iterator遍历 - 无 AOP/IOC 能力:扩展点之间无法依赖注入,也无法做包装增强
3.2 Dubbo SPI 的核心设计
Dubbo SPI 通过 ExtensionLoader 实现,核心特性:
按需加载 + 缓存:
// 只加载指定名称的实现
Protocol protocol = ExtensionLoader
    .getExtensionLoader(Protocol.class)
    .getExtension("dubbo");
扩展点配置文件:META-INF/dubbo/internal/ 下的文件,格式为 name=full.class.name:
dubbo=org.apache.dubbo.rpc.protocol.dubbo.DubboProtocol
rest=org.apache.dubbo.rpc.protocol.rest.RestProtocol
自动包装(AOP):如果扩展实现类有一个构造函数接受同类型的参数,Dubbo 会自动将其包装:
public class ProtocolFilterWrapper implements Protocol {
    private final Protocol protocol;
    // Dubbo 自动将真正的 Protocol 实现注入
    public ProtocolFilterWrapper(Protocol protocol) {
        this.protocol = protocol;
    }
}
自动注入(IOC):通过 setter 方法自动注入其他扩展点:
public class DubboProtocol extends AbstractProtocol {
    // Dubbo 自动注入 ExchangeClient 的 Adaptive 扩展
    private ExchangeClient exchangeClient;
    public void setExchangeClient(ExchangeClient client) {
        this.exchangeClient = client;
    }
}
Adaptive 自适应扩展:@Adaptive 注解标记在类上或方法上,根据 URL 参数动态选择实现:
@SPI("dubbo")
public interface Protocol {
    @Adaptive
    <T> Exporter<T> export(Invoker<T> invoker) throws RpcException;
}
当调用 Protocol 的 export 方法时,Dubbo 会自动生成一个 Protocol$Adaptive 类,根据 invoker.getUrl().getProtocol() 的值动态选择对应的 Protocol 实现。
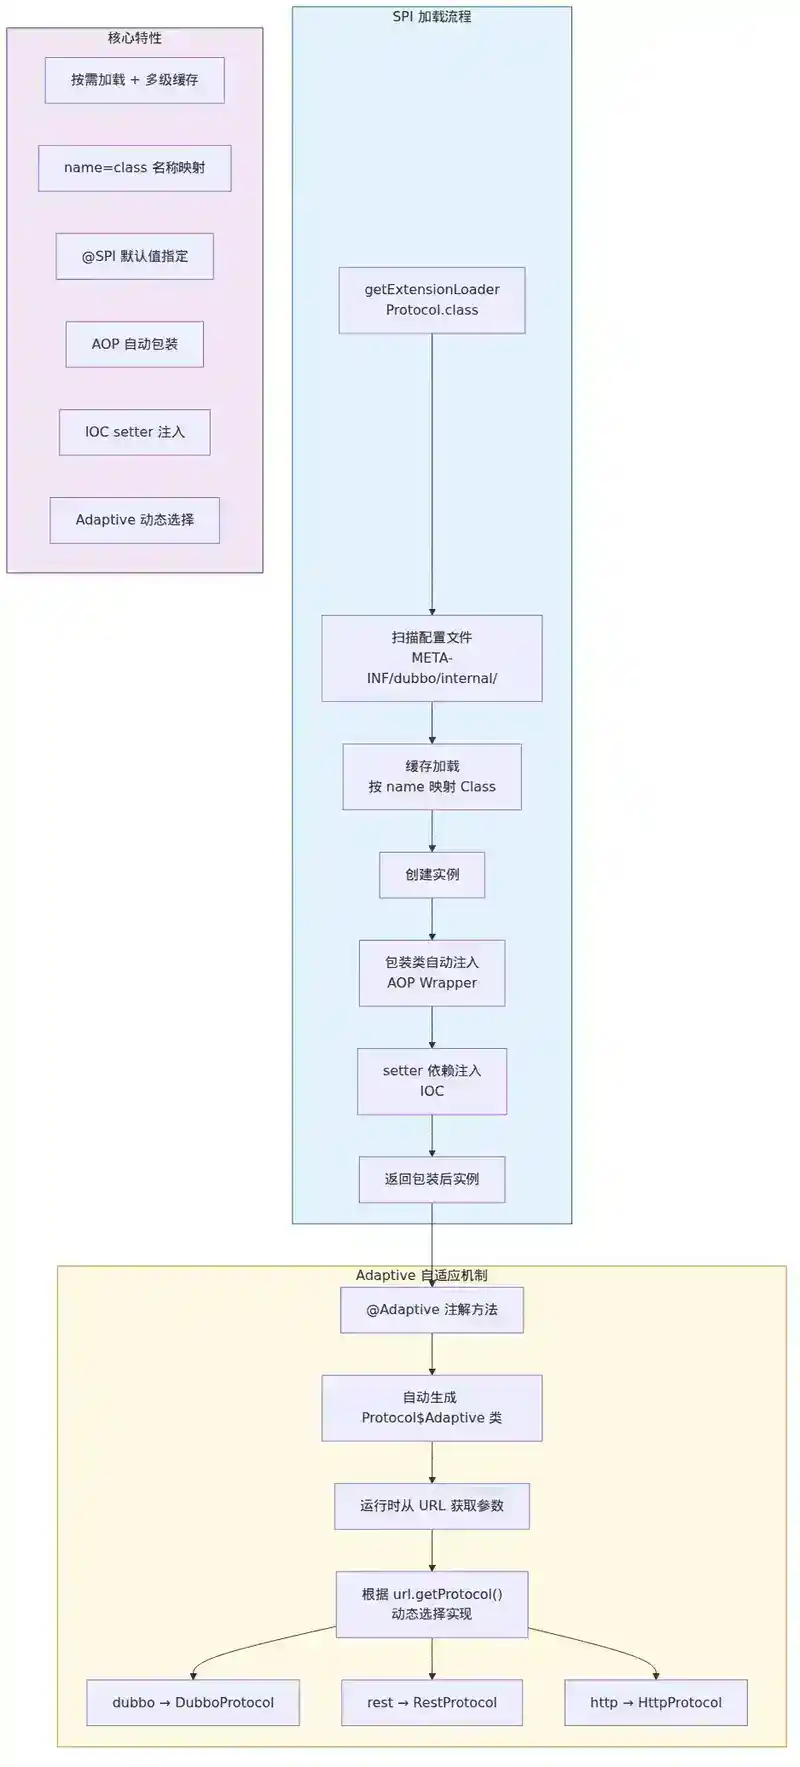
3.3 SPI 的加载流程
ExtensionLoader.getExtensionLoader(Protocol.class)
  → 扫描 META-INF/dubbo/internal/ 下的配置文件
  → 按 name 映射到对应的 Class
  → 创建实例(包装类自动注入)
  → 注入 setter 依赖(IOC)
  → 返回包装后的实例
3.4 SPI 是贯穿全篇的钥匙
理解 SPI 之后,再看 Dubbo 的任何模块都会发现同一个模式:接口定义 + @SPI 注解 + 多个实现 + Adaptive 动态选择。下面讲的服务暴露、集群容错、路由、负载均衡,全部基于 SPI 机制。
四、服务暴露:从本地 Bean 到网络端口
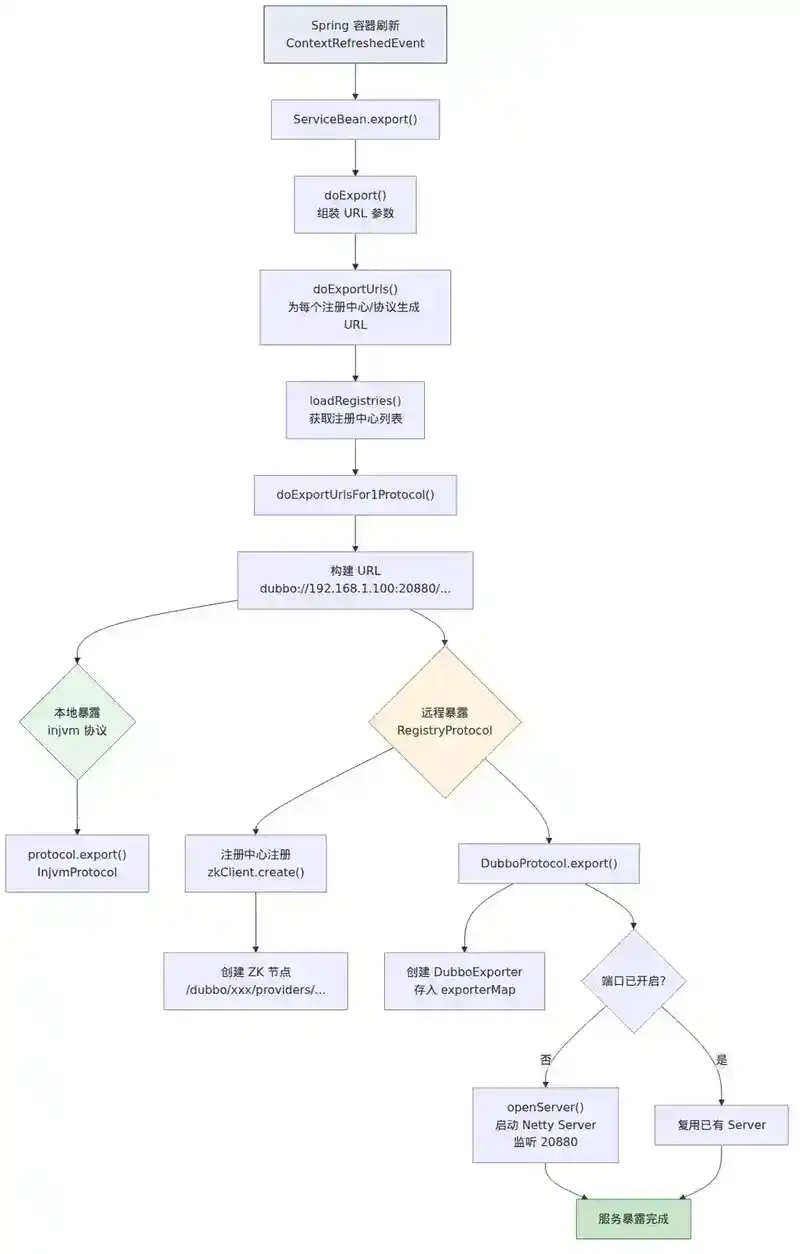
服务暴露是将本地 Spring Bean 注册到注册中心并绑定到网络端口的过程。Dubbo 的服务暴露分为两个阶段:本地暴露和远程暴露。
4.1 服务暴露的触发时机
在 Spring 容器中,ServiceBean 实现了 ApplicationListener<ContextRefreshedEvent>,当 Spring 容器刷新完成时触发 export()。如果你是 Dubbo 3.x 用户,@DubboService 注解的解析由 ServiceClassPostProcessor 在 Bean 注册阶段完成,但实际的暴露仍在容器刷新后。
4.2 暴露全流程
ServiceBean.export()
  → doExport() // 组装 URL:从 @DubboService 注解、XML 配置、系统属性等合并参数
  → doExportUrls() // 为每个注册中心和协议生成 URL
  → loadRegistries() // 获取注册中心地址列表
  → doExportUrlsFor1Protocol(protocolConfig)
    → 构建 URL,例如:dubbo://192.168.1.100:20880/com.example.HelloService?version=1.0.0&...
    → 本地暴露:protocol.export(invoker) // 默认 injvm 协议,同 JVM 走本地调用
    → 远程暴露:registryProtocol.export(invoker)
      → 注册中心注册:zkClient.create("/dubbo/com.example.HelloService/providers/...")
      → 协议暴露:DubboProtocol.export(invoker) // 开启 Netty Server 监听 20880
4.3 关键源码分析
DubboProtocol.export():
public <T> Exporter<T> export(Invoker<T> invoker) throws RpcException {
    URL url = invoker.getUrl();
    String key = serviceKey(url); // 例如:com.example.HelloService:20880
    // 创建 DubboExporter,持有 invoker 引用
    DubboExporter<T> exporter = new DubboExporter<>(invoker, key, exporterMap);
    exporterMap.put(key, exporter);
    // 开启 Netty Server(如果该端口还没有)
    openServer(url);
    return exporter;
}
openServer() 的逻辑:先检查 serverMap 中是否已有同 host:port 的 Server 实例,有则复用,无则创建。这就是为什么同端口可以暴露多个服务。
4.4 URL 的组装规则
URL 是 Dubbo 服务暴露和引用的配置核心。一个典型的 Dubbo URL 长这样:
dubbo://192.168.1.100:20880/com.example.HelloService
?anyhost=true
&application=demo-provider
&deprecated=false
&dubbo=2.0.2
&dynamic=true
&generic=false
&interface=com.example.HelloService
&methods=sayHello
&pid=12345
&timeout=3000
&version=1.0.0
URL 参数的来源优先级(从高到低):
- JVM 系统属性(
-D参数) - 配置文件(
dubbo.properties) @DubboService/@DubboReference注解属性- XML 配置(
<dubbo:service>) @SPI接口的默认值
五、服务引用:从接口代理到远程调用
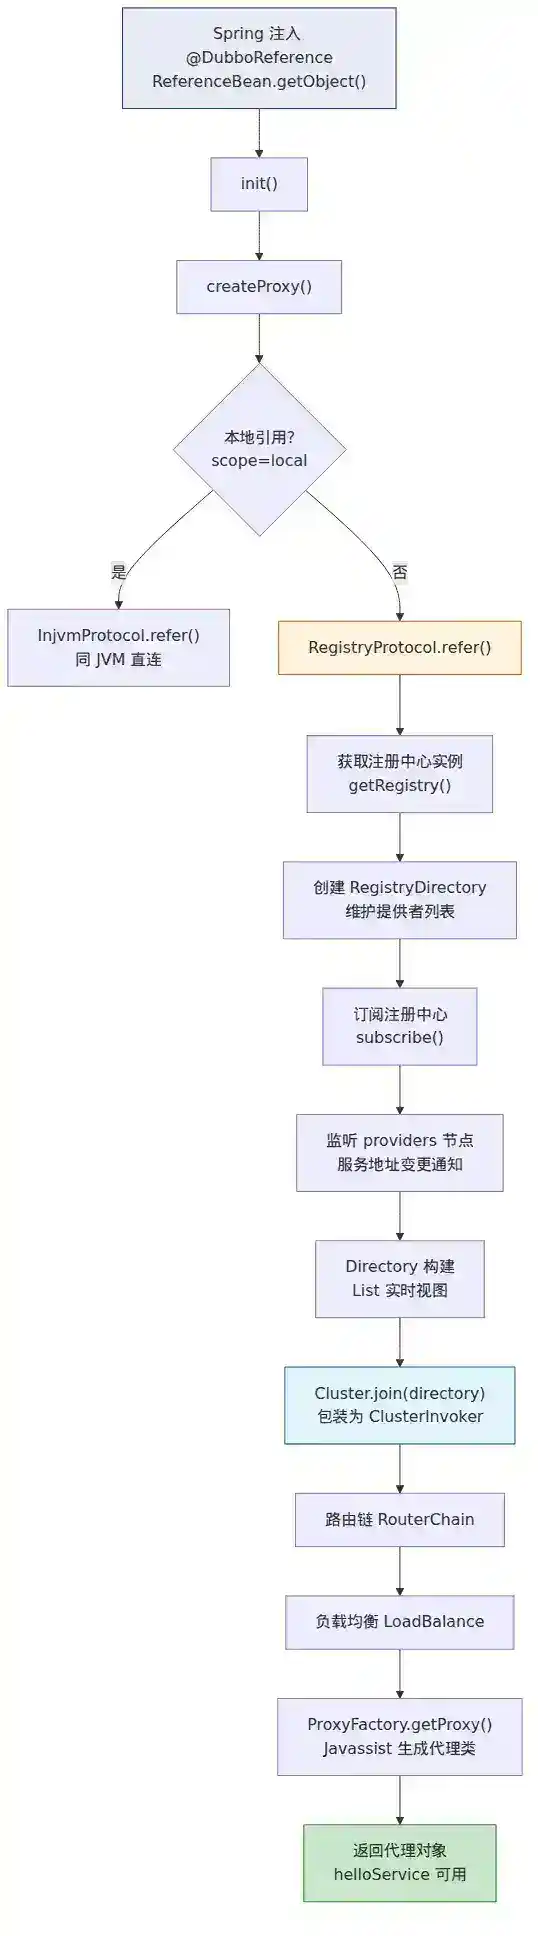
服务引用是将远程服务包装成本地代理对象的过程。消费者调用 helloService.sayHello() 时,实际执行的是代理对象的 invoke 方法,最终通过网络发送 RPC 请求。
5.1 服务引用的触发时机
ReferenceBean 同样实现了 InitializingBean 和 FactoryBean。当 Spring 容器在注入 @DubboReference 属性时,会调用 ReferenceBean.getObject(),触发 init() → createProxy()。
5.2 引用全流程
ReferenceBean.getObject()
  → init()
    → createProxy(map)
      → 判断是本地引用(injvm)还是远程引用
      → 远程引用:protocol.refer(interfaceClass, url)
        → RegistryProtocol.refer()
          → 订阅注册中心:zkClient.subscribe("/dubbo/com.example.HelloService/providers")
          → 获取提供者地址列表 → 构建 Directory
          → Cluster.join(directory) // 将多个 Invoker 聚合成一个 ClusterInvoker
          → 返回代理对象:ProxyFactory.getProxy(clusterInvoker)
5.3 关键源码分析
RegistryProtocol.refer():
public <T> Invoker<T> refer(Class<T> type, URL url) throws RpcException {
    // 1. 获取注册中心实例
    Registry registry = getRegistry(url);
    // 2. 创建 RegistryDirectory,负责服务发现和地址列表维护
    RegistryDirectory<T> directory = new RegistryDirectory<>(type, url);
    directory.setRegistry(registry);
    directory.setProtocol(protocol);
    // 3. 订阅注册中心
    directory.subscribe(subscribeUrl.addParameter(CATEGORY_KEY,
        PROVIDERS_CATEGORY + "," + CONFIGURATORS_CATEGORY + "," + ROUTERS_CATEGORY));
    // 4. 将 Directory 包装为 ClusterInvoker
    return cluster.join(directory);
}
RegistryDirectory 是消费者端的核心组件,它:
- 监听注册中心的服务提供者列表变化
- 将每个提供者 URL 转换为一个
Invoker对象 - 维护一个
List<Invoker>的实时视图 - 当列表变化时,通知上层 Cluster 刷新
5.4 代理对象的创建
Dubbo 默认使用 Javassist 生成代理类。代理类大致长这样:
public class proxy0 implements HelloService {
    public String sayHello(String name) {


        Invocation inv = new RpcInvocation("sayHello", new Class[ ]{String.class}, new Object[ ]{name});


        Result result = handler.invoke(inv);
        return result.recreate();
    }
}
六、集群容错:当服务提供者不可用时
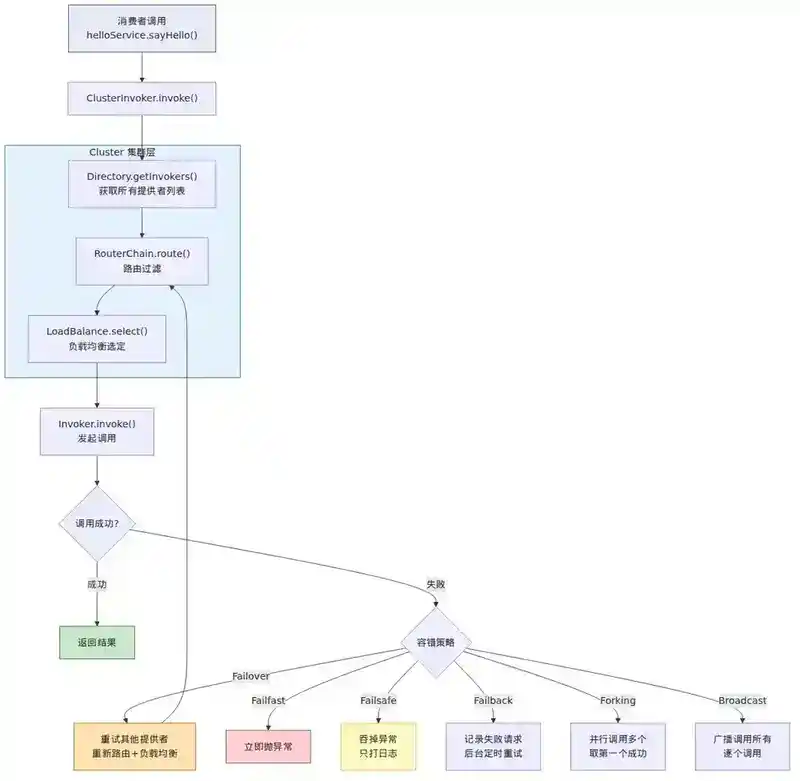
集群(Cluster)将多个服务提供者抽象为一个逻辑整体,对外暴露一个 ClusterInvoker。当消费者发起调用时,Cluster 内部经过路由、负载均衡选出目标 Invoker 执行,如果失败则根据容错策略处理。
6.1 集群组件架构
ClusterInvoker
  └── Directory(服务目录)
  └── Router(路由器)
  └── LoadBalance(负载均衡)
6.2 六大容错策略
Dubbo 内置了 6 种容错策略,通过 @SPI("failover") 标记默认策略:
| 策略 | 类名 | 行为 | 适用场景 |
|---|---|---|---|
| Failover | FailoverClusterInvoker |
失败自动切换,重试其他提供者 | 幂等操作(默认) |
| Failfast | FailfastClusterInvoker |
快速失败,只发一次调用,失败立即抛异常 | 非幂等写入 |
| Failsafe | FailsafeClusterInvoker |
失败安全,吞掉异常只打日志 | 日志写入、审计 |
| Failback | FailbackClusterInvoker |
失败自动恢复,后台定时重试 | 消息通知 |
| Forking | ForkingClusterInvoker |
并行调用多个提供者,取第一个成功返回 | 实时性要求高 |
| Broadcast | BroadcastClusterInvoker |
广播调用所有提供者,逐个调用 | 通知所有提供者 |
6.3 FailoverClusterInvoker 源码解读
public Result doInvoke(Invocation invocation, List<Invoker<T>> invokers, LoadBalance loadbalance) {
    List<Invoker<T>> copyInvokers = invokers;
    int len = getUrl().getMethodParameter(invocation.getMethodName(), RETRIES_KEY, 2) + 1;
    RpcException le = null;
    List<Invoker<T>> invoked = new ArrayList<>(len);
    for (int i = 0; i < len; i++) {
        // 重试前重新做路由和负载均衡选择
        Invoker<T> invoker = select(loadbalance, invocation, copyInvokers, invoked);
        invoked.add(invoker);
        try {
            Result result = invoker.invoke(invocation);
            return result;
        } catch (RpcException e) {
            le = e;
        }
        // 下一次重试时,从候选列表中移除已失败的
        copyInvokers = invokers;
        if (copyInvokers.size() == invoked.size()) {
            break; // 没有更多可用的提供者了
        }
    }
    throw le; // 全部失败,抛出最后一个异常
}
关键点:每次重试前都会重新执行路由和负载均衡,这保证了重试能选到不同的提供者。
6.4 集群容错的生产实践
重试次数设置:建议 retries=0 用于非幂等操作(如扣款),retries=2 用于幂等操作(如查询)。
实际场景:假设你有一个支付服务,3 个提供者。如果使用 failover + retries=2,第一次调用失败后会重试另一个提供者,但重试可能导致重复扣款。因此在 Dubbo 中,写操作应使用 failfast(retries=0),或者在服务端做幂等保证。
七、路由规则:谁可以调用谁
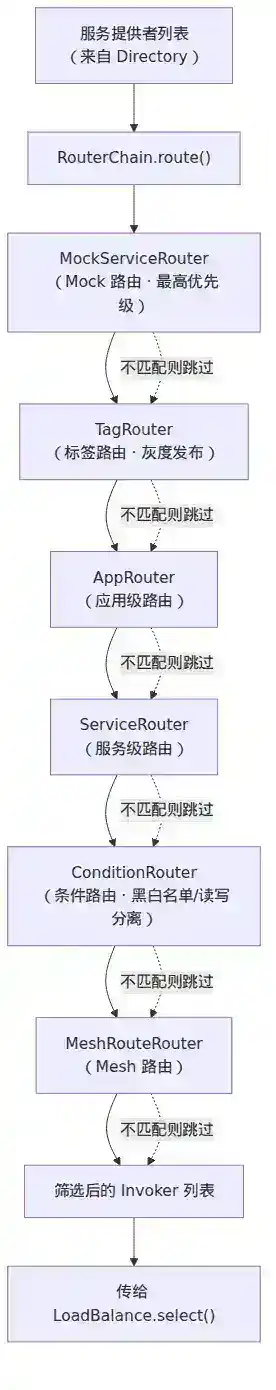
路由(Router)在负载均衡之前执行,负责从服务提供者列表中筛选出符合条件的子集。简单说:路由回答"哪些提供者可以调用",负载均衡回答"选哪个来调用"。
7.1 路由链
Dubbo 的路由是一个责任链,多个 Router 按优先级串联执行:
Invoker 列表
  → MockServiceRouter(Mock 路由,最高优先级)
  → TagRouter(标签路由,用于灰度发布)
  → AppRouter(应用级路由,基于应用名匹配)
  → ServiceRouter(服务级路由,基于服务名匹配)
  → ConditionRouter(条件路由)
  → MeshRouteRouter(Mesh 路由)
  → 筛选后的 Invoker 列表 → 负载均衡
7.2 条件路由(ConditionRouter)
条件路由是 Dubbo 最经典的动态路由方式,通过管理后台配置规则,无需重启应用。
规则格式:[服务消费者匹配条件] => [服务提供者匹配条件]
// 示例 1:强制灰度
host = 10.20.153.10 => host = 10.20.153.*

// 示例 2:读写分离
method = find*,list*,get*,query* => host = 172.22.3.91,172.22.3.92
method != find*,list*,get*,query* => host = 172.22.3.93

// 示例 3:黑白名单
host != 10.20.153.10 =>
Dubbo 会将条件路由规则解析为 MatchPair 对,消费端匹配条件(whenCondition)和提供端匹配条件(thenCondition)分别存储在 Map<String, MatchPair> 中。
7.3 标签路由(TagRouter)
标签路由是 Dubbo 2.7 引入的灰度发布利器。工作流程:
- 消费者通过
RpcContext设置请求标签:RpcContext.getClientAttachment().setAttachment("dubbo.tag", "gray"); - TagRouter 在路由时,优先匹配携带同名标签的提供者
- 如果没有匹配到 Tag 提供者,根据
force参数决定是降级到普通提供者还是直接报错
# 配置示例
tag-router:
  force: false  # force=false 时降级到普通提供者
  tags:
    - name: gray
      addresses: ["192.168.1.101:20880", "192.168.1.102:20880"]
7.4 路由失效的热更新
路由规则存储在注册中心(如 ZooKeeper 的 /dubbo/config/dubbo/ 路径下),RegistryDirectory 不仅监听 providers 节点,还监听 routers 和 configurators 节点。规则变更后,RouterChain 自动重建,秒级生效。
八、负载均衡:选哪个提供者来调用
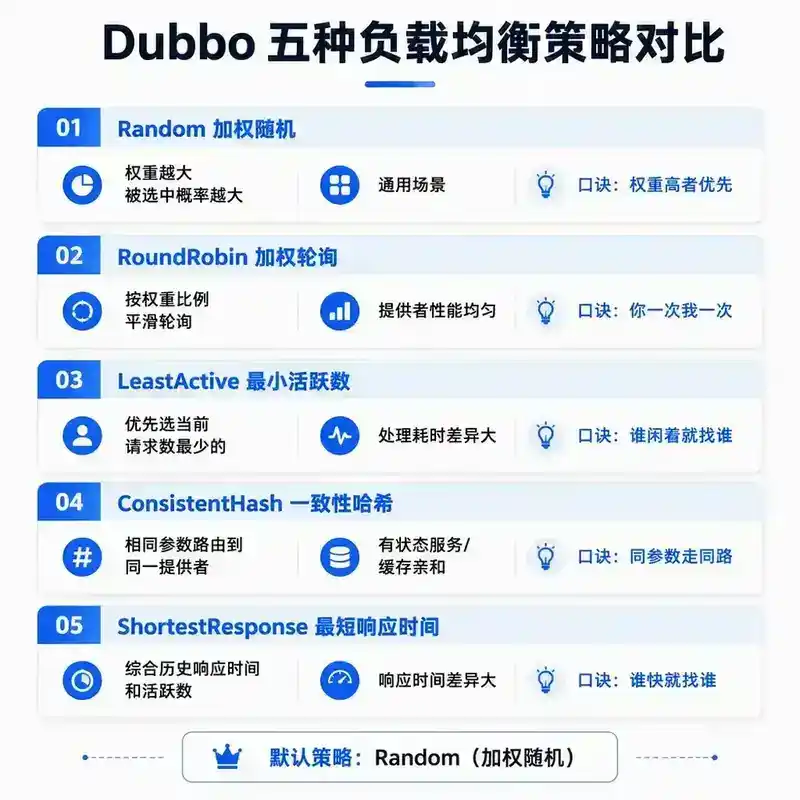
经过路由筛选后,剩余的是一个或多个候选项。负载均衡负责从中选出一个 Invoker 执行调用。
8.1 五种负载均衡策略
Dubbo 通过 @SPI(RandomLoadBalance.NAME) 默认使用加权随机策略。
| 策略 | 类名 | 算法 | 核心思想 |
|---|---|---|---|
| Random | RandomLoadBalance |
加权随机 | 权重越大,被选中的概率越大 |
| RoundRobin | RoundRobinLoadBalance |
加权轮询 | 按权重比例平滑轮询,Nginx 同款算法 |
| LeastActive | LeastActiveLoadBalance |
最小活跃数 | 优先选当前正在处理的请求数最少的提供者 |
| ConsistentHash | ConsistentHashLoadBalance |
一致性哈希 | 相同参数的请求总是落到同一提供者 |
| ShortestResponse | ShortestResponseLoadBalance |
最短响应时间 | 综合历史响应时间和当前活跃数 |
8.2 加权随机算法详解
protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
    int totalWeight = 0;
    boolean sameWeight = true;
    // 1. 计算总权重
    for (int i = 0; i < invokers.size(); i++) {
        int weight = getWeight(invokers.get(i), invocation);
        totalWeight += weight;
        if (sameWeight && i > 0 && weight != getWeight(invokers.get(i-1), invocation)) {
            sameWeight = false;
        }
    }
    // 2. 随机偏移
    if (totalWeight > 0 && !sameWeight) {
        int offset = ThreadLocalRandom.current().nextInt(totalWeight);
        for (Invoker<T> invoker : invokers) {
            offset -= getWeight(invoker, invocation);
            if (offset < 0) {
                return invoker;
            }
        }
    }
    // 3. 权重相同则纯随机
    return invokers.get(ThreadLocalRandom.current().nextInt(invokers.size()));
}
权重计算支持预热(Warmup):服务刚启动时权重较低,逐步提升到配置值,避免刚启动的实例被大量流量打垮。
8.3 加权轮询(平滑加权轮询)
Dubbo 的 RoundRobin 实现的是 Nginx 同款平滑加权轮询算法。核心思想:每次选择时,每个提供者的 currentWeight 加上其 weight,选出 currentWeight 最大的,然后将其 currentWeight 减去总权重。
假设 A(weight=5), B(weight=1), C(weight=1)
第1轮: A+=5→5, B+=1→1, C+=1→1 → 选 A, A-=7→-2
第2轮: A+=5→3, B+=1→2, C+=1→2 → 选 A, A-=7→-4
第3轮: A+=5→1, B+=1→3, C+=1→3 → 选 B, B-=7→-4
...
这种算法保证了:权重高的节点被选中的次数按比例分配,但不会连续多次选中同一节点,避免负载尖刺。
8.4 一致性哈希的适用场景
一致性哈希适合有状态服务或需要缓存亲和性的场景。相同参数(或通过 hash.arguments 指定的参数)的请求总是路由到同一台机器:
// 配置:对方法 getOrder 的前 2 个参数做哈希
@DubboReference(loadbalance = "consistenthash", parameters = {"hash.arguments", "0,1"})
private OrderService orderService;
8.5 负载均衡与集群容错的协作
负载均衡不是独立工作的:
ClusterInvoker.invoke()
  → 获取 Directory 中的 Invoker 列表
  → RouterChain.route() 过滤
  → LoadBalance.select() 选中一个
  → 调用 invoke()
  → 如果失败:
    → Failover:重试,重新走 Router + LoadBalance
    → Failfast:直接抛异常
    → Failsafe:吞掉异常
九、一次 RPC 调用的完整链路
结合上面的所有模块,我们来看一次 Dubbo RPC 调用的完整路径:
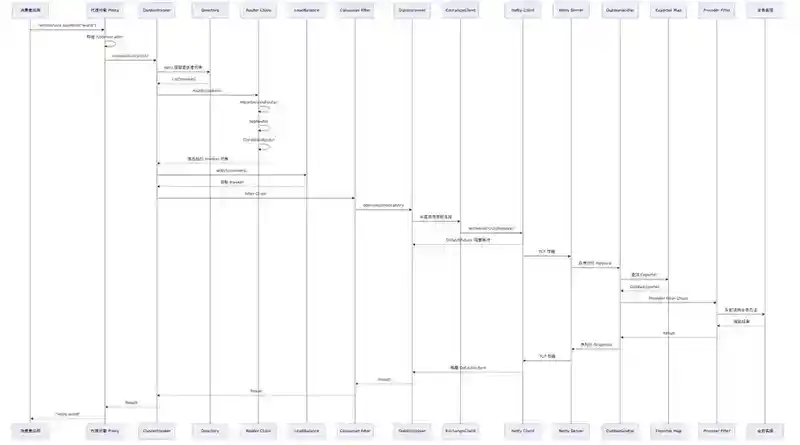
消费者端(Consumer)
1. helloService.sayHello("world")
   → 代理对象 proxy0.sayHello("world")
   → 构造 RpcInvocation(方法名, 参数类型, 参数值)

2. ClusterInvoker.invoke(invocation)
   → 从 Directory 获取提供者列表
   → Router Chain 路由过滤
   → LoadBalance 选择目标 Invoker

3. 经过 Consumer Filter Chain
   → MonitorFilter 记录调用统计
   → 其他自定义 Filter

4. DubboInvoker.doInvoke()
   → 从连接池获取 ExchangeClient
   → 构造 Request(id, invocation)
   → 发送请求(Netty Channel.writeAndFlush)

5. 等待响应
   → DefaultFuture 阻塞等待(默认超时 1000ms)
   → 收到响应后唤醒
提供者端(Provider)
6. NettyServerHandler 收到请求
   → 反序列化 Request
   → 交给 ExchangeHandler 处理

7. 根据 serviceKey 从 exporterMap 中查找 DubboExporter
   → 获取服务端 Invoker

8. 经过 Provider Filter Chain
   → MonitorFilter, ExceptionFilter, 自定义 Filter

9. 反射调用实际业务方法
   → Method.invoke(serviceImpl, args)

10. 构造 Response(result)
    → 序列化响应
    → 通过 Channel 写回消费者
十、生产实践与常见陷阱
10.1 超时配置的"三把锁"
Dubbo 的超时可以配置在多个层级,优先级从高到低:
- 方法级:
@DubboReference(timeout = 3000, parameters = {"sayHello.timeout", "2000"}) - 接口级:
@DubboReference(timeout = 3000) - 提供者端:
@DubboService(timeout = 5000)(消费者优先,提供者兜底)
最佳实践:消费者端配置超时,提供者端也配置一个稍大的超时作为兜底。不要只依赖默认的 1000ms。
10.2 版本号与灰度发布
// 提供者
@DubboService(version = "2.0.0")
public class HelloServiceImplV2 implements HelloService {}

// 消费者
@DubboReference(version = "2.0.0")  // 只调用 2.0.0 版本
private HelloService helloService;
配合标签路由实现灰度:先让一小部分消费者打上 dubbo.tag=gray,路由到灰度版本的提供者,验证无误后逐步扩大范围。
10.3 多注册中心的隔离策略
# 消费者:只订阅但不注册
dubbo.registry.address=zookeeper://127.0.0.1:2181?register=false

# 提供者:只注册但不订阅
dubbo.registry.address=zookeeper://127.0.0.1:2181?subscribe=false
这在多机房部署时非常有用,消费者只订阅本地机房的注册中心,避免跨机房调用。
10.4 线程模型:到底是单连接还是连接池
Dubbo 默认使用单一长连接(同一个消费者-提供者对之间共享一个 TCP 连接),这是 Dubbo 高性能的关键设计之一。但这也意味着:
- 如果提供者端业务处理慢,会阻塞该连接上的所有请求
- 可以通过
connections参数增加连接数:@DubboReference(connections = 3) - Dubbo 3.x 引入了 Triple 协议,支持 HTTP/2 多路复用,解决了单连接队头阻塞问题
10.5 异步调用
// 方式 1:CompletableFuture
CompletableFuture<String> future = RpcContext.getServiceContext().asyncCall(
    () -> helloService.sayHello("world")
);
future.whenComplete((result, ex) -> {
    // 处理结果
});

// 方式 2:返回值直接定义为 CompletableFuture
@DubboReference
private HelloService helloService; // 接口方法返回 CompletableFuture<String>
10.6 服务端线程池隔离
Dubbo 默认使用固定大小线程池(200 线程),所有服务共享。如果某个服务耗时长,会拖垮整个提供者:
<!-- 为某个服务单独配置线程池 -->
<dubbo:service interface="com.example.SlowService"
    executors="slowExecutor" />
<dubbo:service interface="com.example.FastService"
    executors="fastExecutor" />
十一、面试官视角提问
请先自行思考,再参考答案。
Q1:Dubbo 的 SPI 和 JDK SPI 的核心区别是什么?为什么 Dubbo 要自己实现一套 SPI?
Q2:Dubbo 服务暴露的"本地暴露"和"远程暴露"有什么区别?什么场景下本地暴露会生效?
Q3:请描述从消费者调用 helloService.sayHello() 到提供者执行完返回结果的完整链路,包括线程切换和网络 IO。
Q4:Failover 策略下,重试时如何保证不会再次选到同一个失败的提供者?如果重试 2 次后仍然失败,Dubbo 会做什么?
Q5:条件路由和标签路由的设计目标有什么不同?什么场景下应该用条件路由,什么场景下用标签路由?
Q6:Dubbo 的加权随机负载均衡中,预热(Warmup)是如何实现的?如果不做预热,新启动的实例会有什么问题?
Q7:Dubbo 默认使用单长连接,这个设计有什么优缺点?Dubbo 3.x 的 Triple 协议是如何解决单连接队头阻塞的?
Q8:假设你有一个 Dubbo 服务,偶尔出现超时,但监控显示提供者 CPU 和内存都很正常。你会怎么排查?
参考答案
A1:三大区别:(1) JDK SPI 全量加载所有实现类,Dubbo SPI 按需加载 + 多级缓存;(2) JDK SPI 没有名称映射,Dubbo SPI 通过 name=class 格式支持按名称获取;(3) Dubbo SPI 支持 AOP(自动包装)和 IOC(setter 注入),这是 JDK SPI 不具备的。为什么自研:Dubbo 有 300+ 扩展点,全量加载不可接受;同时 Dubbo 需要根据 URL 参数动态选择扩展实现(Adaptive 机制),JDK SPI 做不到。
A2:本地暴露使用 injvm 协议,消费者和提供者在同一个 JVM 时生效。Dubbo 默认先本地暴露,如果消费者在同一个 JVM 内,调用会走 injvm 协议,跳过网络传输,直接调用本地方法。远程暴露绑定到网络端口(如 Netty Server 监听 20880)。判断本地引用:如果消费者引用的 URL 中有 scope=local 或在 RegistryDirectory 中发现提供者同 JVM,则走本地调用。
A3:消费者端:代理对象 → ClusterInvoker(路由 + 负载均衡选 Invoker)→ Consumer Filter Chain → DubboInvoker → ExchangeClient 从连接池获取连接 → Netty 通道发送请求 → DefaultFuture 阻塞等待。网络传输:Netty I/O 线程处理编解码。提供者端:Netty I/O 线程收到请求 → 反序列化 → 交业务线程池 → 从 exporterMap 查找 Exporter → Provider Filter Chain → 反射调用实际方法 → 构造 Response → 序列化 → 写回通道。关键线程切换:消费端 Netty I/O 线程 → 业务线程回调;提供端 Netty I/O 线程 → Dubbo 业务线程池。
A4:每次重试前会重新执行 select(loadbalance, invocation, copyInvokers, invoked),其中 invoked 参数会传入已尝试过的 Invoker 列表,select 方法内部会排除已调用的 Invoker。同时,copyInvokers 也会排除已调用项。如果全部提供者都失败,抛出最后一个 RpcException。注意:如果 invoked.size() == copyInvokers.size() 说明没有更多可用提供者,提前退出循环。
A5:条件路由是按属性匹配(如 IP、方法名、参数值),适合静态的黑白名单、读写分离。标签路由是按动态标签匹配,通过 RpcContext 传标签,适合灰度发布、A/B 测试。条件路由的规则在注册中心存储,修改后全局生效;标签路由由消费者主动设置标签,更灵活但需要业务代码配合。
A6:预热通过 getWeight() 方法实现。服务刚启动时,根据启动时间与当前时间的差值,计算一个预热权重:weight = (uptime / warmup) * configuredWeight。随着时间推移,权重从 0 线性增长到配置值。不做预热的问题:新实例刚启动,JIT 还未优化、连接池未建立,性能远低于稳定运行的实例,如果立即接收全量流量会导致超时和雪崩。
A7:优点:减少连接开销(TCP 握手、内存占用),适合服务提供者少的场景;缺点:单连接队头阻塞,一个慢请求阻塞后续所有请求。Dubbo 3.x Triple 协议基于 HTTP/2,支持 Stream 多路复用——在单个 TCP 连接上建立多个逻辑 Stream,各 Stream 独立传输,互不阻塞。同时 Triple 还支持 Server Push 和双向流。
A8:排查思路:(1) 确认是偶发还是持续——看监控的 P99/P999 分布;(2) 检查 GC 日志——是否有 STW 导致的暂停;(3) 检查 Dubbo 线程池——dubbo- 开头的线程是否全部繁忙;(4) 检查网络——ping 延迟、丢包率;(5) 检查下游依赖——数据库、缓存、其他 RPC 的耗时;(6) 检查 Dubbo 序列化——大对象序列化耗时;(7) 检查是否触发了 JIT 去优化。最可能的原因:Full GC 暂停、线程池耗尽、下游依赖慢。
总结
Dubbo 的核心架构是一座精心设计的"积木城堡"——SPI 是积木的接口标准,服务暴露/引用是城堡的城门,集群容错是守卫,路由是门禁,负载均衡是调度中心。每个模块既独立又通过 URL 和 SPI 紧密协作。
掌握 Dubbo 架构的关键不是记住每个类的名字,而是理解数据流(URL 如何传递配置)和调用链(一次 RPC 的完整路径)。当你能在脑海中画出从 @DubboReference 注解到 Netty 字节流的完整链路时,Dubbo 对你来说就不再是"黑盒框架"了。
本文基于 Dubbo 2.7.x / 3.x 源码分析,部分细节可能因版本不同有差异,请以实际使用的版本为准。