阅读时间:约 45 分钟 难度:中高级 前置知识:分布式系统基础概念、CAP 理论、Java 并发编程基础
一、为什么会有 ZooKeeper?
分布式系统有一个经典困境:协调难。
想象你管理一个 100 台机器组成的集群。每台机器独立运行,但它们需要就"谁是 Leader"、"配置是否已更新"、"某个服务是否还活着"这些问题达成一致。没有协调机制,每个节点都是信息孤岛——Leader 选举可能选出两个 Leader,配置更新可能只推送到一半节点,服务下线了其他节点却不知道。
这就是 ZooKeeper 要解决的核心问题:为分布式系统提供可靠的协调原语。
ZooKeeper 的设计哲学非常务实:不追求极致的写入吞吐,而是追求强一致性、高可靠性和低延迟的读操作。它把自己定位为分布式系统的"瑞士军刀"——不是用来存业务数据,而是存元数据(配置、状态、锁信息、成员列表)。
一个本质类比:ZooKeeper 之于分布式系统,就像文件系统之于操作系统——它提供了一棵共享的树形命名空间,分布式节点通过读写这棵树来协调彼此的行为。
二、数据模型:类文件系统的 ZNode 树
2.1 树形命名空间
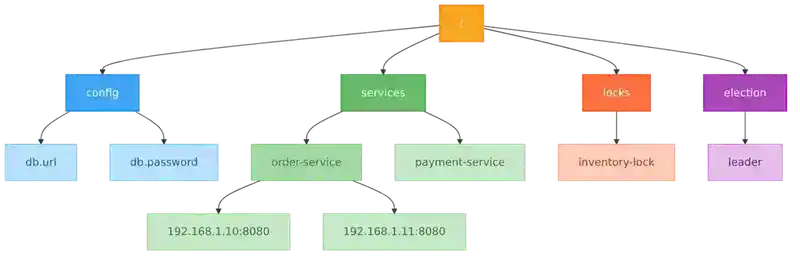
ZooKeeper 的数据模型是一棵层次化的树,每个节点称为 ZNode。路径用 / 分隔,类似 Unix 文件系统:
/
├── /config
│   ├── /config/db.url
│   └── /config/db.password
├── /services
│   ├── /services/order-service
│   │   ├── /services/order-service/192.168.1.10:8080
│   │   └── /services/order-service/192.168.1.11:8080
│   └── /services/payment-service
├── /locks
│   └── /locks/inventory-lock
└── /election
    └── /election/leader
每个 ZNode 可以存储少量数据(默认最大 1MB),同时维护一个版本号(version)和时间戳。这个设计决定了 ZooKeeper 适合存元数据而非大块数据。
2.2 ZNode 的四种类型
这是理解 ZooKeeper 的核心,也是面试高频考点:
| 类型 | 创建命令 | 生命周期 | 典型用途 |
|---|---|---|---|
| 持久节点(PERSISTENT) | create /path data |
显式删除才消失 | 配置信息、全局元数据 |
| 持久顺序节点(PERSISTENT_SEQUENTIAL) | create -s /path data |
同持久节点,但名称带自增序号 | 分布式锁的排队队列 |
| 临时节点(EPHEMERAL) | create -e /path data |
创建它的客户端会话断开即自动删除 | 服务注册、成员存活检测 |
| 临时顺序节点(EPHEMERAL_SEQUENTIAL) | create -e -s /path data |
同临时节点,但名称带自增序号 | Leader 选举、分布式锁 |
关键理解:临时节点是 ZooKeeper 实现"服务发现"和"故障检测"的基石。当客户端与 ZooKeeper 之间的 Session 断开(比如进程崩溃、网络分区),该客户端创建的所有临时节点都会被 ZooKeeper 自动清理。其他监听了这些节点的客户端会收到通知。
2.3 ZNode 的 Stat 结构
每个 ZNode 都携带一个 Stat 结构,包含版本号、时间戳等信息:
cZxid  — 创建该节点的事务 ID
mZxid  — 最后修改该节点的事务 ID
pZxid  — 最后修改子节点列表的事务 ID
ctime  — 创建时间
mtime  — 最后修改时间
version — 数据版本号(每次修改 +1,用于 CAS 操作)
cversion — 子节点列表版本号
aversion — ACL 版本号
dataLength — 数据长度
numChildren — 子节点数量
版本号是 ZooKeeper 实现**乐观锁(CAS)**的机制:更新数据时必须传入当前版本号,如果版本号不匹配(说明数据已被其他客户端修改),更新失败。这是实现分布式锁的基础。
三、ZAB 协议:ZooKeeper 的共识引擎
ZAB(ZooKeeper Atomic Broadcast)是 ZooKeeper 的核心协议,它保证了集群中所有节点数据的一致性。理解 ZAB 是理解 ZooKeeper 工作原理的关键。
3.1 为什么不用 Paxos/Raft?
ZooKeeper 诞生于 2007 年,当时 Raft 还没出现,Paxos 虽然理论完备但工程实现极为复杂。ZooKeeper 团队设计了一个更务实的协议——ZAB。
ZAB 和 Raft 有很多相似之处(都是 Leader-based 共识协议),但 ZAB 的设计更侧重于读写分离和高吞吐的写操作。
3.2 ZAB 的两种模式
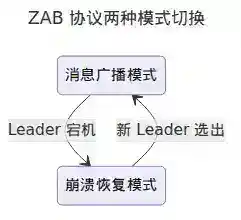
ZAB 协议运行在两种交替的模式下:
┌─────────────────────────────────────────────────────┐
│                  ZAB 协议状态机                        │
├─────────────────────────────────────────────────────┤
│                                                     │
│   ┌──────────────┐    Leader 宕机     ┌───────────┐ │
│   │  消息广播模式  │ ──────────────→  │ 崩溃恢复模式 │ │
│   │ (Broadcast)  │ ←──────────────  │ (Recovery) │ │
│   └──────────────┘  新 Leader 选出    └───────────┘ │
│                                                     │
└─────────────────────────────────────────────────────┘
消息广播模式(Broadcast):集群正常运行时的状态。Leader 接收客户端的写请求,将其转化为事务提案(Proposal),广播给所有 Follower,等待超过半数确认后提交。
崩溃恢复模式(Recovery):Leader 宕机或网络分区后,集群进入此模式。目的是选出新 Leader,并将所有节点的数据同步到一致状态。
3.3 消息广播:两阶段提交的改进版
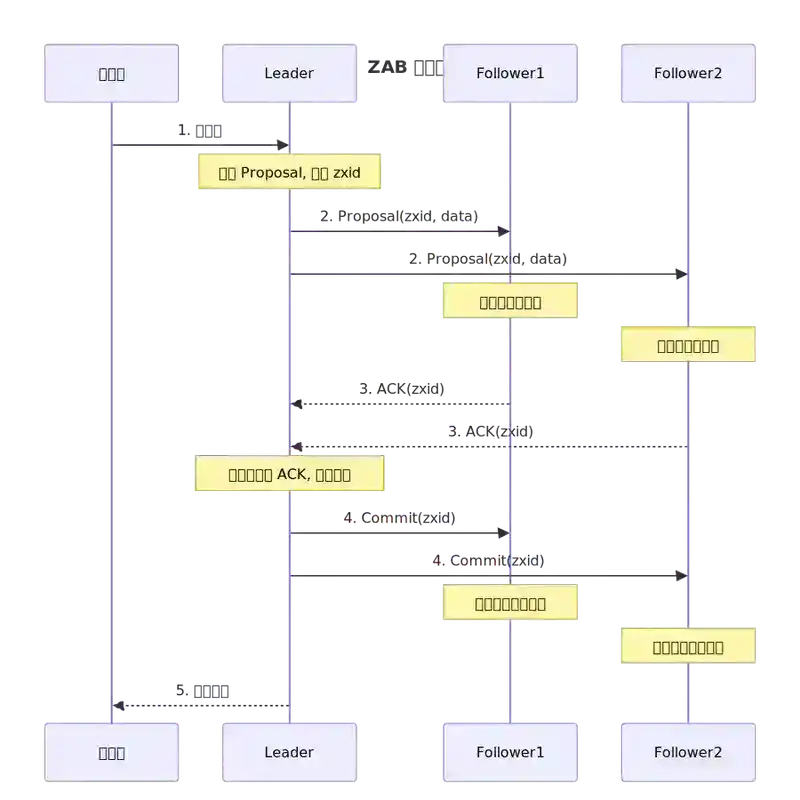
ZAB 的消息广播借鉴了两阶段提交(2PC),但做了关键优化——没有 Abort 阶段:
客户端          Leader                Follower₁          Follower₂
  │                │                     │                  │
  │──写请求────────→│                     │                  │
  │                │                     │                  │
  │                │─Proposal(zxid,data)─→│                  │
  │                │─────────────────Proposal(zxid,data)───→│
  │                │                     │                  │
  │                │←────ACK(zxid)───────│                  │
  │                │←───────────────────ACK(zxid)──────────│
  │                │                     │                  │
  │                │─Commit(zxid)───────→│                  │
  │                │─────────────────Commit(zxid)──────────→│
  │                │                     │                  │
  │←──响应─────────│                     │                  │
关键点:
- Proposal 是有序的:每个事务被分配一个递增的 zxid(64 位,高 32 位是 epoch,低 32 位是计数器),保证全局顺序。
- 过半即提交:Leader 收到超过半数 Follower 的 ACK 后,就提交事务并响应客户端。这保证了可用性,同时容忍少数节点故障。
- Follower 按序提交:Follower 严格按照 zxid 顺序提交事务,即使某些 Proposal 的 ACK 还没收到,也必须按序等待。
3.4 崩溃恢复:谁来当 Leader?
崩溃恢复要解决两个核心问题:
- 选谁当新 Leader:必须选一个包含了所有已提交事务的节点。
- 数据同步:新 Leader 必须确保所有节点数据一致。
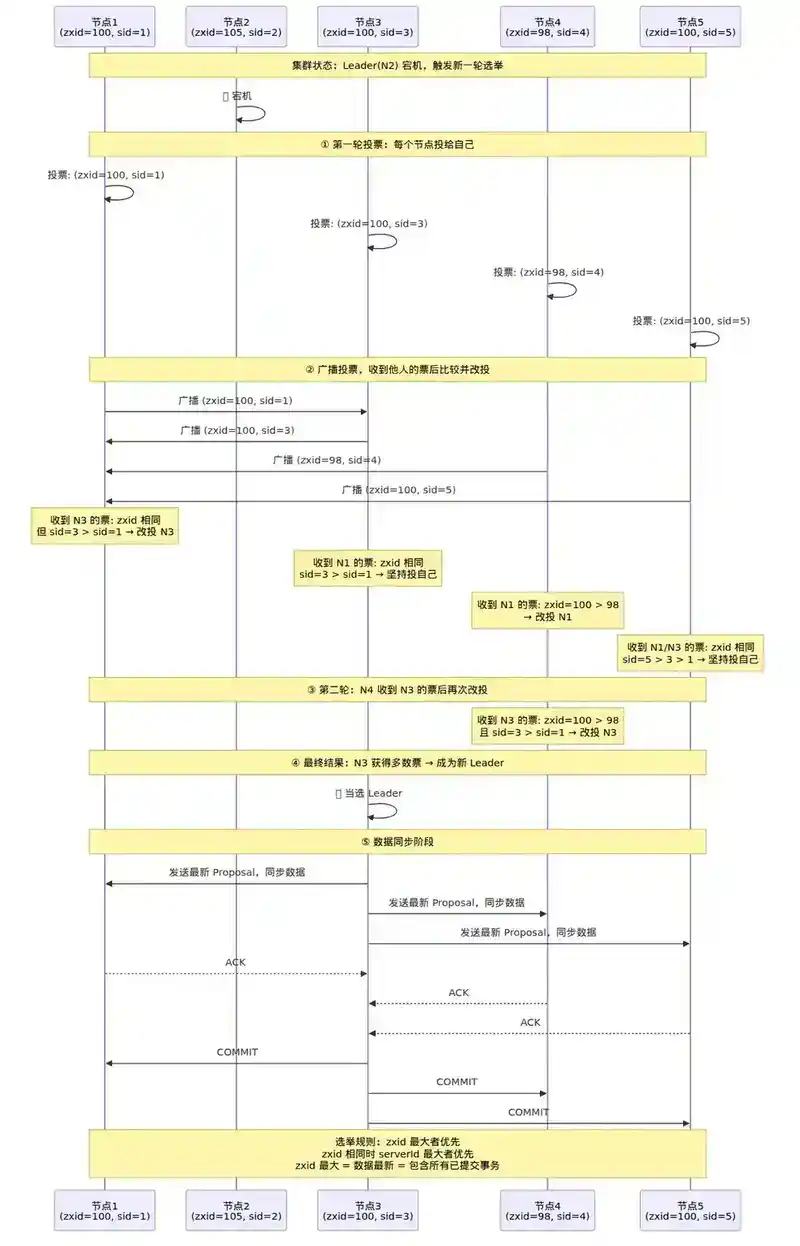
Leader 选举策略:ZooKeeper 使用 Fast Leader Election(FLE)算法。基本规则是:每个节点投票给自己,然后比较谁的 zxid 最大(谁的数据最新),选 zxid 最大的节点当 Leader。如果 zxid 相同,选 serverId 最大的。
这样设计的原因:zxid 最大的节点一定包含了所有已提交的事务。因为任何已提交的事务必然被超过半数的节点确认,而 zxid 最大的节点至少和这些节点中的某一个有相同的 zxid 范围。
数据同步:新 Leader 选出后,它会将自己的数据状态作为基准,要求所有 Follower 同步。具体做法是 Leader 发送自己最新的事务 Proposal 给 Follower,Follower 确认后,Leader 发送 COMMIT 消息。同步完成后,集群进入广播模式。
3.5 ZAB 与 Raft 的核心差异
| 维度 | ZAB | Raft |
|---|---|---|
| Leader 选举 | 选 zxid 最大的 | 选 log 最新且 term 最大的 |
| 日志提交 | 过半 ACK 即提交 | 当前 term 的日志必须复制到多数才能提交 |
| Follower 落后 | Leader 主动推送 | Follower 被动拉取 |
| 成员变更 | 静态配置 | 联合共识(Joint Consensus) |
| 读操作 | 可在 Follower 执行(可能读到旧数据) | 强一致读 |
四、临时节点与 Session 机制
4.1 Session 的生命周期
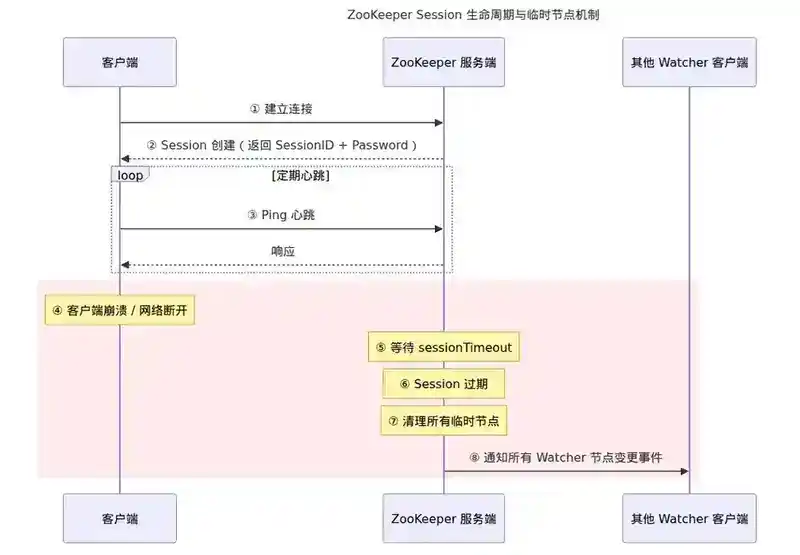
临时节点是 ZooKeeper 最具特色的设计之一,而它的实现依赖于 Session 机制:
客户端                          ZooKeeper 服务端
  │                                   │
  │─────────建立连接──────────────────→│
  │←────────SessionID + Password──────│  (Session 创建)
  │                                   │
  │─────────Ping/心跳─────────────────→│  (定期发送)
  │                                   │  Session 超时判断:
  │                                   │  tickTime(每次心跳间隔)
  │                                   │  × syncLimit(最大容忍次数)
  │           ...心跳...              │  = sessionTimeout
  │                                   │
  │  × 客户端崩溃/网络断开            │
  │                                   │  等待 sessionTimeout
  │                                   │  ↓
  │                                   │  Session 过期!
  │                                   │  清理所有临时节点
  │                                   │  通知所有 Watcher
4.2 Session 超时判断
ZooKeeper 服务端使用分桶策略管理 Session 超时:
Session 过期时间轴
├── bucket₁ (expireTime: T+1s)
├── bucket₂ (expireTime: T+2s)
├── bucket₃ (expireTime: T+3s)  ← 当前检查点
├── bucket₄ (expireTime: T+4s)
└── ...
Leader 每隔 tickTime 检查当前时间是否已经超过某个桶的过期时间。如果超过,该桶中所有未续期的 Session 都被标记为过期,对应的临时节点被删除。
一个重要的生产实践:sessionTimeout 不是越短越好。太短会导致网络抖动时频繁触发 Session 过期和临时节点删除,引起服务动荡。通常设置为 10-30 秒。
4.3 临时节点的"幽灵"问题
当客户端因为 GC 停顿(Full GC 持续数秒)被误判为 Session 过期,它的临时节点被删除。等 GC 结束后,客户端恢复,但它以为自己还是 Leader(因为本地状态没变),这就是"幽灵 Leader"问题。
解决方案:
- 客户端收到 SessionExpired 事件后,必须重新创建临时节点,重新参与选举。
- 在业务层面,使用 fencing token(自增序号)防止老 Leader 执行写操作。
五、Watcher 机制:分布式通知的基石
5.1 设计哲学:一次性触发
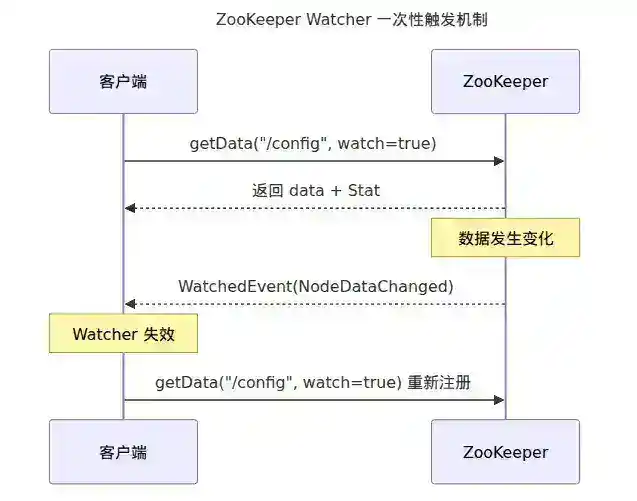
ZooKeeper 的 Watcher 有一个反直觉的设计:一次性的(one-time trigger)。
客户端                              ZooKeeper
  │                                    │
  │──getData("/config", watch=true)───→│  (注册 Watcher)
  │←──data + Stat─────────────────────│
  │                                    │
  │           ... 数据变化 ...          │
  │                                    │
  │←──WatchedEvent(NodeDataChanged)───│  (触发通知)
  │                                    │
  │   Watcher 已失效!                  │
  │   需要重新注册才能继续监听          │
  │                                    │
  │──getData("/config", watch=true)───→│  (重新注册)
为什么是一次性的?
这是个经过深思熟虑的设计。如果 Watcher 是持久化的,服务端需要为每个客户端维护一个 Watcher 列表,在每次数据变更时遍历通知所有客户端。这在大量客户端监听同一节点时会造成严重的性能问题,而且如果客户端已经离线,通知会堆积。
一次性触发加上客户端主动重新注册,把"通知"和"拉取最新数据"解耦了:
- 服务端只需要在数据变更时发出一次通知,不关心客户端是否收到;
- 客户端收到通知后,主动拉取最新数据,同时决定是否继续监听。
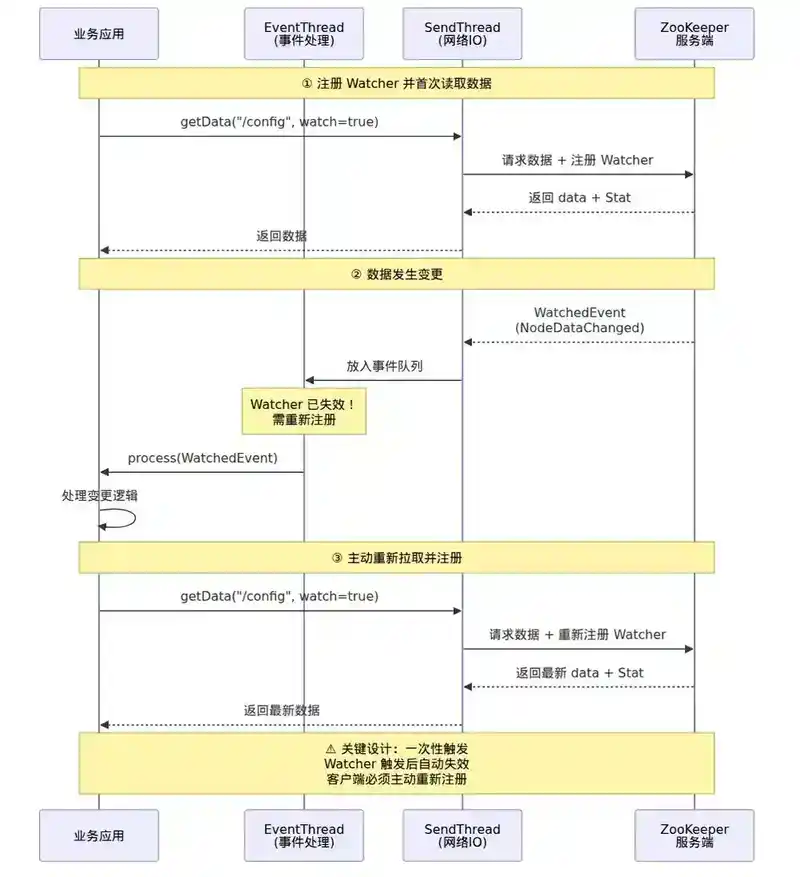
5.2 Watcher 的实现流程
客户端线程模型:
┌──────────────────────────────────────────────────────┐
│  IO 线程(SendThread)          Event 线程(EventThread)  │
│ ┌─────────────────────┐      ┌─────────────────────┐ │
│ │ 发送请求              │      │ 处理 Watcher 事件    │ │
│ │ 接收响应              │ ───→ │ 调用 process() 回调   │ │
│ │ 接收 Watcher 通知     │      │ 执行业务逻辑          │ │
│ └─────────────────────┘      └─────────────────────┘ │
└──────────────────────────────────────────────────────┘
客户端使用两个线程:
- SendThread:负责网络 I/O,包括发送请求、接收响应、接收 Watcher 通知。
- EventThread:专门处理 Watcher 事件,调用用户的
process(WatchedEvent event)回调。
注意:Watcher 事件处理是串行的——所有事件在同一个 EventThread 中顺序处理。如果某个 Watcher 的回调执行时间过长,会阻塞后续事件的处理。
5.3 Watcher 的类型
| Watcher 类型 | 触发条件 |
|---|---|
NodeCreated |
被监听的节点被创建 |
NodeDeleted |
被监听的节点被删除 |
NodeDataChanged |
被监听的节点数据被修改 |
NodeChildrenChanged |
被监听节点的子节点列表发生变化(增/删) |
常见误区:NodeChildrenChanged 只通知子节点列表变化,不告诉你具体是哪个子节点变了。你需要自己对比新旧子节点列表。
5.4 Curator 的增强
Apache Curator 是 ZooKeeper 的官方客户端封装,它解决了原生 Watcher 的几个痛点:
- 自动重新注册:Curator 的
NodeCache、PathChildrenCache、TreeCache在收到通知后自动重新注册 Watcher。 - 事件合并:如果短时间内有多次变更,Curator 会合并事件,减少回调次数。
- 异步回调:支持异步监听,避免阻塞 EventThread。
六、一致性保证:ZooKeeper 到底承诺了什么?
6.1 ZooKeeper 的一致性模型
ZooKeeper 提供的是顺序一致性(Sequential Consistency),不是线性一致性(Linearizability)。
顺序一致性:所有客户端看到的操作顺序是一致的,这个顺序是所有操作的一个合法排列,且每个客户端的操作保持其自身的顺序。
线性一致性:比顺序一致性更强,要求操作的顺序与真实时间顺序一致。如果操作 A 在操作 B 之前完成,那么所有客户端都必须先看到 A 再看到 B。
ZooKeeper 不保证线性一致性的原因是:读操作可以在任意节点执行。Follower 上的数据可能比 Leader 稍旧(复制延迟),所以客户端从 Follower 读到的数据可能是过时的。
6.2 ZooKeeper 的具体保证
- 顺序一致性:来自同一个客户端的更新请求,严格按照客户端发送的顺序执行。
- 原子性:更新操作要么在所有节点上成功,要么全部失败。不存在部分成功。
- 单一系统镜像(Single System Image):客户端无论连接到哪个 ZooKeeper 节点,看到的都是同一个系统视图(数据树)。但注意,Follower 上可能有短暂的复制延迟。
- 持久性:一旦更新成功,数据就持久化保存,直到被后续更新覆盖。
- 实时性(Timeliness):ZooKeeper 保证在有限时间内,客户端看到的数据状态不会过于陈旧,但这个"有限时间"没有硬性保证。
6.3 什么场景下 ZooKeeper 不适用?
- 强一致读:如果你需要每次读都读到最新数据,必须调用
sync()让 Follower 与 Leader 同步后再读,或者只读 Leader。 - 高吞吐写:ZooKeeper 的写操作必须经过 Leader,单集群的写入吞吐上限通常在每秒万级别。不适合作为业务数据的主存储。
- 大数据量存储:ZNode 数据上限 1MB,且 ZNode 总数不宜过多(通常建议控制在万级别)。
七、典型应用场景
7.1 配置管理
场景:集群中所有节点需要共享同一份配置,且配置变更时需要实时生效。
实现:
1. 管理员在 /config/app 节点写入新的配置数据
2. 所有应用节点监听 /config/app 的 NodeDataChanged 事件
3. 收到通知后,各节点重新读取配置并应用
注意事项:
- 配置不要太大(ZNode 数据量限制)
- 考虑到配置变更频率低,可以将配置缓存在本地,减少对 ZooKeeper 的读压力
- 敏感配置(密码等)需要加密存储
7.2 服务注册与发现
场景:微服务架构中,服务提供者需要注册自己的地址,服务消费者需要发现可用的提供者。
实现:
/服务名/provider/临时顺序节点
例如:/services/order-service/192.168.1.10:8080-0000000001
服务启动时,在对应服务名下创建临时节点,写入自己的地址(IP:Port)。服务停止或宕机时,临时节点自动删除。消费者监听 /services/order-service 的子节点变化,维护一份可用的服务地址列表。
优势:自动感知服务上下线,无需额外的心跳机制。
局限:服务节点数量不宜过多(ZooKeeper 不适合存大量 ZNode)。Dubbo 早期使用 ZooKeeper 做注册中心,后来逐步转向 Nacos 等专用注册中心。
7.3 分布式锁
场景:多个进程需要互斥地访问共享资源。
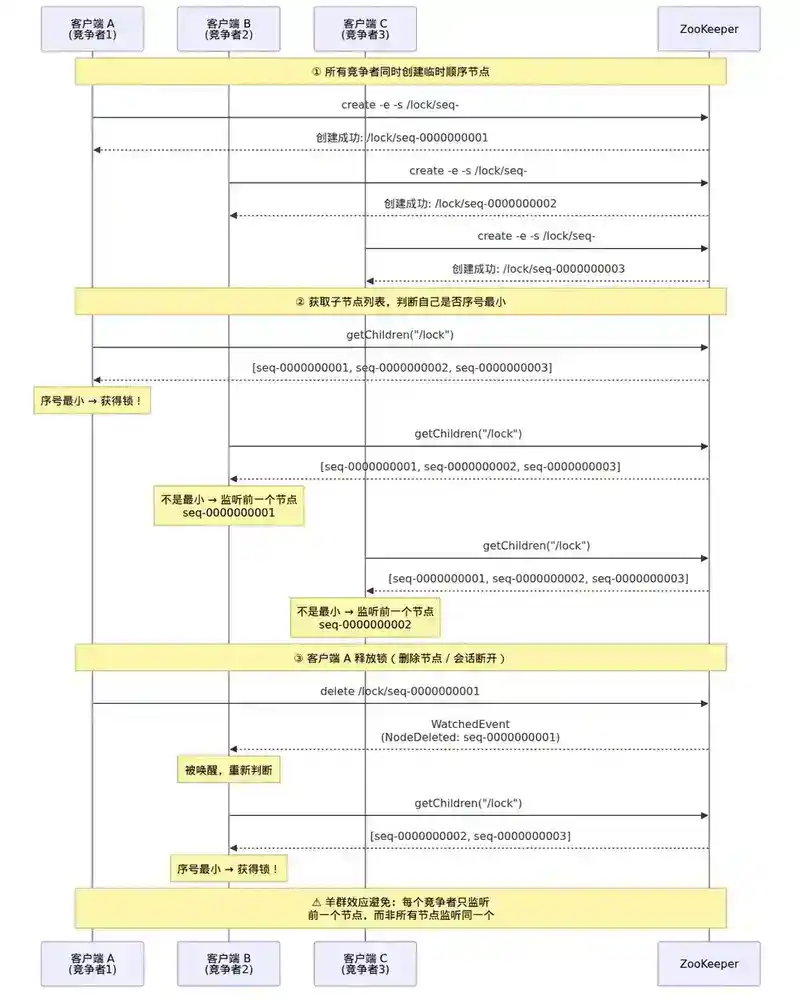
实现(基于临时顺序节点):
1. 所有竞争者同时在 /locks/mylock/ 下创建临时顺序节点
2. 获取 /locks/mylock/ 下的所有子节点,按序号排序
3. 如果自己创建的节点序号最小,则获得锁
4. 否则,监听前一个节点的删除事件
5. 收到前一个节点删除的通知后,重新判断自己是否序号最小
为什么不用 create -e 直接竞争创建同一个节点? 因为"创建同名节点失败"只能实现非阻塞的锁尝试,无法实现排队等待。顺序节点方案实现了公平锁——先来先得。
"羊群效应"(Herd Effect)问题: 如果所有竞争者都监听同一个节点,当锁释放时,所有竞争者同时被唤醒,但只有一个能获得锁,造成大量无效唤醒。正确的做法是每个竞争者只监听自己前一个节点,这样锁释放时只有下一个竞争者被唤醒。
7.4 Leader 选举
场景:集群中需要选出一个 Leader 来执行特定任务(如定时任务调度、数据分片管理)。
实现(与分布式锁类似):
1. 所有候选者在 /election/ 下创建临时顺序节点
2. 序号最小的节点对应的进程成为 Leader
3. 非 Leader 监听前一个节点的删除事件
4. Leader 宕机后,临时节点被删除,下一个序号的节点成为新 Leader
7.5 分布式队列
场景:实现一个简单的分布式任务队列。
实现:
生产者:在 /queue/ 下创建顺序节点,数据为任务内容
消费者:获取 /queue/ 下的所有子节点,按序号排序,处理最小的,处理完后删除
局限:ZooKeeper 并不适合做大规模消息队列(数据量限制、吞吐限制),这种方案只适合少量元数据级别的任务协调。
八、生产实践与常见陷阱
8.1 ZNode 数量和大小
- 单个 ZNode 数据不建议超过 1MB(上限),通常控制在 KB 级别
- 集群总 ZNode 数量建议控制在数万以内
- 大量的 ZNode 会导致快照文件变大,影响恢复速度
8.2 连接数管理
- ZooKeeper 集群的客户端连接数是有限的
- 每个客户端应复用同一个 ZooKeeper 连接(单例模式)
- 不要在短生命周期对象中频繁创建/销毁 ZooKeeper 连接
8.3 Session 超时设置
- 不要设置过短(如 3 秒),网络抖动或 GC 可能导致误判
- 不要设置过长(如 60 秒),故障检测延迟过大
- 推荐 10-30 秒,需结合业务容忍度
8.4 Watcher 的相关陷阱
- 忘记重新注册:原生的 Watcher 是一次性的,收到通知后必须重新注册。
- EventThread 阻塞:Watcher 回调在单线程中执行,不要在回调中做耗时操作。
- 连接断开期间的变更丢失:客户端与 ZooKeeper 断开连接期间的数据变更,Watcher 不会补发。重连后需要重新读取数据并重新注册 Watcher。
8.5 集群规模建议
- 生产环境最小 3 台,推荐 5 台(容忍 2 台故障)
- 不要使用偶数台(2 台无法形成多数,4 台不比 3 台更可靠)
- Observer 节点可以扩展读能力,不参与投票
九、总结
ZooKeeper 通过以下机制构建了分布式协调的基础设施:
| 机制 | 解决的问题 |
|---|---|
| ZAB 协议 | 保证集群节点间数据一致性,支持 Leader 选举和故障恢复 |
| 临时节点 | 自动感知客户端存活状态,实现服务注册和故障检测 |
| Watcher 机制 | 实现数据变更的实时通知,驱动配置更新、锁释放、Leader 变更等 |
| 顺序一致性 | 保证所有客户端看到一致的操作顺序 |
| 版本号(CAS) | 实现乐观锁,支撑分布式锁和事务操作 |
ZooKeeper 的设计哲学是"简单可靠"——它不试图解决所有分布式问题,而是提供一组经过验证的原子原语,让你在它之上构建复杂的协调逻辑。理解 ZAB 协议、临时节点和 Watcher 机制,就掌握了 ZooKeeper 的核心。
面试提问
以下是面试官视角可能追问的问题,请尝试独立回答后再看参考答案:
问题 1(基础)
ZooKeeper 的临时节点和持久节点有什么区别?为什么临时节点能实现服务自动发现?
点击查看参考答案
临时节点与客户端 Session 绑定,客户端断开连接后 Session 超时,临时节点被自动删除。持久节点不会因客户端断开而删除。
服务发现:服务提供者启动时创建临时节点(如 /services/order-service/192.168.1.10:8080),服务消费者监听父节点的子节点变化。当服务提供者宕机,临时节点自动删除,消费者收到通知并从本地列表中移除该节点,实现自动感知。
问题 2(中等)
ZAB 协议的两阶段提交和传统 2PC 有什么区别?为什么 ZAB 不需要 Abort 阶段?
点击查看参考答案
传统 2PC 有 Prepare 和 Commit 两个阶段,如果 Prepare 阶段有参与者失败,协调者需要发送 Abort 回滚。
ZAB 不需要 Abort 的关键原因:ZAB 的 Proposal 是有序的、幂等的。如果某个 Follower 没收到 Proposal 或 ACK 失败,Leader 不需要 Abort,因为:
- 后续的崩溃恢复阶段会重新同步未提交的事务
- 新 Leader 选出后,会要求所有节点同步到自己的状态
- 客户端通过重试保证最终一致性
ZAB 本质上是一个原子广播协议,而非事务协议——它不关心事务的语义,只关心消息的有序传递。
问题 3(中等)
ZooKeeper 的 Watcher 为什么是一次性的?如果设计成持久化的会有什么问题?
点击查看参考答案
一次性 Watcher 是经过权衡的设计:
如果设计成持久化的:
- 服务端压力大:服务端需要维护每个客户端对每个节点的 Watcher 映射,数据变更时遍历通知所有客户端,在大规模集群中性能开销大。
- 通知堆积:如果客户端离线或处理慢,大量通知堆积。
- 状态不一致:客户端因网络问题漏掉通知后,服务端无法感知,客户端数据与 ZooKeeper 不一致。
一次性触发 + 客户端主动重新注册的设计:
- 服务端只负责触发一次通知,减轻负担
- 客户端收到通知后主动拉取最新数据,保证数据一致
- 客户端自己决定是否继续监听,逻辑更灵活
问题 4(较难)
ZooKeeper 集群中,3 台和 4 台节点的容错能力有什么区别?为什么推荐使用奇数台?
点击查看参考答案
ZooKeeper 使用多数派(过半)原则:
- 3 台节点:容忍 1 台故障(需要 2 台存活形成多数)
- 4 台节点:同样只能容忍 1 台故障(需要 3 台存活形成多数,2 台不是多数)
4 台比起 3 台,多了一台机器的成本,但容错能力没有提升。而且 4 台情况下,如果恰好 2 台故障,集群无法工作(2/4 不构成多数),反而增加了故障概率。
因此生产环境推荐 3 或 5 台,避免偶数台。
问题 5(较难)
为什么说 ZooKeeper 不适合做服务注册中心?Nacos 相比 ZooKeeper 在注册中心场景下做了哪些改进?
点击查看参考答案
ZooKeeper 做注册中心的问题:
- CP 模型:网络分区时,少数派节点不可用,导致注册中心整体不可用。但注册中心其实更关注可用性(AP),宁可短暂不一致也不应不可用。
- 临时节点数量限制:大量微服务实例会产生大量临时节点,ZooKeeper 的 ZNode 上限和快照性能是瓶颈。
- Watcher 的羊群效应:大量消费者监听同一服务时,每次变更都会触发大量通知。
Nacos 的改进:
- AP + CP 可切换:默认 AP 模式,保证注册中心的高可用性;配置中心使用 CP 模式。
- 健康检查机制:支持客户端心跳和服务端主动探测,不依赖临时节点和 Session 超时。
- 推送机制:使用 UDP 推送 + 长轮询,比 ZooKeeper 的 Watcher 更高效。
- 存储可扩展:支持 MySQL 等外部存储,突破了 ZooKeeper 的内嵌存储限制。
问题 6(挑战)
ZooKeeper 的写请求必须经过 Leader,那么读请求呢?如果直接在 Follower 上读,可能读到旧数据,怎么解决?
点击查看参考答案
ZooKeeper 默认情况下,读请求可以在任意节点执行(包括 Follower),这可能导致读到旧数据(复制延迟)。
解决方案:
- 调用
**sync()**:在读之前先调用sync(),让 Follower 与 Leader 同步到最新状态,然后在该 Follower 上读。这保证了读到的数据不旧于sync()调用时的状态,不保证线性一致性。 - 只读 Leader:Curator 等客户端支持配置只在 Leader 上执行读操作,代价是 Leader 压力增大。
- 业务层面容忍:很多场景下短暂的不一致是可接受的(如配置管理),不需要完全强一致。
底层原理:sync() 命令会作为一个事务被 Leader 处理,Leader 处理完后提交,Follower 收到这个 sync 事务的提交后,就可以保证它已经应用了到此为止的所有事务。
本文基于 ZooKeeper 3.8.x 版本编写,部分机制在后续版本中可能有优化调整。